Retail Intelligence in tempo reale: creare raccomandazioni per l'e-commerce con Lakebase e AI Search su Databricks
In che modo una piattaforma leader di e-commerce di moda offre raccomandazioni di prodotti personalizzate a bassa latenza a milioni di utenti — interamente basata sulla Databricks Data Intelligence Platform.
di Sunny Singh
- Un'architettura di riferimento completa per creare un motore di raccomandazione e ranking multi-stage su Databricks — dall'ingestione del clickstream al serving personalizzato in tempo reale — sostituendo un'infrastruttura ML frammentata con un'unica piattaforma unificata.
- Il sistema fornisce raccomandazioni di prodotti personalizzate a bassa latenza combinando raccomandazioni batch precalcolate con un percorso di scoring in tempo reale, utilizzando Databricks AI Search per il recupero dei candidati, Lakebase per l'online feature serving e Model Serving per l'inferenza a bassa latenza.
- Unificando data engineering, gestione delle feature, addestramento dei modelli e serving in tempo reale su un'unica piattaforma governata, i team di e-commerce eliminano il codice di integrazione, accelerano i cicli di iterazione e ottengono una lineage end-to-end dal clickstream grezzo alle previsioni in produzione.
L'opportunità: la personalizzazione come motore di ricavi
Ogni secondo che un acquirente trascorre su un'app di e-commerce di moda genera un flusso di segnali di intento: ricerche, visualizzazioni di prodotti, aggiunte alla lista dei desideri, interazioni con il carrello. Le piattaforme che convertono questi segnali in consigli sui prodotti pertinenti in tempo reale sono quelle che vincono. I benchmark di settore mostrano che una personalizzazione efficace può aumentare i tassi di conversione del 10-30% e incrementare significativamente il valore medio dell'ordine.
Tuttavia, la creazione di un sistema di raccomandazione di livello di produzione rimane una delle sfide di ingegneria ML più difficili. Richiede l'ingestione di dati in tempo reale, una complessa ingegneria delle feature, molteplici modelli ML che lavorano all'unisono e un'infrastruttura di serving che risponde in millisecondi, il tutto mantenendo sincronizzati l'inventario, la posizione e le regole aziendali.
Questo blog presenta un'architettura di riferimento completa per creare un sistema di questo tipo su Databricks, basata su un'implementazione reale per una delle principali piattaforme di e-commerce di moda in Asia che serve oltre 1 milione di utenti attivi mensili su un catalogo di oltre 100.000 SKU.
Panoramica del sistema: l'architettura in sintesi
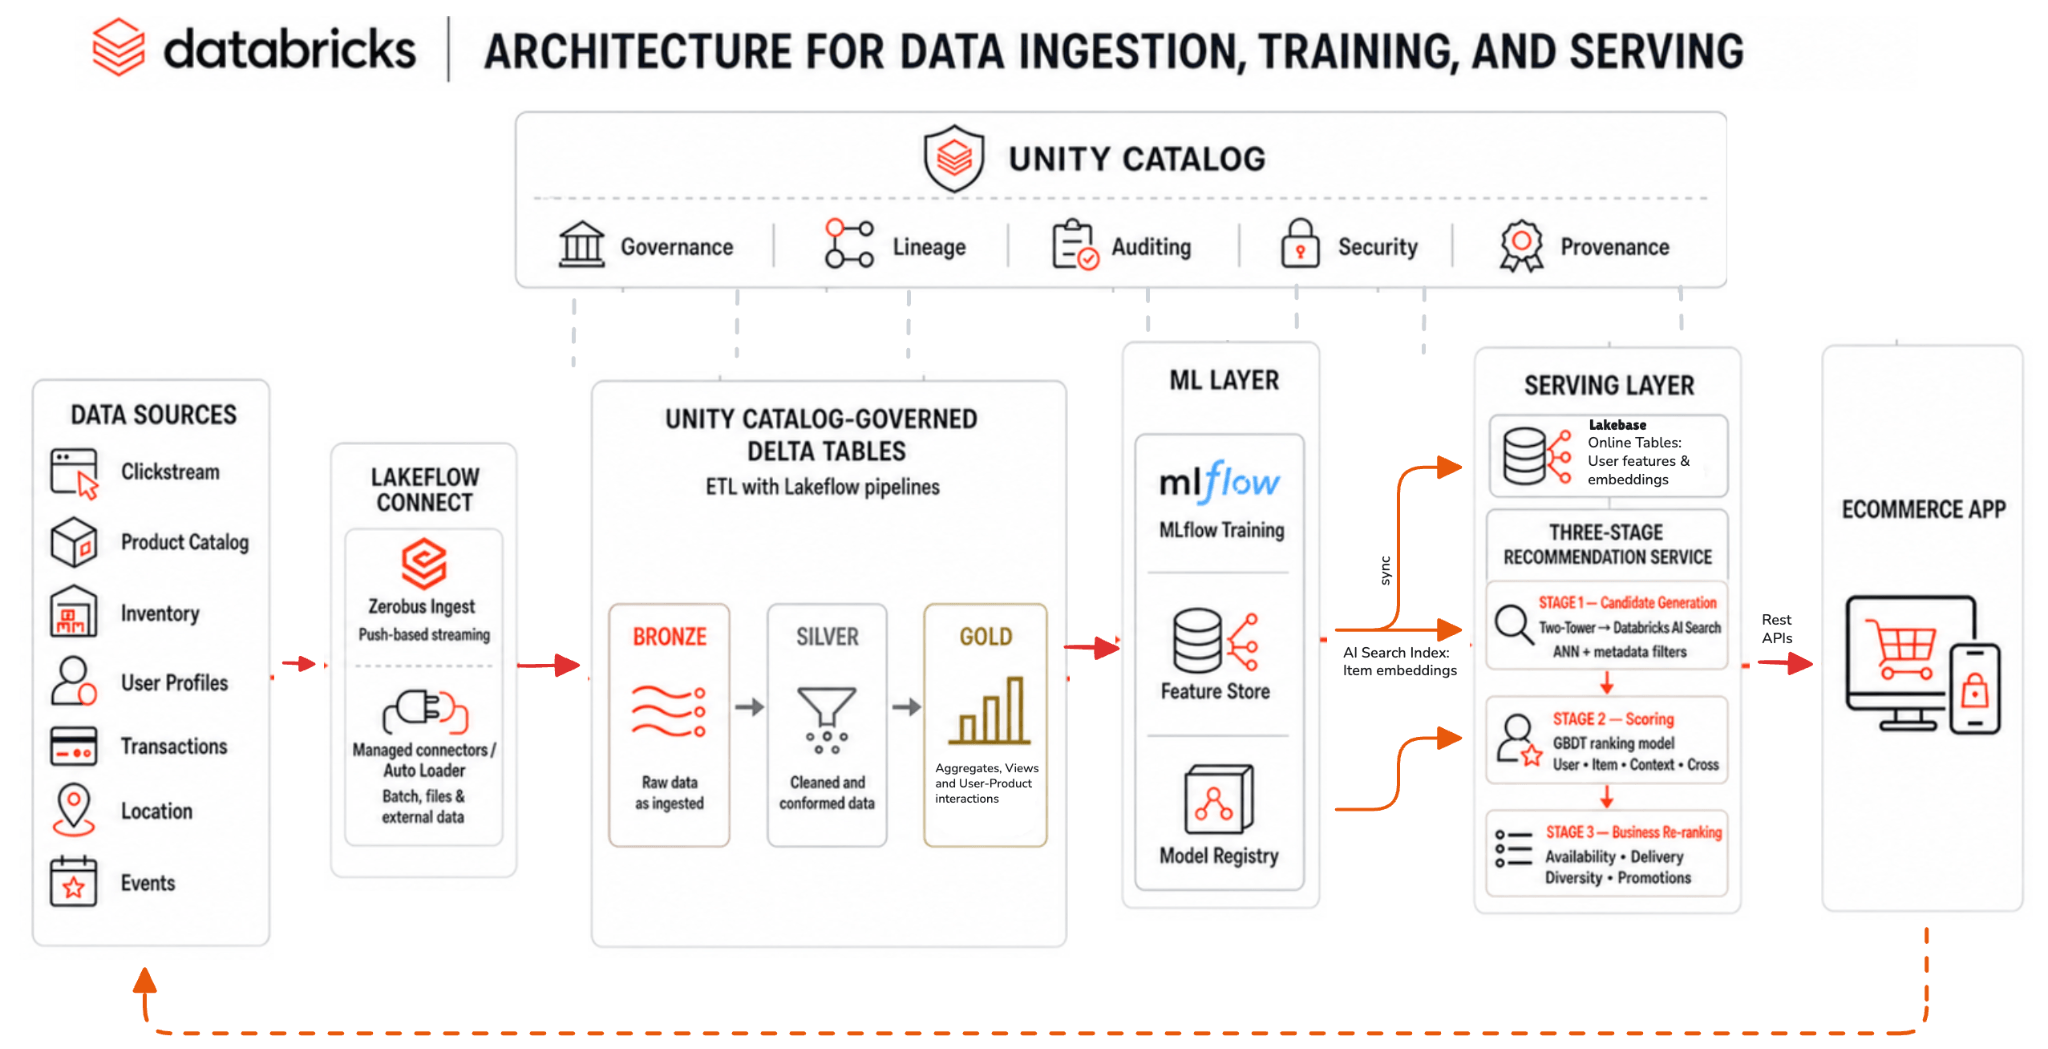
L'architettura segue un approccio di piattaforma unificata in cui ogni componente, dall'ingestione al serving, viene eseguito su Databricks, gestito da Unity Catalog.
Architettura complessiva del sistema:
Ingestione dei dati: dal clickstream al lakehouse in pochi secondi
La piattaforma acquisisce circa 1.000 eventi al secondo: visualizzazioni di prodotti, ricerche, azioni di aggiunta al carrello, acquisti e metadati delle sessioni. La funzionalità Lakeflow Connect Zerobus Ingest fornisce la spina dorsale dell'ingestione, depositando gli eventi direttamente nelle tabelle Delta di Unity Catalog senza richiedere un message broker autogestito.
Un'importante distinzione architetturale: i dati del clickstream fluiscono attraverso Zerobus nel lakehouse per il calcolo delle feature offline e l'addestramento del modello, ma durante l'inferenza in tempo reale (Percorso B), i segnali dell'utente in sessione (ciò che l'acquirente sta visualizzando in questo momento) vengono inviati direttamente come parte del payload della richiesta API all'endpoint di Model Serving. Questo esclude completamente l'archiviazione nel lakehouse durante il percorso di inferenza, garantendo la disponibilità del contesto in tempo reale senza incorrere in latenze di ingestione.
Zerobus accetta dati da qualsiasi client producer Kafka standard (Java, Python, Go) tramite una semplice modifica della configurazione: basta indirizzare il bootstrap server verso l'endpoint Zerobus e i record verranno depositati nella tabella Delta di destinazione. Per i team che già utilizzano un'infrastruttura Kafka, Structured Streaming con Declarative Pipelines offre un percorso alternativo con la stessa architettura a valle.
I dati fluiscono in un'architettura medallion:
Livello Bronze — Flussi di eventi non elaborati di tipo append-only e dati di riferimento:
- Segnali dell'utente:
- Comportamentali: sequenze di navigazione, query di ricerca, pattern di dwell time, cronologia dei clic
- Transazionali: frequenza di acquisto, valore medio dell'ordine, tasso di reso, distribuzione della spesa per categoria
- Preferenze: articoli nella lista dei desideri, ricerche salvate, affinità con i brand, preferenze sulle taglie
- Demografici: fascia d'età, cluster di posizione, tipo di dispositivo, livello di coinvolgimento dell'app
- Segnali degli articoli:
- Catalogo: gerarchia delle categorie, brand, fascia di prezzo, materiale, colore, stagionalità
- Prestazioni: tasso di conversione, rapporto visualizzazioni-carrello, tasso di reso, valutazione media
- Visivi: embedding delle immagini (per catturare la somiglianza di stile oltre gli attributi di testo)
- Freschezza: giorni dalla messa in vendita, velocità dei trend, traiettoria delle scorte
- Segnali contestuali:
- Temporali: ora del giorno, giorno della settimana, vicinanza al giorno di paga, periodi di festività/saldi
- Geografici: città dell'utente, centro di distribuzione più vicino, preferenze di stile regionali
- Ambientali: meteo (influenza le preferenze di categoria), eventi locali
- Sessione: intento di navigazione corrente (dedotto dal comportamento all'interno della sessione)
Livello Silver — Pulito, organizzato in sessioni e arricchito:
- Comportamento dell'utente organizzato in sessioni (sequenze di navigazione, tempi di permanenza, pattern di interazione)
- Feature dei prodotti pulite (attributi normalizzati, gerarchie di categorie)
- Segnali di coinvolgimento aggregati (conteggio delle visualizzazioni a 7 giorni, punteggi dei trend, indici di popolarità)
- Matrici di interazione utente-prodotto (segnali di feedback impliciti)
Livello Gold — Tabelle di feature pronte per il modello e dataset di addestramento:
- Vettori di feature dell'utente (embedding comportamentali, profili di preferenza, cluster demografici)
- Vettori di feature dell'articolo (embedding del prodotto, codifiche degli attributi)
- Dataset di addestramento (coppie di interazione etichettate per l'addestramento del modello)
- Liste di raccomandazione precalcolate (generate in batch, memorizzate per una ricerca rapida)
Le feature vengono aggiornate con cadenze diverse: gli aggregati comportamentali si aggiornano quotidianamente tramite Databricks Workflows pianificati, mentre l'intero catalogo prodotti si sincronizza settimanalmente. Gli embedding sia per gli utenti che per gli articoli vengono ricalcolati quotidianamente per catturare l'evoluzione delle preferenze e il nuovo inventario. Il Feature Store di Databricks gestisce sia le feature offline (per l'addestramento) que le feature online (per il serving), garantendo la coerenza tra addestramento e serving: le stesse definizioni di feature utilizzate durante l'addestramento del modello sono automaticamente disponibili al momento dell'inferenza tramite le tabelle online di Lakebase.
Unity Catalog gestisce ogni livello, fornendo la derivazione (lineage) dal singolo evento clickstream non elaborato fino alla previsione finale servita all'app, con un controllo degli accessi granulare che garantisce la protezione delle PII mentre le feature aggregate fluiscono liberamente verso l'addestramento del modello.
Serving in tempo reale: due percorsi per risposte a bassa latenza
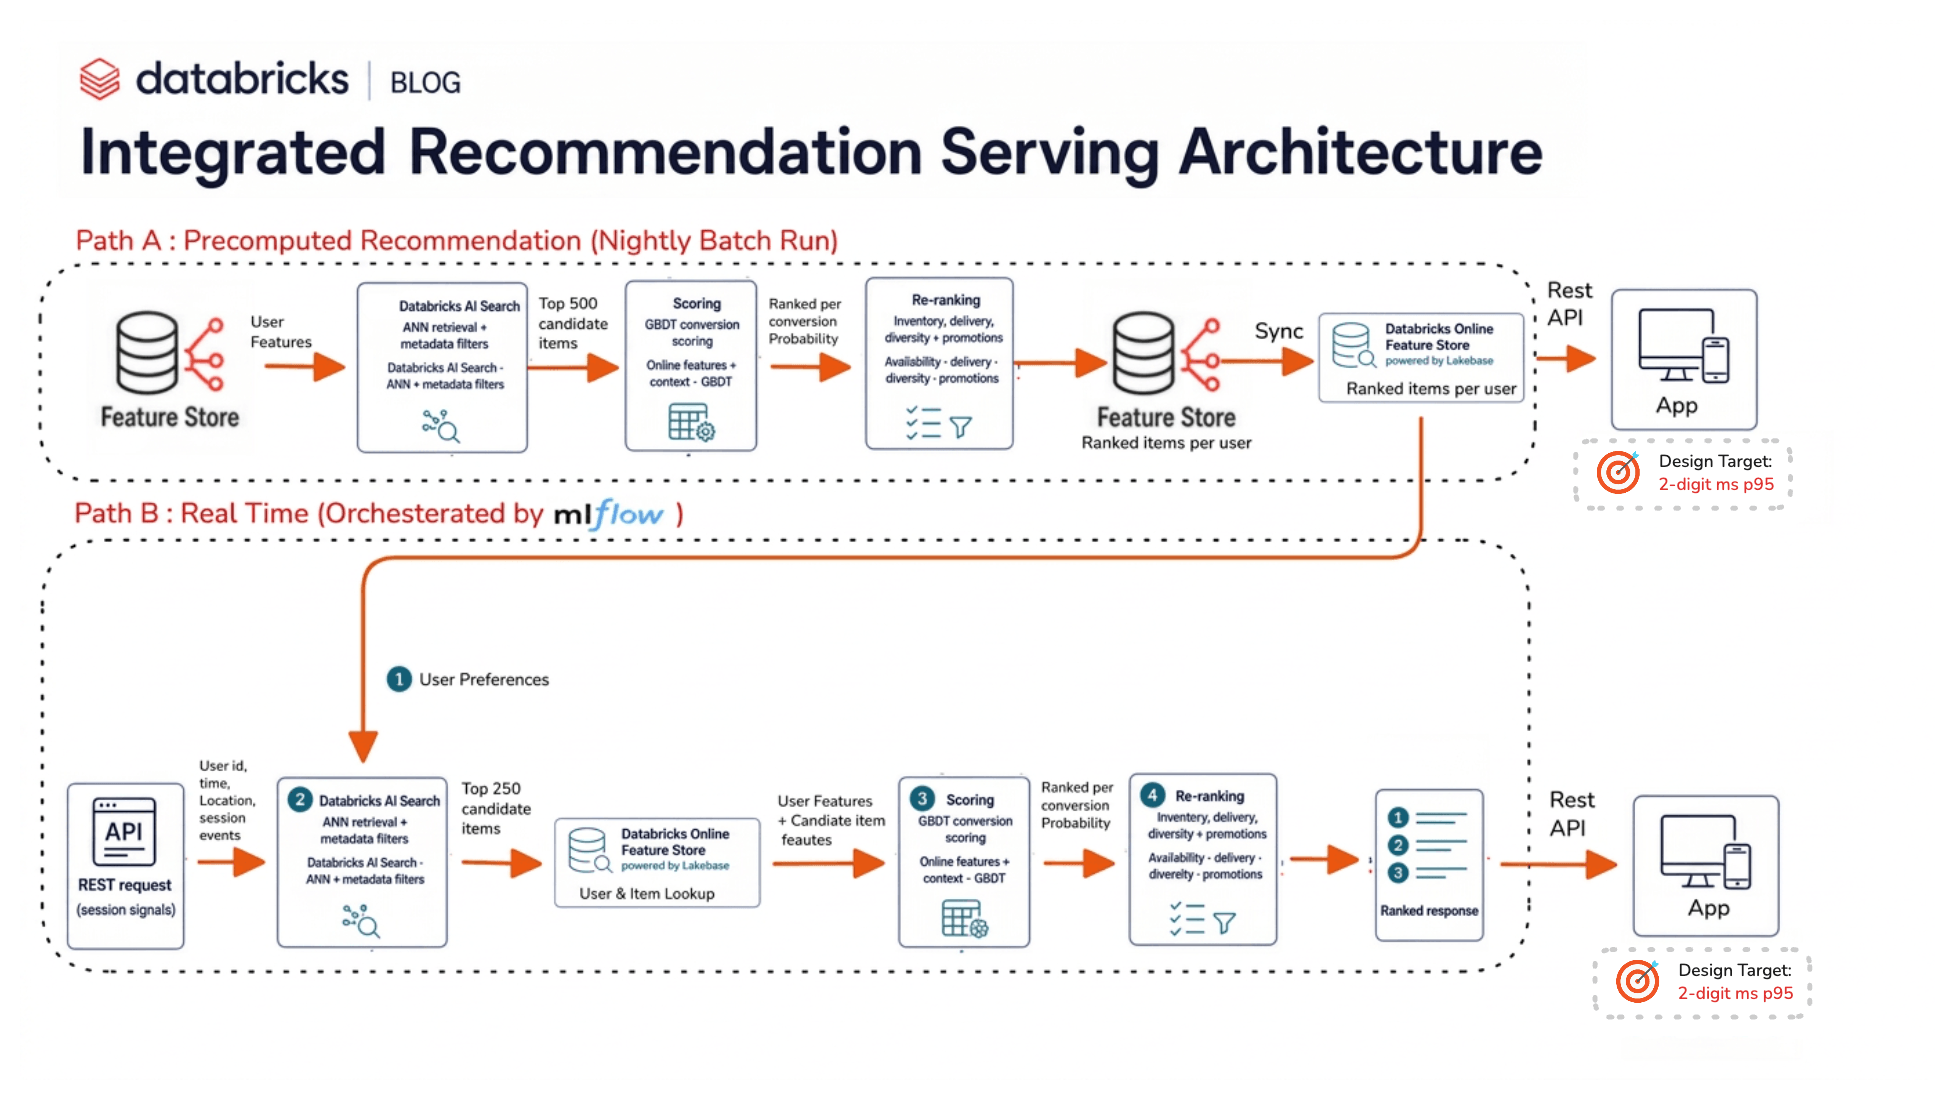
L'architettura di serving fornisce due percorsi complementari, ciascuno ottimizzato per diversi pattern di interazione. Il percorso A gestisce le superfici prevedibili e ad alto volume in cui il precalcolo è sia fattibile che ottimale. Il percorso B gestisce le superfici dinamiche e sensibili alla sessione in cui l'intento immediato dell'utente deve plasmare la risposta in tempo reale.
Percorso A — Raccomandazioni batch precalcolate (< ms a 2 cifre)
Il percorso A serve la maggior parte delle aree di raccomandazione: caroselli della homepage, classifiche delle pagine di categoria, campagne e-mail e notifiche push. Queste aree condividono una caratteristica comune: l'identità dell'utente e il tipo di area sono noti in anticipo, quindi i risultati possono essere calcolati in anticipo.
Un job batch notturno, orchestrato da Databricks Workflows, esegue l'intero funnel a 3 fasi offline per ogni utente attivo. Recupera gli embedding utente più recenti, esegue query ANN batch sull'indice degli articoli di AI Search per generare i candidati, assegna loro un punteggio con il modello LightGBM utilizzando le feature del livello Gold e applica le regole aziendali (punteggio dell'inventario, vicinanza della consegna, diversità, potenziamento promozionale). L'output (un elenco di prodotti classificati top-N per utente, in genere 50-100 articoli per area) viene scritto nelle tabelle online di Lakebase, indicizzato per ID utente e tipo di area.
Al momento del serving, l'app esegue una semplice ricerca chiave-valore: user_id + surface → elenco di prodotti classificati. Nessuna inferenza del modello, nessuna ricerca vettoriale, nessun assemblaggio di feature: solo una lettura diretta da Lakebase.
Poiché il job batch viene eseguito ogni notte, il Percorso A riflette i segnali e lo stato dell'inventario del giorno precedente. Per la maggior parte delle superfici questo livello di aggiornamento è più che sufficiente — le preferenze a lungo termine e le affinità con i brand si evolvono in giorni, non in minuti — e i nuovi prodotti che hanno ricevuto i loro embedding iniziali appariranno nei consigli entro 24 ore.
Percorso B — Scoring in tempo reale basato sulla sessione (< ms a 2 cifre)
Il Percorso B si attiva quando il contesto dei consigli esiste solo al momento della richiesta — "Articoli simili" nella pagina dei dettagli del prodotto, suggerimenti "Completa il look" o risultati di ricerca riordinati dinamicamente che si adattano durante la navigazione dell'utente.
L'app di e-commerce invia i segnali della sessione corrente — articoli visualizzati negli ultimi minuti, query di ricerca attive, contenuto del carrello e pattern di dwell-time — direttamente come payload della richiesta all'endpoint di Model Serving tramite REST API. L'endpoint esegue l'intero funnel a 3 fasi in modo sincrono all'interno di un singolo ciclo di richiesta-risposta:
- Fase 1 — Recupero dei candidati in tempo reale L'endpoint trasforma i segnali della sessione in un embedding della query — l'embedding dell'articolo del prodotto visualizzato o un embedding utente combinato che unisce il profilo delle preferenze a lungo termine (da Lakebase) con il comportamento all'interno della sessione, dando maggior peso ai segnali recenti. Questo embedding viene inviato a Databricks AI Search, che esegue un recupero ibrido: ricerca di similarità ANN combinata con filtri di metadati rigidi (idoneità della categoria, inventario regionale, soglie minime di stock). Gli articoli esauriti o non idonei non entrano mai nel set di candidati. AI Search restituisce 200–500 candidati in un singolo round-trip di rete. Per le superfici basate sulla sessione, l'endpoint calcola un embedding della query combinato — unendo l'embedding delle preferenze a lungo termine pre-calcolato dell'utente (recuperato da Lakebase) con un embedding di sessione derivato dagli articoli visualizzati di recente, ponderato verso i segnali recenti per catturare l'intento immediato. Questa combinazione è un calcolo leggero eseguito all'interno dell'endpoint, non una chiamata a un modello separato
- Fase 2 — Assemblaggio delle feature e scoring Gli ID degli articoli candidati attivano point lookup sulle tabelle online di Lakebase, recuperando feature utente pre-calcolate (aggregati comportamentali, segmento demografico, sensibilità al prezzo) e feature dell'articolo (tasso di conversione, punteggio di tendenza, giorni dalla pubblicazione). Le feature di contesto in tempo reale (ora del giorno, dispositivo, posizione, promozioni attive) sono derivate direttamente dal payload della richiesta. L'endpoint costruisce vettori di feature per ogni coppia utente-candidato — incluse le cross-feature come l'affinità utente-categoria e la sovrapposizione delle preferenze del brand — e le passa al modello di scoring LightGBM, che prevede la probabilità di conversione in una singola chiamata di inferenza batch senza risorse GPU.
- Fase 3 — Regole di business e re-ranking L'elenco con i punteggi passa attraverso un livello di re-ranking deterministico: lo scoring sensibile all'inventario riduce la priorità dello stock in esaurimento, lo scoring basato sulla prossimità di consegna favorisce i magazzini più vicini per un'evasione più rapida, l'iniezione di diversità impedisce la dominanza di brand o categorie nell'elenco finale e il boosting promozionale mette in evidenza gli articoli allineati con le campagne attive. L'elenco riordinato viene troncato alla dimensione richiesta (in genere 10–20 articoli) e restituito come risposta dell'API.
Le regole di business sono guidate dalla configurazione — i pesi promozionali, le soglie di diversità e i limiti di inventario vengono letti da una tabella di configurazione gestita al momento del serving, consentendo ai team commerciali di modificare le regole senza dover distribuire nuovamente il modello.
L'endpoint è implementato come un modello MLflow PyFunc personalizzato che orchestra internamente la pipeline multifase — interrogando AI Search, eseguendo lookup su Lakebase, eseguendo l'inferenza LightGBM e applicando le regole di business all'interno di una singola chiamata predict().
Una strategia di fallback garantisce la resilienza: se il percorso in tempo reale supera il budget di latenza, il sistema degrada gradualmente per servire articoli popolari memorizzati nella cache o i consigli pre-calcolati dell'utente dal Percorso A.
Gestione del problema del cold start
Ogni sistema di raccomandazione deve affrontare due scenari di cold start:
Nuovi utenti (nessuna cronologia di navigazione): Quando un utente arriva per la prima volta, il sistema costruisce un embedding utente predefinito a partire dai segnali demografici disponibili — posizione, tipo di dispositivo, contesto di registrazione ed eventuali preferenze dichiarate. Questo embedding viene utilizzato per la ricerca ANN nell'indice degli articoli, inserendo efficacemente il nuovo utente all'interno di un cluster comportamentale con caratteristiche demografiche simili. Man mano che l'utente interagisce, il suo embedding converge rapidamente verso le sue reali preferenze.
Nuovi prodotti (nessun dato di interazione): Quando un nuovo SKU entra nel catalogo, il sistema genera un embedding dell'articolo a partire dai suoi attributi — titolo, categoria, brand, fascia di prezzo e feature visive estratte dalle immagini del prodotto. Questo embedding viene utilizzato per trovare articoli esistenti simili nello spazio vettoriale, e il nuovo prodotto eredita i punteggi di raccomandazione iniziali dai suoi vicini più prossimi. I nuovi prodotti appaiono nei consigli al ciclo batch giornaliero successivo.
Ciclo di vita del modello e miglioramento continuo
I modelli vengono riaddestrati settimanalmente utilizzando Databricks Workflows, con il tracciamento degli esperimenti e il controllo delle versioni gestiti tramite MLflow. La piattaforma supporta la distribuzione champion/challenger — le nuove versioni del modello vengono distribuite insieme al modello di produzione, con il traffico che viene gradualmente spostato in base alle metriche di prestazioni online.
Le principali metriche ML monitorate includono:
- AUC-ROC — misura la capacità del modello di scoring di distinguere tra gli articoli con cui un utente interagirà e quelli con cui non lo farà
- NDCG@K (Normalized Discounted Cumulative Gain) — valuta se gli articoli più rilevanti appaiono in cima all'elenco ordinato
- Recall@K — misura quale frazione di articoli rilevanti viene recuperata con successo dalla fase di generazione dei candidati
- Log Loss — traccia la calibrazione delle previsioni, garantendo che i punteggi di probabilità di conversione rimangano ben calibrati nel tempo
Queste metriche del modello sono integrate dai KPI aziendali — click-through rate, tasso di conversione e ricavi per sessione — che fungono da convalida definitiva del fatto che i miglioramenti del modello si traducano in un impatto reale.
Il rilevamento automatico del drift segnala quando le distribuzioni delle feature o le distribuzioni dei punteggi di previsione deviano dalle baseline, avviando un'indagine o un riaddestramento accelerato. I log di serving vengono correlati alle pipeline di addestramento tramite identificatori a livello di richiesta, garantendo che il ciclo di feedback produca dati di addestramento puliti e privi di leakage per l'iterazione successiva del modello. Le tecniche di addestramento sensibili alla posizione garantiscono che il modello apprenda le reali preferenze dell'utente anziché gli artefatti della posizione di visualizzazione.
Risultati attesi
Questa architettura consente:
- risposte personalizzate nell'ordine di ms a 2 cifre su scala, soddisfacendo le aspettative di prestazioni dei moderni acquirenti orientati al mobile
- Consigli aggiornati quotidianamente che riflettono l'ultimo inventario, i prodotti di tendenza e l'evoluzione delle preferenze degli utenti
- Governance unificata dal clickstream grezzo alle previsioni in produzione, con lineage completa e controllo degli accessi tramite Unity Catalog
- Sperimentazione rapida — le nuove varianti del modello possono essere addestrate, valutate e distribuite in pochi giorni anziché in mesi
- Semplicità operativa — un'unica piattaforma sostituisce il mosaico di sistemi separati per l'ingestione, la feature engineering, l'addestramento e il serving
- Scalabilità fluida — da migliaia a milioni di utenti senza dover riprogettare l'architettura, sfruttando il calcolo serverless e l'infrastruttura gestita
Conclusione
La creazione di un motore di raccomandazione e ranking di livello di produzione non richiede più l'unione di una dozzina di sistemi specializzati. Unificando l'ingestione in tempo reale (Zerobus), la gestione delle feature (Feature Store + Lakebase), l'addestramento dei modelli (MLflow + Workflows), il recupero vettoriale (AI Search) e il serving a bassa latenza (Model Serving) su un'unica piattaforma governata, i team di e-commerce possono concentrarsi su ciò che conta davvero: comprendere i propri clienti e offrire il prodotto giusto al momento giusto.
Il risultato non è solo un motore di raccomandazione — è una piattaforma di personalizzazione completa e pronta per la produzione che può fungere da spina dorsale intelligente di qualsiasi esperienza di e-commerce.
Vuoi creare il tuo? Esplora i Databricks Recommendation Engine Solution Accelerators, approfondisci la documentazione di AI Search o contatta il team del tuo account Databricks per un workshop sull'architettura.
(Questo post sul blog è stato tradotto utilizzando strumenti basati sull'intelligenza artificiale) Post originale
Ricevi gli ultimi articoli nella tua casella di posta
Iscriviti al nostro blog e ricevi gli ultimi articoli direttamente nella tua casella di posta.