"Regex per le righe": semplificare il rilevamento dei pattern in SQL con MATCH_RECOGNIZE
Usa MATCH_RECOGNIZE ogni volta che una sequenza è importante, dai trend del mercato azionario ai guasti dei sensori e altro ancora.
- MATCH_RECOGNIZE è un nuovo operatore SQL, disponibile in Public Preview, che consente di rilevare pattern e sequenze dai dati degli eventi.
- MATCH_RECOGNIZE utilizza un pattern matching simile alle regex.
- MATCH_RECOGNIZE è estremamente utile in molti settori, tra cui: servizi finanziari, cybersecurity, e-commerce e produzione/IoT
Immagina di lavorare nella cybersecurity e di avere una tabella che traccia i tentativi di accesso. Questa tabella include ogni tentativo di accesso come riuscito o non riuscito e il momento in cui è avvenuto. Desideri individuare pattern di accesso insoliti, quindi potresti chiederti: "quali utenti hanno registrato fallimenti di accesso consecutivi, seguiti da un successo?". Trovare questo tipo di attività sospetta con l'SQL standard è complicato. L'SQL tratta le righe come insiemi disordinati di fatti senza una sequenza temporale e non esiste un concetto intrinseco di sequenza di eventi.
Potresti contare i tentativi di accesso falliti per utente, ma i conteggi non ti aiutano a capire se questi tentativi sono avvenuti in un intervallo di tempo ristretto o distribuiti nell'arco di un mese; inoltre, non possono dirti se un accesso riuscito è avvenuto subito dopo i fallimenti. Per farlo in SQL, finirai per scrivere una query complessa che concatena più espressioni di tabella comuni (CTE), ancorando la finestra temporale al primo fallimento e controllando poi ogni riga successiva.
MATCH_RECOGNIZE semplifica tutto questo. Ora disponibile nell'elaborazione Databricks (incluso Lakehouse Real-Time), MATCH_RECOGNIZE ti consente di descrivere direttamente la sequenza che ti interessa, come una regular expression per le righe. Una singola clausola SQL ora gestisce il pattern matching, eliminando query SQL eccessivamente complicate basate sulla logica "gaps and islands" (intervalli e isole).
Vediamo alcuni esempi specifici di settore su come MATCH_RECOGNIZE semplifica il rilevamento delle sequenze in diversi ambiti.
Cybersecurity: identificare anomalie di accesso sospette

Se stai cercando attacchi di credential stuffing nei log di autorizzazione, il semplice conteggio dei tentativi di accesso può portare a falsi positivi. In particolare, devi rilevare picchi ad alta frequenza, come 5 o più tentativi di accesso falliti entro una specifica finestra temporale ristretta, seguiti immediatamente da un accesso riuscito.
Le funzioni finestra standard COUNT() OVER (PARTITION BY user_id ORDER BY event_time) possono dirti quanti fallimenti si sono verificati in un intervallo di tempo, ma non possono facilmente ancorare una finestra temporale scorrevole al primo fallimento di una sequenza specifica, né possono isolare chiaramente la sequenza una volta che si verifica un successo.
Con MATCH_RECOGNIZE, puoi utilizzare FIRST(FAIL.event_time) direttamente all'interno del blocco DEFINE per ancorare il timestamp del tentativo fallito iniziale. Ogni evento FAIL successivo viene controllato dinamicamente per garantire che rientri entro 1 ora dal primo tentativo prima di passare allo stato SUCCESS.
Analisi finanziaria: rilevamento di trend azionari a forma di V
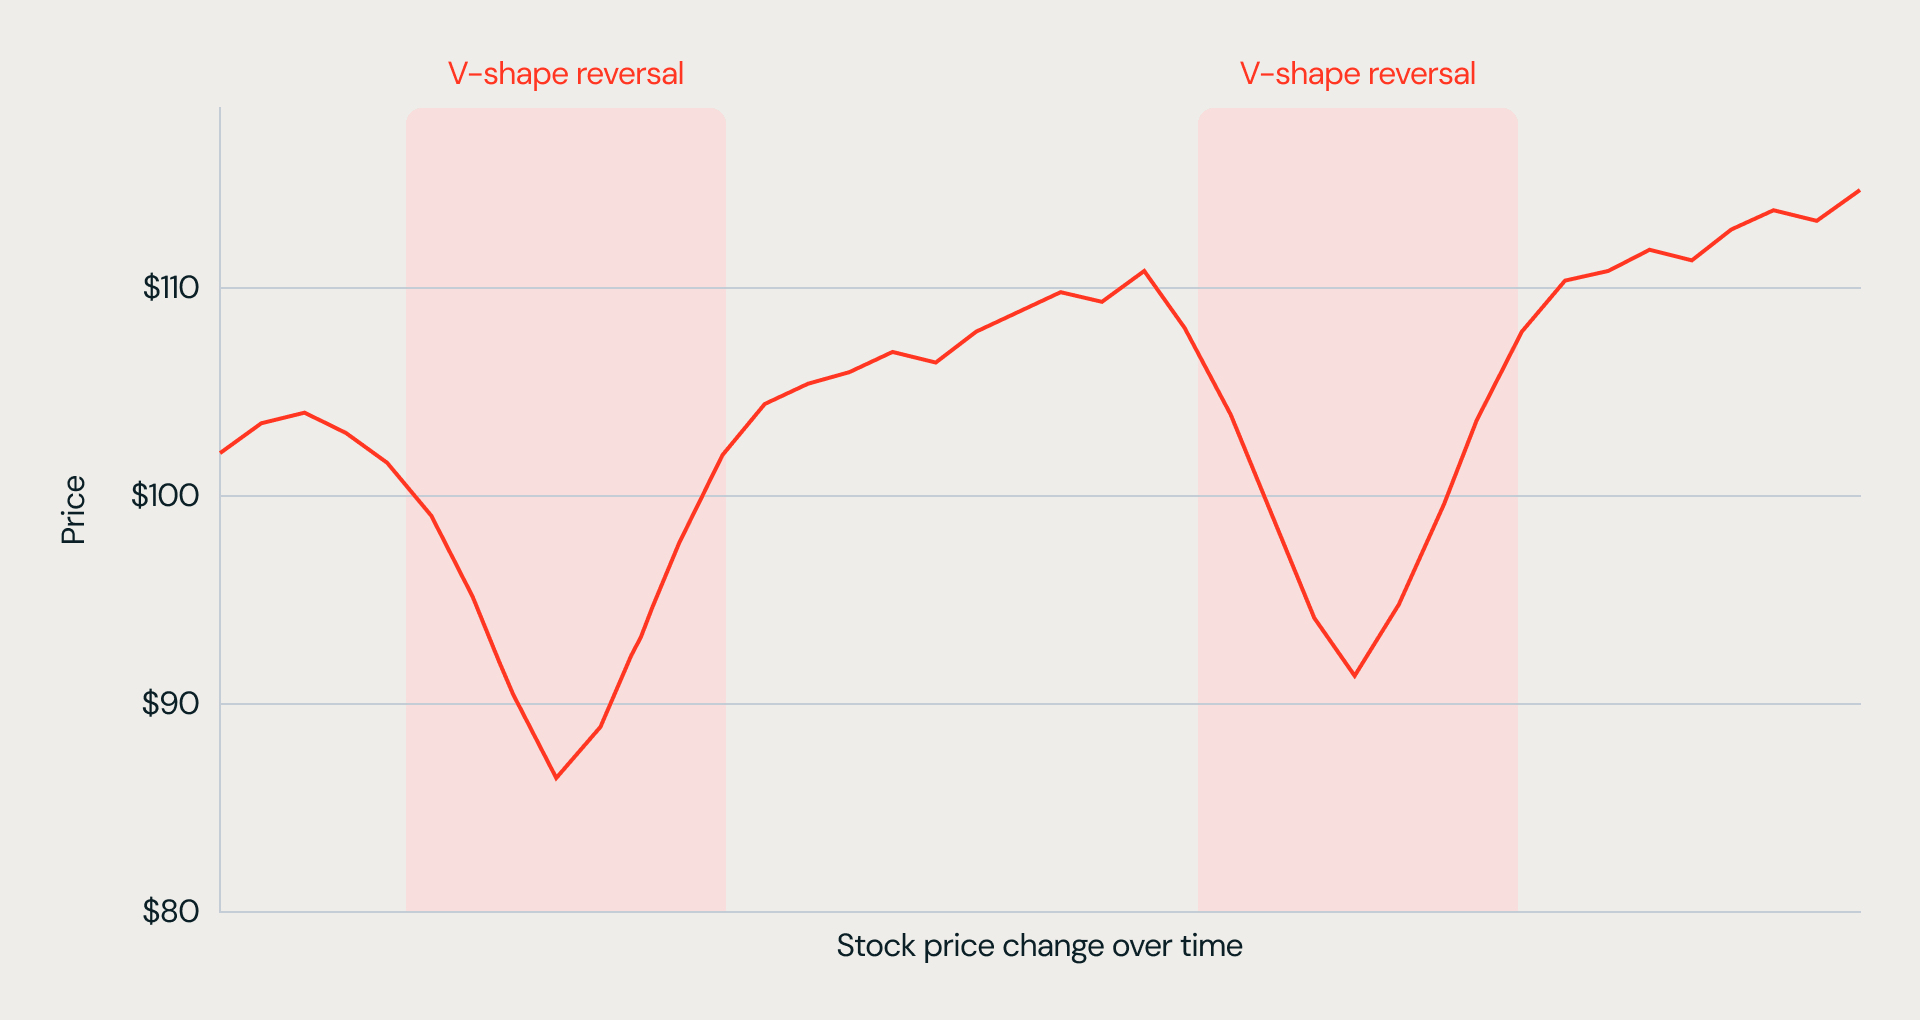
Ogni analista di dati di mercato si interessa alle inversioni di prezzo, ovvero ai momenti in cui un titolo perde valore e poi improvvisamente inizia a recuperarlo. Questa forma è nota come "V-shape" (forma a V) e trovarla in SQL standard significa ricorrere a una tecnica chiamata "gaps and islands": poiché l'SQL non ha una nozione nativa di trend, devi prima suddividere manualmente le righe in "isole" (tratti consecutivi in cui il prezzo si muove nella stessa direzione) prima ancora di poterti chiedere dove inizia e finisce una forma a V.
In pratica, ciò significa utilizzare LAG e LEAD per confrontare ogni riga con quelle adiacenti, creando un contatore cumulativo che si incrementa ogni volta che la direzione si inverte (in modo da avere un ID di gruppo per ogni isola), e poi scrivere filtri HAVING per confermare la forma e i confini di ciascuna isola. È una struttura complessa solo per rispondere a una domanda semplice: "dove è sceso il prezzo per poi recuperare?"
La clausola MATCH_RECOGNIZE elimina la necessità di questa complessa struttura. Ti basta partizionare i dati per simbolo, ordinarli per tempo e definire la forma del trend a V come una sequenza di stati simili a espressioni regolari.
E-Commerce: rilevamento dell'abbandono del carrello

I product manager vogliono individuare gli utenti con un forte intento di acquisto, ma che non completano mai la transazione. Gli utenti che dimostrano un reale intento di acquisto, ma che poi spariscono, rappresentano un segnale prezioso. Identificare questo gruppo di utenti può aiutare a: determinare a quali utenti inviare un promemoria, misurare facilmente l'opportunità e quale percentuale sia recuperabile con azioni di follow-up e, come punto di confronto con altri utenti di questa coorte, scoprire nuovi insight (ad esempio, se un determinato prodotto ha un prezzo troppo alto). Un funnel di conversione fallito ad alto valore traccia gli utenti che hanno:
- Visualizzato la pagina di un prodotto due o più volte (VIEW 2 o più volte, indicando un forte interesse)
- Aggiunto l'articolo al carrello (ADD_TO_CART)
- Infine abbandonato la sessione (utilizzando un filtro temporale)
L'ultimo passaggio non si basa su un valore, ma su un intervallo di tempo basato sull'attività dell'utente. Non esiste una riga di "abbandono" da associare o un "errore di check-out", l'utente semplicemente si ferma. Nel SQL tradizionale, per dimostrare una negazione si ricorre a sottoquery NOT EXISTS, self-join e funzioni finestra per mostrare che non è successo nulla dopo l'aggiunta degli articoli al carrello e che è trascorso abbastanza tempo di inattività per considerare il carrello abbandonato.
MATCH_RECOGNIZE esprime direttamente il concetto "non è successo nulla dopo questo" con l'ancora di fine partizione $, che impone che l'aggiunta al carrello sia l'ultimo evento registrato nella sessione. Aggiungi un filtro temporale per la finestra di inattività e otterrai una regola di abbandono basata sul timeout senza self-join.
Produzione / IoT: prevedere i guasti delle apparecchiature dai dati dei sensori

La manutenzione predittiva si basa sull'individuazione di tendenze e pattern. In qualsiasi macchina in uso, la temperatura interna tende ad aumentare, ma una sequenza di aumento costante della temperatura, seguita da un picco di vibrazioni, potrebbe segnalare un guasto imminente.
L'SQL tradizionale richiede confronti riga per riga continui per cercare di rilevare una tendenza pericolosa. MATCH_RECOGNIZE gestisce la logica riga per riga in modo nativo. All'interno della clausola DEFINE è possibile utilizzare le funzioni PREV e NEXT (che funzionano in modo simile a LAG e LEAD). Ciò significa che impostare una regola per l'aumento della temperatura è semplice come scrivere temperature > PREV(temperature).
Prova Match Recognize su Lakehouse oggi stesso
Ora è più facile che mai scoprire pattern nei dati e semplificare l'analisi delle sequenze di eventi. MATCH_RECOGNIZE consente di scrivere meno codice per il pattern matching in modo logico. Questa clausola è più facile da convalidare, più facile da gestire e semplice da aggiornare.
- Esplora la documentazione: Approfondisci la documentazione ufficiale di riferimento SQL per saperne di più su sintassi avanzata dei pattern, quantificatori e aggregati di misura.
- Provalo nel tuo workspace: Testa gli esempi sopra riportati sui tuoi flussi di log, sessioni di clickstream o telemetria di serie temporali in Databricks SQL o Lakehouse//RT.
- Migra le pipeline legacy: Identifica le tue CTE di self-join e window function più complesse e lascia che Genie Code ti aiuti a riscriverle con query MATCH_RECOGNIZE più semplici.
Il miglior data warehouse è un Lakehouse. Le nostre funzionalità native continuano a espandersi e ti consentono di eseguire analisi più potenti su un'unica piattaforma unificata.
(Questo post sul blog è stato tradotto utilizzando strumenti basati sull'intelligenza artificiale) Post originale
Ricevi gli ultimi articoli nella tua casella di posta
Iscriviti al nostro blog e ricevi gli ultimi articoli direttamente nella tua casella di posta.