Esegui, esegui il debug e scala i carichi di lavoro Databricks dal tuo IDE locale
Connetti il tuo editor locale o la CLI alle risorse di calcolo Databricks, all'area di lavoro e a Unity Catalog per uno sviluppo fluido di data engineering e ML.
- Esegui in modo interattivo ed esegui il debug dei carichi di lavoro Databricks dal tuo IDE: connettiti a Serverless, AI Runtime e cluster dedicati.
- Riduci al minimo i passaggi all'area di lavoro: sfoglia Unity Catalog e modifica i file dell'area di lavoro direttamente dall'IDE.
- Gestisci un unico ambiente tra l'IDE e l'area di lavoro: i tuoi file e le dipendenze del progetto sono sempre sincronizzati.
L'area di lavoro Databricks è creata appositamente per l'analisi dei dati e la data engineering. Tuttavia, potresti preferire l'uso di IDE locali e della CLI per sfruttare i tuoi strumenti e agenti di codifica come Cursor, Copilot e Claude Code. Questo è particolarmente vero quando si sviluppano pipeline complesse su larga scala o modelli di machine learning.
Fino ad ora, l'estensione Databricks per Visual Studio e Cursor e Databricks Connect consentivano lo sviluppo Spark locale utilizzando le risorse di calcolo Databricks. Ma l'esecuzione remota di carichi di lavoro non Spark e il mantenimento delle dipendenze sincronizzate con Databricks Runtime rimanevano punti critici comuni.
Ora stiamo colmando queste lacune. Con i nostri ultimi aggiornamenti all'esperienza IDE, ora puoi connettere VS Code, Cursor o il tuo terminale direttamente alle risorse di calcolo Databricks. Esegui, esegui il debug e scala i carichi di lavoro Python e SQL su un'infrastruttura cluster reale, mantenendo al contempo tutta l'ergonomia del tuo IDE.
Esecuzione remota senza compromessi
Utilizzando il nostro nuovo tunnel SSH (vedi la documentazione), puoi connettere il tuo editor locale o la CLI a Serverless, AI Runtime e cluster dedicati:
Esegui in modo interattivo ed esegui il debug dei file dell'area di lavoro e dei notebook da VS Code, Cursor o dalla CLI.
Usa lo stesso ambiente tra l'IDE e l'area di lavoro: le tue dipendenze e i tuoi file sono sempre sincronizzati con Databricks Runtime e l'area di lavoro.
Sfrutta gli agenti di codifica nel tunnel SSH in modo che abbiano il contesto completo dell'area di lavoro e lavorino con Databricks in modo più efficace. Cursor e Copilot funzionano fin da subito, mentre altri agenti come Claude Code possono essere installati quando il tunnel SSH è attivo.
Iniziare è semplice. Puoi connetterti al tunnel SSH con un singolo comando utilizzando la Databricks CLI:
databricks ssh connectper connetterti a serverless.databricks ssh connect --accelerator <GPU_type>per connetterti ad AI Runtime, dove il tipo di GPU può essere (GPU_1xA10 o GPU_8xH100).databricks ssh connect --cluster <cluster_id>per connetterti a un cluster dedicato.
Puoi anche avviare il tunnel SSH in un IDE includendo --ide vscode o --ide cursor come flag aggiuntivo.
In alternativa, puoi avviare il tunnel SSH direttamente dalla versione più recente dell'estensione IDE.
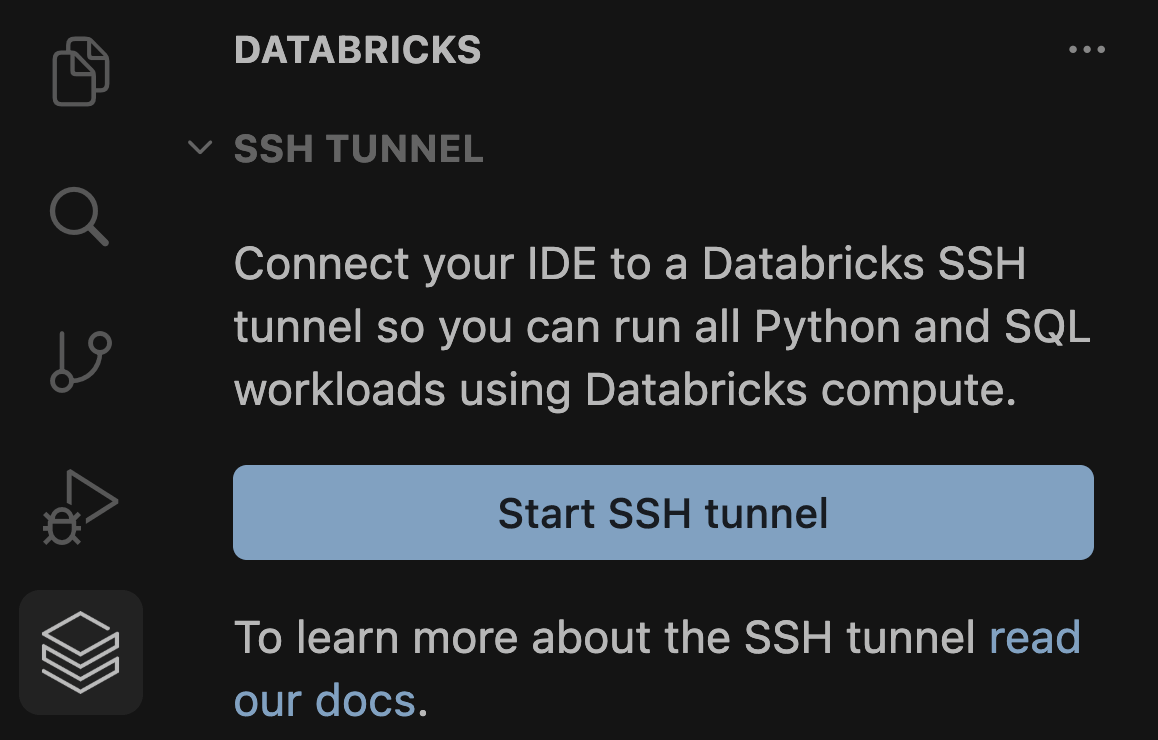
Abbiamo incluso anche altre funzionalità che rendono più facile utilizzare la CLI e l'IDE come ambiente di lavoro principale:
- Gestisci le dipendenze del progetto (documentazione): Specifica un ambiente di base dell'area di lavoro con il flag
--base-environmentper avviare il tuo tunnel SSH con le dipendenze Python preinstallate. vedi - Monitora l'utilizzo e i costi (documentazione): Associa una policy di utilizzo serverless con il flag
--usage-policy-idper tracciare i costi del tunnel SSH per utente, team o progetto. - Esplora i tuoi data asset utilizzando Unity Catalog dall'IDE (documentazione): Sfoglia cataloghi, schemi e tutti i tuoi data asset senza dover passare all'area di lavoro nel bel mezzo del tuo flusso di sviluppo.
Per tutti i dettagli sulla connessione al tunnel SSH, consulta la documentazione qui.
Novità in arrivo
- Unity AI Gateway verrà configurato automaticamente per gli utenti del tunnel SSH, consentendoti di gestire l'accesso e la spesa per ogni agente, strumento, modello e MCP.
- L'estensione IDE esistente verrà integrata nel tunnel SSH, consentendoti di distribuire e gestire i Declarative Automation Bundles da un'interfaccia utente nell'IDE.
- Le dipendenze non Python e le immagini Docker personalizzate saranno configurabili all'avvio del tunnel SSH, consentendoti di assumere il pieno controllo del tuo ambiente.
Conclusione
Con queste funzionalità puoi sviluppare dall'ambiente che preferisci, operando al contempo all'avanguardia della data engineering e della ML engineering. Indirizza il tuo IDE e i tuoi agenti verso Databricks, esegui il codice ed effettua il debug su risorse di calcolo reali e mantieni un ciclo di sviluppo rapido.
Scopri di più + Prossimi passi
Per iniziare a usare gli strumenti di sviluppo presentati nel blog, consulta la seguente documentazione:
- 'Tunnel SSH' (AWS | Azure | GCP)
Connettiti alle risorse di calcolo Databricks per eseguire in modo interattivo carichi di lavoro Python e SQL dall'IDE o dalla CLI, mantenendo al sicuro tutto il codice e i dati all'interno della tua area di lavoro Databricks. - 'Estensione IDE' (AWS | Azure | GCP)
Lavora con i file locali e definisci, distribuisci ed esegui i Declarative Automation Bundles utilizzando un'interfaccia utente nell'IDE. - 'Databricks Connect' (AWS | Azure | GCP)
Connetti il tuo ambiente di sviluppo locale alle risorse di calcolo Databricks per eseguire da remoto carichi di lavoro Spark. - 'Unity AI Gateway' (AWS | Azure | GCP)
Controlla quali servizi AI possono utilizzare i team, instrada e gestisci il traffico AI, imposta guardrail e monitora l'utilizzo da un unico piano di controllo.
Per capire quali strumenti si adattano meglio alle tue esigenze, vedi Connettersi dal proprio IDE.
(Questo post sul blog è stato tradotto utilizzando strumenti basati sull'intelligenza artificiale) Post originale
Ricevi gli ultimi articoli nella tua casella di posta
Iscriviti al nostro blog e ricevi gli ultimi articoli direttamente nella tua casella di posta.