Scalabilità e gestione di un grande progetto dbt su Databricks: il team dati di IFCO parla di prestazioni, visibilità e debugging
- Ottimizza i modelli incrementali dbt in modo che ogni esecuzione scriva solo le righe modificate, utilizzando il liquid clustering, una strategia di merge mirata e il dynamic file pruning. Questo ha ridotto il tempo di esecuzione del job principale di IFCO di oltre il 60% ed eliminato il full refresh notturno.
- Diagnostica i modelli lenti dal piano di esecuzione effettivo della query, non dal codice SQL compilato, poiché è lì che emergono le vere cause. IFCO ha strutturato questa diagnostica in una procedura ripetibile eseguita su ogni modello.
- Esegui il progetto dbt come un singolo task per modello su Databricks Jobs con lo strumento open-source databricks-dbt-factory, anziché come un unico job opaco. Questo offre visibilità per singolo modello, riesecuzioni mirate e test obbligatori.
Abstract
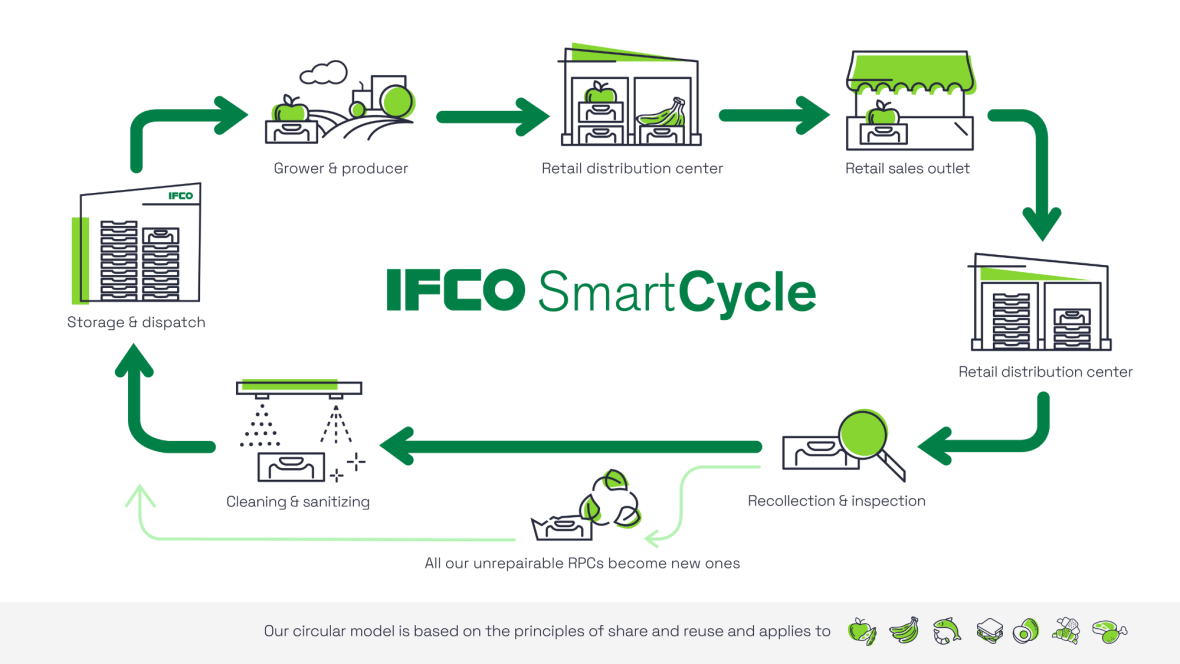
IFCO gestisce uno dei pool di imballaggi riutilizzabili più grandi al mondo, con centinaia di milioni di casse e pallet. Con oltre 2.000 dipendenti in tutto il mondo, IFCO impiega più di 350 persone in Germania, la maggior parte delle quali lavora presso la sede centrale globale a Pullach, vicino a Monaco. L'attività consiste in un servizio di pooling circolare: i contenitori di plastica riutilizzabili (RPC) trasportano i prodotti freschi dai coltivatori e confezionatori ai centri di distribuzione e ai rivenditori, per poi tornare ai Service Center di IFCO per essere lavati, selezionati e spediti nuovamente, in oltre 50 paesi.
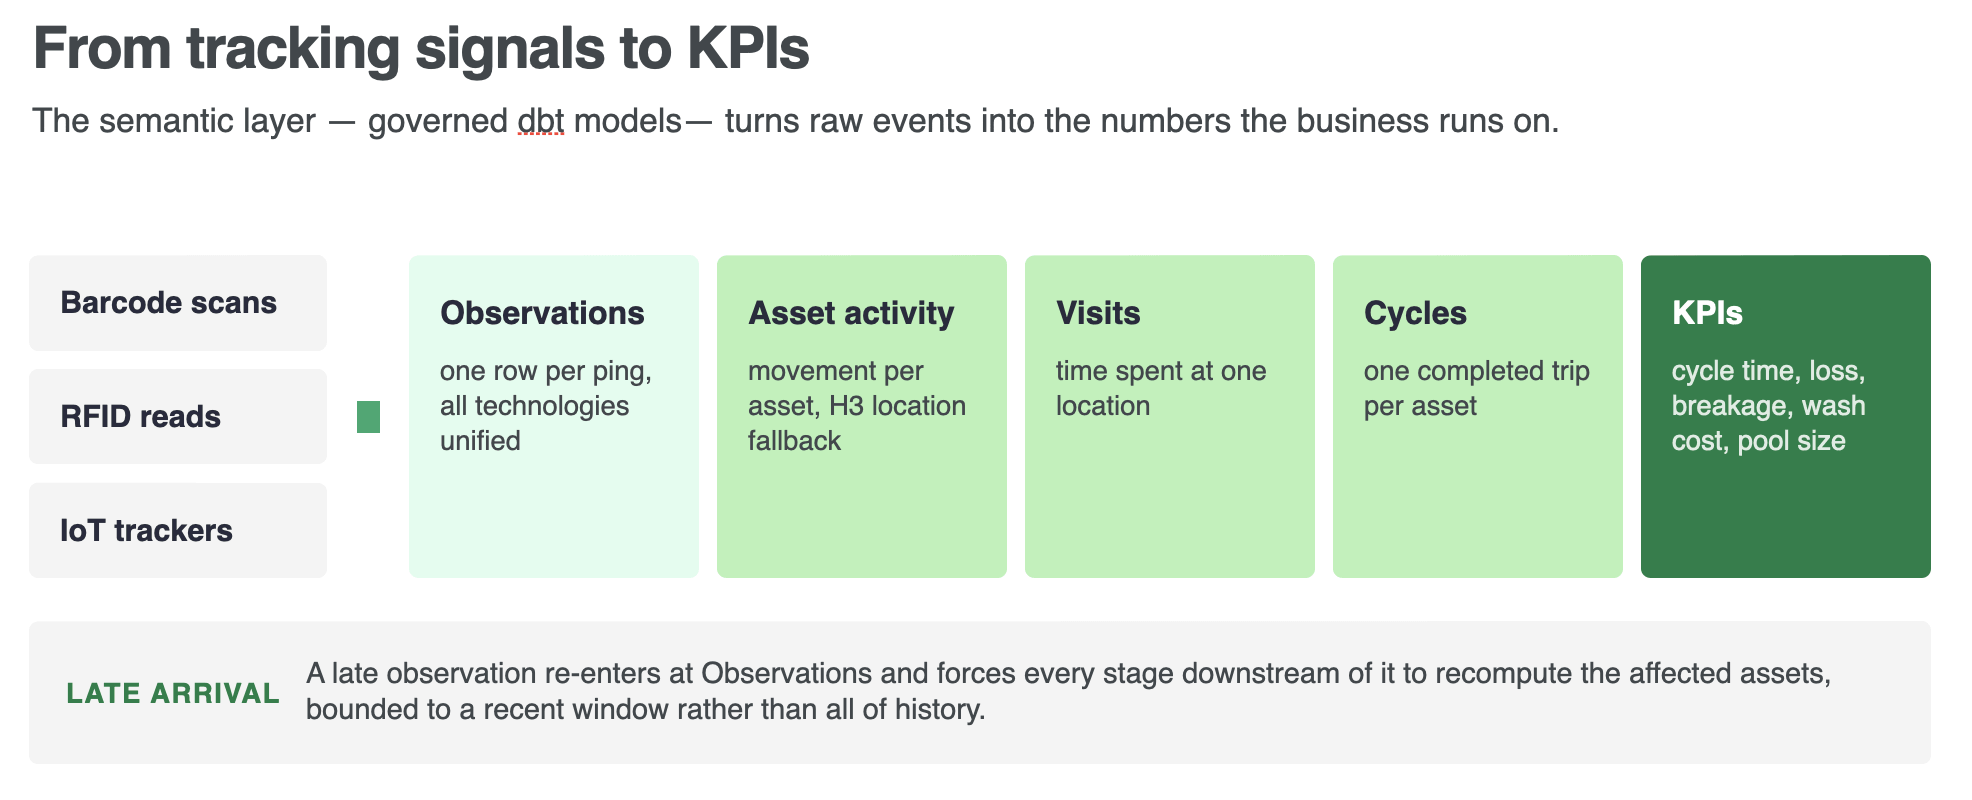
Ogni cassa e pallet viene tracciato lungo il suo ciclo di vita, alimentando i KPI su cui si basa l'attività: tempo di ciclo, perdite, rotture, costi di lavaggio e dimensioni del pool. Trasformare miliardi di eventi di tracciamento grezzi in KPI affidabili è difficile per tre motivi: la quantità di dati è enorme, alcuni arrivano in ritardo in modi difficili da prevedere e, quando ciò accade, la pipeline è costretta a correggere lo storico già segnalato.
Questo post mostra come il team della piattaforma dati di IFCO, in collaborazione con il team Forward Deployed Engineering di Databricks, ha reso tale pipeline più rapida ed economica. La logica di trasformazione rimane in dbt. Viene eseguita su Databricks, dove ogni impostazione incrementale si mappa su un comportamento di scrittura concreto di Delta Lake: quali colonne raggruppano (cluster) i dati, quanta parte della tabella di destinazione deve essere interessata da una scrittura e se le righe vengono unite (merge) o sostituite. Configurare correttamente queste impostazioni, con la giusta granularità dei dati, ha ridotto il tempo di esecuzione giornaliero del job del semantic layer principale di oltre il 60% e ha permesso a IFCO di eliminare un costoso processo di full refresh notturno.
IFCO e la natura del problema dei dati
Una cassa viene prelevata, riempita, spedita, restituita, lavata e riutilizzata molte volte all'anno, quindi IFCO deve sapere dove si trova ogni asset e cosa gli è successo. IFCO ha introdotto un semantic layer, che unisce molti segnali di tracciamento diversi in un'unica vista governata dell'attività degli asset: scansioni di codici a barre al passaggio delle casse sulla linea di lavaggio, letture RFID alle porte di carico e tracker alimentati a batteria che segnalano la posizione GPS, i beacon Bluetooth vicini e la temperatura. (In questo post, per "semantic layer" si intendono questi modelli dbt governati che trasformano gli eventi di tracciamento grezzi in KPI aziendali). Tre proprietà rendono questo compito difficile.
- Scala. Ogni giorno affluiscono miliardi di eventi di tracciamento. Il consolidamento raggruppa i ping ripetuti di ciascun asset in un numero molto inferiore di righe di attività, ma le tabelle lette dai KPI sono comunque così grandi che ricostruirle da zero è costoso.
- Arrivi tardivi imprevedibili. La maggior parte delle osservazioni arriva entro una finestra temporale prevista, ma alcuni feed registrano ritardi di settimane e alcuni di mesi, senza una pianificazione fissa. Una pipeline che presuppone che i dati odierni rappresentino il quadro completo di ciò che è accaduto ieri riporterà silenziosamente uno storico errato.
- Riconciliazione dello storico. L'attività degli asset è una sequenza, quindi un'osservazione tardiva non si limita a colmare una lacuna. Se si inserisce una scansione a metà della cronologia di un asset, cambia ciò che la pipeline ha già dedotto per tutto ciò che segue: dove è andato l'asset successivamente, quando è iniziato il suo ciclo, in quale categoria di KPI è rientrato. Un arrivo tardivo costringe quindi la pipeline a ricalcolare lo stato che ha già pubblicato, anziché limitarsi ad aggiungere una nuova riga. L'obiettivo è generare rapidamente una stima accurata e farla convergere verso la realtà man mano che arrivano i dati tardivi, senza rielaborare tutto ogni notte.
Elaborazione incrementale su scala
Un modello incrementale dbt è, sotto la scocca, un insieme di comportamenti di lettura e scrittura Delta, e la maggior parte del vantaggio deriva da un unico principio: fare in modo che ogni esecuzione tocchi il minor numero possibile di righe e le riduca il prima possibile. La prima e più importante leva è la lettura stessa, che scansiona solo i file e gli asset modificati effettivamente necessari per un'esecuzione, poiché ogni riga che si evita di leggere è una riga che non raggiungerà mai le costose operazioni di ordinamento (sort), riorganizzazione (shuffle) e scrittura per asset a valle. Ciascuna delle tecniche descritte di seguito è una normale configurazione dbt che si traduce in uno specifico comportamento Delta.
Esegui il clustering sulle colonne utilizzate per filtrare e unire (join). Il Liquid clustering, basato sulla granularità con cui viene interrogato ciascun modello (per l'attività degli asset, l'asset e la data dell'evento), consente al motore di saltare i file anziché scansionarli. È ciò che permette il funzionamento delle due tecniche successive.
Scegli deliberatamente la strategia incrementale. La strategia determina il modo in cui ogni esecuzione scrive, e la scelta deriva da due domande: ogni riga ha una chiave stabile e stai aggiornando le righe in loco o sostituendo un gruppo di esse contemporaneamente? Per gli upsert con chiave e ad alta densità di deduplicazione, il merge è l'opzione predefinita. Basato sulla granularità reale (per l'attività degli asset, asset_id e event_date_time) esegue due operazioni che un'eliminazione e reinserimento massivo (bulk delete-and-reinsert) non può fare:
Il predicato equi-join attiva il dynamic file pruning (potatura dinamica dei file): i valori chiave nel batch in entrata saltano i file di destinazione che non possono contenere una corrispondenza, in modo che la scrittura interessi solo la porzione che viene modificata. (DBT_INTERNAL_DEST and DBT_INTERNAL_SOURCE sono gli alias di dbt per la tabella di destinazione e il batch in entrata nell'istruzione generata.) Il clustering sulle stesse chiavi su cui si basa il merge mantiene precisa tale potatura. Un controllo sull'hash della riga, un matched_condition che confronta un hash surrogato di ciascuna riga, evita quindi di riscrivere le righe che non sono effettivamente cambiate, risparmiando scritture e mantenendo pulito il feed delle modifiche a valle.
delete+insert è l'alternativa: elimina un intero gruppo di righe per chiave e lo reinserisce. Questo è più semplice quando un'esecuzione ricalcola un gruppo come un'unica unità e le righe non hanno un'identità stabile su cui effettuare la corrispondenza, al costo di riscrivere il gruppo anche dove nulla è cambiato. Con volumi molto elevati, vale la pena effettuare un benchmark di entrambe le opzioni anziché fare supposizioni.
Limita la scrittura a una finestra recente. Lo stesso meccanismo dei predicati ha un secondo utilizzo. Invece di un equi-join per il file pruning, un limite temporale limita la scrittura ai dati recenti, in modo che sui modelli a monte con volumi più elevati il MERGE corrisponda a una porzione recente della destinazione anziché all'intera tabella:
Poiché il predicato si basa su quando una riga è stata inserita (ingested) e non su quando si è verificato l'evento, anche un evento vecchio di mesi viene comunque intercettato, purché sia arrivato di recente. La finestra deve solo essere sufficientemente ampia da coprire l'intervallo tra l'arrivo dei dati e l'elaborazione da parte di questo job. Se impostata su un valore troppo stretto, i dati tardivi verranno saltati silenziosamente: non si verificherà alcun errore, semplicemente non verranno mai elaborati.
Ricalcola solo ciò che è cambiato. I modelli limitano il loro raggio d'azione agli asset interessati da dati nuovi o tardivi, identificati da un watermark di inserimento, e leggono una finestra più ampia di quella che scrivono, in modo che gli eventi tardivi vengano acquisiti senza un full refresh.
Mantieni Delta ordinato. Le tabelle incrementali pesanti attivano le scritture ottimizzate e l'auto-compattazione, oppure affidano la manutenzione delle tabelle a Predictive Optimization, in modo che i merge frequenti non lascino un sovraccarico di lettura dovuto a file di piccole dimensioni.
La disciplina consiste nell'applicare queste impostazioni sulla giusta granularità per poi confermare, dal piano di query effettivo, che il motore esegua davvero il pruning anziché una scansione silenziosa.
Un esempio pratico: consolidare le osservazioni nell'attività degli asset
Il modello più attivo nel semantic layer è quello che consolida le osservazioni provenienti da ogni tecnologia di tracciamento in un unico flusso sensibile alla posizione per ciascun asset. Determina quando un asset si è effettivamente spostato utilizzando funzioni finestra partizionate per asset e ordinate per ora dell'evento. Quando un'osservazione non contiene una posizione esplicita, ricorre alle funzioni H3 integrate di Databricks SQL, che mappano ogni latitudine/longitudine su una cella di griglia esagonale, in modo che "stesso posto" diventi un semplice confronto tra ID di cella e la loro distanza sulla griglia, anziché ripetuti calcoli matematici sulla distanza geografica. Era, con un ampio margine, il singolo elemento che consumava più tempo di esecuzione.
La prima mossa non è stata quella di ottimizzare, ma di vedere cosa fosse effettivamente in esecuzione, e questa distinzione è importante. dbt compile esegue il rendering del SELECT di un modello con i relativi riferimenti risolti, ma per un modello incrementale questa non è l'istruzione eseguita da Databricks. Dietro a quel SELECT compilato, dbt genera ed esegue un'operazione più ampia: viste temporanee, scansioni della tabella di destinazione e la scrittura finale sulla tabella. L'unico modo per scoprire dove finiscono tempo e memoria è leggere il piano di query effettivamente eseguito, fase per fase, dalla cronologia delle query, non dal codice SQL compilato.
Letto in questo modo, il piano era impietoso. Il modello scansionava miliardi di righe, riversando (spilling) centinaia di gigabyte su disco e trascorrendo circa l'85% del tempo in un singolo ordinamento (sort) e riorganizzazione (shuffle) della finestra per asset. In effetti, ricostruiva l'intera tabella a ogni esecuzione. Tre fattori hanno causato questo comportamento:
- L'insieme di asset "modificati" non si riduceva mai. Un timestamp a monte veniva rigenerato a ogni esecuzione invece di essere propagato dalla sorgente, quindi quasi tutti gli asset sembravano nuovi. Quando tutto sembra modificato, un'esecuzione incrementale si trasforma silenziosamente in un full refresh.
- Il ricalcolo per singolo asset non aveva limiti. Le window function analizzavano a ritroso l'intera cronologia di ciascun asset, quindi anche un insieme di modifiche realmente ridotto trascinava anni di cronologia attraverso l'ordinamento.
- La fase di windowing calcolava colonne che la query finale non utilizzava mai, inclusa una seconda finestra orientata al futuro il cui intero output veniva scartato.
Ogni correzione deriva direttamente dalla sua causa: propagare il timestamp di ingestion reale attraverso i modelli a monte in modo che l'insieme modificato rifletta dati realmente nuovi, limitare il ricalcolo a una finestra recente, eliminare le colonne inutilizzate e la finestra futura, eseguire il clustering sulla granularità con cui il modello viene interrogato e, infine, eseguire l'intero grafo come task paralleli per modello su calcolo serverless (la sezione successiva). Insieme, questi interventi hanno ridotto il tempo di esecuzione del job principale di oltre il 60 percento, quasi due terzi, ed eliminato il full refresh notturno che era necessario per mantenere corretti i KPI.
Da una sessione di debug a una competenza ripetibile
La diagnosi sopra descritta (leggere il piano di esecuzione reale invece del SQL compilato, controllare il lato di lettura e il lato di scrittura, tracciare ogni sintomo fino alla causa radice) non è specifica del modello di consolidamento. È una sequenza che qualsiasi ingegnere eseguirebbe su qualsiasi modello incrementale lento su Databricks. Questa sequenza è ciò che viene pacchettizzato come competenza ("skill"): un playbook che un agente IA esegue su richiesta, in modo che la diagnosi si adatti al numero di modelli anziché al numero di ingegneri che ricordano come farlo.
La competenza rispecchia l'esempio pratico passo dopo passo. Estrae l'effettiva famiglia di istruzioni dalla cronologia delle query, non dall'output di dbt compile, perché per un modello incrementale si tratta di istruzioni diverse. Legge entrambi i lati dell'esecuzione: le metriche lato scansione (file eliminati, righe lette, spill) e le metriche lato scrittura (righe scritte rispetto a righe eliminate), poiché l'amplificazione si manifesta solo sul lato scrittura. Successivamente, verifica la presenza delle stesse tre classi di errore riscontrate nel modello di consolidamento: un insieme modificato che non si riduce mai (un timestamp a monte rigenerato invece di essere propagato), un ricalcolo per asset illimitato (una finestra senza limite di lookback) e lavoro sprecato (colonne o passaggi di finestra calcolati ma mai letti a valle). Ogni controllo si basa su una metrica o su un segnale del piano, non su un'intuizione.
L'output è un report, non una correzione silenziosa: ogni risultato viene presentato con le relative prove (righe scansionate, byte di spill, nodo del piano), abbinato a una modifica proposta, e nulla viene applicato a un modello finché non viene approvato. Una volta approvato, le stesse metriche prima/dopo utilizzate per giustificare la correzione vengono misurate nuovamente all'esecuzione successiva, in modo che la competenza chiuda il cerchio invece di dare per scontato che la correzione abbia funzionato.
Il vantaggio è la coerenza, non la novità. Le tre cause alla base del tempo di esecuzione del modello di consolidamento erano ordinarie e facili da trascurare sotto carico (un timestamp rigenerato, una finestra illimitata, colonne inutilizzate). L'esecuzione di una competenza per rilevarle non costa nulla in termini di ripetizione e trova la stessa classe di problemi sul modello successivo prima che diventi un problema di tempo di esecuzione del 60 percento che qualcuno deve segnalare.
Esecuzione di un progetto dbt di grandi dimensioni su Databricks Jobs
Databricks Workflows (Lakeflow Jobs) gestisce dbt come un tipo di task di prima classe: un progetto dbt può essere pianificato, eseguito e monitorato accanto alle fasi di ingestion e a valle in un unico workflow governato, con tentativi e avvisi condivisi. La versione più semplice esegue l'intero progetto come un singolo task dbt. Funziona, ma è una scatola nera: se un modello fallisce, fallisce l'intero job, senza possibilità di visualizzare, rieseguire o monitorare i singoli modelli. Su questa scala, si tratta di un rischio operativo.
La soluzione consiste nell'eseguire il grafo dbt come singoli task Databricks, uno per ciascun modello, test, seed e snapshot. IFCO genera questo grafo con databricks-dbt-factory, una libreria open source autonoma (con licenza MIT, su GitHub e PyPI). Legge il manifesto dbt e un modello di job e produce un job Databricks Asset Bundle con un task per nodo. La granularità per task conviene solo se ogni task è economico da avviare, il che si riduce a tre meccanismi:
- Tipo di task Notebook. Un piccolo notebook runner condiviso attiva dbt tramite la sua API Python. dbt elabora il SQL e lo invia al SQL warehouse, in modo che il calcolo del notebook non elabori dati.
- Ambienti di base. Un ambiente di base è uno snapshot predefinito di un ambiente Python serverless. Questo contiene già
dbt-databricks, quindi ogni task si avvia da esso ed evita l'installazione tramite pip che un nuovo task dovrebbe altrimenti eseguire. - Iniezione del manifesto. Un manifesto precompilato viene passato direttamente a dbt in modo da saltare il parsing, e ogni task scrive gli artefatti in una directory locale privata. Su un progetto di grandi dimensioni eseguito da molti task contemporaneamente, questa è la differenza tra minuti spesi a rileggere il progetto e lavoro utile.
Mantenendo ridotto l'overhead, il fan-out offre alle operation ciò di cui hanno bisogno: visibilità a livello di task, riesecuzioni mirate del solo modello fallito e dei suoi dipendenti, logging, alerting e testing per modello, e un runner che puoi estendere (caricare segreti, taggare un'esecuzione con un SHA di git o pubblicare su Slack in poche righe). Tutto viene distribuito come Databricks Asset Bundles tramite una matrice di GitHub Actions sensibile al percorso, e il tempo di esecuzione e il costo per modello vengono tracciati dai tag delle query e dalle tabelle di sistema in una dashboard con avvisi, in modo che una regressione emerga in un giorno e non in una fattura mensile.
Test e qualità su scala
L'efficienza non ha valore se altera silenziosamente i numeri, quindi la qualità viene imposta, non semplicemente auspicata. Ogni modello ha un proprietario e un test di univocità. Le chiavi primarie vengono testate come univoche e non nulle con gravità di errore. I modelli con logica reale (window function, join multipli, macro non banali) richiedono unit test. dbt-bouncer blocca i commit che violano queste regole, insieme a sqlfluff sul dialetto Databricks, e i contratti vengono applicati sui layer letti dai consumatori esterni.
La stessa disciplina si applica al costo dei test stessi. I controlli sulle viste vengono materializzati o raggruppati in un numero inferiore di passaggi, poiché un controllo basato su vista ricalcola la vista a ogni esecuzione; i controlli di base diventano vincoli di colonna e i test sono limitati ai dati incrementali. Localmente, gli sviluppatori fanno riferimento a un manifesto di produzione, in modo che vengano compilati solo i modelli modificati mentre quelli a monte leggono da prod. In CI, gli unit test e i test sui dati campionati vengono eseguiti sui modelli modificati prima del merge.
Benchmarking
| Misura | Prima | Dopo |
|---|---|---|
| Tempo di esecuzione giornaliero, job principale | ≈ 7 ore | 2 h 20 min, ridotto del ~66% |
| Full refresh notturno | necessario per mantenere corretti i KPI | dismesso |
| Righe scansionate per esecuzione, modello di consolidamento | ≈ 25 miliardi (e in crescita quotidiana) | -75% di righe scansionate |
| Costo di calcolo giornaliero | Ridotto del 58% | |
| Asset ricalcolati per esecuzione | quasi l'intero pool | ≈ 3 - 5% del pool |
Prossimi passi
La pipeline oggi è batch: l'ingestion avviene una volta al giorno e il layer semantico viene eseguito sopra di essa, emettendo una stima iniziale e facendola convergere all'arrivo dei dati tardivi. Tre interventi consigliati durante l'attività porterebbero questo approccio oltre, aprendo la strada a KPI quasi in tempo reale.
- Consumare solo ciò che è cambiato, con Change Data Feed. Il Change Data Feed di Delta consente a un modello a valle di leggere solo le righe modificate a monte, invece di scansionare nuovamente i suoi input. Applicato al modello di consolidamento e ai suoi dipendenti, riduce il lavoro di riconciliazione da "scansionare una finestra recente" a "elaborare le righe esatte che sono state spostate", il passo successivo naturale dopo aver limitato il ricalcolo.
- Ingestion a latenza inferiore. Il caricamento giornaliero può passare a un percorso di ingestion in streaming, Auto Loader o un connettore Lakeflow Connect a bassa latenza, senza dover riprogettare nulla a valle. Questo da solo riduce la freschezza dei dati da un giorno a pochi minuti.
- Trasformazioni in streaming dichiarative. La stessa logica di trasformazione può essere eseguita continuamente come una Lakeflow Declarative Pipeline che legge uno stream, anziché come un batch notturno, con un'elaborazione stateful che gestisce la riconciliazione per asset all'arrivo degli eventi.
La questione decisiva è l'esigenza aziendale, non la tecnologia. Laddove una metrica debba essere realmente aggiornata entro pochi minuti anziché entro la mattina successiva, questo percorso la fornisce sulle stesse tabelle governate, con la stessa logica definita da dbt. Laddove sia sufficiente un aggiornamento giornaliero, la pipeline batch è già la soluzione più economica.
Conclusione
La struttura della soluzione prevede una netta divisione del lavoro. La logica di trasformazione rimane in dbt, modulare e testata, mentre i dati rimangono nel formato aperto Delta Lake sotto un unico modello di governance Unity Catalog, in modo che la lineage e i controlli di accesso sopravvivano a ogni ricreazione delle tabelle e nulla sia vincolato a un singolo motore di query. Questa logica dbt viene compilata nelle funzionalità Databricks progettate per la scalabilità: liquid clustering, scritture incrementali Delta, dynamic file pruning e funzioni geospaziali H3. Esegui la diagnostica dal piano di query reale anziché dal codice SQL compilato, riduci il numero di righe che raggiungono le costose operazioni di ordinamento e shuffle ed esegui il progetto come un grafo di task per modello, in modo che il team delle operation ottenga visibilità e riesecuzioni sicure con un overhead ridotto. I vantaggi maggiori non sono derivati da cluster più grandi, ma dal fatto di svolgere meno lavoro: elaborare meno righe, ricalcolare meno asset e ricreare la tabella molto meno spesso.
(Questo post sul blog è stato tradotto utilizzando strumenti basati sull'intelligenza artificiale) Post originale
Ricevi gli ultimi articoli nella tua casella di posta
Iscriviti al nostro blog e ricevi gli ultimi articoli direttamente nella tua casella di posta.