Unificare la governance tra motori e cataloghi nell'Open Lakehouse
Come due nuove specifiche di Apache Iceberg™ rendono la governance portabile quanto i tuoi dati
- Le restrizioni di lettura e le etichette del catalogo sono due nuove specifiche di Apache Iceberg™ che aiutano a standardizzare il modo in cui le policy vengono applicate tra motori e cataloghi.
- Entrambe le aggiunte eliminano la frammentazione nell'applicazione delle policy. Le restrizioni di lettura delegano le decisioni a motori affidabili; le etichette del catalogo rendono i metadati di governance portabili tra cataloghi federati.
- Ora esiste un modello chiaro per ogni pattern di accesso: applicazione centralizzata per i motori non affidabili, restrizioni di lettura per quelli affidabili e etichette del catalogo per la federazione da catalogo a catalogo.
Nei nostri post precedenti, abbiamo mostrato come i formati di tabella aperti, le API aperte e la governance unificata si stiano unendo per completare la visione dell'Open Lakehouse. Abbiamo anche introdotto il controllo degli accessi basato sugli attributi cross-engine, che consente di applicare in modo coerente le policy definite in Unity Catalog quando i motori esterni accedono ai dati regolamentati.
Ora, questa visione sta iniziando a concretizzarsi apertamente. La community di Apache Iceberg™ ha recentemente introdotto due importanti aggiunte all'Iceberg REST Catalog: restrizioni di lettura e etichette del catalogo. Insieme, affrontano due sfide distinte: delegare l'applicazione a un motore esterno e rendere il contesto di governance portabile tra i cataloghi.
In questo post esamineremo più da vicino entrambe le nuove aggiunte alle specifiche: come funzionano, le sfide principali che affrontano, le future opportunità di innovazione e quando utilizzarle.
Restrizioni di lettura: standardizzare l'applicazione delegata
Le restrizioni di lettura affrontano uno scenario comune da motore a catalogo: un'organizzazione gestisce i dati in un catalogo e desidera interrogarli da vari motori o strumenti.
Per qualsiasi query regolamentata, devono accadere tre cose:
- Il catalogo riceve l'identità richiedente e il contesto pertinente, come soggetti, gruppi, ruoli o persino attributi di identità come 'regione'
- Valuta la policy per decidere se l'utente può leggere la tabella e quali filtri di riga o maschere di colonna applicare.
- Un livello di elaborazione attendibile applica tale decisione quando i dati vengono letti.
Quando si accede ai dati da un motore, queste responsabilità possono essere suddivise in due modi.
Con l' applicazione centralizzata, tutti e tre i passaggi rimangono all'interno dell'ambiente del catalogo. Ad esempio, Databricks implementa il controllo degli accessi granulare su elaborazione dedicata instradando in modo trasparente le query attraverso una flotta di filtraggio sicura. E la funzionalità Cross-engine ABAC di Unity Catalog estende questa governance ad altri motori posizionando la flotta di filtraggio dietro le API di scansione/pianificazione dell'Iceberg REST Catalog per sanificare i dati prima che un motore esterno come Apache Spark1 o DuckDB elabori il risultato.
Con l' applicazione delegata, il catalogo riceve l'identità richiedente e valuta la policy, quindi restituisce le restrizioni di riga e colonna risultanti a un motore di cui si fida per applicarle. In questo contesto, fiducia significa che il catalogo può fare affidamento sul motore per applicare le restrizioni e impedire agli utenti di aggirarle. I motori come Apache Spark e DuckDB non sono attendibili quando gli utenti controllano il runtime, perché tali utenti possono eseguire codice arbitrario o accedere direttamente ai dati sottostanti. Una distribuzione Trino configurata in modo sicuro è un esempio di motore attendibile perché fornisce l'applicazione nativa per i filtri di riga e le maschere di colonna.
L'applicazione delegata richiede un contratto comune tra il catalogo e il motore. La community di Iceberg ha adottato le restrizioni di lettura per fornire tale contratto.
Come funzionano le restrizioni di lettura
Quando un lettore carica una tabella tramite l'Iceberg REST Catalog, il catalogo valuta le policy applicabili per il principal richiedente e il contesto della richiesta. Può restituire le azioni di proiezione delle colonne e le espressioni dei filtri di riga richieste, e il motore attendibile deve applicare tali restrizioni durante la lettura della tabella.
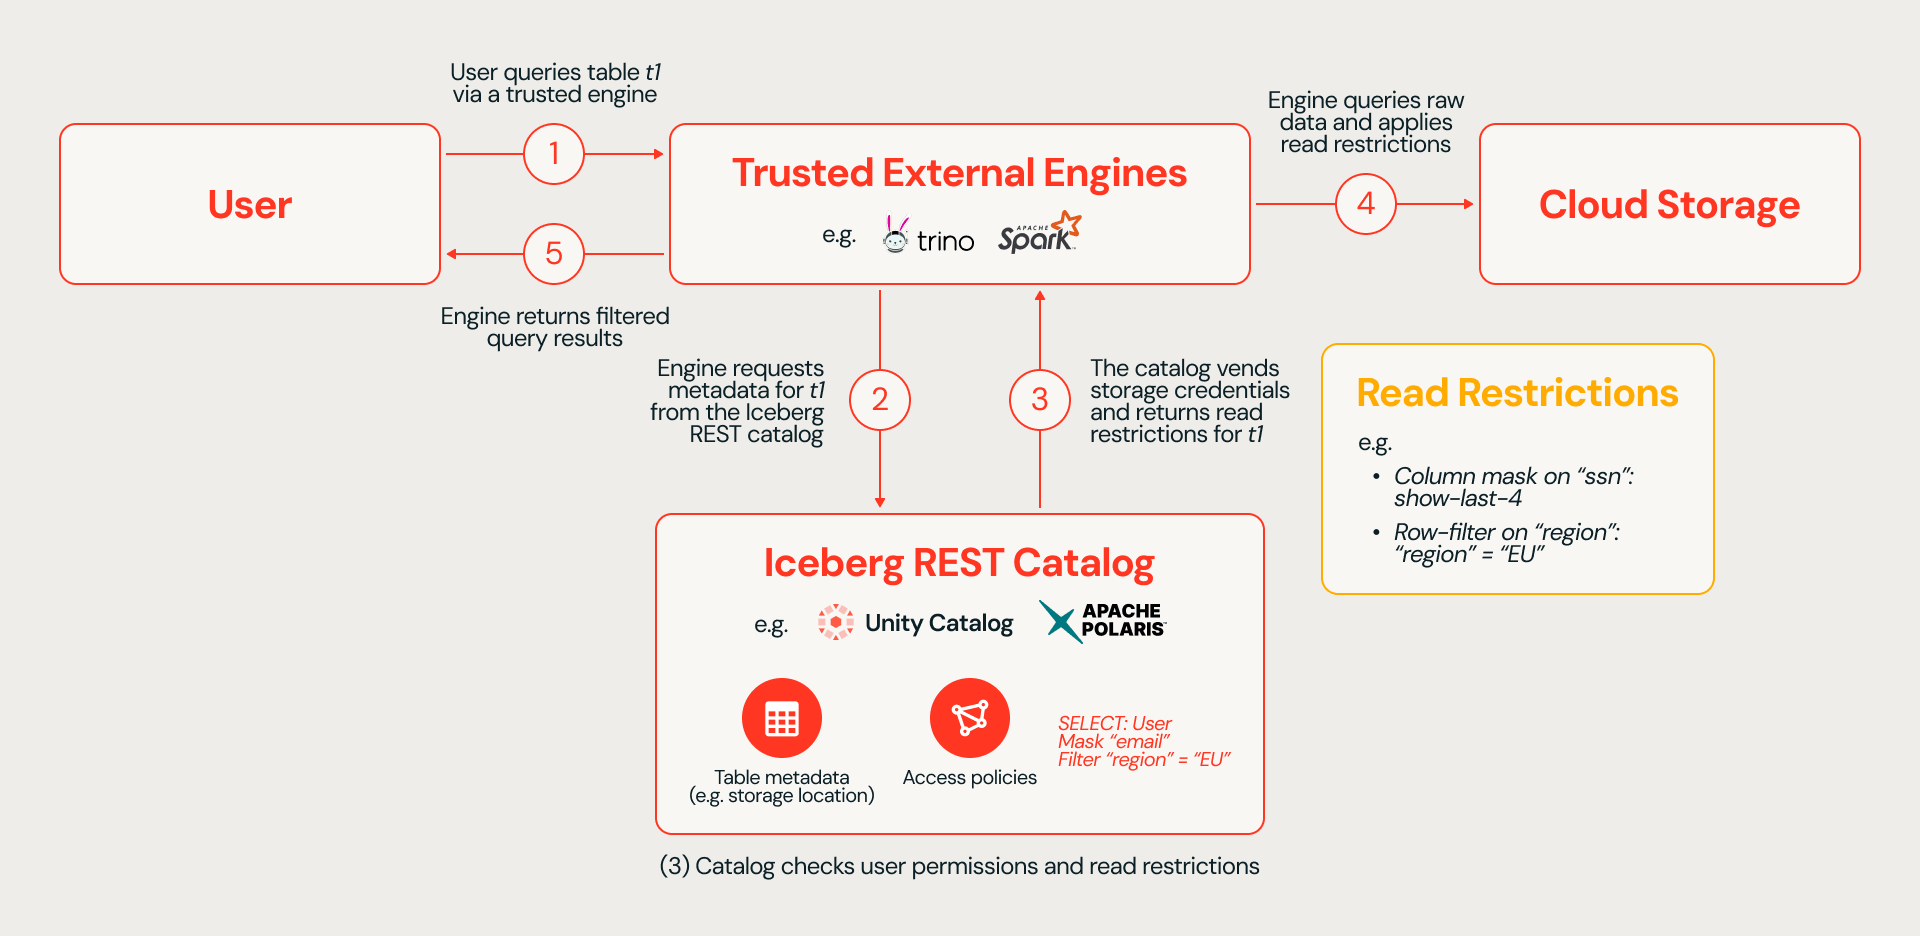
Due decisioni di progettazione sono importanti per comprendere l'attuale portata della proposta.
In primo luogo, il motore non riceve la policy così come definita dall'amministratore. Invece, riceve il risultato per un particolare principal, espresso come istruzioni di filtraggio o mascheramento che deve applicare. Ciò crea un contratto di applicazione comune tra il motore e il catalogo. La specifica iniziale definisce un vocabolario limitato: nove azioni di proiezione delle colonne predefinite e espressioni di filtri di riga standardizzate come confronti o appartenenza a set. Molte policy aziendali reali dipendono da sottoquery, tabelle di ricerca o UDF personalizzate, che non possono essere espresse all'interno del vocabolario delle restrizioni di lettura. Questo ha un'implicazione importante: le policy possono essere rappresentate solo quando il catalogo può ridurre il loro risultato al vocabolario definito dallo standard, altrimenti si perde la semantica della policy.
In secondo luogo, la specifica definisce ciò che un motore attendibile deve applicare, ma non come il catalogo stabilisce tale fiducia. Una dichiarazione da parte del client non è sufficiente, quindi gli amministratori di sistema e le implementazioni devono utilizzare meccanismi di sicurezza appropriati al loro ambiente. Le discussioni della community di Iceberg hanno preso in considerazione meccanismi come mTLS e OAuth, ma in ultima analisi la fiducia rimane al di fuori del protocollo (discussione della community di Iceberg).
Le restrizioni di lettura sono più adatte per scenari di accesso diretto da motore a catalogo in cui le policy del catalogo di origine sono semplici e un motore attendibile può applicare la decisione risultante. Rimangono molte domande sull'implementazione, ad esempio come un motore propaga in modo sicuro l'identità e gli attributi dell'utente finale, come un catalogo distingue l'utente dal motore che agisce per suo conto e come le credenziali sono vincolate al destinatario previsto. Man mano che emergono le implementazioni, siamo entusiasti di collaborare con la community di Iceberg per superare queste sfide ed evolvere lo standard.
Etichette del catalogo: rendere portabile il contesto di governance
Le etichette del catalogo affrontano uno scenario diverso: la governance tra cataloghi federati.
Molte aziende ora collegano più cataloghi, come Unity Catalog, Snowflake, AWS Lake Formation e Google Cloud Knowledge Catalog, tramite federazione e API aperte. Questo è più complesso di un'integrazione da motore a catalogo perché ogni catalogo serve i propri utenti, applicazioni e motori attraverso modelli di identità, linguaggi di policy e semantiche distinti.
Qualsiasi soluzione di governance unificata che funzioni su scala aziendale deve:
- Preservare l'espressività delle policy. I clienti devono poter definire regole sofisticate, tra cui policy basate su attributi e sottoquery complesse, e applicarle in modo coerente su sistemi eterogenei.
- Garantire una chiara verificabilità e responsabilità. Ogni catalogo deve essere in grado di dimostrare la conformità in modo indipendente, senza richiedere agli amministratori di riconciliare i percorsi di audit su più sistemi.
- Scalare senza inserire un altro servizio di catalogo nel percorso critico. La discovery basata sui permessi nel Catalogo A non dovrebbe richiedere una chiamata al Catalogo B per ogni utente e asset. Ad esempio, la maggior parte delle esperienze utente in Unity Catalog tiene conto dei permessi, e il caricamento di Catalog Explorer o la ricerca con completamento automatico potrebbero altrimenti richiedere migliaia di decisioni per utente che sono difficili da memorizzare nella cache, rallentando l'esperienza utente e vincolando le prestazioni e la disponibilità a un altro servizio.
Le etichette di catalogo, adottate di recente dalla community di Iceberg, rappresentano il primo passo verso questa visione. Le etichette consentono ai cataloghi di scambiare metadati chiave-valore leggeri a livello di tabella e colonna tramite API aperte. Le etichette possono indicare che un campo contiene PII, associare un dataset a un dominio aziendale o fornire suggerimenti semantici per i modelli AI. Poiché la proposta è generale, le etichette possono supportare molti casi d'uso oltre al controllo degli accessi, tra cui discovery, proprietà, attribuzione dei costi, contesto AI e qualità dei dati.
Come funzionano le etichette di catalogo
Quando un catalogo di destinazione carica una tabella da un catalogo di origine tramite la federazione dei cataloghi, il catalogo di origine restituisce le etichette a livello di tabella e di colonna.
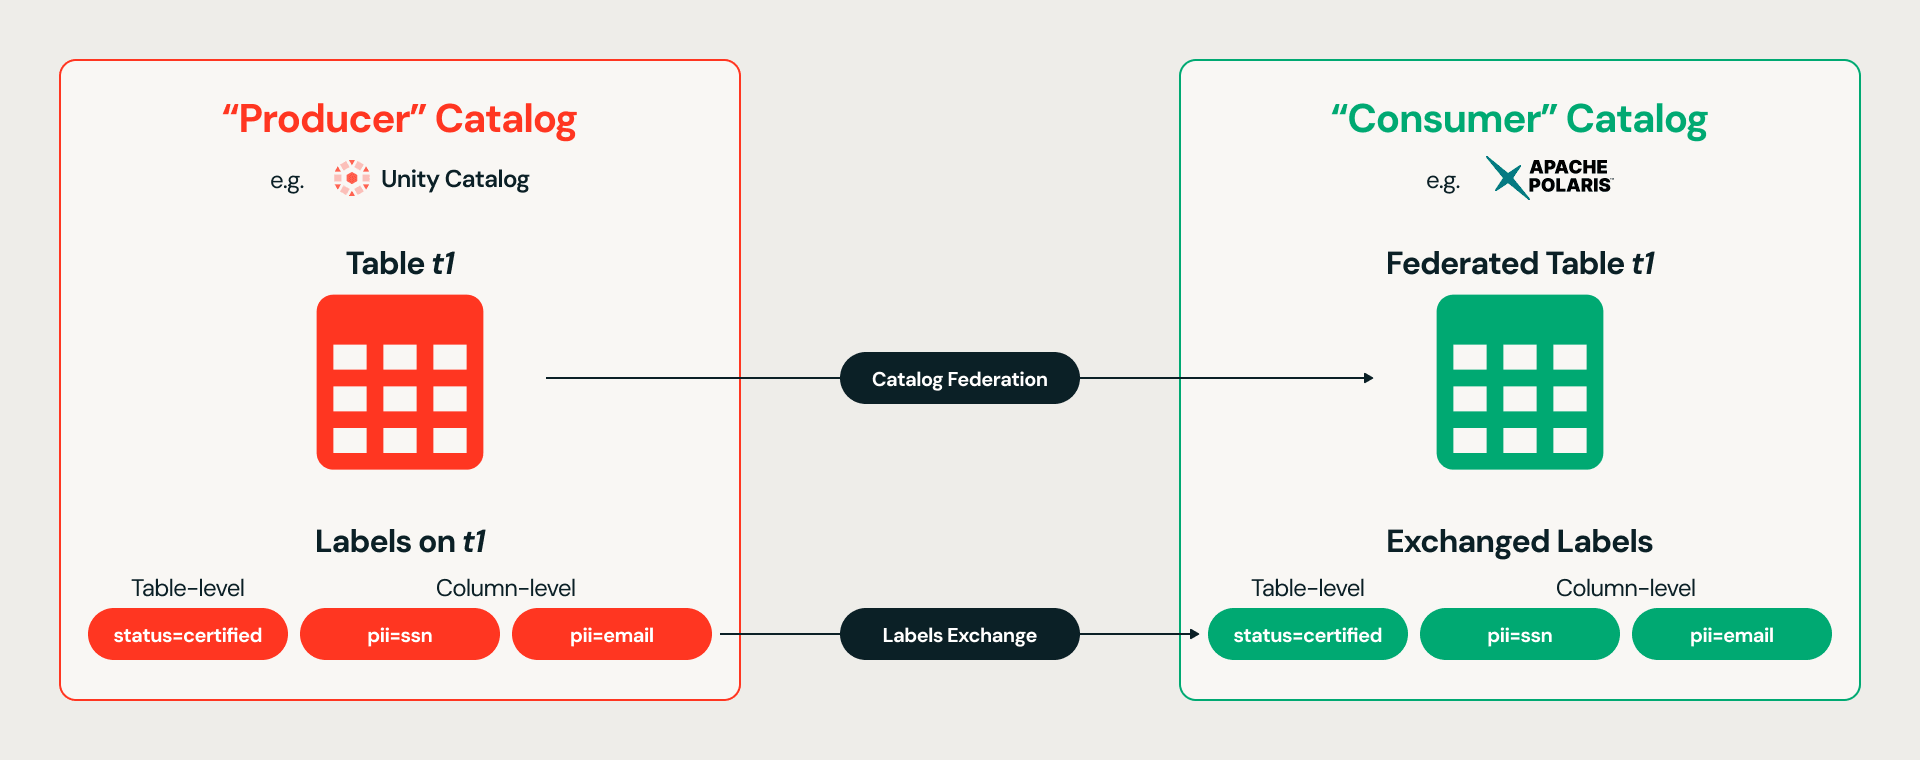
Il catalogo di destinazione mappa quindi le etichette nelle proprie classificazioni, attributi o nel modello di tag nativo. Valuta quindi l'accesso utilizzando le proprie identità e policy native e applica i controlli all'interno del proprio runtime. Ad esempio, se un catalogo di origine etichetta una colonna ssn come pii=ssn, il catalogo di destinazione può applicare una policy basata su tag che maschera le colonne che portano quell'etichetta.
Poiché l'applicazione delle policy rimane locale, il catalogo di destinazione preserva l'espressività delle sue policy native ed evita di chiamare il catalogo di origine per ogni decisione di accesso. Inoltre, ciascun catalogo mantiene in modo indipendente i propri record di applicazione e il percorso di audit.
È bene tenere presente che le etichette sono coppie chiave-valore opache. Lo standard non definisce una semantica condivisa o identificatori stabili, e la lineage delle etichette non si estende oltre il catalogo di origine. Il catalogo di destinazione riceve solo la chiave e il valore risolti, non se l'etichetta fosse destinata alla discovery, al controllo degli accessi, all'attribuzione dei costi o a un altro scopo. Le etichette rendono quindi portabili i metadati, ma non il loro significato; le aziende hanno comunque bisogno di convenzioni condivise o mappature esplicite per interpretare le etichette in modo coerente.
Le etichette di catalogo sono ideali per scenari catalog-to-catalog con federazione tra sistemi eterogenei, in cui il catalogo di destinazione ha il proprio sistema di governance e necessita di un contesto riutilizzabile piuttosto che di una decisione di accesso separata per ogni utente e richiesta. L'idea di fondo è che la governance e il contesto aziendale, come i metadati delle tabelle, debbano essere aperti e portabili attraverso le API REST Catalog di Iceberg.
Scegliere il modello giusto
Il modello giusto dipende dalla destinazione: applicazione centralizzata per un engine non attendibile, restrizioni di lettura per un engine attendibile e etichette di catalogo per lo scambio aperto di metadati quando la destinazione è un altro catalogo con il proprio sistema di governance.
Applicazione centralizzata tramite scan planning | Restrizioni di lettura | Etichette di catalogo | |
Come funziona | Il catalogo di origine valuta e applica la policy tramite un servizio di filtraggio sicuro, restituendo solo i dati autorizzati | Al momento della query, il catalogo indica all'engine quali restrizioni applicare per questo specifico utente e asset, ad esempio "applica mask_alphanum sulla colonna 12" | I cataloghi condividono informazioni aziendali o di governance aggiuntive su una determinata tabella, ad esempio "la colonna 12 ha la classificazione pii=ssn" |
Ideale per | Accesso diretto da un engine non attendibile, come un runtime Spark o DuckDB controllato dall'utente | Accesso diretto engine-to-catalog in cui l'origine valuta la policy e un engine attendibile applica il risultato | Federazione tra sistemi eterogenei con la propria identità, policy e runtime di applicazione |
Identità e sicurezza | Il client deve tradurre e trasmettere i concetti di identità (ruoli, gruppi, ecc.) al catalogo. L'applicazione rimane all'interno del confine attendibile del catalogo, in modo che i dati non autorizzati non raggiungano mai l'engine. | Il client deve tradurre i concetti di identità (principal, ruoli, gruppi, attributi utente) in qualcosa che il catalogo comprenda e trasmettere questi attributi come parte del contesto della richiesta | La destinazione utilizza le identità e gli attributi che già comprende, riducendo il contesto sensibile scambiato tra i sistemi |
Scalabilità, prestazioni e disponibilità | Lo scan planning lato server può ottimizzare l'accesso ai dati, ma l'instradamento delle query regolate attraverso una flotta di filtri aggiunge latenza e una dipendenza operativa rispetto all'applicazione nell'engine di destinazione. | Il catalogo di destinazione non può più riutilizzare una tabella memorizzata nella cache tra i suoi utenti perché le risposte delle tabelle diventano specifiche per l'utente. Ciò fa sì che esperienze come la navigazione, la ricerca e il completamento automatico richiedano una cache per utente o una chiamata separata al catalogo di origine per ogni azione dell'utente. | Il contesto di governance può essere memorizzato nella cache e aggiornato in modo che la ricerca, la navigazione e altre esperienze utente siano gestite in modo nativo |
Governance e verificabilità | Il catalogo di origine conserva la sua piena espressività delle policy native e registra la valutazione e l'applicazione delle policy all'interno dello stesso ambiente attendibile | Le decisioni sono limitate al vocabolario condiviso dello standard. I record di audit sono suddivisi tra i sistemi di origine e di destinazione. | La destinazione utilizza il proprio motore di policy nativo e mantiene un record end-to-end di valutazione e applicazione |
In sintesi | Da utilizzare quando il catalogo di origine deve garantire che i dati non autorizzati non raggiungano mai un motore non attendibile | Da utilizzare quando la destinazione è un motore attendibile e le policy di origine possono essere espresse interamente con restrizioni di lettura | Da utilizzare quando la destinazione è un altro catalogo che necessita di una governance scalabile a velocità nativa tra i suoi utenti e motori |
I prossimi passi
Le restrizioni di lettura e le etichette di catalogo risolvono due problemi distinti e importanti per la governance multipiattaforma. Le restrizioni di lettura offrono ai cataloghi un modo standard per delegare l'applicazione delle regole a motori attendibili. Le etichette di catalogo rendono la governance e il contesto aziendale portabili tra i cataloghi, proprio come i tuoi dati. Insieme all'applicazione centralizzata tramite Cross-Engine ABAC, questi offrono alle aziende un insieme pratico di opzioni per gestire i dati in modo coerente tra motori e cataloghi.
Congratulazioni alla community di Apache Iceberg per aver adottato entrambe le proposte. Anche se c'è ancora molto lavoro da fare, questo è un traguardo importante. Siamo entusiasti di vedere una parte sempre più ampia dell'ecosistema adottare questi elementi fondamentali e di continuare a lavorare con la community per rendere realtà la governance unificata nel lakehouse aperto.
1Le linee guida sulla sicurezza di Apache Spark indicano che il codice inviato dagli utenti viene eseguito senza restrizioni sul suo comportamento e offre agli utenti il controllo sulle risorse assegnate alla loro applicazione. Un'estensione Spark può implementare restrizioni di lettura, ma il deployment si qualifica come attendibile solo quando gli amministratori controllano il runtime ed eliminano qualsiasi via di aggiramento dell'applicazione, poiché manca di un'API di controllo degli accessi a livello di tabella, per non parlare di una per il controllo degli accessi granulare (discussione della community di Iceberg).
(Questo post sul blog è stato tradotto utilizzando strumenti basati sull'intelligenza artificiale) Post originale
Ricevi gli ultimi articoli nella tua casella di posta
Iscriviti al nostro blog e ricevi gli ultimi articoli direttamente nella tua casella di posta.