エージェントとデータチームのためのオープンパイプラインフレームワーク
組み込みのデータ品質管理、検証、ガバナンスにより、AI エージェントによる大規模な利用に対応したパイプラインを安全に構築できます。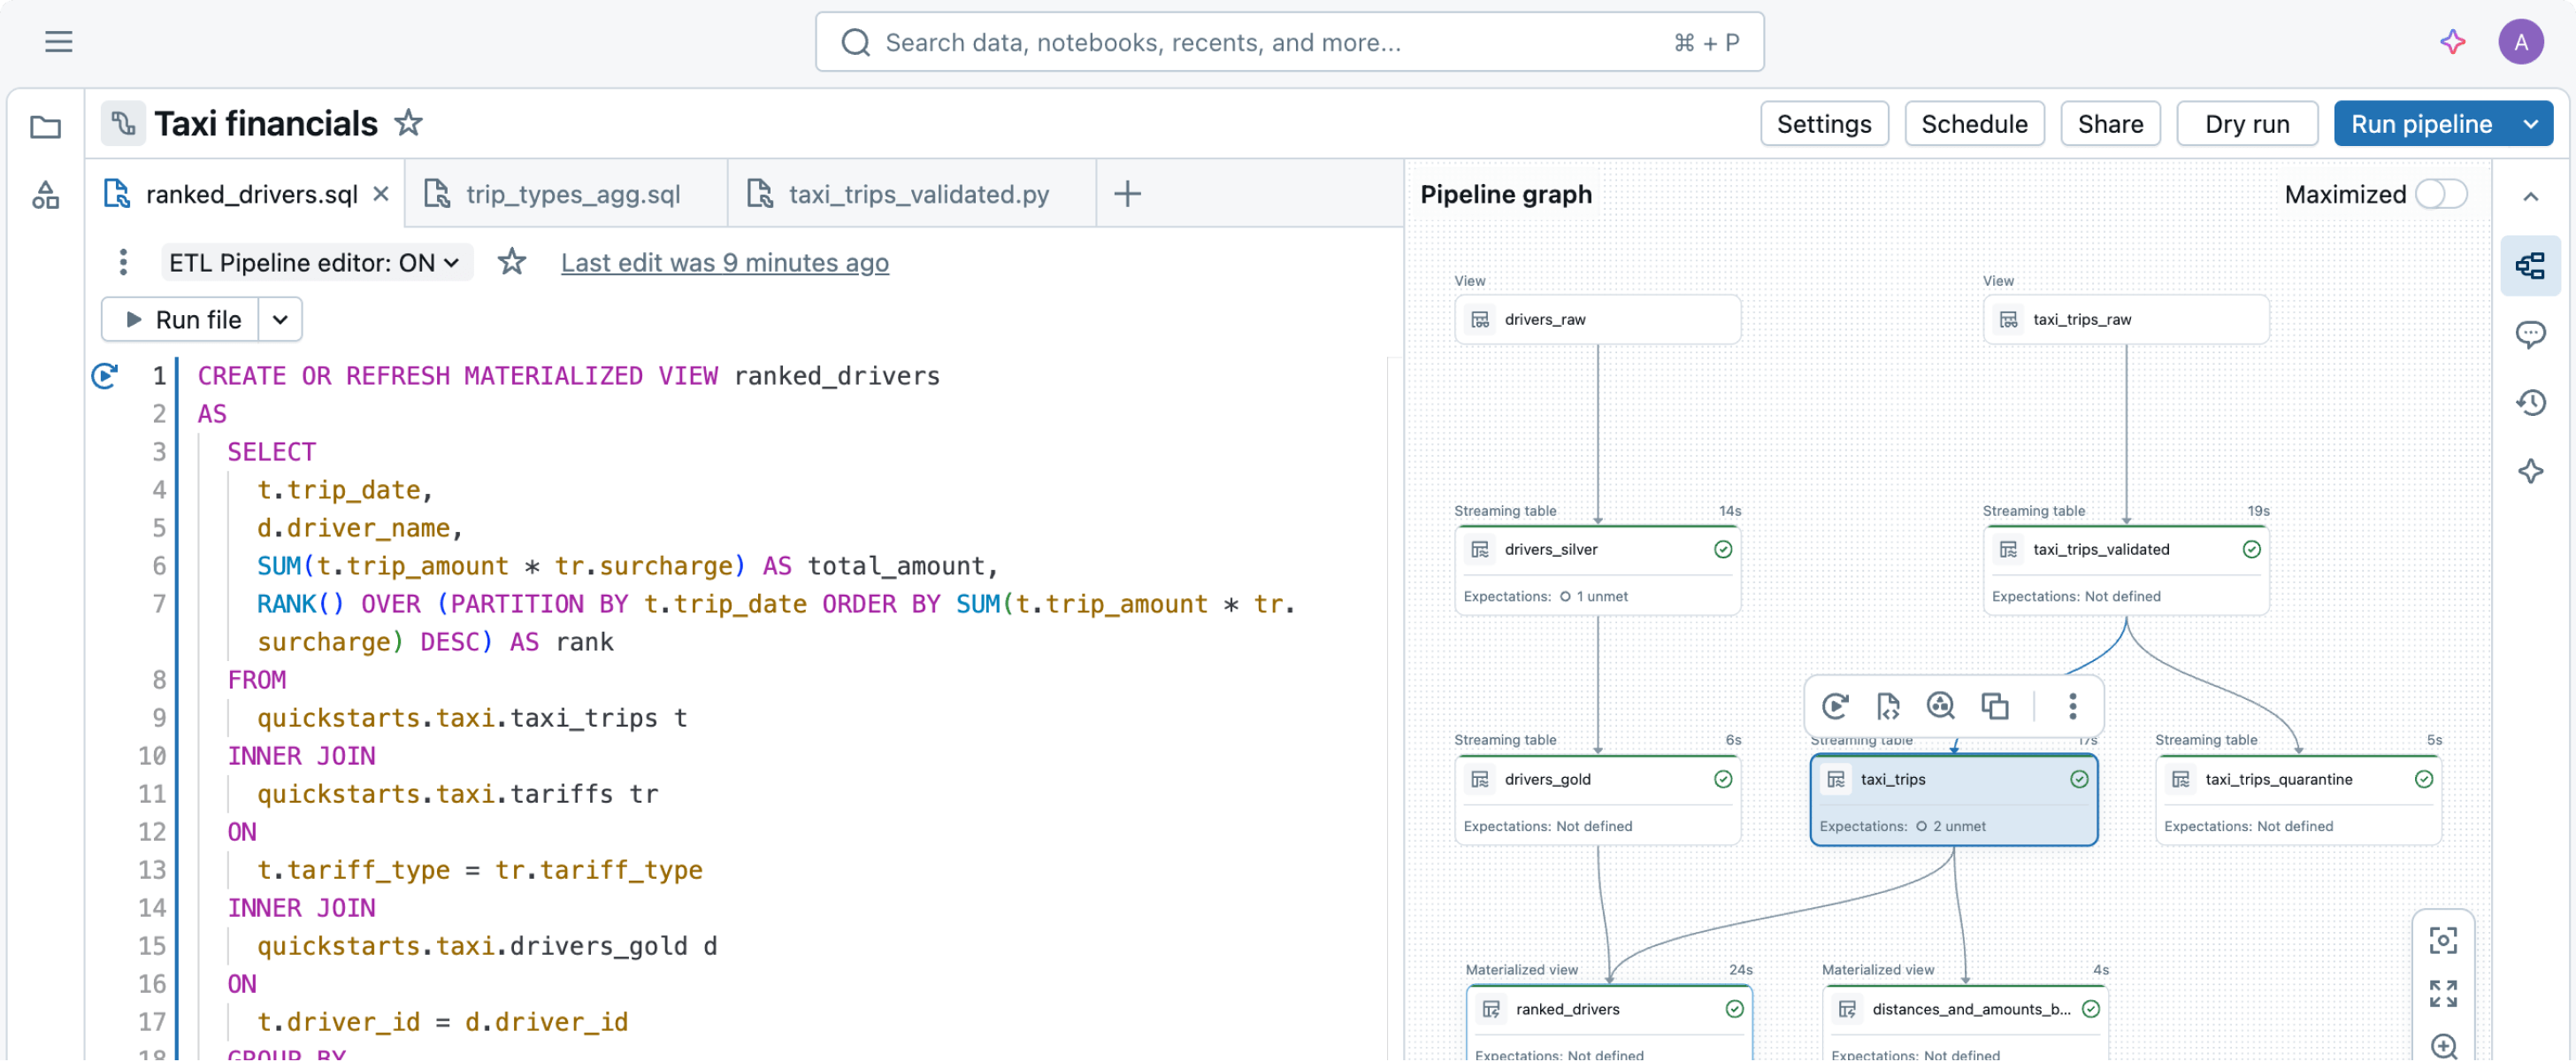
TOP TEAMS SUCCEED WITH INTELLIGENT DATA PIPELINES
AI エージェントによる大規模な利用に対応したパイプラインを安心して構築・実行
オープンスタンダード、自動化された品質チェック、エンタープライズグレードのガバナンスにより、データチームとAIエージェントを強化します。
オープンスタンダード
データパイプラインの普遍的なオープンスタンダード。 Apache Spark™ でバッチとストリーミング、そして SQL と Python を統合し、データチームや AI エージェントが堅牢な本番用コードを生成するためのポータブルな基盤を提供します。

エージェント向けに構築
コーディングエージェントのためのネイティブフレームワーク。 エージェントは、データをどのような状態にしたいかを宣言します。 Apache Spark™ 宣言型パイプライン(SDP)は、パイプラインを実行する前に、依存関係グラフを自動的に解決し、コンパイラのドライランを実行し、品質ルールを適用します。

ガバナンスが適用された実行
安全で自律的なパイプライン実行。 Unity Catalogは厳格なカタログ境界とセキュリティを適用し、SDPは状態管理、エラー回復、増分処理をバックグラウンドで処理します。
エージェントと人間のパイプライン開発を標準化するように構築されています
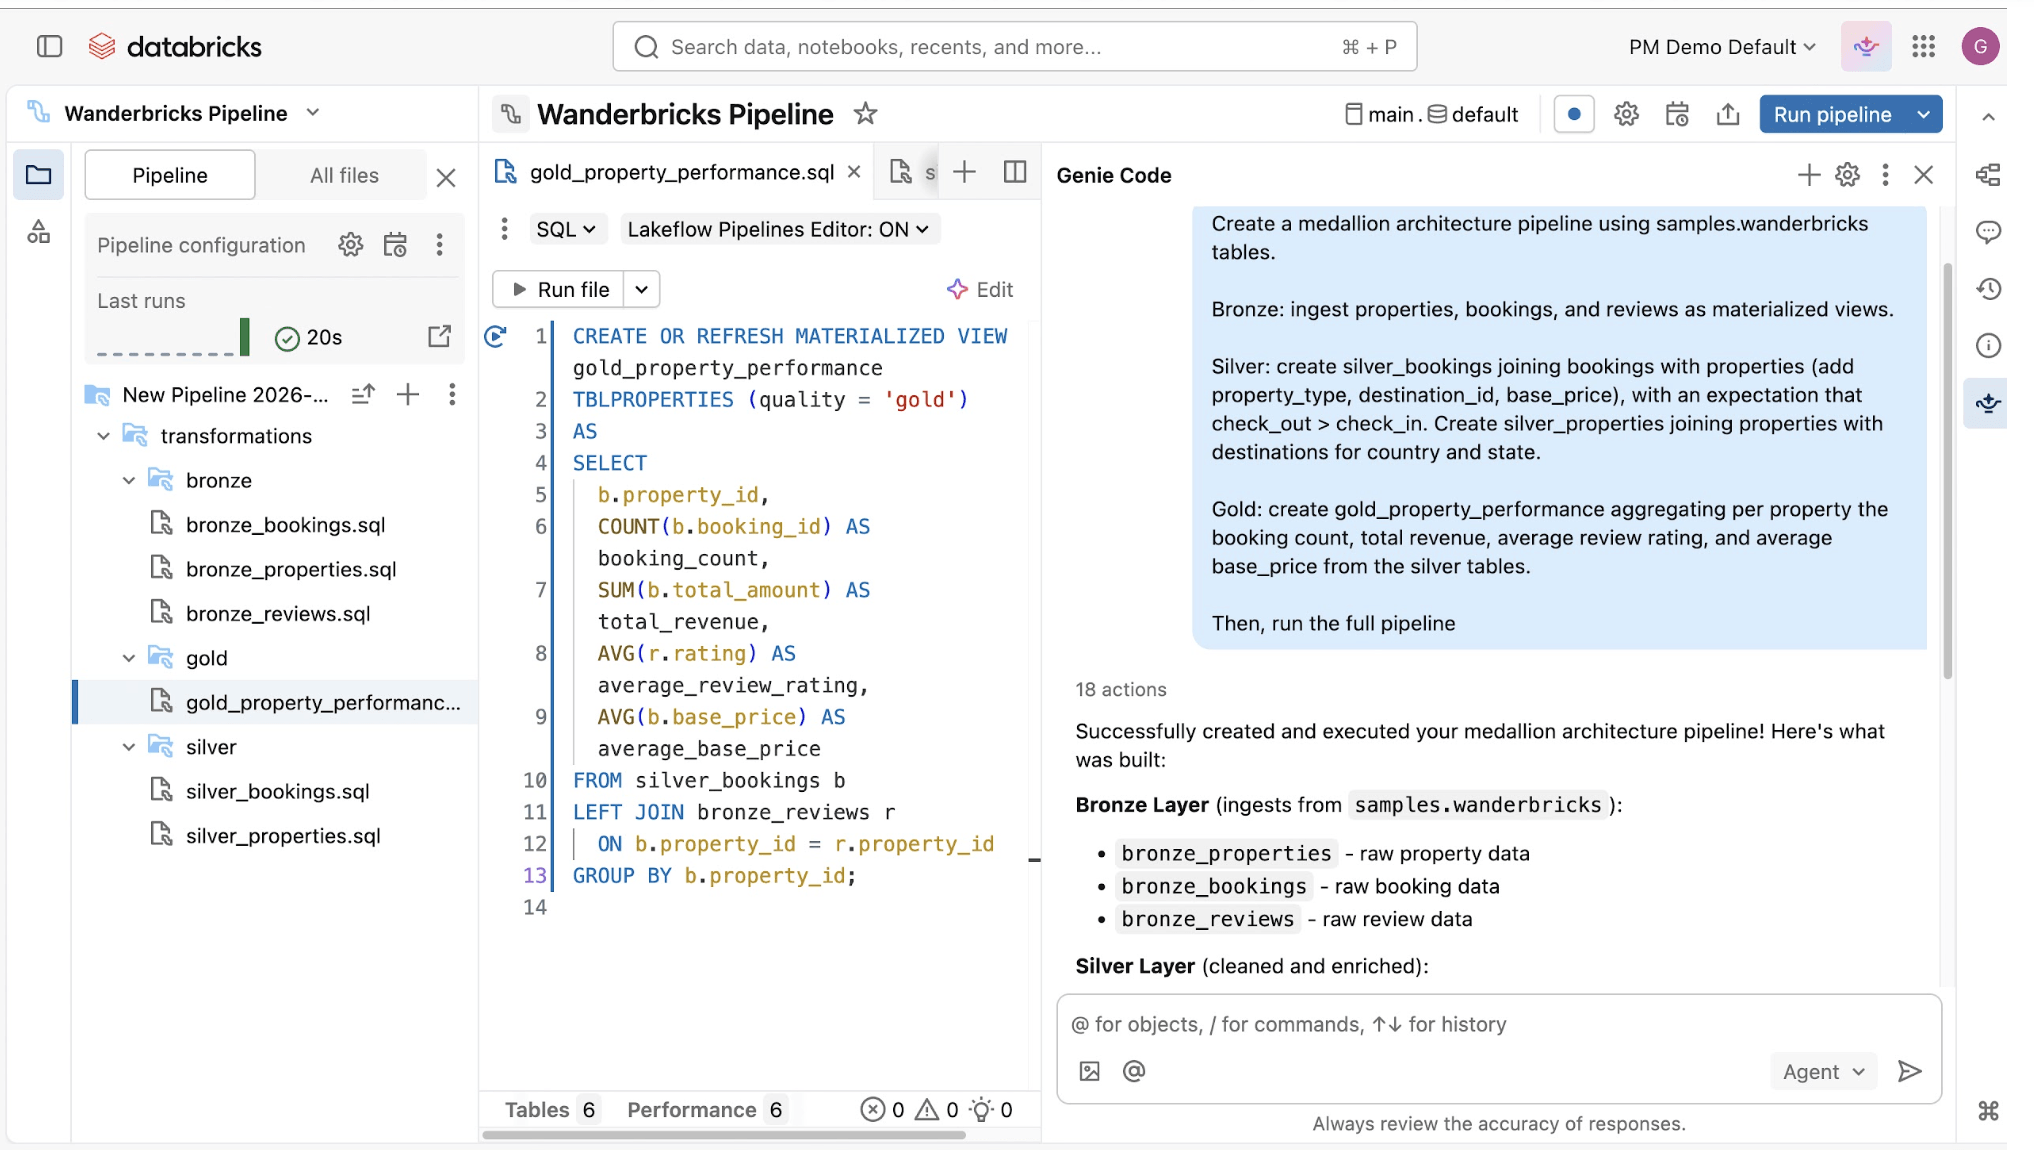
エージェントに対応した作成機能、データ処理パターンへの自動対応、すべてのチームで共通のフレームワークにより、パイプライン開発を標準化します。Genie Code または任意のコーディングエージェントを通じて自然言語を使用し、宣言的にパイプラインを作成・検証し、改善を繰り返せます。
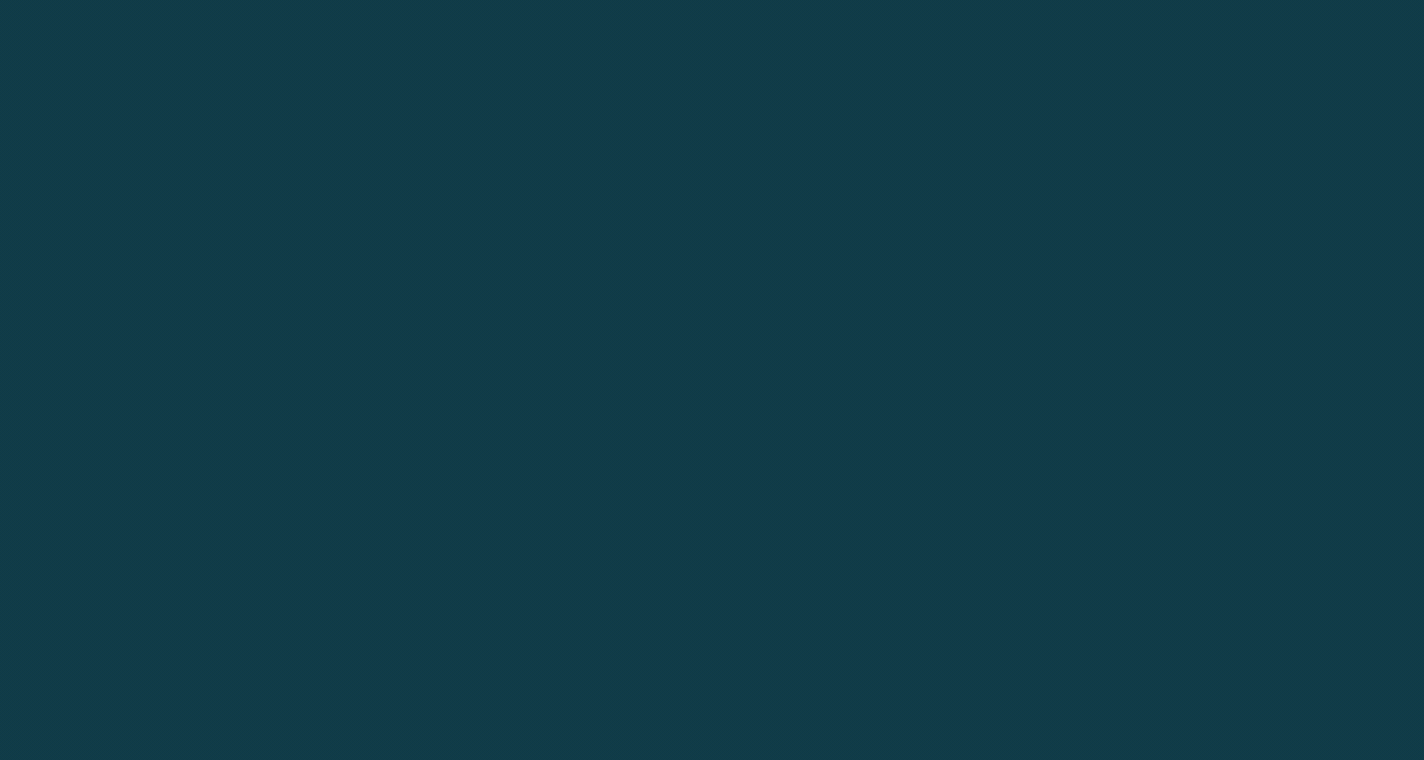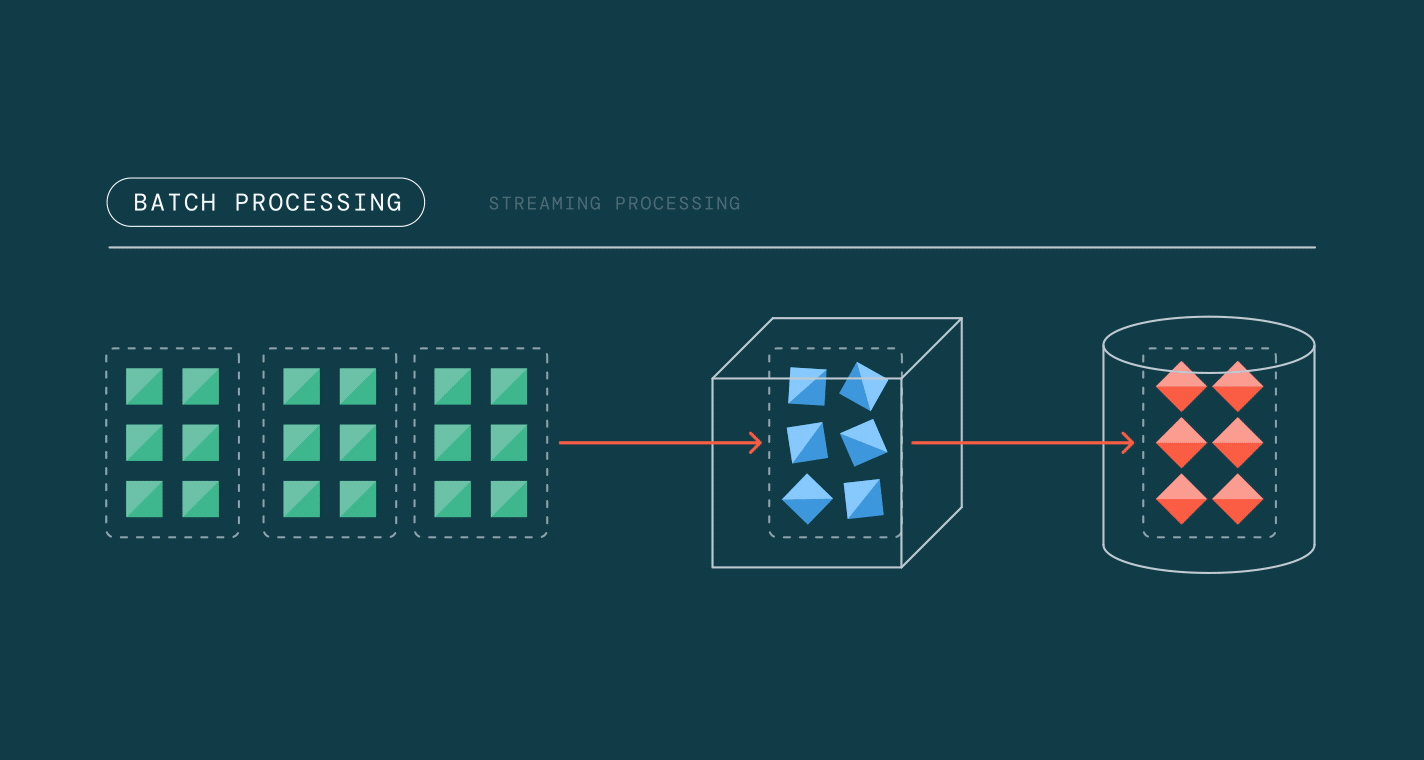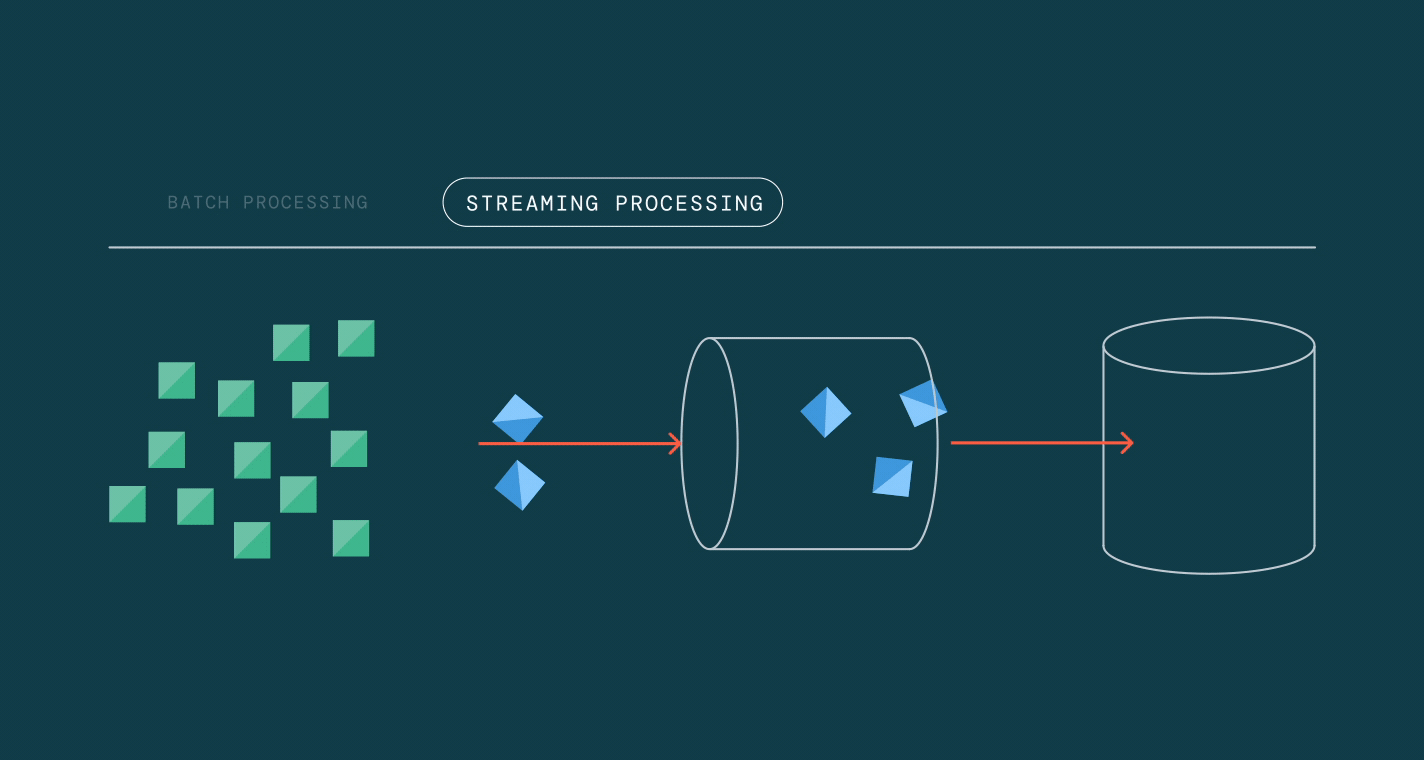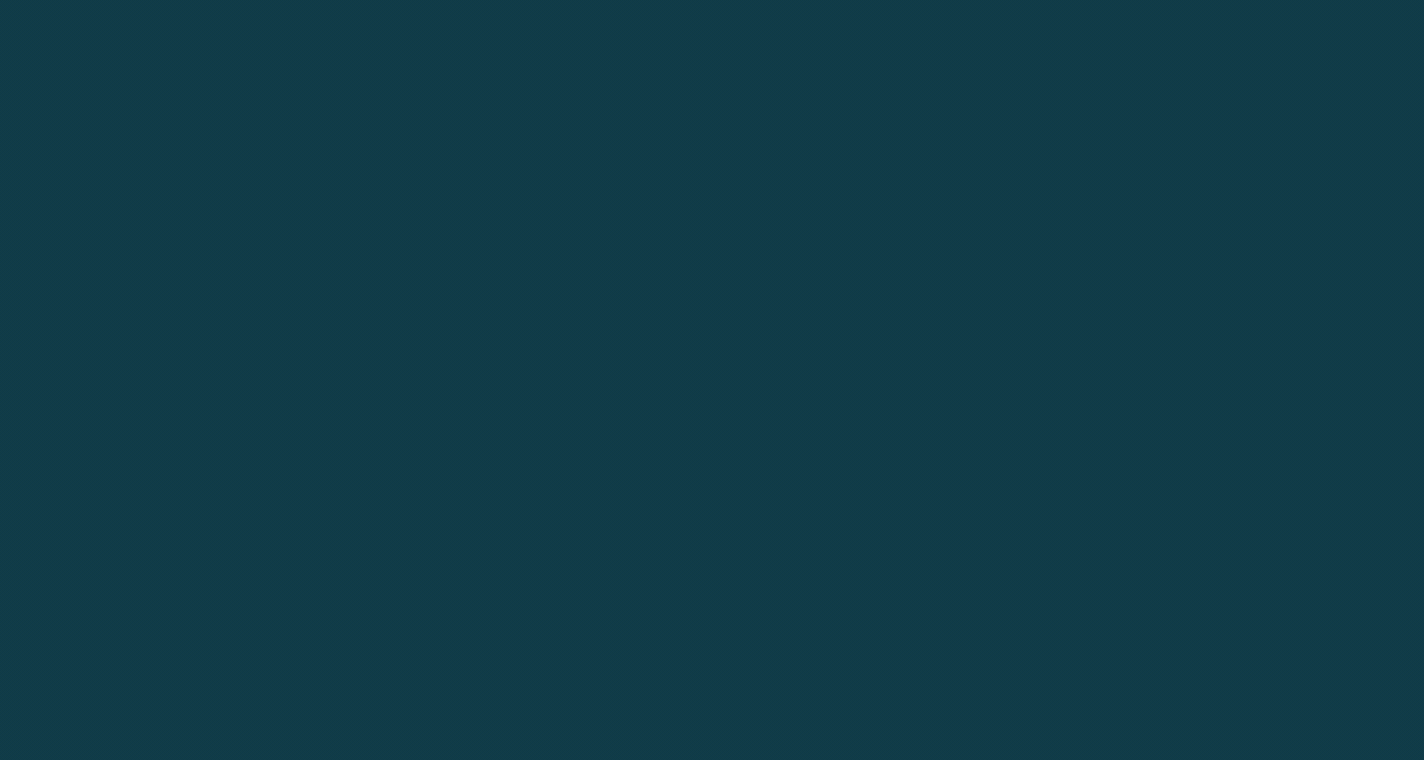
SDPでは、バッチ処理とストリーム処理のためのSparkの統合APIを活用し、処理モードを簡単に切り替えることができます。
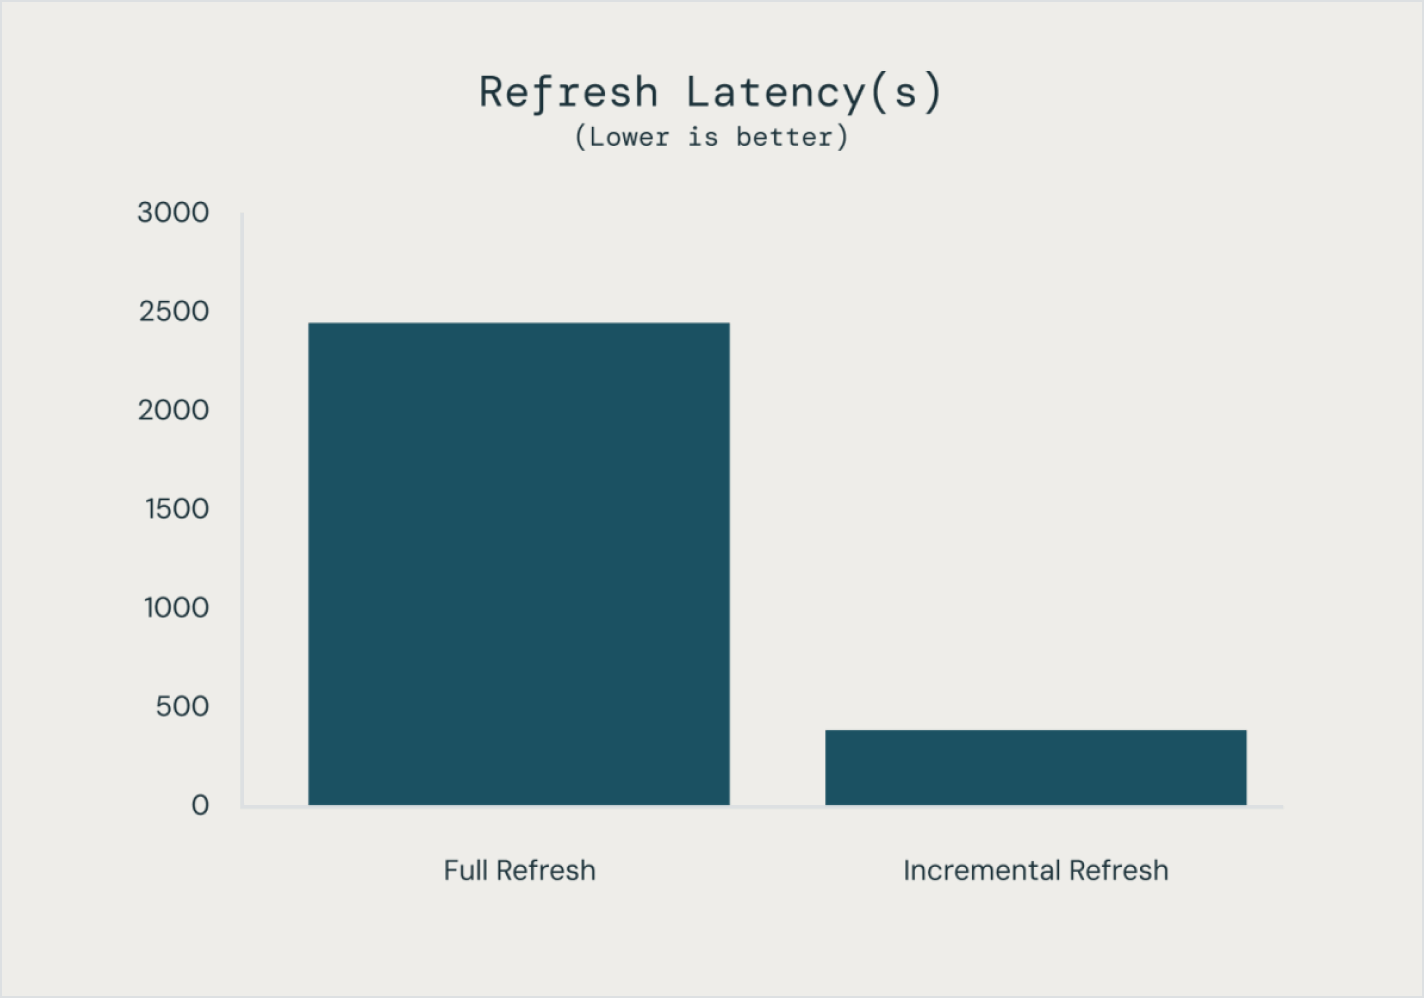
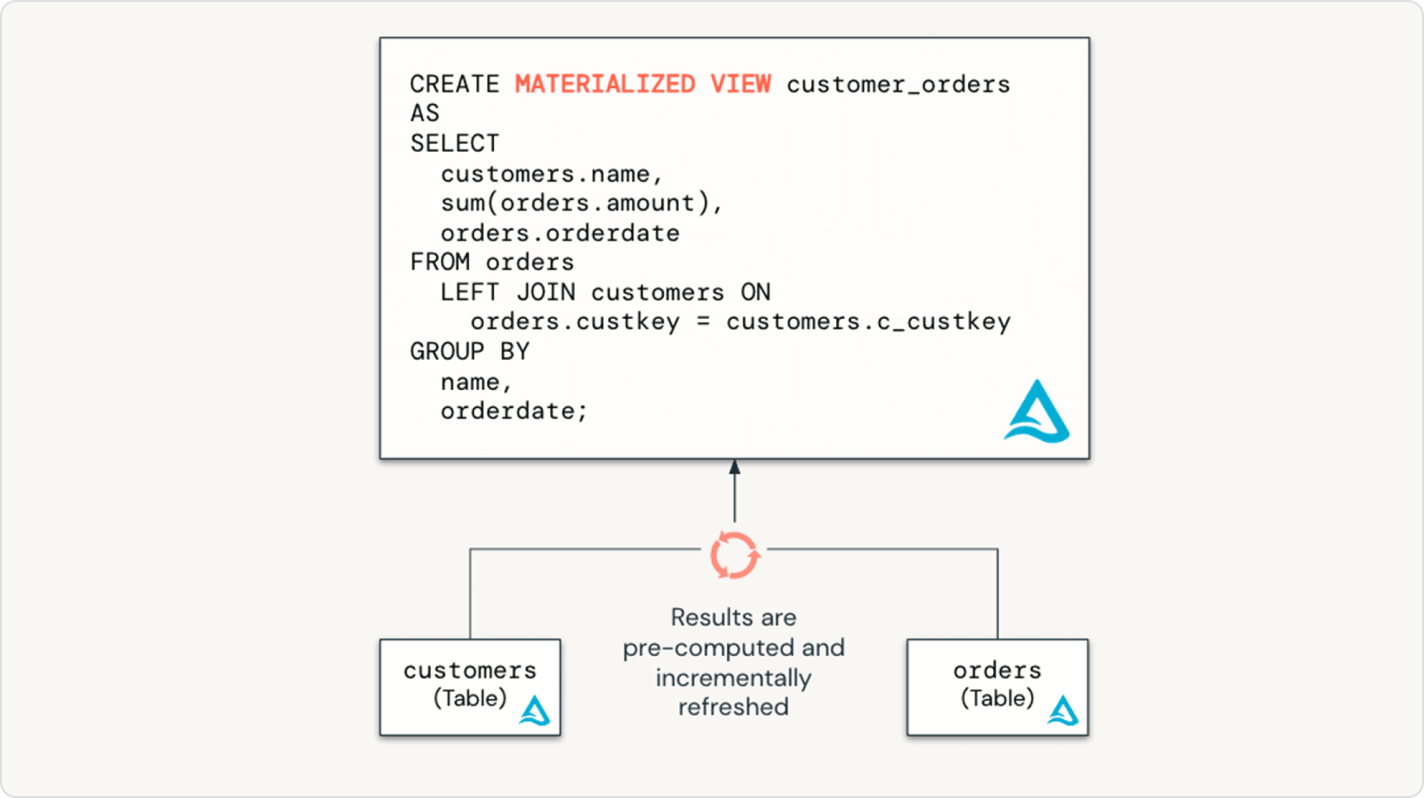
SDP では、テーブルとマテリアライズドビューを使用して増分データパイプライン全体を宣言することで、パイプラインのパフォーマンスを簡単に最適化できます。
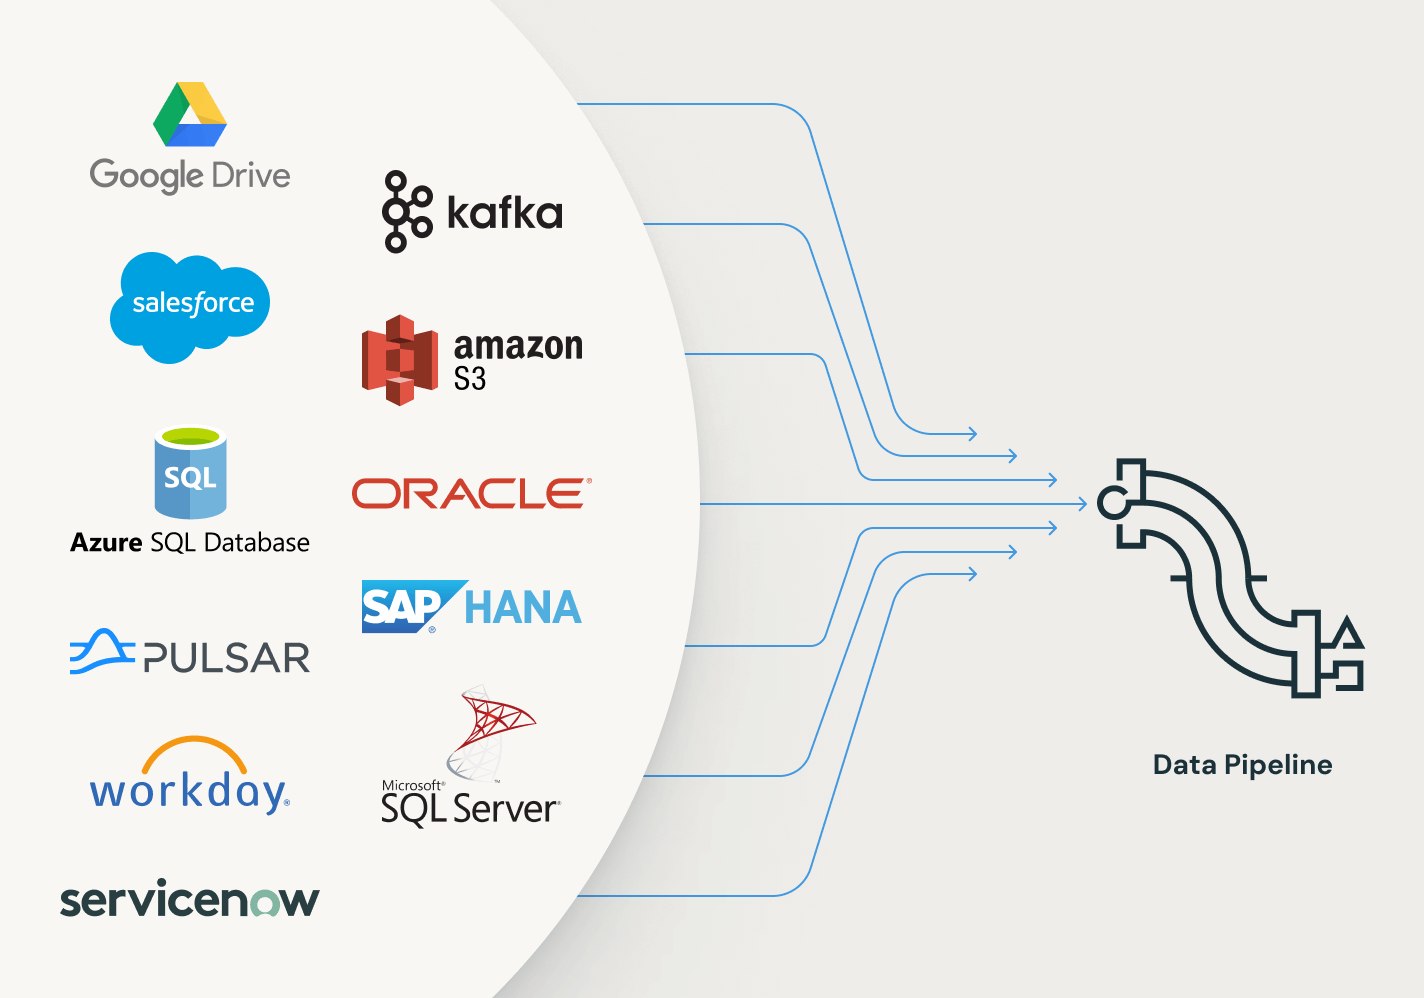
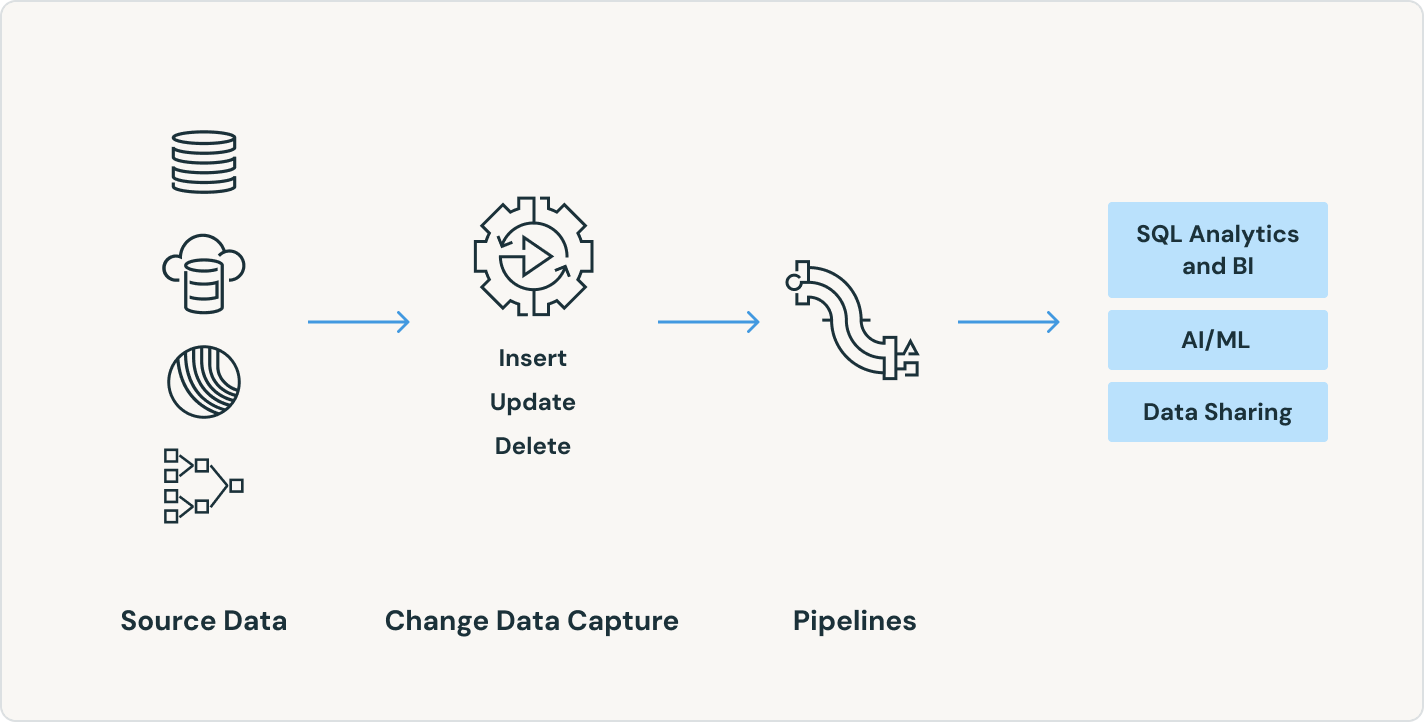
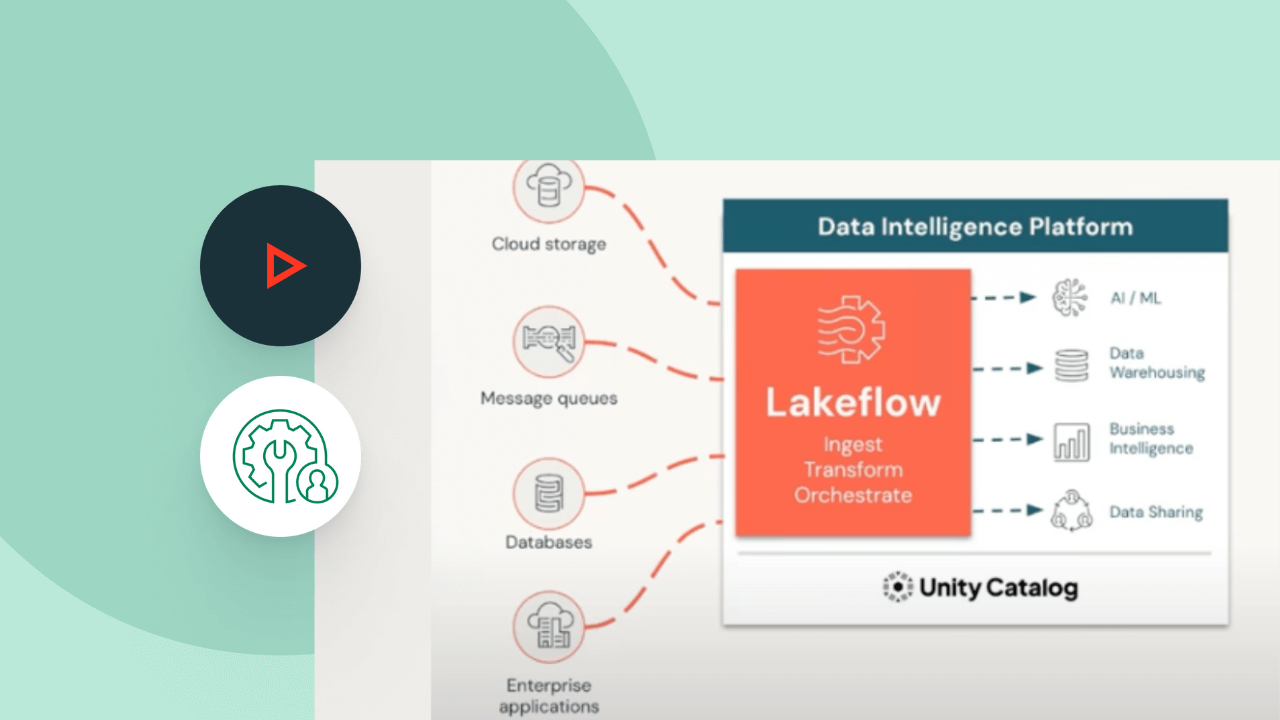
SDPは、ソースとシンクの幅広いエコシステムをサポートしています。 クラウドストレージ、メッセージバス、変更データフィード、データベース、エンタープライズアプリなど、あらゆるソースからデータをロードします。
エクスペクテーションにより、テーブルに取り込まれるデータがデータ品質要件を満たすことを保証でき、パイプラインを更新するたびにデータ品質に関するインサイトが得られます。
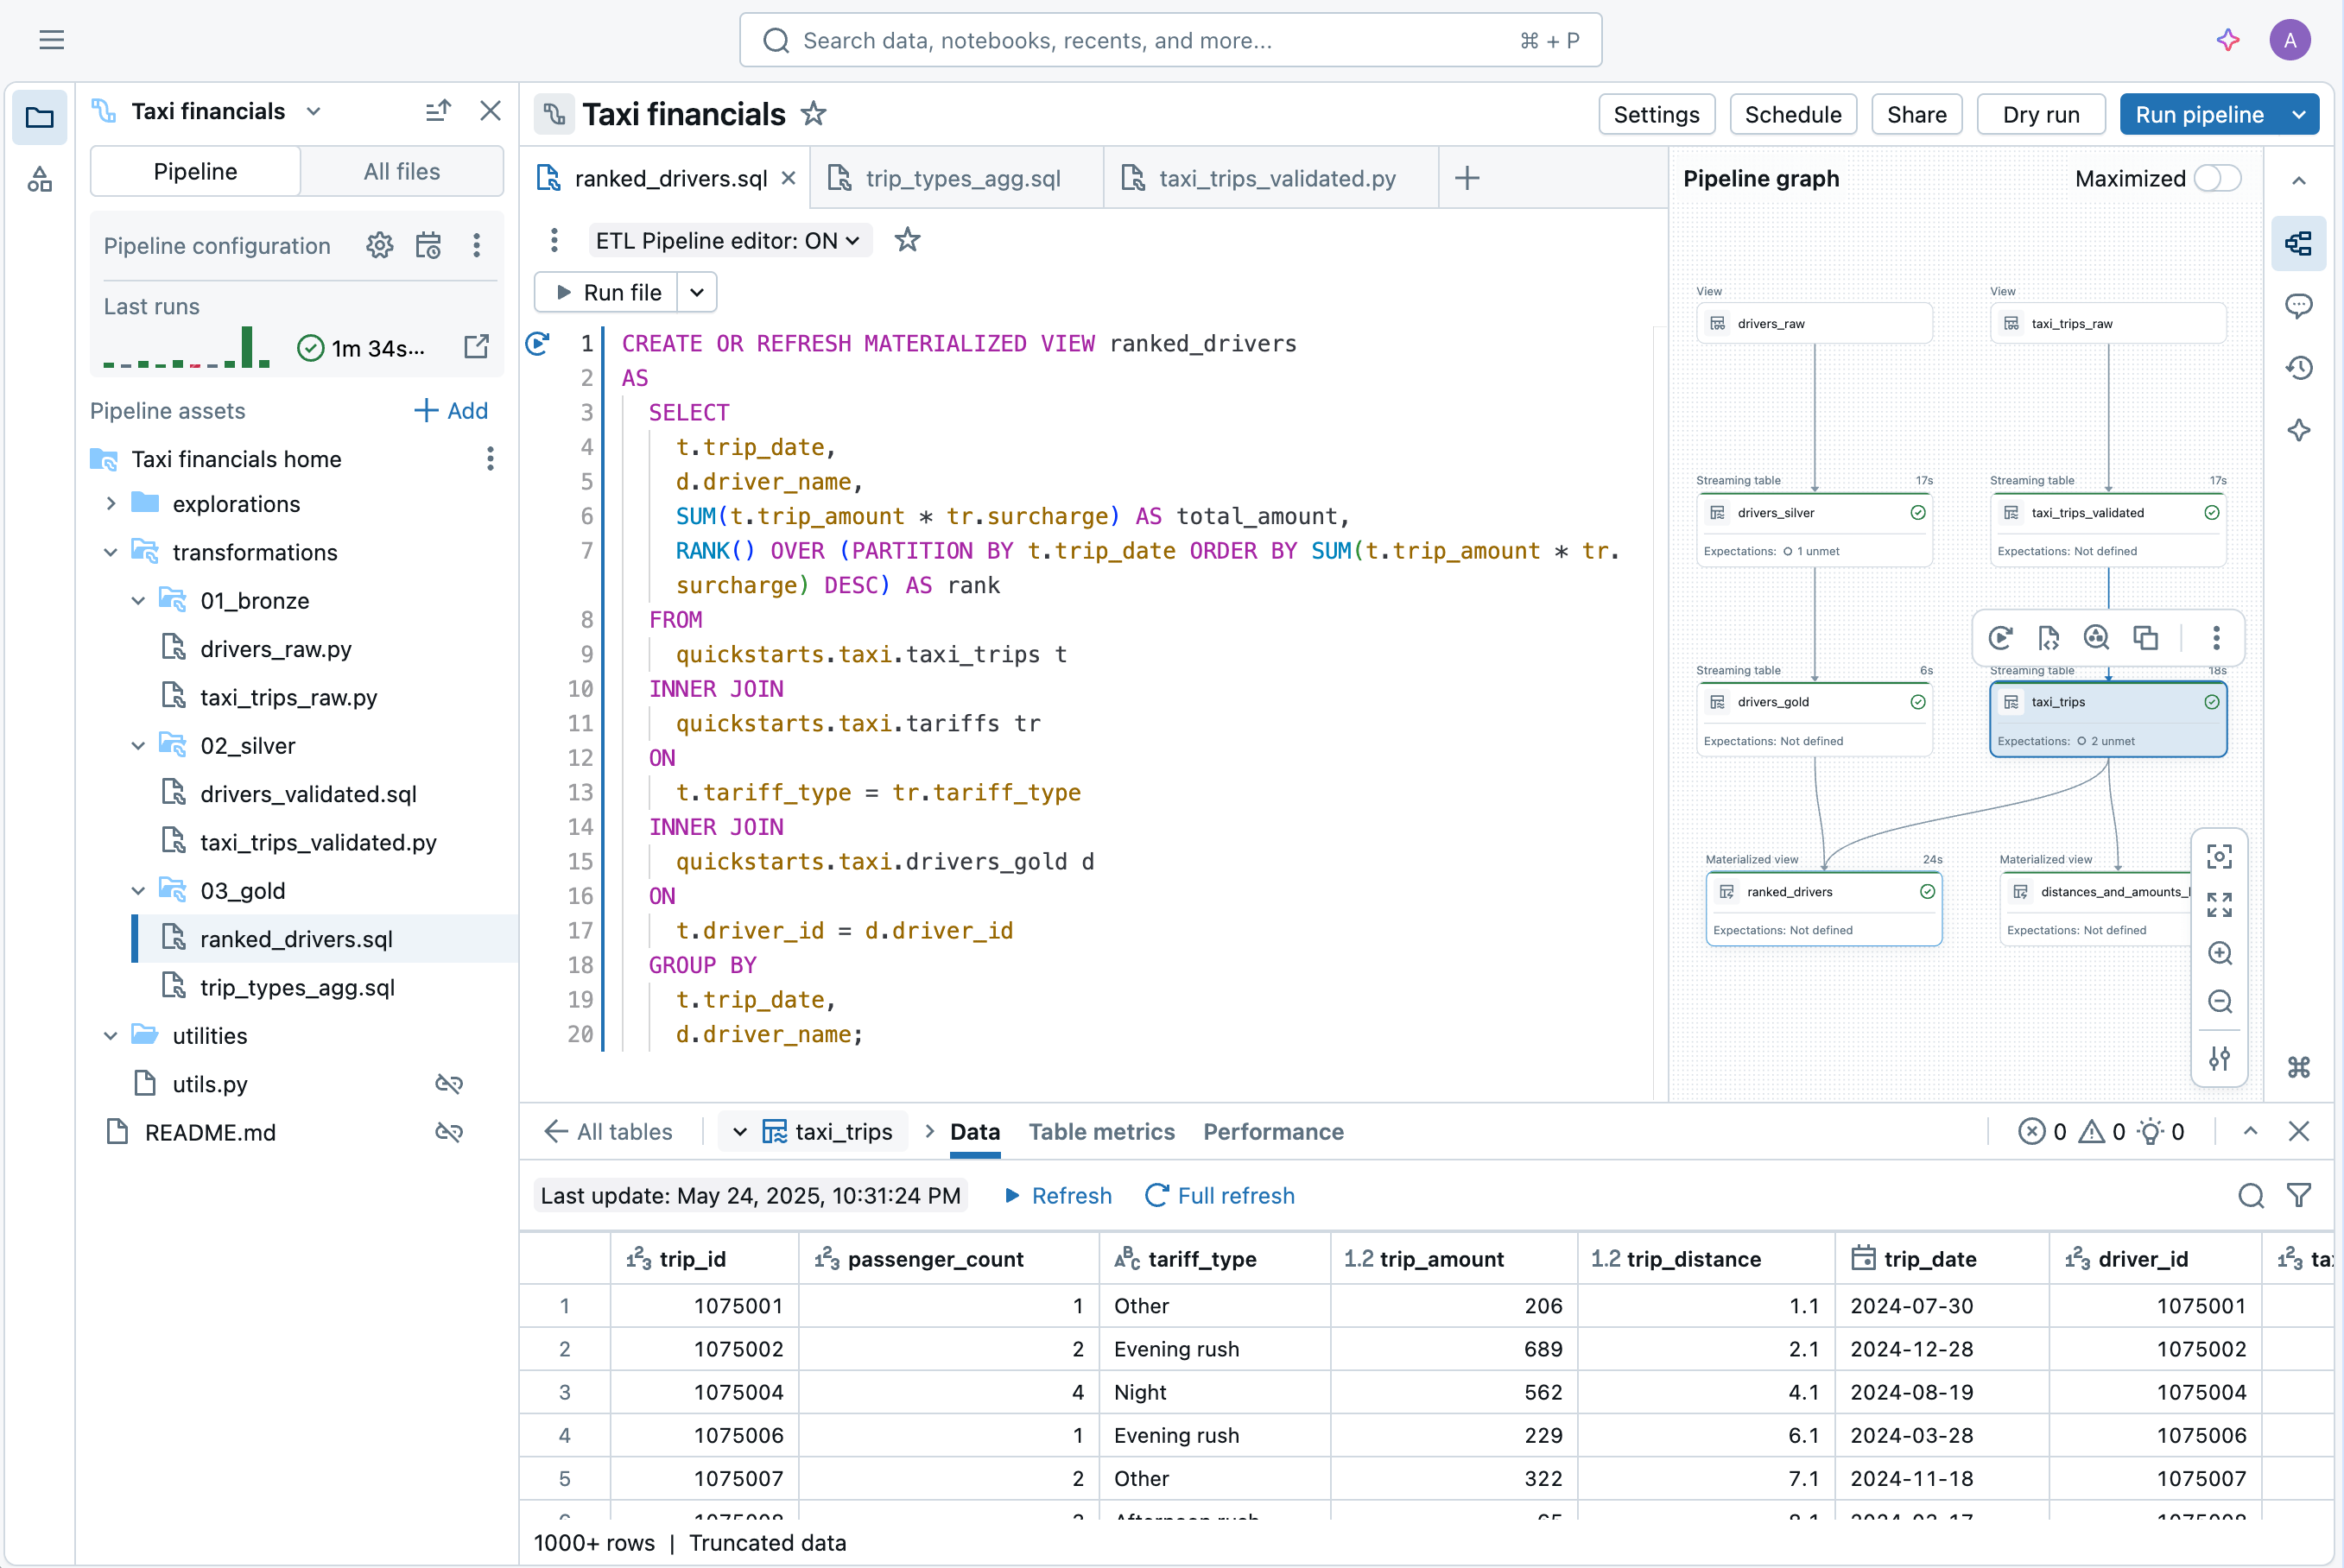
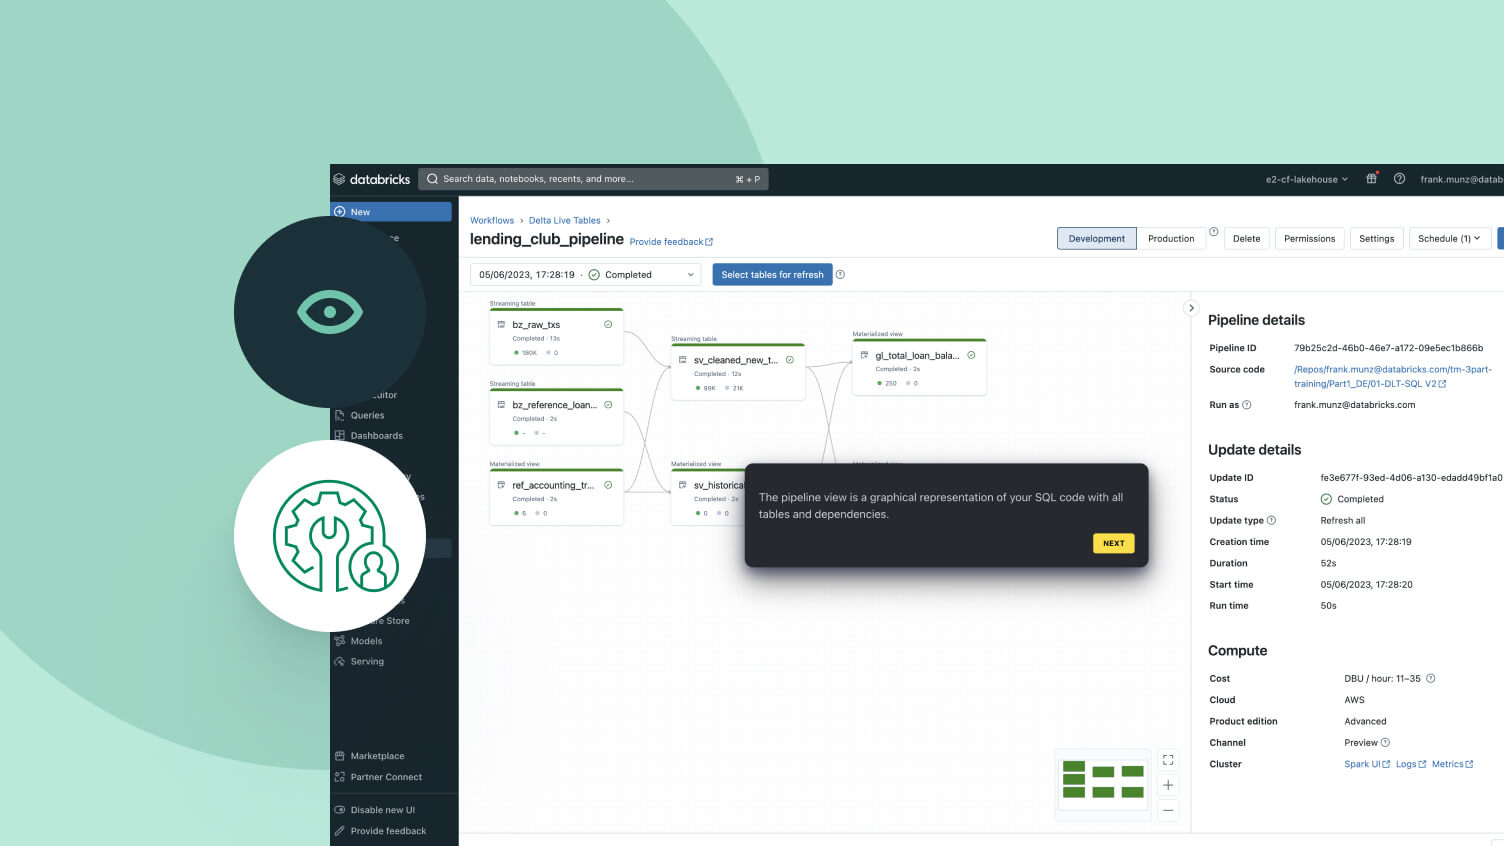
データエンジニアリング向けのネイティブ IDE である Lakeflow パイプラインエディタで、作業コンテキストを切り替えることなくパイプラインを開発できます。DAG、データプレビュー、実行に関するインサイトを1つのUIで確認できます。 オートコンプリート、インラインエラー、診断機能により、コードを簡単に開発できます。
その他の機能
データパイプラインを合理化

使用量に応じた価格設定で、支出を抑制
使用した製品の分のみが、秒単位で課金されます。さらに詳しく
Databricks Data + AI Platform で他の統合されたインテリジェントなサービスもご覧ください。
Genie Code
データ作業のための自律型AIパートナー。

Lakeflow Connect
あらゆるソースからの効率的なデータ取り込みコネクタとDatabricks Data + AI Platformとのネイティブ統合により、統合ガバナンスの下で、分析やAIへのアクセスが容易になります。

Lakeflow Jobs
ETL、分析、機械学習パイプラインのマルチタスクワークフローを簡単に定義、管理、監視できます。 サポートされている幅広いタスクタイプ、高度な可観測性機能、そして高い信頼性により、データチームはあらゆるパイプラインの自動化とオーケストレーションを強化し、生産性を向上させることができます。

Lakehouse Storage
レイクハウス内のあらゆるフォーマットや種類のデータを統合し、すべての分析およびAIワークロードに活用します。

Unity Catalog
Databricks Data + AI Platform に組み込まれた、データ・AI のための業界唯一の統合されたオープンなガバナンスソリューションにより、あらゆるデータ資産をシームレスに管理できます。

Document Intelligence
組み込みのガバナンスの下で、エージェント AI 向けにエンタープライズドキュメントの解析、情報抽出、分類を大規模に行います。

Databricks Data + AI Platform
Databricks Data + AI Platform が、お客様のデータと AI のワークロードをどのように支えるかをご覧ください。
次のステップへ
Spark 宣言型パイプラインに関するよくある質問
Spark 宣言型パイプライン(SDP)は、Apache Sparkにおけるバッチおよびストリーミングデータエンジニアリングを簡素化するオープンフレームワークです。 データチームとコーディングエージェントが手続き型コードを記述する代わりに、ターゲットとなるデータ状態を宣言できるようにすることで、SDP は依存関係を自動的に解決し、データ品質のエクスペクテーションを適用し、増分状態管理を行います。