Databricksアプリのハンズオンガイド
01 | Databricksでのアプリ構築入門
組織全体でAIとアナリティクス能力が成熟するにつれて、人々が実際に使える形でインサイトを提供するという新しい課題が浮上しています。
今日のデータチームは、探索と分析のための強力なツールを手にしている。ノートブックは迅速な反復をサポートし、ダッシュボードは広範な可視性を可能にし、モデルは予測と自動化を推進します。しかし、ビジネス要件がライブデータとユーザー入力を組み合わせたインタラクティブなアプリケーションへと移行すると、ワークフローに組み込まれたAIアシスタントや特定の運用プロセスに合わせたカスタムツールなど、チームはしばしば壁にぶつかります。
従来、本番運用用アプリケーションを構築することは、データプラットフォームから完全に離れることを意味していました。分析からアプリケーションへの移行は、インフラストラクチャのプロビジョニング、データベースの構成、認証の実装、デプロイメントパイプラインの設定、セキュリティレビューへの対応を意味していました。それぞれのステップで、アプリケーションのビジネス価値に直接貢献することなく、コスト、リスク、時間が増加しました。多くの組織にとって、この「ラストマイル」の課題は、アプリケーションの提供を数か月遅らせるか、あるいはまったくリリースできない原因となっていました。
問題はデータやAI能力の不足ではありません。信頼できる本番運用のアプリケーションとして、他の人が使えるように提供するのが難しいのです。
このガイドは、そのギャップを埋めるのに役立つように設計されています。実践的なウォークスルー、作業中のコード例、実際のパターンを通じて、Databricks AppsとLakebaseがどのように連携し、プラットフォームを離れずに動作するプロトタイプから本番運用アプリケーションへと移行させるかを学びます。
アプリケーションデプロイの課題
今日のデータおよびAIアプリケーションを構築するチームにとって、実用的なプロトタイプから本番運用へのデプロイメントまでの道のりは、差別化につながらない重労働で満ちています。Pythonに精通したデータエンジニアが分析を拡張している場合でも、レイクハウスのデータ上で構築しているJavaScript開発者である場合でも、同じ障害に直面します。
- インフラストラクチャのプロビジョニングと管理: すべてのアプリケーションには実行する場所が必要です。従来、これは VM またはコンテナのプロビジョニング、ロードバランサーの構成、SSL 証明書の設定、スケーリング ポリシーの管理を意味していました。
- 認証とセキュリティの複雑さ: 本番運用アプリケーションには、安全な認証フロー、資格情報管理、アクセス制御が必要です。オープン認証 (OAuth) の正しい実装、シークレットのローテーション、セキュリティポリシーへのコンプライアンスの確保には、専門的な知識が求められます。実装を誤ると脆弱性が生じ、正しく実装するには多大なエンジニアリング労力がかかります。
- データの同期とレイテンシ: インタラクティブなアプリケーションはデータへの高速なアクセスを必要としますが、分析データストアは、ユーザー向けのアプリケーションが必要とする低レイテンシ、high-concurrencyのアクセスパターンには最適化されていません。分析システムから運用データベースにデータを移動させ、そのデータを最新の状態に保つためのパイプラインを構築することは、複雑さをさらに増し、潜在的な障害点を追加します。
- デプロイの自動化と環境管理: 開発からステージング、本番運用へとコードを移行するには、継続的インテグレーションと継続的デリバリー (CI/CD) パイプライン、環境設定、そして慎重な調整が必要です。
- ガバナンスとコンプライアンス: エンタープライズ アプリケーションは、データアクセス ポリシーを遵守し、監査証跡を維持し、きめ細かい権限を適用する必要があります。データ プラットフォームですでに確立されているガバナンスとは別に、アプリケーション コードでガバナンス制御を実装すると、作業が重複し、ポリシーのdriftが生じる可能性があります。
これらの課題は、実際のコストを生み出します。デプロイの複雑さが勢いを削ぐ: 変更を迅速かつ確実に行えないと、イテレーションが遅くなり、チーム間の調整に時間を浪費することになります。その結果、貴重な機能はデータプラットフォーム内に閉じ込められたままとなり、組織全体ではなく一部の技術ユーザーしかアクセスできなくなります。
Databricks アプリと Lakebase: 統合アプリケーションプラットフォーム
Databricksは、アプリケーション ホスティングとオペレーショナル データベースをデータ インテリジェンス プラットフォームに直接取り込むことで、これらの課題に対処します。Databricksでは、アプリケーション用に個別のインフラストラクチャを必要とせず、アプリが依存するデータやAI機能と並行して実行される統合ソリューションを提供します。
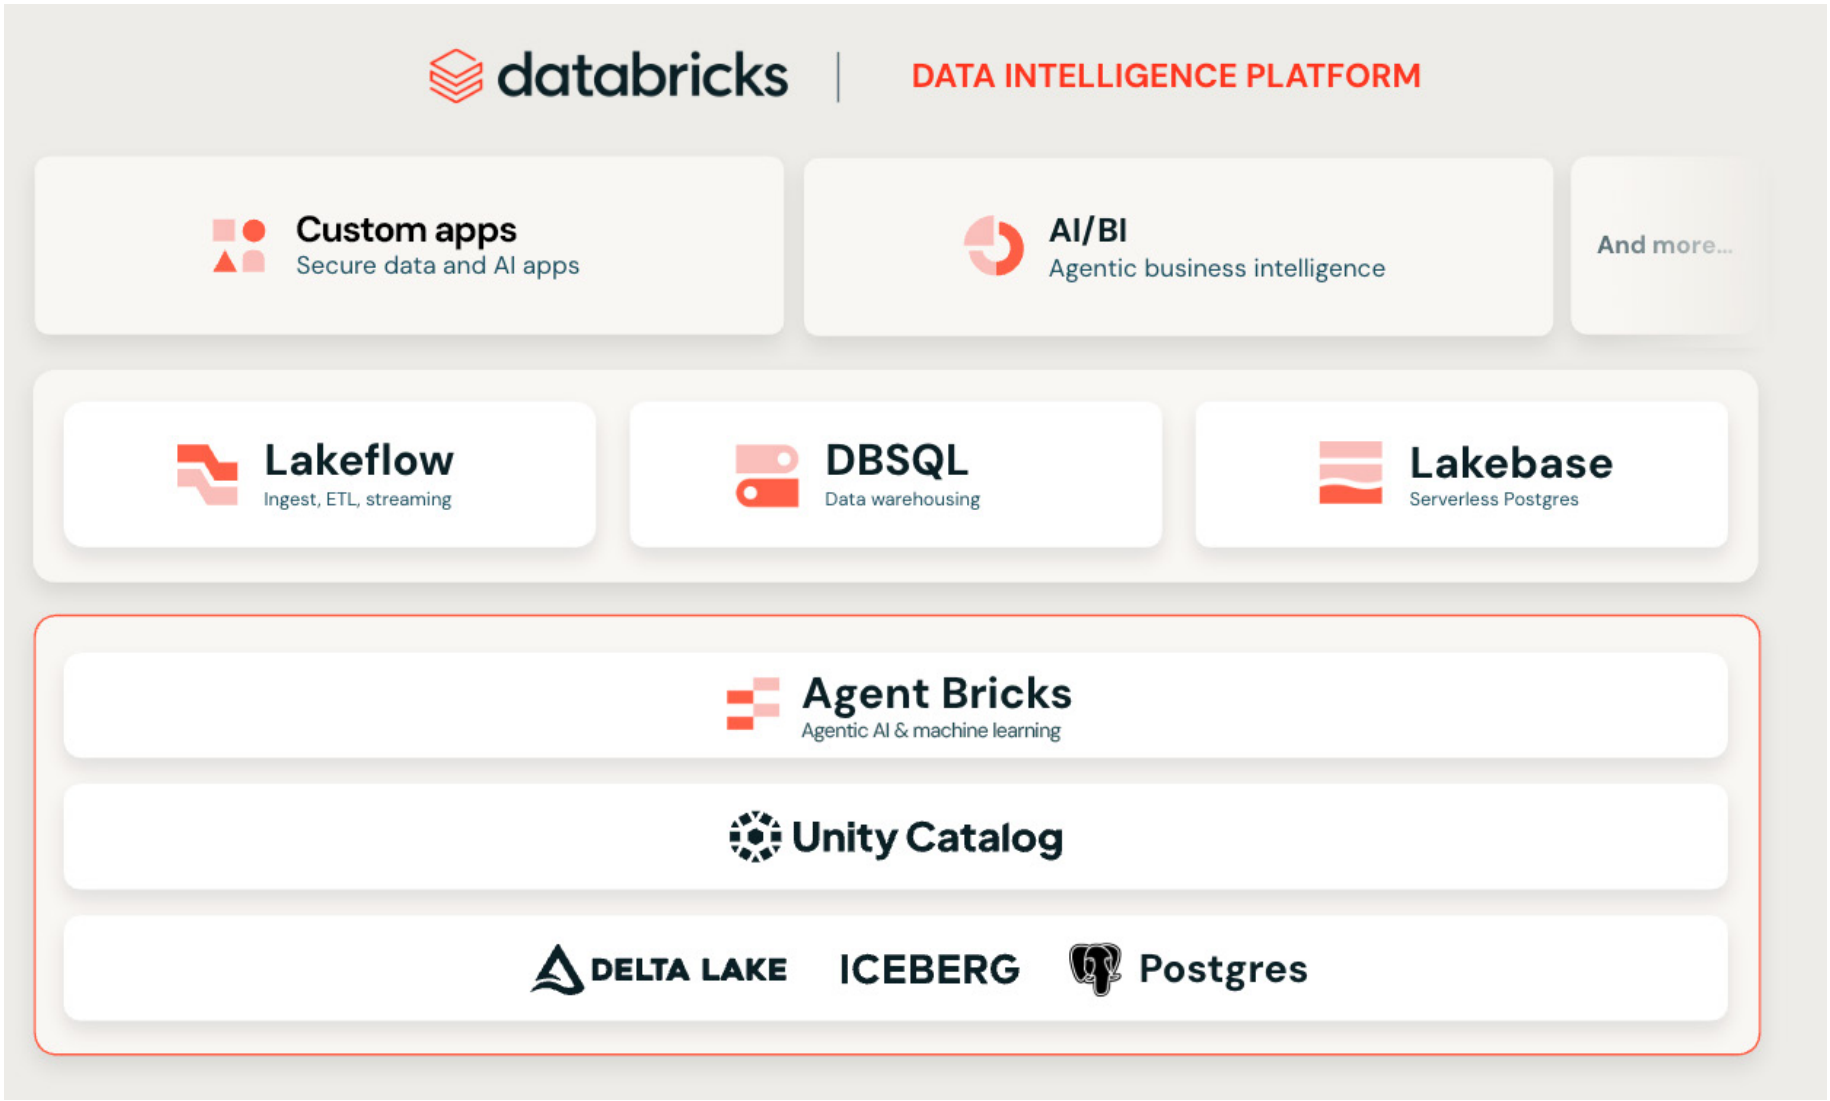
Databricks Apps は、Streamlit、Dash、Flask、FastAPI、Reactなどのオープンソースフレームワークで構築されたウェブアプリケーションを実行するためのServerlessアプリケーションホスティングプラットフォームを提供します。アプリケーションはプラットフォームの組み込みのセキュリティ、コンプライアンス、リソース管理機能を継承します。プロビジョニングのインフラもなく、管理すべきコンテナもなく、スケーリングポリシーの設定もありません。アプリはガバナンスのためにUnity Catalogと自動的に統合され、アプリレベルのアクセスのためのService Principal認証とユーザーレベルの権限に対するユーザー代理認証の両方をサポートします。
Lakebase は、レイクハウスと緊密に統合されたフルマネージドの PostgreSQL データベースです。対話型アプリケーションが必要とする、トランザクション対応で低レイテンシーのデータアクセスを提供すると同時に、Unity Catalog テーブルからデータを自動的に同期します。Lakebase を使用すると、次のことが可能になります:
- 分析知見をアプリケーションにリアルタイムで提供
- アプリケーションの状態とユーザー入力を保存します
- 完全な原子性、一貫性、分離性、耐久性 (ACID) トランザクションをサポート
これらはすべて、カスタムの抽出・変換・ロード(ETL)パイプラインを構築したり、データベースインフラを管理したりせずに実現可能です。
これらの機能を組み合わせることで、可能性が大きく広がります。
| 従来のアプローチ | 最新の DATABRICKS アプリと LAKEBASE のアプローチ |
|---|---|
| 分離されたホスティング インフラストラクチャ | Serverless コンピュートとゼロインフラストラクチャ管理 |
| カスタム認証システム | 組み込みのOAuthとUnity Catalogの統合 |
| 手動のデータ同期パイプライン | Unity Catalogからの自動同期テーブル |
| システム間で断片化されたガバナンス | Unity Catalogによる統合ガバナンス |
| 複雑なマルチツール展開 | Databricks Asset Bundles (DAB) を使用した単一コマンドでのデプロイ |
従来、OLTP システムと OLAP システムを橋渡しするには、複雑なデータエンジニアリングと特注の統合レイヤーが必要でした。アプリケーションをデプロイするには、別々の DevOps チーム、ばらばらの CI/CD パイプライン、手動でのセキュリティ設定が必要でした。Lakebase と Databricks Apps を併用することで、これらの複雑さは大幅に軽減されます。開発者は、トランザクションレイヤーからリアルタイムの分析データに直接アクセスし、インタラクティブなアプリケーションを数ヶ月ではなく数分でデプロイできます。
このガイドの内容
このガイドでは、Databricks 上で本番環境に対応したデータおよび AI アプリケーションを構築するための実践的な手順を説明します。個々の機能に焦点を当てるのではなく、各章で、独自のユースケースに合わせて変更できる実用的なコードを使用し、完全なアプリケーション パターンを順を追って説明します。
以下の方法について説明します。
- ノートブックやプロトタイプから実際のアプリケーションに移行
- トランザクションレイヤーを通じて分析データとアプリケーションの状態を提供する
- カスタムインフラストラクチャなしで、セキュアでガバナンスの効いたアプリケーションを構築
- 再現可能で本番運用に対応したパターンを使用して、アプリケーションをデプロイ・運用します
このガイドを終えれば、Databricksプラットフォーム上でインテリジェントなアプリケーションを自信を持って構築、展開、管理する方法を明確に理解できるはずです。
02 | ノートブックから本番運用アプリケーションへ
執筆者: Pascal Vogel、Evan Pandya、Christopher Pries
本番データアプリケーションの課題
本番運用データアプリケーションの構築は複雑です。アプリのホスト、データベースの管理、システム間のデータ移動には、それぞれ別々のツールが必要になることがよくあります。各レイヤーで、セットアップ、メンテナンス、デプロイのオーバーヘッドが追加されます。
Databricks Data Intelligence Platformは、すべてを単一のプラットフォーム、つまりDatabricks Data Intelligence Platformに統合することで、これを簡素化します。Databricks Appsは、Serverless コンピュート上でWebアプリケーションを実行します。Lakebaseは、Unity Catalogと同期するマネージドPostgresデータベースを提供し、アプリがガバナンスの効いたデータに高速にアクセスできるようにします。また、Databricks Asset Bundles(DABs)を使用すると、コード、インフラストラクチャ、データパイプラインをまとめてパッケージ化し、単一のコマンドでデプロイできます。
この章では、Unity Catalog のデータを Lakebase に同期することから、Databricks プラットフォームでウェブアプリを実行し、DABs でデプロイを自動化するまで、これら 3 つの要素が連携して実際のデータアプリケーションを構築およびデプロイする方法を説明します。
アーキテクチャとその仕組み
このパターンを示すタクシートリップアプリケーションを紹介します。ReactとFastAPIのアプリケーションで、Lakebase同期テーブルから読み込み、Unity Catalog Deltaテーブルから数秒以内に自動データ更新が行われます。
以下の図は、ソリューションアーキテクチャの簡略化されたビューを示しています。
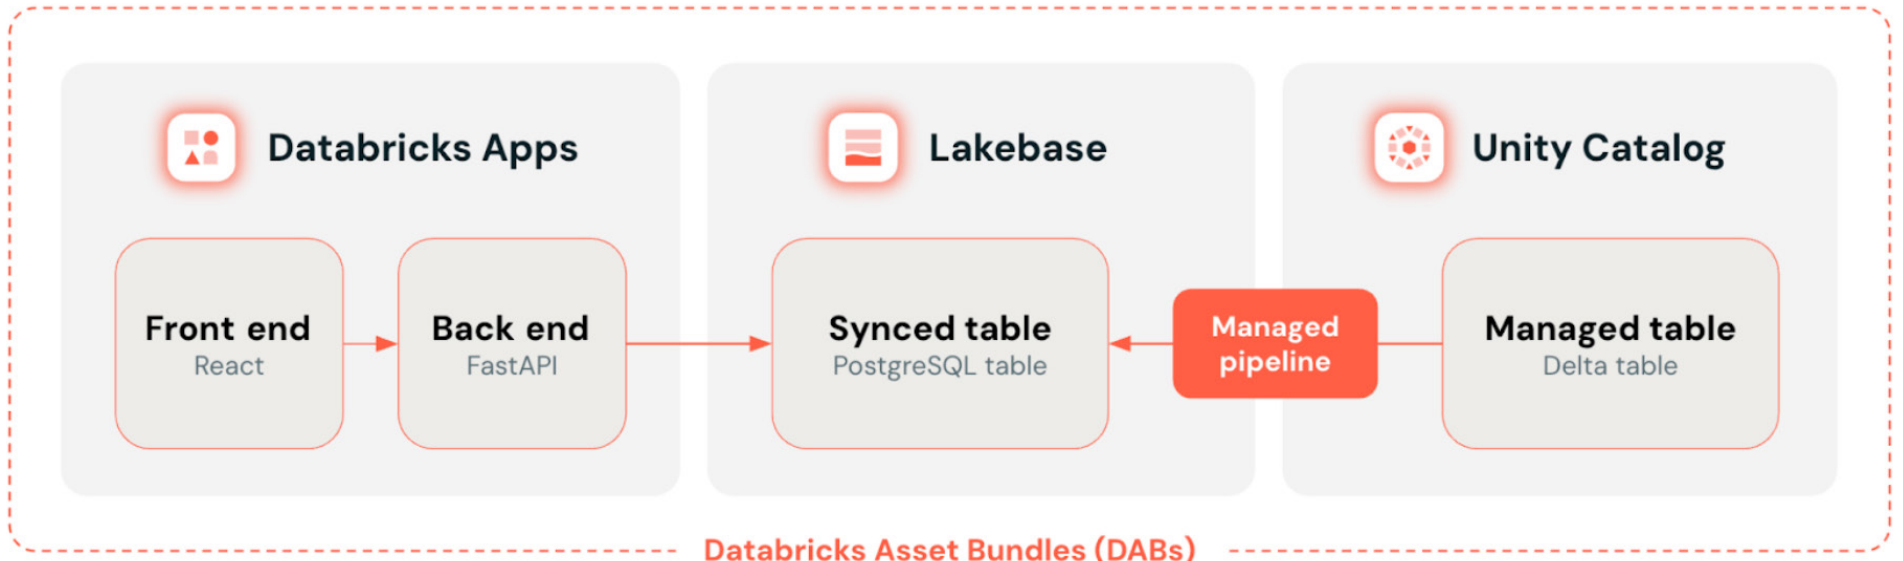
概要として、Databricks Appsはユーザーがデータを探索し、視覚化するためのフロントエンドとして機能します。Lakebaseは、アプリがクエリーを実行するPostgresデータベースを提供し、同期されたテーブルによってUnity Catalogのライブデータに近い状態を維持します。DABは、アプリ、データベース、データ同期といったすべてのリソースを、バージョン管理された1つのユニットとして定義およびデプロイすることで、すべてを統合します。
主なソリューションコンポーネント:
- Databricks アプリ: ユーザーは、React、TypeScript、Vite、FastAPI を使用して構築されたウェブ アプリケーションと対話します。アプリは、Lakebase Postgres データベースに保存されている Unity Catalog 同期テーブルからデータを読み取ります。
- Unity Catalog 同期テーブル: 管理された同期パイプラインを介して Unity Catalog テーブルと自動的に同期され、Lakebase データベース インスタンスで実行される読み取り専用の Postgres テーブルです
- Lakebaseデータベースインスタンス: Lakebaseのストレージとコンピュートを管理し、Databricksアプリが接続するためのPostgres Endpointを提供します
- Unity Catalog テーブル: すべてのデータベースワークスペース で 利用可能なサンプルテーブル である samples.nyctaxi.trips からクローンされた、ニューヨーク市のタクシー乗車データを含む Delta テーブル。
- Databricks Asset Bundles (DAB): アーキテクチャのすべての主要な要素がコードで定義されているバンドル
このサンプルアプリは、最近のタクシー乗車を表とグラフの形式で表示し、新しい乗車を自動的にポーリングします。これは、Unity CatalogのDeltaテーブルをミラーリングするLakebaseの同期テーブルからデータを読み込みます。
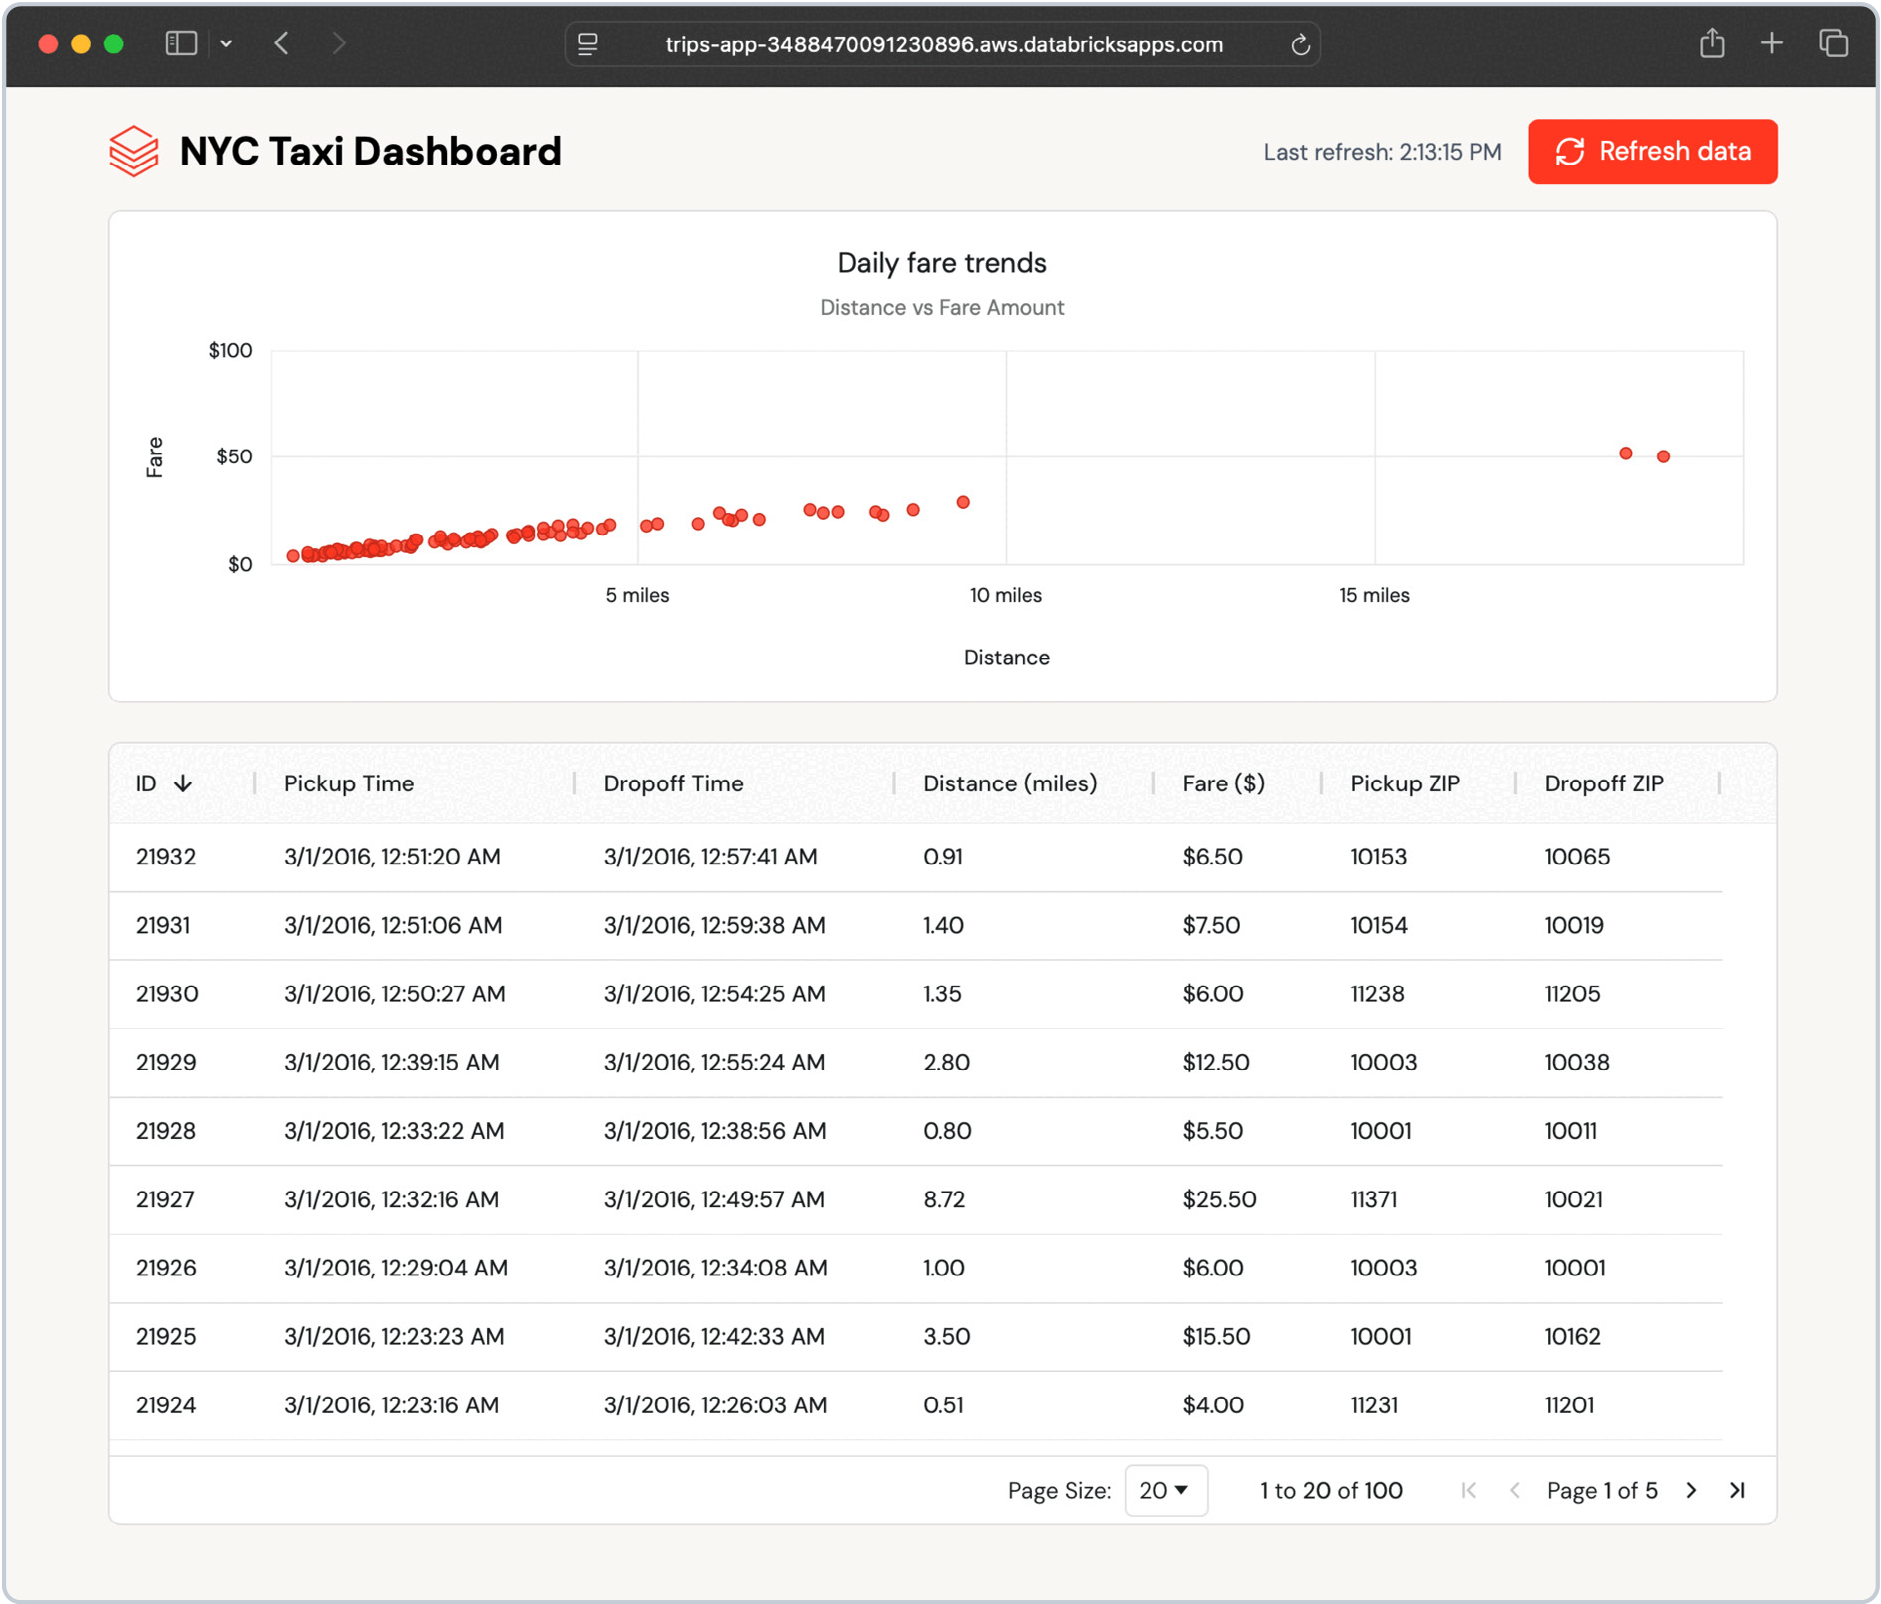
同期されたテーブルが自動的に更新されるため、Unityカタログテーブルの変更は数秒以内にアプリに現れ、カスタムETLは不要です。
ソースのDeltaテーブルに新しいデータを挿入し、同期されたテーブルを更新することで、これをテストできます:
次に、同期された trips_synced テーブルの更新をTriggerします。
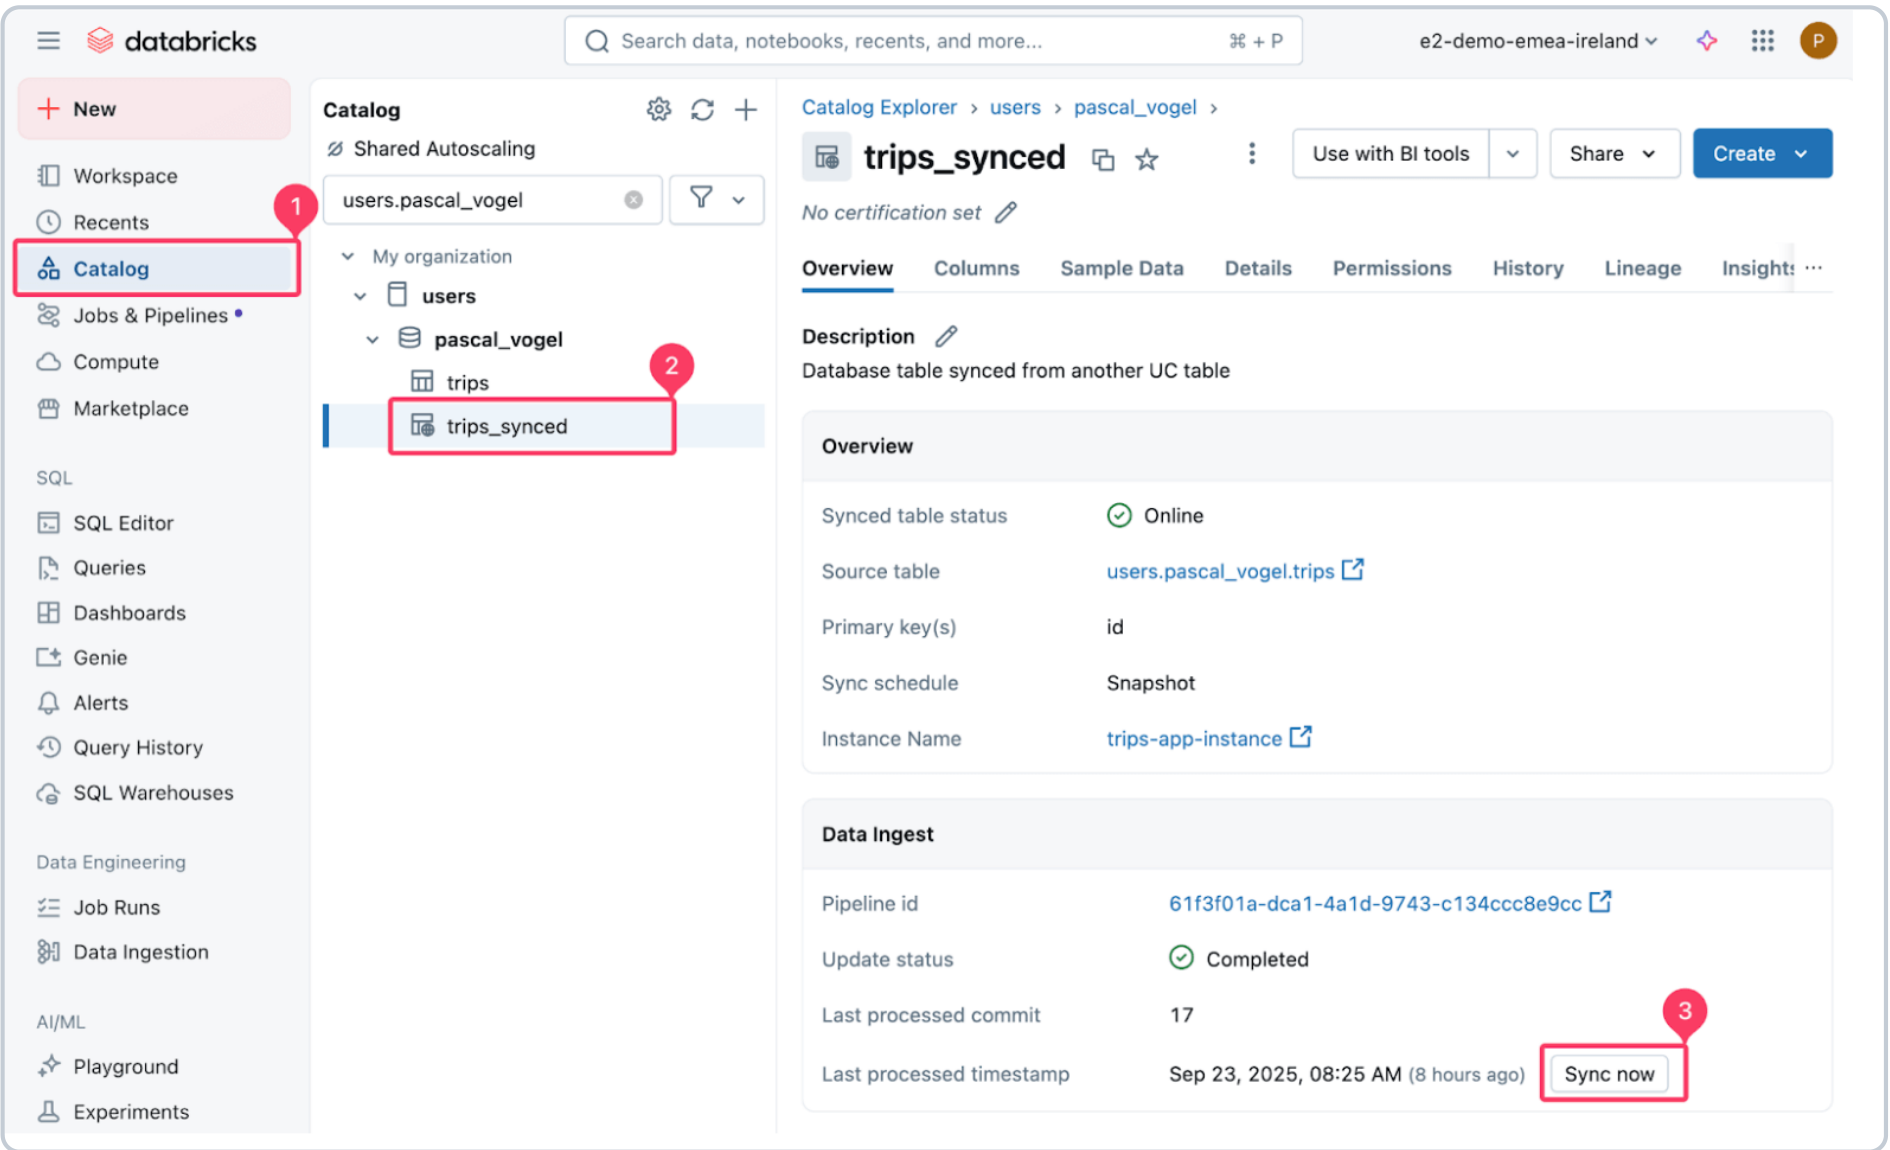
同期を駆動する管理パイプラインは、ソースのDeltaテーブルのスナップショットコピーを作成し、ターゲットのPostgresテーブルに書き込みます。
数秒以内に、新しいレコードがダッシュボードに表示されます。アプリは更新をポーリングし、ユーザーはオンデマンドで更新できるため、Lakebase が追加のエンジニアリングを必要とせずに運用データを最新の状態に保つ様子がわかります。
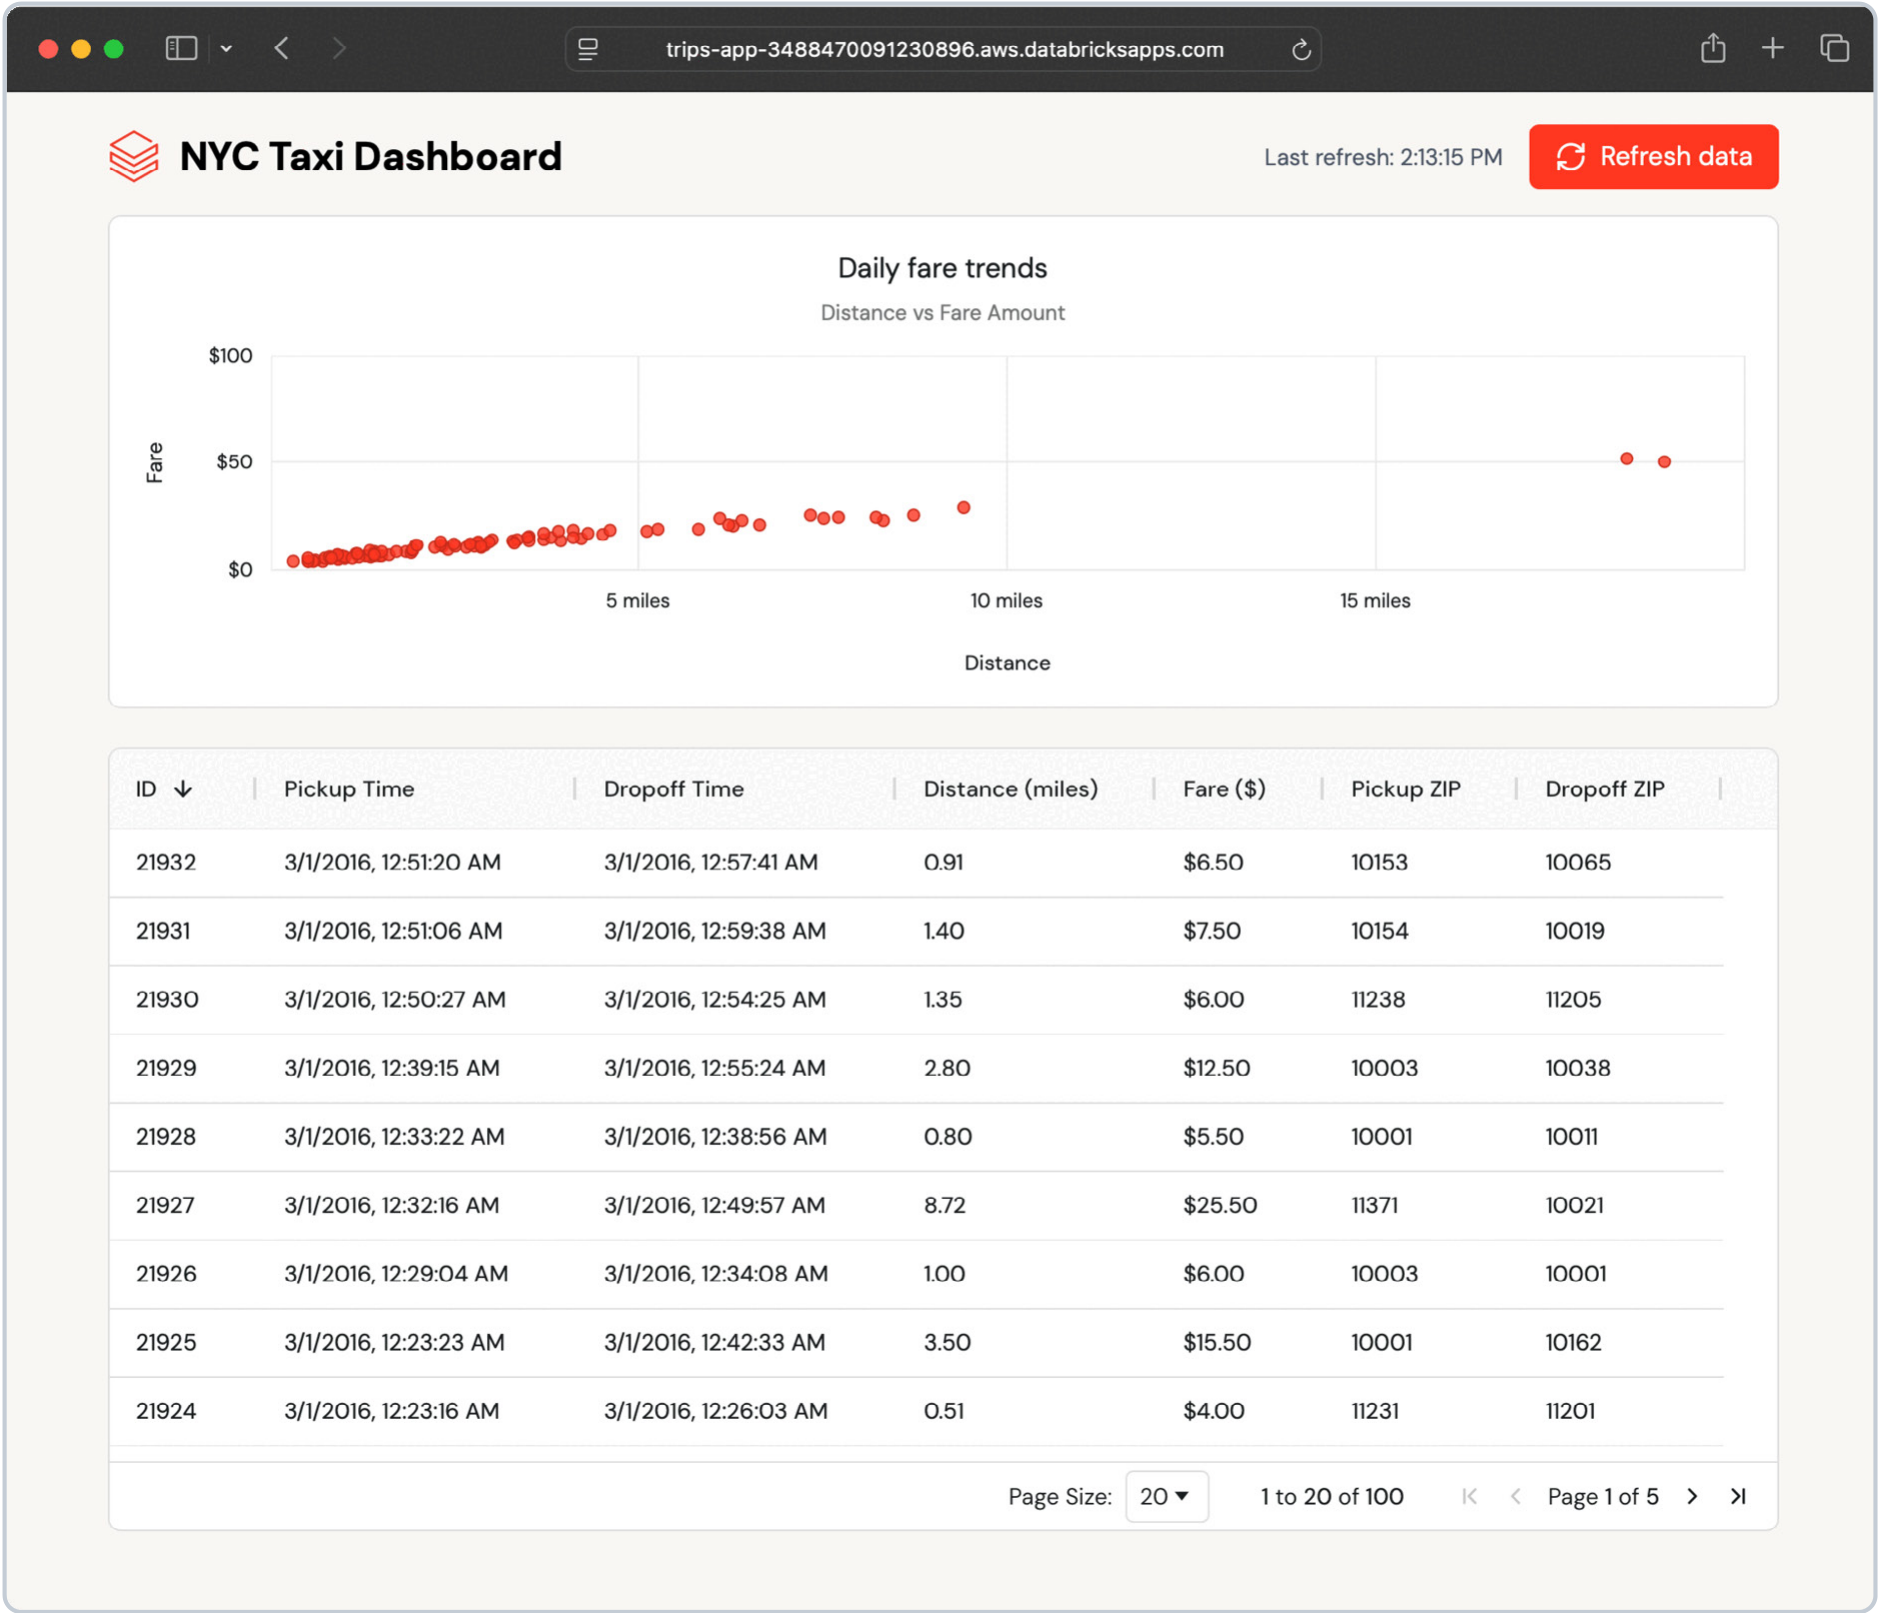
このシームレスなデータフローは、Lakebase同期テーブルがすべての同期を自動的に処理しているため実現しています。
アプリの構造
Databricksアプリでソリューションのさまざまな要素がどのように組み合わさっているかを見ていきましょう。
認証とデータベース接続
各Databricksアプリには、作成時に一意のService PrincipalIDが割り当てられ、これを使用してLakebaseを含む他のDatabricksリソースとやり取りします。
Lakebase は OAuth machine-to-machine (M2M) 認証をサポートしています。アプリは、そのService Principalの認証情報とともに、 Databricks SDK for Python の WorkspaceClient を使用して有効なトークンを取得できます。WorkspaceClient は、1 時間で有効期限が切れる短期間の OAuth トークンの更新を処理します。
アプリは Psycopg Python Postgresアダプターを使ってLakebaseに接続を確立する際にこのトークンを使用します:
Postgresのホスト名とデータベース名は、 Lakebaseリソースを使う際、Databricksアプリの環境変数として自動的に設定されます。
Postgresユーザーは、Databricks Appsにデプロイされた場合はアプリのService Principal、アプリをローカルで実行しているユーザーの場合はそのユーザーのDatabricksユーザー名になります。
RESTful FastAPIバックエンド
アプリのFastAPIバックエンドはこの接続を使ってLakebaseにクエリーし、同期したテーブルから最新のトリップデータを取得します:
FastAPI は、API Endpoint を提供するだけでなく、StaticFiles クラスを使用して静的ファイルを提供することもできます。Vite のビルドプロセスを使用して React フロントエンドをバンドルすることで、FastAPI を使用して提供できる静的ファイルのセットを生成できます。
Reactフロントエンド
ReactフロントエンドがFastAPI Endpointを呼び出してデータを表示します。
このサンプル アプリケーションでは、可視化のために ag-grid と ag-charts を使用し、数秒ごとに新しいデータを自動的にチェックします:
Databricks アセットバンドルリソースの定義
上記に示すすべての Databricks リソースとアプリケーションコードは、単一のソースコードリポジトリ内で DAB として管理できます。これは、すべてのリソースを単一のコマンドで Databricks ワークスペースにデプロイできることも意味します。詳細なデプロイ手順については、GitHub リポジトリを参照してください。
これによりソフトウェア開発ライフサイクルが簡素化され、開発、ステージング、本番運用環境でのCI/CDベストプラクティスを用いた展開が可能になります。
以下のセクションでは、バンドルファイルについてさらに詳しく説明します。
バンドル設定
databricks.yml には、バンドル設定と含まれるリソースの形式で DAB バンドル構成が含まれています。
この例では、開発環境とステージング環境のみを定義しています。
本番運用のユースケースでは、追加の環境を検討してください。より高度な設定例については、Databricks DAB サンプル リポジトリと DABs ドキュメントを参照してください。
LakebaseのセットアップとUnity Catalogとの同期
DABsでLakebaseインスタンスを定義するには、database_instanceリソースを使用します。最低でも、インスタンスのキャパシティフィールドを定義する必要があります。
さらに、Unity Catalog テーブルと Postgres テーブルの間に管理された同期パイプラインを設定する synced_database_table リソースを定義します。
このためには、source_table_full_name を介してソーステーブルを定義します。Unity Catalog のソーステーブルでは、primary_key_columns フィールドで定義された更新を処理するために、一意の (複合) 主キーが必要です。
Lakebase内のターゲットテーブルの場所は、ターゲットデータベースオブジェクト(logical_database_name)とテーブル名(name)によって決まります。
同期されたテーブルはUnity Catalogのオブジェクトでもあります。このリソース定義では、同期テーブルをソーステーブルと同じカタログおよびスキーマに、databricks.ymlで定義されたDAB変数を用いて配置します。これらのdefaultを異なる 変数 値 を設定する ことで上書きできます。
このユースケースでは、SNAPSHOT 同期モードを使用します。利用可能なオプションについては、この章の「考慮事項とベストプラクティス」セクションを参照してください。
Databricks Apps リソース
DABはDatabricks Appsのコンピュートリソースとアプリケーションのソースコードを一つのバンドルとして 定義することを可能にします。これにより、Databricksのリソース定義とソースコードの両方を単一のリポジトリにまとめて管理できます。私たちの場合、FastAPIとViteに基づくアプリのソースコードはプロジェクトのトップレベルのアプリディレクトリに保存されています。
この設定は、database.ymlリソース定義で定義されたdatabase_nameとinstance_nameを動的に参照します。
データベースは、DABsで定義できるサポート対象のアプリリソースです。データベースをアプリリソースとして定義することで、Lakebaseインスタンスとやり取りする際にアプリのService Principalが使用するPostgresのロールが自動的に作成されます。
考慮事項とベストプラクティス
モジュール式で再利用可能なバンドルを作成する
この例では開発環境とステージング環境にデプロイしますが、DABsを使用すると、開発ライフサイクルに合わせて複数の環境を簡単に定義できます。Azure DevOps、GitHub Actions、またはその他のDevOpsプラットフォームでCI/CDパイプラインを設定することで、これらの環境全体へのデプロイを自動化します。
DABs の 置換と変数を使用して、環境固有の構成を定義します。たとえば、開発用と本番運用に異なる Lakebase インスタンスの容量構成を定義して、コストを削減できます。同様に、同期テーブルに対して異なる Lakebase 同期モードを定義し、環境固有のデータ レイテンシー要件を満たすことができます。
Lakebaseの同期モードを選択し、パフォーマンスを最適化してください
適切なLakebase 同期モード を選ぶことが、コストとデータの新鮮さのバランスを取る鍵となります。
| スナップショット | トリガー済み | 継続 | |
|---|---|---|---|
| 更新方法 | 各ランでのテーブル全体の置換 | 初回フルコピーと増分変更 | 初期ロードとリアルタイムのストリーミング更新 |
| 性能 | 他のモードよりも10倍効率的 | コストとパフォーマンスのバランス | コストが高い - 継続的に稼働 |
| レイテンシー | 高レイテンシー — スケジュールまたは手動 | 中程度の遅延 — オンデマンド | 最低遅延 — リアルタイム、~15秒 |
| 最適な用途 |
|
|
|
| 制限事項 |
|
|
|
マネージド同期パイプラインの通知を設定して、障害発生時にアラートを受け取るようにします。
クエリーのパフォーマンスを向上させるには、適切なインスタンス容量を選択して、Lakebase データベースインスタンスのサイズを適正化してください。Postgres の同期テーブルに、クエリーパターンに一致するインデックスを作成し、プリインストールされているpg_stat_statements 拡張機能を使用してクエリーパフォーマンスを調査することを検討してください。
アプリの本番運用に向けた準備
このサンプルアプリケーションは、Lakebaseから最新のデータを取得するために、ポーリングベースのアプローチを実装しています。要件に応じて、WebSocketsやサーバー送信イベントを使用したプッシュベースのアプローチを実装して、サーバーリソースをより効率的に使用し、データ更新のタイムリー性を高めることもできます。
アプリのユーザー数が増加しても対応できるように、FastAPIバックエンドによるデータベース操作のTriggerを減らすには、クエリー結果をインメモリにキャッシュするfastapi-cacheのようなキャッシュの実装をご検討ください。
認証と認証にはOAuth 2.0を使用してください。レガシーのパーソナルアクセストークン(PAT)に頼らないでください。ローカルマシンでの開発中は、Databricksコマンドラインインターフェース(CLI)を使って OAuth U2M認証 を設定し、LakebaseなどのライブDatabricksリソースとシームレスに連携させましょう。
同様に、デプロイされたアプリは、関連付けられたService Principalを OAuth M2M に使用して、他の Databricks サービスで認証と認可を行います。または、アプリのユーザー承認を設定して、アプリユーザーに代わってDatabricksリソースでアクションを実行することもできます。
その他の一般的なベストプラクティスとセキュリティのベストプラクティスについては、DatabricksアプリのドキュメントにあるDatabricksアプリのベストプラクティスも参照してください。
まとめ
本番運用データアプリケーションを構築するからといって、展開、データ同期、インフラ管理のための別々のツールを同時に管理する必要はないはずです。Databricks Appsは、インフラストラクチャ管理なしでPythonやNode.jsアプリケーションを動かすServerlessコンピュートを提供します。Lakebase 同期テーブルはUnityカタログのDeltaテーブルからPostgresへ低遅延データを自動的に提供し、カスタムETLパイプラインを排除します。DAB(データアクセスバンドル)は、アプリケーションコード、インフラストラクチャ定義、データ同期構成を単一のバージョン管理されたバンドルにパッケージ化することで、これらすべてを統合し、環境間で一貫したデプロイを可能にします。
デプロイの複雑さは勢いを削ぎます。変更を迅速かつ自信を持ってシップできないと、イテレーションが遅くなり、環境driftが発生し、チーム間の調整に時間を浪費することになります。DABsを使用してアプリケーションスタック全体をコードとして扱うことで、次のようになります:
- CI/CDオートメーションを有効にする
- 開発、ステージング、本番運用の各環境で一貫したデプロイを確保します
- チームがデプロイパイプラインと格闘するのではなく、機能の構築に集中できるようにします
これにより、通常の導入面での頭痛を避けてプロトタイプから本番運用へ移行できます。
完全なサンプルは、ステップバイステップのデプロイ手順とともにGitHubリポジトリで入手できます。
始めましょう
Lakebase、Databricks Apps、DABsについての詳細は、Databricksドキュメントをご覧ください。Databricks Appsに関するその他の開発者向けリソースについては、Databricks Apps CookbookおよびCookbook resource collectionをご覧ください。
03 | インテリジェントアプリケーションのためのトランザクション基盤
執筆者: Jasper Puts と Antonio Javier Samaniego Jurado
はじめに
従来の方法で社内ツールやAI搭載アプリケーションを構築すると、開発者は反復的でエラーが発生しやすいタスクの迷路に迷い込むことになります。まず、専用のPostgresインスタンスを立ち上げ、ネットワーキング、バックアップ、モニタリングを設定し、その後、使用しているフロントエンドフレームワークにそのデータベースを接続するために数時間、あるいは数日を費やす必要があります。さらに、カスタム認証フローを作成し、きめ細かい権限をマッピングし、UI、APIレイヤー、データベース全体でそれらのセキュリティ制御を同期させる必要があります。各アプリケーションコンポーネントは、マネージドクラウドサービスから自己ホスト型のVMまで、それぞれ異なる環境に存在します。このため、開発者は、それぞれ異なるデプロイメントパイプライン、環境変数、資格情報ストアをやりくりしなければならなくなります。その結果、スタックが分断され、スキーマの移行や新しいロールの追加といった1つの変更が複数のシステムに波及し、手動での更新、大規模なテスト、絶え間ない調整が必要となります。このようなオーバーヘッドはすべて、開発者の注意を、製品のコア機能とインテリジェンスの構築という真の付加価値からそらしてしまいます。
Databricks LakebaseとDatabricks Appsにより、アプリケーションスタック全体がレイクハウスと共に一元管理されます。Lakebaseは、分析およびAIワークロードを支える基盤のレイクハウス テーブルと統合された、低レイテンシの読み取りと書き込みを提供するフルマネージドのPostgresデータベースです。
Databricks AppsはUIにServerlessランタイムを提供し、組み込みの認証、細かい権限、ガバナンスコントロールも備えており、これらはLakebaseが提供するデータに自動的に適用されます。これにより、複数のプラットフォームをつなぎ合わせたり、データベースを同期したり、パイプラインを複製したり、システム間のセキュリティポリシーを調整したりすることなく、トランザクション状態、アナリティクス、AIを組み合わせたアプリを簡単に構築・展開できます。
なぜ Lakebase と Databricks アプリなのか
LakebaseとDatabricks Appsは連携して、Databricks Platformでのフルスタック開発を簡素化します:
- Lakebase は、高速な読み取り、書き込み、更新が可能なフルマネージドの Postgres データベースを提供し、さらにブランチングやポイントインタイムリカバリなどの最新の機能も備えています。
- Databricks Appsは、アプリケーションのフロントエンドにServerlessランタイムを提供し、組み込みのIDアクセス制御、Unity Catalogやその他のlakehouseコンポーネントとの統合も備えています。
この2つを組み合わせることで、個別のインフラを管理することなく、Lakebaseで状態を保存・更新し、lakehouseで統制されたデータにアクセスし、安全なServerless UIを介してすべてを提供できるインタラクティブなツールを構築できます。次の例では、このセットアップを使用して簡単な休暇申請承認アプリを構築する方法を紹介します。
はじめに: Lakebase を使用したトランザクションアプリの構築
このウォークスルーでは、マネージャーがチームからの休暇申請をレビューして承認するのに役立つ、シンプルなDatabricksアプリの作成方法を説明します。このアプリはDatabricksアプリを使用して構築されており、バックエンドデータベースとしてLakebaseを使用して申請を保存および更新します。
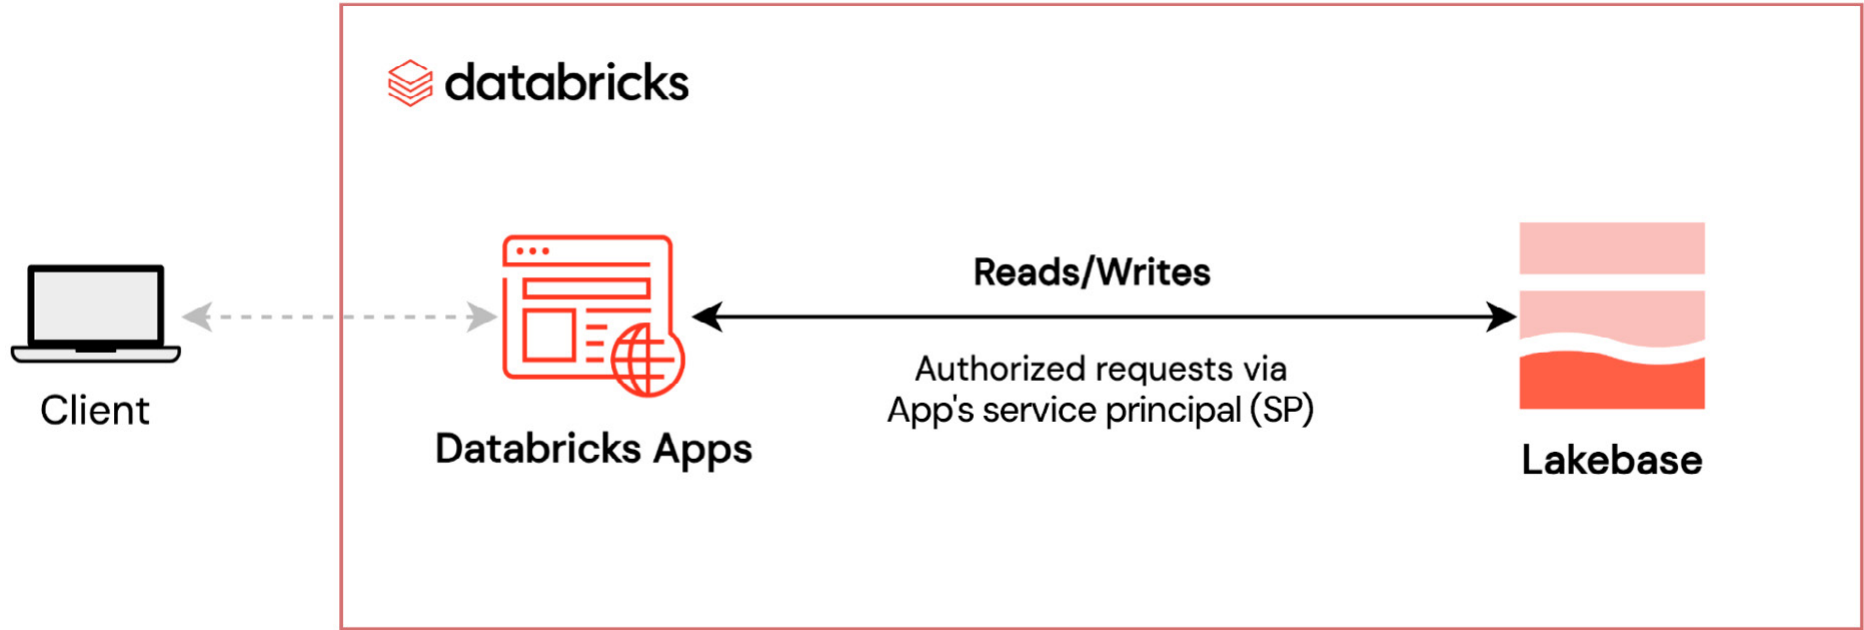
このソリューションの内容:
- Lakebaseデータベースのプロビジョニング
数回クリックでServerlessのPostgres OLTPデータベースを構築できます。 - 2. Databricks appの作成
StreamlitやDashなどのPythonフレームワークを使用して、Lakebaseへの読み取りと書き込みを行うインタラクティブなアプリを構築します。 - スキーマ、テーブル、アクセス制御の設定
必要なテーブルを作成し、アプリのクライアント ID を使用して、アプリにきめ細かい権限を割り当てます。 - Lakebase に安全に接続して操作する
Databricks SDK と SQLAlchemy を使用して、アプリコードから Lakebase への読み取りと書き込みを安全に行います。
このウォークスルーは、最小限の動作例を使ってすぐに始められるように設計されています。後で、より高度な設定に拡張できます。
ステップ1:レイクベースの提供
アプリを構築する前に、Lakebaseデータベースを作成する必要があります。これを行うには、コンピュート tabに移動し、OLTP Databaseを選択して、名前とサイズを指定します。これにより、Serverless の Lakebase インスタンスが作成されます。この例では、データベースインスタンスの名前をlakebase-demo-instanceとします。
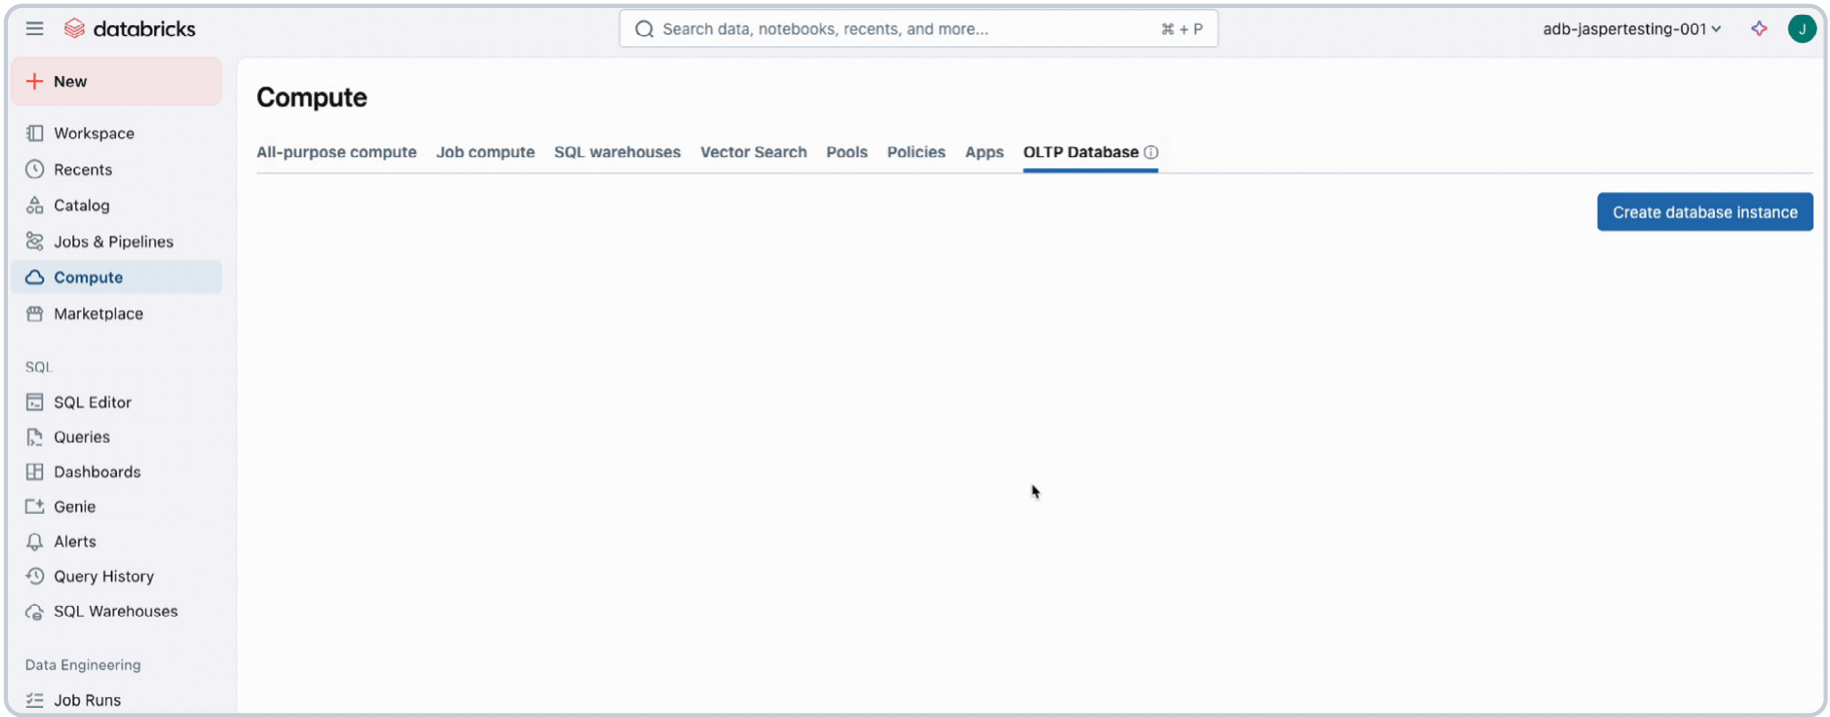
ステップ2: Databricksアプリを作成し、データベースアクセスを追加する
データベースができたので、それに接続するDatabricksアプリを作成しましょう。空のアプリから始めるか、Template(例: Streamlit、Flask)を選択できます。アプリに名前を付けた後、データベースをリソースとして追加します。この例では、事前に作成されたdatabricks_postgresデータベースが選択されています。
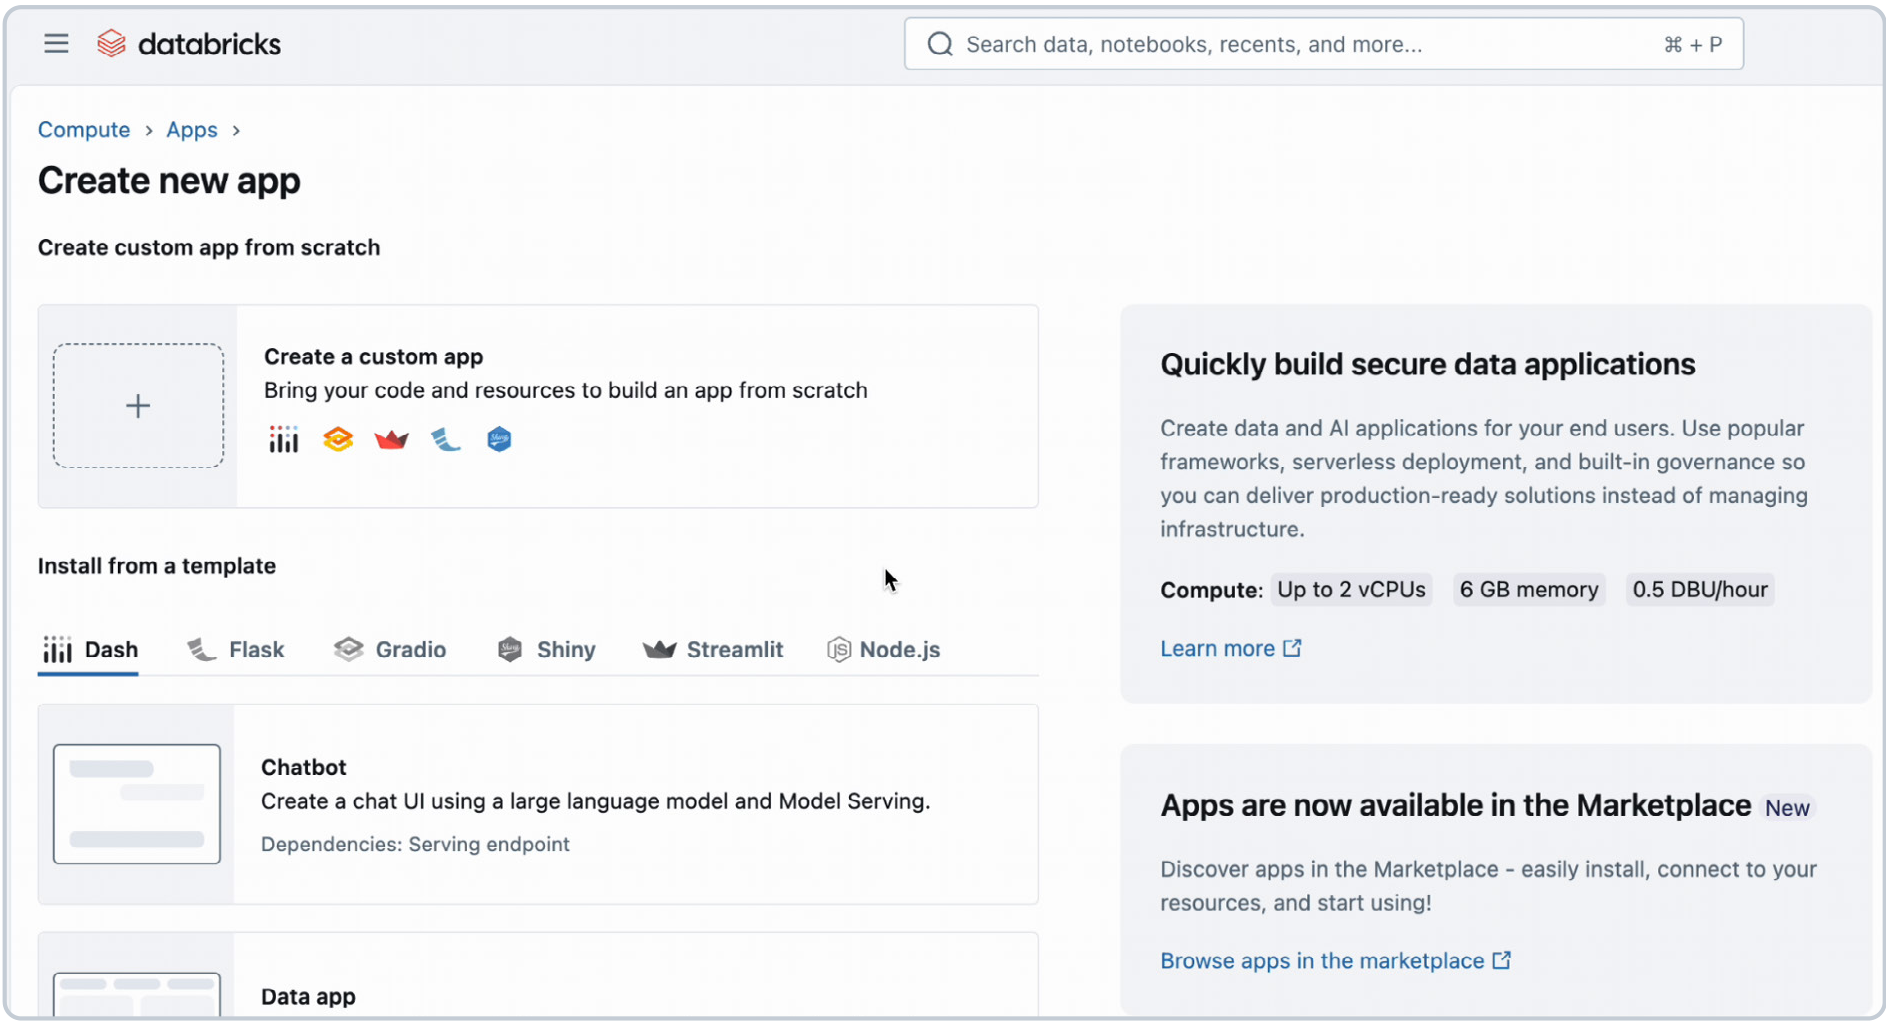
データベース リソースを自動的に追加する:
- アプリに CONNECT 権限と CREATE 権限を付与します
- アプリのクライアントIDに紐付けられたPostgresロールを作成します。
このロールは、後でテーブルレベルのアクセス権を付与するために使用されます。
ステップ3:スキーマの作成、テーブルの定義、権限の設定
データベースがプロビジョニングされ、アプリが接続されたら、スキーマを作成し、アプリが使用するテーブルを定義できます。

- アプリのクライアントIDを取得する
アプリの Environment tabから、DATABRICKS_CLIENT_ID変数の値をコピーします。これは助成金申請書の申請に必要です。 - Open the Lakebase SQL editor
Go to your Lakebase instance and click 新しいクエリー.これにより、データベースEndpointが既に選択された状態でSQLエディタが開きます。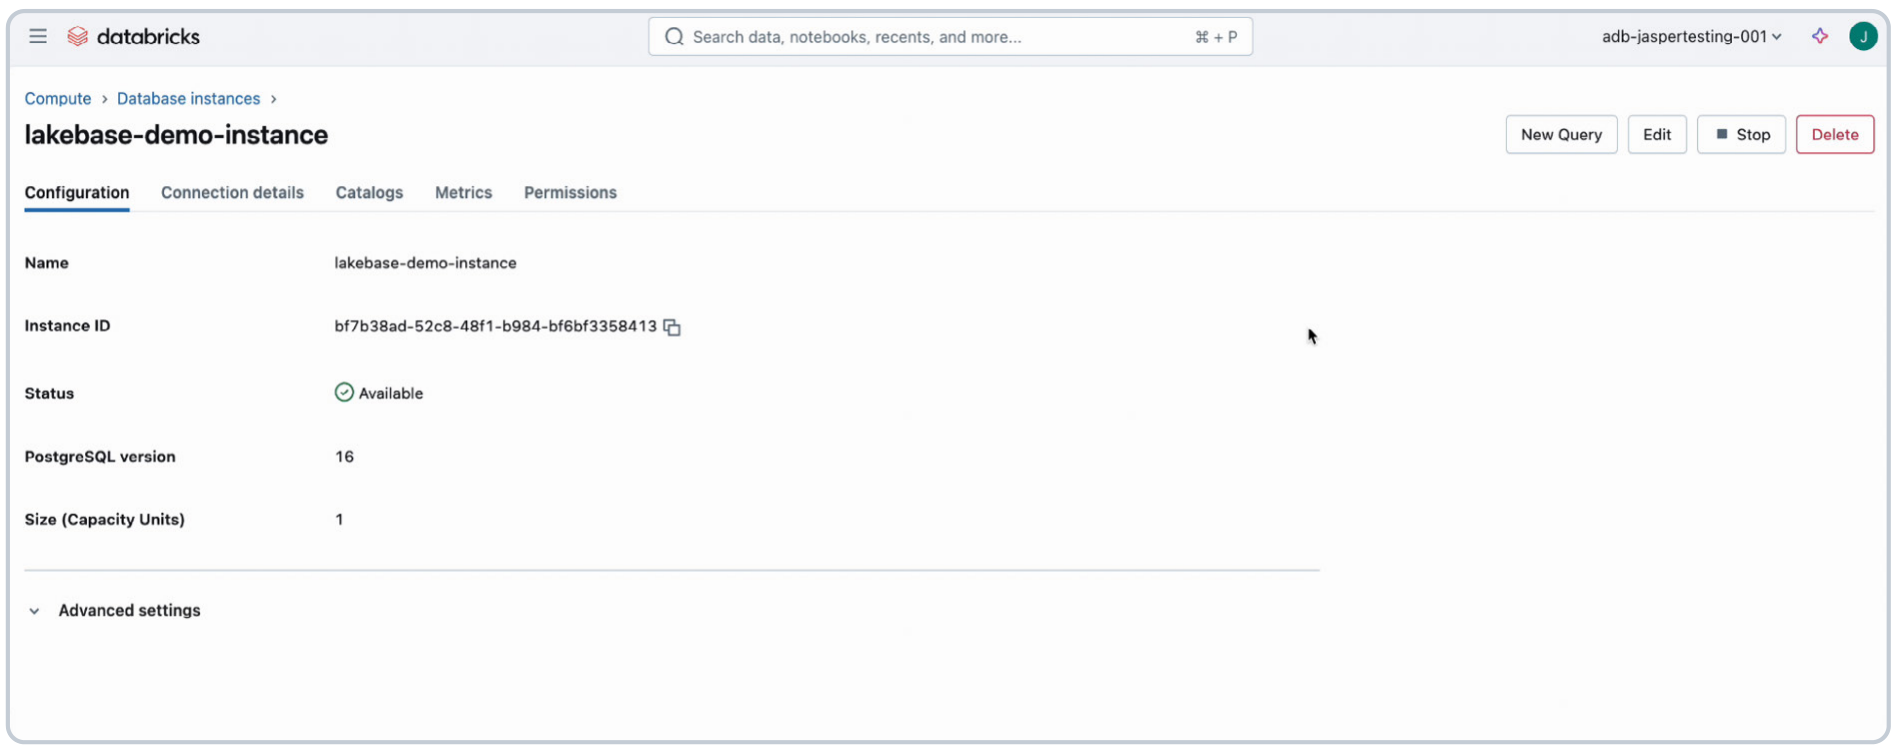
次の SQL を実行します:
SQLエディタを使用するのは、このプロセスを実行するための迅速かつ効果的な方法ですが、大規模なデータベーススキーマの管理は、バージョン管理、コラボレーション、自動化をサポートする専用ツールで対応するのが最適です。FlywayやLiquibaseなどのツールを使用すると、スキーマの変更を追跡し、CI/CDパイプラインと統合して、データベース構造がアプリケーションコードと共に安全に進化するようにできます。
ステップ 4: アプリをビルドする
権限が設定されたので、アプリを構築できます。この例では、アプリはLakebaseから休暇申請を取得し、マネージャーがそれらを承認または拒否できるようにします。更新は同じテーブルに書き戻されます。
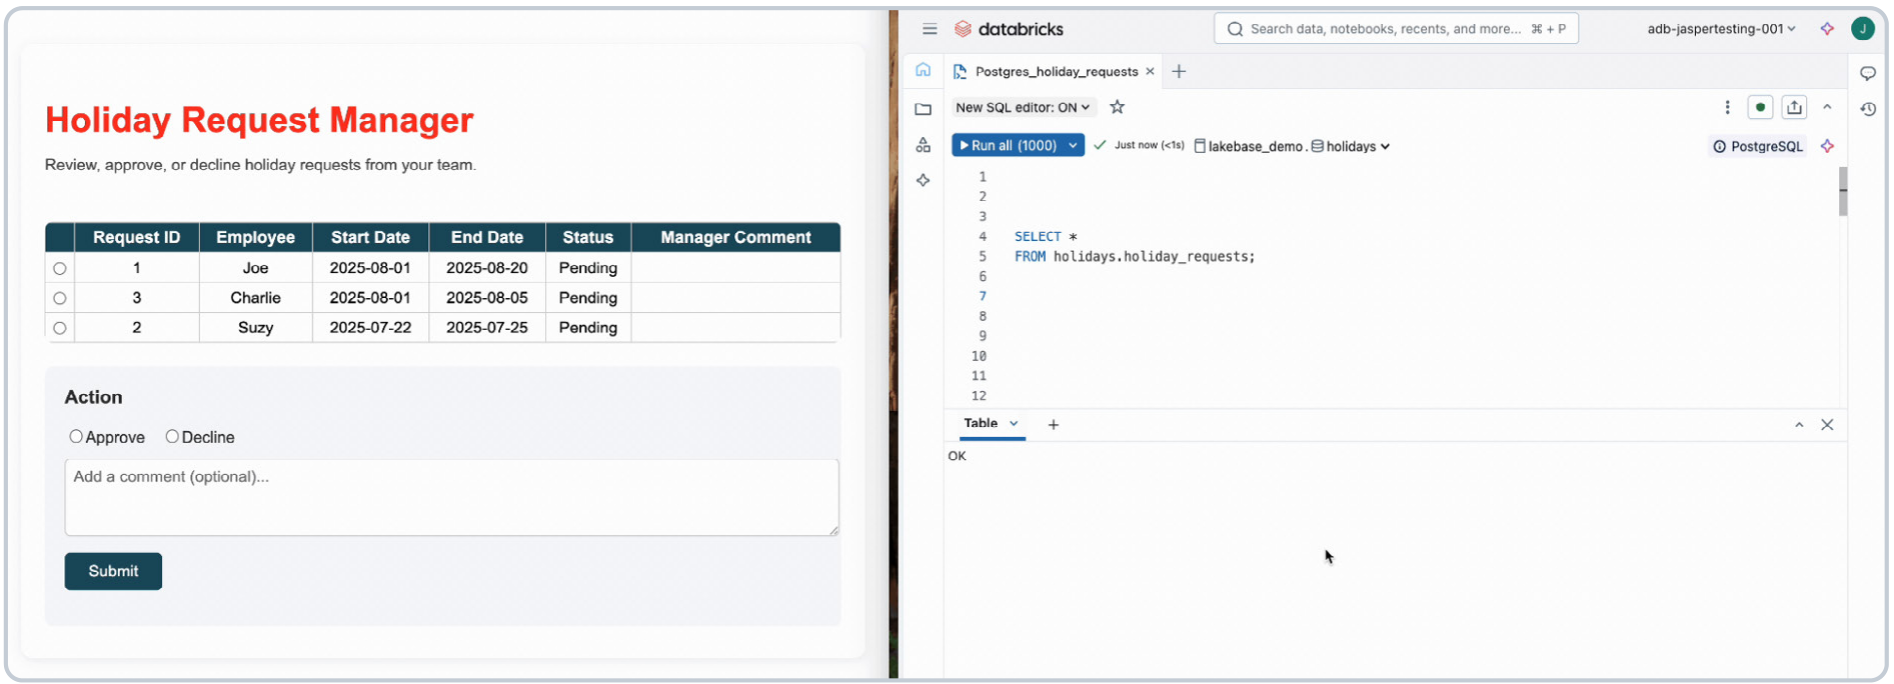
ステップ5: Lakebaseに安全に接続する
SQLAlchemy と Databricks SDK を使用して、安全なトークンベースの認証でアプリを Lakebase に接続します。Lakebase リソースを追加すると、PGHOST と PGUSER が自動的に公開されます。SDKがトークンのキャッシュを処理します。
ステップ6: データの読み取りと更新
次の関数は、休暇申請テーブルの読み取りと更新を行います:
これらのコード スニペットは、Streamlit、Dash、Flask などのフレームワークと組み合わせて、Lakebase からデータを取得し、アプリで視覚化するために使用できます。必要な依存関係がすべてインストールされるように、アプリの requirements.txt ファイルに必要なパッケージを追加してください。コード スニペットでは、以下のパッケージが使用されています。
Extending the Lakehouse with Lakebase
Lakebaseは、フルマネージドのOLTPデータベースをプラットフォームに直接統合することで、レイクハウスにトランザクション機能を追加します。これにより、読み取りと書き込みを必要とするアプリケーションを構築する際に、外部データベースや複雑なパイプラインが不要になります。
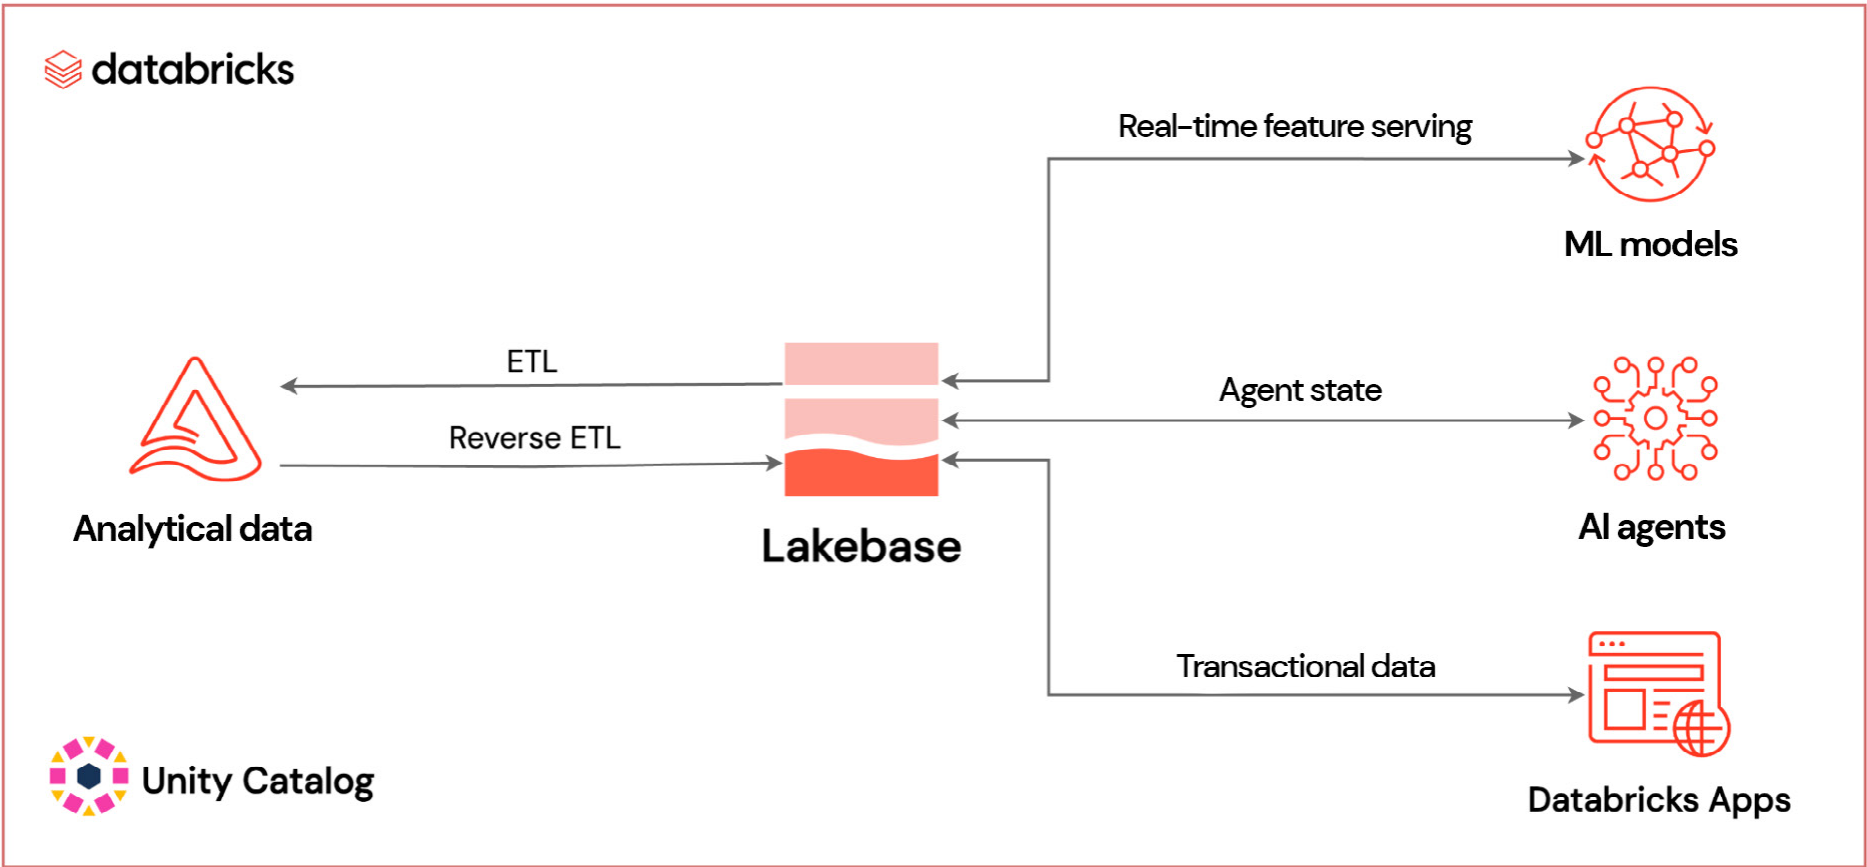
LakebaseはDatabricksとネイティブに統合されており、データ同期、本人認証、ネットワークセキュリティなど、湖の他のデータ資産と同様に対応しています。そのため、システム間でデータを移動するためにカスタムETLやリバースETLは必要ありません。例をいくつかご紹介します。
- オンライン特徴量ストアと同期テーブルを使用すると、分析特徴量をリアルタイムでアプリケーションに提供できます
- 運用データを Delta テーブルと同期して、ヒストリカルデータ分析などに使用できます
これらの機能により、次のような本番運用レベルのユースケースのサポートが容易になります:
- AI エージェントにおける状態の更新
- リアルタイムワークフローの管理 — 例: 承認、タスクルーティング
- 推奨システムや価格設定エンジンにライブデータを取り込む
Lakebase は、パーソナライズされた推奨、チャットボット アプリケーション、ワークフロー管理ツールなどのアプリケーションで、すでにさまざまな業界で使用されています。
まとめ
Lakebaseは、Databricksアプリとシームレスに連携し、Lakehouseのデータと簡単に統合できるトランザクショナルなPostgresデータベースを提供します。外部OLTPシステムや手動統合ステップを排除することで、フルスタックのデータおよびAIアプリケーションの開発を簡素化します。
すでにDatabricksをアナリティクスやAIに使っている場合、Lakebaseはアプリケーションにリアルタイムのインタラクティビティを追加しやすくします。低遅延トランザクションのサポート、組み込みのセキュリティ、Databricks Appsとの緊密な統合により、プラットフォームを離れることなくプロトタイプから本番運用へと移行できます。
この例では、以下の方法を紹介します。
- Lakebase インスタンスをセットアップしてアクセスを設定します
- Lakebase への読み書きを行う Databricks アプリを作成する
- 最小限の設定で、安全なトークンベース認証を使用します。
- Python と SQL を使用して、休暇申請を管理するための基本的なアプリを構築する
使用方法と価格の詳細については、Lakebase と Databricks Apps のドキュメントを参照してください。
04 | アナリティクスをアプリケーションに
はじめに:アナリティクスと運用が融合しています
今日のアプリケーションは、生のイベントデータだけに頼ることはできない。彼らは、パーソナライズ、自動化、インテリジェントなユーザー体験を実現するために、湖畔の建物からキュレーションされた文脈的かつ実用的なデータを必要としています。
そのデータを低遅延で確実に提供することは課題であり、複雑なパイプラインやカスタムインフラを必要とすることが多いです。
リバースETLとは何ですか?
リバースETLは、レイクハウスからの高品質データをアプリケーションを動かす運用システムに同期します。これにより、信頼できるデータセットやAI駆動の知見が、パーソナライズ、推薦、不正検出、リアルタイム意思決定を可能にするアプリケーションに直接流れ込むことが可能になります。
リバースETLがなければ、知見はlakehouseに留まり、それを必要とするアプリケーションに届きません。レイクハウスは、データのクレンジング、エンリッチ、アナリティクスへの変換が行われる場所ですが、低レイテンシのアプリ操作やトランザクションワークロード向けには構築されていません。そこでLakebaseの出番です。アクションにつながるツールに、信頼できるレイクハウスのデータを直接配信します。
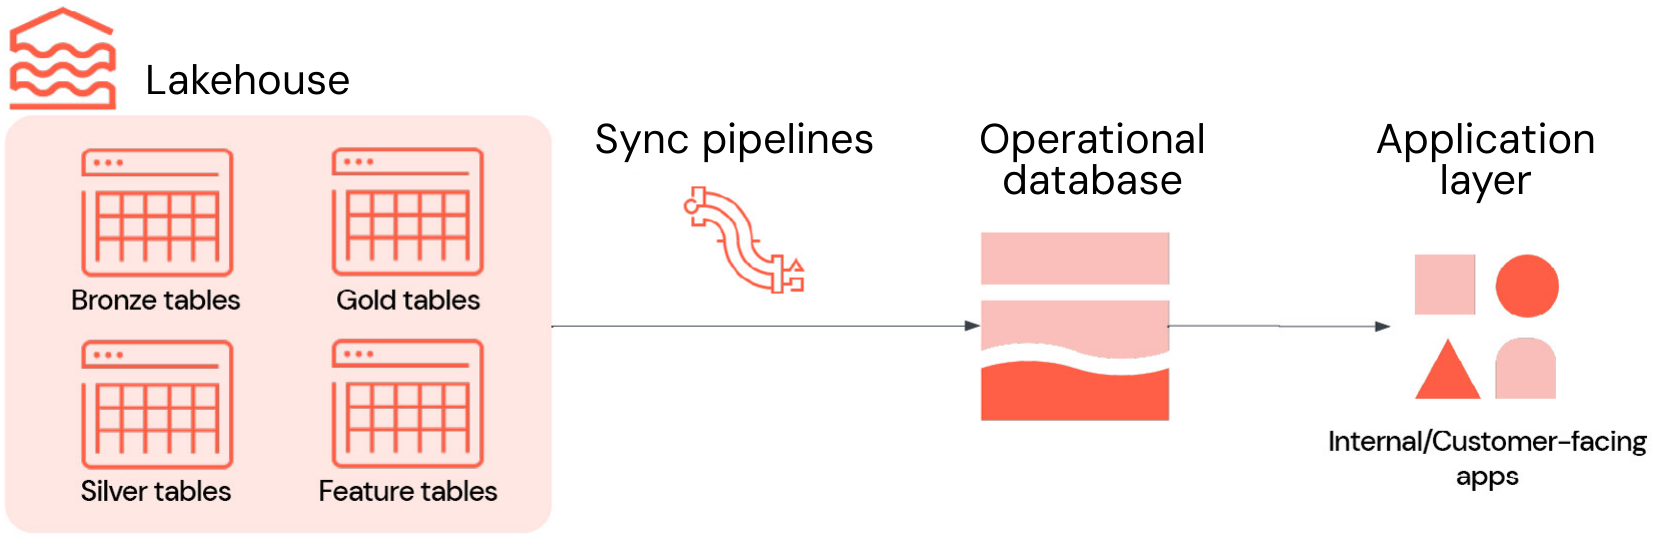
実際には、リバースETLは通常、Lakebaseに統合された4つの主要なコンポーネントで構成されます。
- Lakehouse: ビジネスレベルの集計テーブル(ゴールドテーブルとも呼ばれる)、加工済み特徴量、機械学習推論出力など、意思決定を促進するために使用される、キュレーションされた高品質なデータを格納します。
- パイプラインの同期: スケジューリング、新鮮度保証、モニタリングをもとに関連データを運用ストアに移行します
- オペレーショナルデータベース: high concurrency、低レイテンシー、ACIDトランザクションに最適化されています
- アプリケーション: 顧客向けのアプリケーション、社内ツール、APIs、ダッシュボードなど、知見がアクションに変わる最終的な宛先として機能します。
Reverse ETLの課題
リバースETLはシンプルに見えますが、実際にはほとんどのチームが次のような課題に直面します。
- 脆弱なカスタムビルドのETLパイプライン: 多くの場合、ストリーミングインフラストラクチャ、スキーマ管理、エラー処理、オーケストレーションが必要です。これらは脆弱で、維持にリソースを大量に消費します。
- 複数の分離したシステム: アナリティクスと運用のための別々のスタックは、管理すべきインフラや認証層の増加、フォーマットミスマッチのリスク増加を生み出します
- 一貫性のないガバナンスモデル: 分析システムと運用システムはしばしば異なる政策領域に存在するため、一貫した品質管理や監査ポリシーの適用が困難です
これらの課題は、開発者とビジネスの両方にとって摩擦を生じさせ、データを確実にアクティブ化し、インテリジェントなリアルタイムアプリケーションを提供する取り組みを遅らせます。
Lakebase :defaultで統合され、簡単にリバースETLが利用できます
Lakebaseはこれらの障壁を取り除き、リバースETLをフルマネージドの統合ワークフローに変換します。高性能のPostgresエンジン、lakehouseとの緊密な統合、組み込みのデータ同期を組み合わせることで、追加のインフラストラクチャなしで、新しい知見をアプリケーションに反映させることができます。
Lakebaseのこれらの機能は、リバースETLにとって特に価値があります。
- deep lakehouse integration:外部のETLジョブを構築または管理することなく、スナップショット、スケジュール、または継続的にlakehouseのテーブルからLakebaseにデータを同期します。これにより、カスタムパイプライン、再試行、モニタリングの複雑さが、ネイティブなマネージドエクスペリエンスに置き換えられます。
- フルマネージドの Postgres: オープンソースの Postgres 上に構築された Lakebase は、ACID トランザクション、インデックス、結合、および PostGIS や pgvector などの拡張機能をサポートしています。pgAdmin や JDBC などの既存のドライバーやツールに接続できるため、新しいデータベース技術を学んだり、別の OLTP インフラストラクチャを維持したりする必要がありません。
- スケーラブルで回復力のあるアーキテクチャ: Lakebaseはコンピュートとストレージを分離して独立したスケーリングを可能にし、10ミリ秒未満のクエリーレイテンシと数千QPSを実現します。マルチAZ高可用性、ポイントインタイムリカバリ、暗号化ストレージなどのエンタープライズグレードの機能が含まれており、これらは自己管理型データベースに関連するスケーリングと回復力の課題を解消します。
- 統合されたセキュリティとガバナンス: LakebaseをUnity Catalogに登録して、オペレーショナルデータを一元化されたガバナンスフレームワークに取り込み、カタログレベルでの監査証跡と権限を網羅します。Postgresプロトコル経由でのアクセスでは、引き続きネイティブのPostgresのロールと権限が利用されるため、広範なDatabricksガバナンスモデルと連携しつつ、確実なトランザクションセキュリティが保証されます。
- クラウド非依存のアーキテクチャ: ワークフローを再設計することなく、お好みのクラウド環境でお使いの lakehouse と共に Lakebase をデプロイできます。
Databricksデータインテリジェンスプラットフォームのこれらの機能により、Lakebaseは、カスタムパイプライン、スタンドアロンのOLTPシステム、個別のガバナンスに依存する断片化されたリバースETL設定に取って代わります。統合された高性能かつセキュアなサービスを提供し、分析的な知見が、より少ない運用労力でガバナンスを維持したまま、より速くアプリケーションに流れ込むようにします。
サンプルユースケース: Lakebase を使用したインテリジェントなサポートポータルの構築
実例として、Lakebaseで駆動されるインテリジェントサポートポータルの構築方法を説明しましょう。このインタラクティブポータルは、lakehouseからのML駆動の知見(予測されるエスカレーションリスクや推奨される行動など)を活用し、チームが入ってくるインシデントのトリアージを支援します。この機能により、ユーザーは各チケットの所有権を割り当てたり、ステータスを追跡したり、コメントを残したりすることができます。
Lakebase は、予測を Postgres に同期すると同時に、アプリからの更新も保存することで、これを可能にします。これにより、アナリティクスとライブ オペレーションを組み合わせたサポート ポータルが作成されます。パーソナライゼーション エンジンや ML 駆動のダッシュボードなど、他の多くのユースケースにも同じアプローチが適用されます。
ステップ1: レイクハウスからLakebaseに予測を同期する
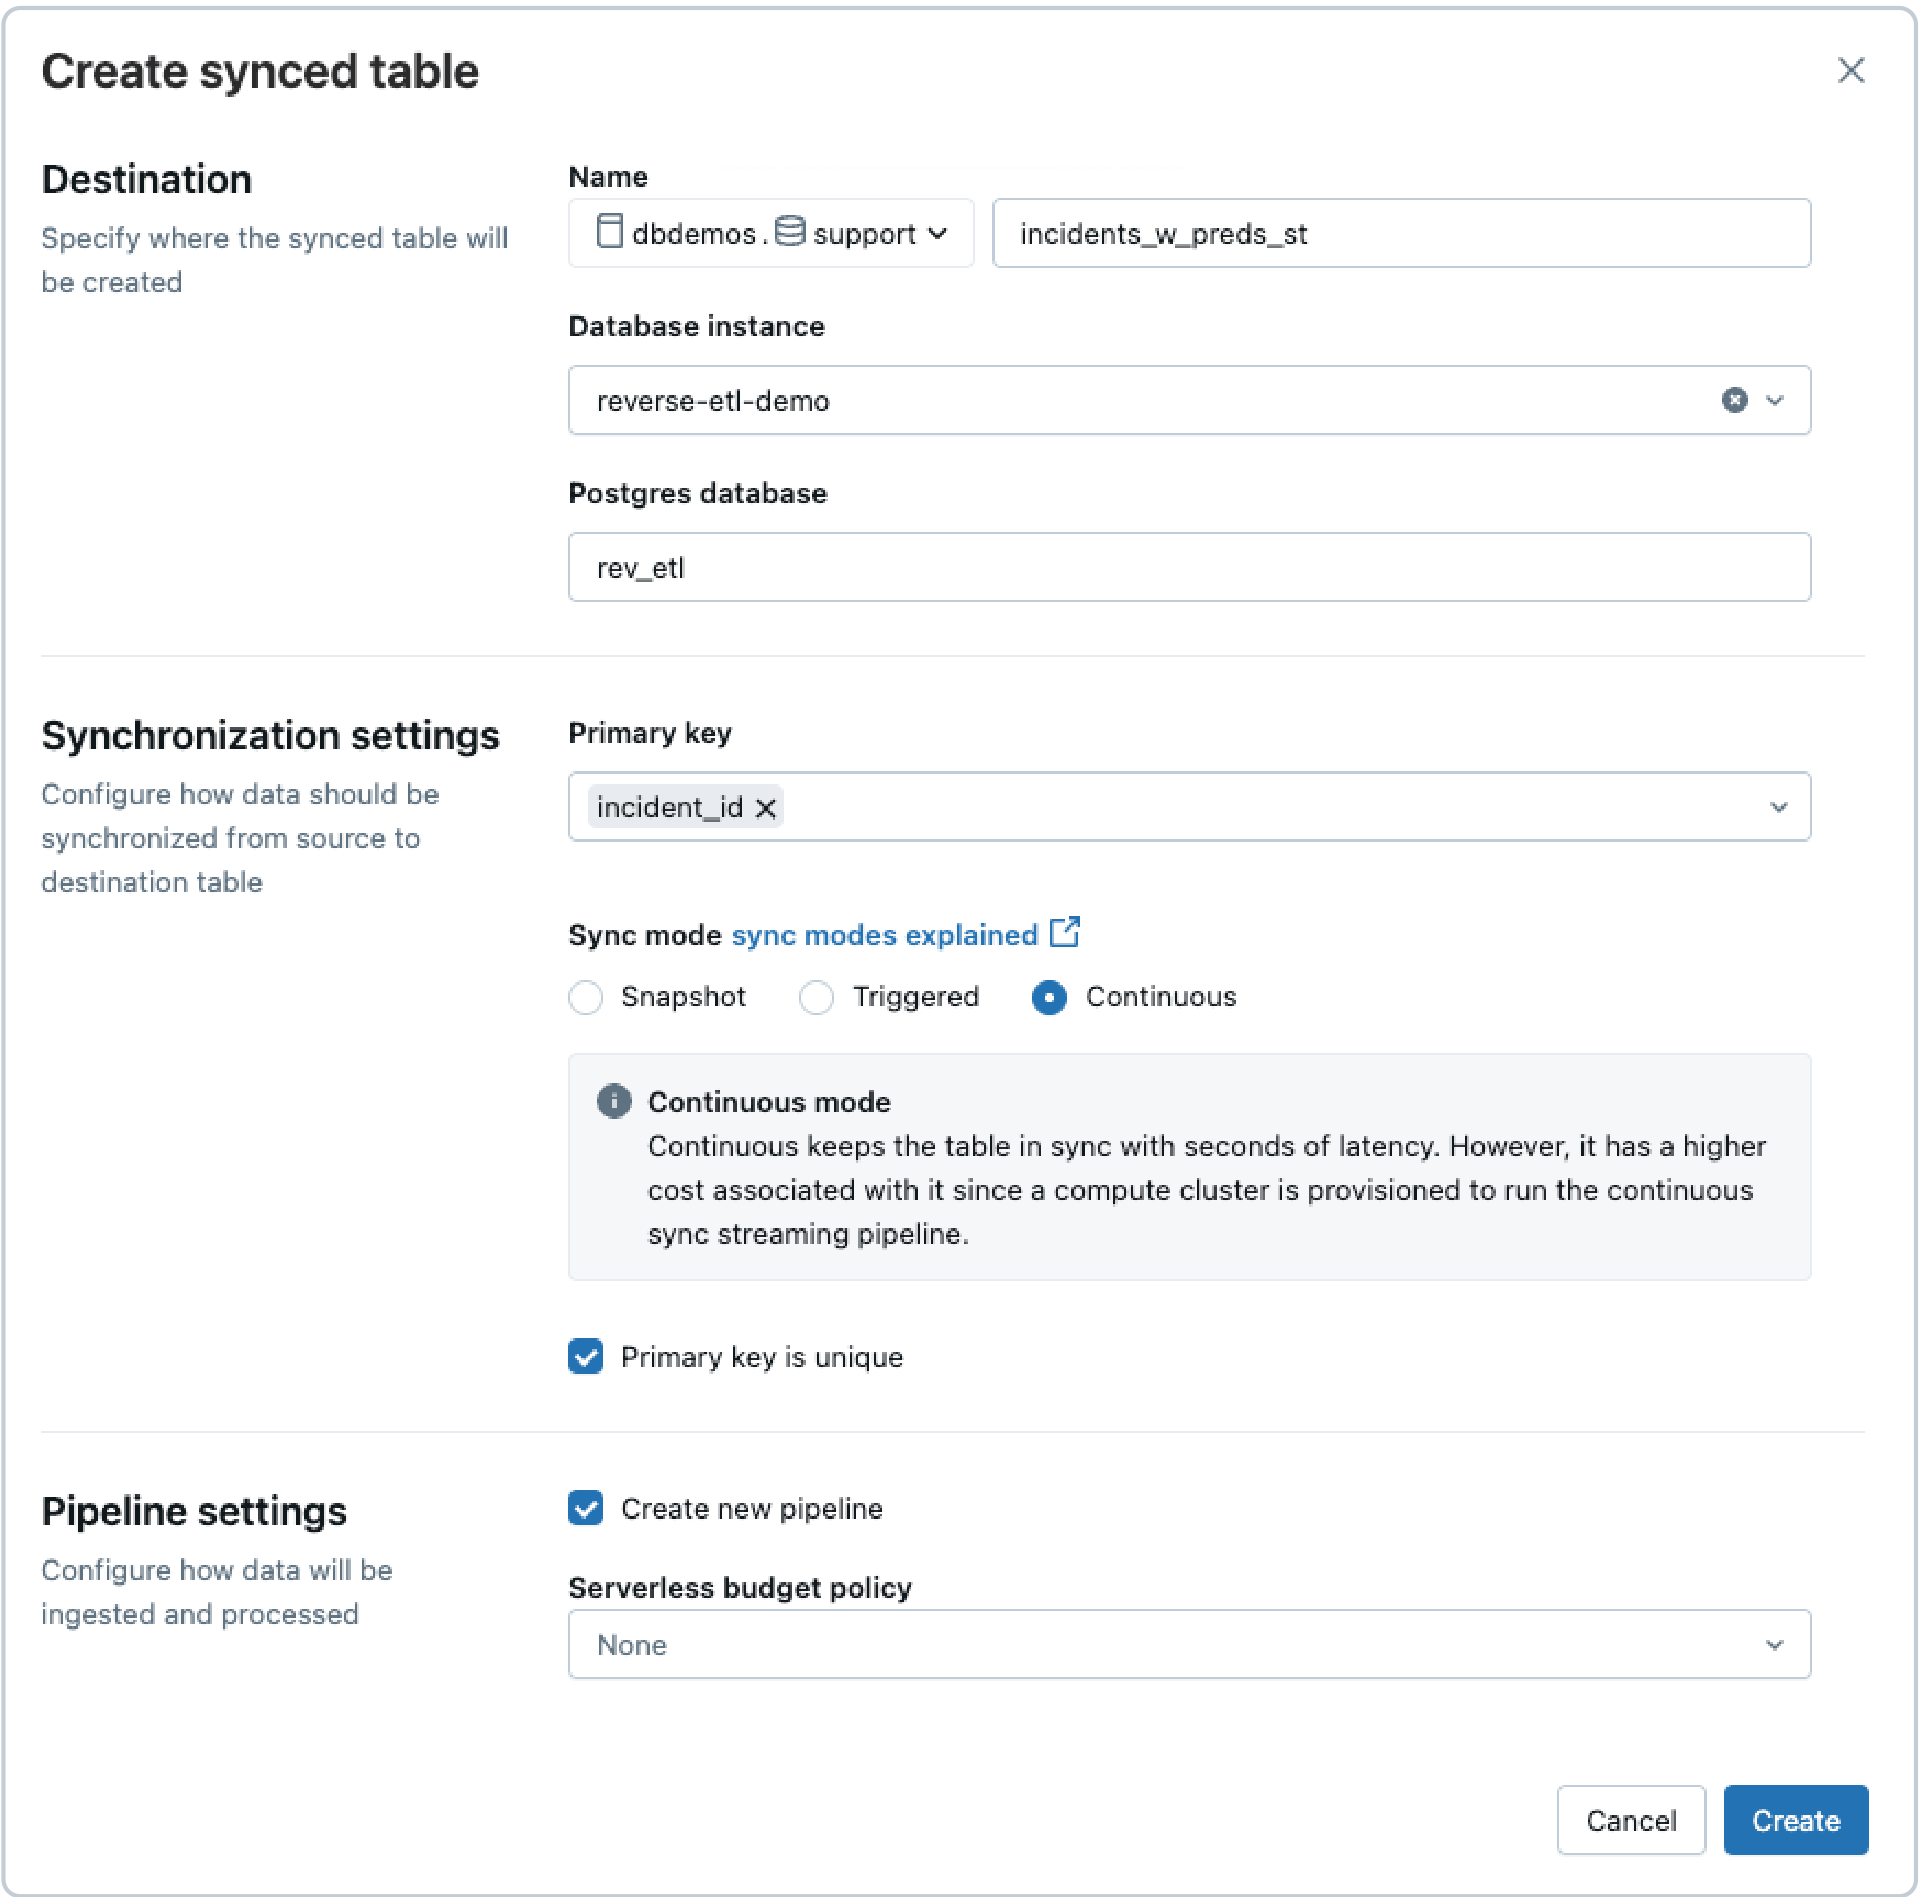
機械学習の予測で強化されたインシデントデータは Delta テーブルに格納され、ストリーミングパイプラインを介してほぼリアルタイムで更新されます。サポートアプリを稼働させるため、Lakebase のリバース ETL を使用して、この Delta テーブルを Postgres テーブルに継続的に同期します。
UI で、次を選択します:
- 同期モード: 継続的(低遅延の更新用)
- プライマリキー: incident_id
これにより、遅延を最小限に抑えながら、アプリに最新のデータが反映されるようになります。
注:Databricks SDKを使用して、プログラムで同期パイプラインを作成することもできます。
ステップ 2: ユーザー入力用の状態テーブルを作成する
サポートアプリには、所有権、ステータス、コメントなど、ユーザーが入力したデータを保存するためのテーブルも必要です。このデータはアプリから書き込まれるため、同期テーブルではなく、Lakebaseの別のテーブルに保存する必要があります。
スキーマは次のとおりです。
ステップ3:DatabricksアプリでLakebaseアクセスを設定する
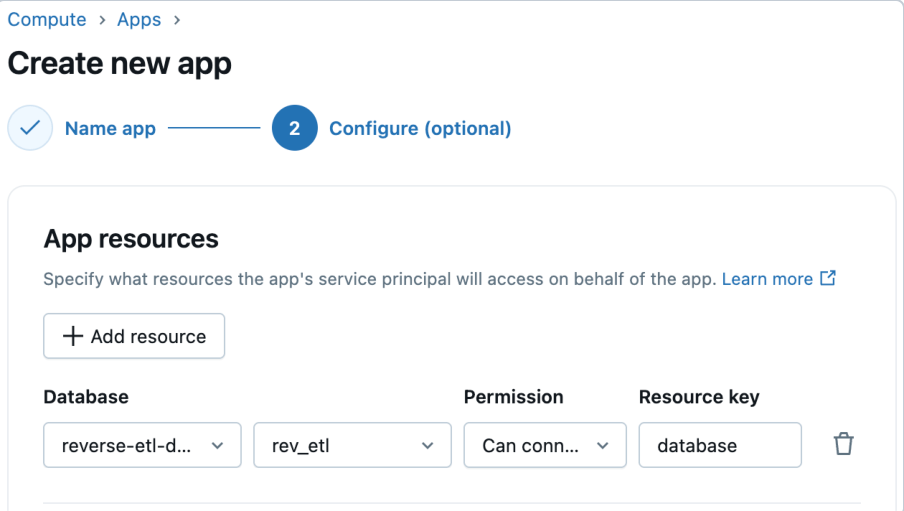
Databricks AppsはLakebaseとの一流の統合をサポートしています。アプリを作成する際は、Lakebaseをアプリリソースとして追加し、Lakebaseインスタンスとデータベースを選択するだけです。DatabricksはアプリのService Principalに対応するPostgresロールを自動的にプロビジョニングし、アプリとデータベース間の接続を効率化します。その後、このロールに必要なデータベース、スキーマ、およびテーブルの権限を付与できます。
ステップ4: アプリのコードをデプロイする
データの同期と権限設定が完了したら、サポートポータルを動かすFlaskアプリをデプロイできます。このアプリはPostgres経由でLakebaseに接続し、グラフ、フィルター、インタラクティブ機能を備えた豊富なダッシュボードを提供します。
まとめ
分析的知見を運用アプリケーションに取り入れることは、もはや複雑で脆弱なプロセスを必要としません。Lakebaseにより、リバースETLはフルマネージドな統合された機能となります。Postgresエンジンの性能、スケーラブルなアーキテクチャの信頼性、Databricksプラットフォームのガバナンスを組み合わせています。インテリジェントサポートポータルの構築やその他のリアルタイムでデータ駆動型の体験を構築する場合でも、Lakebaseはエンジニアリングのオーバーヘッドを削減し、知見から行動への道のりを加速させます。
Lakebaseで同期テーブルを作成する方法について詳しくは、ドキュメントをご覧になり、今すぐ始めましょう。
05 |Databricks上で安全でリアルタイムなアプリケーションの提供
シルビア・クリスティン・シューマッハ著
はじめに
Databricks Lakebase は、インテリジェントなアプリケーションを構築するためのオペレーショナルデータベースの合理化を大幅に強化します。Databricks Apps を使用すると、これらのデータおよび AI アプリを、標準装備のガバナンスと認証機能とともに、本番運用に迅速にデプロイできます。
Lakebaseは、Databricksプラットフォームとシームレスに統合されたフルマネージドのPostgresサービスであり、開発者はトランザクションデータをネイティブに操作できます。カスタムのETLパイプライン、コネクタ、ミドルウェアは不要です。Databricks Appsはこれをさらに推し進め、インフラストラクチャ管理を完全に不要にします。また、ワークスペースのセキュリティポリシーとUnity Catalogの権限を自動的に継承する、マネージドのServerlessコンピュートを提供します。
歴史的に、OLTP(オフ・トレープ)とOLAPシステムの橋渡しには複雑なデータエンジニアリングと特注の統合層が必要であり、アプリケーション展開には別々のDevOpsおよびインフラチーム、異なるCI/CDパイプライン、手動のセキュリティ設定が必要でした。LakebaseとDatabricksアプリを組み合わせることで、これらの複雑さが大幅に軽減されます。開発者はトランザクション層からリアルタイムの分析データに直接アクセスでき、数か月ではなく数分でインタラクティブなアプリケーションを展開できるため、本番運用対応のアプリケーションにライブデータを組み込むことが格段に容易になりました。
生成AIの文脈では、この組み合わせは特に強力です。Databricks Appsは、StreamlitやGradioのようなインタラクティブなAIインターフェースとレイクハウスデータを独自に組み合わせ、Databricks Data Intelligence Platform上で直接動作します。そこにはすでにデータやモデルが存在します。Lakebaseのトランザクションデータは、リアルタイムでコンテキスト認識型アプリケーションを支える重要な推進力となり、GenAIをより迅速に本番運用へと投入し、組み込みのエンタープライズセキュリティとガバナンスを備えています。
企業は、このデータをアプリのインターフェースに直接表示することで、新たな可能性を切り開くことができます。
- AIアシスタントは、簡単に設定できるアクセス制御に従いながら、ライブのビジネスデータを参照します。
- ユーザーは、最新のAIによるガイダンスを用いて、データドリブンな意思決定を行います。
- 検索拡張生成(RAG)モデルは、出力を最新の事実に基づかせます。
- ワークフローは、常時利用可能なマネージドアプリケーションを通じて、進化するトランザクションとの整合性を保ちます。
この統合により、GenAIは企業の完全なコンテキストで必要なときに必要な場所で動作し、現代のチームが求める本番運用の信頼性と簡素化されたデプロイメントが保証されます。
この章では、安全でCI/CDに対応したStreamlitアプリを構築し、それをLakebaseに接続するDatabricksアプリとしてデプロイする方法を順を追って説明します。このアプリを使用すると、ユーザーは読み取り専用のインターフェースでUnity Catalogから同期されたキャンペーンメトリクスを探索できます。これにより、ビジネスダッシュボード、キャンペーンのモニタリング、アドホックな探索などのユースケースを実現できます。
主要なテクノロジー
- Streamlit: PythonのインタラクティブUIフレームワーク
- SQLAlchemy: データベースアクセスのためのSQLツールキットとORMです
- Databricks SDK: 安全な OAuth トークン管理
- Postgres (Lakebase): マネージドOLTPバックエンド
- DABs: 宣言的なアプリのデプロイと CI/CD 統合
- GitHub: ソース管理とパイプラインの自動化
ソリューション概要
プロセスは、2つの主要なステップで構成されています。
- Lakebaseのセットアップ
- Lakebaseインスタンス(Databricksが管理するPostgres)を作成します
- Sync a Unity Catalog table into the Postgres instance via スナップショットモード
- Databricksアプリの作成
- UI には Streamlit を使用します
- SQLAlchemyとDatabricks OAuthを使用してLakebaseに安全に接続
- リレーショナル テーブルにインタラクティブなフィルタとビューを追加
- バージョン管理、デプロイ、自動化にはDatabricks Asset Bundles(DABs)とGitHubを使用します
完全なソースコードとデプロイ手順については、GitHub リポジトリをご覧ください。
ステップバイステップガイド
開発を効率化するために、ローカルでのテストとイテレーションには Cursor を Databricks Connect でセットアップすることをお勧めします。
1. レイクベースの設置
同期されたテーブルを持つLakebaseインスタンスがまだない場合は、次のステップに従ってください:
1. Lakebaseインスタンスの作成
Lakebaseのドキュメントのステップ1~7に従って、「postgres-campaigns」という名前のLakebaseインスタンスを作成します。
2. GitHub リポジトリをクローンする
リポジトリには、アプリのデプロイ用に次のファイルが含まれています。
- app.py — メインのStreamlitアプリケーション
- config.yaml — データベースおよびテーブルパラメータの集中型設定
- generate_campaign_data.ipynb — キャンペーンのパフォーマンスデータを生成するためのノートブック
- requirements.txt — Streamlit、SQLAlchemy、Databricks SDKを含むすべてのPython依存関係
- databricks.yml — DAB の宣言型デプロイメント構成
- README.md — セットアップと使用方法に関する分かりやすいドキュメント
- gitignore — リポジトリをクリーンに保つためのローカルおよび環境固有のファイルの除外
3. Unity Catalogテーブルを作成する
クローンしたGitHubリポジトリからgenerate_campaign_data.ipynbスクリプトを開きます。ノートブックウィジェット内でカタログ、スキーマ、テーブル名を指定し、スクリプトを実行して合成キャンペーンパフォーマンスデータを生成します。
4. Unity Catalogテーブルの同期
Synced Tables機能を使用して、Unity Catalogテーブルのデータを自動的に同期する読み取り専用テーブルをPostgresに作成します。同期テーブルを作成するには、こちらのステップに従ってください。ステップ1のLakebaseインスタンスにテーブルを同期します。
- Postgresデータベース: campaign_db
- テーブル名: campaign_metrics_synced
- モード:スナップショット
これで、以下が利用可能になっているはずです。
- Lakebase インスタンス: postgres-campaigns
- 同期されたリレーショナルテーブル: campaign_metrics_synced
2. アプリをデプロイする
これから、Lakebaseインスタンスに接続し、データをインタラクティブに表示するStreamlitアプリを作成します。
1. 設定の更新
クローンしたGitHubリポジトリ内のconfig.yamlを、ご自身のデータベース詳細で編集します。必要な情報は、データベースの「接続の詳細」tabで確認できます。
2. 依存関係のインストール
3. Databricksの環境変数を設定する
設定> 開発者>アクセストークン > 管理 > 新しいトークンを生成して新しいパーソナルアクセストークン(PAT)を取得してください。環境変数は以下のように設定します:
4. Postgresデータベースの構成
独自のPostgresデータベースに接続するには、app.pyのDB_CONFIGセクションを更新してください。
5. アプリ名の更新
databricks.ymlファイルはアプリをデプロイ可能なリソースとして定義しています。アプリ名を入力してください:
6. DABsを使用してデプロイ
バンドルのソースコードがDatabricksワークスペース内の次の場所で利用可能になります。
コンピュート > Apps > <your-app> からアプリに移動し、提供されたLinkを開くことができます。アプリにはまだデータベースにアクセスする権限がないため、この時点ではデータを表示できません。
3. データベースに対するアプリの権限を設定する
1. アプリから CLIENT_ID を抽出します
- コンピュート > Apps > <your-app>
- アプリで [Environment tab] を開き、DATABRICKS_CLIENT_ID の値をコピーします。
2. アプリへの権限の付与
- Postgres インスタンス(コンピュート > OLTP Database > >your-instance>)に戻り、New クエリー をクリックします
- エディターで選択されているコンピュートに Postgres コンピュートが表示されることを確認します。
- データベースを「postgres」から、ご自身のPostgresデータベース(例:postgres-campaigns)に切り替えます。
- 次のコードを実行します:
[コンピュート] > [アプリ] ><your-app> に移動して、アプリに戻ることができます。提供されたLinkを開くと、リレーショナルテーブルが表示されます。
Oauth による Postgres 接続のハイライト
このアプリは Databricks SDK を使用し、OAuth トークンでマネージド Postgres インスタンスに対して安全に認証します。
- 手動でのトークン管理は不要
- 15 分ごとにトークンを自動的に更新します。
- Databricksワークスペースの資格情報を使用します
学んだこと
- Databricks OAuth — シームレスかつ本番運用に対応しており、アプリ認証に利用できます。
- Streamlit — ビジネス向けツールのラピッドプロトタイピングを提供します
- Databricks Asset Bundles (DABs)は、CI/CD パイプラインに不可欠なデプロイとロールバックを簡素化します。
- 同期テーブル — Databricks Appsでトランザクションデータをすぐに利用できるようにします
試してみましょう
ご自身のデータで試してみませんか?
- GitHubリポジトリのクローン
- app.pyでDB_CONFIGをカスタマイズする
- databricks.yml で your-app-name をカスタマイズします
- databricks bundle deployを使用してデプロイ
わずか数行のコードでDatabricks Appsのオペレーショナルデータを活用し、チームが必要な場所で必要な知見を提供します。
今すぐインテリジェントなアプリケーションを開発しましょう。パイプラインを構築したりサーバーをメンテナンスしたりすることなく、数分でレイクハウスのデータをLakebaseに同期できます。
06 | Lakebaseを使用して会話メモリを持つAIエージェントを構築する方法
作成者: Yatish Anand、Bo Cheng、Cathy Zdravevski、Evan Pandya、Susan Pierce
会話の記憶が重要な理由
多くのAIエージェントは単一ターンのやり取りではうまく機能しますが、実際の運用ワークフローに適用すると苦戦します。サイバーセキュリティにおいて、調査は1ステップで終わることは稀で、アナリストは脅威の種類からソースIP、IPからユーザー、ユーザーからデバイスへと変化します。これらの調査は複数回のセッションにまたがることが多く、継続性が求められる。
本番運用で効果的に機能するためには、エージェントには状態 (state) が必要です。エージェントは、すでに起こったことを記憶し、完全なコンテキストを維持したまま作業を再開できなければなりません。
この章では、Databricksプラットフォーム上で、インタラクションをまたいで会話の記憶を永続化するサイバーセキュリティAIエージェントを構築します。エージェントはLangGraphのチェックポイント機能を使用して実行状態をLakebaseに保存し、調査をシームレスに一時停止および再開できるようにします。Databricks AI Agent Frameworkを使用してエージェントをデプロイし、Streamlitで構築されたDatabricksアプリとしてエンドユーザーに公開します。
エージェントの状態レイヤーとして Lakebase を使用する
ステートフルエージェントは、最小限のレイテンシーでアプリケーションの状態を読み書きできるトランザクションデータベースを必要とします。Lakebase は、Databricks Platform に完全に統合された、フルマネージドの Postgres 互換 OLTP サービスとしてこの基盤を提供します。Postgres と互換性があるため、別のインフラストラクチャを構築することなく、実績のあるトランザクションデータベースの信頼性とエコシステムを得ることができます。
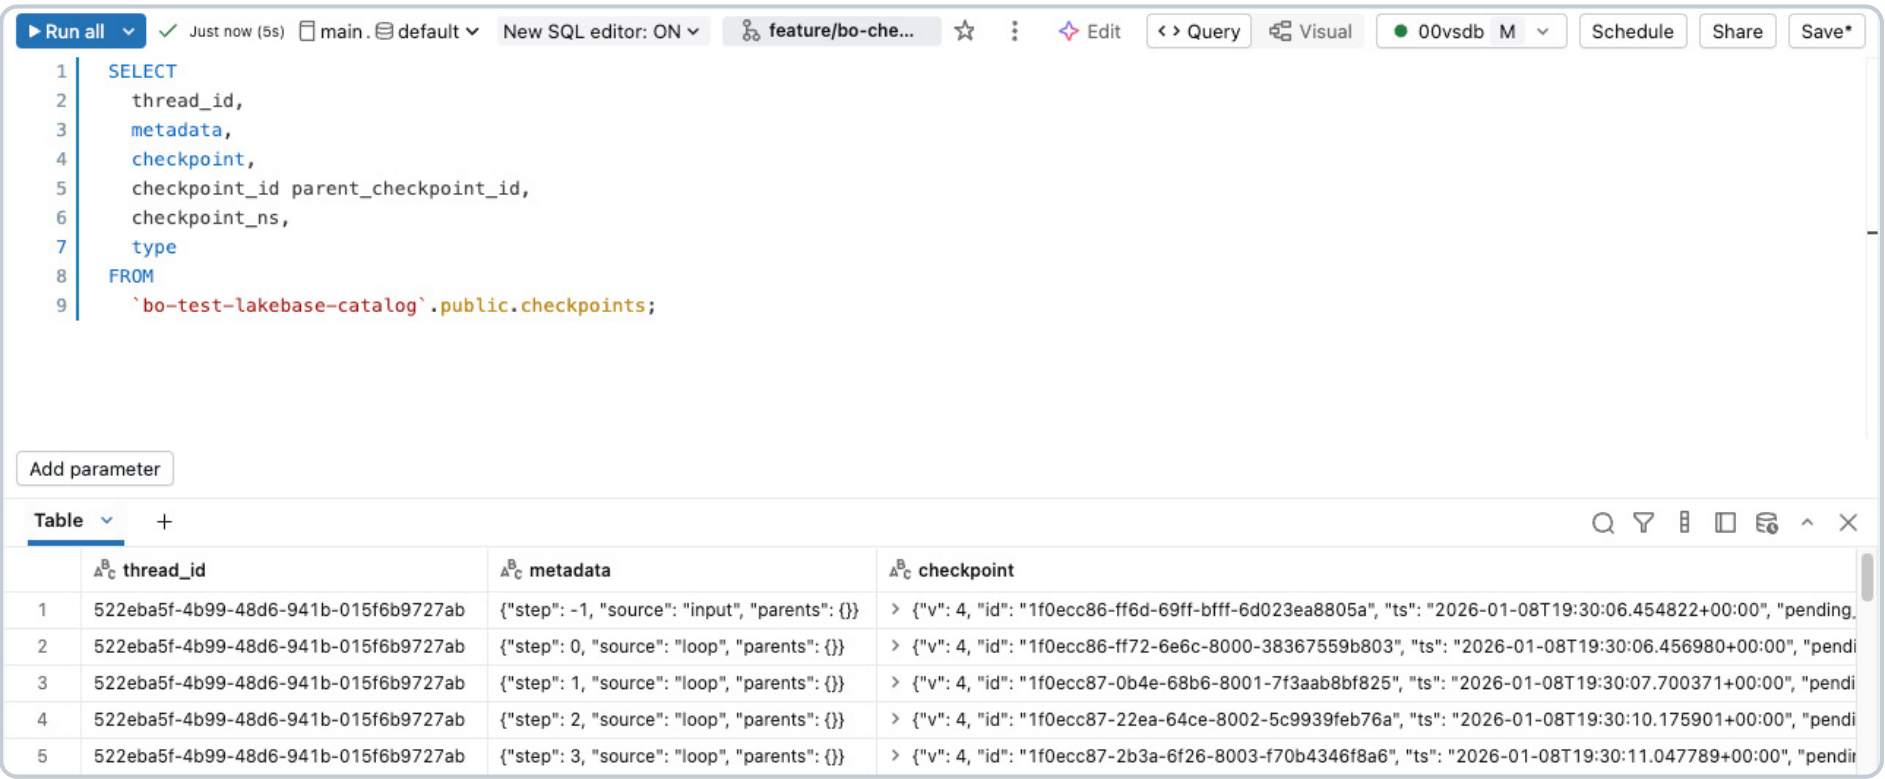
このソリューションでは、LakebaseはLangGraphのチェックポイントストアとして機能します。エージェントの実行の各ステップはスレッド識別子のもとで永続化され、そのスレッドが再度参照されると、エージェントは以前のメッセージ、ツールの呼び出し、中間状態といった完全なコンテキストを保持したまま再開します。低レイテンシの読み取りにより、エージェントはこのコンテキストを迅速に取得でき、会話の応答性を維持できます。
このアプローチにより、別のデータベースを導入したり、追加の運用上の複雑さを管理したりすることなく、リアルな対話メモリを実現できます。エージェントのロジック、ツール、メモリ、デプロイのすべてが、データとAIのワークロードをすでに実行しているのと同じプラットフォーム上に存在します。
AIエージェントのメモリーパターン
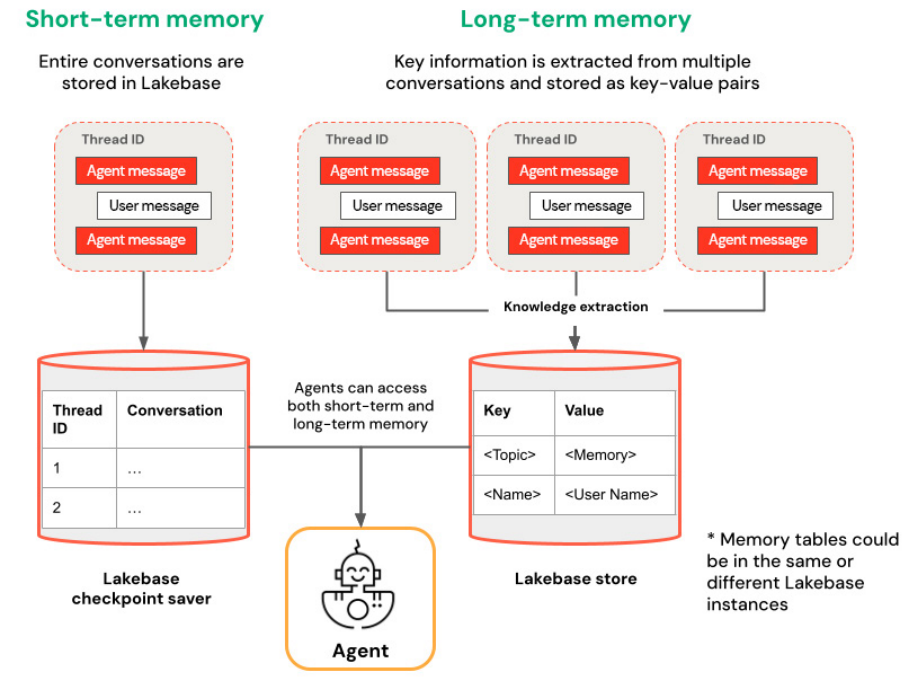
この章では、スレッドレベルのチェックポイント機能を通じて実装される短期記憶について解説します。各会話は一意のスレッド識別子に関連付けられ、ワークフローが進行するにつれてエージェントの状態が増分的に保存されます。これにより、コンテキストを失うことなく、どの時点からでも調査を再開できます。
Lakebaseはまた、スレッドやユーザー間で情報を永続させる長寿命メモリパターンもサポートしています。これらのパターンにより、エージェントは時間の経過とともに知識を蓄積することが可能になるが、同時に、スコープ、保持、ガバナンスに関する追加の設計上の考慮事項が生じる。ユーザーの好みやセッション間で蓄積された発見が持続する長期記憶については、 Databricksドキュメント内の長期記憶セクションを参照してください。
アーキテクチャの概要
このソリューションは、以下のコンポーネントで構成されています。
- Databricks 上で提供される、推論を実行するチャットモデル
- 管理されたセキュリティデータをツールとして公開するUnity Catalog関数
- 制御フローとツールの呼び出しを管理するためのLangGraphオーケストレーション
- Lakebaseはエージェントステート用のトランザクションチェックポイントとしてプロビジョニングされました
- パッケージングとデプロイメントのための Databricks AI Agent Framework
- エンドユーザーインタラクション用のStreamlitベースのDatabricksアプリ
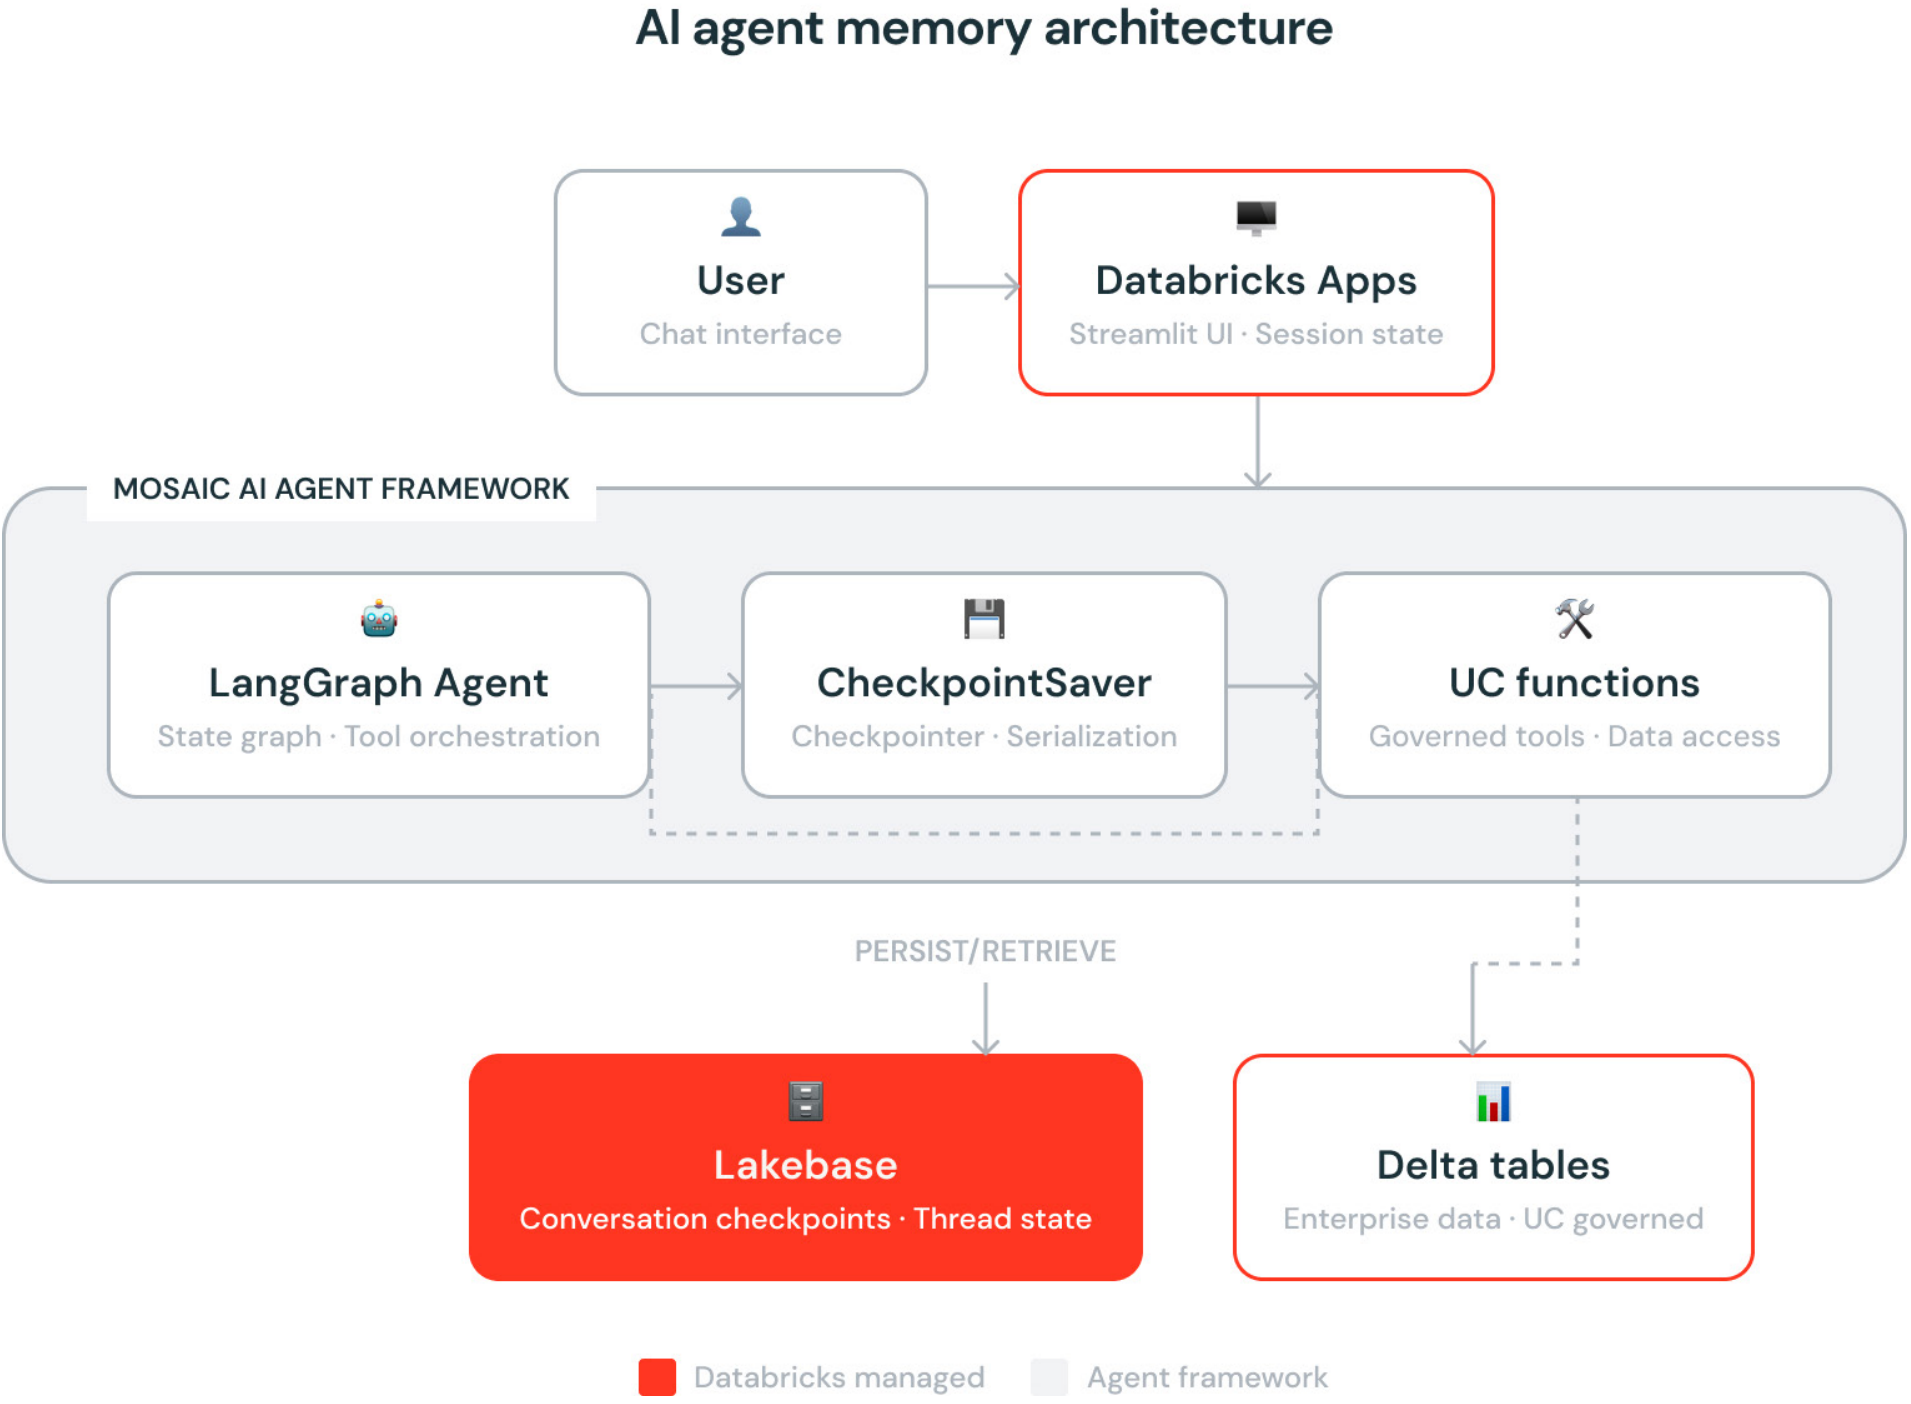
これらのコンポーネントが一体となって、Databricksプラットフォーム上で完全に実行される、本番環境に対応したステートフルなエージェントアーキテクチャを形成します。
実装ガイド
前提条件
本ガイドはDatabricksプラットフォーム上でAIアプリケーションを構築する経験があることを前提としており、環境ブートストラップではなくエージェントアーキテクチャに焦点を当てています。
開始する前に、以下をご確認ください:
- ServerlessコンピュートにアクセスできるDatabricksワークスペース
- Unity Catalog関数を作成するための権限
- Lakebaseでプロビジョニングされたインスタンスを作成する権限
- Databricks Model Serving と Databricks Apps へのアクセス
このデモでは、次のライブラリを使用します。Databricksサーバーレスコンピュート上のノートブックでセットアップを実行し、ステップバイステップで手順に従ってください。ソリューション全体を含むGitHubリポジトリはこちらからご覧いただけます。
ステップ1:Unityカタログ関数でガバナントされたセキュリティコンテキストを追加する
エージェントは、信頼できるコンテキストに基づいて意思決定を行います。サイバーセキュリティのワークフローでは、このコンテキストは多くの場合、構造化されたイベントテーブルおよびIDテーブルに存在します。Unity Catalog関数は、このデータを呼び出し可能なツールとしてエージェントに公開するための安全なメカニズムを提供します。
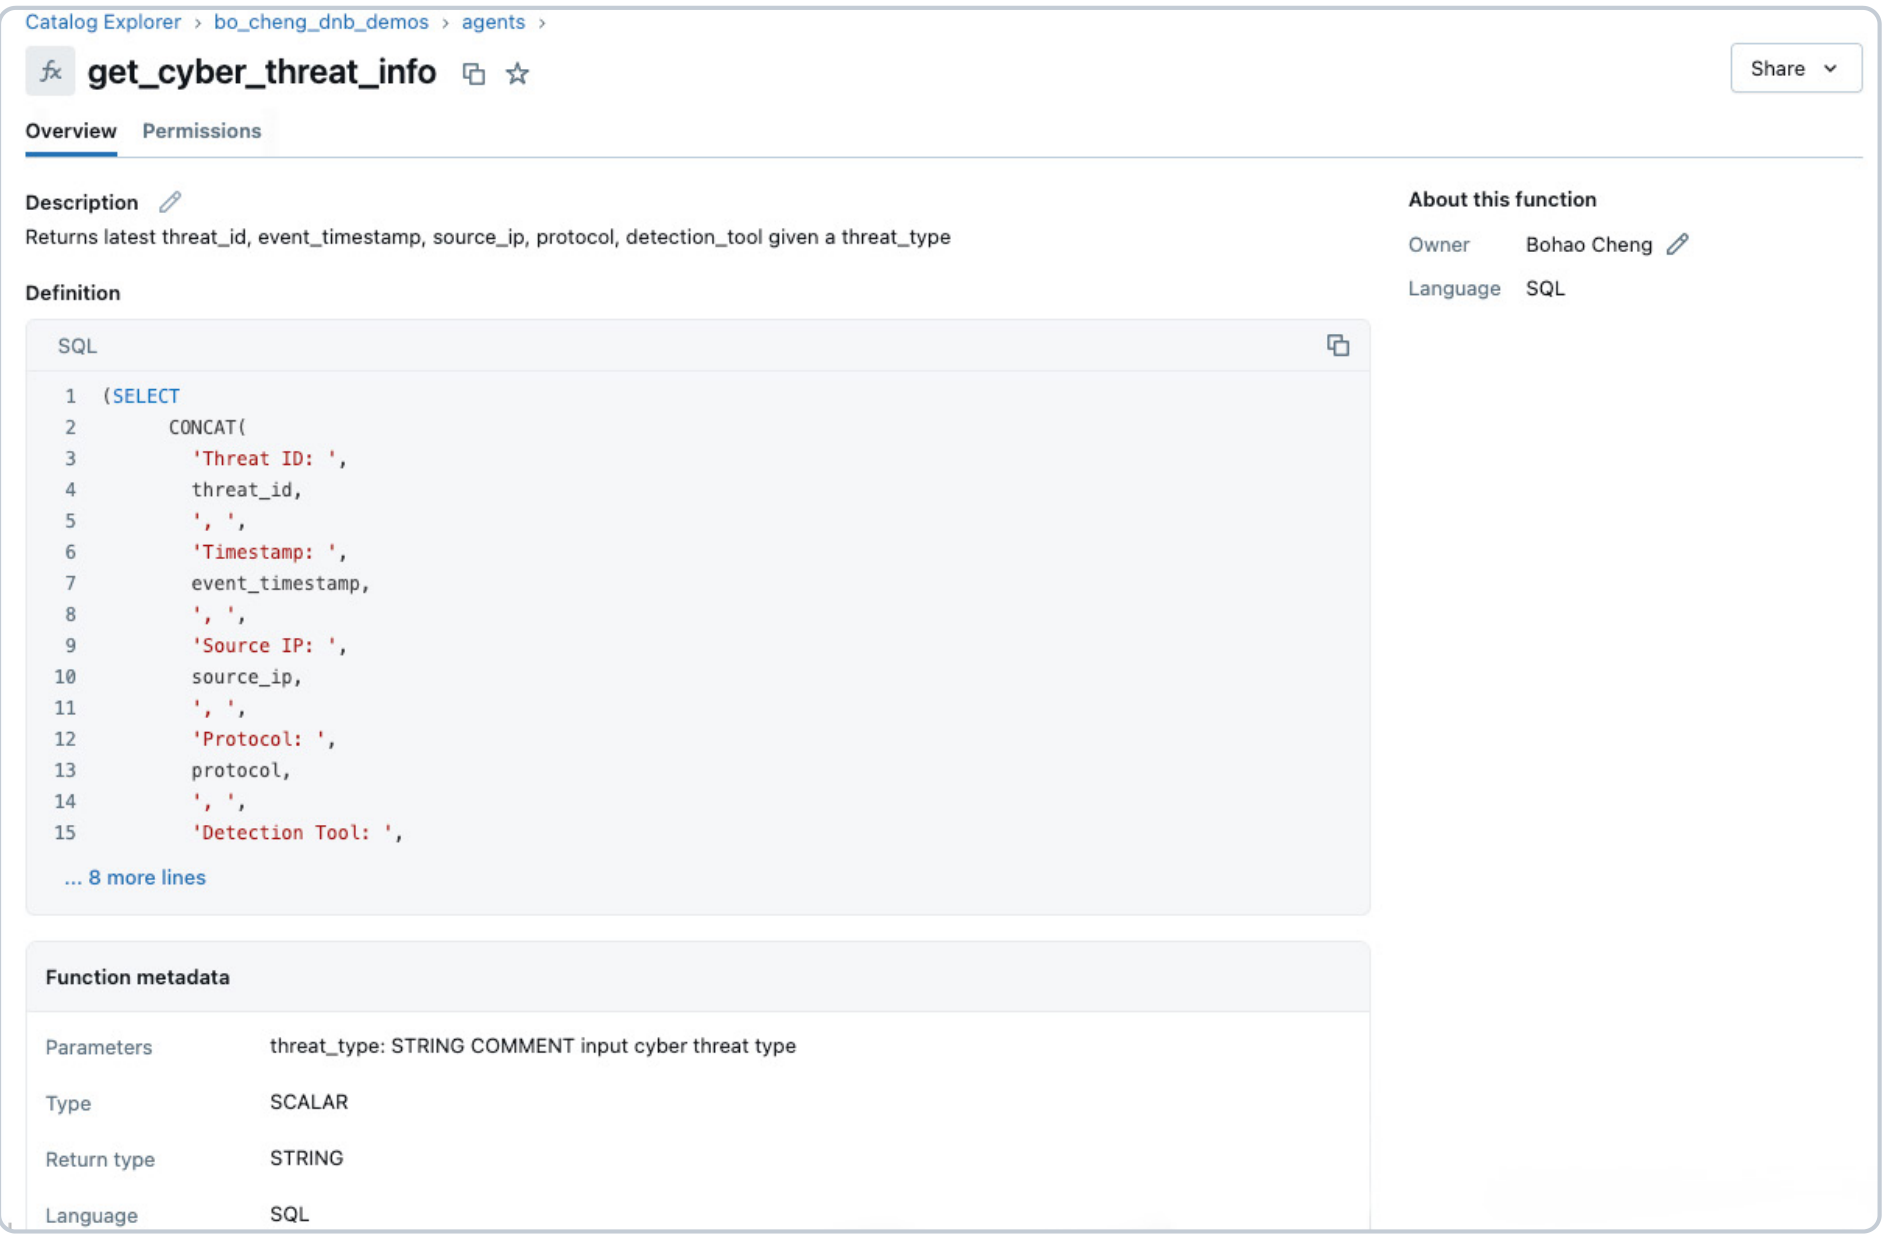
この例では、2つの SQL 関数を作成します。
- get_cyber_threat_info は、指定された脅威タイプに関する最新の脅威イベントを取得します。
- get_user_info は、ソース IP アドレスに関連付けられたユーザー詳細を取得します
これらの関数はDatabricks SQL (DBSQL)で作成され、Unity Catalogによって管理されることで、一貫したアクセス制御、監査、リネージが保証されます。
関数を作成すると、指定したカタログとスキーマの [Functions] tab の下に表示されます。
ステップ 2: チェックポイント用の Lakebase インスタンスを作成する
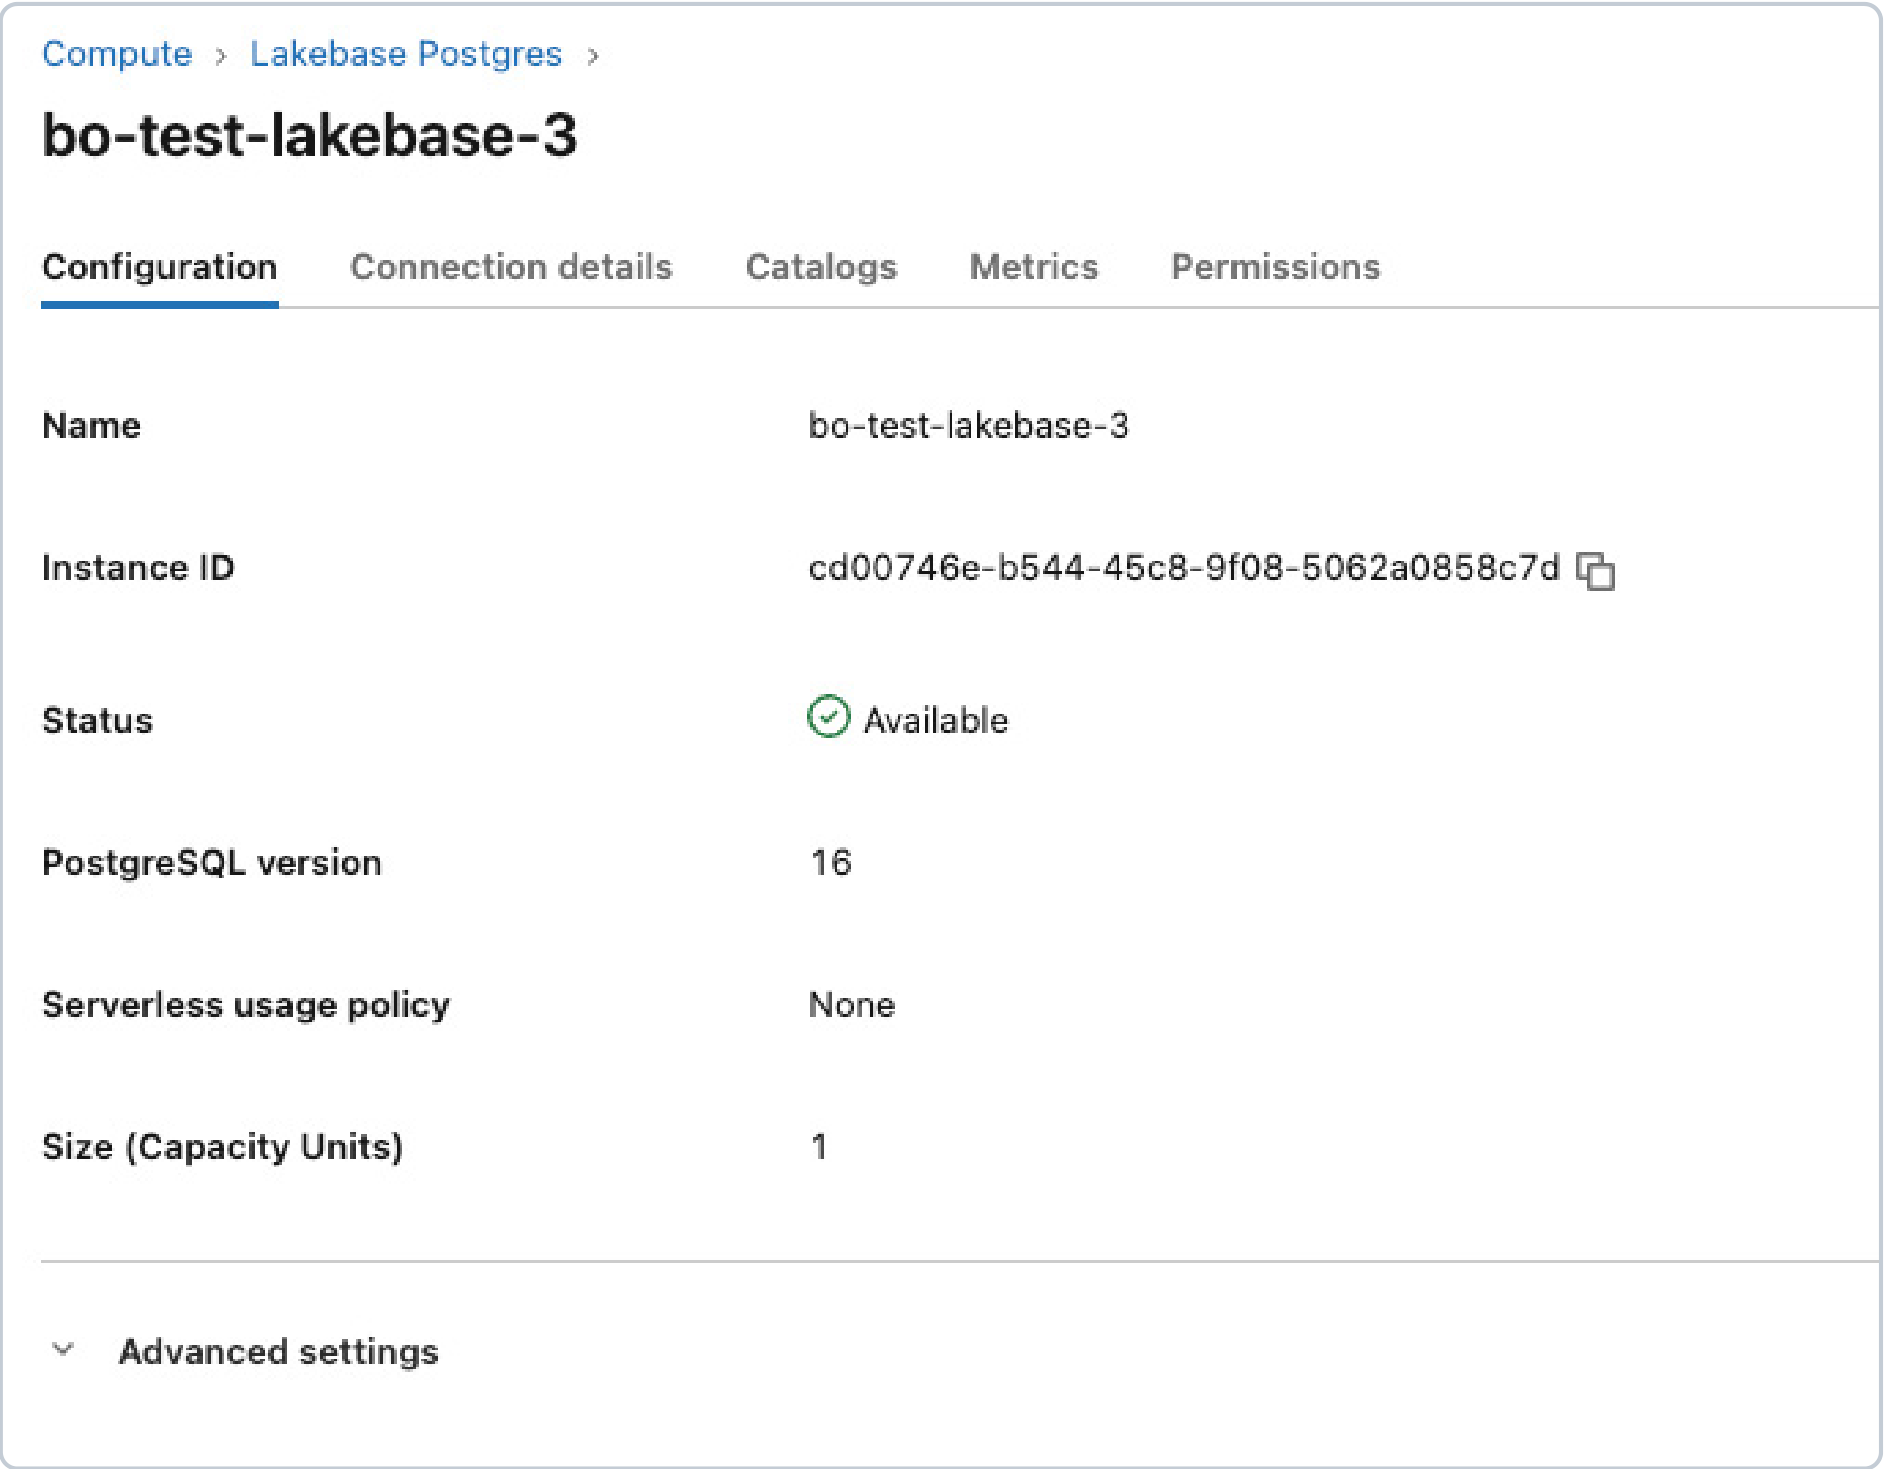
エージェント状態を永続化するには、LangGraphのチェックポイントとして機能するLakebaseインスタンスを作成します。外部のPostgresデータベースを管理するのではなく、LakebaseはDatabricksのセキュリティおよびアイデンティティと直接統合されるマネージドトランザクションサービスを提供しています。
エージェントの各実行ステップはLakebaseに書き込まれます。Lakebaseは低レイテンシのトランザクションワークロードに最適化されているため、これらの書き込みがエージェントの応答時間に加えるオーバーヘッドは最小限です。チェックポイントをスレッド識別子に関連付けることで、エージェントはユーザーが期待する応答性を損なうことなく、セッションをまたいで会話を確実に再開できます。
この実装ではlanggraph-checkpoint-postgres統合を使用しているため、LangGraphは標準的なPostgresのセマンティクスを用いてエージェントの状態をLakebaseに直接永続化できます。
インフラストラクチャの標準化方法に応じて、Databricks SDK for Pythonを使用してLakebaseインスタンスを作成するか、Databricks Asset Bundles (DABs) で宣言的に管理できます。
さらに、データベースカタログを作成することで、DBSQLを使用してチェックポイントの履歴をクエリーできるようになります。
ステップ 3: LangGraph でオーケストレーションし、MLflow でトレースする
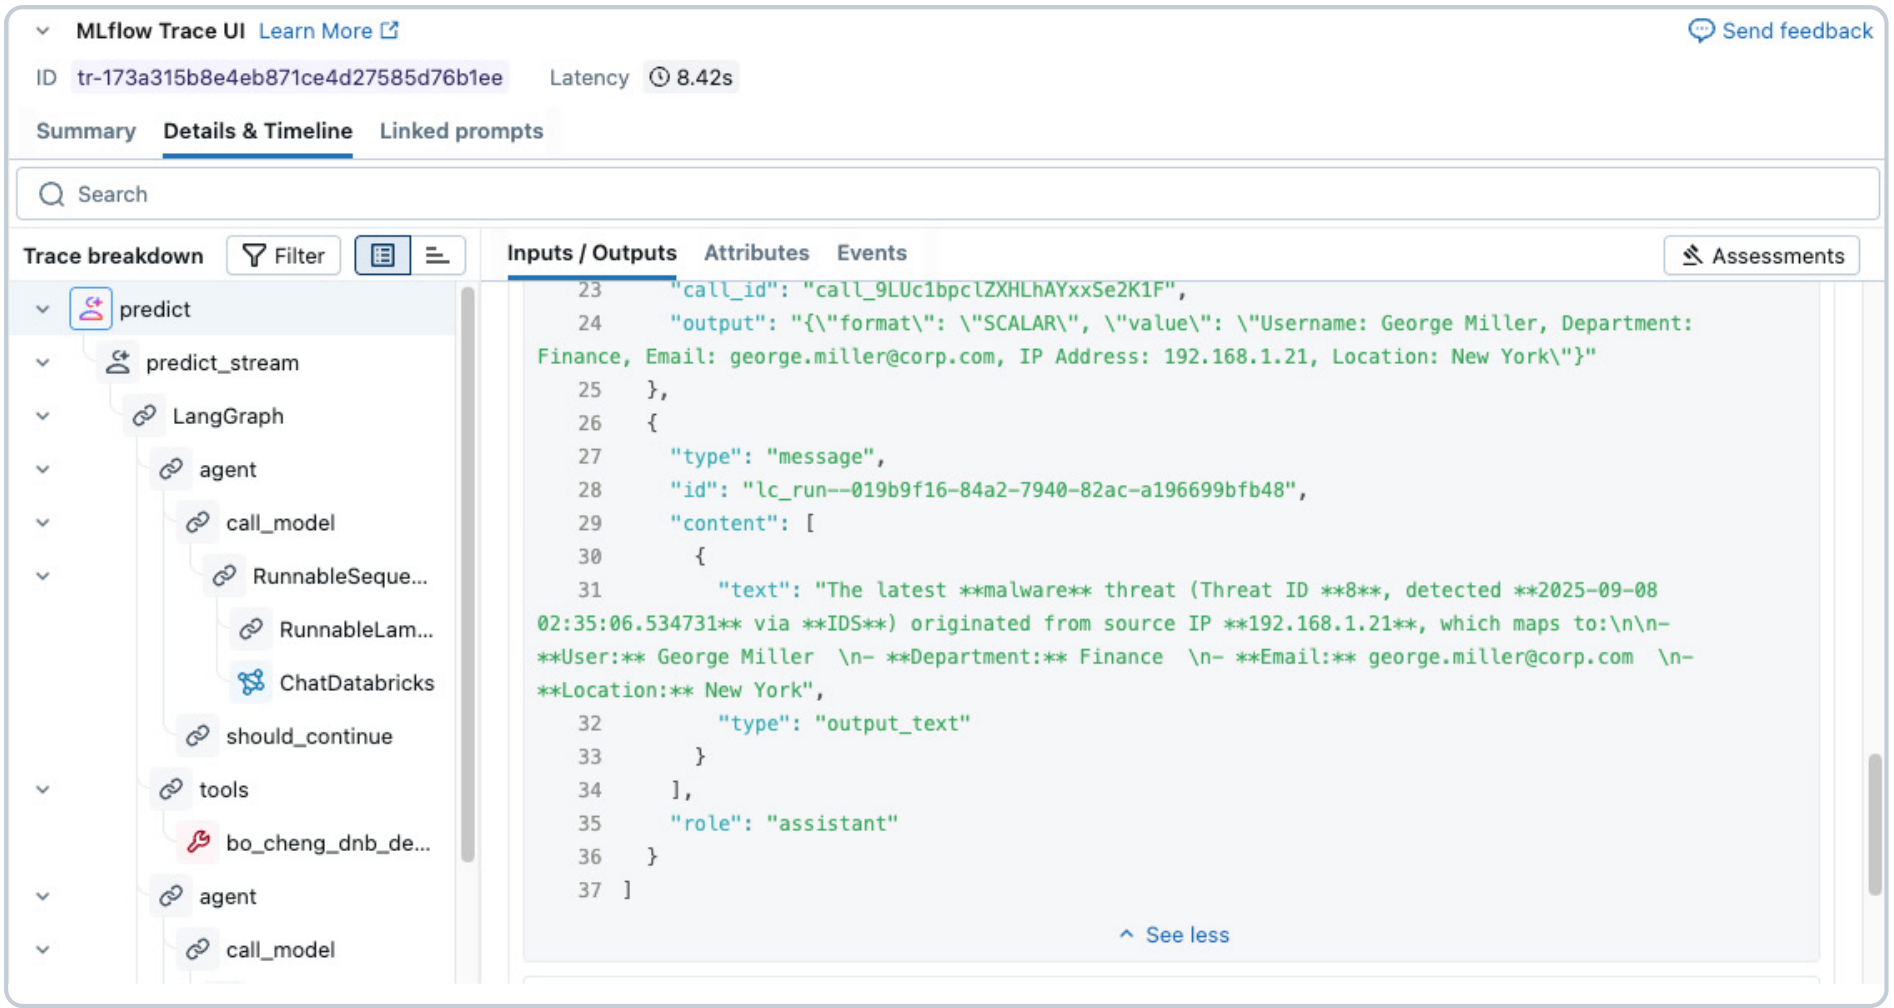
DatabricksはLangGraphオーケストレーションフレームワークと直接統合します。手順に沿って進めている場合は、LangGraphオプションを選択してください。LangGraphは、エージェントの振る舞いのためのコントロールプレーン (いつモデルを呼び出すか、いつツールを呼び出すか、ターン間でどのように状態を永続化するか) を提供します。この実装では、Unity Catalogのツールをチャットモデルにバインドし、Lakebaseをバックエンドとするチェックポインターを使用してスレッドレベルの状態を保存および復元します。
デプロイの前に、MLflow Tracingで動作を検証してください。トレースにより、入力、出力、ツール呼び出し、中間ステップの監査が容易になります。これは、デバッグや本番運用でのエージェントの動作を理解するために不可欠です。
ステップ4: Databricks AI Agent Frameworkを使用してエージェントをデプロイする
検証が完了すると、Databricks AI Agent Frameworkを使ってエージェントがパッケージ化・展開されます。これにより、登録、バージョン設定、サービスが簡素化されつつ、ガバナードされたリソースへの認証パススルーが維持されます。
MLflowでエージェントをログに記録する際は、モデルサービングEndpoint、Unity Catalog関数、Lakebaseインスタンスなどの依存リソースを明示的に宣言してください。これにより、デプロイメントがどのアセットに依存しているかが明確になります。以下のコードは、predict関数とpredict_stream関数の関連部分のみを示しています。これらは、Lakebaseと統合するdatabricks_langchainの短期記憶CheckpointSaverを実演するものです。モデルの完全なコードは、GitHubリポジトリでご自由にご確認いただけます。
その後、MLflowのコードからのモデルアプローチを使用して、エージェントをログに記録し、登録する必要があります。
モデルがログに記録されると、カタログを使用して、バージョンやアーティファクトを表示したり、関連するUnity Catalogオブジェクトを示すリネージの概要を取得したりすることもできます。
![],](https://www.databricks.com/sites/default/files/doc-importer/14/figure-556.png)
最後に、シンプルなagents.deploy()を使用できます。これは、モデルサービングEndpointを作成し、専門家評価のためにReview Appをインスタンス化する関数呼び出しです。ここでは、Lakebaseでプロビジョニングされたインスタンスへの認証に指定されたService PrincipalのクライアントIDとクライアントシークレットなど、エージェントが認証に必要とする環境変数をログに記録します。
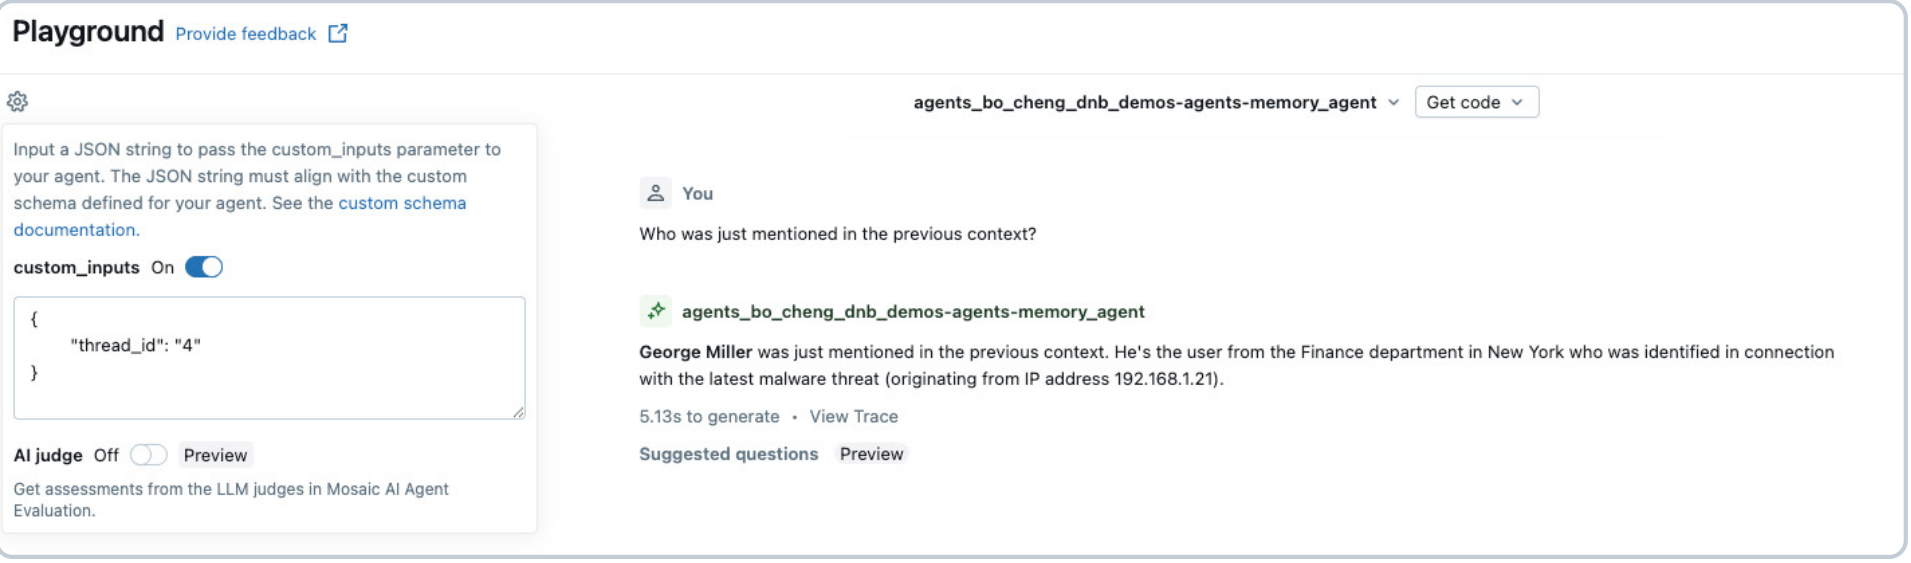
展開後、エージェントはAI PlaygroundやReview Appを使ってテストし、エンドユーザーに公開されます。レビューアプリは、フロントエンドの Databricks アプリと統合する前に、AI アプリの感触を確かめるための組み込みチャット UI です。
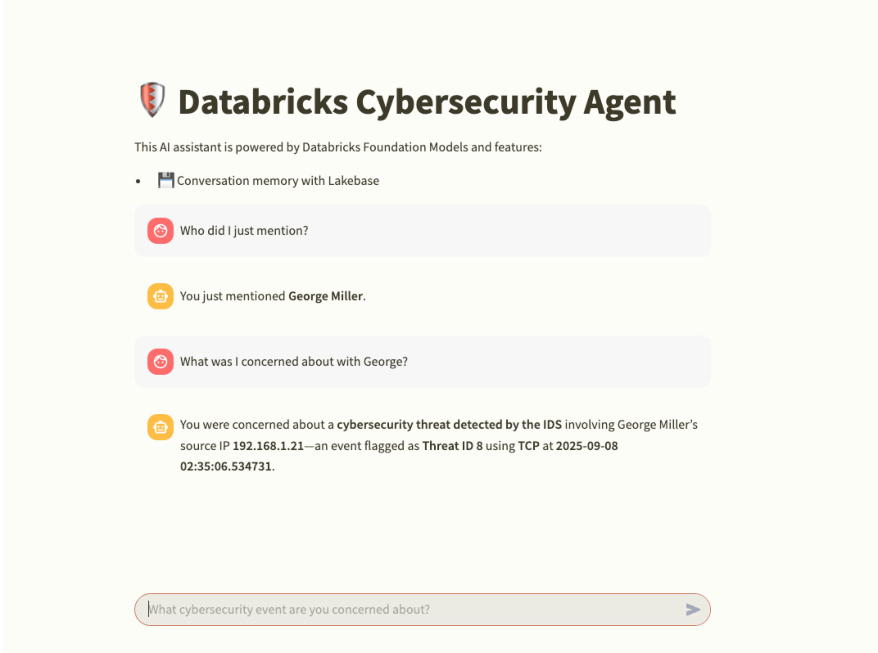
これで、モデルサービング Endpoint を Databricks アプリと統合できます。これは、Databricks Platform 上で AI アプリを構築する最も安全な方法であり、Streamlit、Gradio、Plotly Dash、Shiny、Flaskなどの Python フレームワークが標準でサポートされています。このサイバーセキュリティアナリストエージェントには、Streamlitを使用しています。
Databricks Appsは、アプリ認証 (提供されたService Principalを使用) またはユーザー認証 (ユーザーに代わって、アプリがログインユーザーのIDで動作) の2つの認証モードを提供します。どちらの方法でも、MLflowデプロイメントクライアントを使用して、エージェントのモデルサービングEndpointとやり取りします。
会話メモリの鍵となるのは thread_id です。これは Lakebase 内で会話の各チェックポイントを結びつけるための一意な識別子です。Streamlit アプリでは、ユーザーはサイドバーに既存の thread_id を入力することで、中断したところから正確に以前の会話を再開できます。次の図では、thread_id は 4 です。そのため、ユーザーがアプリを閉じ、後で同じ識別子で戻ってきた場合、エージェントは以前の会話の完全なコンテキストを読み込んで再開します。
thread_idが指定されていない場合、アプリはセッション用に新しいthread_idを生成し、新しい会話を開始します。これは、短期記憶の仕組みを説明するための簡単な実装例です。本番運用では、アプリは通常thread_id永続性を自動的に処理し、各ユーザーを会話スレッドに関連付けて識別子を手動で追跡しなくて済みます。
まとめ
ステートフルメモリは本番運用AIエージェントにとって不可欠です。サイバーセキュリティのような分野では、調査は複数の段階やセッションにまたがり、捜査官は効果的に調査を行うために状況を把握しておく必要がある。
このガイドでは、Lakebaseをトランザクションメモリ層としてLangGraphチェックポイントの際にDatabricks上でステートフルなサイバーセキュリティエージェントを構築しました。Unity Catalogの機能はデータへのガバナンスアクセスを提供し、MLflowはトレースとライフサイクル管理を可能にし、Databricks AIエージェントフレームワークは展開を簡素化します。これらのコンポーネントは、Databricksプラットフォーム上で完全に動作するエンドツーエンドのエージェントアーキテクチャを提供します。
このパターンは、継続性を必要とするあらゆる多段階のワークフローに広く適用されます。Lakebaseを使用すると、外部データベースなしでエージェントに会話メモリを追加でき、状態、ガバナンス、デプロイメントを単一のプラットフォームに統合できます。
関連リソース
次のステップ