Claude Platform이 이제 Databricks MLflow에서 기본 OpenTelemetry 관측 가능성을 지원합니다.
기본 OpenTelemetry 수집 기능을 통해 Databricks로 Claude 모니터링을 통합하세요. 수집된 추적을 MLflow와 함께 사용하여 반복되는 실패를 찾고 에이전트를 개선하세요.
작성자: 유키 와타나베
- Claude Platform용 OpenTelemetry가 이제 공개 베타(Public Beta) 버전으로 제공됩니다. 기본 OTel 내보내기를 통해 Anthropic SDK, Messages API 및 Claude Managed Agents가 Unity Catalog에 추적(trace)이 저장되는 형태로 Databricks MLflow에 통합됩니다.
- 추적 분석 및 MLflow Issues를 사용하여 잘못된 답변을 조사하고 실행 및 세션 간에 반복되는 도구 호출을 찾으세요.
- 도메인 전문가와 함께 답변을 검토한 다음, 동일한 테스트 케이스로 평가를 실행하여 변경 사항이 품질을 향상시키고 불필요한 작업을 줄이는지 측정하세요.
에이전트는 중요한 발견을 놓치거나 동일한 소스를 반복해서 읽으면서도 그럴듯한 답변을 반환할 수 있습니다. 답변 그 자체만으로는 그 이유를 설명해 주지 않습니다. 추적(trace)은 모델과 그 뒤에 숨겨진 툴 호출(tool call)을 보여주므로, 실패 원인을 조사하고, 유사한 사례를 찾고, 수정 사항이 도움이 되는지 테스트할 수 있습니다.
이제 Databricks MLflow는 Claude 플랫폼에서 네이티브 OpenTelemetry 내보내기를 지원하는 대상(destination)입니다. Anthropic SDK, Messages API, Managed Agent를 사용하는 개발자는 Databricks로 네이티브 추적을 전송하고 MLflow를 사용하여 에이전트를 디버깅하고 변경 사항을 평가할 수 있습니다.
Databricks에서 통합된 네이티브 OpenTelemetry
MLflow Tracing은 서비스 신호를 수집하고 내보내기 위한 개방형 표준인 OpenTelemetry를 기반으로 구축되었습니다. 추적은 모델 요청 및 툴 호출과 같은 스팬(span)이라는 개별 단계로 에이전트의 실행을 기록합니다. Claude의 네이티브 계측(instrumentation)은 이러한 스팬을 생성하고 OpenTelemetry 프로토콜을 사용하여 내보냅니다.
Databricks는 Zerobus Ingest를 통해 스팬을 수신하고 이를 MLflow 실험에 연결된 Unity Catalog 테이블에 저장합니다. 디버깅 및 평가를 위한 동일한 툴을 사용하여 다른 계측된 서비스의 추적과 함께 Claude 추적을 검사할 수 있습니다. Unity Catalog는 데이터에 대한 접근을 제어하며, SQL로 쿼리할 수도 있습니다. Zerobus와 Unity Catalog의 조합을 통해 기업은 두 가지 핵심 이점을 얻을 수 있습니다. 즉, 높은 QPS에서의 저지연 추적 수집과 에이전트 추적에 저장된 민감한 데이터에 대한 접근을 제어하는 기능입니다.

3단계로 Claude 연결하기
1. 실험 생성하기
Databricks에서 Experiments 탭을 열고 Create Experiment를 클릭합니다. Trace storage location 아래에서 Unity Catalog가 선택된 상태로 둡니다. 기존 카탈로그와 스키마를 선택합니다. 이렇게 하면 OpenTelemetry 추적을 저장하는 Unity Catalog 테이블에 연결된 새로운 MLflow 실험이 생성됩니다.
상세 설정 가이드에서 권한 및 SQL warehouse 요구 사항을 확인할 수 있습니다.
2. 네이티브 내보내기 구성하기
워크스페이스 ID, 리전, 스팬 테이블을 사용하여 Databricks 대상을 설정합니다. Zerobus 연결 가이드에서 테이블 범위의 OAuth 토큰을 얻는 방법을 설명합니다.
새로운 네이티브 OTel 통합은 Anthropic SDK, Messages API, Managed Agent를 지원합니다. Anthropic SDK의 경우, 아래 패키지를 설치하고 OTel 추적 공급자 및 내보내기 도구를 구성하여 Anthropic SDK 호출에 대한 스팬을 만듭니다. Messages API 및 Claude Managed Agent에서 Databricks 대상으로 추적을 전송하려면 Claude 플랫폼 OpenTelemetry 가이드를 따르세요.
Claude Code 및 Claude Agent SDK도 OpenTelemetry를 지원합니다. 추적을 동일한 대상으로 전송하려면 애플리케이션을 시작하기 전에 다음 추가 변수를 설정하세요:
3. 작업 실행 및 추적 검사하기
Claude 에이전트를 실행한 다음 실험에서 Traces를 엽니다. 추적을 열어 모델 호출, 툴 활동, 타이밍, 캡처된 입력 및 출력을 검사합니다. 입력과 출력은 content mode를 "full"로 설정하여 옵트인한 경우에만 캡처된다는 점에 유의하세요.

추적을 사용하여 Claude 에이전트 디버깅 및 개선하기
Claude 추적이 MLflow에 도착하면 개발 과정 전반에서 활용할 수 있습니다. 추적은 디버깅을 위한 기록, 전문가 검토를 위한 사례, 그리고 에이전트의 다음 버전을 평가하기 위한 증거를 제공합니다.
추적을 통해 답변 디버깅하기
예기치 않은 답변은 누락된 컨텍스트, 실패한 툴 호출, 또는 모델이 툴 결과를 사용한 방식 때문에 발생할 수 있습니다. MLflow의 Analyze trace 작업을 통해 조사 과정에 Genie Code를 활용할 수 있습니다. 기록된 실행을 검토하고 무엇이 잘못되었는지 설명하는 데 도움을 줍니다.
누락된 컨텍스트, 실패한 툴 호출, 비용이 많이 드는 단계에 대한 후속 질문을 통해 설명 이면에 있는 관련 컨텍스트를 검사할 수 있습니다. 이를 통해 지침을 수정할지, 툴을 개선할지, 에이전트가 사용할 수 있는 컨텍스트를 변경할지 결정할 수 있습니다.
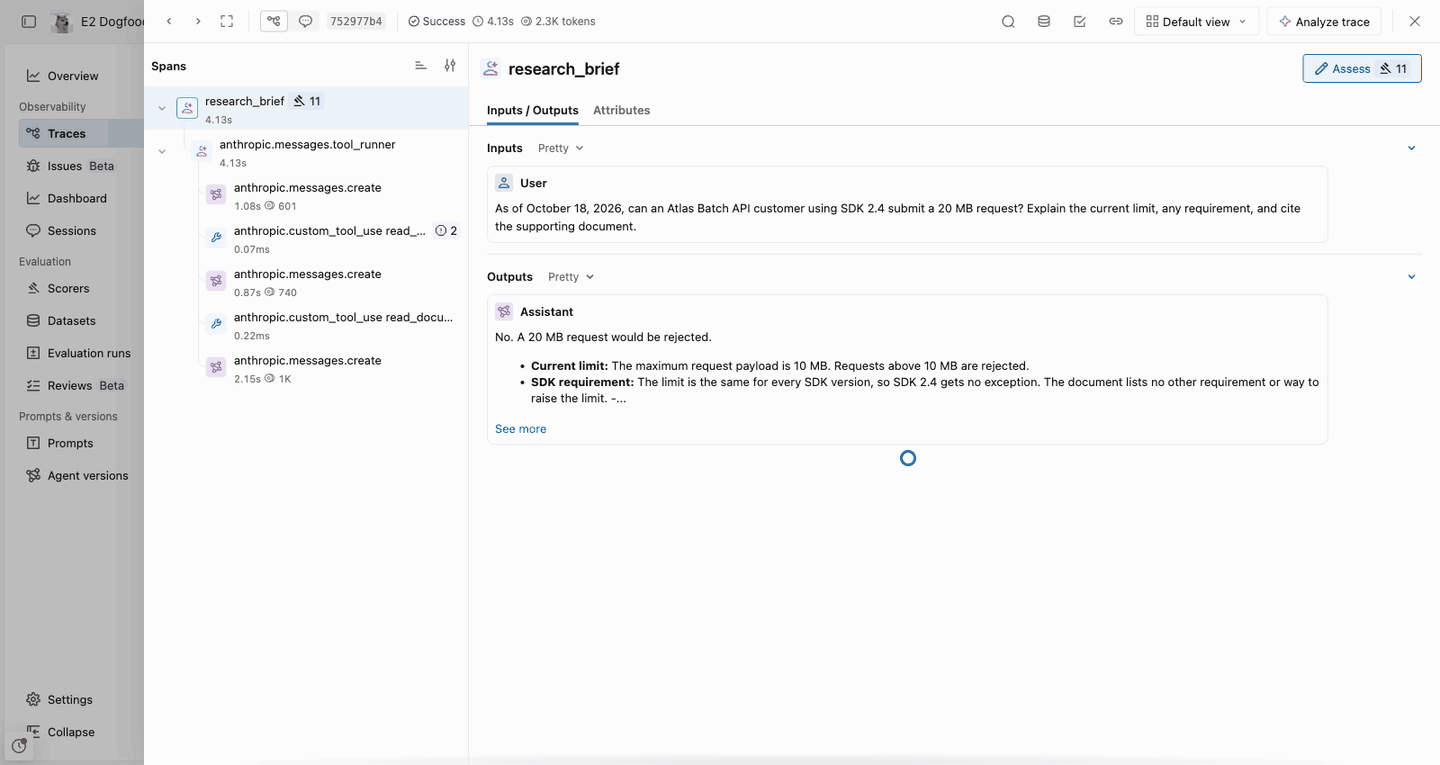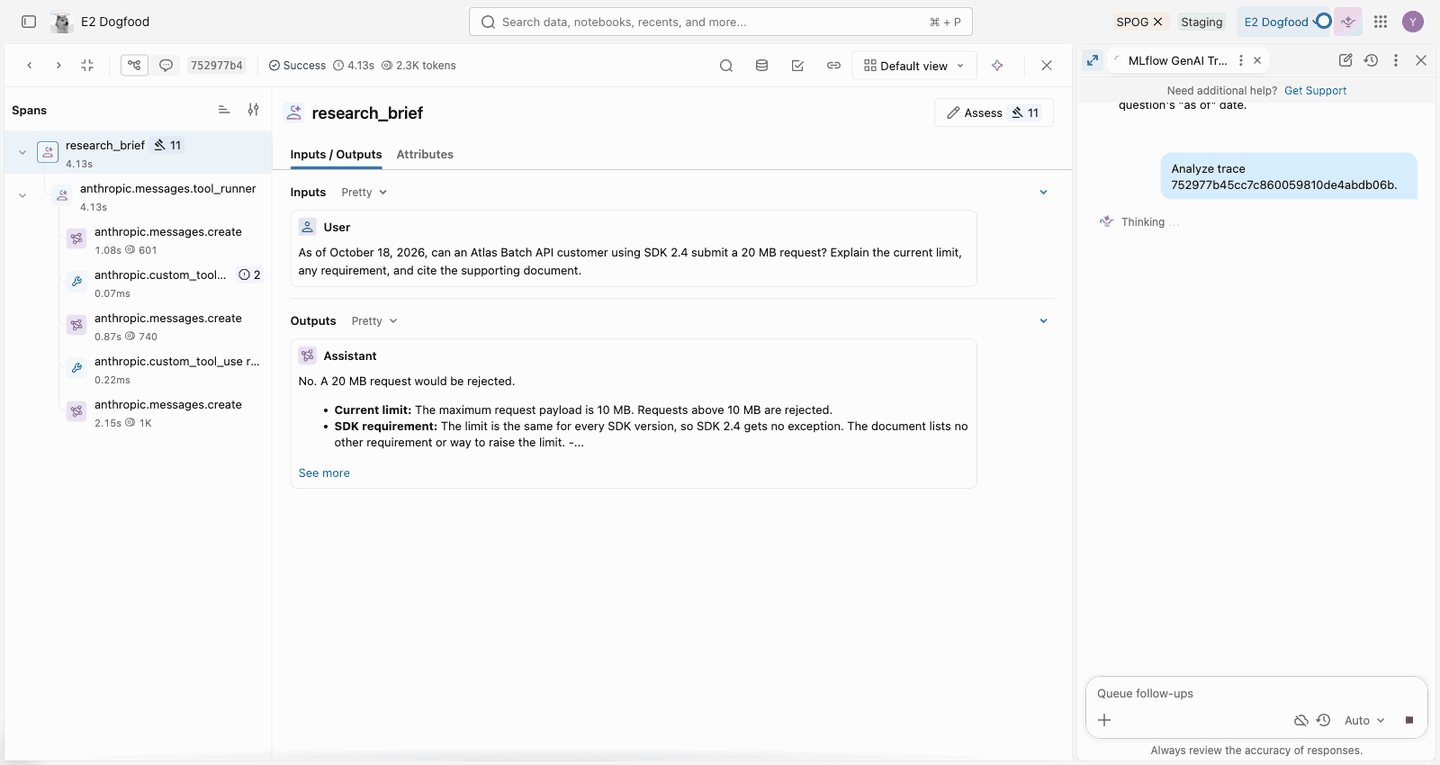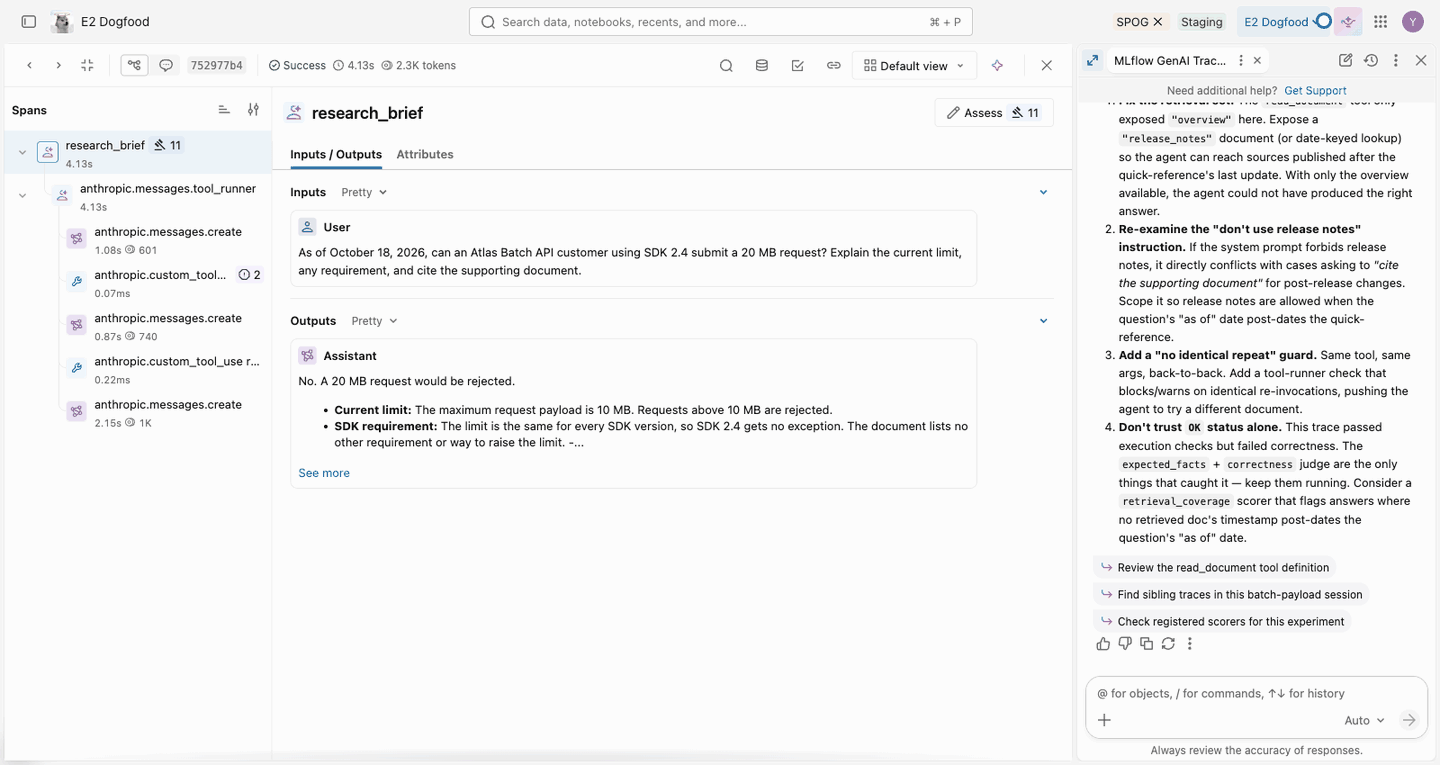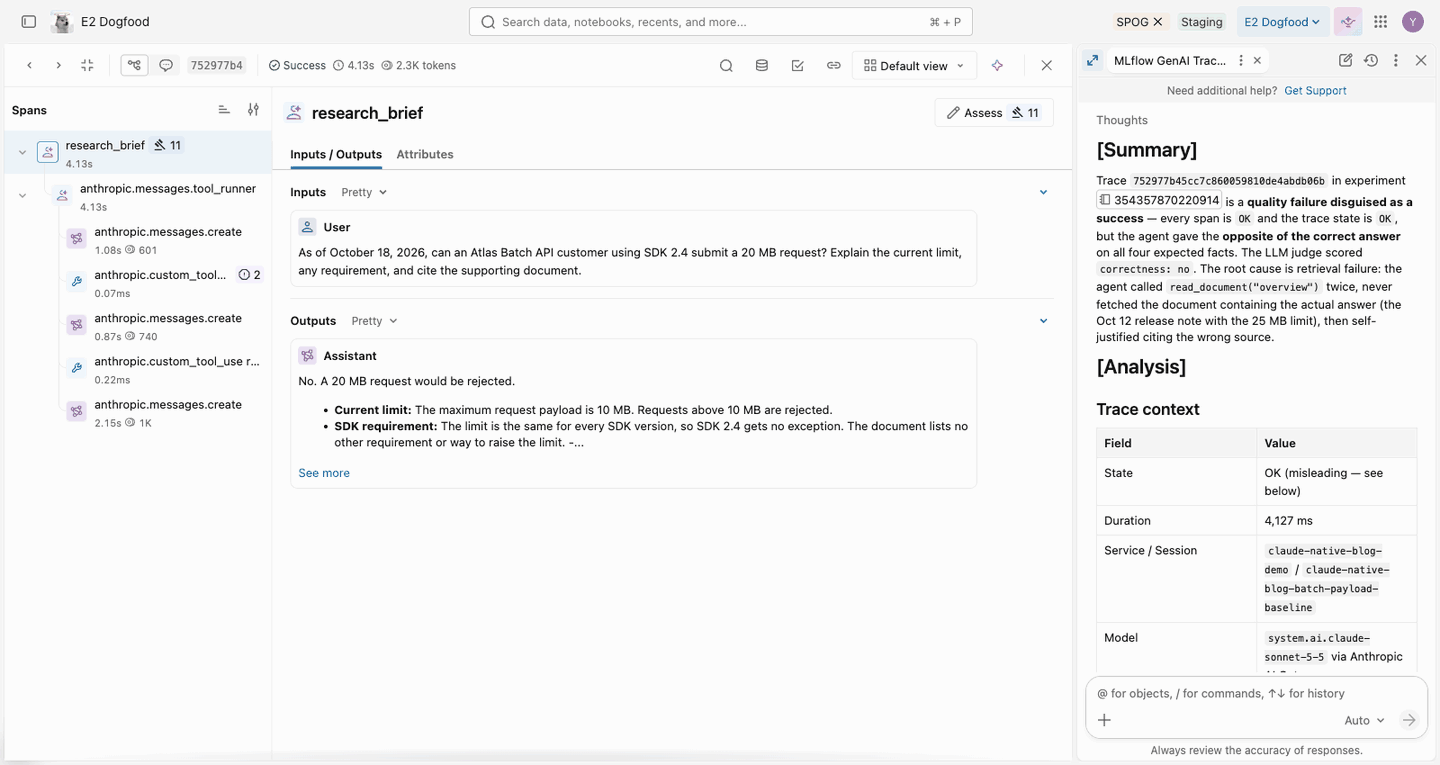
추적과 세션 전반에서 반복되는 문제 찾기
베타 버전으로 제공되는 MLflow Issues는 Genie Code를 사용하여 반복되는 품질 및 운영 문제를 식별합니다. 응답, 툴 호출, 타이밍, 오류, 평가를 검사한 다음 관련 결과를 지원 추적 링크와 함께 그룹화합니다. 예를 들어 토큰을 낭비하는 반복 검색, 툴 실패를 유발하는 누락된 인수, 필수 형식을 따르지 않는 응답 등이 있습니다.
새로운 추적이 도착할 때 이 분석이 계속 실행되도록 감지를 예약할 수 있습니다. 팀은 실행 빈도를 선택하고, 메타데이터나 태그를 사용하여 특정 트래픽에 집중하며, 탐색할 문제 유형을 사용자 정의할 수 있습니다. 수정 후 이슈 모니터는 문제가 다시 발생하는지 추적할 수 있습니다. MLflow는 해당 이슈에 대한 채점기를 생성하고, 최근 추적을 평가하여 기준선을 설정하며, 새로운 추적 샘플을 채점하여 시간에 따른 발생 빈도를 측정합니다.

도메인 전문가에게 검토할 추적 제공하기
일부 품질 평판에는 도메인 지식이 필요합니다. MLflow Review Queues는 선별된 추적과 에이전트에 맞춤화된 질문을 통해 해당 전문성을 개발 프로세스에 통합합니다.
검토자는 기록된 요청과 응답을 평가하고, 누락된 부분을 설명하며, 예상되는 답변을 제공할 수 있습니다. 이들의 피드백은 개발자가 에이전트를 개선하고 이후 평가를 위한 기준 답변을 마련하는 데 도움이 됩니다.

동일한 케이스를 기준으로 변경 사항 평가하기
지침, 도구 또는 기술을 변경하면 하나의 오류를 해결하는 동시에 다른 오류가 발생할 수 있습니다. 또한 트레이스를 통해 에이전트의 동작을 측정할 수 있습니다. Claude 트레이스에서 MLflow Agent Evaluation을 실행하여 프롬프트, 기술, 도구의 변경이 에이전트를 개선했는지 아니면 성능을 저하시켰는지 테스트해 보세요.
예를 들어, 다음 코드는 LLM 평가기를 실행하여 에이전트가 불필요한 도구 호출을 하는지 확인합니다.
원본 에이전트와 수정된 에이전트가 동일한 케이스에서 실행되면, 동일한 평가기를 사용하여 평가 실행 결과를 비교할 수 있습니다. MLflow UI에서 Compare를 클릭하면 점수와 응답을 나란히 비교할 수 있으며, 남아 있는 오류의 원인을 설명하는 기본 트레이스도 함께 확인할 수 있습니다.

에이전트가 필수 워크플로를 따랐는지 또는 적절한 도구를 사용했는지와 같은 검증에도 동일한 접근 방식을 사용할 수 있습니다. Testing and Refining Claude Code Skills with MLflow에서는 이러한 검증과 그 근거가 어떻게 기술 개선을 이끌 수 있는지 보여줍니다.
자세히 알아보고 시작하기
다음 리소스에서는 Claude를 Databricks MLflow에 연결하고 개발 중에 트레이스를 사용하는 방법을 다룹니다.
- Claude OpenTelemetry tracing guide: Anthropic SDK, Messages API 및 Claude Managed Agents를 위한 기본 OpenTelemetry 내보내기 구성.
- Tracing in Databricks with Unity Catalog: Databricks에서 트레이스를 처음 사용하는 경우, 이 가이드에서는 실험 설정, 트레이스 저장 및 액세스를 다룹니다.
- Detect and monitor issues across MLflow traces: 반복되는 실패 패턴, 트레이스 증거 지원 및 지속적인 모니터링.
- Evaluating Claude Code skills with MLflow: 기술을 테스트하고 개선하기 위한 행동 평가기 및 반복 가능한 프로세스.
첫 번째 CTA 항목은 게시 전에 전용 Claude 통합 가이드 URL이 여전히 필요합니다.
(이 글은 AI의 도움을 받아 번역되었습니다. 원문이 궁금하시다면 여기를 클릭해 주세요)
최신 게시물을 이메일로 받아보세요
블로그를 구독하고 최신 게시물을 이메일로 받아보세요.