AI 에이전트를 위한 데이터베이스: 5가지 평가 기준
AI 에이전트용 데이터베이스를 평가하는 5가지 기준(브랜치 격리, 서버리스 확장, 하이브리드 검색, ACID 보장, 통합 액세스)에 대해 알아보세요.
작성자: Databricks 직원
- AI 에이전트는 기존 앱이 사용하는 단일 요청 처리 방식이 아니라, 다양한 메모리 유형에 걸쳐 지속적이고 동시적인 읽기 및 쓰기를 지원하는 데이터베이스가 필요합니다.
- 프로덕션 환경에 적합한 에이전트 데이터베이스를 정의하는 5가지 기준은 에이전트별 브랜치 격리, scale-to-zero 컴퓨팅, 단일 쿼리에서의 하이브리드 검색, 동시성 환경에서의 ACID 보장, 그리고 ETL 지연이 없는 통합 플랫폼입니다.
- Databricks의 Lakebase는 Superhuman 및 easyJet의 실제 검증을 거쳐 이러한 모든 기준을 충족합니다.
AI 에이전트용 데이터베이스를 평가하는 5가지 기준은 브랜치 격리, 서버리스 확장, 하이브리드 검색, ACID 보장, 통합 플랫폼 액세스입니다. 이러한 기준은 개발자와 데이터 팀이 에이전트를 프로토타입에서 프로덕션으로 전환하고 동시 작업, 실시간 운영 데이터, 지속적인 상태(state)를 처리하기 시작할 때 해당 데이터베이스가 에이전트를 지원할 수 있는지 판단하는 데 도움이 됩니다.
AI 에이전트용 데이터베이스는 에이전트가 여러 단계와 세션에 걸쳐 작업을 완료하는 데 필요한 상태, 메모리, 도구 실행 결과 및 운영 데이터를 저장하도록 설계된 시스템입니다. 기존 애플리케이션을 지원하는 데이터베이스와 달리, 반복적인 읽기 및 쓰기, 동시 에이전트 활동, 다양한 유형의 메모리 전반에 걸친 검색, 최신 운영 데이터에 대한 액세스를 지원해야 합니다.
AI 에이전트의 부상으로 이러한 요구 사항이 더욱 중요해졌습니다. 개발자가 코딩 에이전트, 고객 지원 에이전트 또는 멀티 테넌트 플랫폼을 운영할 때 에이전트는 단순히 정보를 검색하는 것 이상의 역할을 수행합니다. 에이전트는 상태를 기록하고, 작업을 재개하며, 도구 호출을 조정하고, 변화하는 운영 데이터에 따라 행동합니다. 데이터 팀이 에이전트를 프로덕션으로 전환할 때 데이터베이스의 한계로 인해 오래된 메모리, 쓰기 충돌, 지연 시간, 불필요한 컴퓨팅 비용이 발생할 수 있습니다.
AI 에이전트용 데이터베이스가 기존과 다른 문제인 이유
프로덕션 준비가 된 에이전트는 이미 수행한 작업을 기억하고, 중단된 부분부터 작업을 다시 시작하며, 행동하기 전에 올바른 컨텍스트를 가져와야 합니다. 잘못된 데이터베이스와 연결하면 이 메모리가 오래되거나 불완전해지거나 일관성이 없어질 수 있습니다.
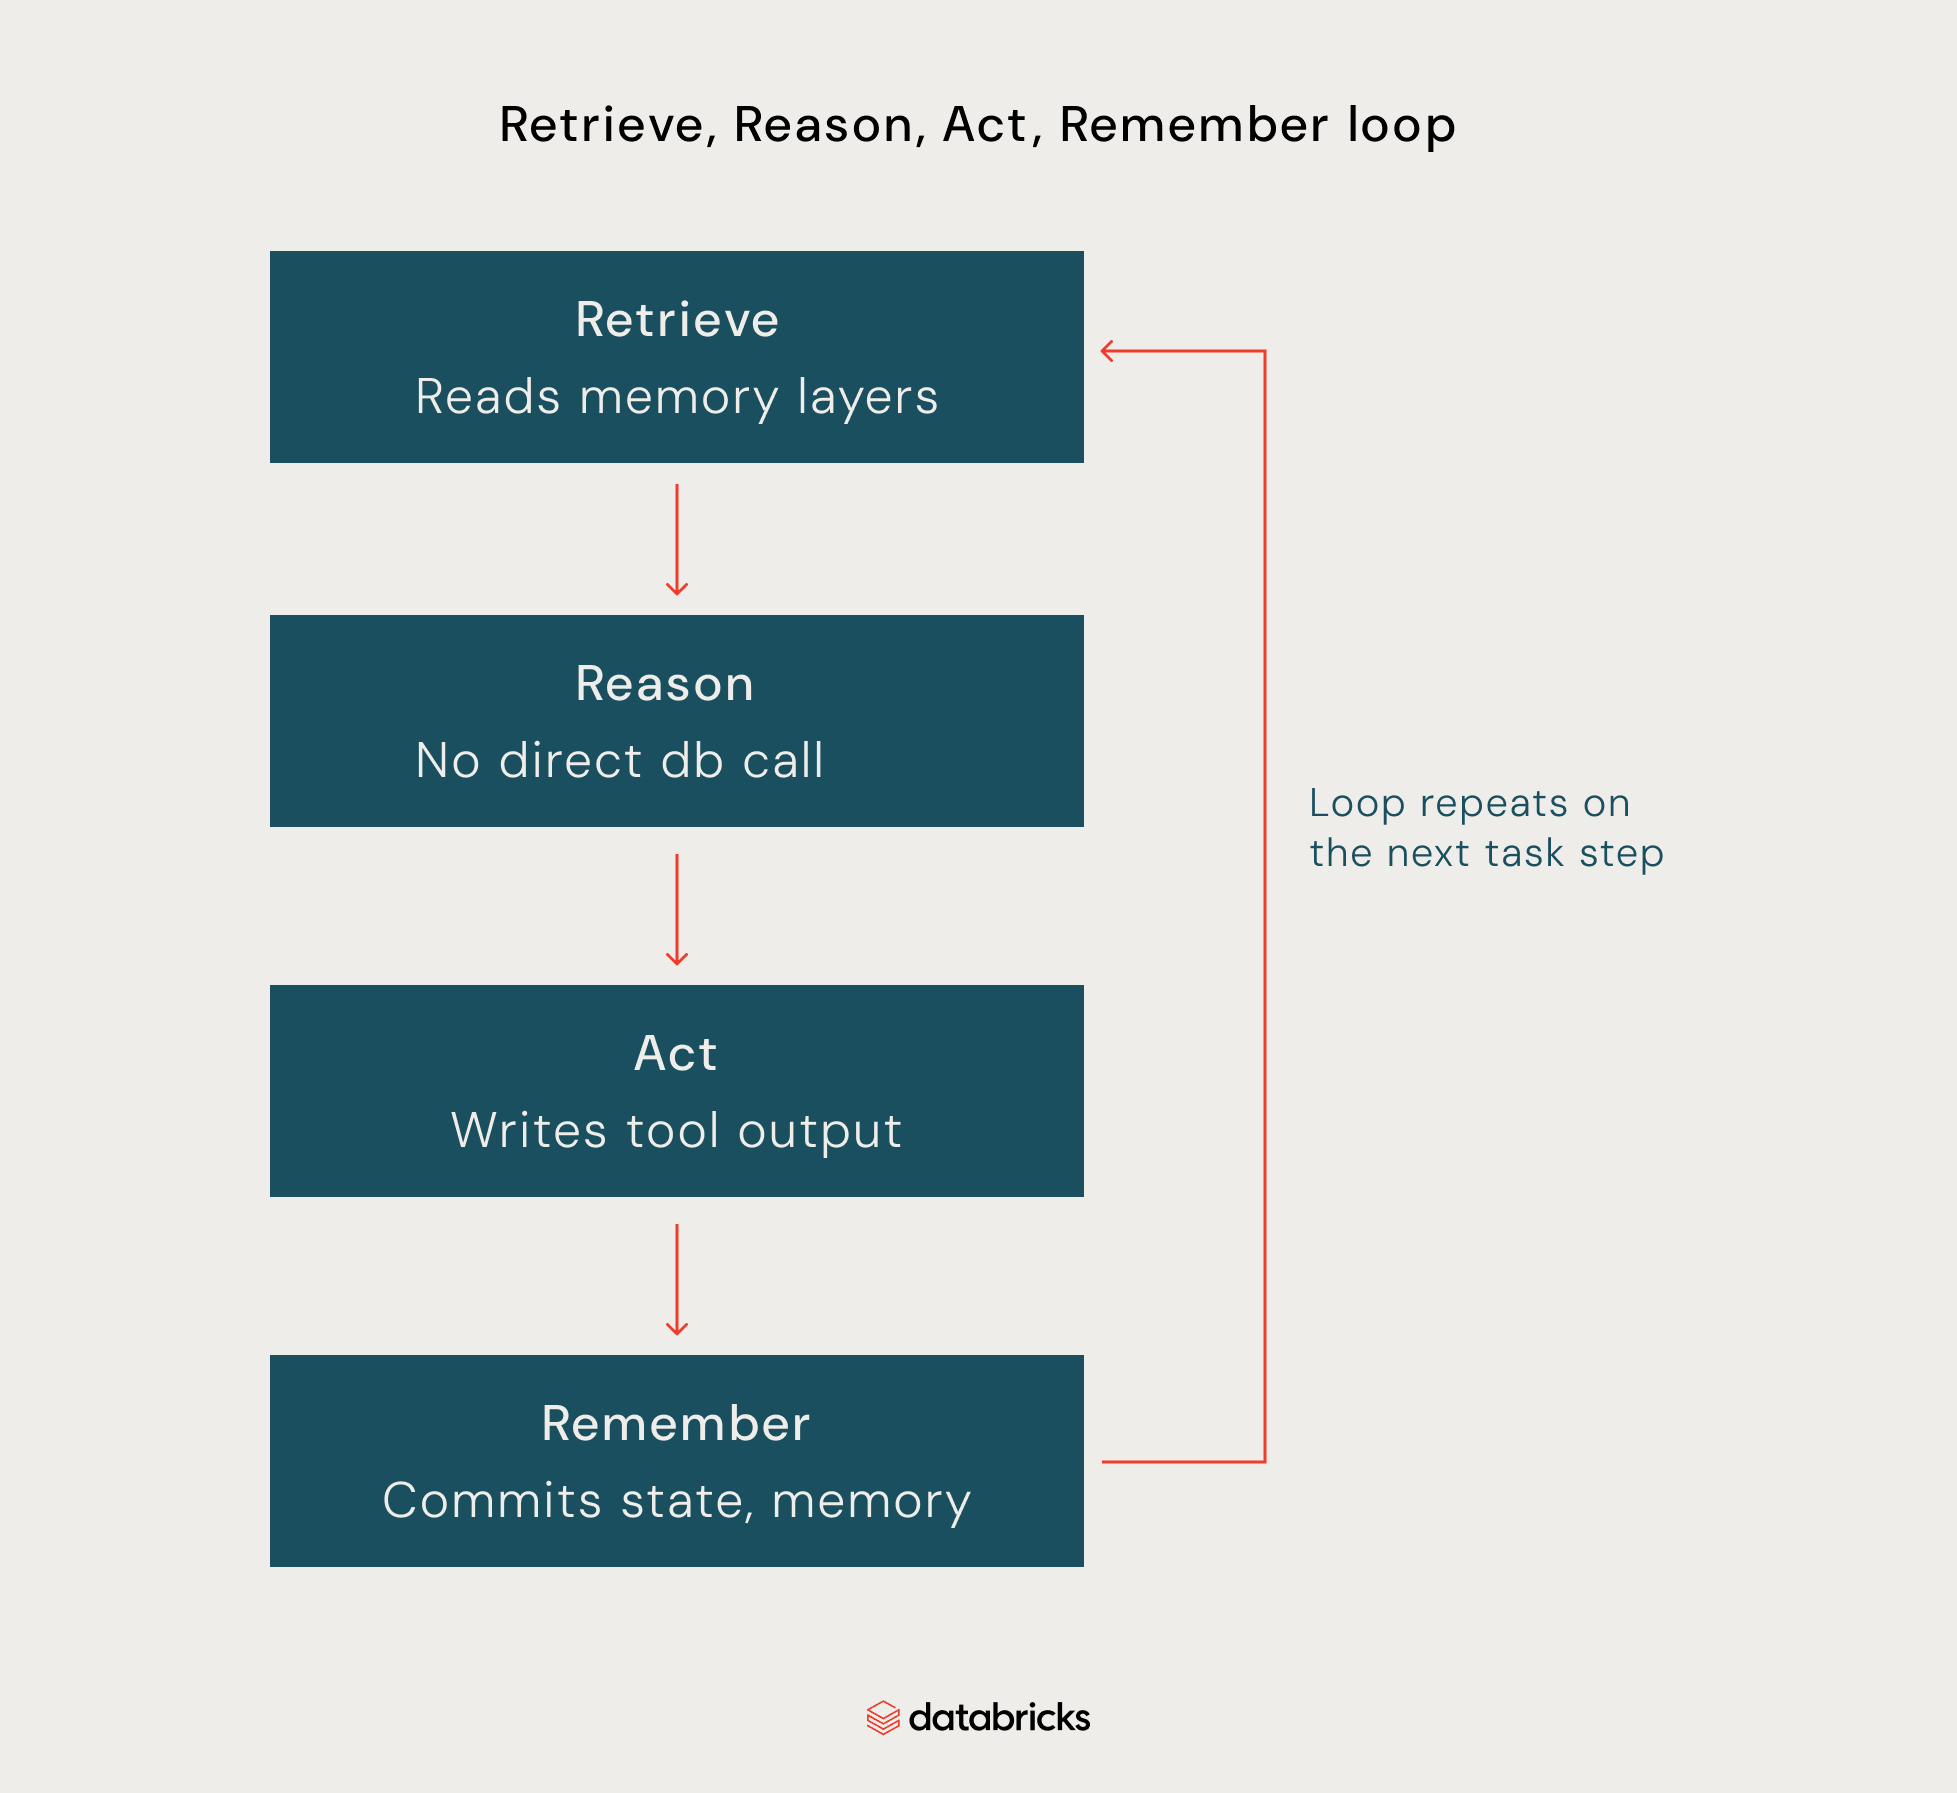
프로덕션 에이전트는 이를 실현하기 위해 4가지 메모리 레이어에 의존합니다.
- 단기 메모리(Short-term memory): 최근 메시지, 검색된 정보, 도구 결과를 포함하여 현재 상호작용 중에 사용할 수 있는 컨텍스트 내 작업 메모리입니다.
- 에피소드 메모리(Episodic memory): 에이전트가 이전 대화, 사용자 선호도, 완료된 작업을 기억할 수 있도록 하는 과거의 상호작용입니다.
- 절차적 메모리(Procedural memory): 외부 저장소에 있든 모델에 내장되어 있든 관계없이 작업이 수행되는 방식을 안내하는 워크플로우, 도구 정의 및 지침입니다.
- 운영 상태(Operational state): 완료 및 대기 중인 단계, 도구 출력, 나중에 작업을 재개하기 위한 체크포인트를 포함한 작업의 실시간 상태입니다.
이는 데이터베이스에 쿼리를 보내고 다음으로 넘어가는 일반적인 애플리케이션보다 더 복잡한 워크로드입니다. 대부분의 프로덕션 데이터베이스는 동일한 한 번에 한 요청 처리 패턴을 기반으로 구축된 운영 데이터베이스(또는 온라인 트랜잭션 처리(OLTP) 시스템)입니다. 에이전트는 그렇게 작동하지 않습니다. 에이전트는 수백 개의 다른 에이전트가 동시에 동일한 작업을 수행하는 동안, 사람의 개입 없이 단일 작업 내에서 계속해서 읽기와 쓰기를 반복합니다.
AI 에이전트 워크로드용 데이터베이스를 평가하기 위한 5가지 기준
AI 에이전트용 데이터베이스를 선택할 때 여러 기준이 중요하지만, 관리형이든 자체 호스팅형이든 상관없이 고려 중인 벤더에 관계없이 평가할 가치가 있는 5가지 기준은 다음과 같습니다.
에이전트별 브랜치: 실제 데이터 기반의 안전한 테스트
합성 데이터만으로 에이전트를 테스트하는 것은 완벽하게 형식이 지정된 소수의 고객 계정으로 지원 시스템을 테스트하는 것과 같습니다. 예상대로 정확하게 작동할 수는 있지만, 실제 계정은 항상 훨씬 더 복잡합니다. 데이터 팀은 결국 누락된 필드, 일관성 없는 레코드, 오래된 데이터, 테스트 픽스처에 포함되지 않은 예외적인 케이스(edge case)를 마주하게 됩니다.
그렇기 때문에 실제 데이터에 대한 격리된 테스트를 데이터베이스 평가 기준으로 삼는 것을 권장합니다. 목표는 에이전트가 프로덕션을 수정할 수 없도록 하면서 프로덕션과 유사한 상태에서 작동하도록 하는 것입니다. 이러한 격리를 달성하는 한 가지 방법은 개발자가 데이터베이스의 전체 복사본을 별도로 유지하지 않고도 독립된 환경을 만들 수 있는 제로 카피 브랜칭(zero-copy branching)입니다.
Lakebase Projects는 개발자가 기본 데이터를 복사하지 않고 프로덕션 데이터에서 브랜치를 생성할 수 있도록 하여 이러한 격리된 개발 및 테스트를 처리하도록 설계되었습니다. 테라바이트 규모의 프로덕션 데이터베이스를 브랜칭하는 데는 약 1초가 소요되며, 브랜치가 상위 데이터베이스와 달라지기 전까지는 추가 스토리지 비용이 발생하지 않습니다.
스케일 투 제로(Scale to zero): 서버리스 요금제가 에이전트 경제성을 변화시키는 방법
매년 클라우드 비용의 27%가 낭비되고 있으며, 사용되지 않고 방치되는 컴퓨팅 자원이 일관되게 가장 큰 원인입니다. 에이전트 데이터베이스가 왜 그런지 보여주는 명확한 예입니다. 대부분의 에이전트는 지속적으로 실행되지 않습니다. 에이전트는 깨어나서 작업을 수행하고 결과를 기록한 다음, 다음 요청이 들어올 때까지 대기 상태로 들어갑니다. 연중무휴 전용 컴퓨팅 비용을 지불한다는 것은 팀이 운영하는 모든 에이전트 데이터베이스에서 동일한 유휴 컴퓨팅 자원 낭비 문제를 겪고 있음을 의미합니다.
서버리스 스케일 투 제로(scale-to-zero) 모델은 활성 연결이 없는 기간이 지나면 컴퓨팅을 일시 중단하고 작업이 다시 시작될 때 재개함으로써 이 문제를 해결합니다. 이를 통해 비용은 유휴 시간이 아닌 실제 사용량을 따르게 됩니다. 하지만 비용 절감만큼이나 시작 속도도 중요합니다. 에이전트가 데이터베이스가 깨어날 때까지 20~30초 동안 기다리는 것은 실용적이지 않으며, 특히 사용자에게 응답하거나 다음 도구 호출을 기다릴 때는 더욱 그렇습니다.
Lakebase는 Postgres에 이 모델을 사용하여 새 쿼리가 발생하면 수백 밀리초 이내에 컴퓨팅을 재개합니다. 덕분에 시작 지연 시간이 매우 짧아 대화형 에이전트 워크로드에서도 스케일 투 제로가 원활하게 작동할 수 있습니다.
하이브리드 검색: 단 한 번의 쿼리로 4가지 메모리 레이어 모두 검색하기
벡터 검색만 사용하는 것은 정확한 도서 청구 기호가 아니라 "비슷한 느낌"으로만 책을 찾을 수 있는 사서와 같습니다. 데이터베이스 아키텍처에 관한 문서를 찾아달라고 하면 잘 찾아내겠지만, 계정 ID가 48291인 레코드를 찾아달라고 하면 정확하게 찾아낼 수 있는 신뢰할 만한 방법이 없습니다. 의미론적 유사성(semantic similarity)은 정확한 일치를 위해 설계되지 않았기 때문입니다.
이것이 바로 많은 검색 증강 생성(RAG) 파이프라인이 벡터 검색에만 의존할 때 직면하는 한계입니다. 하이브리드 검색은 서로 다른 시스템의 결과를 짜깁기하는 대신, 단일 쿼리에서 벡터 유사도, 키워드 매칭, 메타데이터 필터링을 결합하여 이 격차를 해소합니다. 이를 벡터 인덱스와 관계형 저장소로 나누면 에이전트는 한 번이 아니라 두 번의 호출을 해야 합니다. 시스템 간의 동기화가 어긋날 수 있으며, 추가적인 홉(hop)이 발생할 때마다 지연 시간이 늘어나 에이전트의 루프가 이를 감당하기 어려워집니다. 긴밀한 추론 사이클 내에서 유용하게 사용되려면 검색 시간이 100밀리초 미만이어야 합니다.
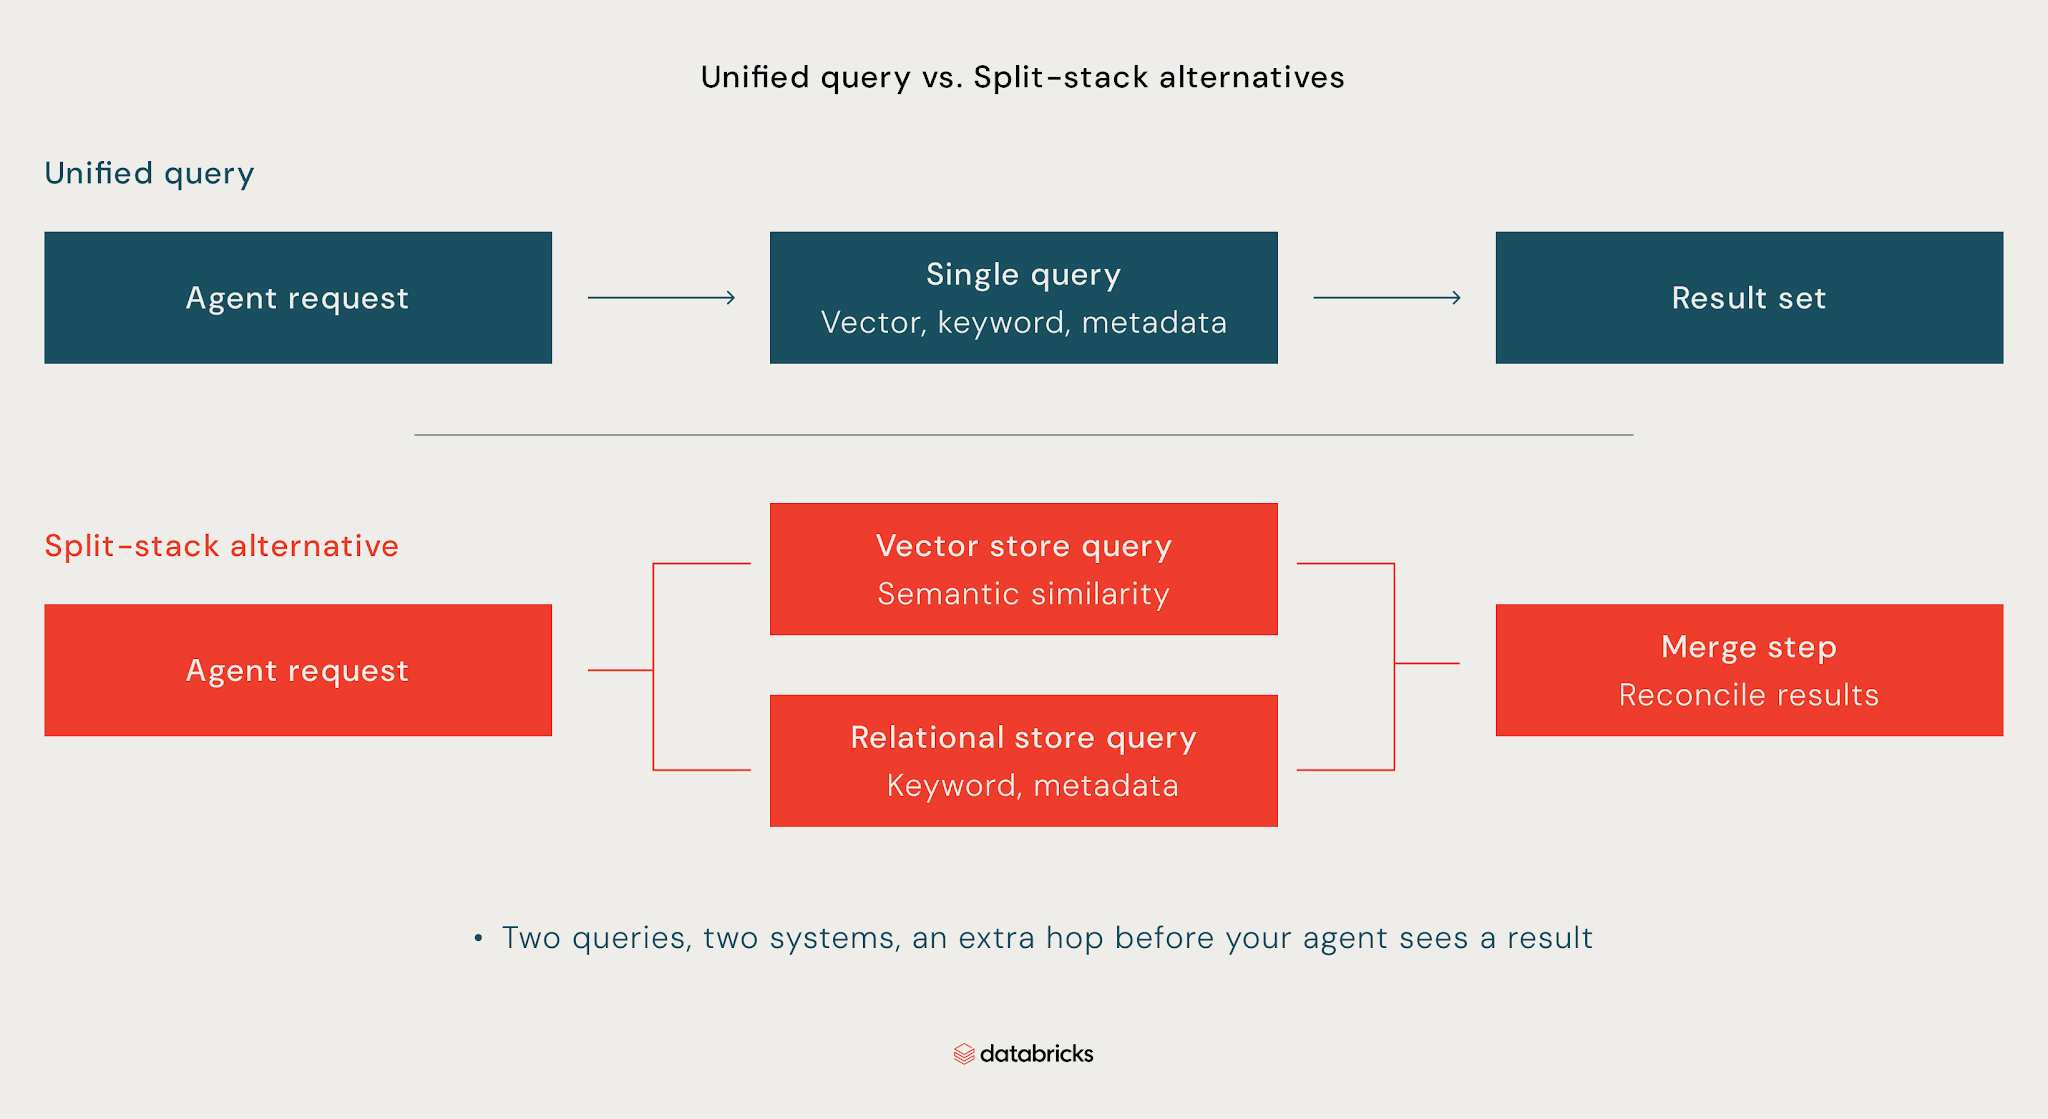
Lakebase Search는 운영 데이터가 이미 있는 동일한 Postgres 테이블에 대해 벡터, 키워드 및 메타데이터 쿼리를 실행하므로 동기화가 어긋날 수 있는 두 번째 시스템이 필요하지 않습니다. 이 데이터의 최신 상태를 유지하는 것은 바로 LTAP 아키텍처 덕분이며, 표준 Postgres보다 최대 5배 빠른 쓰기 성능을 제공합니다. 즉, 에이전트가 방금 기록한 내용을 거의 즉시 검색에 사용할 수 있습니다.
다중 에이전트 시스템을 위한 ACID 보장
두 명의 지원 에이전트가 동시에 동일한 고객 레코드를 업데이트하는 상황을 상상해 보세요. 한 에이전트는 결제 문제를 해결하고 구독 등급을 조정하는 중이고, 다른 에이전트는 환불을 기록하고 있습니다. 적절한 격리가 이루어지지 않으면 하나의 업데이트가 다른 업데이트를 덮어써서 두 에이전트 모두 의도하지 않은 상태로 레코드가 남을 수 있습니다.
그렇기 때문에 트랜잭션 보장이 다중 에이전트 워크로드용 데이터베이스를 평가할 때 필수적인 기준이 되어야 합니다. ACID는 개발자가 확인해야 할 4가지 속성을 제공합니다.
- 원자성(Atomicity): 트랜잭션이 완전히 완료되거나 전혀 완료되지 않아야 합니다.
- 일관성(Consistency): 데이터베이스는 모든 트랜잭션 전후에 유효한 상태를 유지해야 합니다.
- 격리성(Isolation): 동시에 실행되는 트랜잭션이 서로의 작업에 예기치 않은 방식으로 간섭하지 않아야 합니다.
- 지속성(Durability): 커밋된 쓰기는 시스템 다운이나 재시작 후에도 유지되어야 합니다.
다중 에이전트 시스템의 경우 약어 자체보다 실제적인 질문이 더 중요합니다. 도구 출력 커밋이 원자적으로 발생하여 절반만 완료된 작업이 완료된 것으로 처리되지 않도록 할 수 있는가? 두 에이전트가 동일한 레코드를 업데이트하면 어떻게 되는가? 데이터베이스가 지원하는 격리 수준(isolation level)은 무엇인가? 에이전트가 재시작 후 커밋된 상태를 잃지 않고 작업을 재개할 수 있는가?
데이터베이스를 비교할 때 단순히 "트랜잭션을 지원한다"는 주장만 믿기보다는 실제로 지원하는 격리 수준과 커밋 의미론(commit semantics)을 확인하는 것을 권장합니다. 여러 에이전트가 운영 데이터를 공유하게 되면, 이러한 세부 사항이 동시 작업의 예측 가능 여부를 결정합니다.
통합 플랫폼: ETL 없이 AI 스택에서 운영 데이터 활용하기
파이프라인이 따라잡기를 기다리는 에이전트는 오래된 데이터를 기반으로 의존적인 결정을 내리게 됩니다. 파이프라인이 실행될 때쯤에는 에이전트가 작업 중인 레코드가 이미 다시 변경되었을 수 있습니다. 데이터베이스를 평가할 때는 운영 데이터가 이에 의존하는 분석 및 AI 시스템과 얼마나 긴밀하게 연결되어 있는지 살펴보세요.
통합 플랫폼은 중간에 별도의 ETL(추출, 변환, 로드) (ETL) 파이프라인 없이 동일한 데이터에서 운영 쓰기 작업과 분석 읽기 작업을 유지합니다. 에이전트는 최신 데이터로 작업할 수 있고, 모델은 배치 작업을 기다릴 필요 없이 실시간 결과를 사용할 수 있습니다. 또한 데이터 팀은 에이전트 워크로드를 추적하기 어려운 별도의 시스템으로 내보내는 대신, 동일한 플랫폼에서 거버넌스 및 감사 추적을 유지할 수 있습니다. Unity Catalog는 Databricks 내의 운영 및 분석 데이터 모두에서 거버넌스 레이어를 적용하는 역할을 합니다. Superhuman의 사례는 이를 실제로 구현한 모습을 잘 보여줍니다. 캐싱 레이어와 관리형 NoSQL 저장소로 이어지는 맞춤형 동기화 파이프라인을 통합 플랫폼으로 대체함으로써 데이터 통합 기간을 거의 3개월에서 약 2주로 단축했습니다.
easyJet도 수익 관리 스택에서 유사한 접근 방식을 취했습니다. Lakebase로 마이그레이션한 이후, 이 항공사는 동일한 레이크하우스 데이터에서 분석과 함께 실시간 예약 및 가격 책정 활동을 캡처하고, 100개 이상의 Git 리포지토리를 2개로 통합했으며, 앱 개발 주기를 6~9개월에서 약 4개월로 단축했습니다.
Lakebase는 운영 데이터를 Databricks 레이크하우스에 보관하므로, 별도의 ETL 파이프라인 없이 동일한 데이터로 트랜잭션 워크로드와 후속 분석을 모두 지원할 수 있습니다.
멀티 에이전트 시스템, AI 활용 사례, 평가 등 주요 인사이트

AI 에이전트 데이터베이스 평가 스코어카드
비교 대상 벤더가 어디든 상관없이, 후보 데이터베이스를 다음 5가지 체크리스트로 검증해 보면 단 몇 분 만에 강점과 약점을 파악할 수 있습니다.
| 평가 기준 | 테스트 항목 | 최소 기준 | 위험 신호 | Lakebase 작동 방식 |
|---|---|---|---|---|
| 에이전트별 브랜치 | 전체 복사본을 만들지 않고 실제 프로덕션 데이터를 대상으로 격리된 브랜치를 생성할 수 있나요? | 분 단위가 아닌 몇 초 만에 브랜치 생성이 완료됨 | 전체 데이터베이스 복사본이 필요하거나 테스트 주기보다 오래 걸림 | 데이터가 변경되기 전까지 추가 스토리지 비용 없이 테라바이트 규모의 데이터베이스를 약 1초 만에 브랜치로 생성합니다. |
| Scale to zero | 일정 시간 동안 활동이 없으면 컴퓨팅이 일시 중지되고, 바로 사용할 수 있을 만큼 빠르게 재개되나요? | 수동으로 깨우는 단계 없이 1초 미만 내에 컴퓨팅이 재개됨 | 콜드 스타트에 10초 이상 소요되거나, 유휴 상태의 데이터베이스에 여전히 전체 요금이 청구됨 | 수백 밀리초 내에 다시 활성화되며, 일시 중지된 동안에는 비용이 청구되지 않음 |
| 하이브리드 검색 | 단일 쿼리로 벡터 유사도, 키워드 매칭, 구조화된 필터를 결합할 수 있나요? | 단일 쿼리로 100ms 미만 소요 | 벡터 저장소와 관계형 저장소에 각각 별도로 호출한 후 수동으로 병합해야 함 | 동일한 Postgres 테이블을 대상으로 벡터, 키워드, 메타데이터 쿼리를 실행함 |
| ACID 보장 | 두 에이전트가 동시에 동일한 레코드에 기록할 때 어느 한쪽의 쓰기 작업도 유실되지 않나요? | 쓰기 유실 없음, 동시 부하 상황에서도 격리 수준이 유지됨 | 알림 없이 덮어쓰기가 발생하거나 동시성 환경에서 격리 수준이 저하됨 | 동시 에이전트 부하의 영향을 받지 않는 표준 Postgres 트랜잭션 보장 제공 |
| 통합 플랫폼 | 새로운 쓰기 데이터가 분석에 사용 가능해지기까지 얼마나 걸리나요? | ETL 단계가 없거나, 지연 시간이 시간이 아닌 초 단위로 측정됨 | 다른 곳에서 데이터를 쿼리하기 전에 예약된 파이프라인이 필요함 | 별도의 파이프라인 없이 모든 쓰기 작업이 Databricks 레이크하우스에서 즉시 쿼리 가능해짐 |
이러한 최소 기준 중 두 가지 이상을 충족하지 못하는 데이터베이스는 나중에 어떻게든 해결할 수 있는 사소한 절충안이 아닙니다. 에이전트를 대규모로 운영하게 되면 프로덕션 환경에서 심각한 위험 요소가 됩니다.
마무리하며
AI 에이전트용 데이터베이스를 선택할 때 중요한 것은 기능 목록이 아니라 워크로드 적합성입니다. 이 가이드에서 제시하는 5가지 기준은 개발자와 데이터 팀이 프로덕션 환경에 도입하기 전에 모든 데이터베이스를 평가할 수 있는 실용적인 프레임워크를 제공합니다. 현재 후보 데이터베이스가 이러한 요구사항을 충족하지 못한다면, 향후 더 많은 사용자, 더 많은 작업, 더 많은 동시 작업을 처리하게 될 때 프로덕션 에이전트에서 결국 한계가 드러나게 될 것입니다.
AI 에이전트용 데이터베이스를 평가하고 있다면, Lakebase를 살펴보고 Databricks가 트랜잭션 워크로드, 브랜칭, 서버리스 확장, 하이브리드 검색, 운영 데이터에 대한 통합 액세스를 어떻게 지원하는지 확인해 보세요.
자주 묻는 질문
AI 에이전트에 데이터베이스가 필요한가요?
네, 필요합니다. 대부분의 에이전트 구현은 명시적으로 저장하고 다시 로드하지 않는 한 호출 간에 단기 컨텍스트, 에피소드 기록, 절차적 지식 또는 실시간 작업 상태를 유지하지 않습니다. 백엔드에 데이터베이스가 없으면 에이전트는 일반적으로 세션이 종료되는 즉시 해당 컨텍스트를 잃게 되며, 중단된 부분부터 작업을 다시 시작할 수 없습니다.
AI 에이전트에게 벡터 데이터베이스만으로 충분할까요?
벡터 데이터베이스 자체만으로는 충분하지 않습니다. 벡터 데이터베이스는 의미론적 검색을 잘 처리하지만, 에이전트는 운영 상태를 기록 및 업데이트하고, 동시 쓰기 작업 전반에서 트랜잭션 무결성을 보장하며, 유사도 검색으로는 확실하게 잡아내기 어려운 구조화된 필터를 적용해야 합니다. 의미론적 검색은 에이전트가 필요로 하는 기능의 일부일 뿐, 전체 워크로드를 감당할 수는 없습니다.
AI 에이전트의 RAG에 가장 적합한 데이터베이스는 무엇인가요?
정답은 하나가 아닙니다. AI 에이전트의 RAG를 위한 가장 좋은 데이터베이스는 단일 쿼리로 하이브리드 검색을 실행할 수 있고, 에이전트 루프에 맞춰 검색 속도를 충분히 빠르게 유지하며, 오래된 메모리를 방지할 수 있을 만큼 최신 상태를 유지하는 데이터베이스입니다.
멀티 에이전트 시스템은 데이터베이스 요구사항을 어떻게 변화시키나요?
여러 에이전트가 공유 데이터에 동시에 기록하기 시작하면 트랜잭션 무결성은 더 이상 선택 사항이 아닙니다. 데이터베이스는 동시 쓰기 작업을 격리하여 한 에이전트의 업데이트가 다른 에이전트의 업데이트를 알림 없이 덮어쓰지 않도록 해야 하며, 도구 출력값을 원자적으로 커밋하여 절반만 완료된 작업이 완료된 것으로 처리되지 않도록 해야 합니다.
AI 에이전트에서 OLTP와 OLAP의 차이점은 무엇인가요?
에이전트의 실시간 작업, 도구 출력값 기록, 상태 업데이트, 진행 상황 체크포인트 지정 등은 OLTP 워크로드에 해당합니다. 해당 데이터를 기반으로 하는 보고 및 모델 학습은 OLAP 워크로드입니다. 에이전트는 일반적으로 중간에 파이프라인 없이 동일한 데이터에서 두 작업을 모두 처리해야 합니다. 그렇기 때문에 이 가이드의 기준은 동일한 데이터에서 트랜잭션이 많은 에이전트 작업과 후속 분석을 모두 지원할 수 있는 데이터베이스에 초점을 맞추고 있습니다.
Postgres는 AI 에이전트에 적합한가요?
표준 Postgres는 강력한 ACID 보장과 성숙한 생태계를 제공하여 에이전트에 필요한 요구사항의 일부를 충족합니다. 하지만 자체적으로 제로 카피 브랜칭, scale-to-zero 컴퓨팅, 또는 통합된 운영 및 분석 액세스를 제공하지는 않으며, 이러한 기능은 이를 둘러싸고 구축된 플랫폼에 따라 달라집니다.
(이 글은 AI의 도움을 받아 번역되었습니다. 원문이 궁금하시다면 여기를 클릭해 주세요)
최신 게시물을 이메일로 받아보세요
블로그를 구독하고 최신 게시물을 이메일로 받아보세요.