Databricks for Good과 Virtue Foundation: 72개국의 의료 자원봉사자를 필수 의료 서비스에 연결하기 위한 파트너십
작성자: Priyanka Mehta , Shaunak Sen
- Virtue Foundation은 글로벌 보건 의료 성과를 향상하기 위해 AI를 활용하고자 Databricks for Good과 파트너십을 맺었습니다.
- 그 결과, Virtue Foundation은 의료진의 역량이 가장 절실히 필요한 개발도상국의 봉사 기회에 의료진의 기술을 더 효과적으로 매칭할 수 있게 되었습니다.
- Databricks와 Virtue Foundation 팀은 협력을 통해 업데이트된 핵심 데이터 세트를 쉽게 액세스하고 즉시 활용할 수 있는 형식으로 제공하고 있습니다.
소개
Virtue Foundation은 글로벌 보건 의료 지원과 효율적인 글로벌 자선 의료 시장 구축에 집중하는 비영리 단체입니다. 지금까지 가나와 몽골을 중심으로 50,000명이 넘는 환자에게 의료 서비스를 제공해 왔습니다. 이 시장의 중추 역할을 하는 것은 72개 저소득 및 중저소득 국가의 의료 전문가와 자원봉사 기회를 연결하는 플랫폼인 VF Match를 통해 전 세계 의료 시설 데이터를 큐레이션하는 것입니다. Databricks for Good은 2024년부터 Virtue Foundation과 긴밀히 협력하여 AI를 활용해 이러한 국가의 데이터를 통합하고 이를 실질적으로 활용할 수 있도록 지원하고 있습니다.
초기 POC(개념 검증)를 통해 LLM이 서로 다른 웹 데이터 소스에서 정형 정보를 추출하여 의료 인프라 지도와, 가장 중요하게는 자원이 부족한 지역의 서비스 공백을 파악할 수 있음이 입증되었습니다. 하지만 이 기능을 확장하고 프로덕션 환경으로 이전하는 데는 많은 어려움이 따랐습니다. 첫 번째 반복 작업 이후, 당사는 POC를 전 세계 수천 개의 의료 시설 및 비영리 단체의 데이터를 통합하는 프로덕션 등급 시스템으로 전환하는 Databricks 기반 플랫폼을 구축했습니다.
이 글에서는 Virtue Foundation이 의료 자원봉사자 커뮤니티를 이러한 국가의 시급한 요구 사항과 더욱 효과적으로 매칭할 수 있도록 이전 작업을 어떻게 개선했는지 살펴봅니다.
기반 구축: 72개국의 의료 데이터
VF Match의 핵심은 다양한 웹 기반 소스에서 처음부터 구축된 포괄적인 의료 시설 및 비영리 단체 데이터 세트인 FDR(기초 데이터 리프레시):입니다. 당사는 전 세계 72개 저소득 및 중저소득 국가의 데이터를 체계적으로 수집하고 리프레시합니다.
이 리프레시 작업은 상호 보완적인 두 가지 데이터 소스를 기반으로 합니다.
- Overture Maps: Meta와 Microsoft가 제공하는 오픈 소스 지리 공간 데이터 세트로, 신뢰할 수 있는 의료 시설 위치 정보를 제공합니다.
- Bright Data: 인터넷 전반에서 실시간 정보를 캡처하는 산업용 웹 스크래핑 인프라입니다.
FDR의 핵심은 OpenAI의 GPT 모델을 기반으로 하는 정보 추출 파이프라인입니다. 프로덕션 수준의 안정성을 보장하면서 LLM을 통해 2,500만 개 이상의 웹 페이지를 처리하려면 기존의 LLM 추론 파이프라인을 재고해야 했습니다. 당사의 파이프라인은 원샷(one-shot) 추출을 시도하는 대신, 작업을 의료 관련성 분류, 조직 유형(의료 시설 또는 NGO) 식별, 전문 분야, 장비 및 시술 추출 등 목표가 명확한 단계로 세분화합니다.
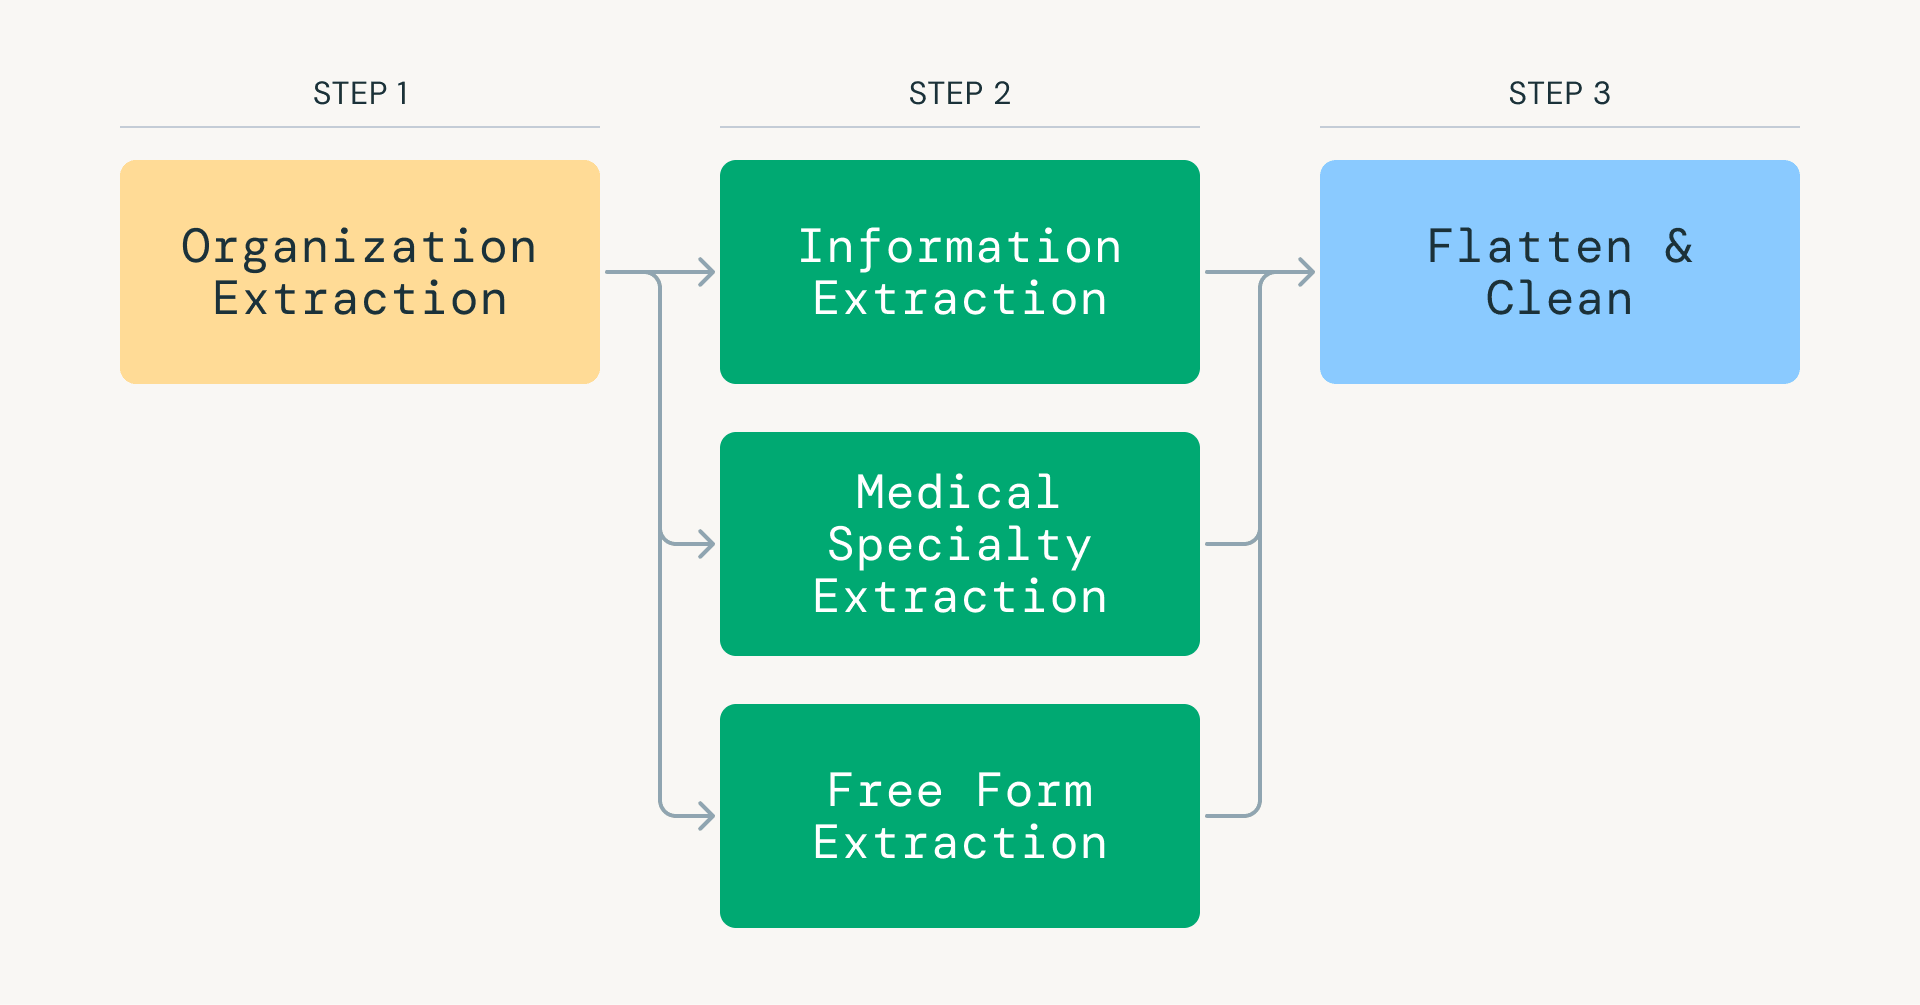
이러한 접근 방식은 토큰 소비를 극적으로 줄이는 동시에 각 모델 호출을 좁고 정밀도가 높은 작업에 집중시킵니다. Databricks와 Apache Spark를 사용하여 스크래핑된 데이터를 효율적으로 오케스트레이션하고 병렬화하며, 수천 개의 실행기(executor)에 워크로드를 분산하여 고처리량 LLM 추론을 지원합니다.
이 파이프라인을 확장 가능하고 프로덕션에 즉시 적용할 수 있도록 만드는 몇 가지 중요한 기능은 다음과 같습니다.
- 확장 가능한 데이터 모델링: 각 단계의 데이터가 스타 스키마에 저장되어 다운스트림 분석을 단순화하고 쿼리 성능을 향상시킵니다.
- 상태 기반 체크포인팅: 모든 레코드가 처리 상태를 추적하므로, 비용이 많이 드는 LLM 호출로 행을 재처리하지 않고도 어느 지점에서나 파이프라인을 재개할 수 있습니다.
- 구성 가능한 추출 레지스트리: 각 추출 방법은 시스템 프롬프트를 지정하는 구조화된 객체에 의해 제어되므로 추출 로직을 모듈화하고 재현 및 확장할 수 있습니다.
- 확장 가능한 분산 처리: 이 시스템은 병렬 처리를 위한 Spark, 대규모 성능을 위한 Photon, 프로덕션 등급의 오케스트레이션을 사용하여 불균형한 멀티 테라바이트 워크로드를 처리합니다.
이러한 보장 사항은 조건부 분기, 병렬 실행 및 지능형 재시도 정책을 통해 15개 이상의 상호 의존적인 작업을 오케스트레이션하는 Lakeflow Jobs를 통해 구현됩니다. 그 결과, 의료 전문가 수준의 정밀도로 의료 시설 데이터를 대규모로 처리하는 시스템이 탄생했습니다.
대규모 엔티티 분석(Entity Resolution)
LLM을 사용하여 시설 및 비영리 단체 데이터를 스크래핑하고 추출하고 나면, 엔티티 분석(Entity Resolution)이라는 고전적인 과제가 발생합니다. 동일한 시설이 이름 변형, 일치하지 않는 주소 또는 누락된 연락처 정보와 함께 여러 데이터 소스에 나타날 수 있습니다. 데이터가 정돈되지 않은 이러한 시나리오에서는 기존의 중복 제거 방식이 작동하지 않으므로, 오픈 소스 확률적 레코드 연결 프레임워크인 Splink를 사용합니다. Splink는 IE(정보 추출) 단계에서 얻은 정보를 사용하여 전화번호, 상세 주소 등의 필드에 대한 가중치 비교를 통해 일치 쌍을 평가합니다. 그 결과 시설당 통합 키가 생성되어 최종 사용자가 각 의료 시설 및 NGO에 대해 신뢰할 수 있는 단 하나의 레코드를 볼 수 있게 됩니다.
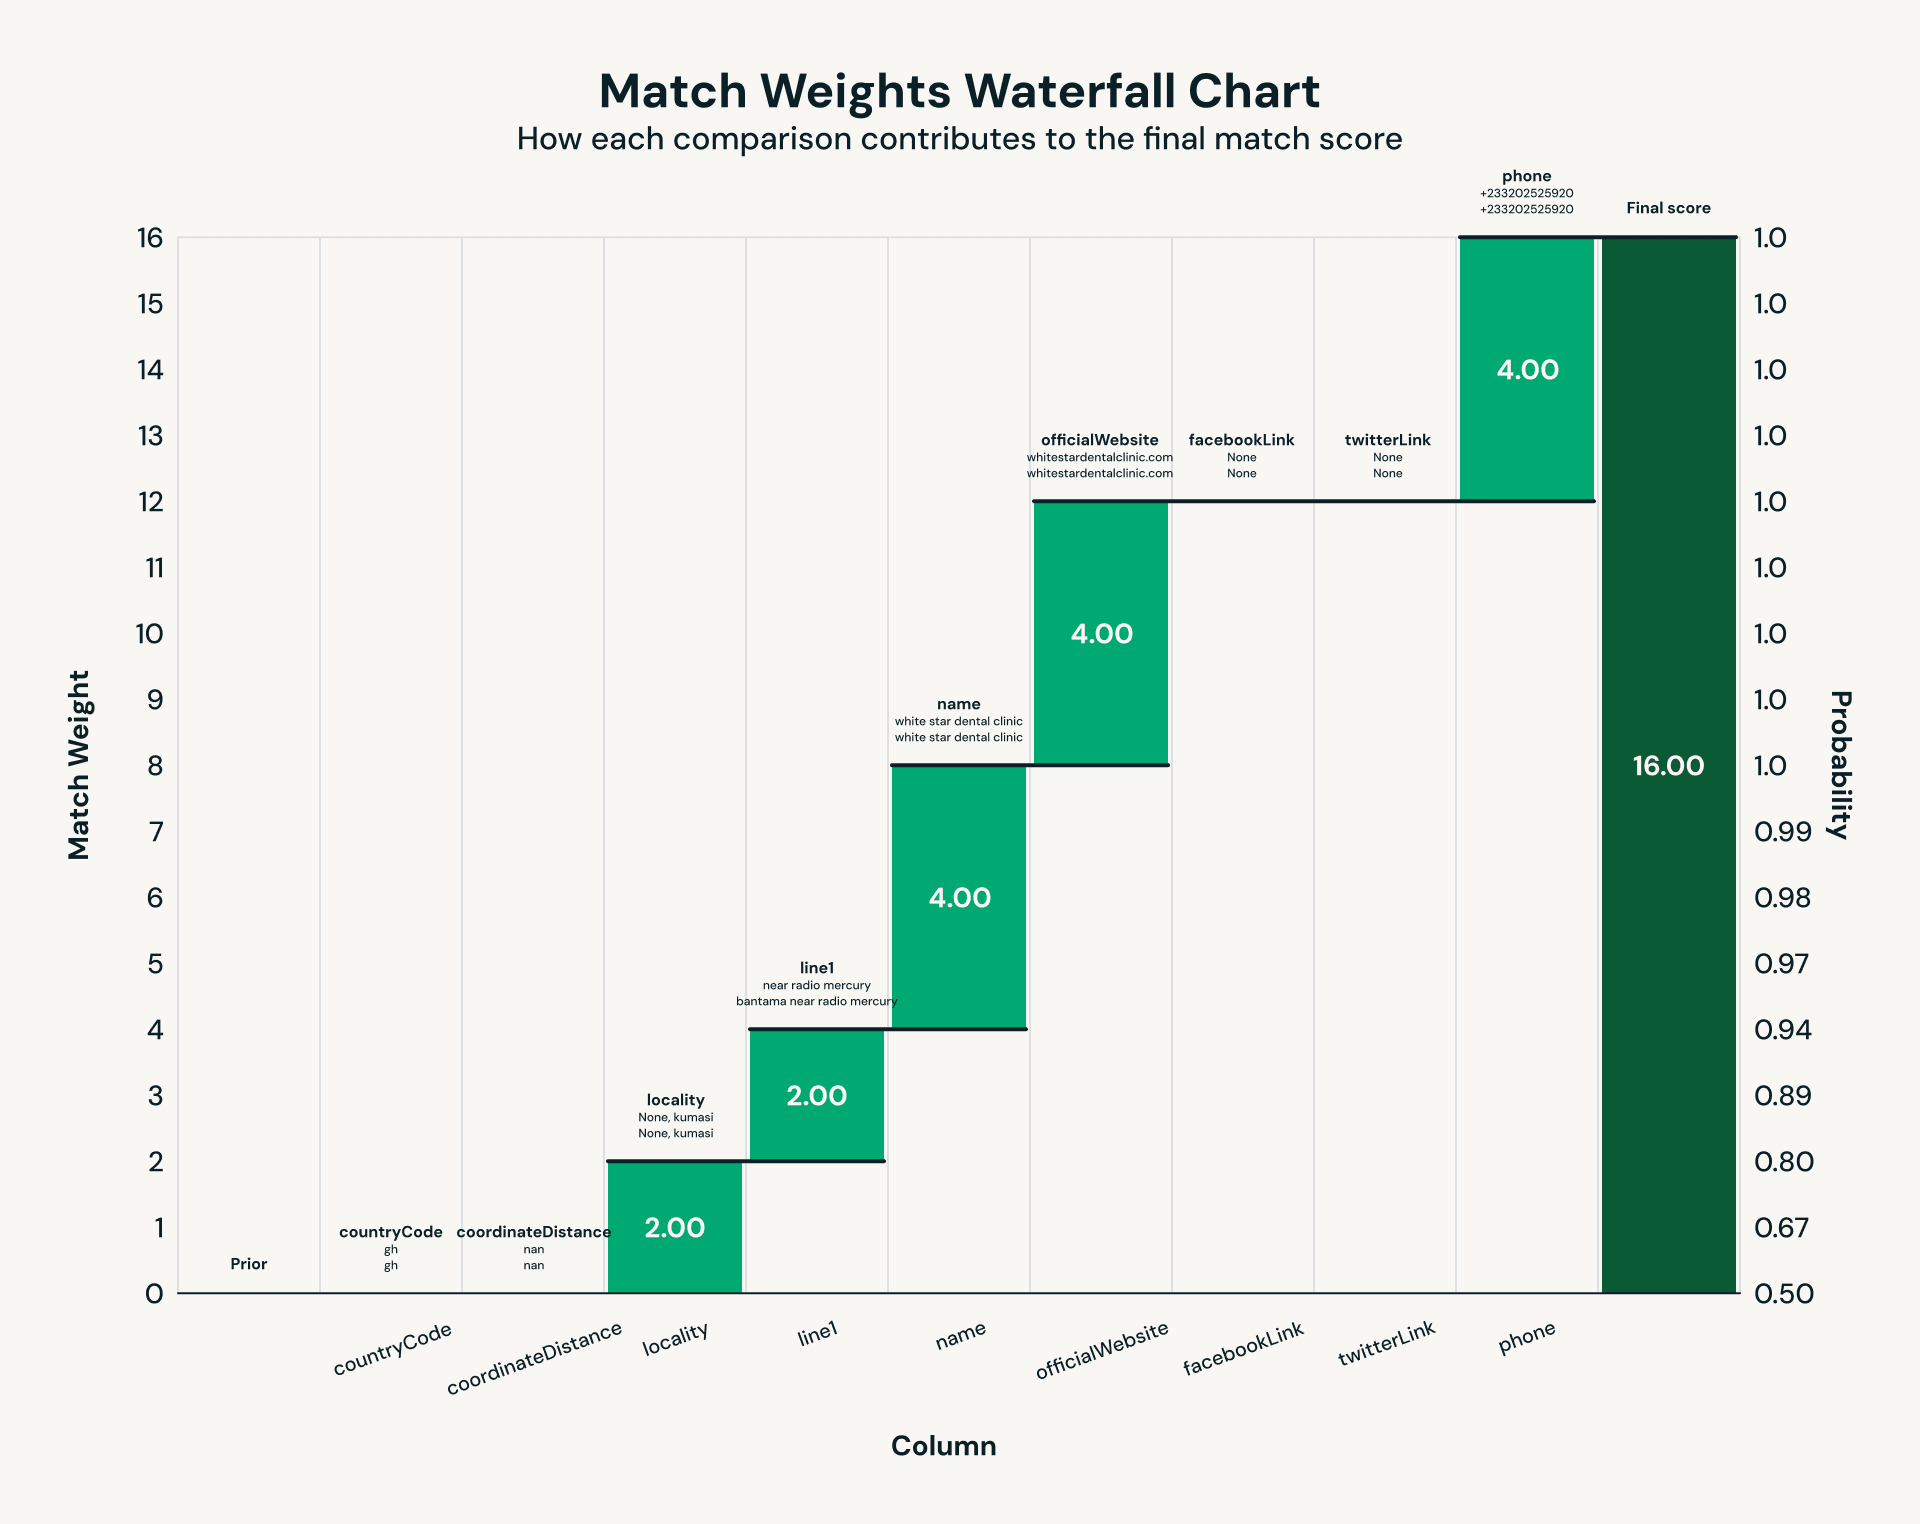
수천 개의 의료 시설과 비영리 단체에 대해 확률적 매칭을 실행하면서 테라바이트 규모에서 발생하는 전형적인 성능 병목 현상이 나타났습니다. 레코드 연결의 핵심은 쌍별 비교(pairwise comparison)인데, 이는 본질적으로 불균형한 워크로드를 생성합니다. 즉, 흔히 발생하는 비교는 대규모 파티션을 생성하는 반면 대부분의 다른 비교는 훨씬 작게 유지됩니다. 초기 실행에서 이러한 현상이 극명하게 드러났는데, 하나의 Spark 파티션이 30분 동안 실행되는 동안 중앙값은 52초 만에 완료되었습니다. 이는 스트래글러(straggler, '마지막 리듀서의 저주')가 작업 성능을 저하시키는 교과서적인 사례였습니다. Databricks의 벡터화된 쿼리 엔진인 Photon을 활성화하자 최악의 데이터 파티션 처리 시간이 30분에서 약 2분으로 단축되어 15배의 성능 향상을 기록했습니다.
VF Agent: 자연어와 의료 데이터의 만남
미래를 내다보며 당사는 전문가가 자연어를 사용하여 데이터를 분석할 수 있는 에이전트 프로토타입을 개발했습니다. LangGraph로 구축된 멀티 에이전트 아키텍처를 사용하며, Databricks Model Serving, AI Search 및 Genie를 활용합니다.
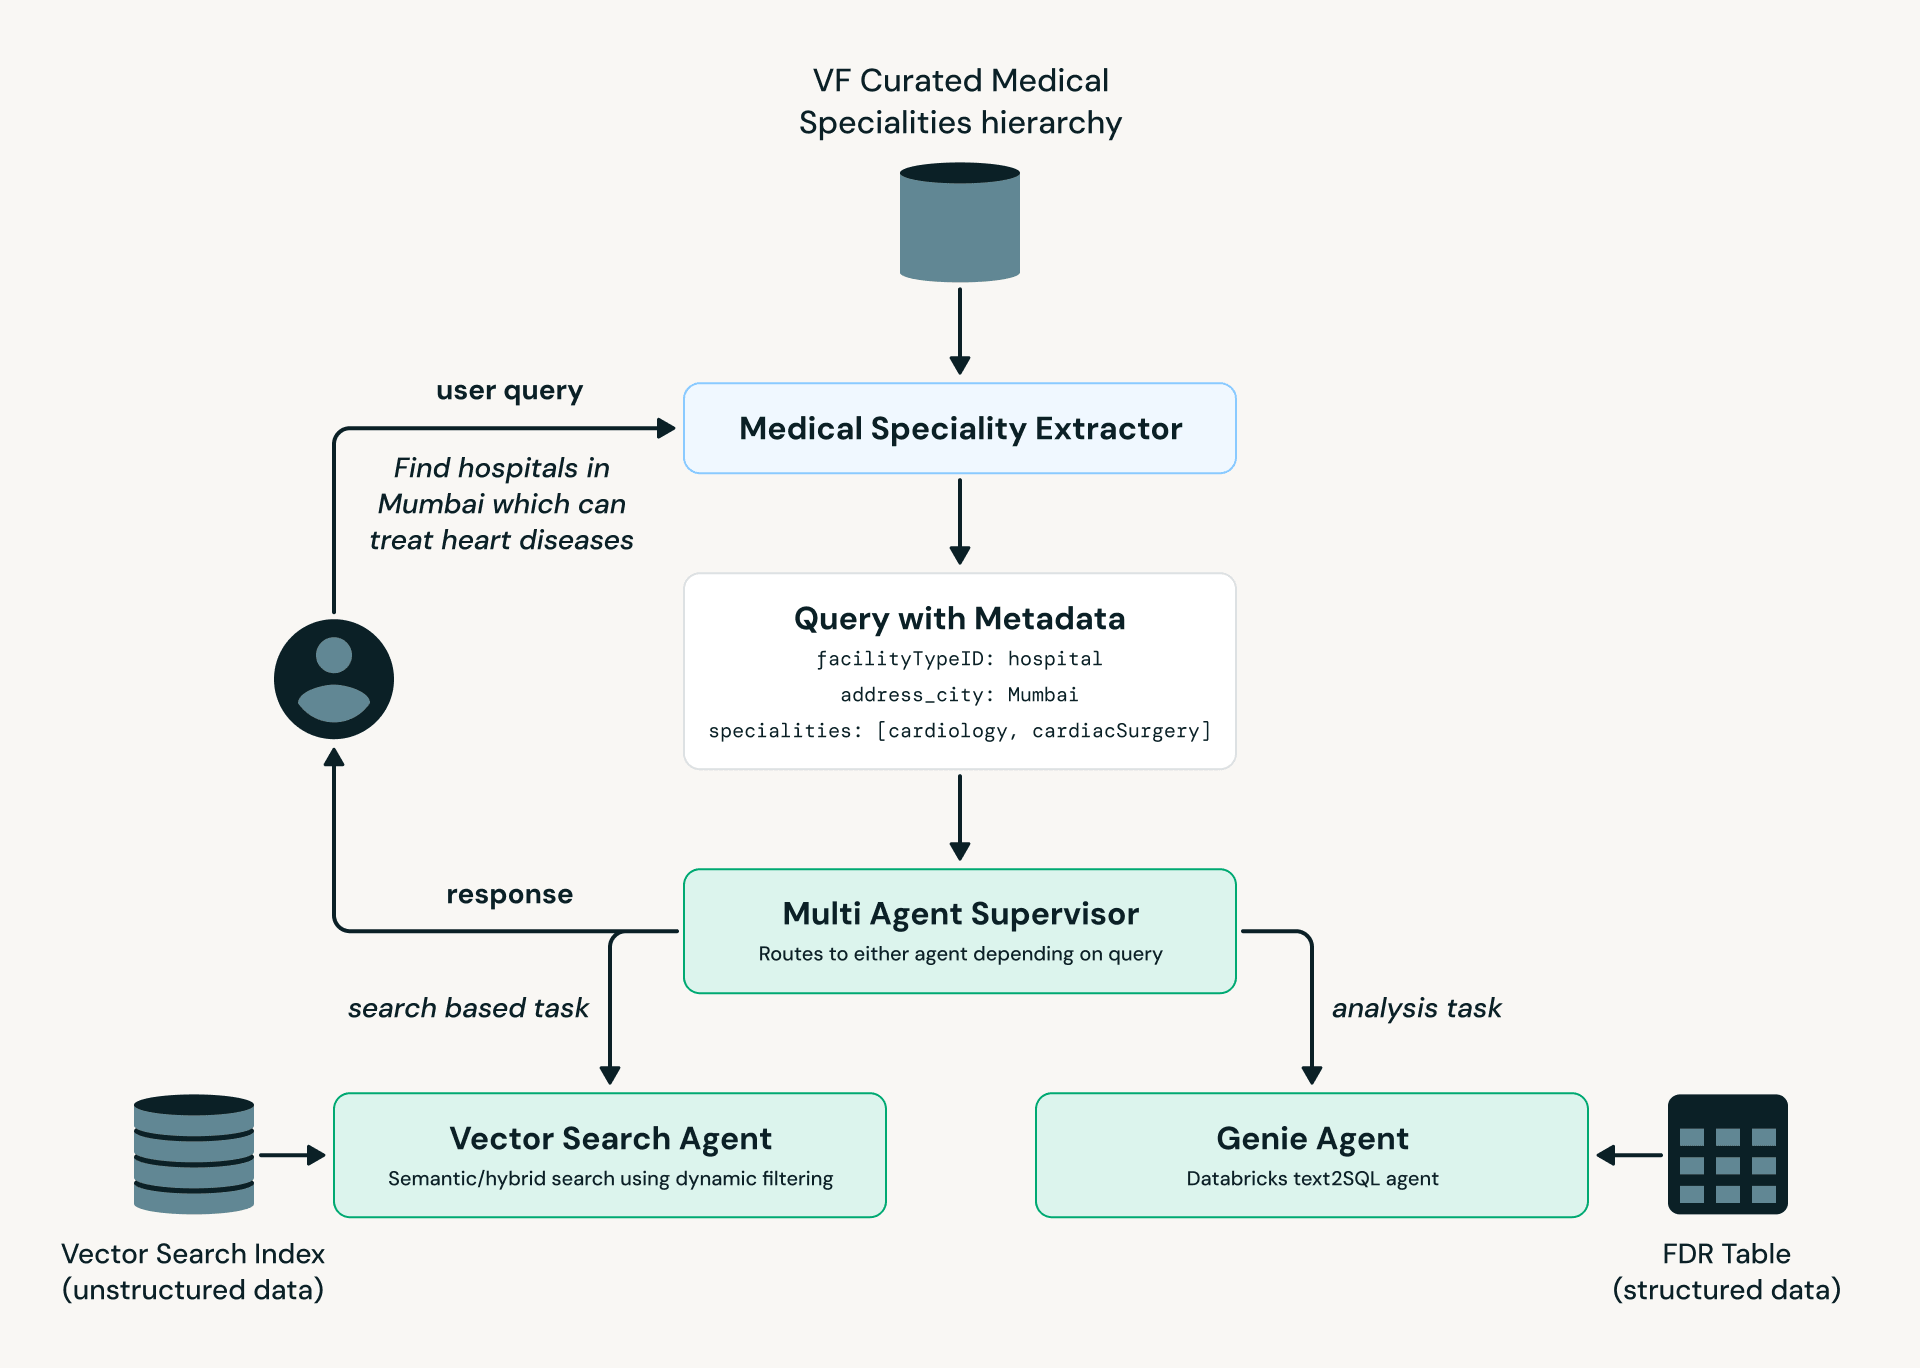
위의 다이어그램에 나와 있는 것처럼, 의료 전문 분야 추출기(Medical Specialty Extractor)는 사용자의 언어를 표준화된 의료 용어로 변환한 다음 이를 멀티 에이전트 감독자(Multi-Agent Supervisor)로 전달합니다. 쿼리의 의도와 복잡성에 따라 AI Search Agent(시설 검색 및 탐색) 또는 Genie Agent(정형 데이터에 대한 분석 쿼리)로 라우팅됩니다.
요약
이제 의료 전문가는 최신 기회를 더 빠르게 찾고, 자신의 의료 전문 분야에 맞는 매칭을 발견하며, 전 세계 수천 개의 시설에 대한 글로벌 데이터에 액세스할 수 있습니다. Virtue Foundation이 POC에서 프로덕션으로 전환한 여정은 고급 AI 시스템이 통합 데이터 플랫폼과 결합할 때 무엇이 가능한지 보여줍니다.
최종 결과는 글로벌 의료 인프라에 대한 통합된 뷰를 제공하여 의료 자원봉사자가 가장 절실히 필요한 곳을 보여주는 것입니다.
이 프로젝트에 대해 자세히 알아보려면 다음을 참조하세요.
- Databricks x Virtue Foundation 프로젝트 개요 - YouTube
- UN Bloomberg 인터뷰(YouTube) - 38:00분 부근
- 동영상 추천사: Bright Initiative x Virtue Foundation x Databricks
아래에서 다른 Databricks for Good 프로젝트에 대해 자세히 알아보세요:
(이 글은 AI의 도움을 받아 번역되었습니다. 원문이 궁금하시다면 여기를 클릭해 주세요)
최신 게시물을 이메일로 받아보세요
블로그를 구독하고 최신 게시물을 이메일로 받아보세요.