Databricks의 에이전트 메모리 소개
작성자: Sirui Sun , Nihit Desai
오늘 Databricks의 에이전트 개발자 플랫폼인 Agent Bricks에 에이전트 메모리(agent memory) 기능을 선보입니다. 에이전트 메모리는 에이전트가 기억해야 할 주요 사실, 기본 설정 및 워크플로를 저장하여 비용과 지연 시간을 줄이는 동시에 에이전트 품질을 향상시킵니다. 현재 베타 버전으로 제공되며, 높은 신뢰성과 낮은 지연 시간을 위해 Lakebase에서 실행되고 Databricks의 최신 메모리 연구를 기반으로 구축되었습니다.
메모리가 없으면 에이전트는 주요 사실을 다시 찾아내고, 사용자 환경설정을 잊어버리며, 이미 수정된 오류를 반복할 위험이 있습니다. 이에 대응해 많은 개발자가 자체 메모리 솔루션을 구현하고 있지만, 메모리를 어디에 저장해야 하는지, 메모리를 어떻게 종합해야 하는지, 생성된 메모리를 어떻게 검색해야 하는지 등 수많은 설계 문제에 직면합니다.
이 문제를 해결하기 위해 Databricks Agent Memory는 Databricks Research가 개척한 MemCurrent 아키텍처를 기반으로 구축되었습니다. MemCurrent는 컨텍스트를 자동으로 기록하고 로드하는 플러그인, 에이전트가 필요할 때 호출하는 도구, 백그라운드에서 메모리를 통합하는 오프라인 드림 파이프라인이라는 세 가지 액세스 패턴을 결합합니다. 이 모든 작업은 Lakebase를 사용하여 극도로 낮은 지연 시간으로 제공됩니다. 내부 벤치마크 결과, 이 메모리 아키텍처를 구현하면 실제 엔터프라이즈 작업에서 토큰을 31% 절감하면서 에이전트 성공률을 3배로 끌어올렸습니다.
Agent Memory는 에이전트 호스팅, Databricks Sandbox, Unity Gateway, 사전 구축된 MCP 서버, 추적 및 평가를 포함한 Agent Bricks의 다른 기능과 결합하여 프로덕션 에이전트를 구축하는 데 필요한 모든 인프라 기능을 개발자에게 제공합니다.
문제점: 상태 비저장 에이전트는 동일한 컨텍스트에 대해 두 번 비용을 지불합니다
에이전트가 데모 단계에서 일상적인 사용 단계로 이동하는 즉시 두 가지 문제점이 나타납니다.
- 다시 찾아낼 때마다 비용이 증가합니다. 상태 비저장 에이전트는 어떤 테이블에 사용량 데이터가 있는지, 내부 약어가 무엇을 의미하는지, 어떤 조인이 실제로 작동하는지 등 어제 파악한 내용을 다시 도출합니다. 연구의 한 실제 세션에서 에이전트는 한 제품의 주요 고객에 대한 질문에 답하기 위해 11번의 도구 호출, 8개의 서브에이전트, 거의 6분의 시간을 소비했습니다. 다음 날에도 똑같은 작업을 다시 반복해야 합니다.
- 에이전트가 맞춤형으로 작동하지 않습니다. 사용자가 기본 설정을 지정하거나, 오류를 수정하거나, 팀의 지표 정의 방식을 설명해도 세션이 종료되면 에이전트는 이를 잊어버립니다. 결국 사용자가했던 말을 반복하거나 에이전트가 실수를 반복하게 됩니다.
에이전트 개발자와 에이전트를 운영하는 플랫폼 팀에는 두 가지 일반적인 우회 방법이 있습니다. 하지만 각각 하나의 문제를 다른 문제와 맞바꾸는 방식입니다.
- 전체 기록을 컨텍스트에 다시 재생하는 방식은 기록이 길어질 때까지는 작동합니다. 오픈 소스 메모리 벤치마크에 따르면 전체 컨텍스트 방식은 동일한 정확도에서 잘 설계된 메모리보다 질문당 약 12배 더 많은 입력 토큰을 사용했으며, 가장 긴 기록에서는 관련 없는 대화 순서가 에이전트를 혼란스럽게 만들어 결과가 더 악화되었습니다.
- 오브젝트 스토리지나 벡터 데이터베이스에 직접 메모리를 구축하는 방식은 추출, 중복 제거, 검색 및 액세스 제어를 직접 관리해야 함을 의미합니다. 메모리가 오래되고 모순된 사실이 쌓이며, 어떤 메모리로 인해 잘못된 답변이 나왔는지 아무도 알 수 없게 됩니다.
팀에 필요한 것은 또 다른 시스템을 구축할 필요 없이 에이전트를 더 저렴하면서도 동시에 더 맞춤화할 수 있는 메모리입니다.
Databricks Agent Memory 작동 방식
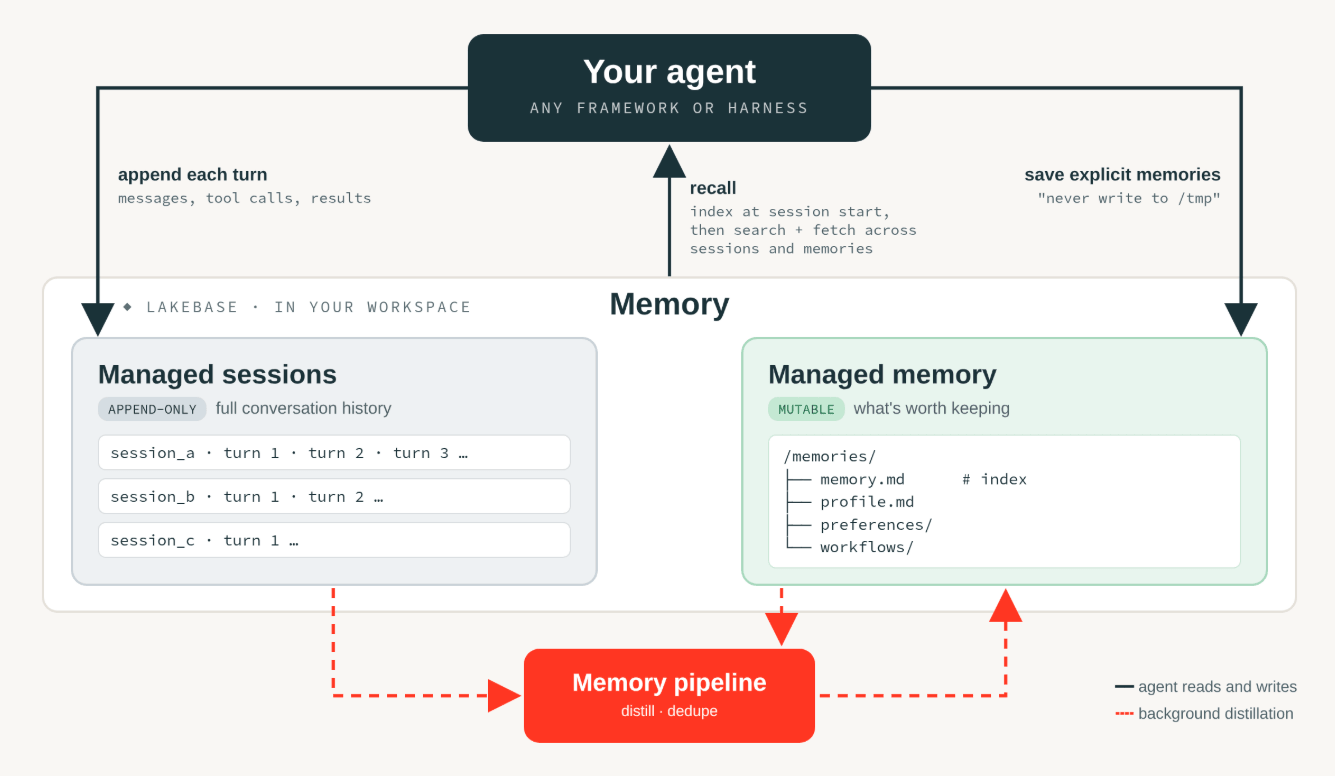
그림 1. Agent Bricks의 Agent Memory. 에이전트는 각 대화 순서를 관리형 세션에 추가하고, 메모리를 직접 불러오고 저장하며, 메모리 파이프라인이 백그라운드에서 세션을 장기 메모리로 요약/정제합니다.
Agent Memory는 세 가지 구성 요소로 이루어져 있습니다.
- 관리형 세션은 프레임워크의 기본 형식으로 메시지, 도구 호출, 결과의 정렬된 기록으로 각 대화를 기록합니다.
- 관리형 메모리는 프로필, 기본 설정, 도메인 지식, 워크플로 등 기억할 가치가 있는 내용을 유지합니다. 세션 시작 시 에이전트는 메모리에 알려진 내용의 인덱스를 로드합니다. 세션 중에 키워드 및 시맨틱 하이브리드 검색을 통해 세부 정보를 찾습니다.
- 메모리 파이프라인은 필요 시 또는 백그라운드에서 정기적으로 세션을 메모리로 정제합니다. 지속적인 사실과 선호 사항을 추출하고, 중복을 제거하며, 최신 대화와 모순되는 사실을 교체합니다.
모든 것은 워크스페이스에 프로비저닝되고 Databricks에서 운영하는 Databricks의 서버리스 Postgres인 Lakebase에서 실행됩니다. 이를 통해 메모리 저장 및 검색이 번개처럼 빨라지고, 에이전트 트래픽에 맞춰 스토리지 규모를 확장할 수 있습니다.
Databricks의 메모리 연구를 바탕으로 구축
Agent Memory는 MemCurrent: 엔터프라이즈 에이전트를 위한 메모리 설계에 설명된 메모리 시스템인 MemCurrent의 프로덕션 구현체입니다. Databricks 연구진의 핵심 발견은 메모리가 두 개의 레이어, 즉 무슨 일이 일어났는지에 대한 원시 기록과 기억할 가치가 있는 내용에 대한 정제된 기록으로 구성되어 작업 도중 에이전트가 임시로 작성하는 대신 백그라운드 프로세스를 통해 최신 상태로 유지될 때 가장 잘 작동한다는 것입니다.
이러한 방식으로 구축된 메모리는 품질과 효율성을 동시에 향상시켰습니다. 메모리가 있는 에이전트는 메모리가 없는 에이전트에 비해 약 3배 더 많은 작업을 완수했으며, 더 빠르게 완료하고 더 적은 토큰을 사용했습니다. 동일한 인프라가 비즈니스 사용자를 위한 Databricks의 자연어 환경인 Genie의 메모리 기능에 이미 구현되어 있습니다.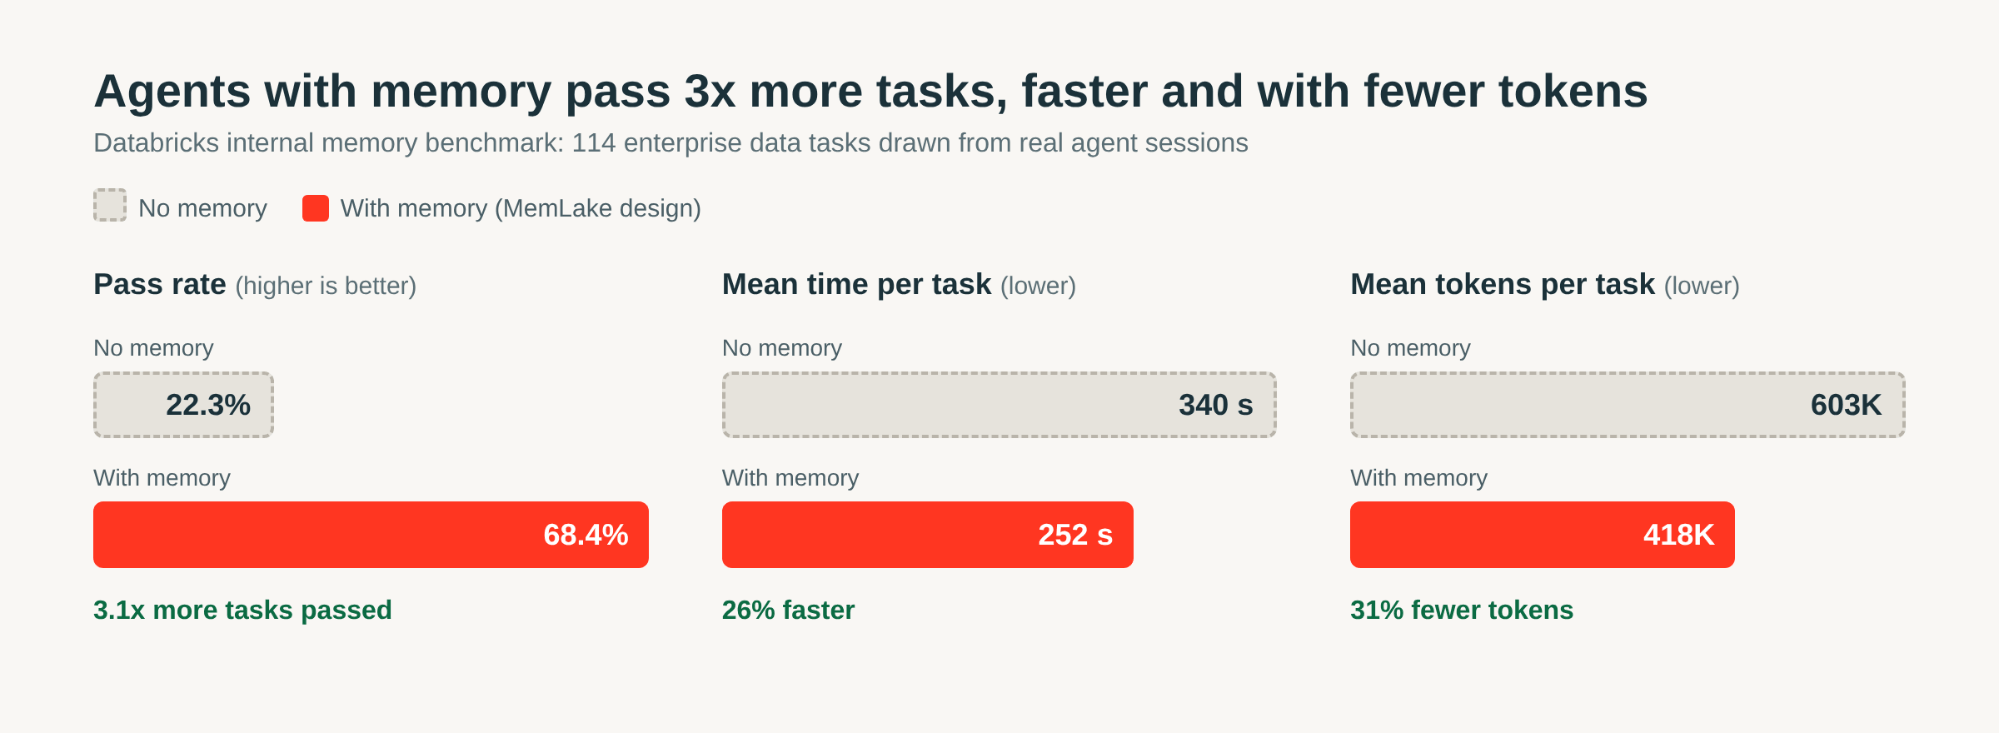
그림 2. 엔터프라이즈 데이터 작업에 대한 Databricks 내부 메모리 벤치마크에서 메모리가 있는 에이전트와 없는 에이전트의 비교. 출처: MemCurrent 연구.
에이전트에 가져오는 변화
- 작업당 비용 절감. 에이전트는 이미 수행한 작업을 건너뜁니다. 위 예시에서 워크플로가 메모리에 저장되면 에이전트는 11번의 도구 호출과 거의 6분이 걸리던 이전과 달리 2번의 도구 호출 및 41초 만에 관련 후속 질문에 답변했습니다.
- 지속되는 개인화. 선호 사항, 수정 사항, 팀 전용 정의가 각 사용자 범위에 맞춰 세션 간에 유지되므로 사용자가 같은 내용을 반복할 필요가 없습니다.
- 반복되지 않는 실수. 에이전트는 자신의 실수를 기억하여 동일한 실수를 두 번 하지 않으므로 귀중한 시간과 토큰을 절약할 수 있습니다.
- 직접 소유하고 제어하는 메모리. 세션과 메모리는 단일 에이전트 프레임워크와 관계없이 Lakebase 프로젝트에 상주합니다. 개발자는 에이전트가 각 사용자에 대해 유지하는 항목을 읽고, 내보내고, 삭제할 수 있으며, "지속적인 고객 선호 사항 유지, 일회성 디버깅 메모 무시"와 같이 메모리 파이프라인에 유지할 대상을 안내하는 지침을 제공할 수 있습니다.
- 전체 루프를 위한 단일 플랫폼. 동일한 에이전트가 Unity Gateway를 통해 모델을 사용하고, Agent Bricks CLI로 배포되며, 메모리가 포함된 Agent Bricks의 추적 기능을 통해 추적 및 평가됩니다.
시작하기
이 중 어떤 것도 사용자 측의 새로운 인프라를 필요로 하지 않습니다. Agent Bricks CLI를 사용하면 몇 분 만에 메모리 및 세션이 포함된 에이전트를 배포할 수 있습니다.
그이후부터 각 사용자와 나누는 에이전트의 다음 대화는 이전 대화에서 학습한 내용으로 시작됩니다. 자세한 내용은 메모리가 있는 새 에이전트를 만드는 빠른 시작 또는 기존 에이전트에 메모리를 추가하는 튜토리얼을 참조하세요.
Agent Memory는 어떤 모델, 프레임워크 또는 하네스를 사용하든 상관없이 사용자 지정 에이전트를 대규모로 구축, 실행 및 개선할 수 있는 Databricks의 에이전트 개발자 플랫폼인 Agent Bricks의 일부입니다. Agent Bricks 둘러보기를 통해 플랫폼의 나머지 기능을 살펴보세요.
추가 리소스
- 10분 미만으로 상태 유지형 에이전트 구축하기 - Agent Bricks CLI 문서를 참조하세요.
- 기존 에이전트에 메모리 및 세션 추가하기 - 에이전트 메모리 및 세션 문서를 참조하세요.
- 배경 연구 자료 읽어보기 - MemCurrent: Designing Memory for Enterprise Agents.
(이 글은 AI의 도움을 받아 번역되었습니다. 원문이 궁금하시다면 여기를 클릭해 주세요)
최신 게시물을 이메일로 받아보세요
블로그를 구독하고 최신 게시물을 이메일로 받아보세요.