Lakebase Search: Postgres용 최첨단 전체 텍스트 및 벡터 검색
Postgres에서 빠르고 확장 가능한 서버리스 검색, 이제 정식 출시(GA)
작성자: Zhou Sun, Jinjing Zhou, Keming Yang, Usamoi Cui, Pranav Aurora , Junyu Chen
- Lakebase Postgres에 이제 내장 검색 엔진이 포함됩니다 (AWS/Azure에서 GA). 두 가지 확장 기능인 lakebase_vector(ANN 검색) 및 lakebase_text(BM25)를 사용하면 별도의 검색 시스템과 ETL 파이프라인 없이도 운영 데이터와 함께 Postgres에서 직접 시맨틱, 키워드 및 하이브리드 검색을 실행할 수 있습니다.
- 대규모 환경에서 pgvector 및 전용 검색 엔진보다 뛰어난 성능을 발휘합니다. 1억 개의 벡터 벤치마크에서 Lakebase는 차순위 시스템 대비 2배의 처리량, pgvector를 사용하는 클라우드 Postgres 대비 4배 저렴한 비용, 71ms의 P99 지연 시간에서 97%의 재현율을 제공합니다. 이는 스토리지와 컴퓨팅을 분리하고 계층형 IVF 클러스터링 및 이진 양자화(RaBitQ)를 사용하여 쿼리가 필요한 데이터만 터치하도록 함으로써 달성됩니다.
- 아키텍처는 서버리스이며 제로(0)로 확장 가능합니다. 데이터 용량이 아닌 쿼리 사용량에 대해서만 비용을 지불합니다. 인덱스 빌드는 기본 데이터베이스에서 오프로드되며, 콜드 스타트는 약 1초가 소요되고, 단일 컴퓨팅 유닛에서 1억 개의 벡터를 서비스할 수 있어 AI 에이전트의 급증하는 검색 패턴에 맞춤 설계되었습니다.
기존의 OLTP 시스템은 AI 에이전트의 검색 요구사항을 충족하도록 설계되지 않았습니다. 이러한 시스템은 모든 데이터에 대해 지연 시간이 낮고 정확도가 높은 검색을 요구하며, 종종 대규모 병렬 검색을 실행합니다. 지금까지는 이를 해결하기 위해 ETL 파이프라인을 사용하여 기본 데이터베이스에 독립형 검색 엔진을 임시방편으로 연결해야 했습니다.
하지만 OLTP 데이터베이스가 검색 워크로드를 효율적으로 직접 실행할 수 있다면 어떨까요?
오늘 저희는 lakebase_vector(확장 가능한 근사 이웃 검색)와 lakebase_text(BM25 전체 텍스트 검색)라는 두 가지 확장 기능을 통해 빠르고 확장 가능한 검색 엔진을 Lakebase Postgres에 도입합니다. 두 확장 기능 모두 AWS 및 Azure에서 정식 출시되었습니다.
lakebase_vector를 통해 Postgres는 이제 벡터 검색의 최전선에 서게 되었습니다. 전용 검색 엔진의 효율성과 확장성을 뛰어넘는 성능을 자랑합니다. VectorDBBench 100M 벤치마크에서 이 기능은 차순위 시스템보다 2배 더 높은 처리량(throughput)을 제공하며, pgvector를 사용하는 클라우드 Postgres 벤더보다 4배 더 저렴합니다. 이는 오토스케일링으로 인한 추가 비용 절감을 고려하기 전의 수치입니다.
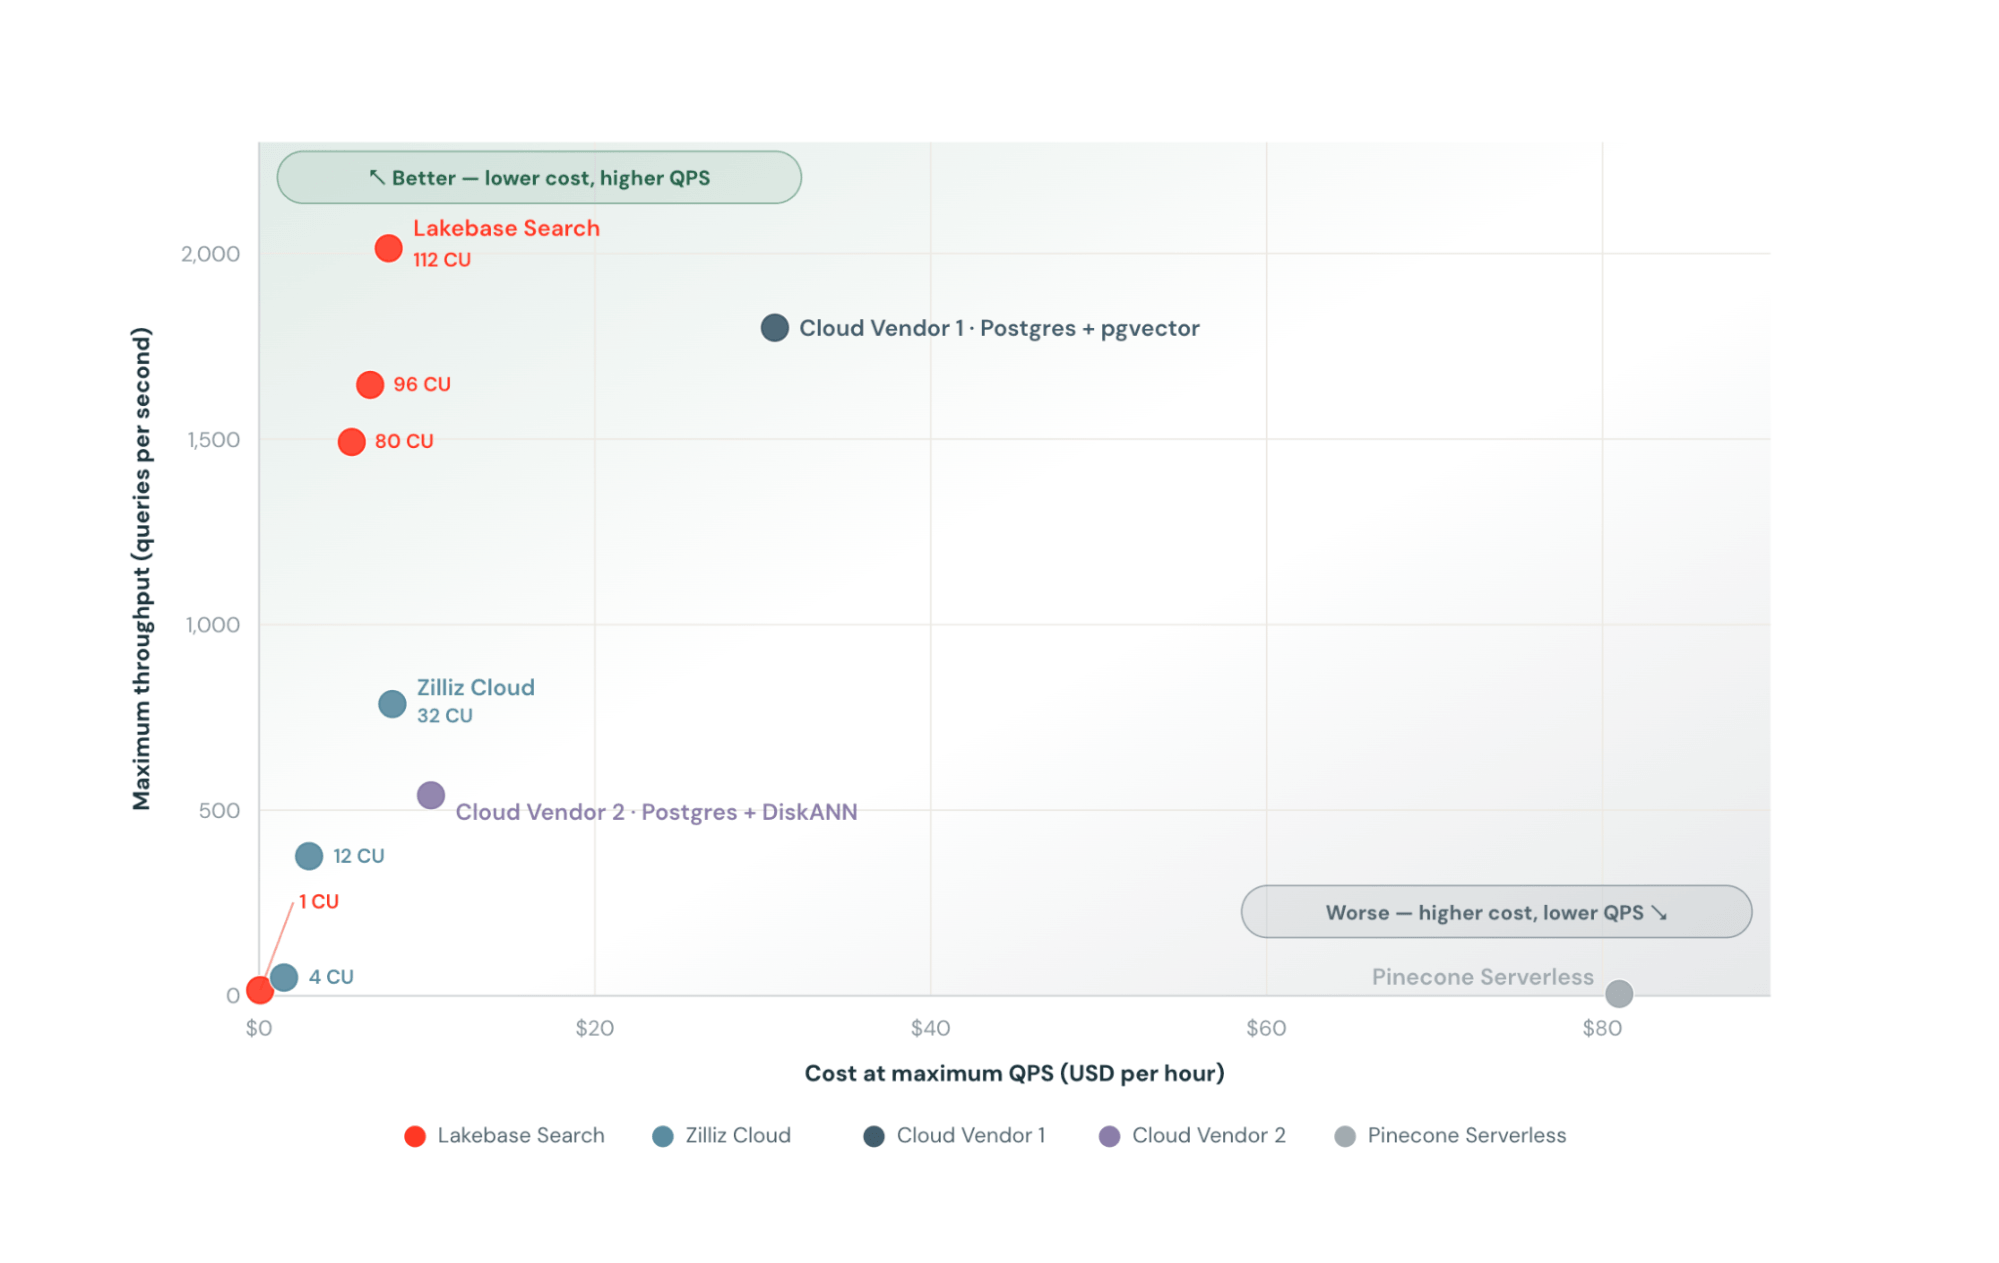
정확도를 희생하지 않고도 이러한 성능을 유지합니다. 테스트 결과, lakebase_vector는 97%의 재현율(recall, 97%의 확률로 실제 가장 가까운 이웃을 성공적으로 검색함)에서 71밀리초의 P99 지연 시간을 기록했습니다.

이제 Lakebase Postgres는 최첨단 검색 기능을 갖추게 되었으며, Conexiom과 같은 고객사는 이전 pgvector 환경의 절반에 불과한 컴퓨팅 공간(compute footprint)으로 1억 개 이상의 행에서 BM25를 사용한 하이브리드 검색을 실행하고 있습니다. 이제 이들은 완전히 서버리스이며 필요에 따라 확장 가능한, 모든 OLTP 및 검색 워크로드를 위한 단일 데이터베이스를 갖추게 되었습니다.
Lakebase Search는 pgvector에 비해 완전히 새로운 차원의 확장성을 제공하며, 동일한 서버리스 데이터베이스에서 BM25를 활성화해 줍니다. 저희는 대규모로 데이터를 에이전트에 연결하기 위해 Lakebase를 사용하고 있습니다. - Jordan Voves, AI/ML Architect @ Conexiom
대규모 환경에서 pgvector가 한계에 부딪히는 이유
대부분의 Postgres 사용자에게 검색은 pgvector에서 시작됩니다. pgvector를 사용하면 별도의 벡터 저장소를 사용하는 복잡함 없이 Postgres 내의 데이터에 대해 직접 HNSW 및 IVFFlat과 같은 인덱스 알고리즘을 통해 벡터 유사도 검색을 수행할 수 있습니다. 실제로 pgvector는 Lakebase Postgres에서 가장 많이 설치되는 확장 기능입니다. 저희는 대규모로 pgvector를 실행하는 고객들로부터 3가지 공통적인 페인 포인트(pain point)를 확인했습니다.
첫째, 비용이 사용량이 아닌 데이터 볼륨에 비례하여 증가합니다.
pgvector는 빠른 속도를 유지하기 위해 데이터베이스 메모리에 인덱스를 보관합니다. HNSW 검색은 무작위 접근(random-access) 그래프 탐색에 의존하기 때문에, 모든 데이터가 RAM에 완벽하게 들어맞아야만 밀리초 단위로 쿼리가 실행됩니다. 인덱스가 디스크로 넘치는(spill) 순간, 쿼리는 일련의 무작위 읽기 작업으로 변하고 성능은 10배에서 50배까지 급락합니다.
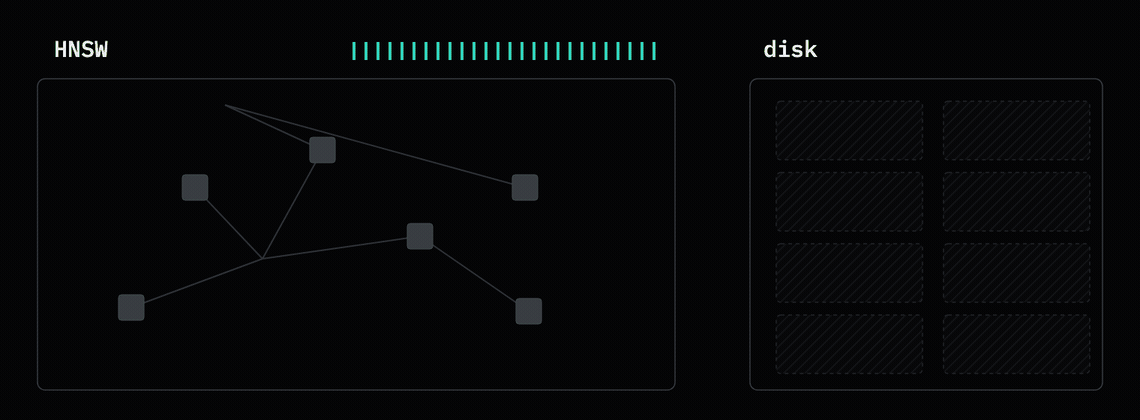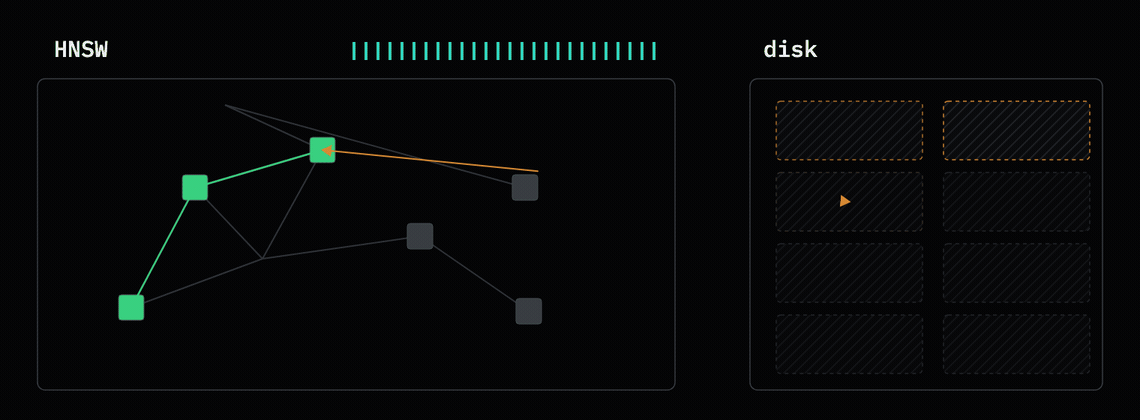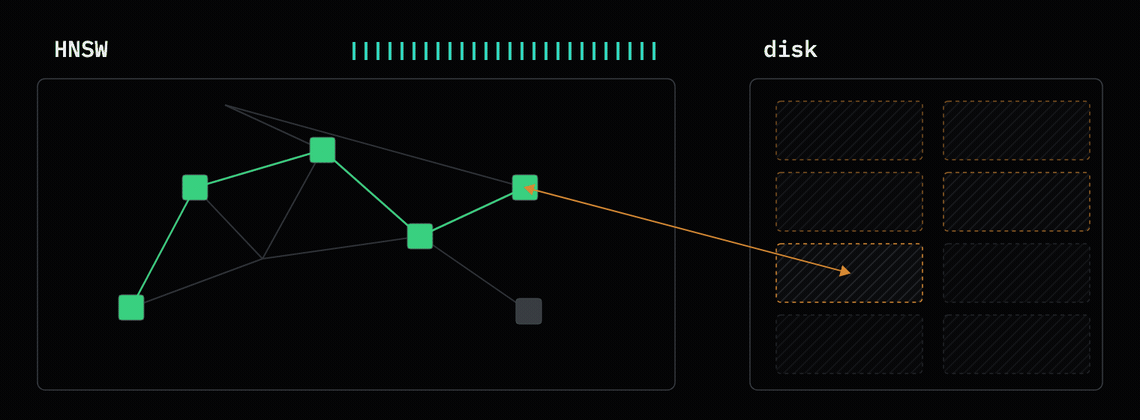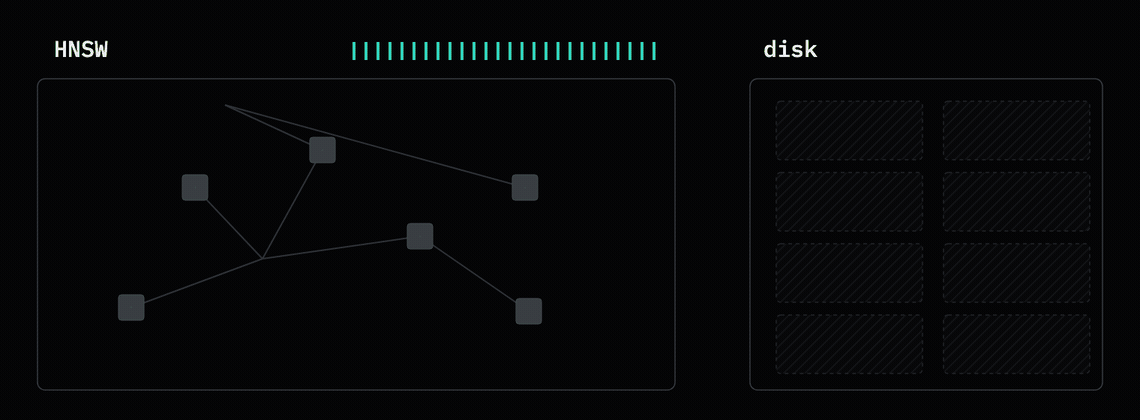
그래프 링크와 Postgres 오버헤드를 고려하면 768차원 float32 벡터는 약 3.3KB의 메모리가 필요합니다. 1억 개의 행이 있는 경우, 밀리초 단위의 쿼리를 위해 인덱스를 상주시키려면 약 330GB의 RAM이 필요합니다. '작업 세트(working set)'라는 개념이 없기 때문에, 인덱스의 전체를 쿼리하든 전혀 쿼리하지 않든 전체 인덱스에 맞춰 리소스를 프로비저닝해야 합니다.
둘째, 인덱스 유지 관리 비용이 많이 들고 데이터베이스를 차단합니다.
HNSW 그래프는 지속적인 무작위 접근에 의존하기 때문에 pgvector 인덱스는 메모리 용량에 제한을 받습니다. 빌드가 디스크로 넘치면 수백만 개의 무작위 I/O 작업으로 인해 성능이 저하되며, 표준 클라우드 인스턴스에서 pgvector 인덱스를 빌드하는 데 거의 50시간이 소요됩니다.
데이터 수집(ingestion)도 동일한 병목 현상을 겪습니다. 모든 쓰기 작업 시 pgvector가 무작위 접근 조회를 사용하여 그래프의 여러 레이어를 탐색하고 수정해야 하므로, 새로운 벡터를 삽입하는 작업은 느리고 비용이 많이 든니다.
둘째, HNSW가 지속적인 무작위 접근 그래프 탐색에 의존하기 때문에 데이터 수집이 느려지고 비용이 많이 듭니다. 또한 그래프의 각 레이어를 수정해야 합니다. 따라서 HNSW 인덱스는
지속적인 유지 관리는 문제를 더욱 악화시킵니다. HNSW는 글로벌 재조정(global rebalancing) 기능이 없기 때문에, 검색 품질을 복원하려면 전체 REINDEX를 수행해야 하며, 이 과정에서 테이블이 잠기고 프로덕션 쓰기 작업이 차단됩니다.
셋째, 성능을 위해 검색 품질을 타협해야 합니다.
각 pgvector 쿼리는 단일 Postgres 백엔드 프로세스에서 실행되므로, HNSW 인덱스 스캔은 전혀 병렬화되지 않습니다.
더 높은 재현율을 얻으려면 엔진이 더 많은 그래프 노드를 방문해야 하므로, 더 많은 무작위 메모리 읽기 및 거리 비교가 발생합니다. 이는 지연 시간을 늘리고 QPS를 떨어뜨립니다. 단일 검색은 여러 코어에 걸쳐 병렬화될 수 없기 때문에, 처리량을 높이기 위한 유일한 옵션은 더 많은 연결이나 읽기 복제본(read-replica)을 추가하는 것뿐입니다.
lakebase_vector, Postgres에 확장 가능한 벡터 검색 도입
pgvector의 주요 병목 현상은 빠른 속도를 내기 위해 전체 인덱스가 단일 머신의 RAM에 들어가야 한다는 점입니다. 그렇지 않아도 된다면 어떨까요?
Lakebase Postgres는 스토리지와 컴퓨팅을 분리하기 때문에 훌륭한 출발점을 제공합니다. 영구 데이터는 저렴한 클라우드 오브젝트 스토리지에 저장되는 반면, RAM과 로컬 NVMe는 그 앞에서 임시 캐시 역할을 하여 활성 작업 데이터 세트를 빠르게 읽을 수 있도록 합니다. 이러한 아키텍처에서 HNSW 캐시는 일련의 무작위 오브젝트 스토리지 읽기를 의미합니다.
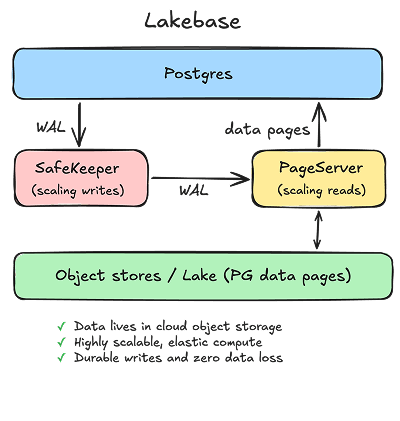
RAM에 캐싱되어 있을 때와 오브젝트 스토리지에 콜드 상태로 있을 때 모두 빠른 인덱스가 필요합니다. 저희는 두 가지 아이디어를 활용합니다.
- 계층적 IVF 클러스터링. 벡터는 연속된 블록으로 저장되는 클러스터로 그룹화됩니다. 쿼리는 메모리에서 클러스터 센트로이드(centroid)의 점수를 매긴 다음, 가능성이 높은 몇 개의 블록만 읽습니다. 이를 통해 수백 번의 무작위 홉(hop)을 몇 번의 대규모 순차 읽기 작업으로 전환합니다.
- 이진 양자화(Binary quantization, RaBitQ). 각 벡터는 차원당 약 1비트로 압축되어 float32보다 약 32배 작아집니다. 쿼리는 압축된 코드를 스캔하여 후보군을 압축한 다음, 이 제한된 후보군을 전체 정밀도(full-precision) 벡터와 비교하여 다시 순위를 매깁니다(rerank).
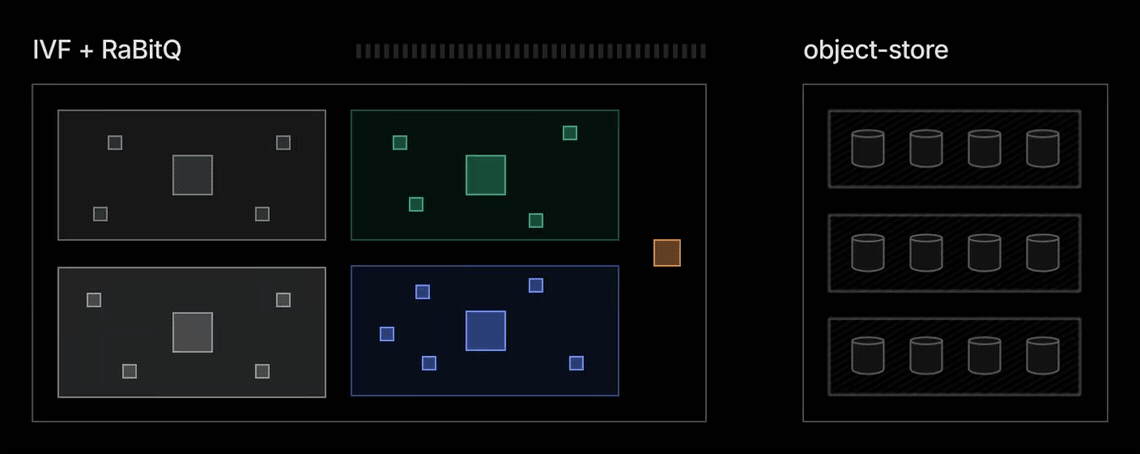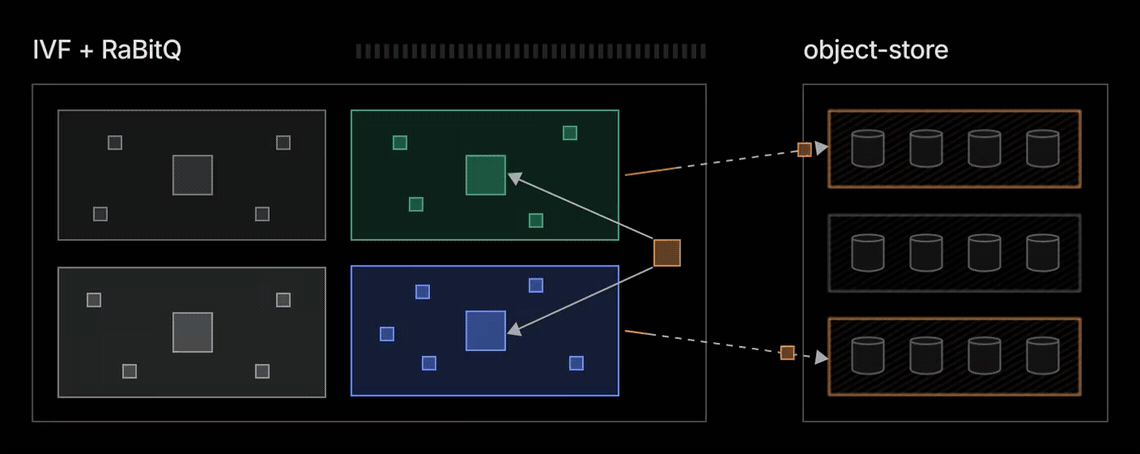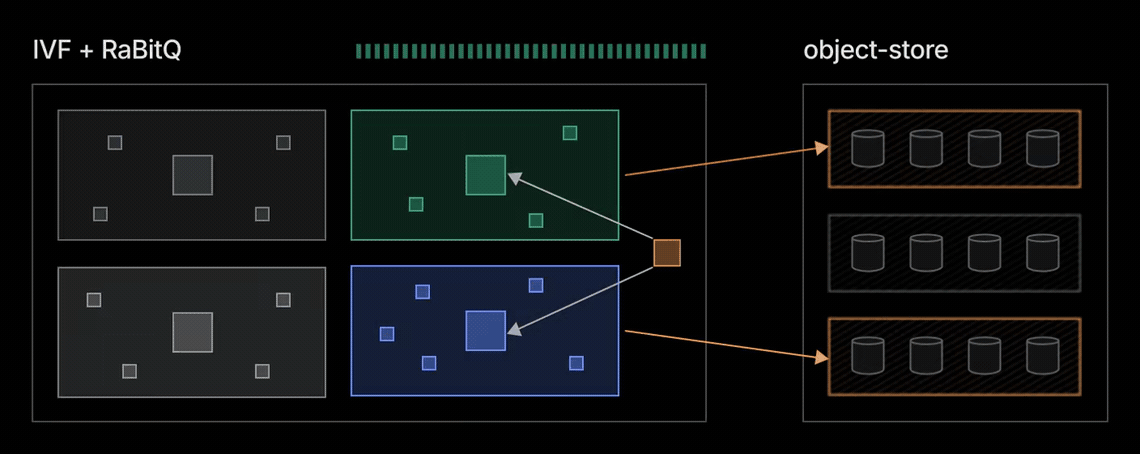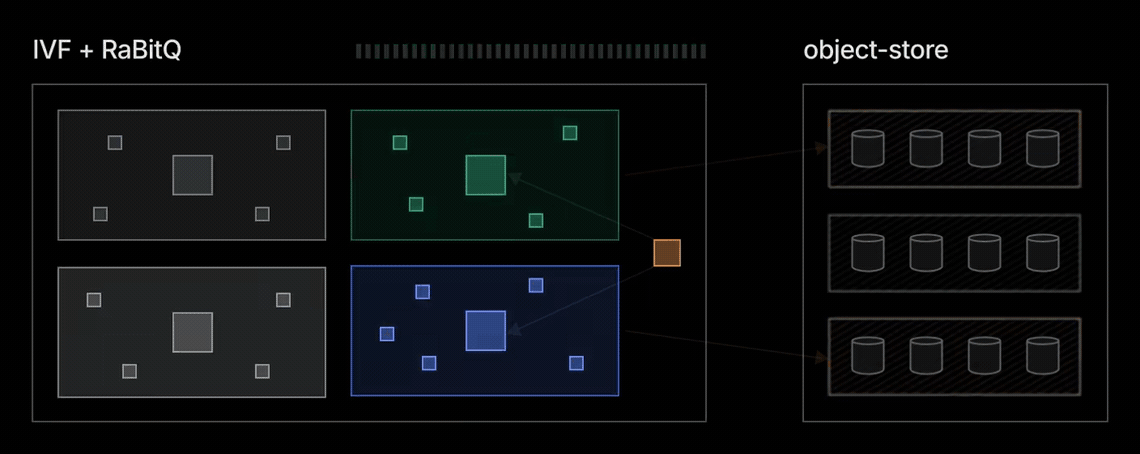
캐싱된 경우, 검색은 양자화된 벡터를 사용하여 아주 작은 공간에서 작동합니다. 콜드 상태인 경우, 쿼리는 전체 인덱스를 탐색할 필요 없이 필요한 블록만 가져옵니다. lakebase_vector는 다음과 같은 이점을 제공합니다.
사용한 만큼만 지불하고 제로(0)로 축소
스토리지와 컴퓨팅을 분리함으로써 lakebase_vector는 완전히 상태 비저장(stateless) 상태가 됩니다. 노드는 필요에 따라 핫 데이터를 캐싱하고, 유휴 상태일 때는 제로(0)로 일시 중단되며, 다음 쿼리가 들어오면 다시 재개됩니다.
- 비활성 상태에서는 스토리지 비용만 지불하므로, Lakebase에서 벡터 인덱스를 유지하는 데 드는 기본 비용이 매우 저렴합니다.
- 양자화된 코드와 쿼리가 터치하는 특정 블록만 활성화(hydrate)되므로 콜드 스타트 비용이 저렴합니다. 제로로 축소된 후 첫 번째 쿼리에 대해 측정한 P90 지연 시간은 단 1.13초(100M × 768차원)에 불과합니다.
- 단 1개의 Lakebase Compute Unit(CU)만으로도 1억 개의 벡터를 서비스할 수 있습니다. 활성 작업 데이터 세트만 컴퓨팅 노드에 캐싱하면 되므로, 실제 사용량과 쿼리 활동을 그대로 반영하는 요금 모델을 제공합니다.

빠르고 오프로드된 인덱스 빌드
lakebase_vector는 인덱스를 더 병렬적인 방식으로 빌드합니다. 소규모 무작위 샘플을 사용해 센트로이드를 한 번만 학습시킵니다. 이 단계가 전체 데이터 세트를 살펴보는 유일한 단계입니다. 그 이후에는 모든 벡터가 가장 가까운 센트로이드에 독립적으로 할당되고, 양자화되어 해당 클러스터의 블록에 기록됩니다. 이 프로세스는 보유한 코어 수만큼 확장되어 컴퓨팅 자원에 맞춰 스케일링할 수 있습니다.

여기서 한 걸음 더 나아가 기본 데이터베이스에서 인덱스 빌드 작업을 완전히 오프로드합니다. 오픈 포맷으로 데이터를 저장하면 LTAP 아키텍처가 인덱싱 및 유지 관리 작업을 Spark와 같은 분산 엔진에 위임할 수 있어, 병렬 컴퓨팅을 통해 빌드 시간을 몇 분 수준으로 단축할 수 있습니다. 계속 지켜봐 주세요.
빠르고 정확한 검색
lakebase_vector는 컴팩트한 1비트 코드를 사용하여 저렴한 비용으로 후보 검색 범위를 넓히고, 정밀한 최종 후보 목록만 전체 정밀도로 재순위화(reranking)합니다. 인덱스 블록이 독립적이기 때문에 단일 쿼리가 CPU 코어 전체에 걸쳐 병렬로 처리되어 높은 재현율(recall)과 낮은 대기 시간(latency)을 동시에 제공합니다.
필터링은 lakebase_vector가 클러스터 블록을 스캔할 때 직접 수행됩니다. 인라인으로 조건자(predicates)를 적용하면 후보를 과도하게 가져오는 현상을 방지하고 필터링된 쿼리에서 높은 재현율을 유지할 수 있습니다.
lakebase_text: Postgres의 네이티브 BM25 검색
표준 Postgres 텍스트 검색(tsvector)에는 코퍼스 전체의 관련성 컨텍스트가 부족합니다. lakebase_text는 글로벌 역문서 빈도(IDF)로 용어 점수를 매겨 Postgres에 네이티브 BM25를 제공합니다. 즉, 드물고 의도가 명확한 용어에는 높은 가중치를 부여하고 일반적인 불용어에는 패널티를 부여합니다.
또한 기존의 tsvector + GIN 인덱스보다 빠릅니다. 순회하는 동안 점수 상한선을 평가함으로써, 엔진은 상위 K개(top-K) 결과에 도달할 수 없는 포스팅 블록 전체를 건너뜁니다.
lakebase_text와 lakebase_vector를 결합하면 Postgres 내부에서 네이티브 하이브리드 검색을 사용할 수 있습니다. 단일 쿼리에서 시맨틱 벡터 검색과 BM25 키워드 관련성을 융합하고, 표준 SQL 필터 조건자를 적용하며, 실시간 운영 테이블과 직접 조인할 수 있습니다.
Lakebase Postgres는 에이전트 시대를 위해 구축되었습니다
에이전트는 기존 검색 엔진의 한계를 뛰어넘었습니다. 에이전트는 벡터 검색을 데이터 스택의 핵심 요구사항으로 만들었으며, 단일 워크플로가 몇 초 만에 수천 개의 동시 검색 요청을 트리거할 수 있는 극심한 버스트성(burstiness)을 초래했습니다.
저희는 이러한 새로운 현실에 맞춰 Lakebase Search를 특별히 설계했습니다. 이제 Lakebase Postgres는 수동 재프로비저닝이나 인프라 관리 없이 1개 행에서 10억 개의 벡터까지, 1 QPS에서 수천 QPS까지 원활하게 확장되는 서버리스 아키텍처를 기반으로 모든 운영 및 검색 워크로드를 처리할 수 있습니다.
수백 명의 베타 고객의 피드백을 바탕으로 Lakebase Search를 구축했으며, 그 결과는 스스로를 증명합니다:
- 데이터베이스 비용 3배 절감: Conexiom은 pgvector 대비 5배 더 높은 처리량을 달성하는 동시에 인프라 비용을 3배 절감했습니다.
- 에이전트를 위한 단 한 번의 SQL 도구 호출: 개발자는 복잡한 다중 시스템 검색 파이프라인을 표준 데이터베이스 규칙에 따라 제어되는 네이티브 하이브리드 검색을 위한 단일 SQL 호출로 대체합니다.
- 통합 OLTP 및 검색: 팀은 실시간 운영 테이블과 전용 검색 클러스터를 사용한 만큼 지불하는 하나의 백엔드로 통합합니다.
Lakebase Search는 현재 AWS 및 Azure에서 정식 버전으로 제공됩니다. 이미 Lakebase에서 앱이나 에이전트를 구축하고 있다면 확장을 활성화하기만 하면 됩니다. 아직 Lakebase를 사용해 보지 않으셨다면 지금 시작해 보세요.
▎ 📝 참고: Databricks AI Search는 기본적으로 고품질 검색을 제공하는 관리형 검색 엔진입니다. 수동 튜닝 없이 훌륭한 결과를 원할 때 더 적합할 수 있습니다. Lakebase Search는 모든 운영 및 검색 데이터를 하나의 데이터베이스에 담고 싶을 때 더 나은 선택입니다.
(이 글은 AI의 도움을 받아 번역되었습니다. 원문이 궁금하시다면 여기를 클릭해 주세요)
최신 게시물을 이메일로 받아보세요
블로그를 구독하고 최신 게시물을 이메일로 받아보세요.