제조 데이터와 AI: 제품 가치 사슬 연결
제조 가치 사슬의 모든 단계에 신뢰할 수 있는 데이터와 AI에 대한 접근성을 제공하세요.
- 제조 데이터는 연결된 제품 가치 사슬 전반에 걸쳐 있지만, 이를 수집하는 시스템은 기능 및 공장별로 분리되어 있습니다.
- Databricks는 서로 다른 시스템의 데이터를 통합하거나 해당 위치에서 직접 쿼리하여, 팀이 가치 사슬 전반의 여러 단계를 넘나드는 질문에 답할 수 있도록 지원합니다.
- 거버넌스가 적용된 시맨틱, 자연어 분석 및 에이전트 기반 애플리케이션을 통해 더 많은 사람들이 데이터 엔지니어가 되지 않고도 데이터를 찾는 단계에서 나아가 실제 행동을 취할 수 있습니다.
제조 결함이 단 하나의 시스템에만 국한되는 경우는 드뭅니다. 불량률 급증은 장비 설정, 공급업체 배치, 물류 이벤트 또는 품질 시스템에 기록된 반복적인 문제와 관련이 있을 수 있습니다. 하지만 이를 조사하는 데 필요한 데이터는 대개 공장, 기능 및 시스템 경계에 따라 분산되어 있습니다.
50여 년 전, 조셉 해링턴(Dr. Joseph Harrington) 박사는 Computer Integrated Manufacturing (CIM)에 대한 비전을 통해 제조가 여러 기능에 걸쳐 연결된 정보 흐름에 의존한다는 점을 인식했습니다. 오늘날 데이터와 AI가 제품 가치 사슬의 각 단계를 연결하면서 그 비전이 현실화되고 있습니다.
제조 분야에서 가장 까다로운 질문은 여러 단계에 걸쳐 발생하는 질문입니다:
- 어떤 공급업체 로트(lot)가 영향을 받은 제품에 도달했는가?
- 이 결함이 이전에도 발생한 적이 있는가? 시정 조치가 효과가 있었는가?
- 어떤 고객이나 서비스 케이스가 영향을 받을 수 있는가?
이 중 어느 하나에라도 답하려면 서로 연동되도록 설계되지 않은 시스템의 데이터를 결합해야 합니다. 제조업체에 필요한 것은 고립된 보고서가 아닙니다. 이들에게 필요한 것은 정보를 유용하게 활용할 수 있도록 거버넌스와 비즈니스 컨텍스트를 갖춘, 제품 가치 사슬 전반에 걸쳐 연결된 정보의 흐름입니다. 이것이 바로 현대적인 데이터 및 AI 플랫폼이 수행할 수 있는 역할입니다.
제조 제품 가치 사슬이란 무엇인가요?
제품 가치 사슬은 원자재와 아이디어를 고객에게 인도되고 현장에서 지원되는 제품으로 변환하는 엔드투엔드 기능 시퀀스입니다. 이는 연구 개발(R&D) 및 엔지니어링, 구매, 생산 및 품질, 영업 및 마케팅, 애프터마켓 및 현장 서비스를 연결합니다. 각 단계에는 고유한 목표, 팀 및 운영 시스템이 있습니다:
- 연구 개발(R&D) 및 엔지니어링 부서는 Product Lifecycle Management (PLM), Computer-Aided Design (CAD), Computer-Aided Engineering (CAE) 및 시뮬레이션, 테스트 데이터, 요구 사항, 엔지니어링 Bills of Materials (BOM)을 활용합니다.
- 구매 부서는 Enterprise Resource Planning (ERP) 구매, 소스 투 페이(source-to-pay), 계약, 공급업체 리스크 및 공급업체 포털을 활용합니다.
- 생산 및 품질 부서는 Manufacturing Execution Systems (MES), Supervisory Control and Data Acquisition (SCADA)/Programmable Logic Controller (PLC) 데이터, 프로세스 히스토리안, Quality Management Systems (QMS)/Laboratory Information Management Systems (LIMS) 및 유지보수 시스템을 활용합니다.
- 물류 및 공급망 부서는 Enterprise Resource Planning (ERP), Warehouse Management Systems (WMS), Transportation Management Systems (TMS), 계획 시스템, Electronic Data Interchange (EDI) 및 텔레매틱스를 활용합니다.
- 영업 및 마케팅 부서는 Customer Relationship Management (CRM), Configure-Price-Quote (CPQ), 가격 책정, 딜러 관리, 마케팅 자동화 및 이커머스를 활용합니다.
- 애프터마켓 및 현장 서비스 부서는 서비스 관리, 보증, 서비스 부품 계획, 커넥티드 제품 데이터, 진단 및 티켓을 활용합니다.
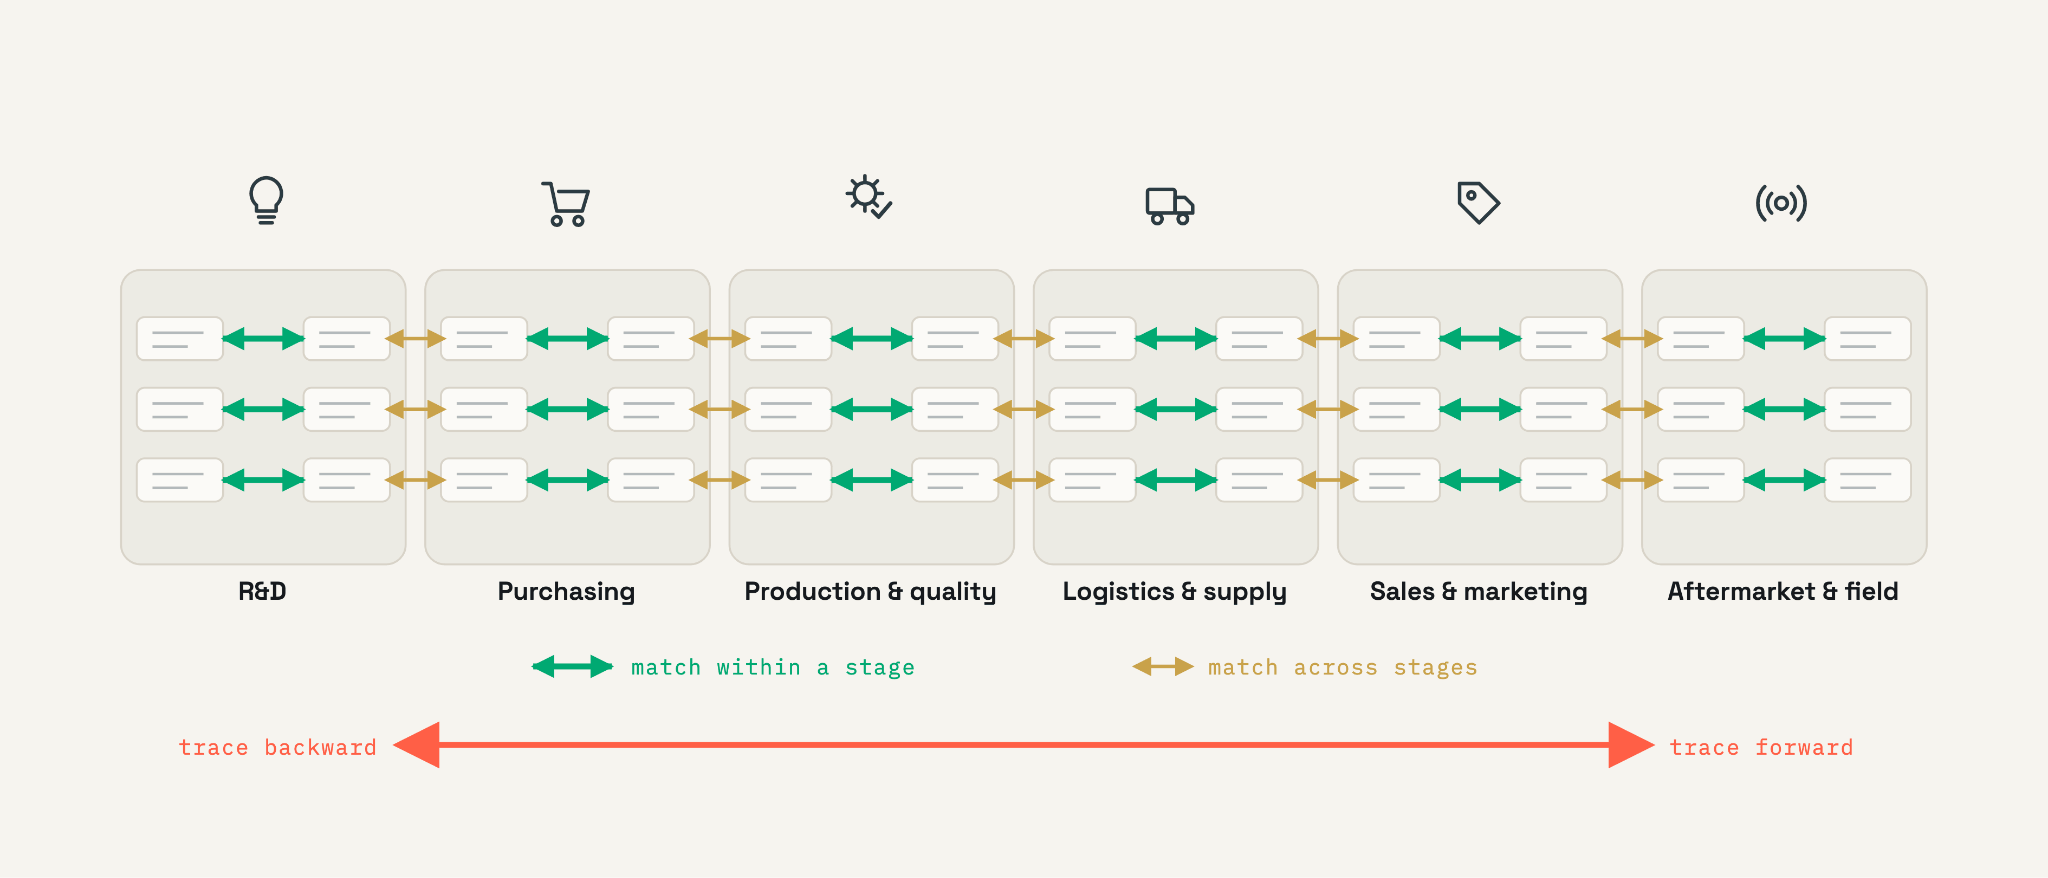
각 단계에서는 가치 있는 운영 데이터가 생성됩니다. 더 큰 기회는 가치 사슬의 한 부분에서 발견한 사실을 다른 부분의 조치와 연결하는 데서 발생합니다. 예를 들어, 생산 과정에서 발견된 품질 문제를 물류 및 공급업체 기록을 통해 조사하거나, 공급업체 경고를 추적하여 해당 자재가 사용된 모든 제품을 찾아내는 것입니다.
시스템 경계가 진짜 문제인 이유
가치 사슬의 모든 단계가 고립되어 있으면, 여러 단계에 걸친 질문은 티켓 발행, 데이터 내보내기 및 대조 작업을 수동으로 수행해야 하는 번거로운 프로젝트가 됩니다. 하지만 데이터를 거버넌스가 적용된 하나의 시스템으로 액세스할 수 있다면, 동일한 질문이 간단한 쿼리 하나로 해결됩니다.
사례 1: 공장 품질 엔지니어가 해결해야 하는 세 가지 질문:
- 불량률 급증이 배치, 장비 또는 설정 때문에 발생한 것인가요? 그리고 지금도 계속 발생하고 있나요?
- 이 결함을 이전에도 본 적이 있나요? 그리고 해결책이 효과가 있었나요?
- 왜 특정 공장이 다른 공장보다 동일한 부품의 불량률이 훨씬 더 높을까요?
각 질문은 Manufacturing Execution System (MES) 기록, 프로세스 히스토리안 데이터, 공급업체 및 Supplier Quality Management (SQM) 데이터, Quality Management System (QMS) 이력, Eight Disciplines (8D) 기록, 그리고 종종 여러 공장 인스턴스 등 여러 시스템에 걸쳐 있습니다. 오늘날 이에 답하려면 티켓을 발행하고, 수동으로 데이터를 내보내고, 소수의 전문가에게 의존해야 합니다.
사례 2: 구매 분석가가 해결해야 하는 세 가지 질문:
- 현재 납품 위험으로 표시된 단일 공급업체에 의존하고 있는 핵심 부품은 무엇인가요?
- 최근 주문에서 공급업체의 정시 납품 및 품질 성과가 저하되고 있나요?
- 한 공급업체에 문제가 생기면 어떤 제품, 공장 및 미결 주문이 영향을 받게 되나요?
각 질문은 Enterprise Resource Planning (ERP) 구매 및 소스 투 페이(source-to-pay) 기록, 계약, 공급업체 리스크 피드 및 공급업체 포털 등 여러 시스템에 걸쳐 있습니다. 오늘날 이에 답하는 것은 티켓 발행, 전문 지식, 수동 데이터 내보내기가 필요한 번거로운 작업이 될 수 있습니다.
이러한 운영 데이터 소스를 통합하면 그러한 마찰이 사라집니다. 가치 사슬을 한 번 통합하고, 한 번 거버넌스를 적용한 다음, 일련번호, 로트 번호 또는 부품 번호와 같은 공유 식별자를 조인 키(join key)로 사용하면 추적성은 쿼리 하나로 해결됩니다. 여섯 가지 질문, 하나의 근본적인 요구 사항: 서로 연결되도록 설계되지 않은 시스템 전반의 데이터를 결합하고 그 결과를 신뢰하는 것입니다. 네 가지 플랫폼 기능이 이를 가능하게 합니다.
Databricks가 제조 데이터를 연결하는 방법
기존 시스템을 중단하는 마이그레이션이 필요하지 않습니다
연결된 가치 사슬을 구축하기 위해 모든 소스 시스템을 전면적으로 마이그레이션할 필요는 없습니다. 복사하는 것이 적절한 선택일 때는 데이터를 복사할 수 있고, 원래 위치에 그대로 두고 쿼리할 수도 있습니다.
제로 카피 Open Sharing 및 Lakehouse Federation을 사용하면, 기업은 모든 유스케이스에 대해 별도의 ETL 파이프라인이나 복사본을 만들지 않고도 소스 시스템의 데이터에 액세스할 수 있습니다. 미러링이 적절한 경우, 커넥터와 클라우드 오브젝트 스토리지를 통해 데이터를 레이크하우스로 가져올 수 있는 확장 가능한 경로를 제공합니다.
Databricks Data and AI Platform은 이러한 유연성과 함께 제조 팀에 필요한 기능들을 제공합니다. 여기에는 생산, 품질 및 공급 데이터 전반에 걸친 이력 분석, 장비 및 차량 텔레메트리를 위한 저지연 처리, 개별 레코드를 신속하게 읽고 쓸 수 있는 애플리케이션 등이 포함됩니다.
앞선 사례들이 의존하는 네 가지 기능
기존 시스템을 중단하는 마이그레이션 없이 소스 데이터 통합 또는 페더레이션: 품질 엔지니어의 질문은 공장 인스턴스 전반의 MES, 프로세스 히스토리안, 공급업체 및 SQM, QMS, 8D 기록에 걸쳐 있으며, 구매 분석가의 질문은 ERP 구매, 계약 및 공급업체 리스크 피드에 걸쳐 있습니다. 제로 카피 Open Sharing 및 Lakehouse Federation을 사용하면 해당 데이터를 원래 위치에서 바로 쿼리할 수 있으며, 복사하는 것이 더 나은 선택일 때는 커넥터를 통해 미러링할 수 있습니다. 어떤 방식이든 질문할 때마다 새로운 ETL 복사본을 만들 필요가 없습니다.
오케스트레이션 및 정제: 두 사례 모두 가공되지 않은 원시 추출물이 아니라 거버넌스가 적용된 골드(Gold) 테이블을 기준으로 조인합니다. Lakeflow는 팀이 원시 입력을 신뢰할 수 있고 분석 준비가 된 데이터로 변환하는 파이프라인(일반적으로 브론즈, 실버, 골드 레이어를 통해)을 구축, 예약 및 모니터링할 수 있도록 지원합니다.
데이터 및 AI를 위한 거버넌스: Unity Catalog는 미러링 및 페더레이션된 데이터 전반을 아우르는 단일 제어 평면(control plane)입니다. 단일 권한 모델, 전체 계보(lineage), 데이터, 모델 및 AI 에이전트에 걸친 검색 기능을 제공하므로 두 사례 모두 동일하게 거버넌스가 적용된 환경에서 해결할 수 있습니다. Unity Gateway를 사용하면 에이전트, 도구, 모델 및 MCP 전반에서 AI 액세스, 비용 및 관찰 가능성(observability)을 제어할 수 있습니다.
에이전트 기능(Agentic capabilities): 이러한 거버넌스 기반 위에 구축된 Genie One은 데이터에 연결되는 AI 동료이며, Agent Bricks는 기업 데이터에 기반한 AI 에이전트를 구축하도록 지원하고, Genie App Builder를 사용하면 누구나 자연어로 에이전트와 애플리케이션을 만들 수 있습니다. 엔지니어와 분석가는 평이한 언어로 질문하고 비즈니스에서 인정하는 정의에 기반한 답변을 얻을 수 있으며, 이는 다음 두 섹션에서 다룰 주제입니다.
실용적인 설계 원칙은 간단합니다. 가치를 더하는 곳에서는 데이터를 통합하고, 복사하는 것이 무의미한 곳에서는 페더레이션하며, 두 가지 모두 동일한 제어 평면을 통해 거버넌스를 적용하는 것입니다. 그 결과, 모든 분석 또는 AI 유스케이스마다 새로운 사일로를 만들지 않고도 제조 데이터 유형과 단계 전반에 걸쳐 작업할 수 있는 방법이 마련됩니다.
데이터 리터러시 향상 – 전문가뿐만 아니라 더 많은 이들에게 유용한 데이터 만들기
플랫폼의 가치는 이를 사용할 수 있는 사람들에 의해 결정됩니다. 많은 제조업체에서는 소수의 전문가 그룹만이 공장 특정 시스템을 이해하고 있으며, 비즈니스 사용자는 보고서나 데이터 내보내기를 기다려야 합니다.
데이터 리터러시는 사람들이 실질적인 단계(관련 데이터 찾기, 신뢰할 수 있는 정의 이해하기, 데이터 분석하기, 자연어로 질문하기, 거버넌스가 적용된 에이전트 또는 애플리케이션 구축하기, 그리고 이러한 자산을 다른 사람들과 공유하기)를 거치며 성장합니다. 모든 사람이 참여하기 위해 데이터 엔지니어가 될 필요는 없습니다. 이러한 성장은 아래에 표시된 6단계를 따릅니다.

기술은 변화의 일부일 뿐입니다. 교육, 실무 커뮤니티, 챔피언 네트워크는 각 부서가 자신감을 키우고 재사용 가능한 패턴을 공유할 수 있도록 지원합니다. 거버넌스가 적용된 공통 데이터 표면은 이러한 커뮤니티에 공유된 정의, 공통 어휘, 팀 간에 재사용할 수 있는 답변 등 구체적인 작업 기반을 제공합니다.
제조업에서 "데이터와의 대화(Talk to Data)"가 작동하는 방식 (그리고 거버넌스가 적용된 시맨틱이 필요한 이유)
데이터 리터러시를 높이는 가장 빠른 방법은 사람들이 데이터와 대화할 수 있도록 하는 것입니다. 배울 쿼리 언어도 없고, 요청 티켓을 발행할 필요도 없으며, 보고서를 기다릴 필요도 없습니다. 자연어 분석은 데이터에 대한 장벽을 낮출 수 있지만, 대화형 인터페이스만으로는 충분하지 않습니다. 답변은 비즈니스에서 인정하는 정의에 기반해야 합니다.
예시: 구매
“현재 납품 위험이 있는 단일 공급업체에 의존하는 핵심 부품은 무엇인가요?”와 같은 질문은 SAP 전용 테이블 헤더, 조인(join) 및 비즈니스 규칙에 대한 지식이 필요할 수 있습니다. 구매 분석가가 이를 조사하기 위해 데이터 전문가가 될 필요는 없어야 합니다.
Purchasing Genie 데모는 이 패턴을 구체화합니다. 실행 가능한 이 프로젝트는 거버넌스가 적용된 데이터 준비, 전문가 에이전트 구축, 그리고 이를 감독자(supervisor) 아래에 구성하여 하나의 거버넌스가 적용된 앱으로 공유하는 3단계로 진행됩니다.

이 패턴은 기술적 전문 지식이 필요한 작업(데이터 준비 및 거버넌스 적용)과 비즈니스 사용자가 직접 할 수 있어야 하는 작업(질문하기, 답변 검토 및 조치 취하기)을 분리합니다.
예시: KPI 보고
동일한 패턴이 일상적인 보고에도 적용됩니다. KPI 정의가 거버넌스가 적용된 시맨틱 레이어에 존재하면 BI 도구와 AI 모두 동일한 비즈니스 로직을 기반으로 작동합니다. Genie 에이전트는 신뢰할 수 있는 정의를 사용하여 기능 내에서 질문에 답변하고, Agent Bricks는 이를 여러 부서에서 작동하는 페르소나 기반 에이전트로 구성합니다. 그 결과, 복잡한 스키마나 단절된 보고서에서 추론하는 대신 비즈니스에서 인정하는 정의에 기반하여 언제나 동일한 질문에 동일한 답변을 얻을 수 있습니다.
메르세데스-벤츠 코리아는 이 패턴을 실제로 적용하고 있으며, 자세한 내용은 여기에서 확인하실 수 있습니다.
실질적인 향후 방향
50여 년 전, 조셉 해링턴(Joseph Harrington) 박사의 컴퓨터 통합 제조(Computer Integrated Manufacturing) 비전은 제조업을 정보의 흐름으로 통합된 하나의 응집력 있는 시스템으로 설명했습니다. 그 비전은 이제 대규모로 실현 가능해졌습니다.
구현을 위한 레시피는 다음 세 단계로 구성됩니다:
- 단일 제어 평면(control plane)인 Unity Catalog를 사용하여 미러링된 데이터 소스와 페더레이션된 데이터 소스를 모두 아우르며 데이터를 한 번에 통합하고 거버넌스를 한 번에 적용합니다.
- 가치 사슬의 한 부분에서 발견된 사항이 다른 부분에서 조치를 유도할 수 있도록 공유 식별자(일련번호, 로트 번호 또는 부품 번호)를 조인 키로 만듭니다. 이를 통해 쿼리로 엔드투엔드 추적성을 확보할 수 있습니다. 적합한 식별자는 도메인에 따라 다릅니다. 일부 도메인에서는 일련번호가 부여된 장치 및 VIN(차대번호)이, 프로세스 제조에서는 로트 또는 배치 번호가 적합합니다.
- 거버넌스가 적용된 비즈니스 시맨틱에 자연어 액세스 기반을 둠으로써 사람들이 데이터와 대화할 수 있도록 합니다.
비즈니스 사용자가 쉬운 언어로 질문하고 신뢰할 수 있는 답변을 얻을 수 있게 되면, 데이터 리터러시는 소수 전문가의 전유물이 아니라 조직 전체의 역량이 됩니다. 그 결과는 또 다른 대시보드가 아닙니다. 가치 사슬 전반에 걸쳐 수천 명의 사람들이 신뢰할 수 있는 데이터를 찾고, 이해하고, 이에 기반해 조치를 취할 수 있게 되는 것입니다.
자주 묻는 질문(FAQ)
가치 사슬 전반에 걸쳐 제조 데이터를 연결할 때 얻을 수 있는 가장 큰 이점은 무엇인가요?
가치 사슬 전반에 걸쳐 제조 데이터를 연결할 때 얻을 수 있는 가장 큰 이점은 한 단계에서 시작되어 다른 단계에서 조치가 필요한 질문에 답할 수 있다는 것입니다. 생산 결함을 물류를 통해 원인이 된 공급업체 배치(batch)까지 추적하거나, 의심스러운 공급업체 로트(lot)를 해당 로트가 도달한 모든 제품으로 추적할 수 있습니다. 연결된 데이터가 없다면 이러한 각 조사는 며칠 동안 수작업으로 진행해야 합니다. 연결된 레이크하우스를 사용하면 동일한 질문이 하나의 쿼리로 해결됩니다.
제조업체는 모든 소스 데이터를 Databricks로 마이그레이션해야 하나요?
제조업체가 모든 소스 데이터를 Databricks로 마이그레이션할 필요는 없습니다. 유용한 경우 데이터를 복사할 수 있지만, 제로 카피(zero-copy) Open Sharing 및 Lakehouse Federation을 사용하면 데이터를 소스 시스템에 그대로 두고 그 자리에서 쿼리할 수 있습니다. Unity Catalog는 페더레이션된 데이터와 미러링된 데이터 모두에 거버넌스를 적용할 수 있습니다.
추적성(traceability)이란 무엇인가요?
추적성은 제조 공정 단계, 제품, 자재 및 운영 기록을 연결하여 팀이 영향을 받은 제품으로부터 역추적하거나 의심스러운 자재로부터 정방향 추적을 할 수 있도록 지원합니다. 이를 통해 더 빠른 문제 해결과 더 정확한 리콜 분석이 가능해집니다. 한 가지 예로 생산된 제품의 일련번호나 로트 번호를 추적하는 것이 있습니다.
LTAP란 무엇이며, 제조업체에 왜 필요한가요?
LTAP는 레이크 트랜잭션/분석 처리(Lake Transactional/Analytical Processing)를 의미합니다. 이는 거버넌스가 적용된 하나의 플랫폼에서 분석 및 트랜잭션 워크로드를 모두 실행하는 것을 말합니다. 제조업에는 이력 데이터에 대한 대규모 분석과 운영 기록을 읽고 쓰는 반응형 애플리케이션이 모두 필요합니다. 과거에는 이 두 가지가 서로 데이터를 복사하며 두 개의 별도 스택에 존재했지만, LTAP는 거버넌스가 적용된 단일 데이터 사본에서 두 가지를 모두 실행합니다.
플랫폼 기능 외에 데이터 리터러시를 성장시키는 요인은 무엇인가요?
기능만으로는 충분하지 않습니다. 각 부서의 교육, 실무 커뮤니티, 챔피언은 사람들이 자신감을 갖고 패턴을 공유하며 거버넌스가 적용된 공통 데이터 표면을 사용할 수 있도록 돕습니다. 플랫폼은 기반을 제공하고, 활발한 커뮤니티는 이를 광범위한 역량으로 전환합니다.
“데이터와의 대화”는 어떻게 신뢰성을 확보하나요?
자연어 액세스는 거버넌스가 적용된 비즈니스 시맨틱(문서화된 측정값, 차원, 조인 및 정의)에 기반해야 합니다. 그러면 Genie는 복잡한 스키마나 단절된 보고서에서 의미를 추론하는 대신 신뢰할 수 있는 동일한 컨텍스트를 사용하여 질문에 답변할 수 있습니다.
Lakehouse Federation이란 무엇인가요?
Lakehouse Federation은 데이터를 소스 시스템에 그대로 유지하면서 Databricks를 통해 쿼리할 수 있도록 지원하는 Databricks의 기능입니다. 이를 통해 추가적인 ETL 파이프라인이나 데이터 복사본을 만들지 않아도 됩니다. 소스 데이터는 미러링된 데이터와 함께 Unity Catalog를 통해 관리되므로 데이터가 물리적으로 어디에 있든 통합된 거버넌스 레이어를 제공합니다.
제조 데이터의 맥락에서 Unity Catalog는 무엇인가요?
Unity Catalog는 데이터, 모델, AI 에이전트를 위한 Databricks의 통합 거버넌스 레이어입니다. 전체 데이터 환경에 걸쳐 단일 권한 모델, 전체 데이터 계보(lineage) 및 검색 기능을 제공합니다. 제조업의 경우, 데이터가 레이크하우스에 있든 소스 시스템에서 페더레이션되었든 관계없이 생산 데이터, 품질 기록, 공급업체 데이터 및 AI 에이전트를 관리하는 단일 제어 평면을 의미합니다.
플랫폼이 대용량 기기 및 차량 텔레메트리를 처리할 수 있나요?
예, 그렇습니다. 이 플랫폼은 배치와 스트리밍을 결합합니다. 대용량 기기 및 차량 텔레메트리를 지연 시간이 매우 짧은 연속 스트림으로 수집하고 안정적으로 처리하여 도중에 이벤트가 누락되지 않도록 합니다.
데이터는 어떻게 Databricks로 유입되나요?
데이터 수집은 쉽게 설계되었습니다. Zerobus Ingest는 거버넌스가 적용된 테이블로 직접 푸시 기반 스트리밍을 지원하고, Lakeflow Connect는 비즈니스 시스템을 위한 관리형 커넥터 및 변경 데이터 캡처(CDC)를 제공하며, Auto Loader 및 Structured Streaming은 파일과 이벤트를 처리합니다.
플랫폼이 개방형이며 멀티 클라우드를 지원하나요?
예, 그렇습니다. Delta 테이블은 클라우드 오브젝트 스토리지에 저장되며, 스토리지와 컴퓨팅이 독립적으로 확장됩니다. Databricks는 AWS, Azure, Google Cloud에서 실행되며, 데이터는 Delta Lake 및 Iceberg와 같은 개방형 형식으로 저장됩니다.
(이 글은 AI의 도움을 받아 번역되었습니다. 원문이 궁금하시다면 여기를 클릭해 주세요)
최신 게시물을 이메일로 받아보세요
블로그를 구독하고 최신 게시물을 이메일로 받아보세요.