MemCurrent: 프로덕션 에이전트를 위한 지속성 메모리 설계
작성자: Databricks AI 연구팀
AI 도구 덕분에 에이전트를 바이브 코딩(vibe code)하기가 매우 쉬워졌습니다. 하지만 프로덕션 환경에서 엔터프라이즈 에이전트를 구축하고 유지 관리하는 일은 여전히 훨씬 더 어렵습니다. 특히 개발자들은 품질(특히 롱테일 작업에서 유용한 답변을 얻는 것)과 효율성(대규모 환경에서 비용과 지연 시간을 적절히 유지하는 것) 사이에서 절충해야 하는 경우가 많습니다. 하나의 차원에서 이점을 얻는 기법이 다른 차원에서는 손실을 가져오는 경우가 흔합니다.
메모리는 두 가지 측면을 동시에 개선할 수 있는 유망한 방법입니다. 메모리를 통해 에이전트는 사용자 선호도, 이전 수정 사항, 메트릭 정의, 성공적인 워크플로 등 유용한 컨텍스트를 여러 작업에 걸쳐 전달할 수 있습니다. 원칙적으로 이는 정확도를 높이고, 반복되는 오류를 줄이며, 불필요한 재탐색을 방지할 수 있습니다. 하지만 이력이 많다고 해서 반드시 더 나은 메모리가 되는 것은 아닙니다. 과거의 모든 상호작용을 제공하는 것은 비용이 많이 들고 오래되거나 상충되거나 무관한 컨텍스트를 유입시킬 수 있습니다. 핵심 과제는 무엇을 유지할지, 어떻게 관리할지, 그 유용성을 어떻게 측정할지 결정하는 것입니다.
이번 게시물에서는 프로덕션 에이전트를 위한 지속성 메모리 아키텍처인 MemCurrent를 소개합니다. MemCurrent는 현재 새로운 Agent Bricks Memory 및 Genie에 적용되어 있습니다. 에이전트는 작업하면서 메모리를 읽고 쓰며, 오프라인 '드림(dreaming)' 파이프라인이 메모리를 통합하여 일관성과 최신성을 유지합니다. 실제 엔터프라이즈 작업으로 구축된 자체 내부 벤치마크에서 MemCurrent는 메모리가 없을 때보다 에이전트의 통과율을 3배로 높이는 동시에 토큰 사용량을 31% 줄이고 실행 속도를 26% 더 빠르게 만들었습니다. 이 게시물의 나머지 부분에서는 이를 어떻게 설계하고 평가했는지, 그리고 그 과정에서 무엇을 배웠는지 설명합니다.
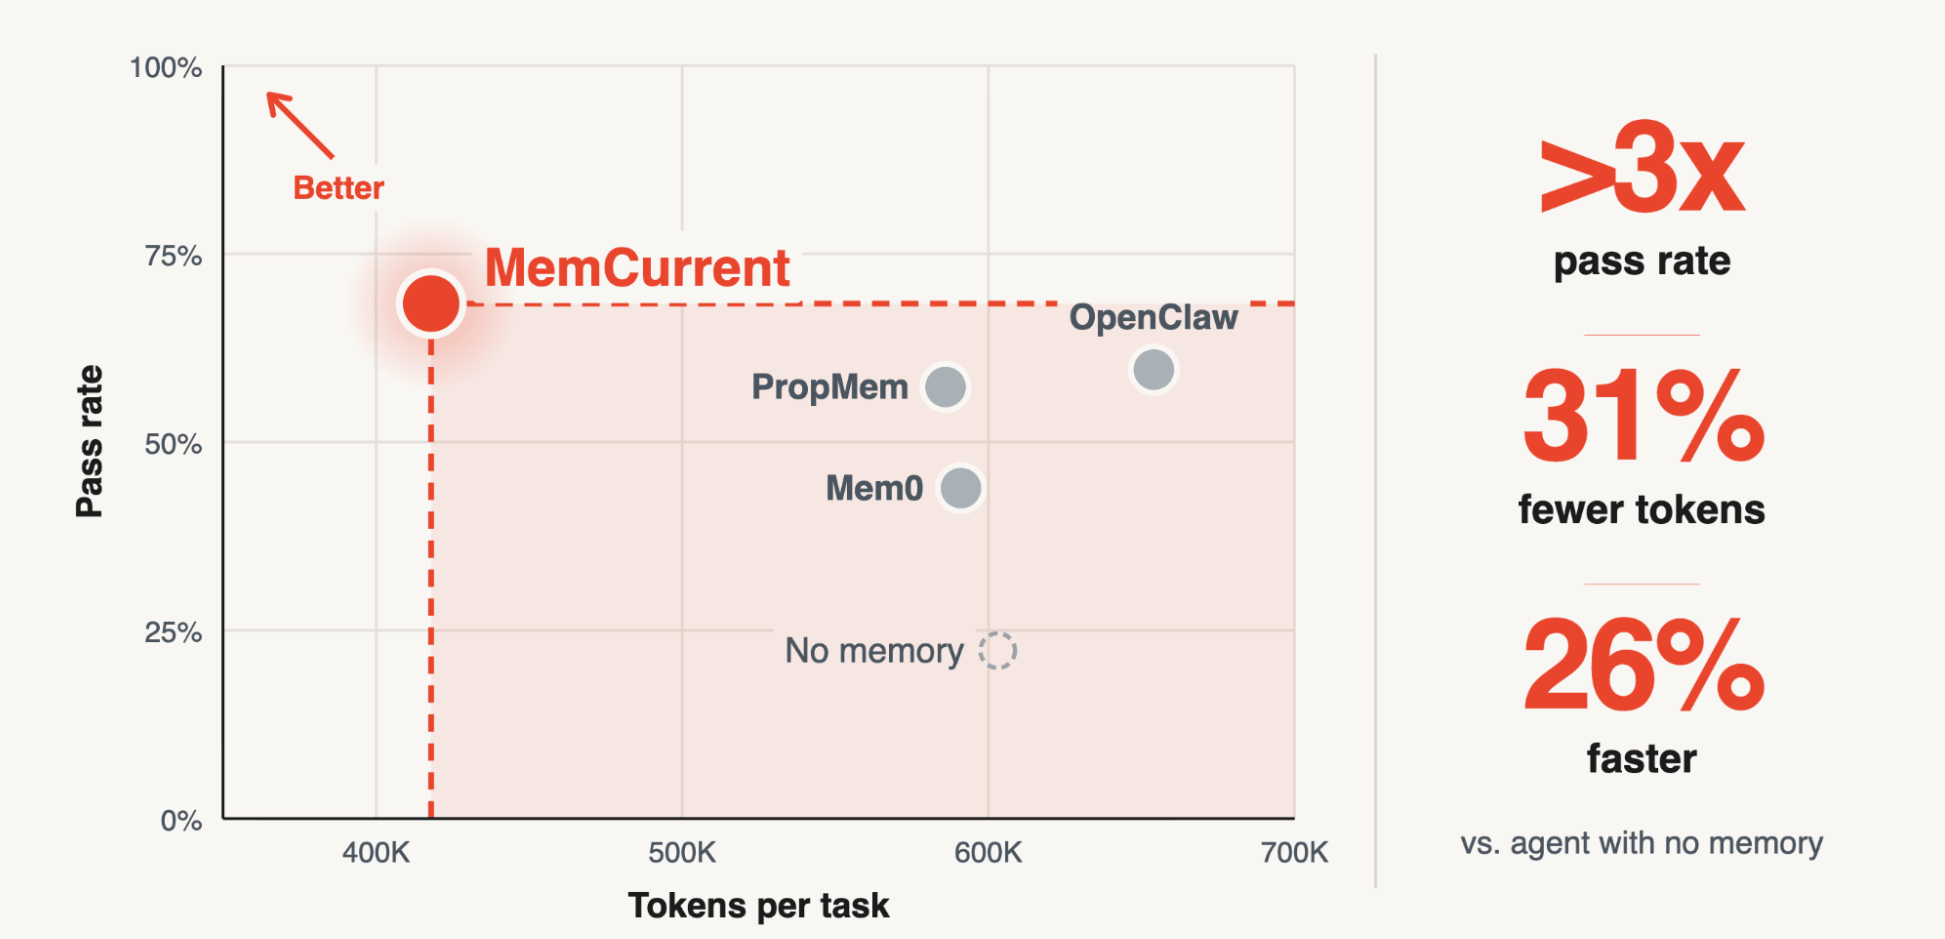
그림 1. 내부 메모리 벤치마크에서 작업당 통과율 대 토큰 수 비교. MemCurrent는 파레토 최적선(Pareto frontier)에 위치하며 두 차원 모두에서 Mem0, PropMem, OpenClaw 메모리보다 뛰어난 성능을 보입니다.
메모리 설계 방식
에이전트에 메모리를 연결하는 방법에는 세 가지가 있습니다. 플러그인(MemAlign 및 Memory Scaling에 관한 이전 작업과 동일) 형태의 경우 메모리는 세션의 정해진 지점에서 자동으로 읽고 쓰여집니다. 도구(tools) 형태에서는 에이전트가 무엇을 언제 읽고 쓸지 결정합니다. 오프라인 파이프라인 형태에서는 일정 또는 트리거에 따라 백그라운드에서 메모리가 업데이트되고 이후 세션에서 사용됩니다. 각 방식에는 트레이드오프가 존재합니다.
다음 형태의 메모리… | 트리거 주체/방식 | 연산 시점 | 장점 | 단점 |
플러그인 | 자동 | 온라인 |
|
|
도구 | 에이전트 | 온라인 |
|
|
| 파이프라인 | 스케줄 또는 트리거 | 오프라인 |
|
|
표 1. 메모리의 세 가지 접근 패턴: 플러그인, 도구 또는 오프라인 파이프라인.
MemCurrent는 세 가지 방식을 모두 가장 적합한 위치에 활용합니다.
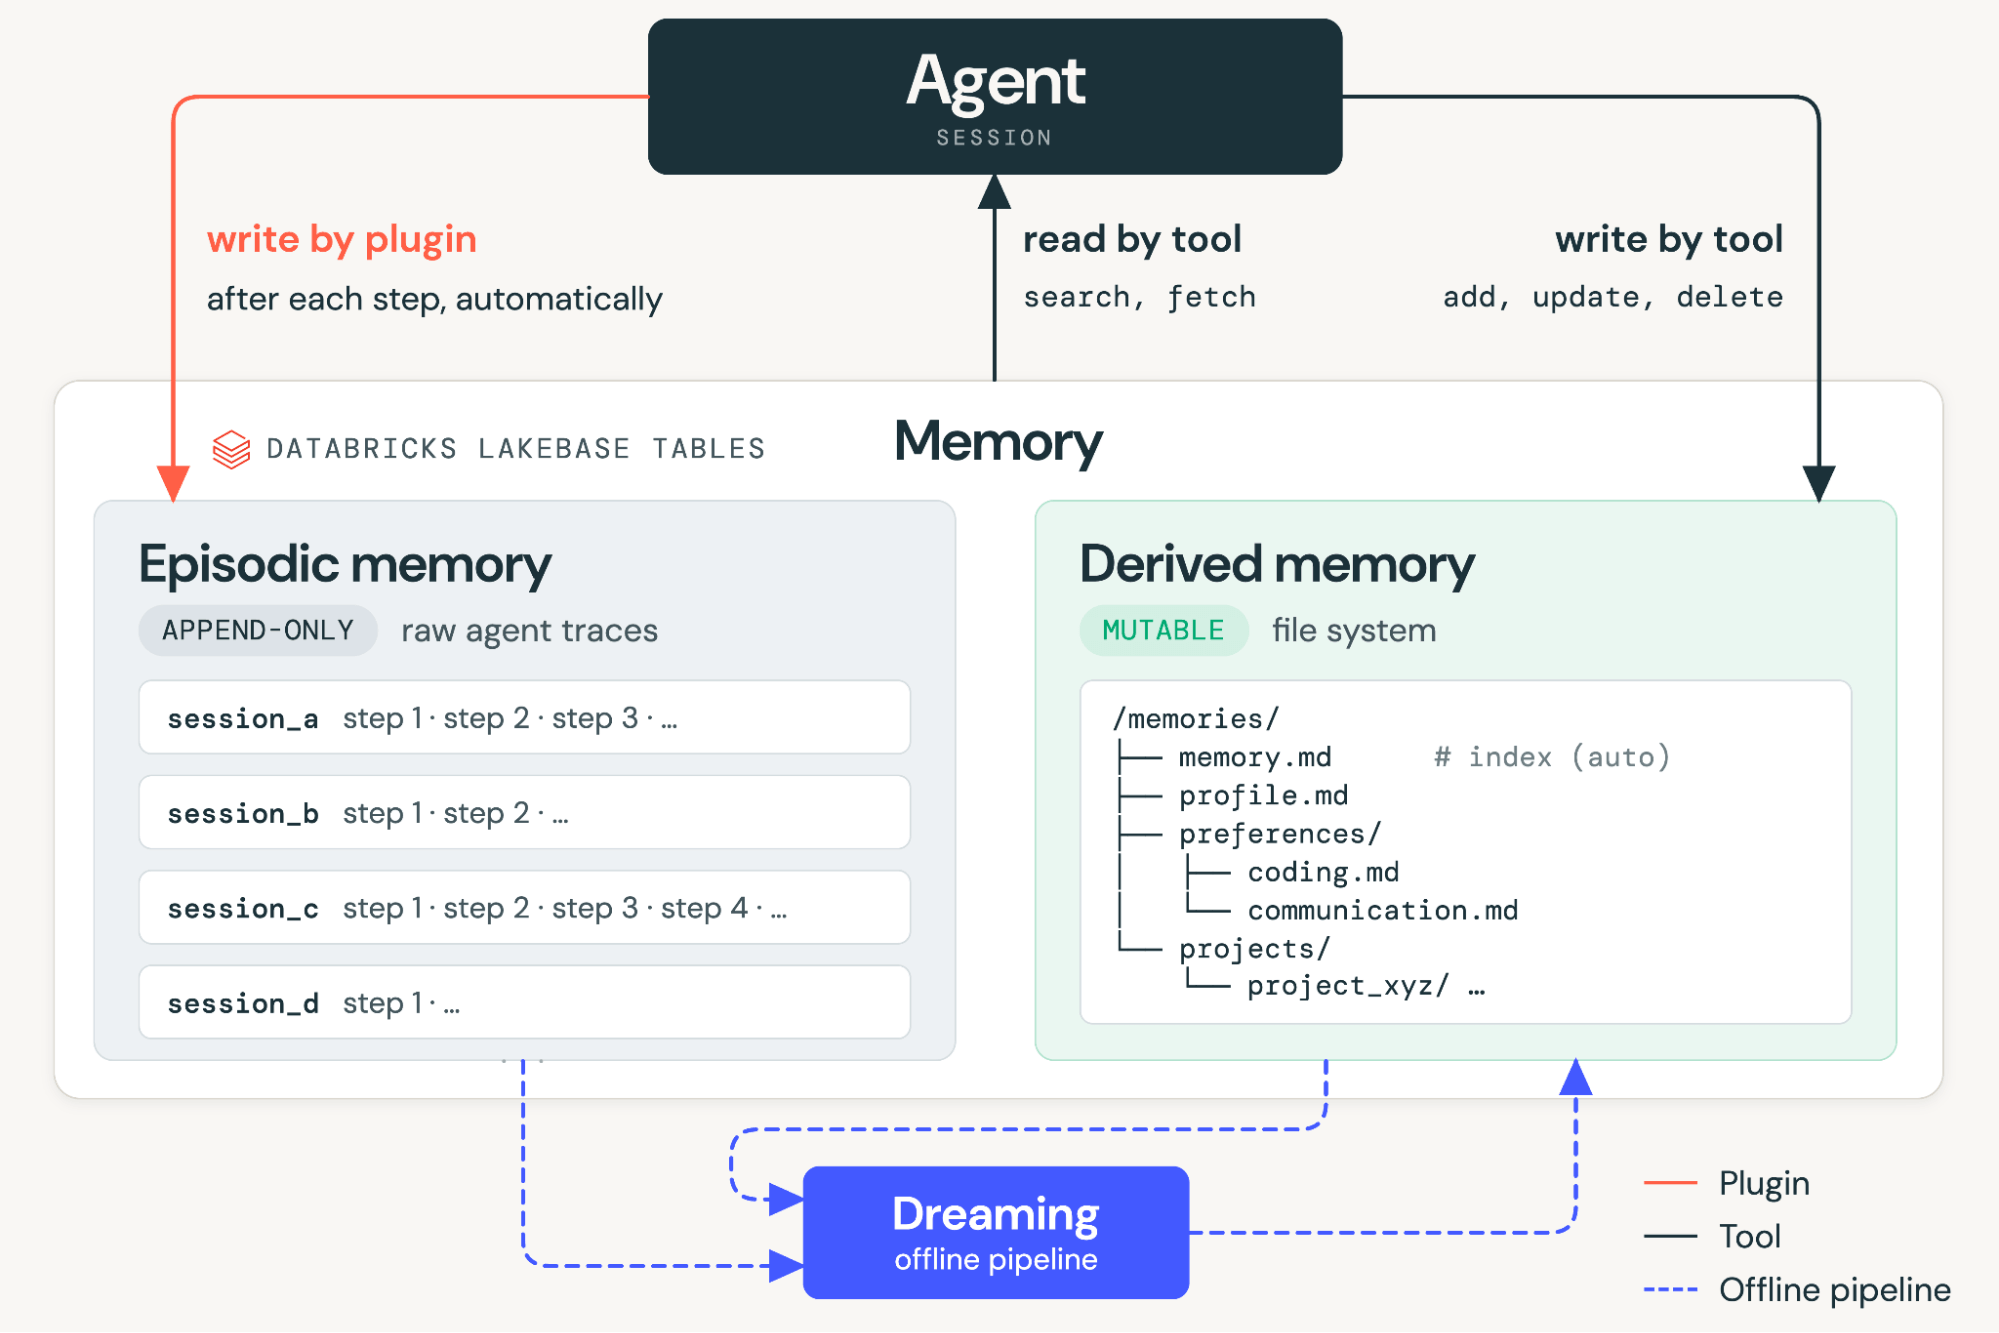
그림 2. MemCurrent 개요.
MemCurrent에는 두 가지 유형의 메모리가 있습니다. 원시 세션 추적 데이터를 저장하는 에피소드 메모리(episodic memory)와 이러한 추적 데이터에서 요약된 학습 내용을 구조화된 지식 기반에 파일 형태로 저장하는 파생 메모리(derived memory)입니다. 최상위에는 자동 생성된 memory.md 인덱스가 위치하여 파일 구조와 각 파일의 포함 내용을 설명합니다.
에피소드 메모리와 파생 메모리 모두 수많은 사용자로 확장 가능하면서 낮은 지연 시간의 응답을 제공하는 프로덕션급 데이터베이스에 저장됩니다. 에피소드 메모리는 추가 전용(append-only) 방식으로, 세션이 실행되는 동안 플러그인이 각 단계를 기록합니다. 파생 메모리는 계층적 파일 시스템을 시뮬레이션하는 변경 가능한 테이블이며 두 가지 방식으로 쓰기가 수행됩니다. 에이전트 도구(add_memory, update_memory, delete_memory)는 "/tmp 디렉토리에 스크립트를 작성하지 마라"와 같은 명시적 요청을 처리합니다. 오프라인 드림 파이프라인은 나머지 요청을 처리하여 각 새 세션에서 암묵적인 학습 내용을 요약해 관련 파일에 담습니다. 또한 과도하게 큰 파일을 분할하고 중복을 병합하며 충돌을 해결하여 전체 저장소를 정리합니다.
읽기는 계층적으로 작동합니다. 세션이 시작될 때 플러그인이 메모리 인덱스를 주입하므로 에이전트는 시작하기 전에 자신이 무엇을 알고 있는지 파악할 수 있습니다. 세션 동안 에이전트는 두 가지 메모리 유형 전체에서 작동하는 두 가지 도구를 사용합니다. search_memory는 쿼리에 대해 가장 잘 일치하는 항목(과거 추적의 한 단계 또는 메모리 파일의 한 줄)을 반환하고, fetch_memory는 식별자(세션 ID 또는 파일 경로)별로 전체 항목을 반환합니다.
메모리 평가 방식
벤치마크
저희는 널리 사용되는 세 가지 오픈소스 벤치마크인 LoCoMo, LongMemEval, ConvoMem으로 시작합니다. 세 벤치마크 모두 개방형 합성 대화에서 앞서 언급된 사실을 에이전트가 회상할 수 있는지 테스트합니다.
또한 사용자가 자신의 데이터에 대해 온갖 질문을 던지는 실제 Genie 대화로부터 내부 메모리 벤치마크를 구축했습니다. 그림 3에서 보듯이, 1만 2천 개 이상의 세션에서 시작하여 메모리 가치가 있는 신호가 포함된 3천 개의 후보를 추출하고, 채점 루브릭이 포함된 후속 질문을 작성했습니다. 동일한 사용자의 다른 세션들은 테스트 케이스의 더미(filler) 데이터 역할을 합니다. 적대적 평가자(adversarial judge)가 지식이 실제로 존재하는지, 사용자에게 특화되어 있는지, 답변에 필요한지, 자연스러운지, 검증 가능한지 등 7가지 기준에 따라 각 테스트 케이스를 점검했습니다. 최종 수동 검토를 거쳐 이 벤치마크는 29명의 사용자 및 2,233개의 이력 세션에 대해 총 114개의 테스트 케이스를 갖추게 되었습니다.
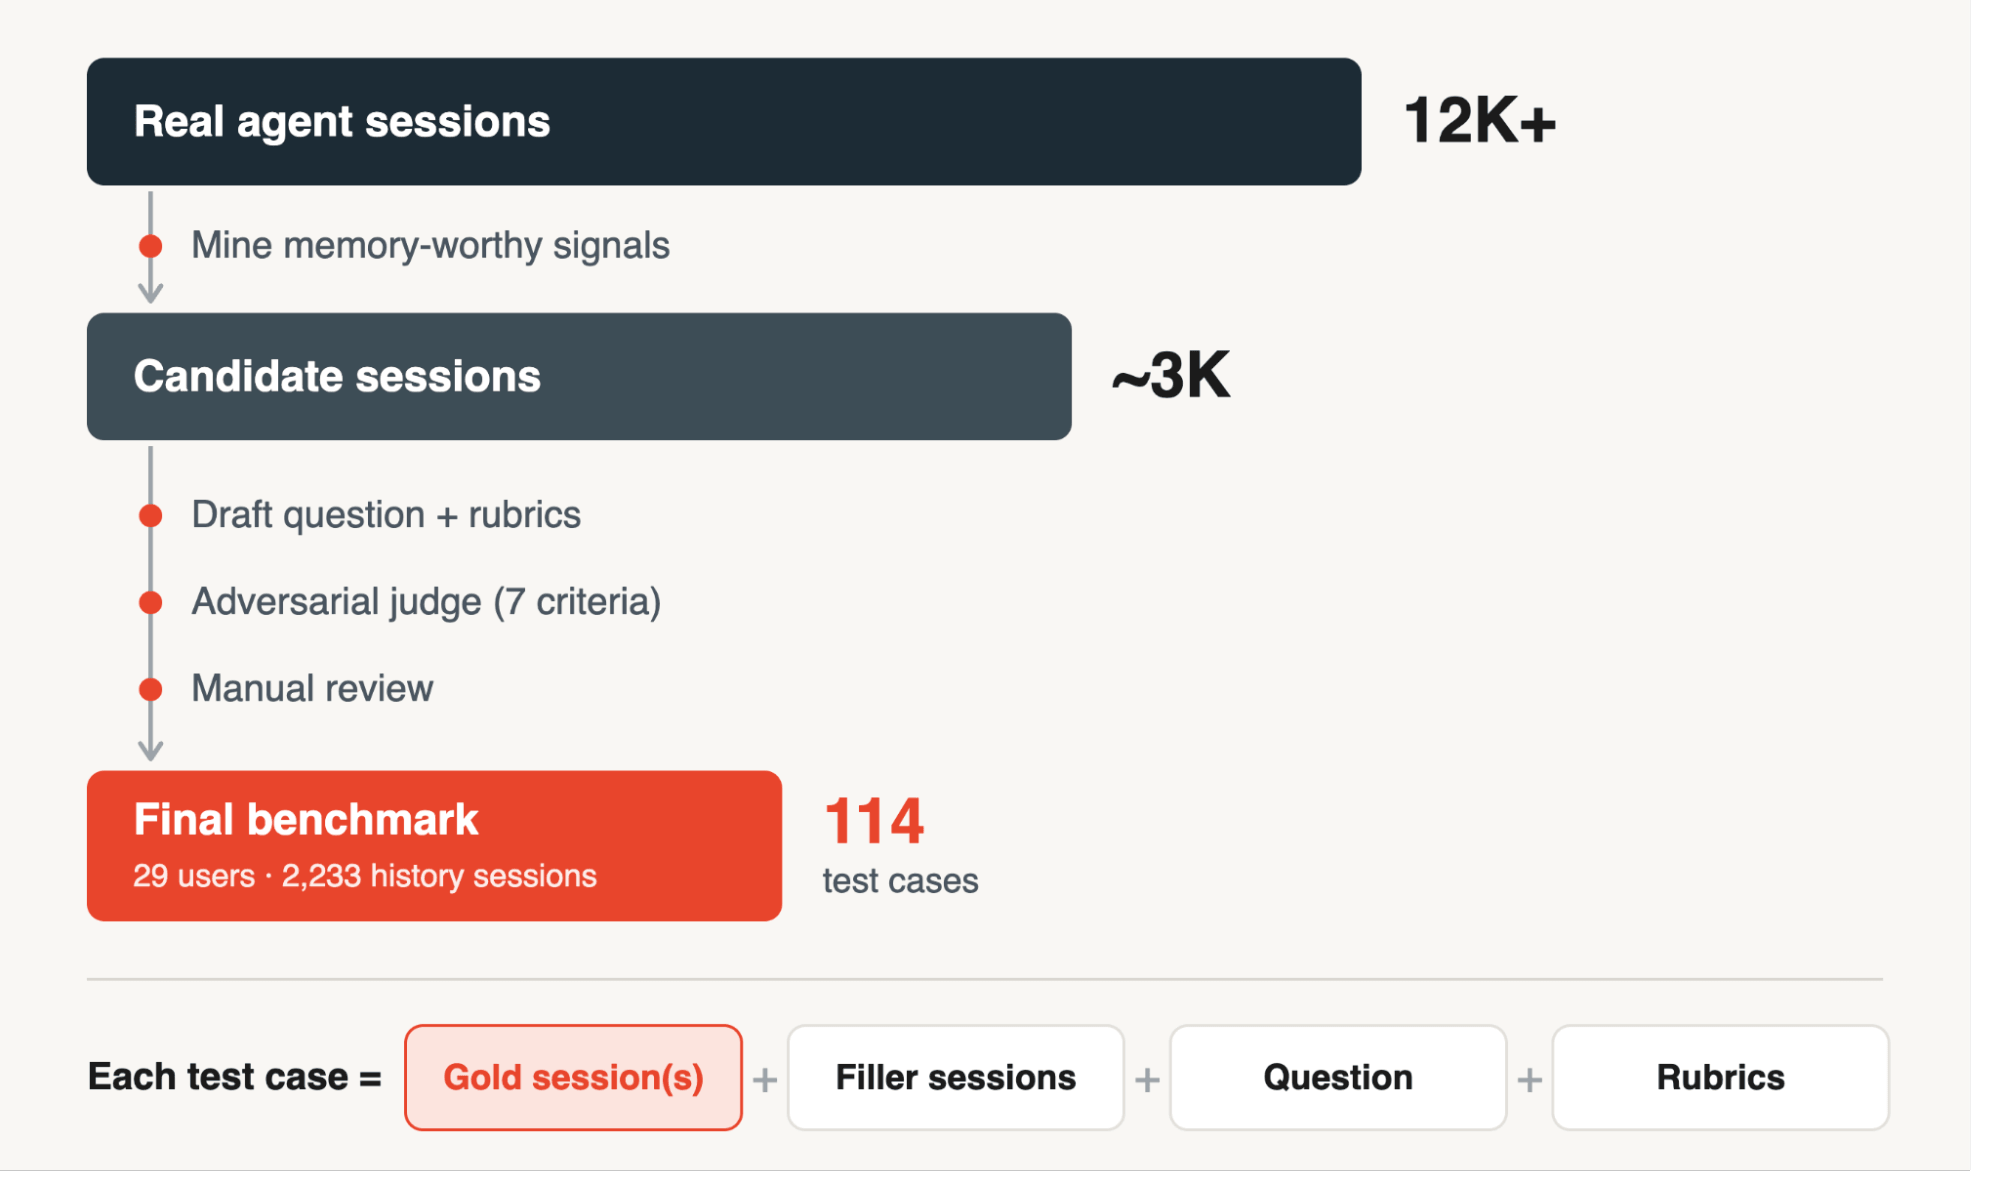
그림 3. 내부 메모리 벤치마크 구축 방법.
예시는 다음과 같습니다.
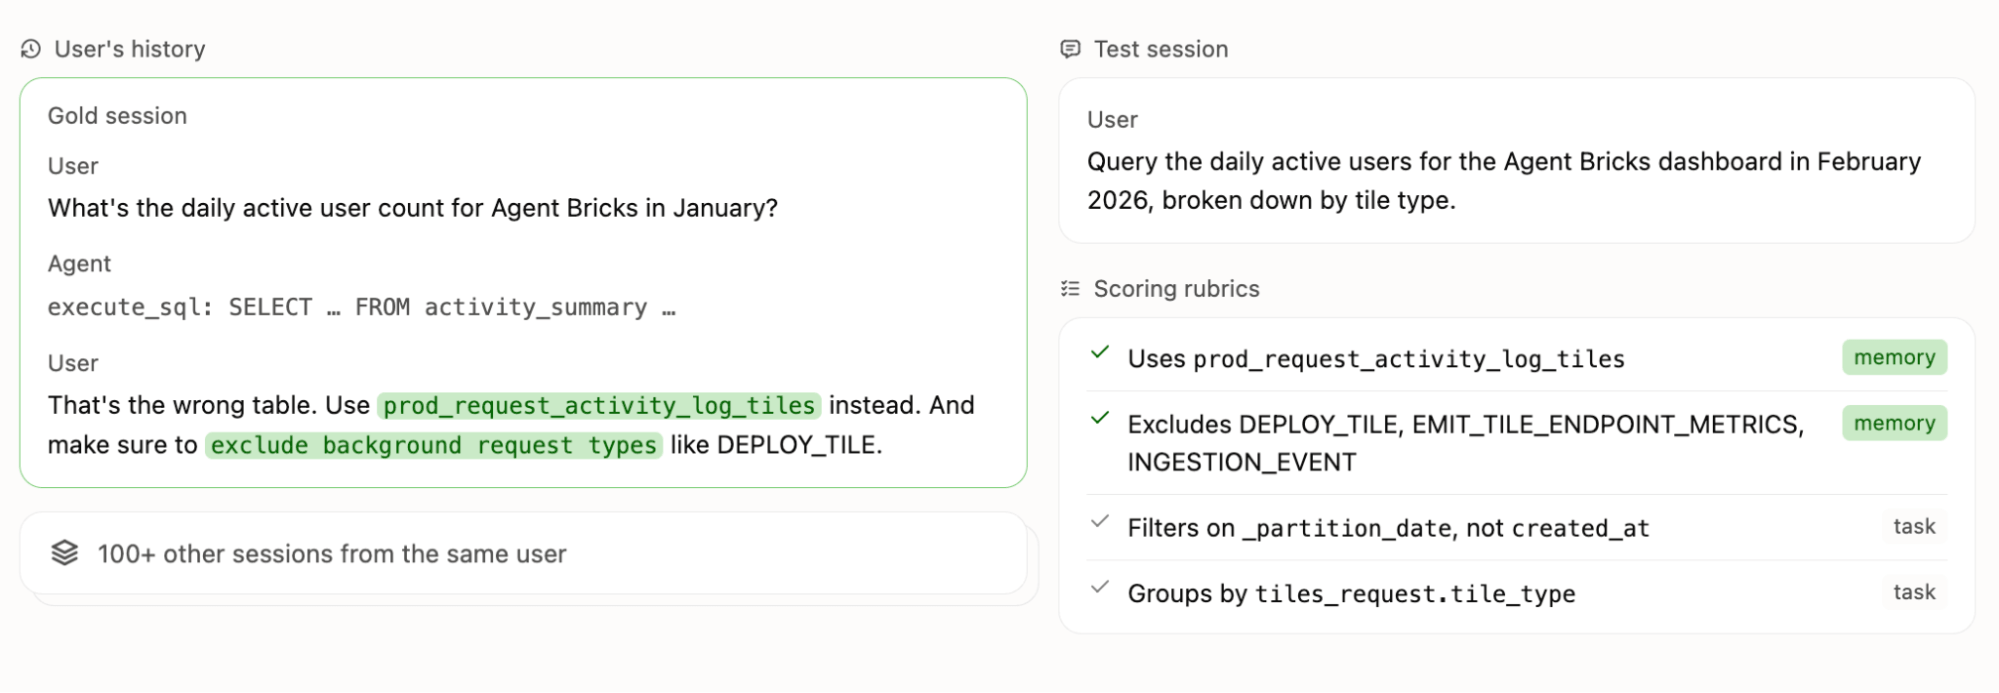
그림 4. 내부 메모리 벤치마크의 예시 테스트 케이스. 과거 세션에서 사용자는 에이전트의 테이블 선택을 수정하고 백그라운드 요청을 제외하도록 지시합니다. 나중에 에이전트는 다르지만 관련된 질문에 직면하며, 100개 이상의 세션 중에서 해당 세션을 찾아 학습한 내용을 적용해야 합니다. 결과는 루브릭 목록(일부는 메모리 의존적, 일부는 작업 고유적)에 따라 LLM 평가자가 점수를 매깁니다.
저희 벤치마크는 세 가지 점에서 기존 벤치마크와 다릅니다.
엔터프라이즈 도메인. 기존 벤치마크는 시뮬레이션된 페르소나의 삶에 관한 개방형 대화입니다. 반면 본 벤치마크는 테이블 시맨틱, 메트릭 정의, 워크플로와 같은 풍부한 엔터프라이즈 지식을 포함하여 데이터 워크스페이스에서의 실제 작업에서 도출되었습니다.
메모리는 답변이 아닌 행동을 촉진합니다. 이전 대화에서 올바른 문자열을 찾는 것만으로는 부족합니다. 에이전트는 검색된 지식을 적용하여 다단계 작업을 완료해야 합니다.
다양성. 테스트 케이스는 5가지 메모리 유형(프로필, 선호도, 도메인 지식, 프로젝트, 워크플로)과 11가지 시나리오(직접 지시, 변경되거나 오래된 사실, 다중 세션 집계, 메모리 독립적 질문 등)를 교차 조합하여 구성됩니다.
결과
동일한 기반 LLM을 사용하여 MemCurrent를 세 가지 오픈소스 메모리 백엔드인 Mem0, PropMem, OpenClaw memory와 비교합니다.
오픈소스 벤치마크. 각 메모리 백엔드를 두 가지 에이전트 하네스(LangGraph 및 OpenAI Agents SDK)로 구축된 간단한 질의응답 에이전트와 결합합니다. 또한 기준점으로 메모리 없음(no memory) 상태의 하한선과 모든 이전 세션이 에이전트의 컨텍스트에 포함되는 전체 컨텍스트(full context) 상태의 상한선, 이렇게 두 가지 베이스라인을 실행합니다. 세 가지 벤치마크 모두에서 MemCurrent는 모든 메모리 백엔드 중 가장 높은 점수를 기록하며 비용 대비 정확도의 파레토 프론티어(Pareto frontier)를 유지합니다. 평균적으로 MemCurrent(88.1%)는 질문당 입력 토큰 수가 약 12배 적음에도 불구하고(8.4K 대 103K) 전체 컨텍스트(87.8%)와 대등한 성능을 보입니다. 기록이 가장 긴 두 가지 벤치마크에서는 프롬프트에 모든 내용을 집어넣어 에이전트에 혼란을 주는 전체 컨텍스트를 오히려 능가하기도 했습니다.
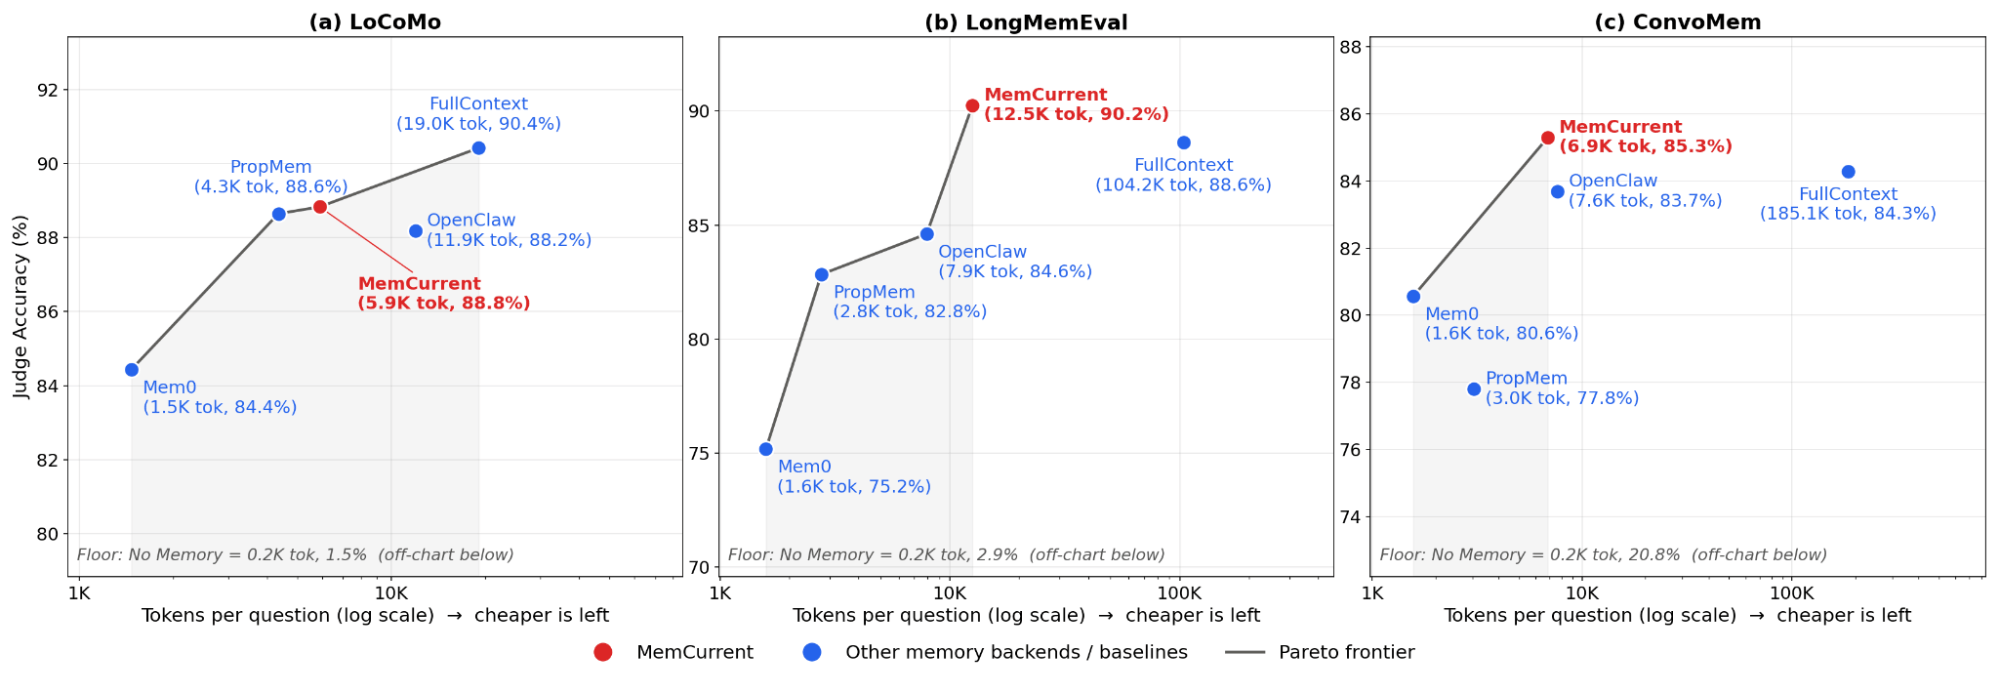
그림 5. (a) LoCoMo(샘플당 19–32개 세션), (b) LongMemEval(s split)(샘플당 38–62개 세션) 및 (c) ConvoMem(500개 샘플의 층화 추출 하위 집합, 샘플당 100개 세션)에서 메모리 백엔드의 비용–정확도1 트레이드오프. 에이전트 및 메모리 모델로 GPT 5.6 luna를 사용합니다. 모든 메모리 백엔드는 세션 시작 시 질문과 관련된 메모리를 자동으로 검색하여 에이전트 컨텍스트에 주입하는 플러그인으로 실행됩니다.2 정확도는 LangGraph 및 OpenAI Agents SDK 하네스와 3회 반복 실험에 대한 평균값입니다. 비용은 질문당 평균 입력 토큰 수(로그 스케일)입니다.
자체 메모리 벤치마크. 자체 벤치마크에서는 격차가 더 벌어집니다. 여기서는 각 메모리 백엔드가 벤치마크 세션이 생성된 동일한 에이전트인 내부 Genie 내에서 실행됩니다. 기록이 너무 길어 컨텍스트에 다 담을 수 없으므로, 상한선은 골드 메모리만 에이전트의 컨텍스트에 주입하는 '골드 주입(gold injection)'으로 설정했습니다. 모든 메모리 백엔드 중 MemCurrent가 가장 높은 통과율(68.4%), 가장 낮은 지연 시간(252초) 및 토큰 사용량(418K)을 기록하며 메모리 없음(22.3%)과 골드 주입(78.6%) 사이 격차의 80% 이상을 메웠습니다. 특히 이전 벤치마크에서 파레토 프론티어에 있던 Mem0는 여기서 높은 지연 시간과 비용을 보이며 43.9%로 뒤처졌습니다. 메모리가 없는 경우와 비교하여, MemCurrent는 에이전트의 통과율을 3배로 높이는 동시에 (22.3% → 68.4%) 속도는 1.35배 빨라지고 비용은 1.44배 절감되었습니다.
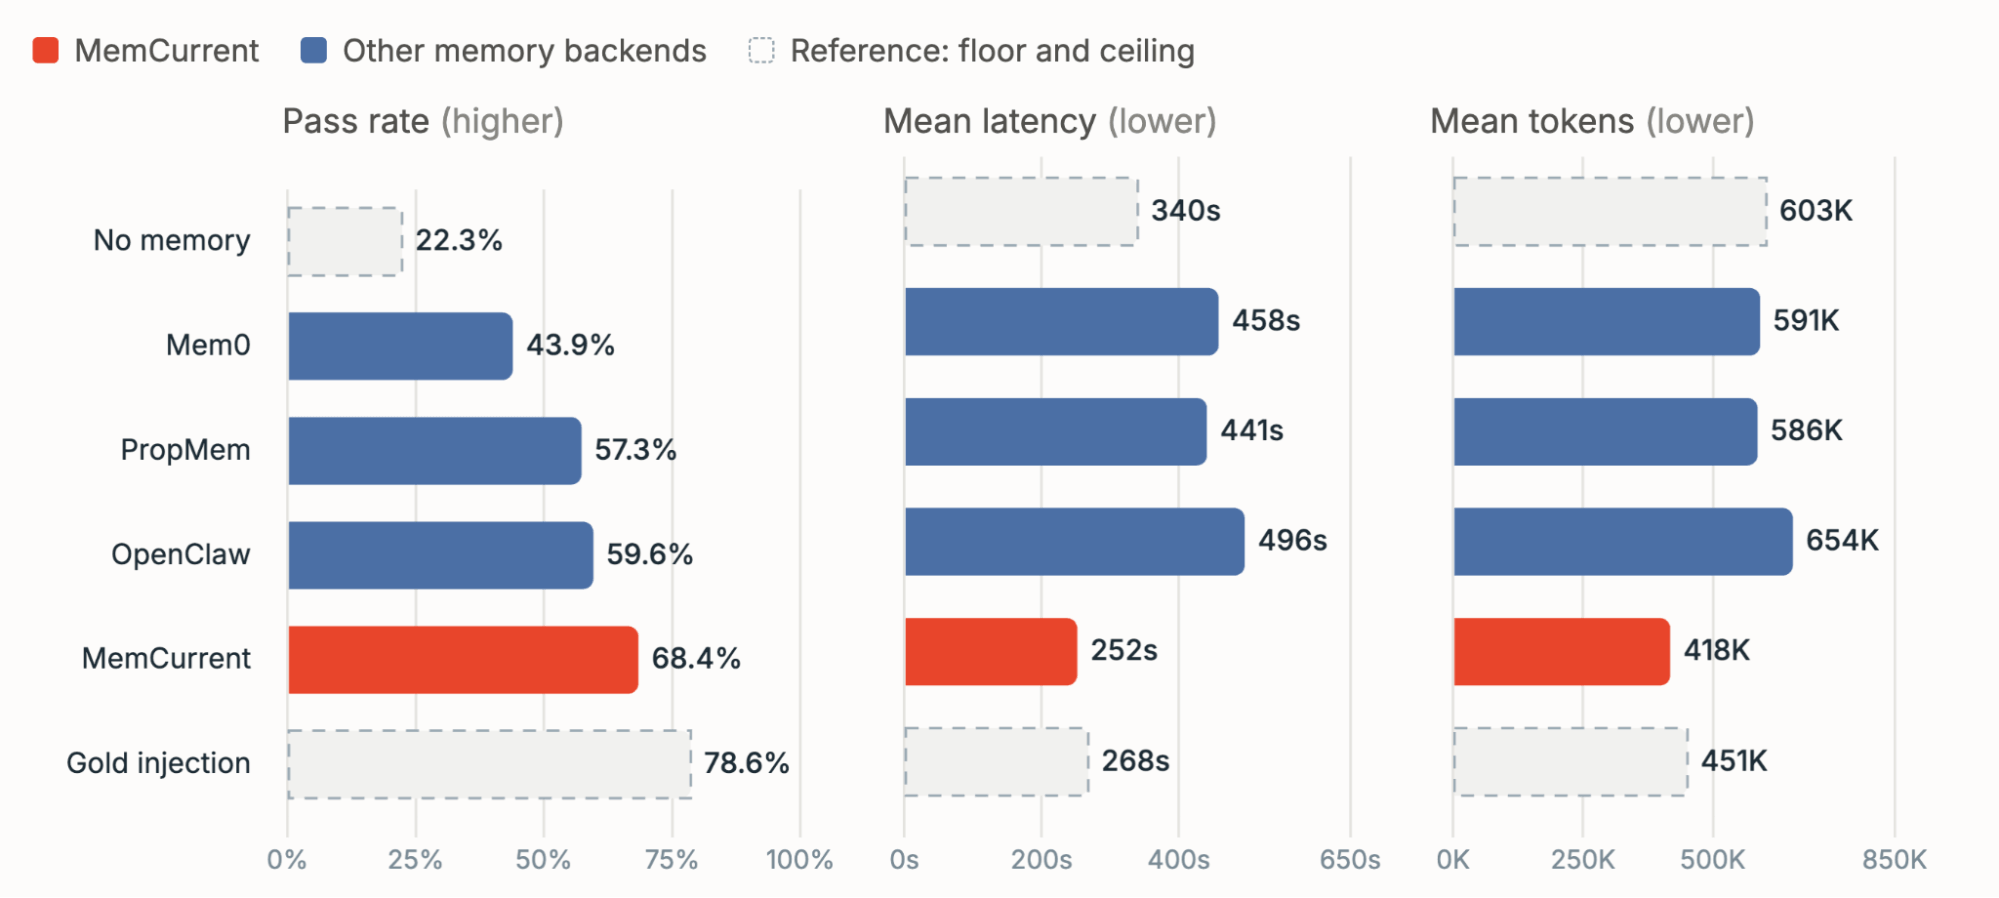
그림 6. 3회 반복 테스트에 걸친 자체 메모리 벤치마크의 작업당 통과율, 평균 지연 시간 및 평균 토큰 사용량. 에이전트 모델로는 Claude Opus 4.6, 메모리 모델로는 GPT 5.6 sol을 사용합니다. 모든 메모리 백엔드는 에이전트 툴 및 세션 시작 플러그인으로 제공됩니다.
MemCurrent 실제 활용 사례
벤치마크 수치 외에도 내부 Genie 세션 사례를 통해 MemCurrent가 실제 현장에서 어떻게 도움이 되는지 두 가지 예시로 살펴보겠습니다.
예시 1: 메모리로 간헐적인 할루시네이션(환각) 오류 방지. 그림 7에서 한 사용자가 에이전트에 지난 두 달 동안 Product X의 상위 20개 사용자를 요청했습니다. 에이전트는 올바른 SQL 쿼리를 작성했지만, 파일에 저장된 실제 실행 결과를 읽지 않았습니다. 그런데도 환각(hallucination)으로 작성된 내용이 담긴 테이블을 자신 있게 생성했습니다. 사용자의 피드백을 받은 후 에이전트는 이 교훈을 메모리에 저장했습니다. 다음번에 쿼리가 실행되었을 때 에이전트는 결과를 먼저 읽고 올바른 테이블을 반환했습니다. 단 한 번의 메모리 교정으로 일회성 실수가 습관이 되는 것을 막았습니다.
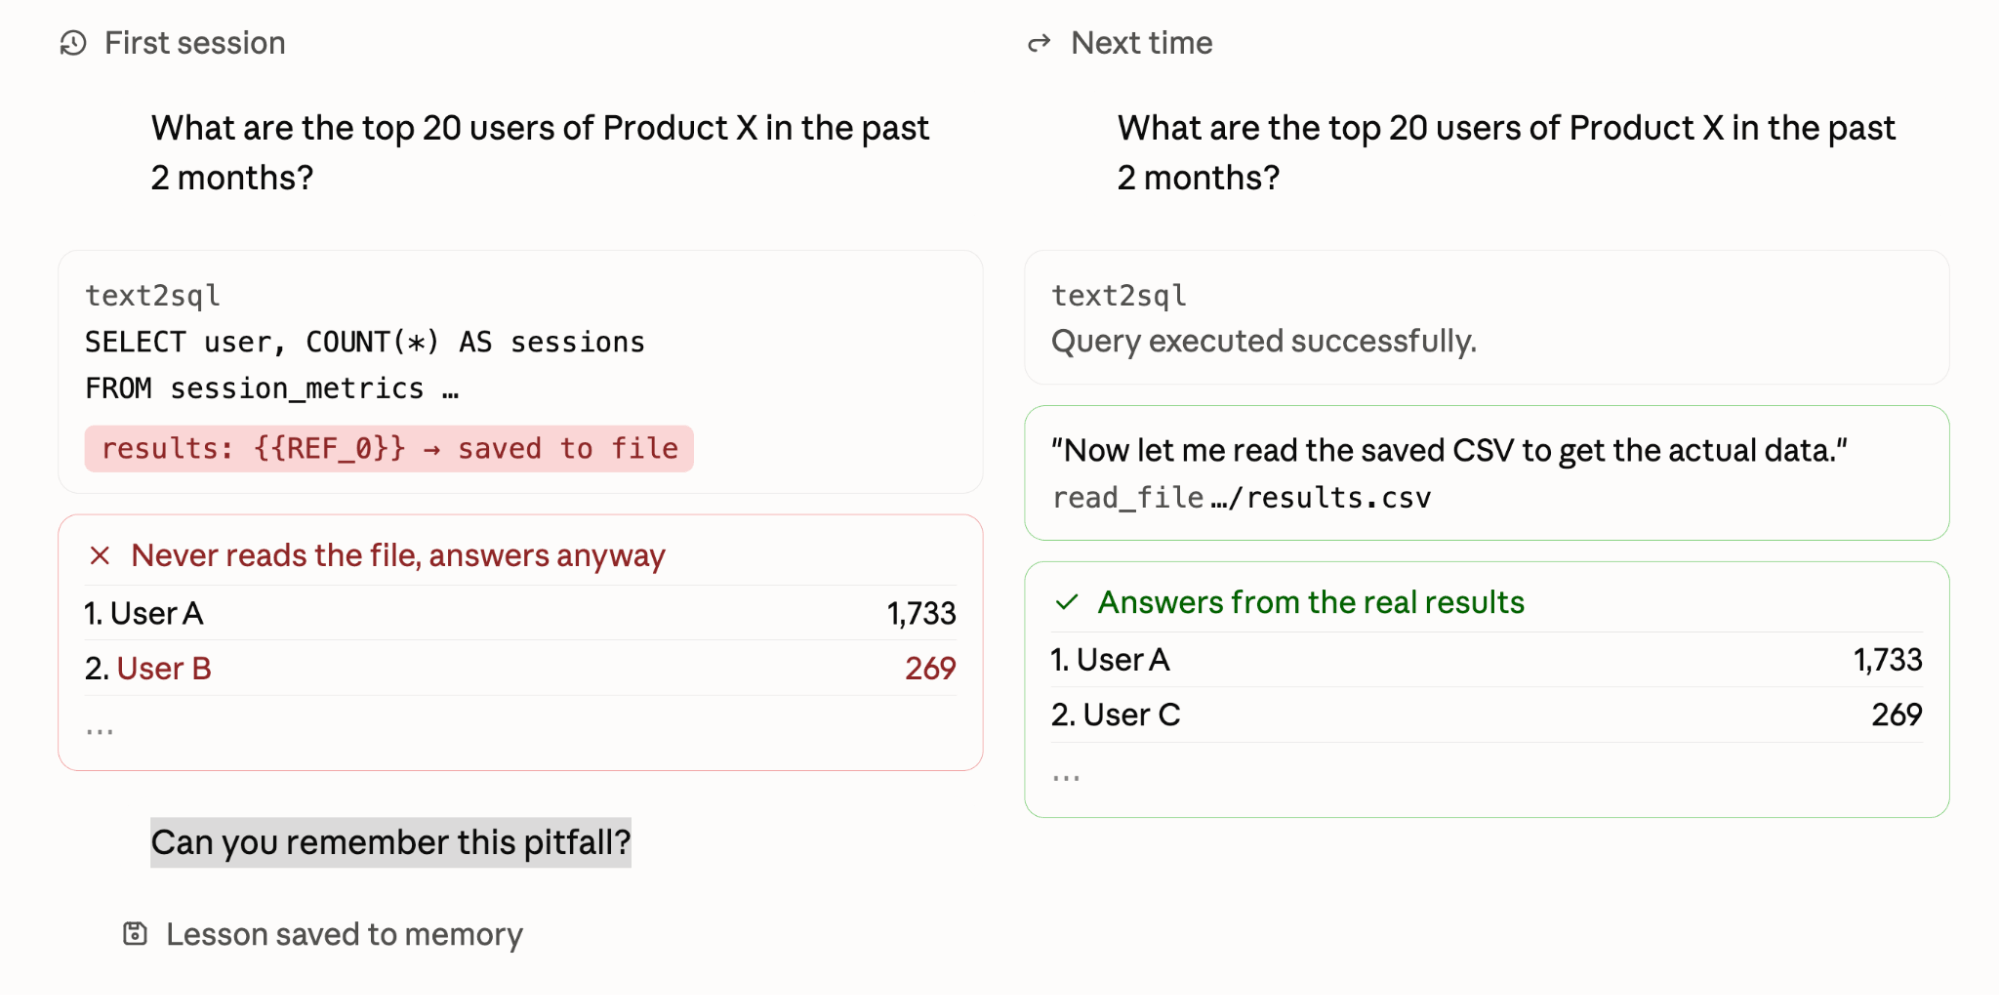
그림 7. 메모리가 에이전트의 반복적인 할루시네이션 오류를 방지하는 데 어떻게 도움이 되는지 보여주는 익명화된 예시.
예시 2: 관련 작업에 대한 계산 리소스 절약. 그림 8에서 사용자가 "상위 5개 SDP 고객"을 요청했습니다. 에이전트는 "SDP"가 무엇을 의미하는지, 어떤 테이블에 사용량 데이터가 있는지, 그리고 이를 어떻게 조인하고 필터링해야 하는지 처음부터 파악해야 했습니다. 이 과정에서 11번의 툴 호출, 8개의 서브에이전트, 그리고 거의 6분의 시간이 소요되었습니다. 에이전트는 이 단계를 메모리에 워크플로 파일로 저장하여 관련 작업에서 재사용할 수 있도록 했습니다. 나중에 사용자는 지난달에 파이프라인 실행 횟수가 5천 회를 넘은 SDP 고객이 몇 명인지 다른 질문을 던졌습니다. 에이전트는 저장된 워크플로를 활용해 2번의 툴 호출과 1개의 서브에이전트만으로 41초 만에 답변했습니다. 질문은 새로웠지만 답변에 이르는 경로는 그렇지 않았으며, 메모리 덕분에 에이전트가 불필요한 탐색 과정을 건너뛸 수 있었습니다.
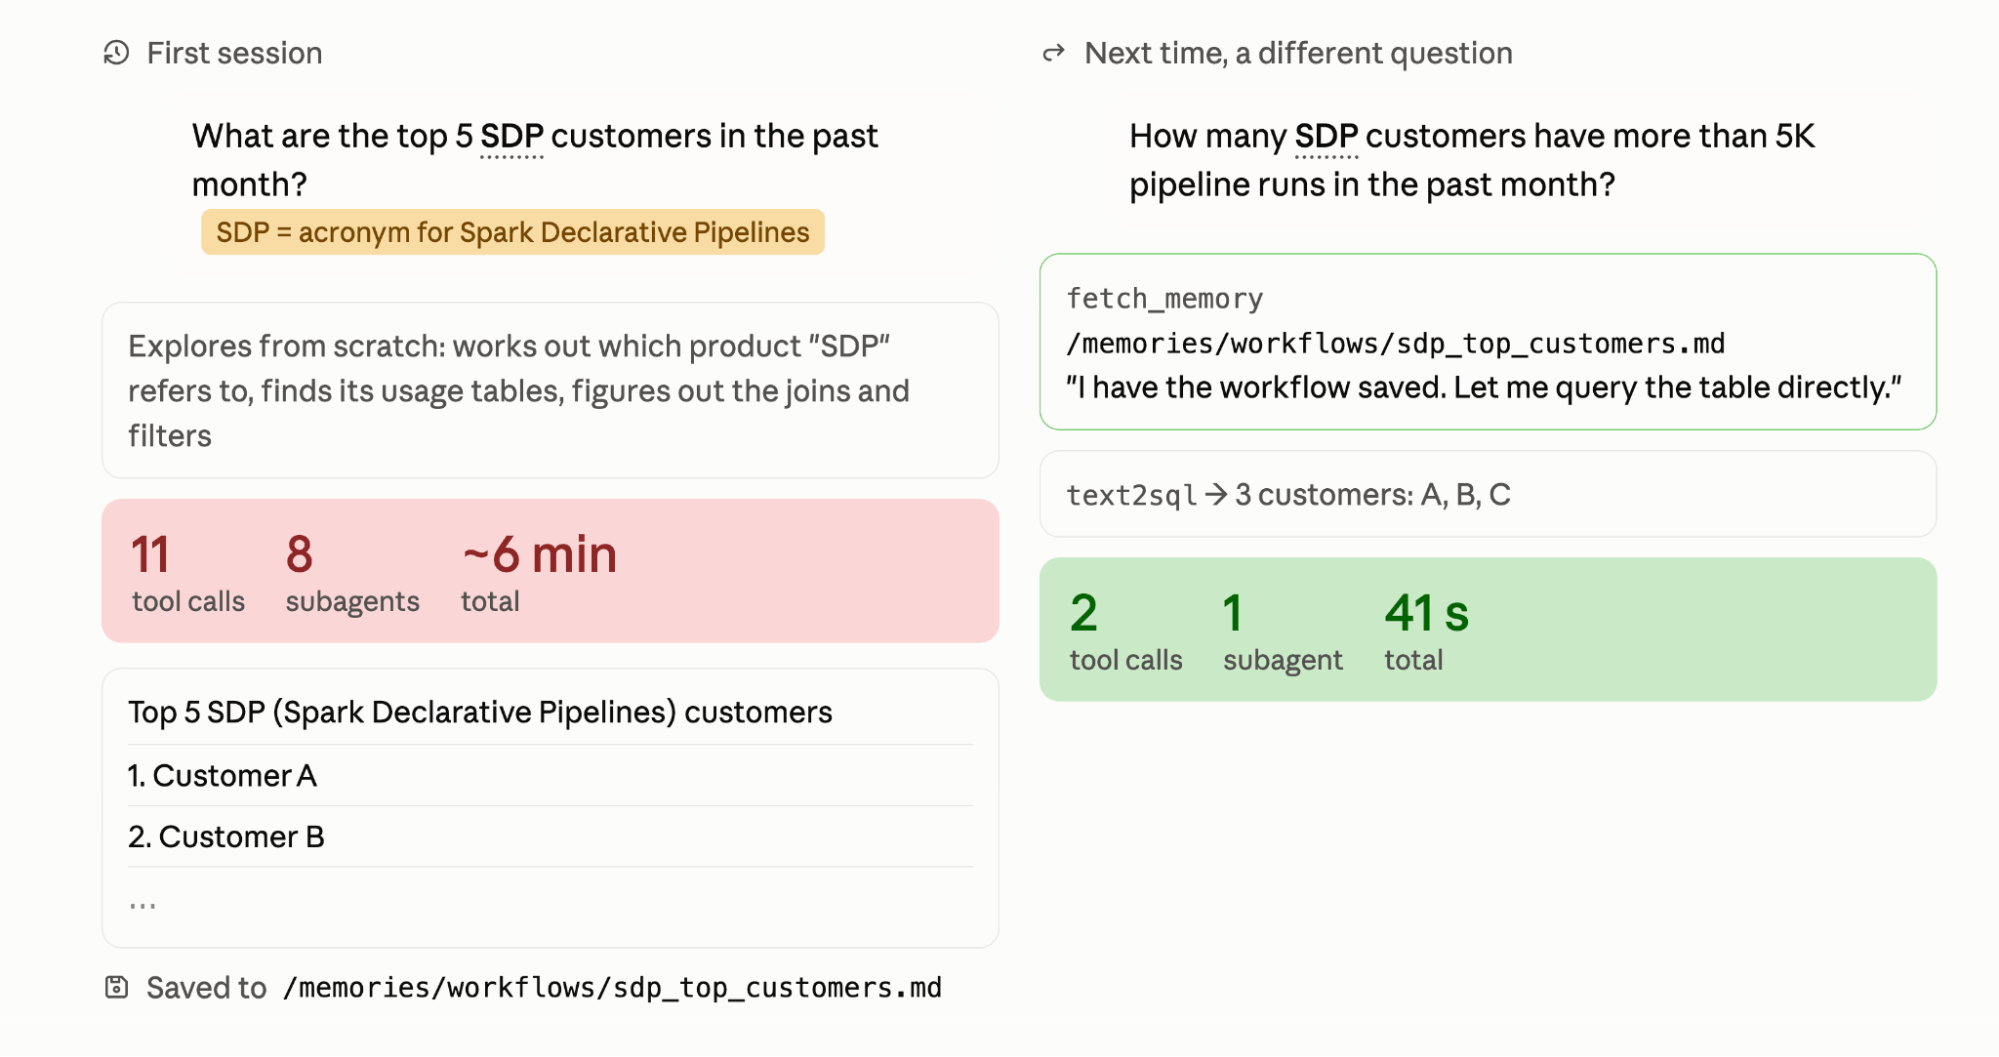
그림 8. 메모리를 통해 6분이 걸리던 작업을 41초로 단축한 익명화된 예시.
MemCurrent의 우수한 성과 요인
MemCurrent의 뛰어난 성능 요인을 이해하기 위해, 메모리 유형과 추출 전략이라는 두 가지 설계 선택 사항에 대해 자체 메모리 벤치마크에서 어블레이션(ablation) 연구를 진행했습니다.
두 메모리 유형이 모두 필요한가요? 에피소드 메모리(Episodic memory)만으로도 어느 정도 도움이 됩니다(메모리가 없을 때 22.3%에서 35.8%로 상승). 원본 기록도 유용하지만, 에이전트는 테스트 케이스의 약 3분의 1에서만 이를 검색했습니다(검색했을 때의 통과율은 60%). 파생 메모리(Derived memory)는 이러한 문제를 방지합니다. 세션 시작 시 주입된 메모리 인덱스가 메모리에서 사용할 수 있는 정보와 검색 시점에 대한 정보를 제공하여 통과율을 66.1%로 끌어올립니다. 여기에 에피소드 메모리를 추가하면 가장 높은 성과인 68.4%를 달성합니다. 상승폭은 작지만, 원본 트레이스가 증류(distillation) 과정에서 누락된 세부 정보를 복원할 수 있음을 보여줍니다.
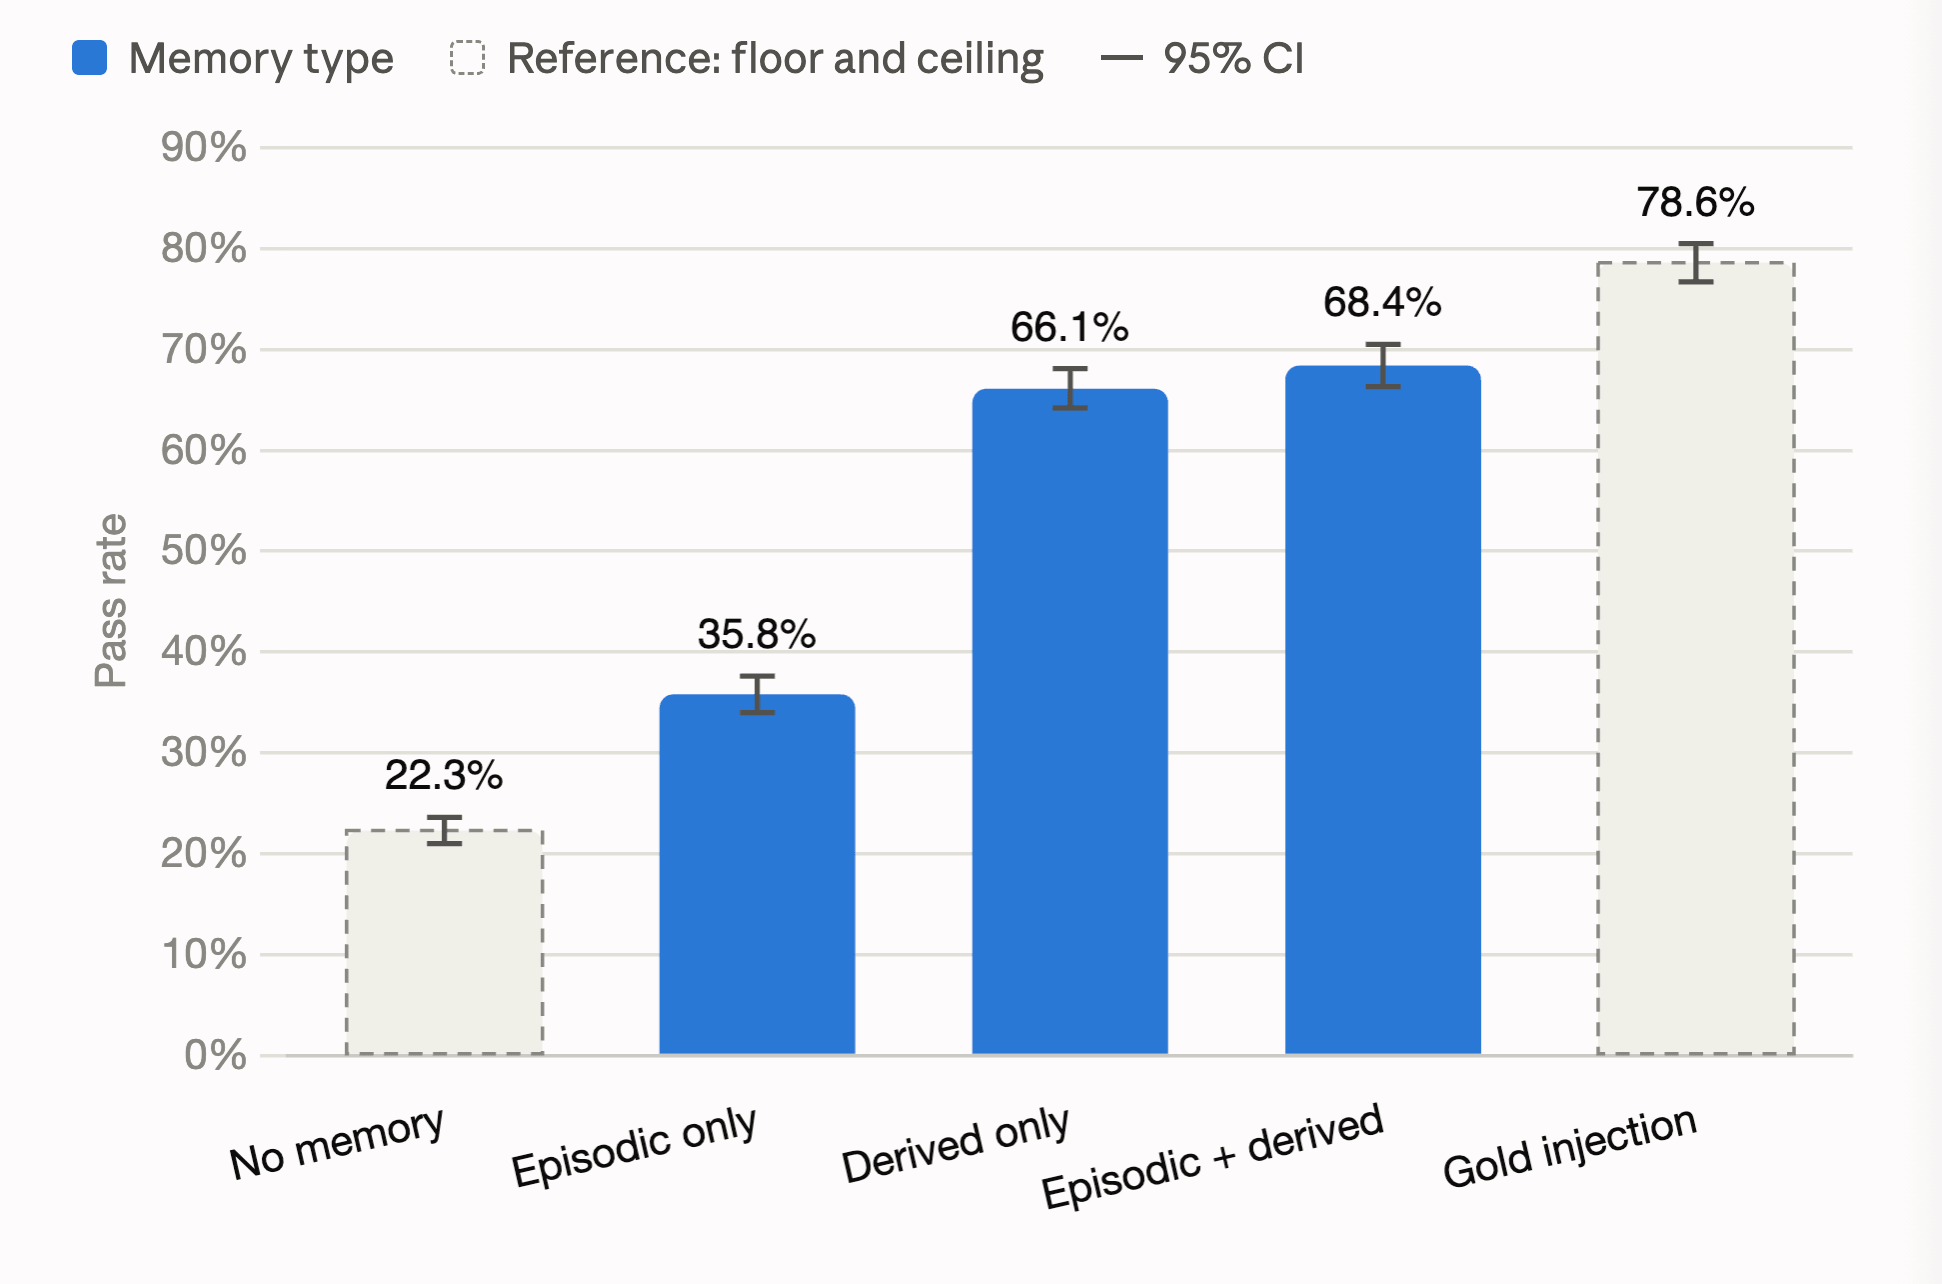
그림 9. 메모리 유형별 통과율.
바람직한 메모리 추출 전략은 무엇인가요? 그림 2에 나타난 바와 같이, 파생 메모리는 온라인 툴과 오프라인 드림(offline dreaming)이라는 두 가지 채널을 통해 추출됩니다. 단독으로 테스트했을 때 오프라인 드림(63.5%)이 온라인 툴(53.9%)보다 거의 10%포인트 더 높은 성과를 보였습니다. 둘을 조합하면 66.1%로 가장 높은 통과율을 기록합니다. 이는 역할 분담 구조를 뒷받침합니다. 드림 기능은 백그라운드 추출 및 통합을 처리하고, 온라인 툴은 명시적인 요청을 즉시 반영합니다.
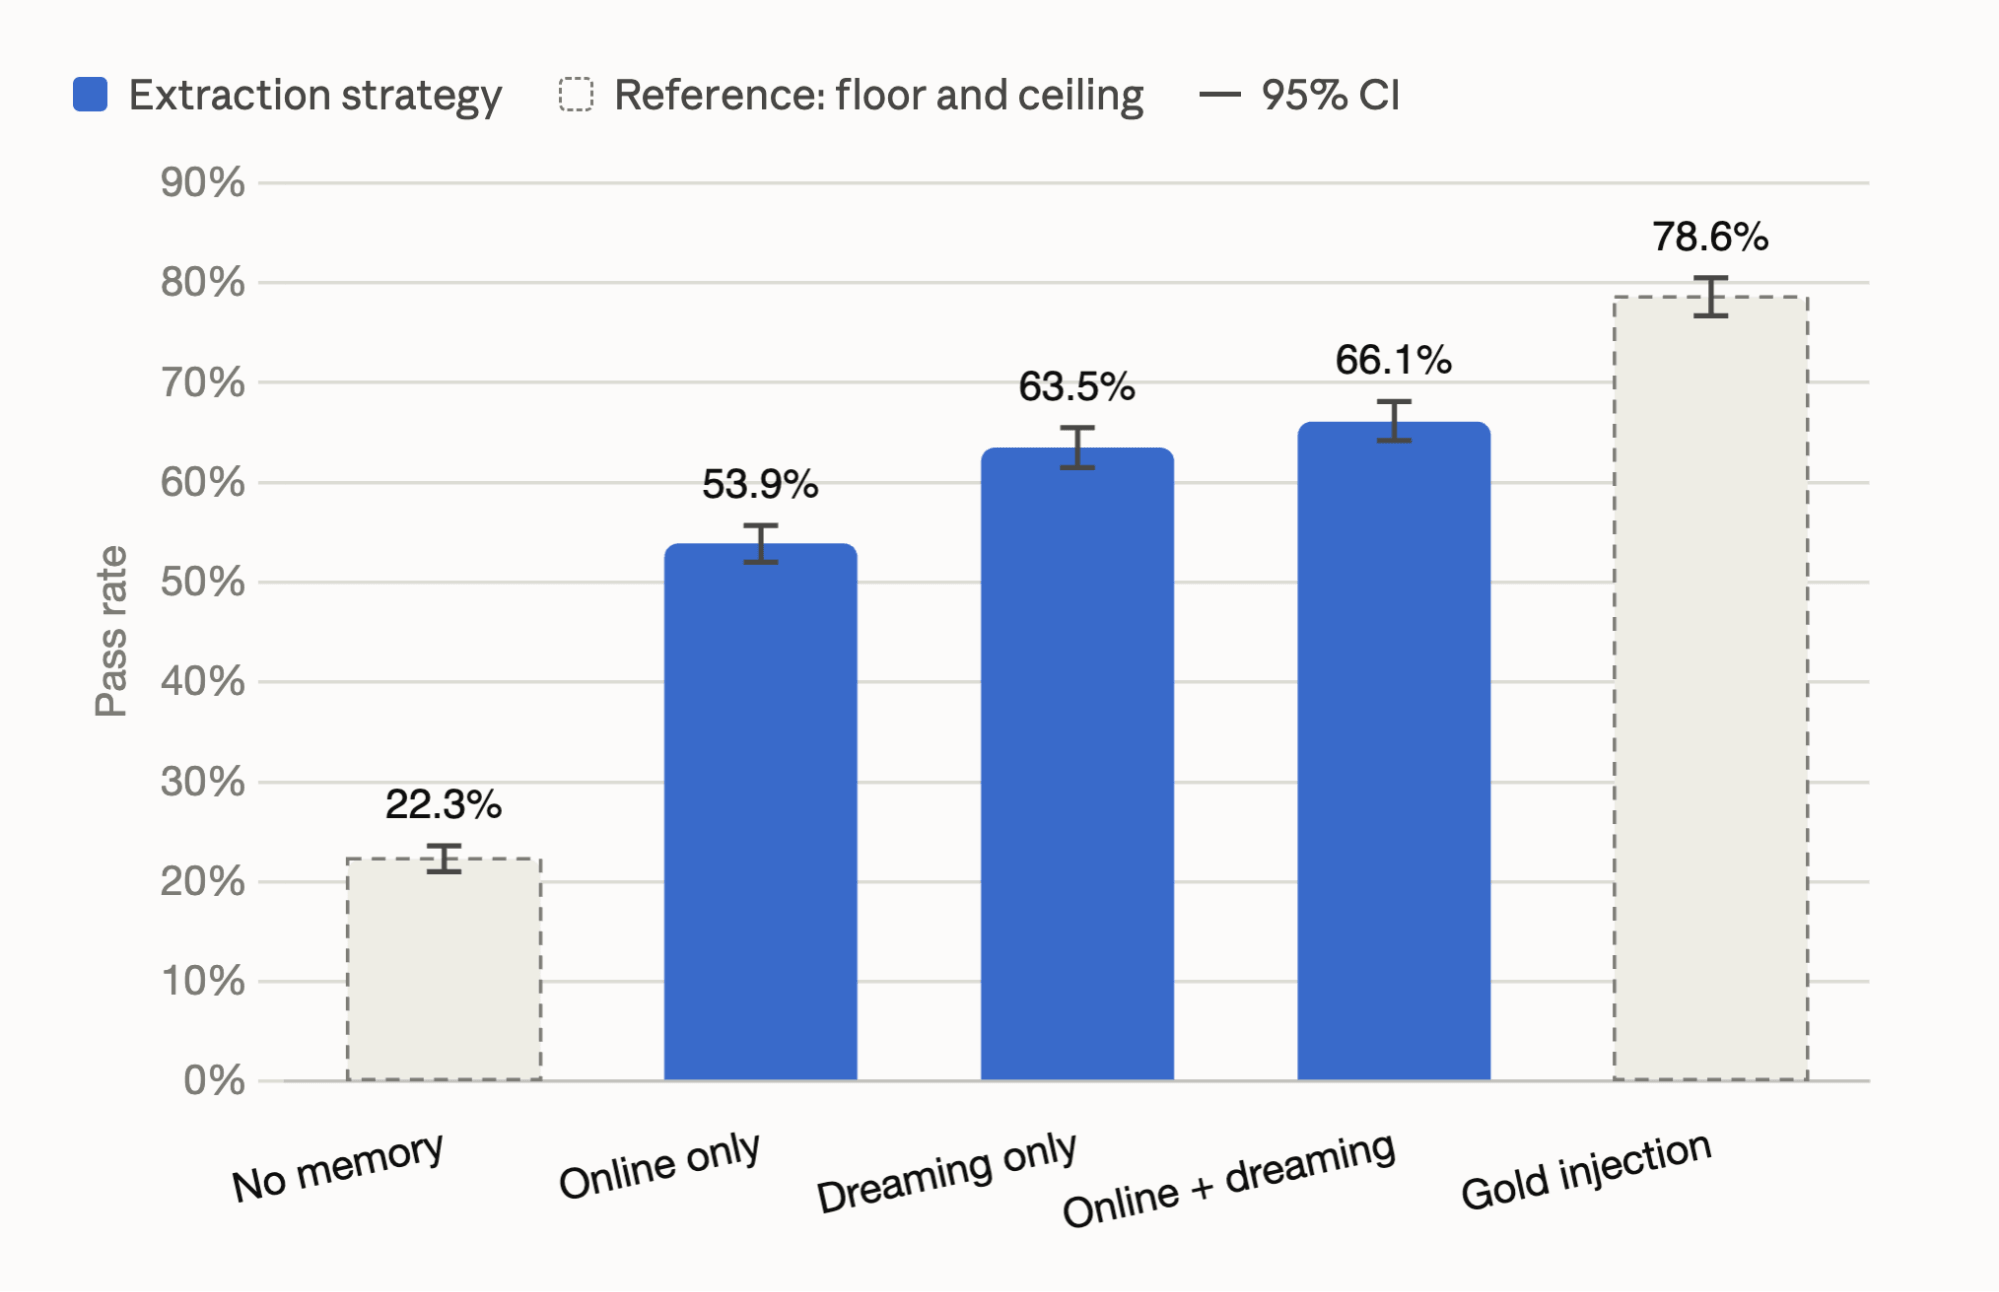
그림 10. 추출 전략별 통과율.
결론
메모리는 에이전트가 매번 처음부터 다시 시작하지 않도록 해주는 핵심 요소입니다. 이번 게시물에서는 에피소드 메모리와 파생 메모리를 결합한 프로덕션 에이전트용 메모리 아키텍처인 MemCurrent를 소개했습니다. MemCurrent는 컨텍스트를 자동으로 기록하고 로드하는 플러그인, 에이전트가 필요할 때 호출하는 툴, 백그라운드에서 메모리를 통합하는 오프라인 드림 파이프라인의 세 가지 접근 패턴을 제공합니다.
우리가 실행한 모든 벤치마크에서 MemCurrent는 품질과 효율성을 동시에 향상시켰으며, 이는 우리가 극복하고자 했던 트레이드오프 관계였습니다. 오픈소스 벤치마크에서 약 12배 적은 입력 토큰으로 전체 컨텍스트 성능과 맞먹는 결과를 보였습니다. 실제 데이터 작업을 기반으로 구축된 자체 메모리 벤치마크에서는 메모리가 없는 경우보다 에이전트의 통과율을 3배로 높이는 동시에 속도도 향상시키고 비용도 절감했습니다.
어블레이션 연구는 가치가 어디에서 발생하는지 보여줍니다. 파생 메모리가 대부분의 역할을 수행하며, 에피소드 메모리는 증류 과정에서 누락된 세부 정보를 복원하여 소폭의 추가적인 성능 향상을 제공합니다. 온라인 툴과 오프라인 드림을 결합하는 것이 최선의 추출 전략입니다. 명시적인 요청은 즉시 적용되는 한편, 드림 기능은 암묵적 학습 내용을 증류하고 백그라운드에서 저장소를 통합합니다.
수치를 넘어 메모리는 단일 에이전트나 LLM에 종속되지 않는 지식 베이스를 제공합니다. 사용자가 새로운 에이전트나 LLM으로 이동하더라도 메모리를 함께 이관할 수 있으며, 조직 전체에서 공유되는 지식의 씨앗이 될 수 있습니다. 이는 우리가 다음에 탐구하고자 하는 방향입니다.
시작하기
이러한 연구 결과를 바탕으로 Databricks 제품 전반의 개선을 이끌어내고자 합니다.
에이전트 개발자용. Agent Bricks는 맞춤형 에이전트를 구축하기 위한 Databricks의 개발자 플랫폼입니다. MemCurrent는 Lakebase 기반의 Agent Bricks Memory 제품에 기본 탑재되어 있습니다. 제공되는 기능은 다음과 같습니다:
- 에피소드 메모리용 세션 스토어
- 파생 메모리용 메모리 스토어
- 자동 드리밍(dreaming) 파이프라인
- 메모리의 영향을 포함한 에이전트 품질 추적 및 평가
- 위의 모든 기능이 포함된 엔드 투 엔드 샘플 에이전트를 10분 미만 만에 시작할 수 있도록 돕는 CLI
지금 바로 맞춤형 에이전트 구축을 시작해 보세요.
Databricks Genie 사용자용. Genie는 Databricks 사용자가 자연어로 데이터와 대화할 수 있는 인터페이스입니다. MemCurrent는 이미 백그라운드에서 작동하여 응답 지연 시간과 비용을 줄이면서 답변 품질을 향상시키는 데 기여하고 있습니다.
Genie 사용을 시작해 보세요.
저자: Veronica Lyu, Wenhao Zhan, Sam Havens, Ziyi Yang, Jenny Sun, Qinxin Wang, Nihit Desai, Sirui Sun, Ankit Mathur, Jane Zhang, Yi Liu, Jialu Liu, Michael Bendersky, Matei Zaharia, Xing Chen
이 프로젝트 전반에 걸쳐 피드백과 지원을 아끼지 않은 Jonathan Li, Rishabh Singh, Andy Zhang, Kenneth Choi, Will Tipton, Cassie Cao, Siddharth Murching, Sue Ann Hong, Pranav Sukumar, Neo Ni, Shanshan Zheng, Chung Wu, 그리고 내부 사용자 연구 참여자분들께 감사드립니다.
1 대부분의 질문은 단일 홉 내에서 답변 가능하므로 지연 시간은 모든 메모리 백엔드에서 비슷합니다(질문당 4~7초).
2 기존 벤치마크에는 플러그인 기반 메모리로도 충분하다는 점을 확인했습니다. 도구를 추가한 결과는 엄격히 열위(strictly dominated)하여 생략되었습니다.
(이 글은 AI의 도움을 받아 번역되었습니다. 원문이 궁금하시다면 여기를 클릭해 주세요)
최신 게시물을 이메일로 받아보세요
블로그를 구독하고 최신 게시물을 이메일로 받아보세요.