NEAREST BY 조인: Databricks Runtime에서 벡터 검색 확장하기
Photon의 심층 커널 최적화와 오픈 스토리지 포맷의 벡터 인덱스를 통해, 벡터 검색을 Databricks에 기본 제공되는 SQL 조인으로 구현한 방법을 알아보세요.
작성자: Zero Qu, Alexis Schlomer, Akash Nayar, Yingyi Bu , 세르게이 차레프
- NEAREST BY는 배치 벡터 검색을 위한 새로운 SQL 조인입니다. 모든 쿼리 행에 대해 벡터 유사도 또는 거리(정확한 방식 또는 근사 방식)를 기준으로 가장 가까운 k개의 행을 찾습니다.
- 커스텀 블록화된 GEMM 커널이 포함된 융합형 Photon 연산자는 거리 스코어링 성능을 하드웨어가 제공하는 최대 연산 처리량까지 끌어올립니다.
- 별도의 동기화나 운영 시스템 없이 레이크하우스를 벡터 저장소로도 사용할 수 있습니다. IVF 벡터 인덱스는 읽기 시 대부분의 파티션을 정리(프루닝)하는 일반적인 리퀴드 클러스터링(liquid-clustered) Delta 테이블입니다.
벡터 검색은 원래 서빙(serving) 문제에서 시작되었습니다. 가장 전형적인 사용 사례는 챗봇이나 검색창입니다. 하나의 쿼리 임베딩이 입력되면, 시스템은 수십 밀리초 내에 상위 k개의 가장 유사한 문서를 반환하도록 최적화되어 있습니다.
하지만 저희 플랫폼에서 처리되는 벡터 검색 워크로드의 상당 부분은 본질적으로 배치(batch) 중심입니다. 즉, 요청 시점에 검색하는 대신 오프라인에서 정확한 또는 근사치 최근접 이웃(nearest neighbors)을 미리 계산해 둡니다. 예를 들어, 한 결제 회사는 엔티티 분석(entity resolution)을 위해 매일 1억 건 이상의 거래를 1억 4천만 개의 가맹점 임베딩과 매칭하고, 한 데이터 기업은 매일 밤 수천만 건의 과거 기록을 보강(enrich)하며, 한 퀀트 펀드는 분류 체계 태깅(taxonomy tagging)을 위해 5천만 개의 벡터 코퍼스를 대상으로 수백만 개의 쿼리 배치를 실행합니다.
엔티티 분석, 중복 제거, 시맨틱 태깅, 분류, 레코드 보강, 배치 추천 등은 근본적으로 배치 워크로드입니다. 이는 정해진 일정에 따라 수백만에서 수십억 개의 벡터를 대상으로 수백만 개의 쿼리를 실행하는 작업으로, 단일 조회 지연 시간(latency)보다는 합리적인 비용으로 SLA 내에 작업이 완료되는지 여부로 성공을 평가합니다. 이러한 워크로드는 더 나은 성능, 안정성, 비용 효율성을 위해 완전히 다른 아키텍처가 필요합니다. 그래서 저희는 기본 원칙(first principles)으로 돌아가 고민했습니다.
요구사항
- 요청당 지연 시간보다 전체 처리량(throughput) 우선. 성공의 기준은 전체 배치 작업이 합리적인 비용으로 SLA 내에 완료되는 것이므로, 설계 시 모든 단계에서 요청당 지연 시간을 양보하더라도 처리량을 극대화해야 합니다.
- 조인(join)의 양쪽 모두에서 확장 가능. 수십억 개의 기준 벡터에 대해 최대 수억 개의 쿼리 벡터를 지원해야 합니다. 시스템은 쿼리와 기준 카디널리티(cardinality)의 모든 형태를 처리할 수 있어야 합니다.
- 탄력적 병렬 처리. 배치 처리량은 수평적 확장(horizontal scale)에서 나옵니다. 작업이 수백에서 수천 개의 코어로 깔끔하게 분할되어야 하며, 컴퓨팅 자원은 작업 크기에 맞게 자동으로 조정되어야 합니다. 즉, 실행 중에는 스케일 아웃하고 완료 후에는 0으로 스케일 다운해야 합니다.
- 코어당 최대 연산 성능. 거리 계산(distance scoring)은 연산 비용이 많이 듭니다. 스케일 아웃은 단일 코어가 달성한 성과를 배가시킬 뿐이므로, 내부 루프는 기본 하드웨어의 연산 대역폭(FLOPs/s) 및 메모리 대역폭(bytes/s)이 허용하는 이론적 한계치에 가깝게 실행되어야 합니다.
- 결함 허용(Fault tolerance). 몇 시간 동안 실행되는 작업은 워커(worker) 손실, 일시적인 태스크 실패, 디스크 스필(spill to disk)을 통한 메모리 압박 속에서도 중단 없이 유지되어야 합니다. 이는 실행 엔진의 고유한 특성이며, 실시간 서빙 엔드포인트에 단순히 덧씌울 수 있는 기능이 아닙니다.
Databricks Runtime은 이러한 요구사항에 완벽히 부합합니다. 이는 Spark와 벡터화된 네이티브 C++ 쿼리 엔진인 Photon을 기반으로 구축된 분산형, 결함 허용형, 탄력적 실행 엔진입니다. 이것이 바로 저희가 별도의 인프라에 의존하는 대신 벡터 검색을 엔진 네이티브 기능으로 직접 구축하기로 결정한 이유입니다.
아키텍처
저희의 첫 번째 버전 VECTOR_SEARCH SQL 함수는 외부 실시간 Vector Search 엔드포인트로 요청을 연계(federate)하도록 설계되었습니다. 이 함수는 한 번에 하나의 쿼리 행을 스트리밍하는 Generate 노드로 구현되었습니다. 모든 행마다 네트워크 요청, 응답 역직렬화(deserialize), 그리고 잠재적인 재시도가 발생했습니다. 작동은 했지만 성능 한계가 드러났습니다. 처리량이 런타임 클러스터 크기가 아닌 실시간 엔드포인트 크기에 의해 제한되었고, 런타임 엔진은 단순한 디스패처 역할로 전락했습니다. 또한 쿼리의 실제 형태를 제대로 활용하지 못했습니다. 배치 벡터 검색은 수백만 개의 작은 검색이 아닙니다. 이는 하나의 거대한 쿼리입니다. 즉, 왼쪽의 각 행에 대해 오른쪽에서 가장 가까운 k개의 행을 찾는 '상위 k 랭킹 조인(top-k ranking join)'입니다. 거대한 조인을 실행하는 것은 바로 런타임 엔진이 가장 잘하는 일입니다.
런타임 엔진에서 벡터 검색을 네이티브로 구현하면 두 가지 측면에서 이점이 있습니다.
- 단일 데이터 사본. 임베딩이 Lakehouse의 Delta tables에 그대로 유지되므로, 별도의 벡터 저장소도, 일관성을 유지하기 위한 동기화 파이프라인도, 운영 및 비용을 지불해야 하는 두 번째 시스템도 필요하지 않습니다.
- 단일 실행 엔진. 검색이 워크로드에 따라 탄력적으로 확장되는 단일 엔진에서 실행되며, 배치 쿼리 형태에 맞게 특별히 제작된 커널을 사용합니다. 이를 통해 각 코어의 성능을 최대 FLOPs까지 끌어올리고, 나머지는 스케일 아웃을 통해 배가시킵니다. 엔진이 이미 결함 허용(fault tolerance)을 자체적으로 처리하므로, 태스크가 자동으로 재시도되고 메모리 압박 시 디스크로 스필됩니다. 클라이언트 측의 동시성 제어, 속도 제한(rate limiting) 또는 재시도 루프가 필요 없습니다.
그 결과 의도적으로 간결하면서도 깊이 있는 스택이 탄생했습니다. 먼저, 상위 k 랭킹 조인을 일급 관계형 연산(first-class relational operation)으로 만드는 새로운 조인 구문인 NEAREST BY가 도입되었습니다. 그리고 이를 세 가지 기본 연산(primitives)인 SIMD 가속 거리 함수와 제한된 상위 k 집계(bounded top-k aggregate)로 변환하는 쿼리 재작성(rewrite) 과정이 있습니다. 또한 실행 계획의 중간 전체를 맞춤형 GEMM 커널로 대체하는 융합된(fused) Photon 연산자가 포함됩니다. 마지막으로 일반적인 liquid-clustered Delta table로 구축되는 선택적 IVF 인덱스를 통해, APPROX 쿼리가 동일한 커널로 기준 벡터의 일부만 점수를 계산할 수 있도록 합니다.
구문: 상위 k 랭킹 조인
기존 엔진들은 두 가지 인터페이스 형태로 수렴되었습니다. pgvector를 사용하는 Postgres와 Snowflake는 거리 연산자를 ORDER BY … LIMIT와 결합합니다. 이 경우 배치는 구동 행(driving row)당 LATERAL 서브쿼리가 필요하며, 옵티마이저는 KNN과 ANN 쿼리를 구분하여 인식할 수 있는 패턴이 부족합니다. 이러한 인식 방식은 취약하기도 합니다. 예상되는 쿼리 형태에서 조금만 벗어나도 빠른 경로(fast path)가 아무런 경고 없이 사라져 버립니다. BigQuery는 테이블 반환 함수(table-valued function)를 제공하여 배치를 일급 객체로 처리하지만, 열 참조가 문자열이어서 파서가 이를 검증할 수 없습니다.
구조적으로 배치 벡터 검색은 이항 관계형 연산(binary relational operation)입니다. 즉, 두 개의 테이블 입력, 이 둘을 결합한 출력, 그리고 왼쪽 행당 상위 k개를 연결하는 구조입니다. 이 구문은 해당 구조를 네이티브 상위 k 랭킹 조인으로 인코딩합니다.
이 조인은 LATERAL과 유사하게 비대칭적입니다. 즉, 왼쪽이 구동하고 오른쪽이 검색됩니다. 랭킹 방향은 명시적입니다. BY SIMILARITY는 내림차순, BY DISTANCE는 오름차순입니다. LEFT OUTER는 후보가 없는 쿼리 행을 유지하며, BY 표현식은 플러그형(pluggable)입니다. 양쪽 모두에서 정렬 가능한 모든 스칼라가 작동하므로, 나중에 다른 점수 계산 표현식에서 동일한 절을 재사용할 수 있습니다.
APPROX와 EXACT는 의미론적 계약(semantic contract)을 인코딩합니다. EXACT는 전수 평가(exhaustive evaluation)를 통해 실제 상위 k개를 보장하며, APPROX는 옵티마이저가 적용 가능한 경우 ANN 인덱스와 같은 근사 전략을 대체하여 사용할 수 있도록 허용합니다. 따라서 인덱스를 생성하거나 삭제해도 쿼리 결과가 무단으로 변경되지 않으며, APPROX를 명시한 쿼리만 근사치 적용에 동의하게 됩니다.
쿼리 재작성(Query rewrite)
NEAREST BY는 논리적 조인 노드로 파싱되며, 옵티마이저는 이를 표준 관계형 연산자로 변환합니다. 즉, 재작성 과정에서 각 쿼리 행에 생성된 ID를 태깅하고, 모든 (쿼리, 기준) 쌍의 점수를 계산한 다음, 그룹화된 상위 k개를 통해 ID당 가장 우수한 k개를 유지하고, 유지된 행을 다시 인라인화합니다.
의미론적으로 이는 교차 조인(cross join), 스칼라 점수 계산 표현식, 그룹화된 상위 k 집계 등 기능 전체를 캡슐화합니다. 모든 연산자가 일반적인 관계형 연산자이기 때문에 실행 계획은 다른 계획과 마찬가지로 분산, 스필, 재시도를 수행합니다. 즉, 정확성과 결함 허용성이 기본으로 제공됩니다. 재작성이 실제로 격리하는 것은 모든 실행 시간이 거쳐 가는 두 가지 기본 연산(primitives)입니다. 바로 쌍의 점수를 계산하는 거리 함수와 각 그룹의 가장 우수한 k개를 유지하는 집계입니다.
저희는 이 계획의 모든 연산자를 Photon에 네이티브로 구현했으며, 여기에 벡터 검색을 위해 특별히 제작된 융합된(fused) 연산자 하나를 추가하여 실행 계획의 중간 섹션 전체를 더 성능이 뛰어나고 배치 친화적인 커널로 완전히 축소했습니다.
Photon 커널
벡터 함수
핵심 빌딩 블록은 ARRAY<FLOAT> 열에 대한 일련의 벡터 SQL 함수들입니다. 그중 세 가지 함수가 유사도 및 거리 계산을 담당합니다.
| SQL 함수 | 계산 대상 | 가까움의 의미 |
|---|---|---|
| vector_inner_product(a, b) | 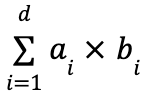 | 더 높음 (BY SIMILARITY) |
| vector_cosine_similarity(a, b) | 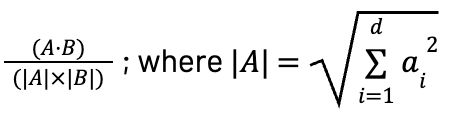 | 높을수록 좋음 (유사도 기준) |
| vector_l2_distance(a, b) | 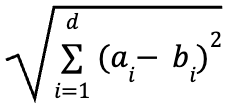 | 낮을수록 좋음 (거리 기준) |
유사도 및 거리 함수와 더불어, 두 가지 노름(norm) 헬퍼 함수인 vector_norm 및 vector_normalize와 두 가지 집계 함수인 vector_sum 및 vector_avg를 함께 출시했습니다. 이 함수들은 쿼리 및 인덱스 빌드를 모두 지원합니다. 거리 함수는 쿼리 점수를 계산하고 행을 가장 가까운 센트로이드(centroid)에 할당하는 반면, 집계 및 정규화 함수는 k-means 실행 중에 해당 센트로이드를 다시 계산합니다.
Photon은 이 모든 함수를 네이티브 SIMD 커널로 실행합니다. 모든 메트릭의 핵심은 곱셈-누산(multiply-adds)이며, 단일 FMA(fused multiply-add) 명령어가 실행될 때마다 전체 벡터 레지스터에서 𝑎 · 𝑏 + 𝑐를 계산합니다. 이 커널들은 네 가지 신중한 설계 선택을 기반으로 구현되었습니다.
- 설계 자체로 보장되는 이식성. 동일한 커널이 지원되는 모든 클라우드(AWS, Azure, GCP) 및 모든 CPU 아키텍처(x86, ARM)에서 실행되어야 합니다. 플랫폼마다 SIMD 너비와 명령어 세트가 다르기 때문에, 각 커널은 여러 ISA 전용 클론으로 컴파일되며, 런타임에 CPU가 지원하는 최적의 클론이 선택됩니다(최신 Intel 코어의 경우 AVX-512, Graviton의 경우 SVE2).
- 제로 카피(Zero-copy) 입력. ARRAY<FLOAT>는 행 내에서 연속적이므로, 각 벡터는 복사 없이 그리고 핫 루프(hot loop) 내부의 요소별 인덱싱 없이 열의 백킹 버퍼를 가리키는 원시 포인터로 읽힙니다.
- 완화된 부동 소수점 의미론(Relaxed float semantics). 엄격한 IEEE 순서 지정을 생략하면 컴파일러가 곱셈-누산을 FMA 명령어로 병합하고 리덕션(reduction)을 병렬 누산기 체인으로 분할할 수 있으므로, 루프가 하나의 누적 합계에 직렬화되지 않습니다.
- 루프 내 스칼라 연산 배제. 핫 루프는 순수한 벡터화된 곱셈-누산 리덕션이며, sqrt 및 나눗셈과 같은 스칼라 작업은 루프 외부에서 단 한 번만 수행됩니다.
top-k 집계
일반 SQL에서 그룹화된 top-k는 윈도우 함수입니다. ROW_NUMBER() OVER (PARTITION BY query ORDER BY score). 이는 모든 파티션을 전체적으로 정렬한 다음, 상위 k개의 순위를 제외한 나머지를 모두 버립니다. 대신 저희는 기존 max_by / min_by 집계 함수를 세 번째 K 매개변수 오버로드로 확장했습니다. 이 구현은 네 가지 핵심 속성을 중심으로 구축되었습니다.
- 단일 비교 선택. 그룹당 집계 상태는 루트가 제거 후보이자 수락 임계값인 제한된 힙(bounded heap)입니다. 힙이 가득 차면 각 후보는 단 한 번의 비교를 통해 수락되거나 거부됩니다. 후보 스트림에 대해 정렬이 수행되지 않습니다.
- O(k) 상태. 그룹당 메모리는 입력 크기와 무관합니다. 10억 개의 행에 대해 점수를 매기는 쿼리도 단 k개의 행 상태만 유지하며, k는 최대 100,000까지 지정할 수 있습니다.
- 지연 구체화(Late materialization). 힙은 완전히 구체화된 복사본이 아니라 인덱스를 저장합니다. 후보는 활성 컬럼형 배치(columnar batch)를 가리키는 포인터로 유지되며, 배치가 재활용될 때까지 여전히 살아남은 경우에만 집계 상태로 복사됩니다.
- 분산 가능성. 집계 함수는 부분/병합(partial/merge) 계약을 가집니다. 각 파티션은 로컬 top-k를 내보내고, 셔플은 원시 쌍 대신 이러한 k-요소 배열을 이동시키며, 병합 시 이를 다시 삽입합니다. 전역 top-k는 항상 부분 집합들의 합집합의 하위 집합이므로 결과는 정확합니다.
루프라인 모델
위의 모든 네이티브 커널을 사용하면 쿼리 계획이 완전히 Photon화되지만, 배치 규모에서는 여전히 최적과는 거리가 멉니다. 그 이유는 구현상의 문제가 아니라 이론적인 문제에 있으며, 루프라인 모델(roofline model)은 이를 시각화하는 간단하고 효과적인 방법입니다.
𝑃𝑎𝑡𝑡𝑎𝑖𝑛𝑎𝑏𝑙𝑒 = 𝑚𝑖𝑛(𝑃𝑝𝑒𝑎𝑘, 𝐴𝐼 × 𝐵𝑊)
𝑃𝑝𝑒𝑎𝑘는 하드웨어의 최대 연산 처리량(FLOPs/s)이고, BW는 메모리 대역폭(bytes/s)이며, 𝐴𝐼는 커널의 산술 강도(arithmetic intensity, 이동된 바이트당 수행된 FLOPs)입니다. 𝐴𝐼에 대한 𝑃𝑎𝑡𝑡𝑎𝑖𝑛𝑎𝑏𝑙𝑒를 그래프로 그리면 루프라인을 얻을 수 있습니다. 즉, 대각선 모양의 메모리 한계선과 가로 모양의 연산 한계선이 릿지 포인트(커널이 연산 제한(compute-bound) 상태가 될 수 있는 최소 𝐴𝐼)에서 만납니다. 릿지 포인트의 왼쪽에서는 FLOP당 이동하는 바이트 수를 줄이는 것만이 도움이 되며, 오른쪽에서는 커널이 연산 제한 상태가 되어 연산 장치 자체가 한계가 됩니다. 구체적으로, 기준 m6i.2xlarge 머신(예시용이며 상수는 하드웨어에 따라 달라짐)의 경우는 다음과 같습니다.
| 코어당 | |
|---|---|
| 최대 연산 처리량 | 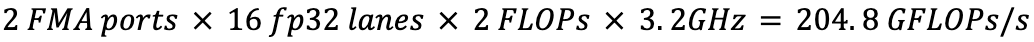 |
| DRAM 대역폭 한계 | 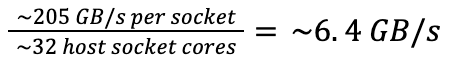 |
| 릿지 포인트 | 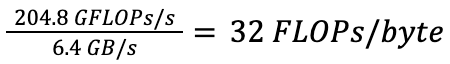 |
*L1/L2 캐시 한계는 DRAM 공정 분배량보다 30~60배 높지만, 기본 테이블이 캐시보다 훨씬 크기 때문에 모든 기본 바이트는 최소 한 번은 DRAM 경계를 넘게 됩니다.
*최대 연산 처리량은 코어 수에 따라 선형적으로 확장됩니다. 64개의 m6i.2xlarge 실행기(각각 4개의 물리적 코어)로 구성된 클러스터는 fp32 FMA 기준 최대 64 x 4 x 204.8 GFLOP/s ≈ 52.5 TFLOP/s에 도달합니다.
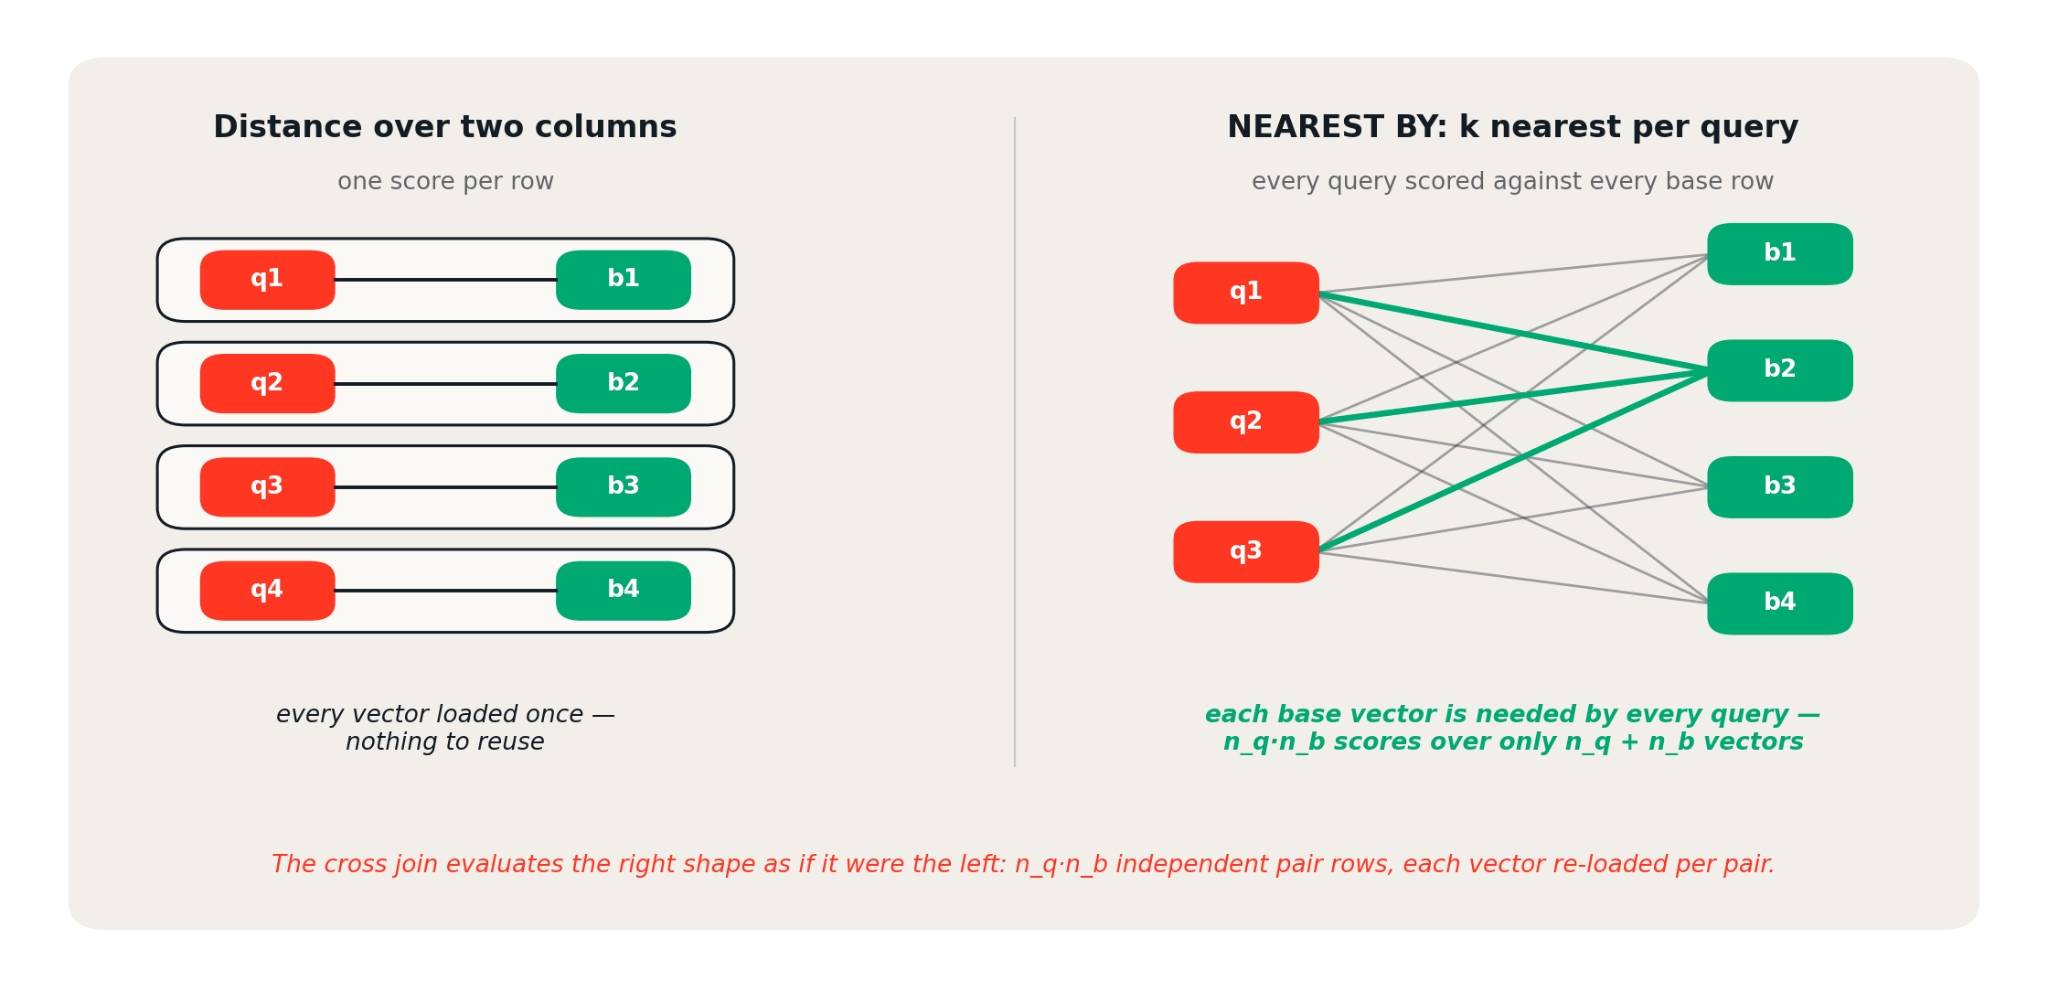
정렬된 두 열의 점수를 매기면 행당 하나의 점수가 생성됩니다. 즉, 모든 벡터가 한 번만 사용되며 재사용이 존재하지 않습니다. 각 기본 벡터는 모든 쿼리에 필요하므로, NEAREST BY 형태는 단 𝑛𝑞 + 𝑛𝑏개의 고유 벡터로부터 𝑛𝑞 × 𝑛𝑏개의 점수를 생성합니다.
이제 단순(naive) 계획과 재사용을 고려한 계획에서 벡터 검색이 이동시키는 데이터 크기를 비교해 보겠습니다. 두 계획 모두에서 FLOPs는 동일합니다: 2 × 𝑑 × 𝑛𝑞 × 𝑛𝑏 (여기서 𝑛𝑞 및 𝑛𝑏는 쿼리 및 기본 측 카디널리티이고, 𝑑는 임베딩 차원입니다).
| 계획 | 이동된 바이트 수 | 산술 강도 (AI) | 스케일링 |
|---|---|---|---|
| 쌍별 크로스 조인(Pairwise cross join) — 모든 피연산자가 새로 로드되어 단 한 번만 사용됨 | 2 × 4 × 𝑑 × 𝑛𝑞 × 𝑛𝑏 | 1/4 | 0(1) |
| 융합된 GEMM(Fused GEMM) — 버퍼링 후 단 한 번 스트리밍됨 | 4 × 𝑑 × 𝑛𝑏 | 𝑛𝑞/2 | 0(𝑛𝑞) |
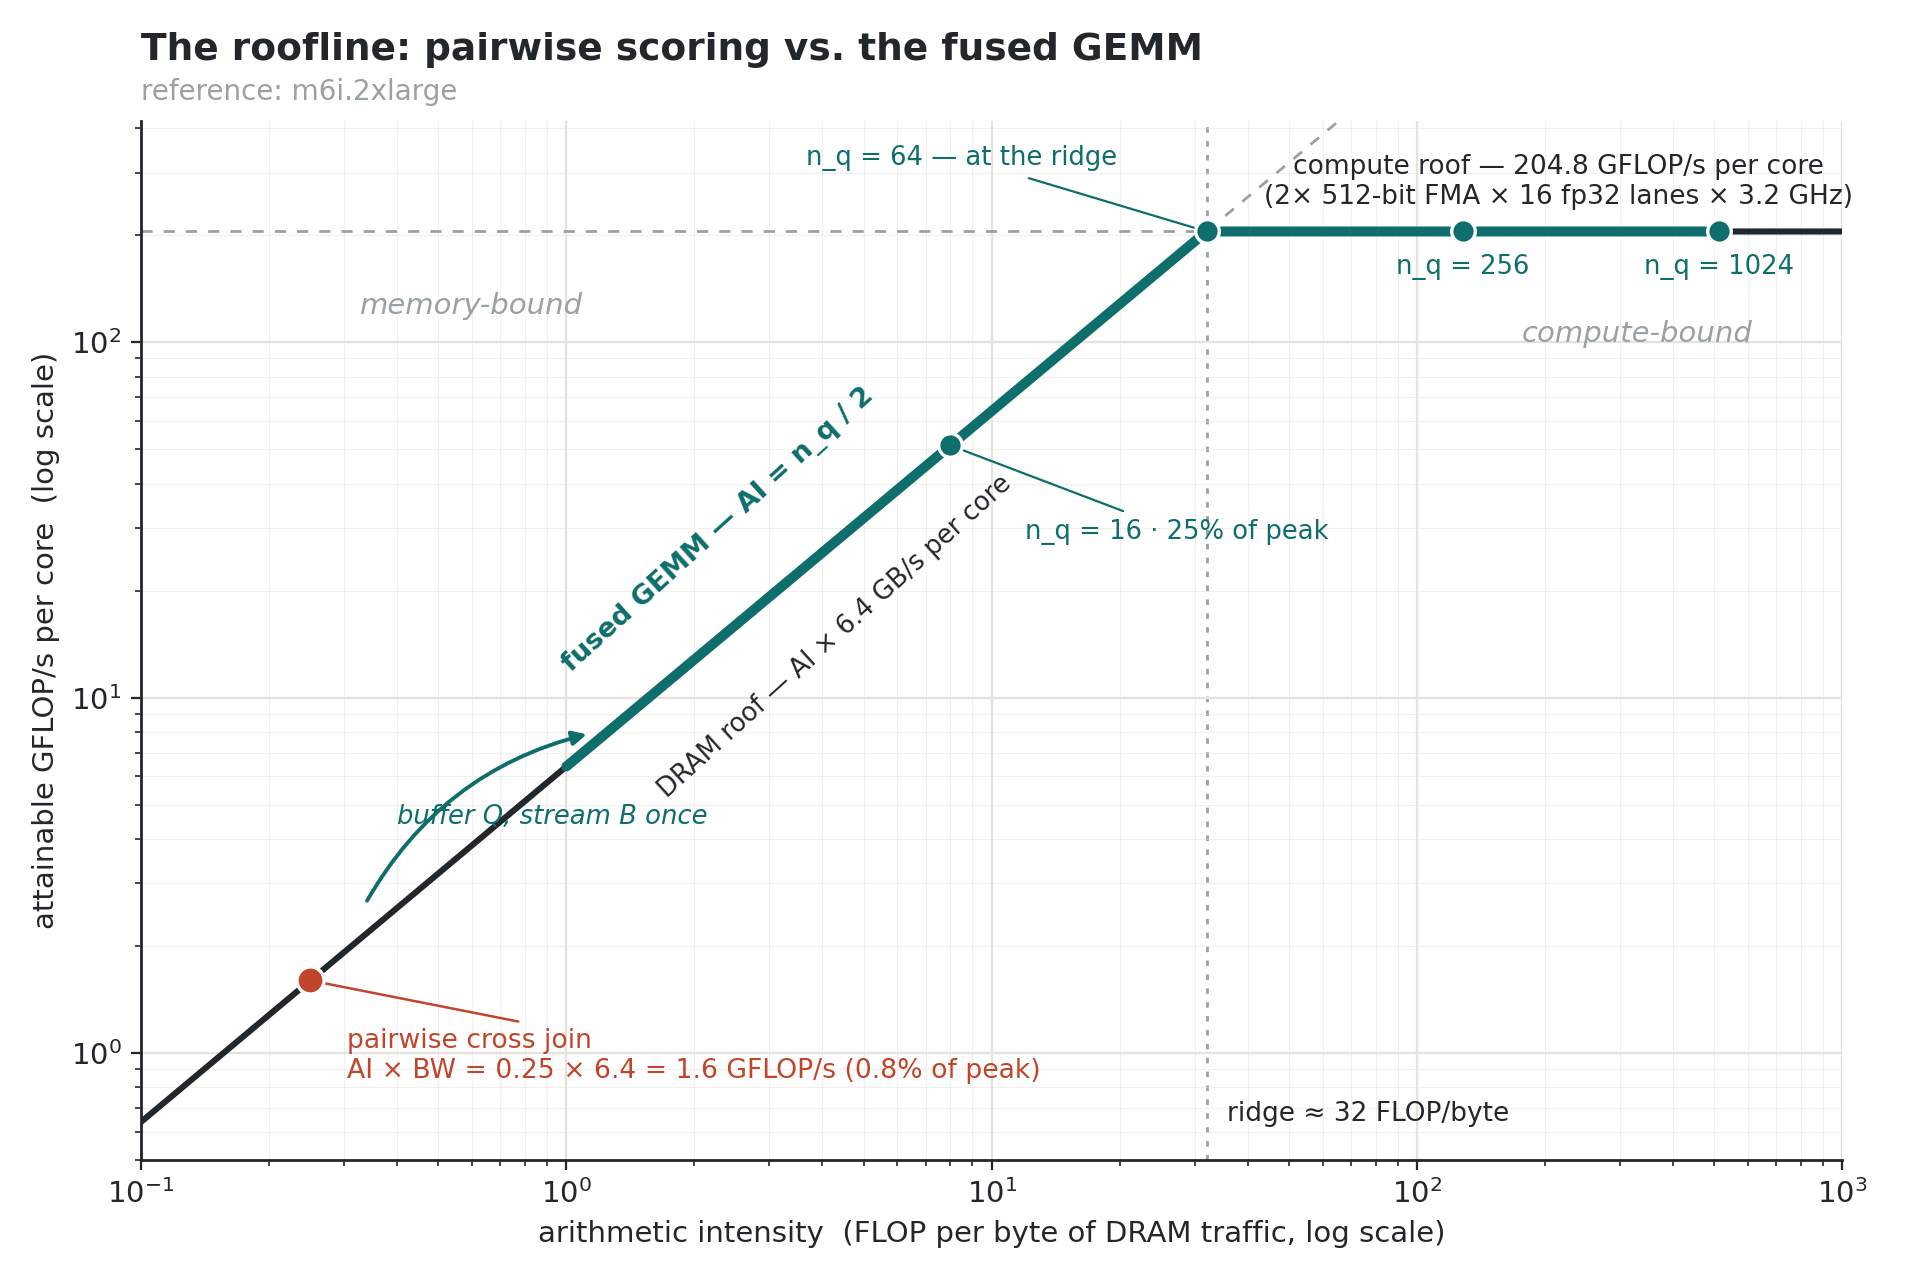
쌍별 점수 계산은 최대 성능의 0.8% 수준에서 DRAM 기울기에 고정되는 반면, 융합된 GEMM 커널의 산술 강도는 배치 크기에 따라 증가합니다(𝐴𝐼 = 𝑛𝑞/2). 이 덕분에 𝑛𝑞 = 64에서 릿지 포인트를 교차하고 더 큰 배치 크기에서는 연산 한계선에 도달할 수 있습니다. 벡터 거리 및 유사도 커널은 입력 형태에 대해 거의 최적에 가깝지만, 단순 계획 형태는 활용할 데이터 재사용이 없으며 배치 처리도 도움이 되지 않습니다. 쌍 폭발(pair explosion)로 인해 FLOPs와 바이트가 동일하게 곱해지기 때문입니다. 해결책은 융합된 연산자 계획(fused operator plan)을 사용하여 커널이 데이터 재사용을 활용하도록 하는 것이며, 산술 강도는 자연스럽게 이를 따르게 됩니다.
융합된 연산자 및 GEMM 커널
융합 연산자는 교차 조인(cross join), 거리/유사도 프로젝션, 그리고 선택적으로 부분 top-k를 대체하는 단일 Photon 실행 노드입니다. 이 노드는 더 작은 입력을 버퍼링하고, 다른 입력을 배치 단위로 스트리밍하며, 커스텀 GEMM 커널을 사용하여 쿼리별 베이스 타일(query-by-base tiles)의 점수를 계산하고, k가 충분히 작을 때 타일 전체에서 쿼리당 top-k 상태를 유지합니다. top-k가 융합되면 출력은 𝑛𝑞 × 𝑛𝑏 쌍이 아니라 최대 𝑛𝑞 × 𝑘개의 후보 행이 되며, 이는 다운스트림 max_by / min_by 병합 커널에서 사용됩니다. 태스크당 피크 메모리는 버퍼링된 측 + 처리 중인(in-flight) 배치 1개 + 0(𝑛𝑞 × 𝑘) 선택 상태입니다. 분산은 표준 조인 전략을 따릅니다. 즉, 크기가 작아 적합한 경우 작은 쪽을 브로드캐스트하고, 그렇지 않으면 양쪽을 파티셔닝하고 블록 데카르트(block-cartesian)를 실행합니다.
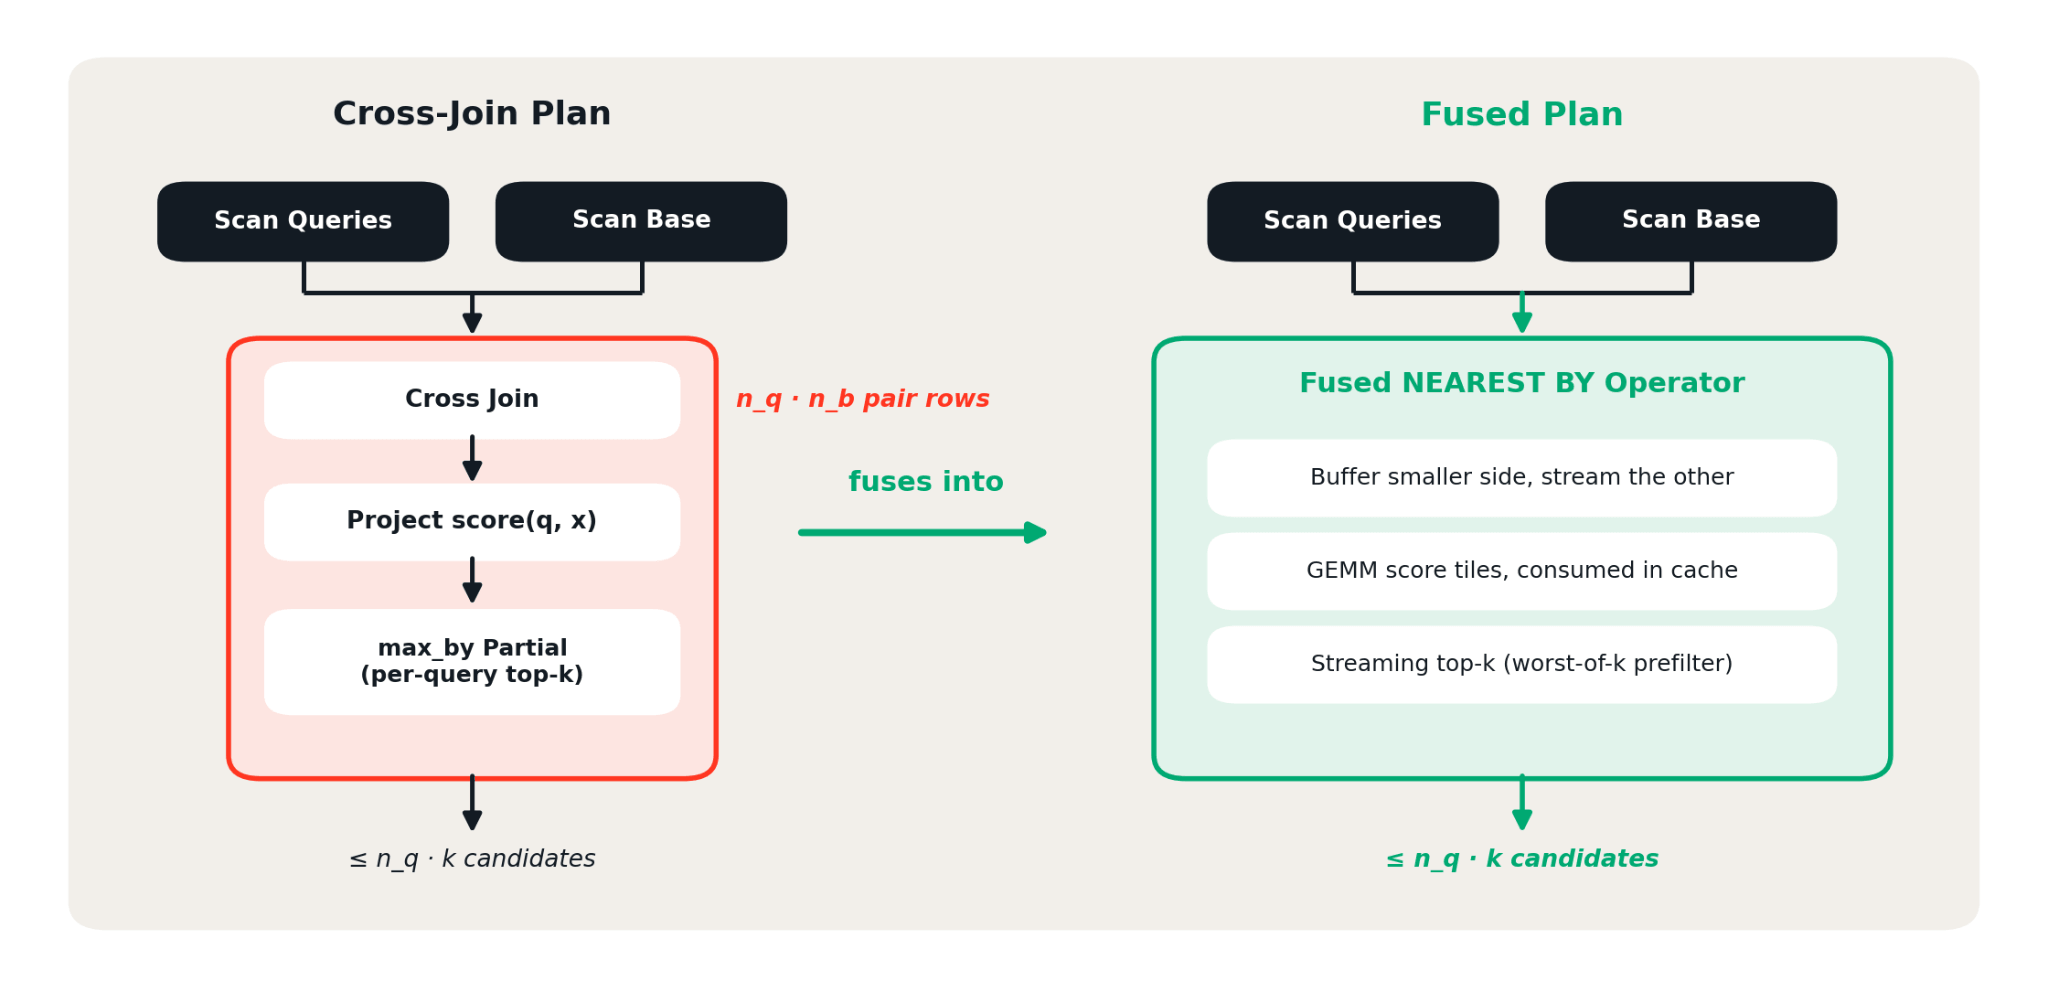
루프라인(roofline) 모델에서 볼 수 있듯이, 융합은 수행하는 FLOPs가 아니라 메모리에서 이동하는 바이트를 변경합니다. 각 베이스 벡터는 로드된 후 버퍼링된 모든 쿼리에 대해 점수가 계산되므로, 연산 강도(arithmetic intensity)는 배치에 따라 선형적으로 증가하며 𝑛𝑞 = 64에서 기준 릿지 포인트(reference ridge point)를 교차합니다. 이는 일반적인 프로덕션 워크로드의 배치 크기보다 훨씬 낮은 수준입니다. 베이스 측이 더 작을 때도 마찬가지로, 연산 강도는 메모리에 상주하는 측에 따라 확장됩니다.
릿지를 교차하는 것은 필요조건이지만 충분조건은 아닙니다. 𝑛𝑞/2 바이트 수는 아래의 블록화된 GEMM 커널의 직접적인 결과입니다. DRAM 루프를 통과하는 것은 병목 현상을 캐시 대역폭과 FMA 레이턴시로 낮출 뿐입니다.
구체적으로, 이 커널은 점수 행렬 𝐷 = 𝑄 · 𝐵𝑇에 대한 클래식 블록 GEMM입니다. 외부 루프는 한 번에 하나의 벡터 패널씩 베이스를 따라 진행하며, 쿼리 타일 전체에서 재사용할 수 있도록 각 패널을 차원 우선(dimension-major)으로 패킹합니다. 임베딩 차원 자체가 패널로 블록화되어 있기 때문에, 중간 루프는 다음 패널을 가져오기 전에 패킹된 패널에 대해 버퍼링된 모든 쿼리 타일을 스윕합니다. 가장 안쪽의 루프는 하나의 차원 패널에 걸쳐 레지스터에 작은 출력 타일을 누적합니다. 단일 패널보다 넓은 임베딩의 경우, 실행 중인 부분 결과는 점수 버퍼에 임시 저장되었다가 다음 패널을 계속하기 위해 다시 읽어옵니다. 완료된 각 타일은 스트리밍 top-k가 제자리에서 사용하는 제한되고 재활용되는 점수 버퍼에 기록되므로, 전체 𝑛𝑞 × 𝑛𝑏 점수 행렬이 DRAM에 기록되지 않습니다.
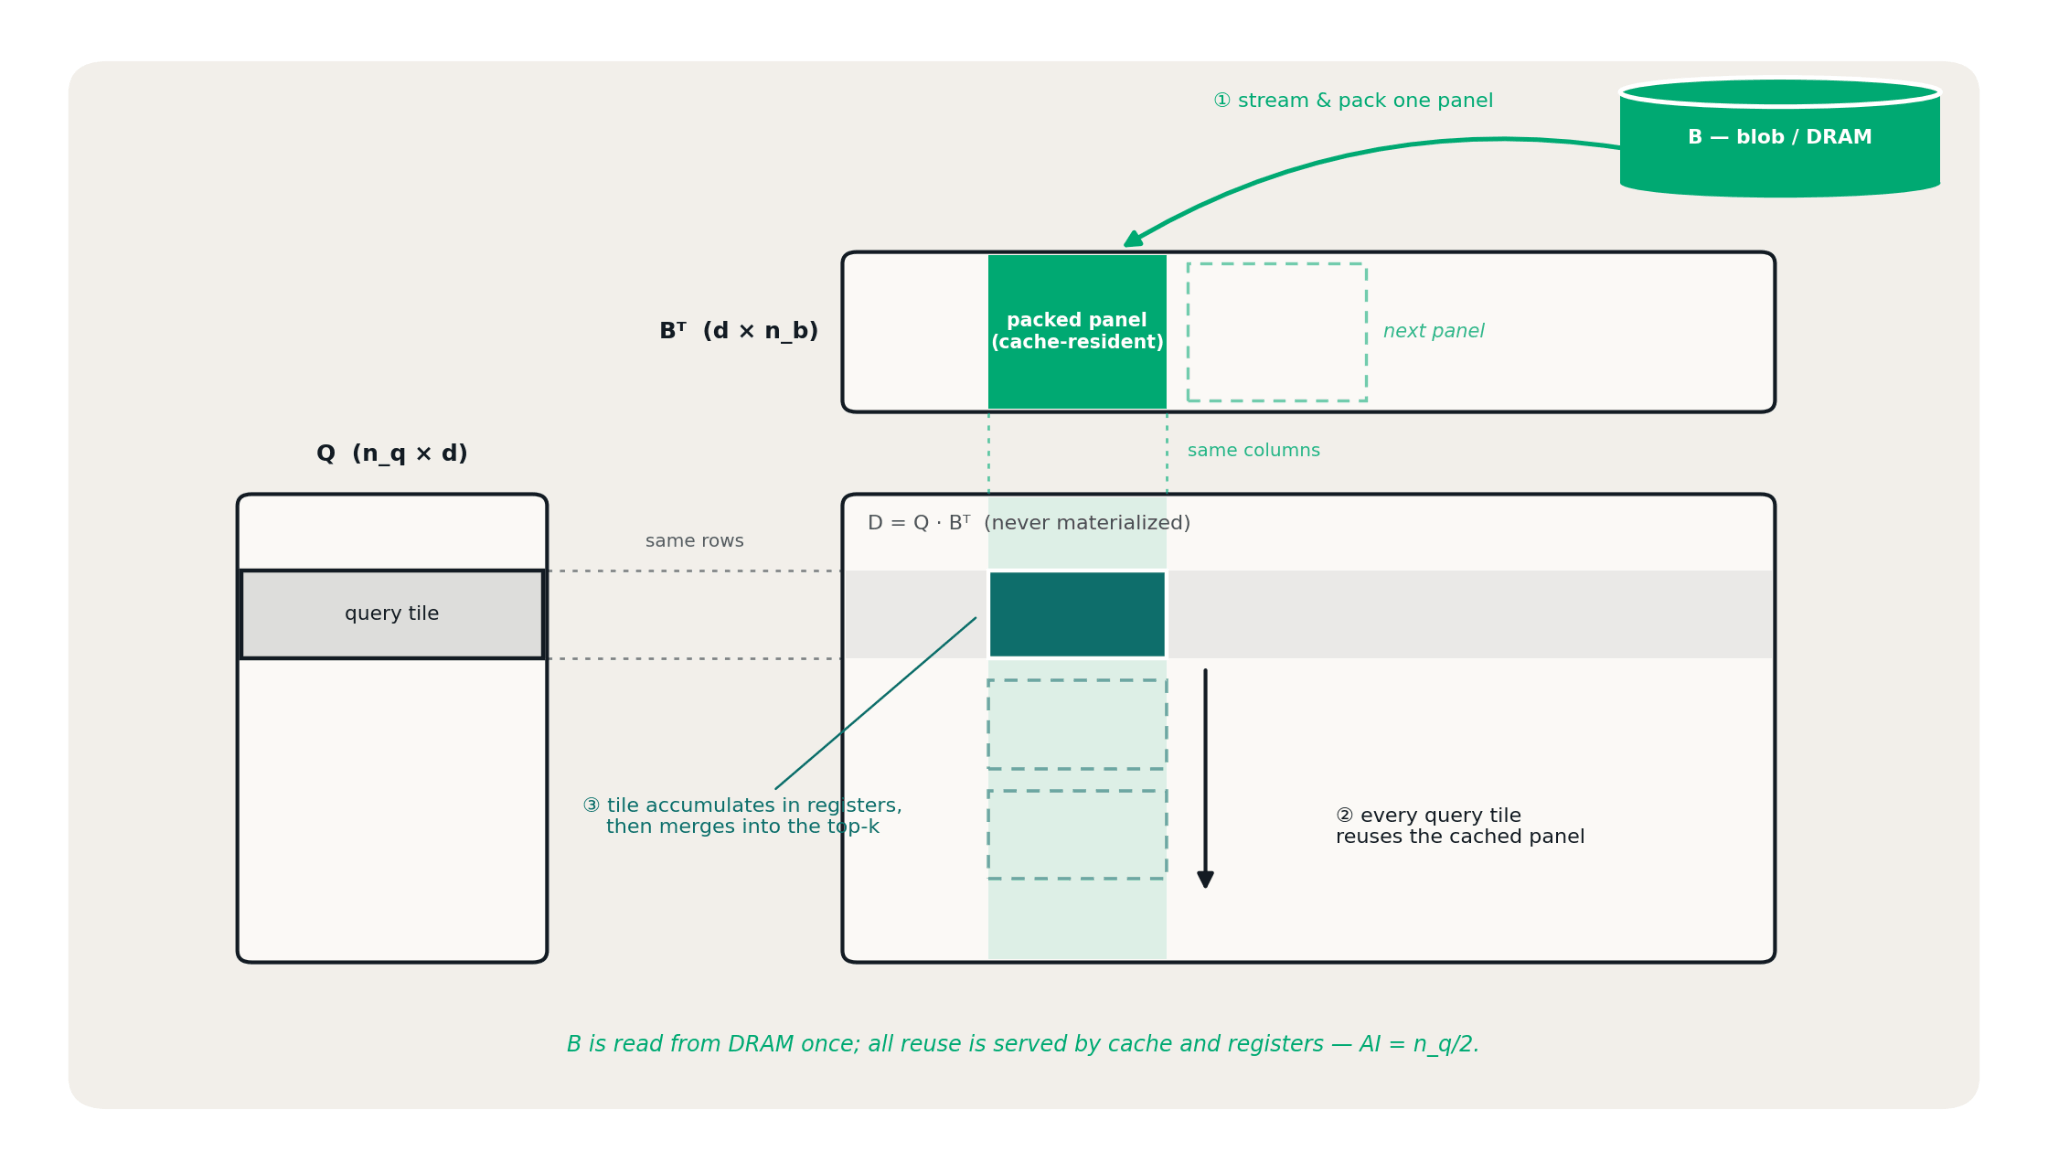
데이터 재사용을 개선하기 위해 두 가지 수준의 블록화가 적용됩니다. 패킹된 베이스 패널은 CPU 캐시 히트를 유도하기 위해 쿼리 타일 전체에서 재사용되는 반면, 레지스터 블록화는 로드된 각 값이 여러 FMA에 기여할 수 있도록 합니다. 각 타일 크기는 다음과 같은 두 가지 상반된 고려 사항의 균형을 맞춥니다.
- 패킹된 패널 크기: 패널은 캐시에 편안하게 들어갈 만큼 충분히 작아야 하지만, 부분 결과를 저장하고 다시 로드하는 오버헤드를 제한할 수 있을 만큼 충분히 커야 합니다. 임베딩 차원을 따르는 각 경계는 점수 버퍼를 통한 왕복이 필요합니다. 패널이 클수록 해당 트래픽은 줄어들지만 캐시 미스가 증가할 수 있습니다.
- 레지스터 타일 크기: 누적기(accumulator)와 피연산자(operand)는 사용 가능한 벡터 레지스터 내에 적합해야 하며, FMA 레이턴시를 오버랩할 수 있도록 충분한 독립적 누적을 제공해야 합니다. 타일이 클수록 데이터 재사용이 증가하고 더 많은 독립적인 작업이 노출되지만, 레지스터 압박과 메모리 스필(spill) 위험도 증가합니다.
대부분의 프로덕션 워크로드는 비교적 작은 k로 실행되므로, 이 경우에 맞게 스트리밍 top-k를 최적화했습니다. 쿼리당 선택 상태는 융합 연산자 내부에 유지되고, 각 점수 타일은 캐시에 있는 동안 선택 항목에 병합되며, 전체 𝑛𝑞 × 𝑛𝑏 행렬은 DRAM에 도달하지 않습니다. 쿼리가 k개의 엔트리를 보유하게 되면 가장 낮은 점수가 허용 임계값(admission threshold)이 되어, 병합 시 벡터화된 비교당 여러 점수를 거부할 수 있습니다. 살아남은 행만 출력으로 수집됩니다. 이 상태가 메모리 압박이 될 정도로 k가 충분히 크면, 연산자는 블록 GEMM만 실행하고 점수가 매겨진 타일을 기존 max_by / min_by 부분 결과로 전달합니다. 이 폴백(fallback) 상황에서 쌍당 하나의 𝑓𝑝32 점수를 내보내는 데는 2𝑑 𝐹𝐿𝑂𝑃𝑠 대비 4 𝑏𝑦𝑡𝑒𝑠의 비용이 들므로, 𝐴𝐼 = 𝑑/2가 되며, 이는 실제적인 차원에서 여전히 릿지를 훨씬 뛰어넘는 수준입니다.
벡터 인덱스
지금까지의 모든 내용은 완전 탐색 KNN(k-nearest-neighbor) 검색을 가속화합니다. 하지만 완전 탐색이 0(𝑛𝑞 × 𝑛𝑏)이라는 사실은 변하지 않습니다. 10억 개의 행에 대한 100만 개의 쿼리는 1015번의 내적(dot product)을 의미하며, 어떤 레지스터 타일도 지수를 상쇄할 수 없습니다. 이것이 바로 APPROX와 벡터 인덱스가 존재하는 이유입니다.
인덱스는 클래식한 IVF(inverted file) 디자인입니다. 인덱싱은 코퍼스 샘플에 대해 k-means를 학습시켜 센트로이드(centroid) 세트를 생성합니다. 모든 베이스 행은 가장 가까운 센트로이드에 할당되며, 쿼리 시 각 쿼리는 가장 가까운 클러스터의 벡터에 대해서만 점수를 계산합니다. 이러한 가지치기(pruning)는 𝑛𝑏와 결합됩니다. 수십억 개 규모에서 쿼리는 코퍼스의 ≤ 0.1%만 탐색하므로, 브루트 포스(brute force) 방식보다 거리 계산 작업이 몇 자릿수나 더 적습니다. 독립적인 클러스터 스캔이 실행기(executor) 전체에서 병렬화되고 레이아웃이 자연스럽게 열 지향(columnar) 스토리지에 배치되는 반면, 그래프 탐색은 직렬 조회의 체인이기 때문에 그래프 인덱스 대신 IVF를 선택했습니다.
물리적으로 인덱스는 일반 Delta Lake 테이블입니다. 할당 행은 센트로이드 ID 옆에 벡터를 전달하며, 테이블은 센트로이드 ID를 기준으로 리퀴드 클러스터링(liquid-clustered)됩니다. 각 클러스터의 후보는 블롭 스토리지에 연속적으로 배치되며, 쿼리가 탐색하지 않은 클러스터의 파일은 읽기 전에 가지치기됩니다. 새로 고침은 트랜잭션 방식이며 증분 방식(incremental)으로 수행됩니다.
APPROX 쿼리는 동일한 기본 프리미티브로 재작성됩니다. 즉, 동일한 top-k NEAREST BY 조인으로 센트로이드를 탐색하고, 센트로이드 ID에 대한 등가 조인(equi-join)을 수행하여 각 쿼리를 탐색된 클러스터로 제한한 다음, 점수 계산 및 top-k를 수행하고 병합합니다. 마지막 새로 고침 이후 추가된 파일은 보상 브랜치(compensation branch)에서 브루트 포스로 처리되고 동일한 병합으로 유니온(union)되므로, 오래된 인덱스는 가지치기를 덜 수행할 뿐 검색 품질을 저하시키지는 않습니다.
쿼리 실행은 쿼리 및 베이스 카디널리티(cardinality)에 의해 결정됩니다.
| 시나리오 | 조인 전략 | 주요 특징 |
|---|---|---|
| 작은 인덱스 테이블, 작은 쿼리 테이블 | BNLJ, 브로드캐스트 인덱스 | 모든 데이터가 메모리에 상주 |
| 작은 인덱스 테이블, 큰 쿼리 테이블 | BNLJ, 브로드캐스트 인덱스 | 쿼리는 파티셔닝된 상태를 유지하며 스트리밍되고, 인덱스는 모두에게 브로드캐스트됨 |
| 큰 인덱스 테이블, 작은 쿼리 테이블 | BNLJ, 브로드캐스트 쿼리 | 인덱스 파티션이 스트리밍되고, 탐색된 쿼리가 브로드캐스트됨 |
| 큰 인덱스 테이블, 큰 쿼리 테이블 | 센트로이드 ID 기준 등가 조인, 인덱스에 대한 인플레이스 셔플 적용 | 센트로이드 ID를 기준으로 탐색된 쿼리를 셔플하고, 인덱스의 리퀴드 클러스터링을 활용하여 인덱스의 전체 셔플을 방지함 |
대규모-대규모(large-large) 케이스는 리퀴드 클러스터링이 가장 큰 효과를 발휘하는 부분입니다. 쿼리 측만 이동하며, 탐색된 각 쿼리는 해당 클러스터의 파티션으로 셔플되는 반면, 인덱스 측은 일치하는 센트로이드 ID에 대한 파일을 직접 스캔합니다. 각 파티션은 정확히 자체 클러스터의 후보만 탐색합니다.
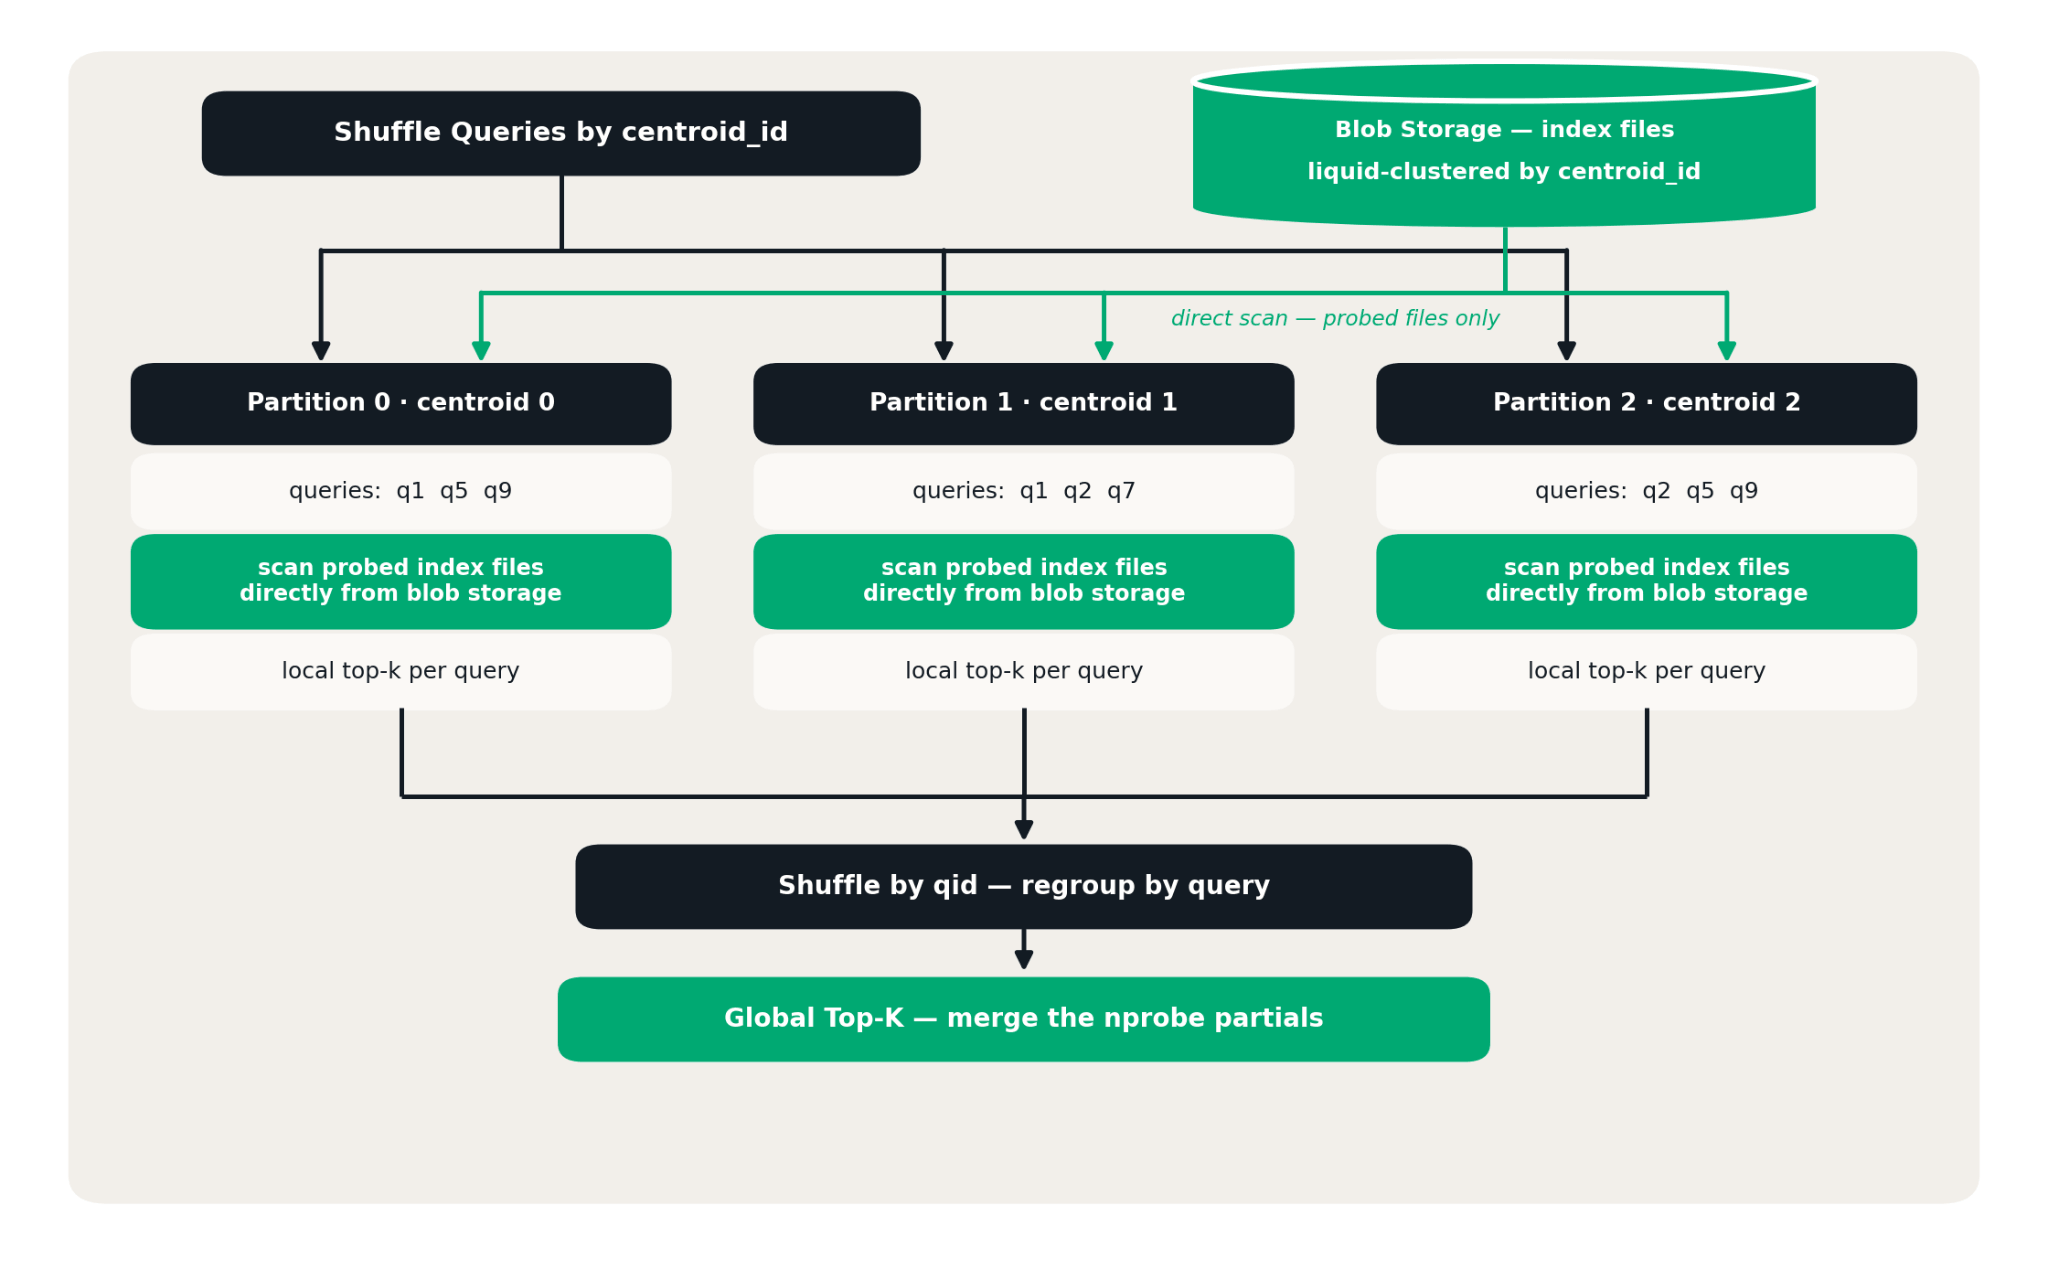
파티션 내에서 각 클러스터의 후보는 밀집된 연속 블록으로 도착하므로 동일한 GEMM 커널이 적용됩니다. 정확한 경로(exact path)는 이를 전역적으로 한 번 실행하고, 근사 경로(approximate path)는 클러스터당 한 번 실행합니다. 쿼리당 로컬 top-k, 재그룹화, 부분 결과 병합 등 집계의 부분/병합 계약(partial/merge contract)이 원래 설계된 목적대로 정확하게 작동합니다.
결과
당사는 100,000개에서 50억 개의 벡터에 이르는 베이스 테이블과 최대 1,000만 개의 벡터로 구성된 쿼리 배치를 사용하여 고객으로부터 관찰된 일반적인 워크로드에 대해 NEAREST BY를 평가했으며, 최소 96%의 recall@K를 목표로 했습니다. 인덱싱된 ANN을 사용한 결과는 다음과 같습니다.
- 의미론적 중복 제거: 1,000만 개의 레코드가 있는 테이블의 셀프 조인이 몇 분 만에 완료되어 중복 감지를 위한 후보 일치 항목을 검색했습니다.
- 분류 및 태깅: 100,000개의 참조 벡터에 대해 1,000만 개의 쿼리를 검색하는 데 1분 미만이 소요되어 유사한 레이블이 지정된 예시를 통한 분류를 지원했습니다.
- 추천 새로 고침: 1,000만 개의 카탈로그 벡터에 대해 100만 개의 쿼리 배치를 실행하여 몇 분 만에 추천 후보를 생성했습니다.
- 엔티티 확인 및 보강: 10억 개의 참조 벡터에 대해 100만 개의 쿼리를 검색하는 작업이 몇 분 만에 완료되어 레코드 연결 및 추가 컨텍스트 검색을 위한 후보 일치 항목을 제공했습니다.
요약
배치 벡터 검색에는 새로운 시스템이 필요하지 않았습니다. 이미 데이터를 보유하고 있는 시스템의 일급 시민(first-class citizen)이 되는 것이 필요했을 뿐입니다. NEAREST BY는 워크로드를 구조적 본질인 top-k 랭킹 조인으로 표현합니다. 루프라인 모델은 왜 나이브한 계획이 메모리 바운드(memory-bound)가 되는지, 그리고 더 빠른 커널이 이를 해결하기 위해 무엇을 해야 하는지 설명합니다. 퓨즈드 연산자(fused operator)와 블록화된 GEMM은 이러한 분석을 연산 집약도(arithmetic intensity)로 전환하며, 벡터 인덱스는 일반적인 리퀴드 클러스터링(liquid-clustered) Delta 테이블로 유지되면서 이를 더욱 확장합니다. 새로운 메커니즘은 하나의 조인 절, 7개의 벡터 함수, 하나의 집계 오버로드, 하나의 퓨즈드 연산자, 그리고 하나의 스토리지 레이아웃 결정이라는 단순하고 좁지만 깊고 효과적인 구조로 의도적으로 설계되었습니다. 셔플 및 스필부터 거버넌스 및 오토스케일링에 이르는 다른 모든 기능은 10년 이상 구축되고 강화된 런타임 엔진과 함께 제공됩니다.
Databricks에서 대규모 AI/ML 워크로드를 위한 까다로운 컴퓨터 시스템을 구축하는 것에 관심이 있으시다면, 저희와 함께 도전해 보세요!
지금 다운로드하기 NEAREST BY 사용해 보기 — 문서 읽기
(이 글은 AI의 도움을 받아 번역되었습니다. 원문이 궁금하시다면 여기를 클릭해 주세요)
AI Engineering, 데이터 엔지니어링, AI Search , Real-Time & Streaming Data
최신 게시물을 이메일로 받아보세요
블로그를 구독하고 최신 게시물을 이메일로 받아보세요.