Lakebase에서 PostgreSQL 19를 사용할 수 있습니다
새로운 기능 체험하기: REPACK, 쿼리 플랜 조언, WAIT FOR LSN 등
작성자: Savannah Longoria
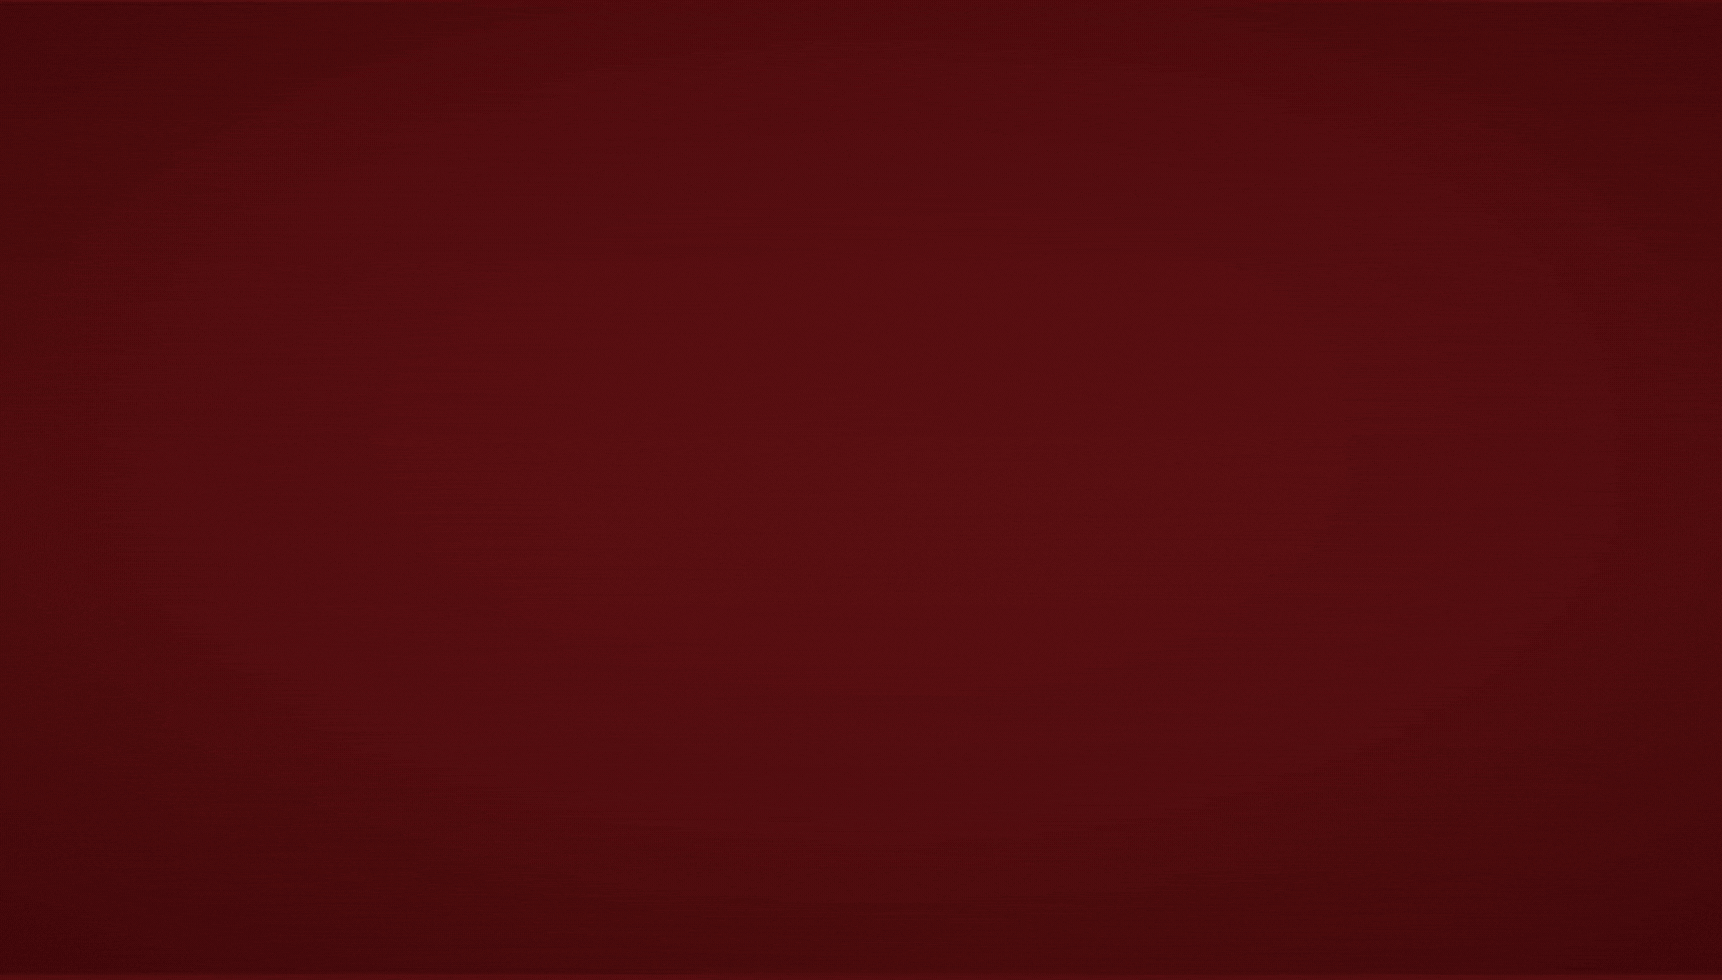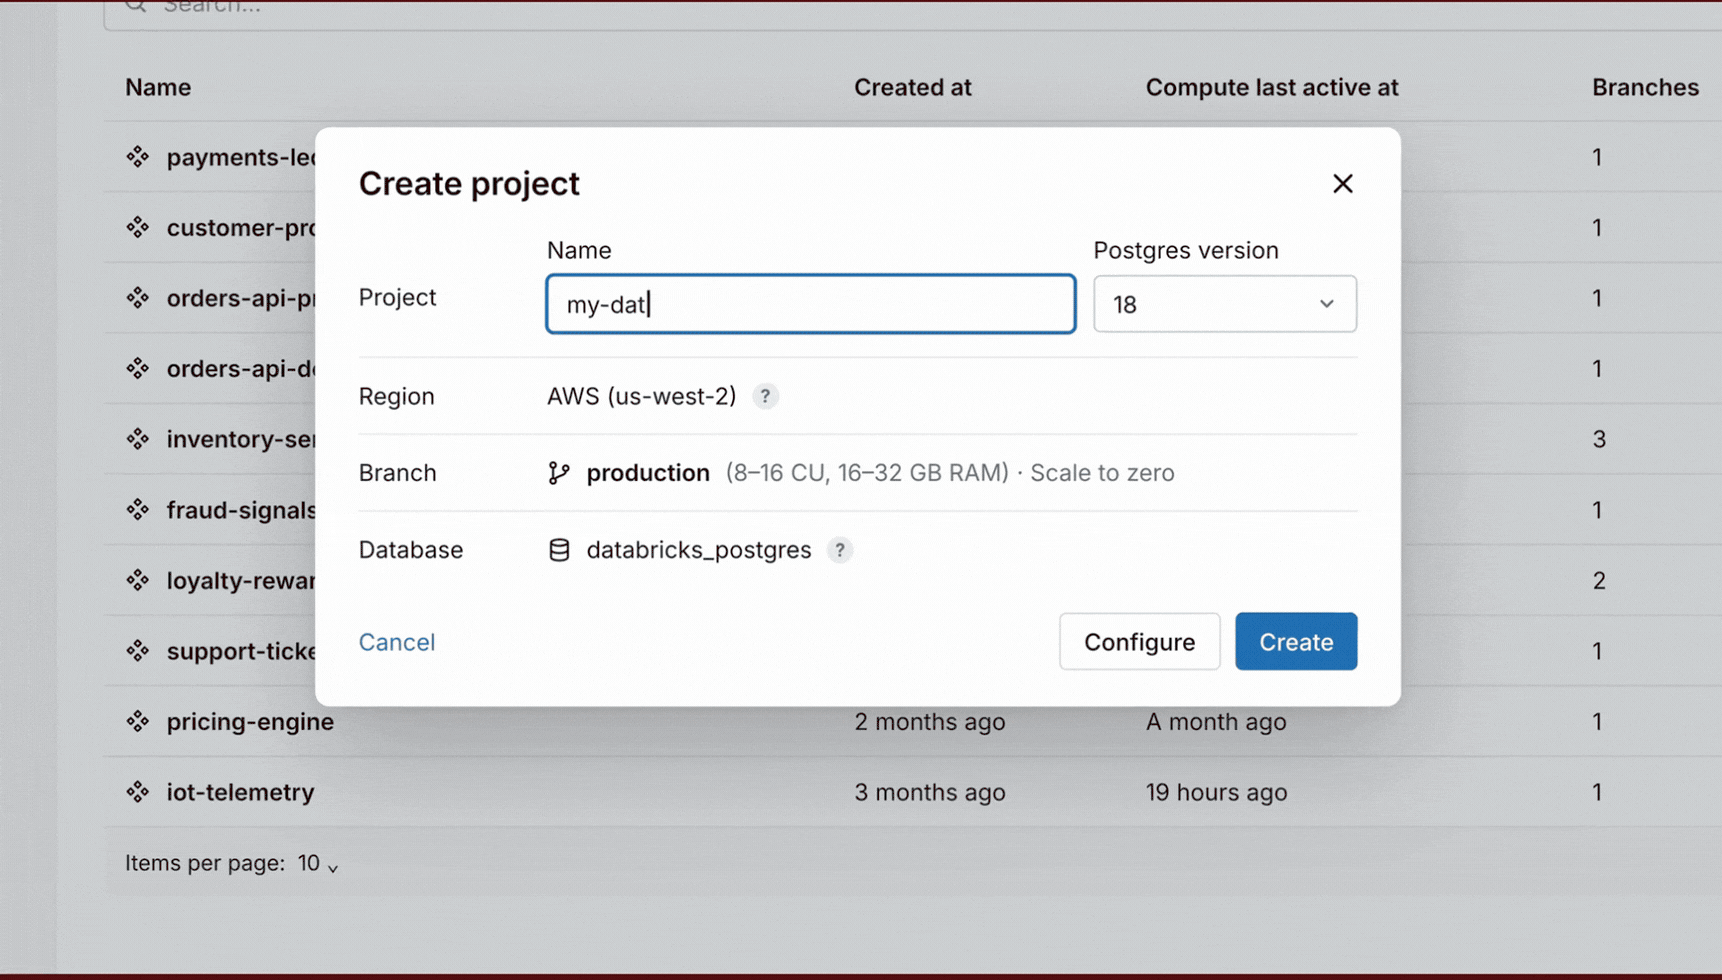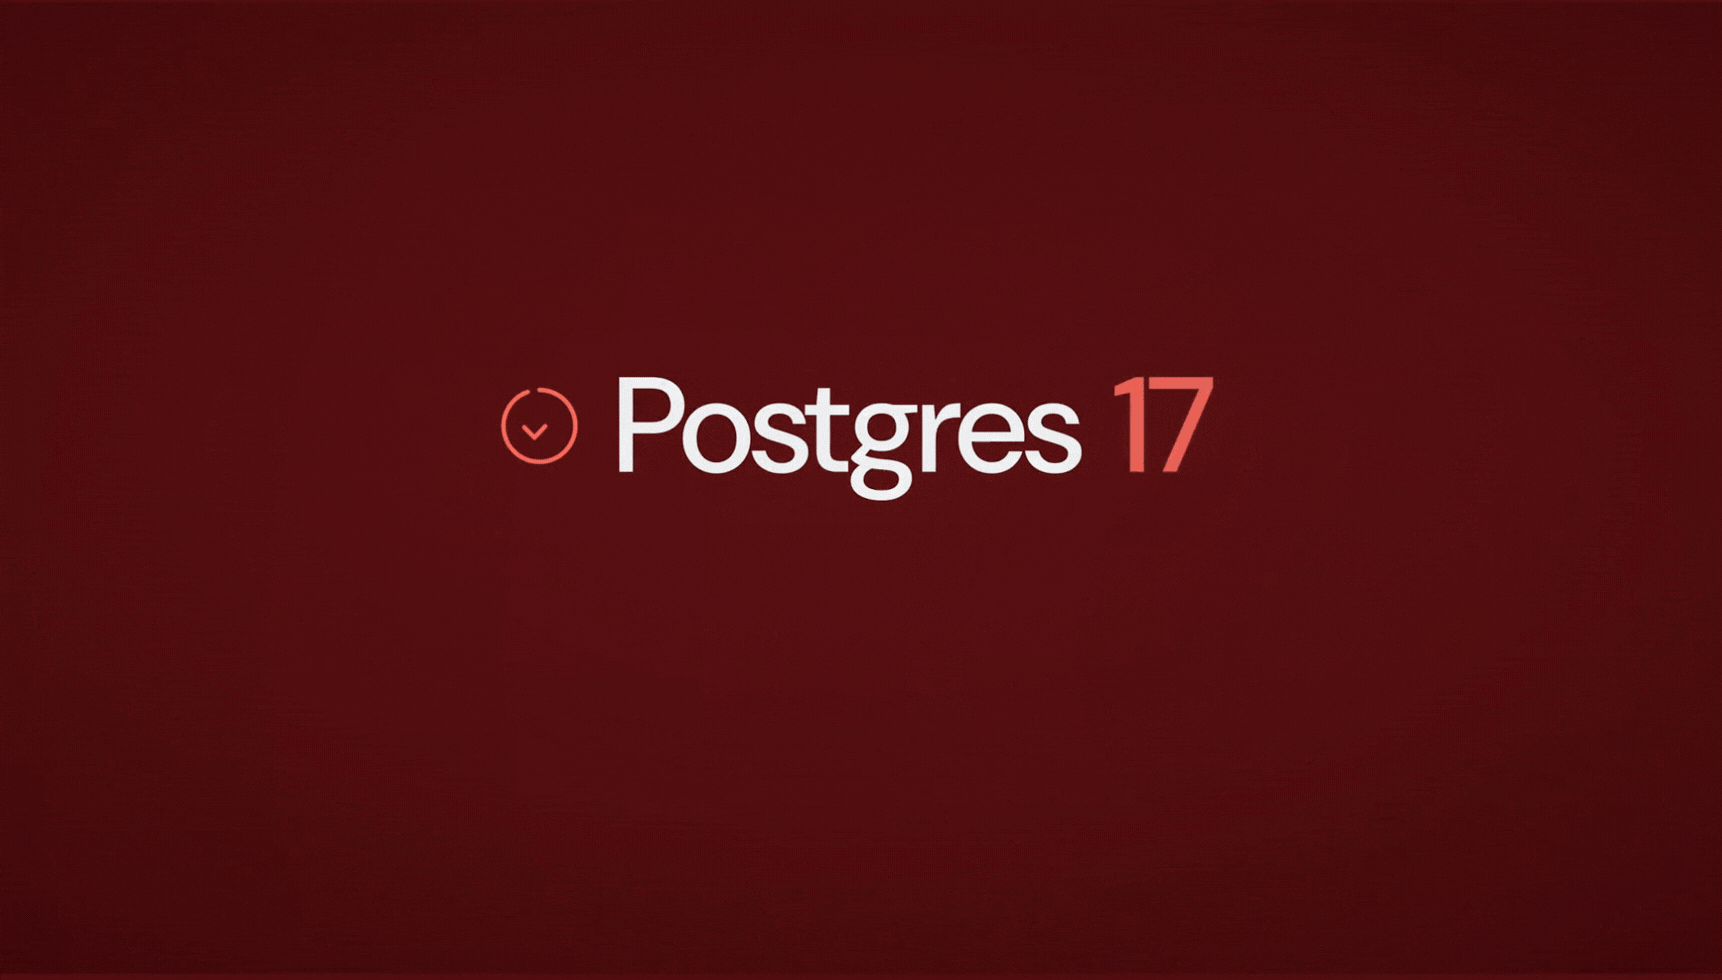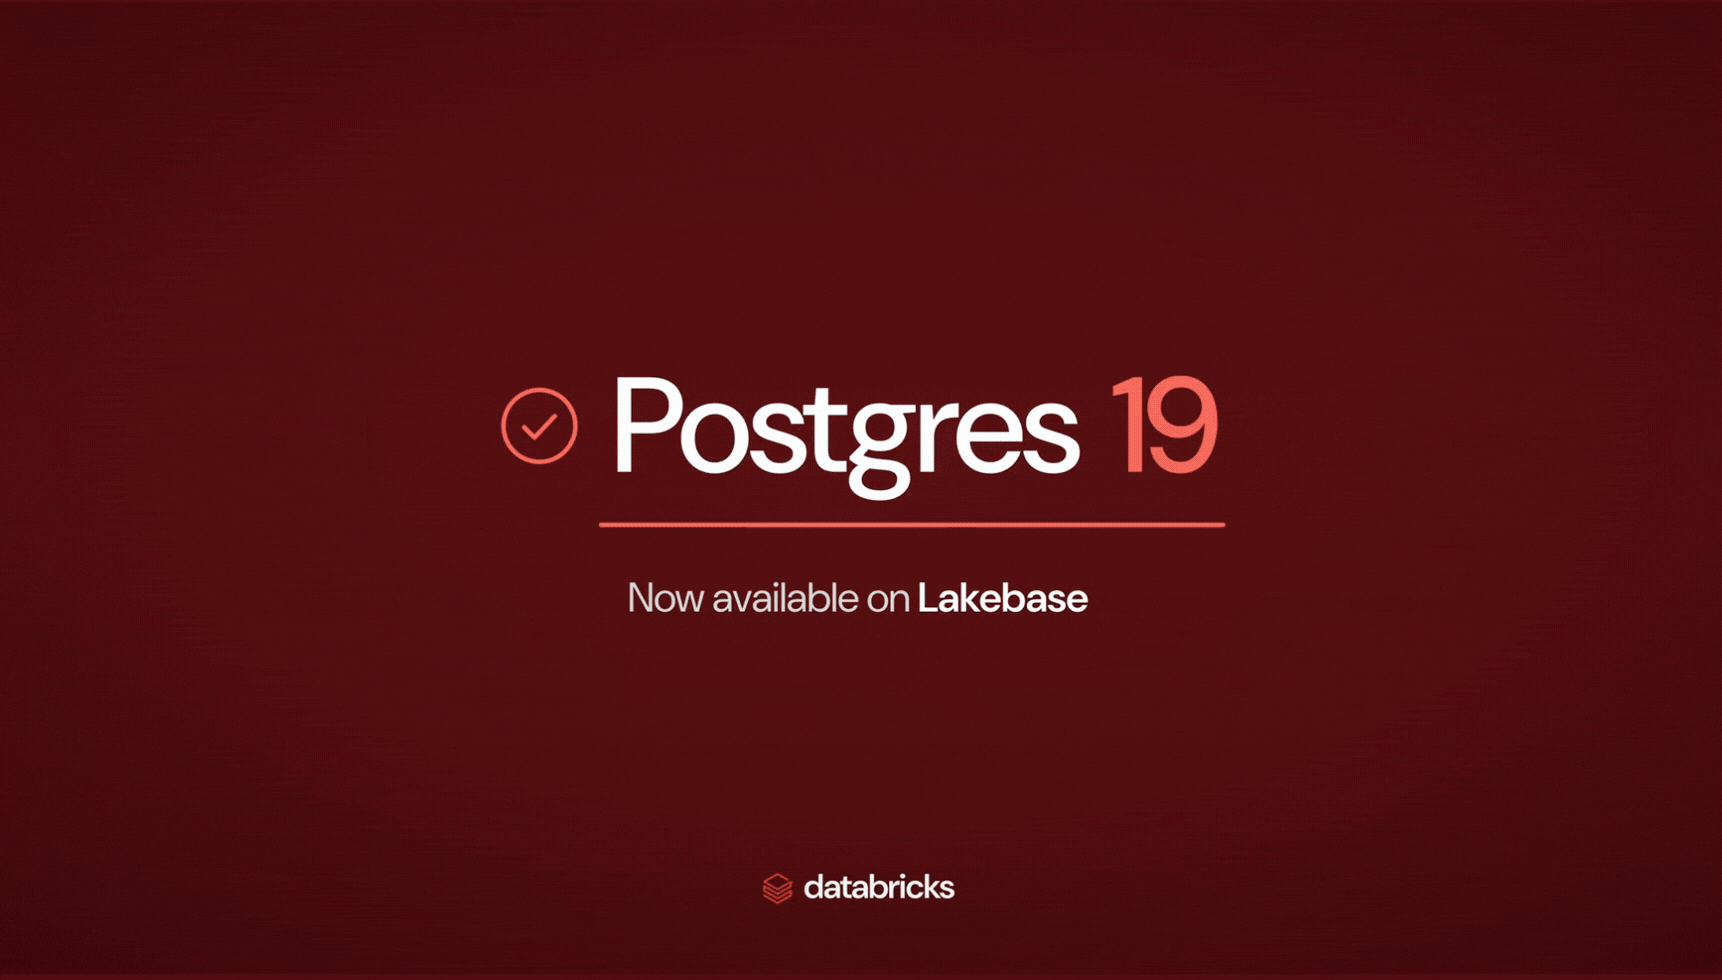
- PostgreSQL 19 버전이 커뮤니티 출시 당일 Lakebase에 적용되었습니다. 사용해 보려면 새로운 Lakebase 프로젝트를 만들고 PostgreSQL 19를 선택하세요.
- 이번 PostgreSQL 릴리스는 운영 제어 기능에 중점을 둡니다. REPACK은 읽기 및 쓰기 작업이 진행되는 동안 공간을 확보하며, 쿼리 플랜 조언 기능을 통해 문제가 발생한 플랜을 안정화할 수 있고, WAIT FOR LSN을 사용하면 복제본에서 쓰기 후 읽기(read-your-writes)가 가능합니다. 논리적 복제 기능도 여러 가지 개선되었습니다.
- 여러 Lakebase 엔지니어들이 쿼리 플랜 조언부터 공유 메모리 및 릴리스 관리까지 이번 릴리스 작업에 참여한 PostgreSQL 커미터 및 기여자들입니다.
PostgreSQL 19 버전이 오늘 GA를 달성했으며 이제 Lakebase에서 바로 사용할 수 있습니다. 새로운 메이저 버전이 다른 관리형 PostgreSQL 서비스에 반영되는 데는 보통 몇 주가 걸립니다. 하지만 저희는 고객들이 당일에 바로 이 기능을 사용할 수 있도록 지원하고자 했습니다.
Lakebase 팀의 여러 엔지니어는 PostgreSQL 커터이자 기여자로서, 쿼리 계획 자문부터 공유 메모리, 로케일 처리, 릴리스 관리까지 이번 릴리스에 직접 참여했습니다. 직접 사용해 보려면 새 Lakebase 프로젝트를 생성한 후 버전을 PostgreSQL 19로 선택하세요.
PostgreSQL 19의 새로운 기능
PostgreSQL 19는 실용적인 릴리스입니다. PostgreSQL의 정체성을 뒤흔드는 단 하나의 거대한 기능은 없습니다. 대신 버전 19는 데이터베이스 팀이 잘 알고 있는 운영상의 문제들을 해결합니다. 비대해진 테이블, 불안정한 쿼리 계획, 레플리카 지연, 불완전한 통계, 그리고 프로덕션 환경에서 안전하게 실행하기 어려운 유지 관리 작업 등이 여기에 해당합니다.
공통된 주제는 제어입니다. PostgreSQL 19는 프로젝트가 지향하는 신뢰성과 예측 가능한 동작을 포기하지 않으면서도, 기본 설정만으로 부족할 때 개입할 수 있는 더 많은 방법을 제공합니다.
전체 변경 사항 목록은 PostgreSQL 19 릴리스 노트에서 확인할 수 있습니다.
REPACK
PostgreSQL은 다중 버전 동시성 제어를 사용하므로 UPDATE은 새 행 버전을 만들고 DELETE은 만료된 튜플을 남깁니다. 주기적인 진공 작업을 통해 해당 공간을 재사용할 수 있게 되지만, 공간이 운영 체제로 반환되거나 유용한 물리적 행 순서가 복원되는 것은 아닙니다. 시간이 지나면서 업데이트가 빈번한 테이블은 비대해지고 클러스터링이 불량해질 수 있습니다.
일반적인 해결책은 VACUUM FULL, CLUSTER 또는 pg_repack 같은 외부 도구였습니다. 기본 제공 명령어도 작동하지만, 전체 작업 동안 ACCESS EXCLUSIVE 락을 유지하여 테이블에 대한 일반적인 접근을 차단합니다.
PostgreSQL 19는 REPACK을 추가하여, 대부분의 작업 동안 일반적인 읽기 및 쓰기가 계속 진행되는 동안 공간을 회수할 수 있게 합니다. 예를 들어, 채팅 애플리케이션은 기존 인덱스를 사용하여 대화 및 전송 시간별로 행을 클러스터링하면서 messages 테이블을 다시 빌드할 수 있습니다:
REPACK은 VACUUM FULL처럼 공간을 회수합니다. 또한 USING INDEX과 함께 사용하면 CLUSTER처럼 물리적으로 행을 정렬합니다. PostgreSQL은 CONCURRENTLY을 통해 일반적인 읽기와 쓰기가 계속되는 동안 테이블을 다시 빌드하고, 논리적 디코딩을 통해 진행 중인 변경 사항을 캡처합니다. 그런 다음 ACCESS EXCLUSIVE 락을 획득하여 캡처된 남은 변경 사항을 적용하고 새 테이블 및 인덱스 파일을 교체합니다. 이 단계는 대개 짧지만 사용량이 많은 테이블에서는 더 오래 걸릴 수 있습니다.
운영상의 제약 조건이 있습니다. 동시 리패킹은 작업 기간 동안 추가 복제 슬롯을 생성하므로, max_repack_replication_slots 하에서 여유 용량이 필요하며 지연 불가능한 기본 키 또는 적절한 인덱스 기반 레플리카 ID를 가진 테이블이 필요합니다. 또한 테이블과 모든 인덱스의 복사본을 위한 임시 디스크 공간이 필요하며, 잠재적으로 테이블 크기까지의 정렬 파일이 추가로 필요할 수 있습니다. 업데이트와 삭제가 많은 테이블에는 추가적인 제한이 있습니다. 현재 업스트림 PostgreSQL 19 구현에서는 REPACK (CONCURRENTLY)이 실행되는 동안 대상 테이블의 튜플이 약 1억 4천만 개 이상 업데이트되거나 삭제되면 실패합니다. 이는 테이블에 이미 있는 행이 아니라 리패킹 중에 발생한 변경 사항을 계산합니다.
모든 관계 유형이 대상이 되는 것은 아닙니다. 장기 실행 트랜잭션은 최종 락을 지연시킬 수 있습니다. 또한 동시 리패킹은 MVCC 안전하지 않습니다. 커밋된 후, 리패킹이 시작되기 전에 찍힌 스냅샷을 사용하는 트랜잭션은 테이블이 비어 있는 것으로 볼 수 있습니다. 이후에 쓰기가 발생함에 따라 물리적 클러스터링도 저하됩니다.
REPACK CONCURRENTLY는 여전히 계획이 필요하지만, 이전에는 더 많은 다운타임이나 확장 기능이 필요했던 작업을 코어로 가져옵니다.
쿼리 계획 자문
PostgreSQL 비용 기반 최적화 프로그램은 테이블 통계와 비용 추정치를 사용하여 실행 계획을 선택합니다. 대부분의 경우 이는 잘 작동합니다.
통계는 개별 테이블을 잘 설명하지만, 실제 데이터셋에는 포착하기 어려운 관계가 포함되는 경우가 많습니다. 기업 고객이 전체 고객의 0.1%를 차지하지만 주문의 30%를 생성한다고 가정해 보겠습니다. 테이블별 통계로는 이러한 테이블 간 상관관계를 포착할 수 없습니다.
orders.customer_id,에 인덱스가 있는 경우 플래너는 각 기업 고객의 주문이 몇 개 안 된다고 추정하여 인덱스를 반복적으로 탐색하는 중첩 루프를 선택할 수 실제로 해당 고객들이 주문의 30%를 차지하는 경우 각 조회는 예상보다 훨씬 많은 행을 반환하며 해시 조인이 더 적절할 수 있습니다.
PostgreSQL 19는 이러한 상황을 위해 pg_plan_advice 과 pg_stash_advice을 추가합니다:
pg_plan_advice은 플래너 결정을 자문으로 설명하고, 제공된 자문을 적용하며, 준수되었는지 여부를 보고합니다.pg_stash_advice은 쿼리 ID별로 자문을 저장하고 일치하는 쿼리가 계획될 때 자동으로 적용합니다.
이러한 구성 요소는 테이블 간 통계를 추가하거나 플래너를 대체하지 않습니다. 대신, 부정확한 추정으로 인해 잘못된 계획이 생성될 때 개입할 수 있도록 합니다.
기업 고객의 주문 수를 계산하는 쿼리를 생각해 보세요:
여기서 c은 필터링된 고객 테이블의 별칭입니다. 다음 자문은 PostgreSQL에 해당 고객들을 해시 조인의 안쪽 측면에 배치하도록 요청합니다:
PostgreSQL이 자문을 적용할 수 있는 경우 EXPLAIN은 다음과 유사한 피드백을 보고합니다:
matched은 결과 계획이 자문을 준수함을 의미합니다. 새로운 계획이 반드시 더 나하다는 것을 의미하지는 않으며, 실제 워크로드에 대해 여전히 평가해야 합니다.
인라인 최적화 프로그램 힌트와 달리, 계획 자문은 애플리케이션의 쿼리 텍스트 외부에 존재합니다. 현재 계획을 검사하고, 집중된 자문을 테스트한 다음, 쿼리 ID별로 보관할 수 있습니다.
pg_stash_advice은 보관된 자문을 자동으로 적용하는 구성 요소입니다. 스토어 관리 기능을 사용하기 전에 각 데이터베이스에서 확장 기능을 생성하세요:
스토어를 만들고 테스트한 자문을 EXPLAIN (VERBOSE)가 보고한 쿼리 ID와 연결합니다. <query_id> 을 계획의 식별자로 바꾸세요:
새 연결에 스토어를 사용하도록 데이터베이스를 구성합니다:
appdb을 데이터베이스 이름으로 바꾸세요.
문제를 진단한 후에는 계획 자문을 안정화 도구로 취급하세요. 데이터 분포가 변경되고, 캐시된 준비된 문장이 잠시 동안 이전 계획을 계속 사용할 수 있으며, 최적화 프로그램은 여전히 틀릴 때보다 맞을 때가 더 많습니다.
플래너가 예기치 않게 중요 쿼리를 더 비효율적인 실행 계획으로 전환할 때, PostgreSQL 19는 이를 안정화할 수 있는 지원 방법을 제공합니다.
병렬 자동 백업(Autovacuum) 및 새로운 통계 뷰
이제 자동 백업은 인덱스를 정리할 때 병렬 워커를 사용할 수 있으며, 이는 autovacuum_max_parallel_workers를 통해 제어됩니다. 새로운 스코어링 시스템은 백업이나 분석이 얼마나 시급한지에 따라 대상 테이블의 우선순위를 정합니다.
새로운 통계 뷰는 서버의 작업 상태를 더 자세히 보여줍니다.
pg_stat_lock은 잠금 유형별 통계를 보고합니다.pg_stat_recovery은 복구 상태를 보여줍니다.pg_stat_autovacuum_scores은 자동 백업이 테이블 우선순위를 지정하는 방식을 보여줍니다.
쿼리 수준의 진단 기능도 향상되었습니다. EXPLAIN (ANALYZE, IO)은 비동기 I/O 활동을 보고하며, auto_explain.log_io은 로그된 계획에 동일한 정보를 포함할 수 있습니다.
또한 PostgreSQL 19는 pg_stat_wal, EXPLAIN (ANALYZE, WAL), 그리고 백업 및 분석 로그에서 전체 페이지 이미지에 대해 기록된 바이트를 보고합니다.
이를 통해 성능 조사가 추정에 대한 의존도를 줄일 수 있습니다. 유지 관리 작업의 우선순위가 지정된 이유, 비동기 I/O가 발생한 위치, 그리고 전체 페이지 이미지에서 발생한 WAL 바이트 수를 확인할 수 있습니다.
논리적 복제
논리적 복제는 변경 데이터 캡처(CDC), 마이그레이션, 실시간 서빙 및 ETL 파이프라인을 위한 핵심 인프라가 되었습니다. PostgreSQL 19는 오랜 기간 지적되어 온 여러 공백을 메웠습니다.
wal_level가replica일 때 재시작 없이 논리적 디코딩을 활성화할 수 있습니다. 첫 번째 유효한 논리적 복제 슬롯을 생성하면effective_wal_level이logical로 상승하여 현재 적용 중인 WAL 수준을 보여줍니다.- 시퀀스 값을 퍼블리셔에서 서브스크라이버로 동기화할 수 있습니다.
- 퍼블리케이션에
FOR ALL SEQUENCES을 사용하여 모든 시퀀스를 포함할 수 있습니다. CREATE PUBLICATION ... FOR ALL TABLES EXCEPT (...)은 지정된 세트를 제외한 모든 테이블을 퍼블리시합니다.- 서브스크립션은
CREATE SUBSCRIPTION ... SERVER를 사용하여postgres_fdw서버의 연결 세부 정보를 재사용할 수 있습니다. retain_dead_tuples서브스크립션 옵션은 복제된 업데이트가 다른 출처에 의해 삭제된 행을 대상으로 할 때 발생하는 충돌을detect update_deleted하기에 충분한 정보를 유지합니다. 감지를 위해서는 서브스크라이버에track_commit_timestamp도 필요하며,pg_stat_subscription_stats은 이러한 충돌 횟수를 집계합니다.
시퀀스 동기화는 특히 논리적 복제를 사용하는 메이저 버전 업그레이드 중에 발생하던 까다로운 마이그레이션 예외 상황을 해결해 줍니다. 시퀀스를 증가시키지 않고 테이블 행을 복사하면 승격된 서브스크라이버가 이미 존재하는 값을 생성하여 중복 키 오류를 유발할 수 있습니다.
PostgreSQL은 기본값인 copy_data = true과 함께 서브스크립션이 생성될 때 초기 시퀀스 값을 복사합니다. 이후의 시퀀스 변경 사항은 연속으로 스트리밍되지 않으므로 컷오버 직전에 새로고침해야 합니다.
이렇게 하면 서브스크립션이 이미 알고 있는 시퀀스가 퍼블리셔의 최신 값으로 업데이트됩니다. 퍼블리케이션에 새로운 시퀀스가 추가된 경우, 컷오버 전에 ALTER SUBSCRIPTION ... REFRESH PUBLICATION을 사용하여 해당 시퀀스를 추가하고 값을 동기화하세요.
WAIT FOR LSN
비동기 읽기 복제본은 기본(Primary) 커밋이 대기하지 않도록 하면서 읽기 용량을 늘려줍니다. 그 대가로 복제 지연이 발생합니다. 애플리케이션이 기본에서 쓰기를 커밋한 후 즉시 복제본에서 읽기를 수행할 때, 복제본이 아직 관련 WAL을 재생(Replay)하지 않아 행을 찾지 못할 수 있습니다.
PostgreSQL 19는 해당 핸드오프를 조정하는 직접적인 방법을 추가합니다. LSN은 PostgreSQL WAL 내의 위치를 식별하며, WAIT FOR LSN은 재생이 요청된 위치에 도달할 때까지 대기 상태를 유지합니다.
기본적으로 WAIT FOR LSN은 스탠바이 서버가 요청된 LSN을 재생할 때까지 무기한 대기합니다. 다른 모드를 사용하면 WAL이 기록되거나 플러시될 때까지 대기할 수 있으며 시간 초과(Timeout)를 설정할 수도 있습니다.
클라이언트나 커넥션 풀러는 여전히 기본에서 복제본으로 LSN을 전달해야 합니다. 이제 데이터베이스가 누락된 동기화 단계를 제공하므로, 쓰기 후 읽기(Read-your-writes) 동작을 위해 폴링이나 임의의 대기 시간을 사용할 필요가 없습니다.
ON CONFLICT DO SELECT
INSERT ... ON CONFLICT DO SELECT은 기존 행과 새로 삽입된 행을 모두 반환하는 깔끔한 get-or-create 패턴을 제공합니다.
이는 값이 변경되지 않았음에도 업데이트를 수행하는 DO UPDATE SET col = EXCLUDED.col 우회 방법을 대체합니다. 이 방법은 충돌이 발생할 때마다 새로운 행 버전을 생성하고 데드 튜플을 남깁니다.
COPY TO를 위한 JSON 출력
COPY TO은 이제 JSON을 직접 출력할 수 있습니다. 기본적으로 줄당 하나의 객체를 작성하며, FORCE_ARRAY은 출력을 단일 JSON 배열로 감쌉니다.
새로운 JSON 형식은 내보내기 전용이므로 COPY FROM에서는 허용되지 않습니다.
더 간결한 SQL 및 성능 변경 사항
마지막으로 편의성을 높여주는 몇 가지 소소한 개선 사항입니다.
- JSON 경로 식에
btrim(),lower(),replace(), 그리고split_part()과 같은 익숙한 문자열 메서드가 추가되었습니다. random(min, max)제품군은 이제 테스트와 합성 데이터셋에 유용한date,timestamp, 및timestamptz을 지원합니다.- 5개의 윈도우 함수가
IGNORE NULLS와RESPECT NULLS을 지원합니다. io_method = worker일 때, I/O 워커는io_min_workers와io_max_workers사이에서 자동으로 확장됩니다. 외래 키 검사가 더 빨라지고 플래너와 실행기가 추가적인 대상 최적화를 거치게 됩니다.
제외된 기능들
PostgreSQL 19 개발 과정에서 여러 주요 기능이 도입되었으나 출시 전에 제외되었습니다. 검토 과정에서 정합성이나 설계상 문제가 발견되었고 릴리스 주기가 임박한 상황에서 이를 해결하기에는 위험이 너무 컸기 때문에, 커뮤니티에서는 해당 기능을 향후 릴리스로 연기했습니다.
이번 19 버전에서 최종적으로 제외된 기능 중 일부는 다음과 같습니다.
SQL/PGQ속성 그래프 쿼리.CREATE PROPERTY GRAPH및GRAPH_TABLE이(가) 일반 테이블에 대한 그래프 패턴 매칭 기능을 SQL에 도입했습니다. 2026년 9월 7일에 철회됨.UPDATE and DELETE ... FOR PORTION OF.대상 시간 범위를 벗어나는 히스토리를 보존하기 위해 행을 분할하는 임시(Temporal) 업데이트 및 삭제. 2026년 9월 15일에 철회됨.ALTER TABLE ... MERGE PARTITIONS및SPLIT PARTITION. 파티션을 결합하거나 분할하기 위한 내장 명령어. 2026년 8월 27일에 철회됨.GROUP BY ALL. select 목록의 모든 비집계 표현식으로 그룹화하기 위한 단축 표기법.. 2026년 7월 17일에 철회됨.- 다음 항목에 대한 텍스트가 아닌 출력 형식
pg_dumpall. 2026년 6월 18일에 철회됨. - DDL 추출 함수.
pg_get_role_ddl(),pg_get_tablespace_ddl()및pg_get_database_ddl()이(가) 2026년 9월 13일에 철회됨.
PostgreSQL 기여자분들께 감사드립니다
PostgreSQL은 커뮤니티 기여자들에 의해 만들어집니다. 릴리스 노트에 이름이 올라간 수백 명의 커뮤니티 기여자분들께 감사드립니다. 이번 PostgreSQL 버전을 위해 애써 주신 Lakebase 팀 엔지니어분들께 특별히 감사드립니다:
- Robert Haas는 pg_plan_advice와 pg_stash_advice를 작성했습니다(후자는 Lukas Fittl과 공동 작업).
- Heikki Linnakangas는 공유 메모리 등록을 위한 새로운 메커니즘, 하위 시스템이 이를 할당하는 방식의 개편, multixact 수정, 그리고 max_locks_per_transaction의 새로운 기본값인 128 설정을 작업했습니다.
- Jeff Davis는 CREATE SUBSCRIPTION이 postgres_fdw 서버의 연결 세부 정보를 재사용할 수 있도록 하는 변경 사항을 작성했으며, 로케일 및 문자 처리와 관련하여 오랜 기간 작업했습니다.
- Jonathan Katz은 PostgreSQL 19 보도 자료를 작업하고 릴리스 조율을 담당했습니다.
- Matthias van de Meent은 정적 인덱스 접근 방식 루틴 변경을 포함하여 여러 커밋을 작업했습니다.
- Alexander Lakhin은 여러 버그를 찾아 신고했습니다.
PostgreSQL 19로 업그레이드하기
모든 새로운 주요 PostgreSQL 버전과 마찬가지로, 도입 시 신중한 접근을 권장합니다. 프로덕션 워크로드를 19.0으로 전환하기 전에 다음을 수행해 보시는 것을 제안합니다:
- 먼저 개발 또는 스테이징 환경에서 PostgreSQL 19를 사용하여 자체 워크로드, 쿼리 및 확장 기능을 테스트합니다.
- 주요 릴리스는 쿼리 플랜과 기본값을 변경할 수 있으므로, 현재 버전과 성능 및 동작을 비교합니다.
- 의존하고 있는 확장 기능이 PostgreSQL 19에서 사용 가능한지 확인합니다(아래 참조).
- 결과에 만족할 때까지 프로덕션 환경을 현재 버전으로 유지합니다.
PostgreSQL 19는 여러 기본값과 호환성 동작도 변경합니다. 업그레이드하기 전에 다음을 확인하세요:
- JIT 컴파일이 기본적으로 꺼져 있습니다.
- TOAST 압축은 pglz 대신 기본적으로 LZ4를 사용합니다.
- MD5 비밀번호 인증은 더 강력한 지원 중단(depreciation) 경고를 발생시킵니다.
- RADIUS 인증 지원이 제거되었습니다.
- standard_conforming_strings가 항상 켜져 있습니다.
- pg_upgrade는 inet 또는 cidr에 영향을 받는 btree_gist 인덱스가 있는 클러스터를 거부합니다.
- 데이터베이스, 역할 및 테이블스페이스 이름에는 더 이상 캐리지 리턴이나 라인 피드를 사용할 수 없습니다.
확장 기능 관련 참고 사항
PostgreSQL 18 릴리스에서 지원되는 대부분의 확장 기능을 다루었지만, 아직 모두가 PostgreSQL 19에서 사용 가능한 것은 아닙니다. 확장 기능 제공업체에서 이용할 수 있게 되는 대로 더 많은 기능을 추가하고 있습니다. 워크로드가 특정 확장 기능에 의존하는 경우, 마이그레이션을 계획하기 전에 PostgreSQL 19에서 사용 가능한지 확인하세요.
실제 사용을 통해 버그 수정과 개선 사항이 드러남에 따라, 커뮤니티는 일반적으로 주요 버전 출시 후 몇 달 뒤에 첫 번째 마이너 릴리스를 선보입니다. PostgreSQL 19.1은 2월에 출시될 것으로 예상되며, 많은 팀이 해당 릴리스에 맞춰 프로덕션 업그레이드를 계획합니다. 이는 모든 .0 릴리스에서 흔히 볼 수 있는 합리적인 패턴이며, 이번에도 마찬가지입니다.
일정이 어떻게 되든 저희가 도와드리겠습니다. 업그레이드 계획이나 테스트에 대해 논의하고 싶으시다면, 계정 팀이나 Databricks 지원에 문의해 주세요.
사용해보기
PostgreSQL 19를 지금 바로 Lakebase에서 이용하실 수 있습니다.새로 시작하는 경우 워크스페이스에서 PostgreSQL 19 프로젝트를 생성하여 사용해보거나 Lakebase 시작하기를 참조하세요.
(이 글은 AI의 도움을 받아 번역되었습니다. 원문이 궁금하시다면 여기를 클릭해 주세요)
최신 게시물을 이메일로 받아보세요
블로그를 구독하고 최신 게시물을 이메일로 받아보세요.