RADAR: 이상 탐지로 회색 장애 감지하기
실시간 이상 탐지를 통해 보이지 않는 부분적 장애를 몇 분 만에 감지하는 방법과 Databricks 상에 동일한 시스템을 구축하는 방법
- 그레이 장애(gray failures)는 정상(녹색) 대시보드를 빠져나가, 아무도 눈치채기 전에 조용히 고객과 매출에 손실을 입힙니다.
- RADAR는 신뢰성 메트릭, 이상 탐지, 알림, 근본 원인 분석으로 구성된 메트릭에 구애받지 않는 4단계 패턴입니다. Databricks는 이를 자체 운영에 적용하여 이러한 장애를 90% 이상의 정밀도로 몇 분 만에 포착하고 발견 속도를 95% 단축합니다.
- 네이티브 구성 요소와 AI 에이전트 스캐폴드를 사용하면 청구, 전환율, 모델 성능 등 모든 메트릭에 대해 동일한 시스템을 Databricks 상에 구축할 수 있습니다.
가장 치명적인 장애 중 일부는 모니터링 시스템이 감지하지 못하는 장애입니다. 모든 헬스 체크가 정상으로 표시되는 동안 일부 고객 그룹에서 조용히 오류가 발생하고 있는 경우입니다. 이러한 "그레이 실패(gray failures)"는 누군가 원인을 파악하기 전까지 몇 시간 동안 사용자 이탈과 매출 손실을 유발합니다. 이 글에서는 이상 탐지(anomaly detection)를 통해 이러한 문제를 조기에 발견하는 방법, 즉 Databricks에서 RADAR라는 시스템을 통해 이를 어떻게 해결하고 있는지, 그리고 비즈니스에 가장 중요한 메트릭에 맞춰 동일한 시스템을 구축하는 방법을 소개합니다. 이 글은 서비스 신뢰성을 책임지는 SRE, 플랫폼 및 데이터 엔지니어, 온콜 담당자, 그리고 이들을 이끄는 엔지니어링 리더분들을 위해 작성되었습니다.
모든 대시보드가 초록색이지만 아무것도 정상적이지 않을 때
평범한 수요일을 상상해 보세요. 고객 대상 서비스의 신뢰성을 유지하는 것이 여러분의 업무이며, 벽에 걸린 모든 대시보드는 초록색입니다. CPU 상태 양호, 지연 시간 정상, 서버 작동 중, 데이터베이스 연결 완료. 팀이 모니터링하는 모든 신호에 따르면 시스템은 완벽해 보입니다.
하지만 실제로는 그렇지 않습니다.
- 9:30 — 정기 배포 중 결제 흐름에 미세한 버그가 유입됩니다.
- 9:35 — 신용카드로 결제하는 고객 20명 중 1명꼴로 결제에 실패하지만, 아무런 경고도 뜨지 않습니다. 몇 번 시도해 본 고객들은 결국 포기하고 사이트를 떠납니다.
- 12:40 — 첫 번째 고객 지원 티켓이 접수됩니다. 단순히 카드 번호를 잘못 입력한 것처럼 보여 아무도 신경 쓰지 않습니다.
- 14:20 — 동일한 문제로 두 개의 티켓이 추가로 접수됩니다.
- 14:25 — 지원 팀장이 패턴을 파악하고 문제를 에스컬레이션합니다.
- 16:00 — 엔지니어들이 버그를 찾아내고 수정 사항을 배포합니다.
거의 7시간 동안 모니터링 시스템은 모든 것이 정상이라고 표시하는 동안, 고객들은 이탈하고 매출은 줄어들고 있었습니다.
그레이 실패(gray failure)란 무엇인가요?
앞서 언급한 수요일의 사례는 전형적인 그레이 실패의 예입니다. 겉보기에는 모든 것이 정상인 것처럼 보이지만, 내부적으로는 특정 부분이 조용히 작동을 멈춰 경고를 발생시키지 않으면서도 고객에게 피해를 줍니다.
그레이 실패가 매우 까다로운 이유는 두 가지가 있습니다.
- 부분적으로 발생합니다. 모든 사용자에게 발생하는 것이 아니라 특정 신용카드 종류와 같이 일부 그룹에만 발생합니다. 즉시 감지할 수 있는 서버 다운은 없으며, 대부분의 사용자는 정상이고 특정 그룹만 지속적으로 실패하는 모호한 상태가 유지됩니다.
- 점점 확산됩니다. 처음에는 소수의 고객에게만 영향을 미치던 문제가 점점 퍼져나갑니다. 방치하면 점점 더 많은 사용자가 동일한 문제에 직면하게 됩니다.
벽 뒤에서 피어오르는 연기라고 생각하면 쉽습니다. 밖에서 보면 집은 멀쩡해 보이지만 안에서는 피해가 확산되고 있으며, 방치할수록 피해 규모는 커집니다. 연구원들은 이 근본적인 문제에 대해 이름을 붙였습니다. Microsoft의 Gray Failure: The Achilles’ Heel of Cloud-Scale Systems 논문에서는 이를 '차등 관찰 가능성(differential observability)'이라고 부릅니다. 즉, 사용자는 문제를 분명히 겪고 있지만 장애 감지 시스템은 이를 알아차리지 못하는 현상입니다.
고객의 제보만 기다리면 실패하는 이유
대부분의 팀은 앞서 수요일의 사례처럼 고객이 직접 알려줄 때까지 기다리는 방식으로 그레이 실패에 대처합니다. 고객 제보는 실제 사용자의 불편을 보여주므로 중요하지만, 고객이 모니터링 시스템의 역할을 대신해서는 안 됩니다. 제보에만 의존하는 데는 세 가지 문제가 있습니다.
- 수동 작업입니다. 누군가 수많은 티켓 중에서 동일한 불만 사항을 직접 찾아내야 하므로 놓치기 쉽습니다.
- 시간이 지체됩니다. 문제를 인지할 수 있을 만큼 충분한 불만이 접수될 때쯤에는 이미 몇 시간 또는 며칠이 지난 후입니다.
- 조용히 진행됩니다. 피해를 입은 대부분의 고객은 티켓을 접수하지 않고 그냥 떠나버립니다.
해결책은 티켓 확인을 중단하는 것이 아니라(티켓은 계속 확인해야 합니다), 항상 실행되면서 사람이 놓치는 부분을 잡아내는 자동 탐지 기능을 추가하는 것입니다. 구체적으로는 평소보다 훨씬 많은 고객이 동시에 동일한 문제를 겪는 순간 즉시 작동하는 시스템이 필요합니다.
| 고객 제보에만 의존할 때 | 자동 탐지 추가 시 |
|---|---|
| 수동 작업 — 놓치기 쉬움 | 사람이 놓치는 부분까지 탐지 |
| 지연 발생 — 인지하는 데 며칠 소요 | 신속함 — 실시간으로 인지 |
| 고객이 소리 없이 이탈 | 급증 현상 감지 — 다수의 사용자 동시 발생 시 알림 |
RADAR를 소개합니다
이것이 바로 RADAR(Reliability Anomaly Detection, Alerting, and Root-cause analysis)의 핵심 개념입니다. Databricks에서는 몇 시간이 아닌 몇 분 만에 그레이 실패를 감지하기 위해 이 시스템을 구축했습니다. 이름에 걸맞게, 가시성이 낮을 때는 무언가에 부딪힐 때까지 기다리지 않고 미세한 신호를 미리 스캔하여 찾아냅니다.
특히 유용한 신호 중 하나인 사용자 오류에 RADAR를 적용하는 방법을 소개합니다.
그레이 실패는 종종 사용자 과실처럼 보이는 오류의 급증으로 나타납니다. 특정 지역의 여러 사용자가 갑자기 특정 유형의 클러스터를 실행할 수 없는 상황을 상상해 보세요. 각 요청은 INVALID_ARGUMENT 오류와 함께 실패합니다. 이는 정중하게 "사용자 측의 잘못입니다"라고 말하는 오류입니다.
하지만 많은 사용자가 동시에 동일한 "사용자 과실" 오류를 겪는다면, 그것은 더 이상 사용자의 잘못이 아닙니다. 바로 우리의 잘못입니다. 이러한 급증 현상이 바로 RADAR가 감지하도록 설계된 패턴입니다.
RADAR의 4단계 작동 방식
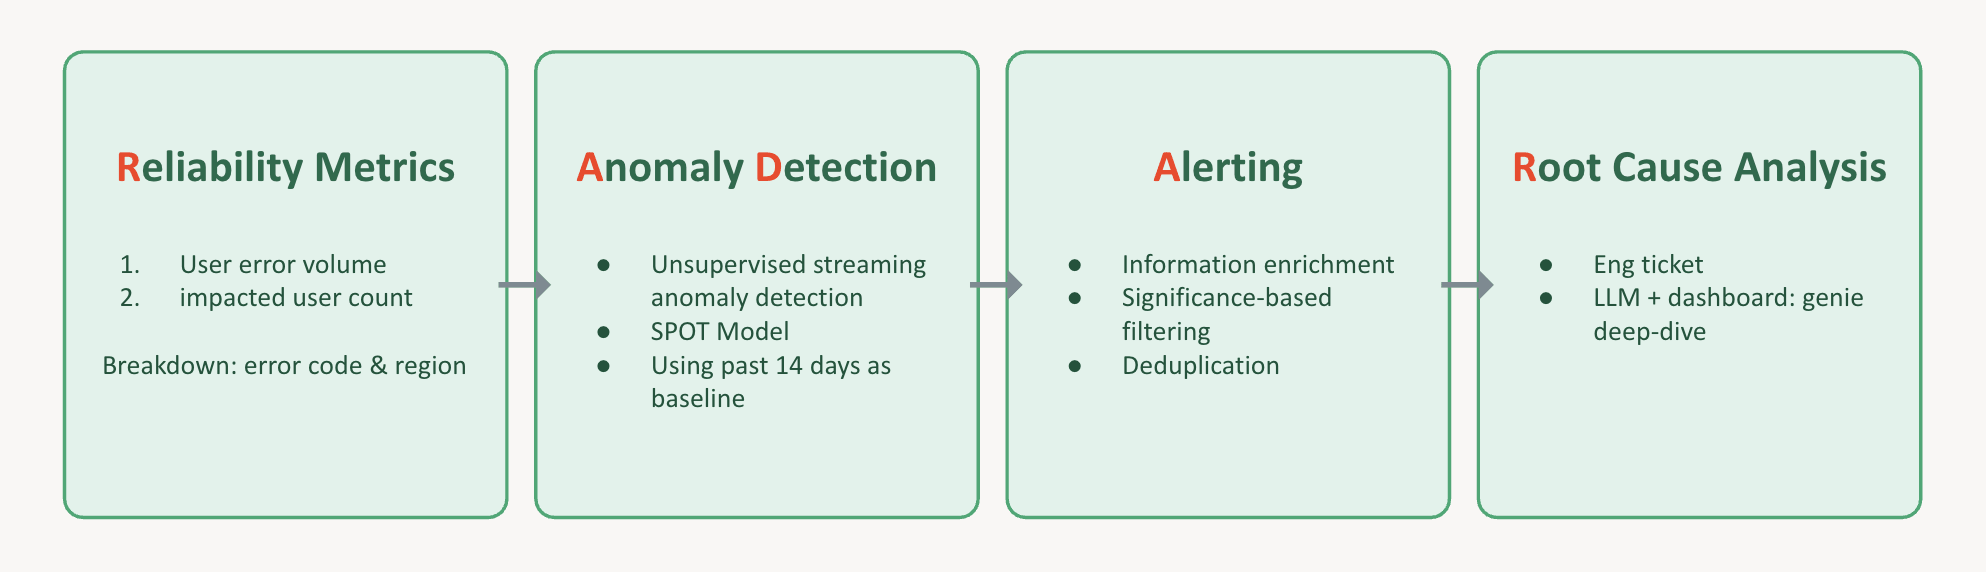
RADAR는 이러한 직관을 4단계의 파이프라인으로 전환합니다.
- 신뢰성 메트릭(Reliability metrics). 매 순간 발생하는 오류의 수와 각 오류를 겪은 개별 사용자의 수라는 두 가지 데이터를 기록합니다. 이를 오류 코드 및 지역별로 세분화하면, 서비스의 상태를 보여주는 풍부한 시계열 데이터 세트를 확보할 수 있습니다.
- 이상 탐지(Anomaly detection). 각 시계열 데이터에 대해 이상 탐지를 실행하여 수많은 임계값을 수동으로 조정하지 않고도 시스템이 비정상적인 상태를 감지하도록 합니다. 저희는 SPOT이라는 비지도 스트리밍 모델을 사용합니다. 이 모델은 지난 14일 동안의 데이터를 통해 '정상' 상태가 무엇인지 학습하며, 수동 차단값 대신 단 하나의 위험 매개변수만 필요로 합니다. (SPOT은 Siffer 등의 논문인 Anomaly Detection in Streams with Extreme Value Theory, KDD 2017에서 유래되었습니다.)
- 알림(Alerting). 이상 징후가 감지되면 알림 레이어가 작동합니다. 알림에 컨텍스트를 추가(enrich)하고, 중요하지 않은 알림은 필터링하며, 중복을 제거(dedupe)하여 온콜 담당자가 동일한 알림에 파묻히지 않도록 합니다. Then it files a ticket routed to the right engineering team for that error.
- 근본 원인 분석(Root-cause analysis). 모든 티켓에는 이상 탐지 상세 분석 정보와 AI 비서인 AI/BI Genie가 지원하는 대시보드 링크가 함께 제공됩니다. 온콜 담당자는 최소한의 시간으로 실제 장애 원인을 파악하는 데 집중할 수 있습니다.
달성한 성과
자체적으로 RADAR를 운영하면서 이러한 장애의 양상이 완전히 바뀌었습니다. 이전에는 장애를 발견하기 위해 고객 티켓에 의존하여 며칠씩 지연되곤 했습니다. RADAR를 도입한 후, 사람이 직접 패턴을 찾을 필요 없이 90% 이상의 정밀도(precision)로 장애 감지 시간을 95% 단축했습니다. 결과적으로 그레이 실패의 피해 범위를 최소화할 수 있게 되었습니다.
어떤 메트릭이든 RADAR를 적용할 수 있습니다
가장 중요한 점은 RADAR가 메트릭의 종류를 가리지 않는다는 것입니다. 저희는 사용자 오류에 이를 적용했지만, 수치가 조용히 잘못될 수 있는 모든 영역에서 동일한 패턴을 적용할 수 있습니다.
- 금융 서비스 — 결제 및 거래 실패, 청구 이상, 사기 징후
- 소매 및 이커머스 — 결제 전환율, 장바구니 오류, 배송 시간
- 의료 및 생명 과학 — 환자 처리량, 보험 청구 처리
- 모든 AI 제품 — 모델이 눈에 띄게 망가지기 전에 나타나는 모델 성능 및 데이터 분포 드리프트(drift)
설정만 다를 뿐 동일한 패턴입니다. 조용히 문제가 발생할 수 있는 곳이라면 어디든 RADAR를 적용할 수 있습니다.
Databricks에서 직접 구축해 보세요
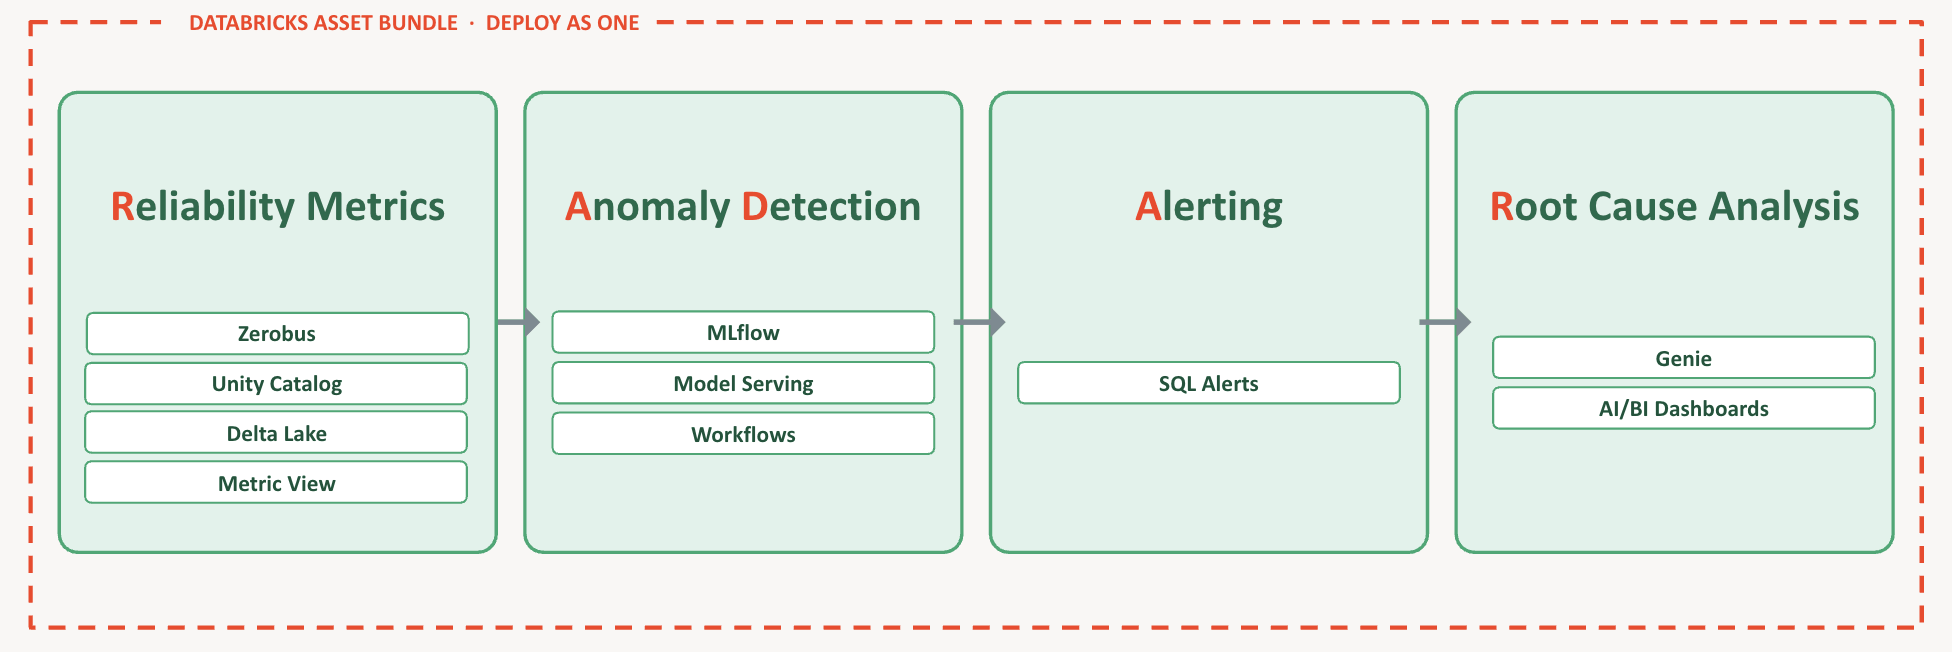
가장 좋은 소식은 필요한 모든 구성 요소가 이미 Databricks에 준비되어 있다는 점입니다. 이 4단계를 플랫폼에 매핑하면 다음과 같습니다.
- 신뢰성 메트릭(Reliability metrics) — 저지연 수집을 위한 Zerobus, 거버넌스를 위한 Unity Catalog 및 Metric View, 스토리지를 위한 Delta Lake
- 이상 탐지 — 모델 학습을 위한 MLflow, 모델 엔드포인트를 제공하는 Model Serving, 반복적인 작업을 오케스트레이션하는 Workflows
- 알림 — 알림을 트리거하는 Databricks SQL Alerts
- 근본 원인 분석 — AI/BI Genie 및 AI/BI Dashboards
그리고 이 모든 것이 선언적 자산 번들(DAB)을 통해 단일 단위로 배포됩니다.
이 모든 부분을 수동으로 연결하는 것은 번거로운 일입니다. 그래서 이 과정을 없앴습니다. 내부 RADAR 시스템 전체를 하나의 스캐폴드(scaffold)로 압축했습니다. 레시피처럼 작동하는 하나의 마크다운 파일로, RADAR의 각 부분을 특정 Databricks 구성 요소에 매핑합니다(수집 및 저장 → Delta 테이블, 이상 탐지 → 작업, 알림 및 중복 제거 → 티켓, 시각화 → 대시보드).
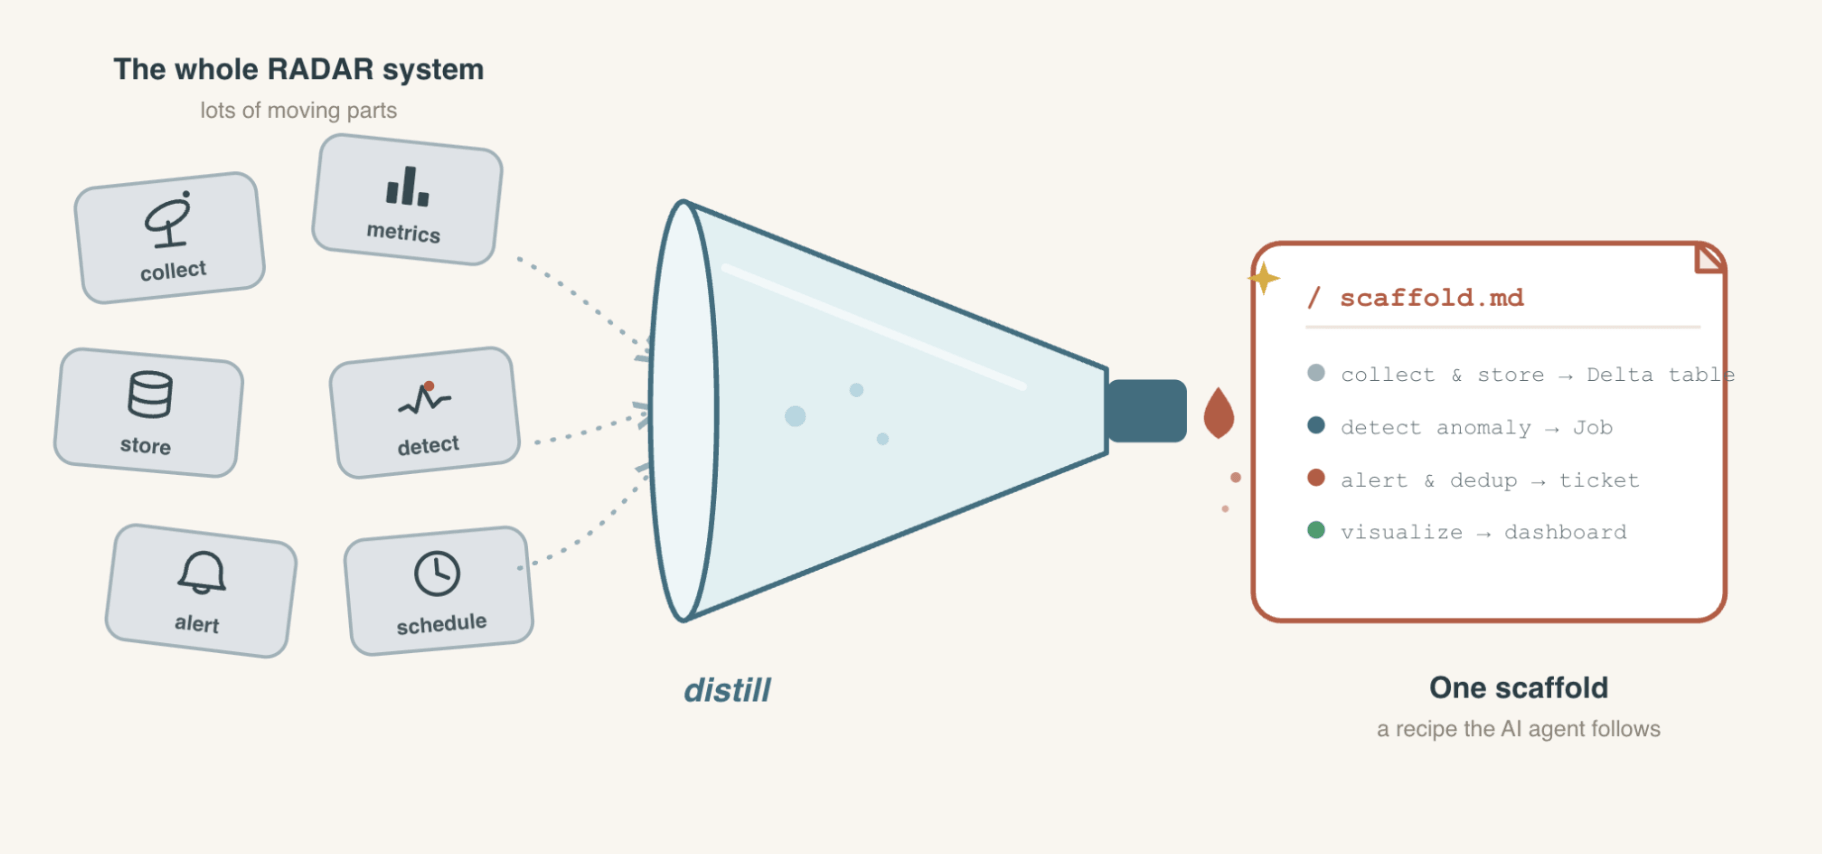
이제 진짜 혜택을 누릴 차례입니다. 신호가 어디에 있든 자체 메트릭을 가져와 메트릭, 스캐폴드, 짧은 프롬프트를 AI 에이전트에게 전달하기만 하면 됩니다. 그러면 AI 에이전트가 Databricks에서 실시간으로 전체 RADAR 시스템을 구축해 줍니다. 단일 프롬프트에서 시스템을 구축하는 방법은 GitHub 안내를 따르세요.
핵심 요약
기억해야 할 두 가지 핵심 사항은 다음과 같습니다.
- 그레이 실패(gray failure)가 확대되기 전에 포착하세요. 초록색 대시보드가 고객에게 아무런 문제가 없다는 증거는 아닙니다. 실시간 이상 탐지 기능을 추가하여 부분적이고 조용한 실패가 며칠이 아니라 몇 분 만에 드러나도록 하세요.
- 중요한 모든 메트릭에 대해 Databricks에 RADAR를 구축하세요. 스캐폴드, 데모, 프롬프트는 모두 공개되어 있으므로 바로 시작해 보세요.
가장 좋은 결과는 화가 난 고객에게 더 빠르게 대응하는 것이 아니라, 고객이 장애를 먼저 발견하는 일이 없도록 하는 것이기 때문입니다.
(이 글은 AI의 도움을 받아 번역되었습니다. 원문이 궁금하시다면 여기를 클릭해 주세요)
최신 게시물을 이메일로 받아보세요
블로그를 구독하고 최신 게시물을 이메일로 받아보세요.