Databricks에서 대규모 dbt 프로젝트 확장 및 운영: 성능, 가시성, 디버깅에 대한 IFCO 데이터 팀의 경험
작성자: Fernando Muñoz, Ludwig Brummer , Maxim Hammer
- 리퀴드 클러스터링, 신중한 병합 전략, 동적 파일 프루닝을 사용하여 매 실행마다 변경된 행만 기록하도록 dbt 증분 모델을 최적화합니다. 이를 통해 IFCO의 핵심 작업 실행 시간이 60% 이상 단축되었고 매일 밤 실행되던 전체 새로 고침(full refresh)을 없앨 수 있었습니다.
- 컴파일된 SQL이 아닌 실제 실행된 쿼리 계획에서 느린 모델을 진단하세요. 진짜 원인은 바로 그곳에서 발견되기 때문입니다. IFCO는 이 진단 과정을 모든 모델에서 실행 가능한 반복적인 기술로 패키징했습니다.
- dbt 프로젝트를 하나의 불투명한 작업으로 실행하지 않고, 오픈 소스인 databricks-dbt-factory를 사용하여 Databricks Jobs에서 모델당 하나의 태스크로 실행합니다. 이를 통해 모델별 가시성을 확보하고, 원하는 모델만 재실행하며, 테스트를 강제 적용할 수 있습니다.
초록
IFCO는 수억 개의 상자와 팔레트를 보유한 세계 최대 규모의 재사용 가능 포장 풀(pool) 중 하나를 운영하고 있습니다. 전 세계적으로 2,000명 이상의 직원을 두고 있는 IFCO는 독일에 350명 이상의 직원을 고용하고 있으며, 이들 대부분은 뮌헨 인근 풀라흐에 위치한 글로벌 본사에서 근무하고 있습니다. 이 비즈니스는 순환형 풀링 서비스입니다. 재사용 가능한 플라스틱 용기(RPC)가 재배자 및 포장업체로부터 유통 센터와 소매업체로 신선한 농산물을 이동시킨 후, 다시 IFCO 서비스 센터로 돌아와 세척, 분류되어 50개국 이상으로 다시 발송됩니다.
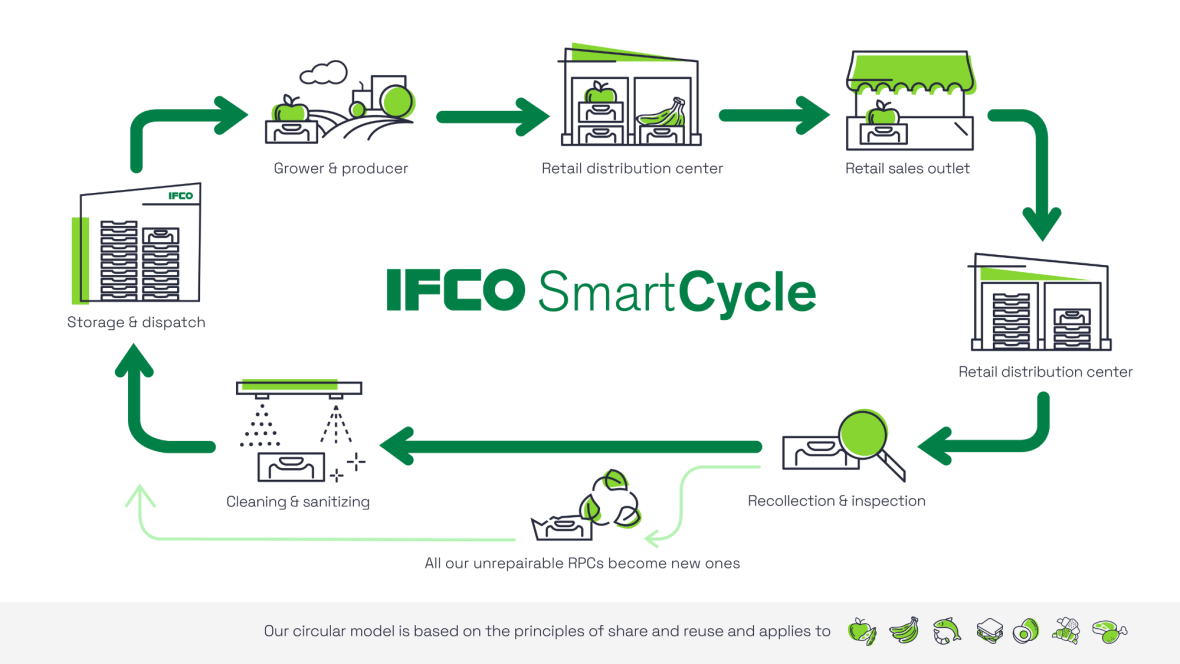
모든 상자와 팔레트는 수명 주기를 통해 추적되며, 비즈니스 운영의 기준이 되는 KPI(주기 시간, 손실, 파손, 세척 비용, 풀 규모)에 데이터를 공급합니다. 수십억 개의 원시 추적 이벤트를 신뢰할 수 있는 KPI로 변환하는 것은 세 가지 이유로 어렵습니다. 데이터의 양이 매우 많고, 일부 데이터는 예측하기 어려운 방식으로 지연되어 도착하며, 지연 데이터가 도착하면 파이프라인이 이미 보고한 과거 이력을 수정해야 하기 때문입니다.
본 포스트에서는 IFCO의 데이터 플랫폼 팀이 Databricks Forward Deployed Engineering과 협력하여 이 파이프라인을 어떻게 더 빠르고 저렴하게 만들었는지 소개합니다. 변환 로직은 dbt에 유지됩니다. 이는 Databricks에서 실행되며, 여기서 각 증분(incremental) 설정은 구체적인 Delta Lake 쓰기 동작에 매핑됩니다. 즉, 어떤 열이 데이터를 클러스터링하는지, 쓰기 작업이 대상 테이블의 어느 정도를 터치해야 하는지, 행이 병합(merge)되는지 또는 대체(replace)되는지 등을 결정합니다. 적절한 데이터 세분성(grain)에서 이러한 설정을 올바르게 구성함으로써 핵심 시맨틱 레이어 작업의 일일 실행 시간을 60% 이상 단축하고, IFCO가 비용이 많이 드는 야간 전체 리프레시(full refresh) 작업을 중단할 수 있게 되었습니다.
IFCO와 데이터 문제의 양상
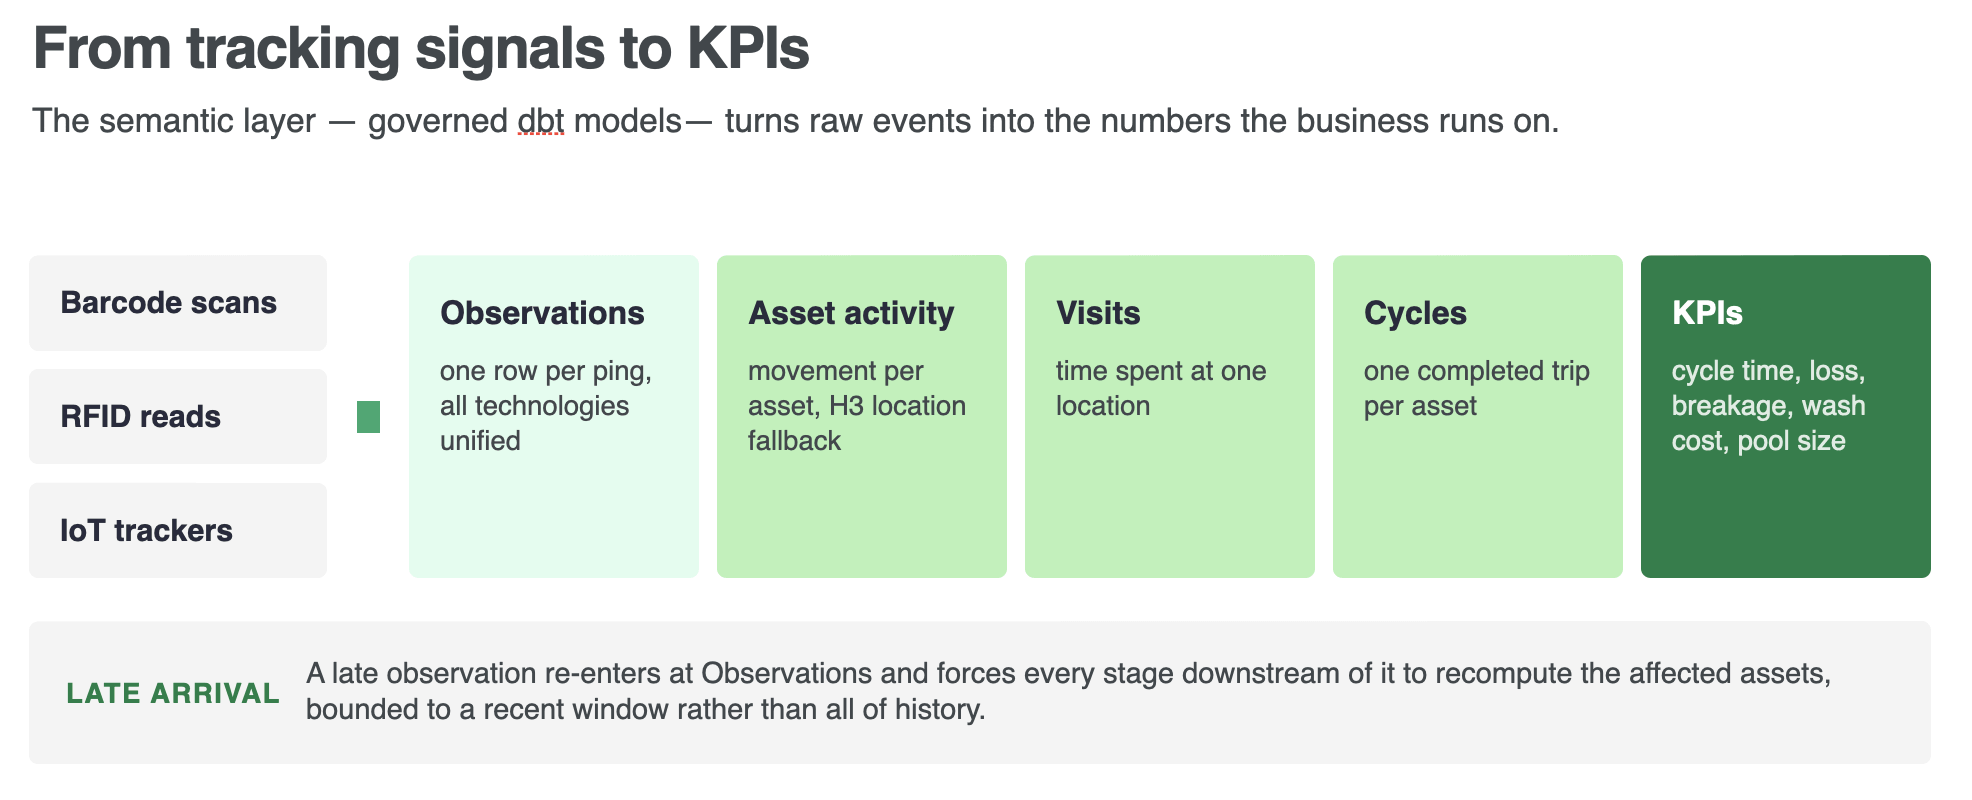
상자는 일 년에 수없이 수거되고, 채워지고, 배송되고, 반납되고, 세척되고, 재사용되므로, IFCO는 모든 자산의 위치와 상태를 파악해야 합니다. IFCO는 다양한 추적 신호를 자산 활동에 대한 하나의 거버넌스된 뷰로 통합하는 시맨틱 레이어를 도입했습니다. 여기에는 세척 라인을 통과하는 상자의 바코드 스캔, 도크 도어에서의 RFID 판독, GPS 위치, 주변 Bluetooth 비콘 및 온도를 보고하는 배터리 구동 추적기 등이 포함됩니다. (이 포스트 전체에서 "시맨틱 레이어"는 원시 추적 이벤트를 비즈니스 KPI로 변환하는 거버넌스된 dbt 모델을 의미합니다.) 세 가지 특성으로 인해 이 작업이 까다로워집니다.
- 규모(Scale). 하루에 수십억 개의 추적 이벤트가 유입됩니다. 통합 작업을 통해 각 자산의 반복적인 핑(ping)을 훨씬 적은 수의 활동 행으로 압축하지만, KPI가 읽는 테이블은 여전히 규모가 커서 처음부터 다시 구축하려면 비용이 많이 듭니다.
- 예측 불가능한 지연 도착. 대부분의 관측 데이터는 예상된 기간 내에 도달하지만, 일부 피드는 정해진 일정 없이 몇 주, 심지어 몇 달씩 지연되기도 합니다. 오늘 보유한 데이터가 어제 발생한 일의 전체 모습이라고 가정하는 파이프라인은 잘못된 과거 이력을 그대로 보고하게 됩니다.
- 과거 이력 조정(Historic reconciliation). 자산 활동은 순차적인 흐름이므로 지연된 관측 데이터가 단순히 빈틈만 채우는 것이 아닙니다. 자산의 타임라인 중간에 스캔 데이터를 추가하면 파이프라인이 그 이후의 모든 상황(자산이 다음에 이동한 위치, 주기가 시작된 시점, 도달한 KPI 버킷 등)에 대해 이미 내린 결론이 달라집니다. 따라서 지연 데이터가 도착하면 단순히 새 행을 추가하는 것이 아니라 파이프라인이 이미 게시한 상태를 다시 계산해야 합니다. 목표는 매일 밤 모든 데이터를 재처리하지 않고도 신속하게 양호한 추정치를 제공하고, 지연 데이터가 도달함에 따라 이를 실제 사실에 수렴시키는 것입니다.
대규모 증분 처리
dbt 증분 모델은 내부적으로 일련의 Delta 읽기 및 쓰기 동작으로 구성되며, 성능 개선의 대부분은 한 가지 원칙에서 비롯되었습니다. 즉, 각 실행이 가능한 한 적은 행을 터치하도록 하고, 가능한 한 일찍 이를 차단하는 것입니다. 첫 번째이자 가장 큰 레버는 읽기 작업 자체로, 실행에 실제로 필요한 파일과 변경된 자산만 스캔하는 것입니다. 읽지 않고 피하는 모든 행은 다운스트림의 비용이 많이 드는 자산별 정렬, 셔플 및 쓰기 단계에 도달하지 않기 때문입니다. 아래의 각 기술은 특정 Delta 동작으로 변환되는 일반적인 dbt 구성(config)입니다.
필터링 및 조인 기준이 되는 열을 클러스터링합니다. 각 모델이 쿼리되는 세분성(자산 활동의 경우 자산 및 이벤트 날짜)에 키가 지정된 Liquid 클러스터링을 사용하면 엔진이 파일을 스캔하는 대신 건너뛸 수 있습니다. 이것이 다음 두 가지 기술을 작동하게 만드는 핵심입니다.
증분 전략을 신중하게 선택하세요. 이 전략은 각 실행이 데이터를 쓰는 방식을 결정하며, 선택은 두 가지 질문에 따라 달라집니다. 각 행에 고유한 키가 있는지, 그리고 행을 제자리에서 업데이트하는지 아니면 한 번에 여러 행을 대체하는지 여부입니다. 키가 있고 중복 제거가 많은 업서트(upsert)의 경우 merge가 기본값입니다. 실제 세분성(자산 활동의 경우 asset_id 및 event_date_time)에 키를 지정하면 대량 삭제 후 재삽입(bulk delete-and-reinsert) 방식이 수행할 수 없는 다음 두 가지 작업을 수행합니다.
동등 조인(equi-join) 조건자는 동적 파일 프루닝(dynamic file pruning)을 활성화합니다. 즉, 유입되는 배치의 키 값이 일치하는 항목을 포함할 수 없는 대상 파일을 건너뛰므로 쓰기 작업은 변경되는 부분만 터치합니다. ((DBT_INTERNAL_DEST and DBT_INTERNAL_SOURCE은 생성되는 문에서 대상 테이블과 유입되는 배치에 대한 dbt의 별칭입니다.) 병합이 일치하는 동일한 키를 클러스터링하면 프루닝을 정밀하게 유지할 수 있습니다. 각 행의 대리 해시(surrogate hash)를 비교하는 matched_condition인 행 해시 가드는 실제로 변경되지 않은 행의 재작성을 건너뛰어 쓰기 작업을 절약하고 다운스트림 변경 피드를 깨끗하게 유지합니다.
delete+insert은 대안입니다. 키별로 전체 행 그룹을 삭제하고 다시 삽입합니다. 이는 실행 시 그룹을 단위로 다시 도출하고 행에 일치시킬 고유한 식별자가 없을 때 더 간단하지만, 변경된 내용이 없는 경우에도 그룹을 다시 작성해야 하는 비용이 발생합니다. 대용량 데이터의 경우 가정을 하기보다는 두 가지 방식을 벤치마킹해 볼 가치가 있습니다.
쓰기 작업을 최근 윈도우로 제한합니다. 동일한 조건자 메커니즘은 두 번째 용도로도 사용됩니다. 파일 프루닝을 위한 동등 조인 대신, 시간 제한을 두어 쓰기 작업을 최근 데이터로 제한함으로써 대용량 업스트림 모델에서 MERGE이 전체 테이블이 아닌 대상의 최근 슬라이스와 일치하도록 합니다.
조건자는 이벤트가 발생한 시점이 아니라 행이 수집된 시점을 키로 사용하므로, 몇 달 전의 이벤트라도 최근에 도달했다면 여전히 캡처됩니다. 윈도우는 데이터가 도달한 시점과 이 작업이 이를 처리하는 시점 사이의 간격을 감당할 수 있을 만큼만 넓으면 됩니다. 너무 좁게 설정하면 지연 데이터가 경고 없이 건너뛰어집니다. 오류는 발생하지 않지만 처리되지 않을 뿐입니다.
변경된 내용만 다시 계산합니다. 모델은 수집 워터마크에서 식별된 신규 또는 지연 데이터의 영향을 받는 자산으로 작업 범위를 제한하고, 쓰는 범위보다 넓은 윈도우를 읽으므로 전체 리프레시 없이도 지연된 이벤트를 캡처할 수 있습니다.
Delta를 깔끔하게 유지하세요. 대규모 증분 테이블은 최적화된 쓰기(optimized writes) 및 자동 압축(auto-compaction)을 활성화하거나 테이블 유지 관리를 예측 최적화(Predictive Optimization)에 위임하여, 빈번한 병합으로 인해 작은 파일 읽기 비용이 발생하지 않도록 합니다.
핵심은 이러한 기법들을 적절한 세분성에 적용한 다음, 실제 쿼리 계획을 통해 엔진이 보이지 않게 전체 스캔을 수행하는 대신 실제로 프루닝을 수행하는지 확인하는 것입니다.
실제 사례: 관측 데이터를 자산 활동으로 통합하기
시맨틱 레이어에서 가장 부하가 큰 모델은 모든 추적 기술의 관측 데이터를 자산별로 위치를 인식하는 단일 스트림으로 통합하는 모델입니다. 이 모델은 자산별로 파티션되고 이벤트 시간순으로 정렬된 윈도우 함수를 사용하여 자산이 실제로 이동한 시점을 파악합니다. 관측 데이터에 명시적인 위치가 없는 경우, Databricks SQL의 내장 H3 함수를 사용합니다. 이 함수는 각 위도/경도를 육각형 그리드 셀에 매핑하여 지리적 거리 계산을 반복하는 대신 셀 ID와 그리드 거리의 저렴한 비교를 통해 "동일한 장소" 여부를 판단할 수 있게 해줍니다. 이 모델은 실행 시간을 가장 많이 소모하는 압도적인 요인이었습니다.
첫 번째 조치는 최적화가 아니라 실제로 무엇이 실행되고 있는지 확인하는 것이었으며, 이 차이는 매우 중요합니다. dbt compile는 참조(refs)가 해결된 모델의 SELECT를 렌더링하지만, 증분 모델의 경우 이는 Databricks가 실행하는 문이 아닙니다. 컴파일된 SELECT 뒤에서 dbt는 임시 뷰, 대상 테이블 스캔, 테이블로의 최종 쓰기 등 더 큰 작업을 생성하고 실행합니다. 시간과 메모리가 어디에서 소모되는지 파악하는 유일한 방법은 컴파일된 SQL이 아니라 쿼리 기록에서 실제 실행된 쿼리 계획을 단계별로 읽는 것입니다.
그렇게 확인한 계획은 심각한 문제를 드러냈습니다. 모델이 수십억 개의 행을 스캔하고, 수백 기가바이트를 디스크로 스필(spill)하고 있었으며, 실행 시간의 약 85%를 단일 자산별 윈도우 정렬 및 셔플에 소비하고 있었습니다. 사실상 매 실행마다 전체 테이블을 다시 구축하고 있었던 것입니다. 세 가지 원인이 있었습니다.
- "변경" 자산 세트가 절대 줄어들지 않았습니다. 업스트림 타임스탬프가 소스에서 그대로 전달되지 않고 실행할 때마다 다시 생성되어 거의 모든 자산이 새로운 것처럼 보였습니다. 모든 것이 변경된 것(dirty)으로 간주되면 증분 실행(incremental run)은 소리 소문 없이 전체 새로고침(full refresh)으로 바뀝니다.
- 자산별 재계산에 제한이 없었습니다. 윈도우 함수가 각 자산의 전체 이력을 모두 조회했기 때문에, 실제로 변경된 세트가 아주 작더라도 정렬 과정에서 수년 치의 이력 데이터가 함께 처리되었습니다.
- 윈도우 단계에서 최종 쿼리가 전혀 사용하지 않는 열을 계산했습니다. 여기에는 전체 출력이 버려지는 두 번째 정방향(forward-looking) 윈도우도 포함되었습니다.
각 해결책은 원인에서 바로 도출됩니다. 변경된 세트가 진짜 새로운 데이터를 반영하도록 업스트림 모델을 통해 실제 수집(ingestion) 타임스탬프를 전달하고, 재계산 범위를 최근 윈도우로 제한하며, 사용하지 않는 열과 정방향 윈도우를 삭제하고, 모델이 쿼리되는 세분성(grain)을 기준으로 클러스터링합니다. 그리고 마지막으로 전체 그래프를 서버리스 컴퓨팅 상에서 모델별 병렬 태스크로 실행합니다(다음 섹션 참고). 이러한 조치를 통해 핵심 작업의 실행 시간을 60% 이상(2/3에 가까운 수준) 단축했으며, KPI를 올바르게 유지하기 위해 매일 밤 수행해야 했던 전체 새로고침을 없앨 수 있었습니다.
일회성 디버깅 세션에서 반복 가능한 기술로 발전시키기
컴파일된 SQL 대신 실제 실행된 계획(executed plan)을 읽고, 읽기 측면과 쓰기 측면을 모두 확인하며, 각 증상의 근본 원인을 추적하는 위의 진단 과정은 통합 모델에만 국한된 것이 아닙니다. 이는 Databricks에서 실행 속도가 느린 증분 모델을 다룰 때 엔지니어라면 누구나 수행할 만한 일련의 과정입니다. 이 과정이 바로 하나의 '기술(skill)'로 패키징되는 것입니다. 즉, AI 에이전트가 필요할 때마다 실행하는 플레이북이 되어, 진단 방법이 엔지니어의 기억력에 의존하는 대신 모델 수에 맞춰 확장(scale)될 수 있도록 합니다.
이 기술은 앞서 살펴본 예시를 단계별로 그대로 반영합니다. 증분 모델의 경우 이 둘이 서로 다른 문(statement)이기 때문에, dbt compile 출력이 아닌 쿼리 기록에서 실제 실행된 문 패밀리(statement family)를 가져옵니다. 증폭(amplification) 현상은 쓰기 측면에서만 나타나므로 실행의 양쪽 측면, 즉 스캔 측 메트릭(정리된 파일 수, 읽은 행 수, 스필)과 쓰기 측 메트릭(기록된 행 수 대 삭제된 행 수)을 모두 읽습니다. 그런 다음 통합 모델에서 발견된 것과 동일한 세 가지 유형의 오류를 확인합니다. 즉, 절대 줄어들지 않는 변경 세트(업스트림 타임스탬프가 전달되지 않고 다시 생성됨), 제한 없는 자산별 재계산(조회 제한이 없는 윈도우), 낭비되는 작업(계산되었으나 다운스트림에서 전혀 읽지 않는 열 또는 윈도우 패스)입니다. 각 점검은 직관이 아닌 메트릭이나 계획 신호(plan signal)를 기반으로 합니다.
출력 결과는 소리 없이 수정되는 것이 아니라 보고서 형태로 제공됩니다. 각 발견 사항은 증거(스캔된 행 수, 스필 바이트, 계획 노드) 및 제안된 변경 사항과 함께 표시되며, 승인되기 전에는 모델에 아무것도 적용되지 않습니다. 승인되면 수정의 타당성을 입증하는 데 사용된 것과 동일한 전/후 메트릭이 다음 실행 시 다시 측정되므로, 단순히 수정이 잘 되었을 것이라 가정하는 대신 기술이 루프를 완전히 닫아(close the loop) 검증을 완료합니다.
이를 통해 얻는 이점은 참신함이 아니라 일관성입니다. 통합 모델의 실행 시간을 늘린 세 가지 원인(다시 생성된 타임스탬프, 제한 없는 윈도우, 사용되지 않는 열)은 평범하면서도 부하가 걸린 상황에서는 놓치기 쉬운 것들이었습니다. 이를 감지하기 위해 기술을 실행하는 것은 반복 비용이 거의 들지 않으며, 누군가 문제를 에스컬레이션해야 할 만큼 실행 시간이 60%나 늘어나는 심각한 문제가 되기 전에 다음 모델에서 동일한 유형의 문제를 찾아낼 수 있습니다.
Databricks Jobs에서 대규모 dbt 프로젝트 실행하기
Databricks Workflows(Lakeflow Jobs)는 dbt를 퍼스트 클래스(first-class) 태스크 유형으로 취급합니다. 즉, 하나의 거버넌스된 워크플로 내에서 수집 및 다운스트림 단계와 함께 dbt 프로젝트를 예약, 실행 및 모니터링할 수 있으며 재시도 및 알림도 공유됩니다. 가장 간단한 방식은 전체 프로젝트를 단일 dbt 태스크로 실행하는 것입니다. 작동은 하지만 이는 블랙박스와 같습니다. 하나의 모델이 실패하면 전체 작업이 실패하며, 개별 모델을 확인하거나 재실행하거나 모니터링할 방법이 없습니다. 이 정도 규모에서는 이것이 운영상의 리스크가 됩니다.
해결책은 dbt 그래프를 모델, 테스트, 시드, 스냅샷당 하나씩 개별 Databricks 태스크로 실행하는 것입니다. IFCO는 독립형 오픈 소스 라이브러리인 databricks-dbt-factory(MIT 라이선스, GitHub 및 PyPI에서 제공)를 사용하여 해당 그래프를 생성합니다. 이 라이브러리는 dbt 매니페스트와 작업 템플릿을 읽고 노드당 하나의 태스크가 포함된 Databricks Asset Bundle 작업을 생성합니다. 태스크별 세분성은 각 태스크를 시작하는 비용이 저렴할 때만 효과가 있으며, 이는 다음 세 가지 메커니즘으로 요약됩니다.
- 노트북 태스크 유형. 소규모 공유 러너 노트북이 Python API를 통해 dbt를 트리거합니다. dbt가 SQL을 작성하여 SQL 웨어하우스로 전송하므로 노트북 컴퓨팅은 데이터를 직접 처리하지 않습니다.
- 기본 환경. 기본 환경은 사전 구축된 서버리스 Python 환경 스냅샷입니다. 여기에는 이미
dbt-databricks가 포함되어 있으므로 각 태스크는 이 환경에서 시작하여 새 태스크가 거쳐야 하는 pip install 과정을 건너뜁니다. - 매니페스트 주입. 사전 구축된 매니페스트가 dbt에 직접 전달되어 파싱 과정을 건너뛰고, 각 태스크는 아티팩트를 프라이빗 로컬 디렉터리에 기록합니다. 동시에 많은 태스크가 실행되는 대규모 프로젝트의 경우, 이는 프로젝트를 다시 읽는 데 몇 분을 낭비하는 것과 유용한 작업을 즉시 시작하는 것의 차이를 만듭니다.
오버헤드를 최소화하면서 팬아웃(fan-out)을 통해 운영에 필요한 요소들을 제공합니다. 즉, 태스크 수준의 가시성, 실패한 모델 및 그 종속 모델만 선택적으로 재실행하는 기능, 모델별 로깅, 알림 및 테스트, 그리고 확장 가능한 러너(몇 줄의 코드로 비밀번호 로드, git SHA로 실행 태그 지정, Slack 전송 등 가능)를 지원합니다. 모든 것은 경로를 인식하는 GitHub Actions 매트릭스를 통해 Databricks Asset Bundles로 배포되며, 모델별 실행 시간과 비용은 쿼리 태그 및 시스템 테이블에서 알림 기능이 있는 대시보드로 추적됩니다. 따라서 성능 저하(regression)가 발생하더라도 월말 청구서가 아닌 하루 만에 이를 감지할 수 있습니다.
대규모 환경에서의 테스트 및 품질 관리
효율성이 아무리 좋아도 수치상 오류가 발생한다면 아무런 소용이 없으므로, 품질은 단순히 기대하는 것이 아니라 강제되어야 합니다. 모든 모델에는 소유자와 고유성(uniqueness) 테스트가 지정됩니다. 기본 키(Primary key)는 에러 심각도 수준에서 고유성 및 null 아님(not null) 여부를 테스트합니다. 실제 로직(윈도우 함수, 다중 조인, 복잡한 매크로 등)이 포함된 모델은 단위 테스트가 필수적입니다. dbt-bouncer는 Databricks 언어(dialect)에 대한 sqlfluff와 함께 이러한 규칙을 위반하는 커밋을 차단하며, 외부 소비자가 읽는 레이어에는 계약(contract)이 강제 적용됩니다.
테스트 자체의 비용에도 동일한 원칙이 적용됩니다. 뷰 기반 검사는 실행할 때마다 뷰를 다시 계산하므로, 뷰에 대한 검사는 구체화(materialized)하거나 더 적은 패스로 병합합니다. 기본 검사는 열 제약 조건으로 변환되고 테스트 범위는 증분 데이터로 제한됩니다. 로컬에서 개발자는 프로덕션 매니페스트를 참조하므로 변경된 모델만 빌드되고 업스트림은 프로덕션에서 읽어옵니다. CI에서는 병합하기 전에 변경된 모델에 대해 단위 테스트 및 샘플링된 데이터 테스트를 실행합니다.
벤치마킹
| 측정 항목 | 변경 전 | 변경 후 |
|---|---|---|
| 핵심 작업의 일일 실행 시간 | ≈ 7시간 | 2시간 20분, 약 66% 감소 |
| 매일 밤 전체 새로고침 | KPI를 올바르게 유지하기 위해 필요함 | 폐지됨 |
| 실행당 스캔된 행 수(통합 모델) | ≈ 250억 개(매일 증가 중) | 스캔된 행 수 75% 감소 |
| 일일 컴퓨팅 비용 | 58% 절감 | |
| 실행당 재계산된 자산 | 전체 풀의 거의 대부분 | 풀의 ≈ 3 ~ 5% |
향후 계획
현재 파이프라인은 배치 방식으로 작동합니다. 즉, 하루에 한 번 수집이 완료되면 그 위에서 시맨틱 레이어가 실행되어 초기 예측치를 내놓고, 지연 데이터가 도착함에 따라 이를 수렴시킵니다. 이번 협업 과정에서 권장된 세 가지 작업을 적용하면 이를 더욱 발전시켜 실시간에 가까운 KPI를 구현할 수 있습니다.
- Change Data Feed를 통해 변경된 내용만 소비합니다. Delta Lake의 Change Data Feed를 사용하면 다운스트림 모델이 입력을 다시 스캔하는 대신 업스트림에서 변경된 행만 읽을 수 있습니다. 이를 통합 모델 및 그 종속 모델에 적용하면 조정(reconciliation) 작업이 "최근 윈도우 스캔"에서 "이동된 정확한 행 처리"로 축소되며, 이는 재계산 범위를 제한한 후 자연스럽게 이어지는 다음 단계입니다.
- 더 낮은 대기 시간의 수집(ingestion). 다운스트림의 아키텍처를 변경하지 않고도 하루에 한 번 수행되던 로드를 스트리밍 수집 경로(Auto Loader 또는 대기 시간이 짧은 Lakeflow Connect 커넥터)로 전환할 수 있습니다. 이것만으로도 데이터 최신성을 일 단위에서 분 단위로 단축할 수 있습니다.
- 선언적 스트리밍 변환. 동일한 변환 로직을 매일 밤 실행되는 배치가 아니라 스트림을 읽는 Lakeflow Declarative Pipeline으로 지속적으로 실행할 수 있으며, 이벤트가 도착할 때 상태 저장 처리(stateful processing)를 통해 자산별 조정을 처리할 수 있습니다.
관건은 기술이 아니라 비즈니스 요구사항입니다. 메트릭이 다음 날 아침이 아니라 실제로 몇 분 내에 최신 상태로 유지되어야 하는 경우, 이 경로를 통해 동일하게 거버넌스된 테이블에서 동일한 dbt 정의 로직으로 이를 제공할 수 있습니다. 일일 새로고침으로 충분한 경우에는 기존 배치 파이프라인이 이미 더 저렴한 해결책입니다.
결론
이 솔루션의 핵심은 명확한 역할 분담에 있습니다. 변환 로직은 모듈화 및 테스트를 거쳐 dbt에 그대로 유지되고, 데이터는 단일 Unity Catalog 거버넌스 모델 하에 개방형 Delta Lake 형식으로 안전하게 보관됩니다. 덕분에 테이블을 재구축하더라도 데이터 리니지와 액세스 제어가 유실되지 않으며, 특정 쿼리 엔진에 종속되지 않습니다. 이 dbt 로직은 대규모 확장을 위해 설계된 Databricks 기능인 리퀴드 클러스터링(liquid clustering), Delta 증분 쓰기, 동적 파일 프루닝(dynamic file pruning), H3 지리 공간 함수로 컴파일되어 실행됩니다. 컴파일된 SQL 대신 실제 쿼리 계획을 통해 문제를 진단하고, 비용이 많이 드는 정렬 및 셔플 단계로 전달되는 행의 수를 줄일 수 있습니다. 또한 프로젝트를 모델별 태스크 그래프로 실행하여 운영 가시성을 확보하고 적은 오버헤드로 안전하게 재실행할 수 있습니다. 가장 큰 성과는 클러스터 크기를 키우는 것이 아니라 작업량을 줄이는 데서 나왔습니다. 즉, 처리하는 행의 수를 줄이고, 재계산하는 자산을 최소화하며, 테이블 재구축 빈도를 크게 낮추는 것입니다.
(이 글은 AI의 도움을 받아 번역되었습니다. 원문이 궁금하시다면 여기를 클릭해 주세요)
최신 게시물을 이메일로 받아보세요
블로그를 구독하고 최신 게시물을 이메일로 받아보세요.