Databricks 앱 실습 가이드
01 | Databricks 앱 빌드 소개
AI와 분석 기능이 조직 전반에서 성숙해지면서 새로운 과제가 생겼어요. 사람들이 실제로 사용할 수 있는 형태로 통찰력을 제공하는 거예요.
오늘날 데이터 팀은 탐색과 분석을 위한 강력한 도구를 갖추고 있습니다. 노트북은 빠른 반복 작업을 지원하고, 대시보드는 광범위한 가시성을 지원하며, 모델은 예측과 자동화를 주도합니다. 그러나 비즈니스 요구사항이 워크플로에 내장된 AI 어시스턴트나 특정 운영 프로세스에 맞춰진 맞춤형 도구처럼 실시간 데이터와 사용자 입력을 결합하는 대화형 애플리케이션으로 전환될 때 팀은 종종 어려움에 직면합니다.
과거에는 프로덕션 애플리케이션을 빌드하려면 데이터 플랫폼 외부로 완전히 나가야 했습니다. 분석에서 애플리케이션으로 이동한다는 것은 인프라 프로비저닝, 데이터베이스 구성, 인증 구현, 배포 파이프라인 설정, 보안 검토 탐색을 의미했습니다. 각 단계는 애플리케이션의 비즈니스 가치에 직접적으로 기여하지 않으면서 비용, 위험, 시간을 추가했습니다. 많은 조직에서 이러한 마지막 마일의 과제로 인해 애플리케이션이 몇 달씩 지연되거나 아예 출시되지 못하는 경우가 있었습니다.
문제는 데이터나 AI 역량 부족이 아닙니다. 다른 사람들이 사용할 수 있도록 신뢰할 수 있는 프로덕션급 애플리케이션으로 이러한 기능을 제공하는 것이 어렵기 때문입니다.
이 가이드는 그 격차를 해소하는 데 도움이 됩니다. 실용적인 워크스루, 작동하는 코드 예제 및 실제 패턴을 통해 Databricks Apps와 Lakebase를 함께 사용하여 플랫폼을 벗어나지 않고도 애플리케이션을 작동하는 프로토타입에서 프로덕션 애플리케이션으로 전환하는 방법을 배우게 됩니다.
애플리케이션 배포 과제
오늘날 데이터 및 AI 애플리케이션을 구축하는 팀에게 작동하는 프로토타입에서 프로덕션 배포로 가는 길은 차별성 없는 과중한 작업으로 가득 차 있습니다. 분석을 확장하는 Python에 능숙한 데이터 엔지니어이든 lakehouse 데이터를 기반으로 구축하는 JavaScript 개발자이든 동일한 장애물에 부딪히게 됩니다.
- 인프라 프로비저닝 및 관리: 모든 애플리케이션은 실행될 공간이 필요합니다. 전통적으로 이는 VM 또는 컨테이너를 프로비저닝하고, 로드 밸런서를 구성하고, SSL 인증서를 설정하고, 확장 정책을 관리하는 것을 의미합니다.
- 인증 및 보안 복잡성: 프로덕션 애플리케이션에는 안전한 인증 흐름, 자격 증명 관리 및 액세스 제어가 필요합니다. OAuth(개방형 인증)를 올바르게 구현하고, 보안 비밀을 순환하며, 보안 정책을 준수하려면 전문 지식이 필요합니다. 잘못 구현하면 취약점이 발생하고, 제대로 구현하려면 상당한 엔지니어링 노력이 필요합니다.
- 데이터 동기화 및 지연: 대화형 애플리케이션은 데이터에 대한 빠른 액세스가 필요하지만 분석 데이터 스토어는 사용자 대면 애플리케이션에 필요한 짧은 지연 시간과 high concurrency 액세스 패턴에 최적화되어 있지 않아요. 분석 시스템에서 운영 데이터베이스로 데이터를 이동하는 파이프라인을 구축하고 데이터를 최신 상태로 유지하면 또 다른 복잡성과 잠재적 장애 지점이 가중돼요.
- 배포 자동화 및 환경 관리: 개발에서 스테이징, 프로덕션으로 코드를 이동하려면 지속적인 통합 및 지속적인 제공(CI/CD) 파이프라인, 환경 구성 및 세심한 조정이 필요합니다.
- 거버넌스 및 규정 준수: 엔터프라이즈 애플리케이션은 데이터 액세스 정책을 준수하고 감사 추적을 유지하며 세분화된 권한을 적용해야 합니다. 데이터 플랫폼에 이미 설정된 거버넌스와 별개로 애플리케이션 코드에 거버넌스 제어를 구현하면 작업이 중복되고 정책 드리프트가 발생할 수 있습니다.
이러한 과제는 실질적인 비용을 발생시킵니다. 배포 복잡성은 추진력을 저해합니다. 변경사항을 빠르고 자신 있게 제공할 수 없으면 반복 작업이 느려지고 팀 간의 조율에 시간을 낭비하게 됩니다. 그 결과, 귀중한 기능들은 더 넓은 조직이 아닌 일부 기술 사용자만 접근할 수 있는 상태로 데이터 플랫폼 내에 갇히게 됩니다.
Databricks 앱 및 Lakebase: 통합 애플리케이션 플랫폼
Databricks는 애플리케이션 호스팅과 운영 데이터베이스를 데이터 인텔리전스 플랫폼으로 직접 가져와서 이러한 문제를 해결해요. Databricks는 애플리케이션을 위한 별도의 인프라를 필요로 하지 않고 앱이 의존하는 데이터 및 AI 기능과 함께 실행되는 통합 솔루션을 제공해요.
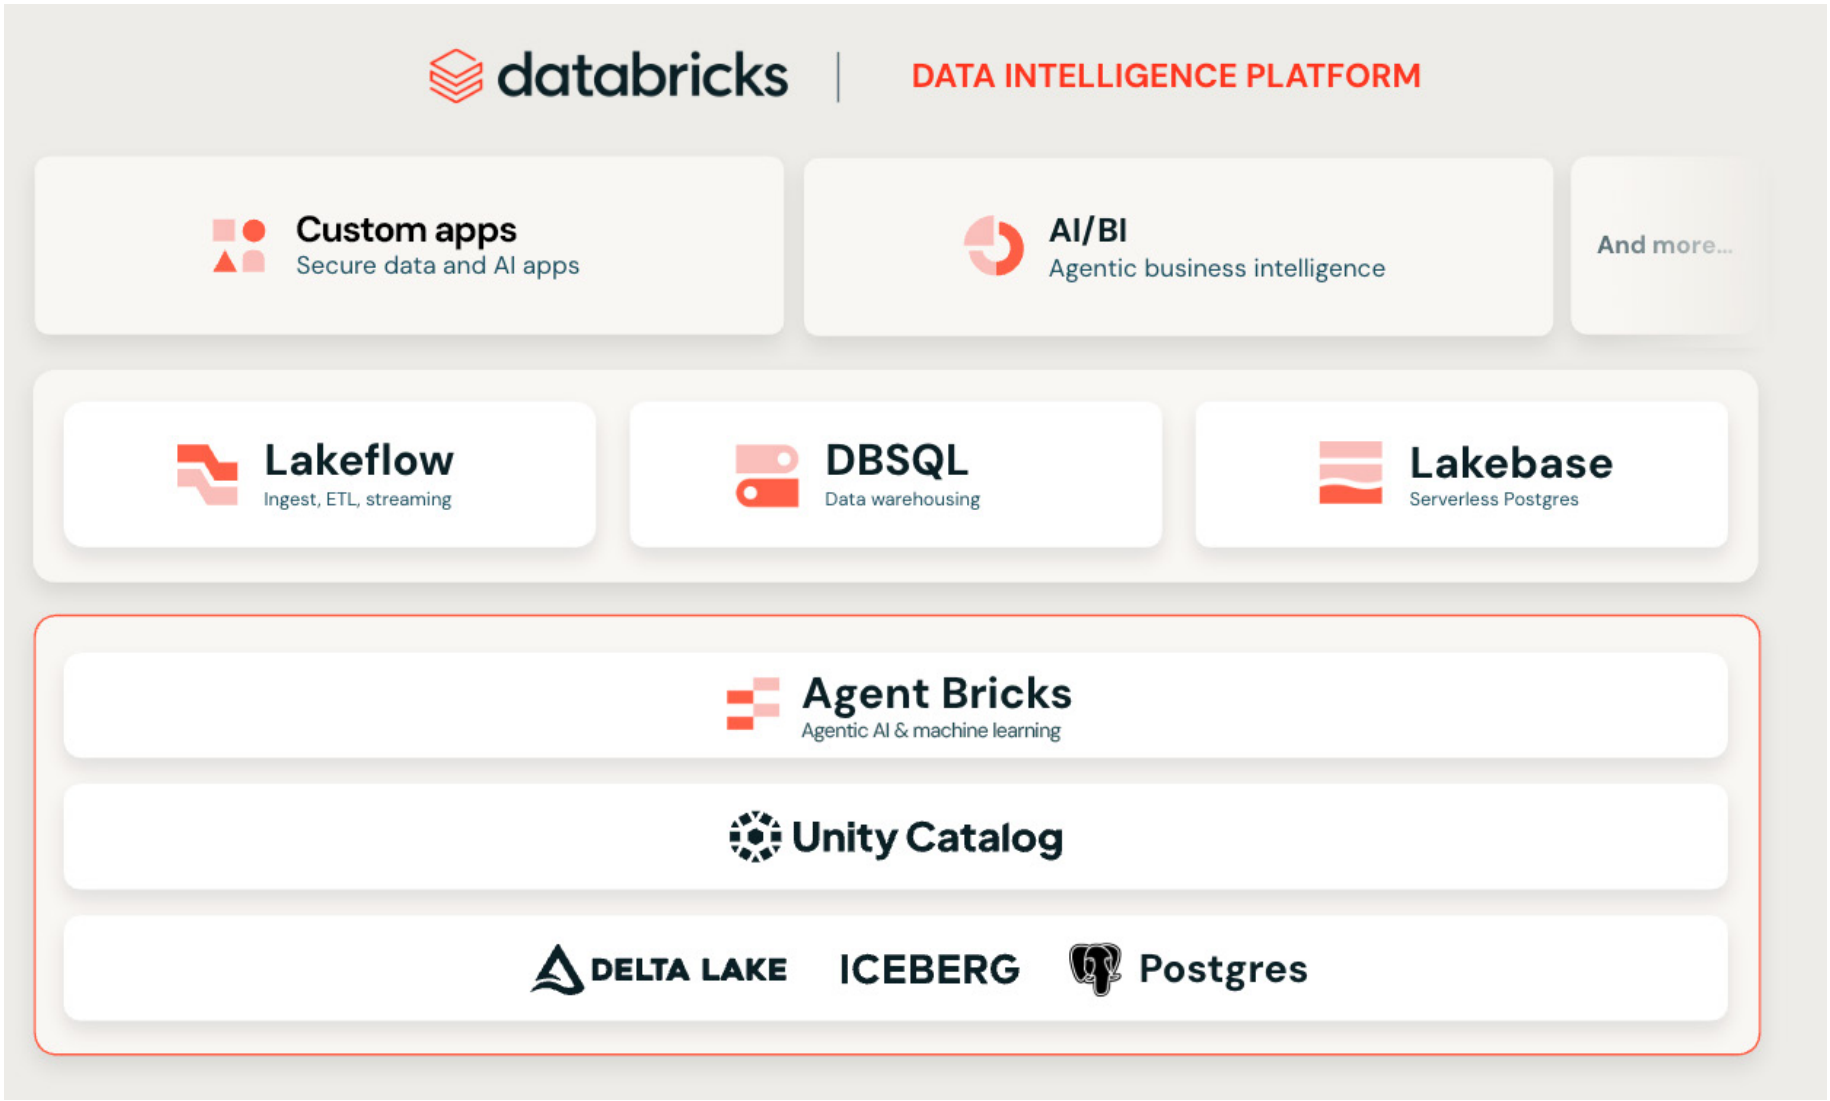
Databricks Apps는 Streamlit, Dash, Flask, FastAPI, React와 같은 오픈 소스 프레임워크로 구축된 웹 애플리케이션을 실행하기 위한 Serverless 애플리케이션 호스팅 플랫폼을 제공합니다. 애플리케이션은 플랫폼에 내장된 보안, 규정 준수 및 리소스 관리 기능을 상속받습니다. 프로비저닝할 인프라, 관리할 컨테이너, 구성할 확장 정책이 없습니다. 앱은 거버넌스를 위해 Unity Catalog와 자동으로 통합되며, 앱 수준 액세스를 위한 Service Principal 인증과 사용자 수준 권한을 위한 사용자 위임 권한 부여를 모두 지원합니다.
Lakebase는 레이크하우스와 긴밀하게 통합된 완전 관리형 PostgreSQL 데이터베이스입니다. 대화형 애플리케이션에 필요한 트랜잭션, 짧은 지연 시간의 데이터 액세스를 제공하는 동시에 Unity Catalog 테이블의 데이터를 자동으로 동기화합니다. Lakebase를 사용하면 다음을 수행할 수 있습니다.
- 실시간으로 애플리케이션에 분석적 인사이트를 제공합니다
- 애플리케이션 상태 및 사용자 입력 저장
- 완벽한 원자성, 일관성, 격리성, 지속성(ACID) 트랜잭션 지원을 유지합니다.
사용자 지정 ETL(추출, 변환, 로드) 파이프라인을 구축하거나 데이터베이스 인프라를 관리하지 않고도 이 모든 것이 가능합니다.
이러한 기능들이 함께 새로운 가능성을 엽니다.
| 기존 접근 방식 | 최신 DATABRICKS APPS 및 LAKEBASE 접근 방식 |
|---|---|
| 분리된 호스팅 인프라 | Serverless 컴퓨팅 및 제로 인프라 관리 |
| 맞춤형 인증 시스템 | 내장된 OAuth 및 Unity Catalog 통합 |
| 수동 데이터 동기화 파이프라인 | Unity Catalog의 자동 동기화 테이블 |
| 여러 시스템에 걸쳐 분산된 거버넌스 | Unity Catalog를 통한 통합 거버넌스 |
| 복잡하고 다양한 도구를 활용한 배포 | Databricks 자산 Bundles(DAB)를 사용한 단일 명령 배포 |
역사적으로 OLTP와 OLAP 시스템을 연결하는 데에는 복잡한 데이터 엔지니어링과 맞춤형 통합 레이어가 필요했어요. 애플리케이션을 배포하려면 별도의 DevOps 팀, 서로 다른 CI/CD 파이프라인, 수동 보안 구성이 필요했어요. 레이크베이스와 데이터브릭스 앱을 함께 사용하면 이러한 복잡성이 크게 줄어들어요. 개발자들은 트랜잭션 계층에서 직접 실시간 분석 데이터에 액세스하고 몇 달이 아니라 몇 분 만에 대화형 애플리케이션을 배포할 수 있어요.
이 가이드의 내용
이 가이드는 Databricks에서 프로덕션에 즉시 사용 가능한 데이터 및 AI 애플리케이션을 구축하기 위한 실습형 지침을 제공합니다. 개별 기능에 초점을 맞추기보다는 각 챕터에서 자체 사용 사례에 적용할 수 있는 작동 코드를 사용하여 완전한 애플리케이션 패턴을 안내합니다.
다음 방법을 알게 될 것입니다:
- 노트북 및 프로토타입에서 실제 애플리케이션으로 전환
- 트랜잭션 레이어를 통해 분석 데이터 및 애플리케이션 상태를 제공합니다.
- 맞춤형 인프라 없이 안전하고 관리되는 애플리케이션을 구축하세요.
- 반복 가능하고 프로덕션에 바로 사용할 수 있는 패턴을 사용하여 애플리케이션을 배포하고 운영합니다.
이 가이드가 끝나면 Databricks 플랫폼에서 자신 있게 지능형 애플리케이션을 빌드, 배포, 관리하는 방법을 명확하게 이해하게 될 것입니다.
02 | Notebook에서 프로덕션 애플리케이션으로
Pascal Vogel, Evan Pandya 및 Christopher Pries작성
프로덕션 데이터 애플리케이션의 과제
프로덕션에 사용할 수 있는 데이터 애플리케이션을 구축하는 것은 복잡합니다. 앱을 호스팅하고, 데이터베이스를 관리하며, 시스템 간에 데이터를 이동하려면 종종 별도의 도구가 필요합니다. 각 계층은 설정, 유지보수 및 배포 오버헤드를 추가합니다.
Databricks Data Intelligence Platform은 모든 것을 단일 플랫폼인 Databricks Data Intelligence Platform에 통합하여 이 과정을 단순화합니다. Databricks Apps는 Serverless 컴퓨팅에서 웹 애플리케이션을 실행합니다. Lakebase는 Unity Catalog와 동기화되는 관리형 Postgres 데이터베이스를 제공하여 앱이 거버넌스 적용 데이터에 빠르게 액세스할 수 있도록 합니다. 그리고 Databricks Asset Bundles(DAB)를 사용하면 코드, 인프라, 데이터 파이프라인을 함께 패키징하고 단일 명령으로 배포할 수 있습니다.
이 챕터에서는 Unity Catalog 데이터를 Lakebase에 동기화하는 것부터 Databricks 플랫폼에서 웹 앱을 실행하고 DABs로 배포를 자동화하는 것까지 이 세 가지 요소가 함께 작동하여 실제 데이터 애플리케이션을 빌드하고 배포하는 방법을 보여줍니다.
아키텍처 및 작동 방식
Unity Catalog Delta 테이블의 데이터가 몇 초 내에 자동으로 업데이트되고 Lakebase 동기화 테이블에서 읽어오는 React 및 FastAPI 애플리케이션인 전체 패턴을 보여주는 택시 여정 애플리케이션을 살펴보겠습니다.
다음 다이어그램은 솔루션 아키텍처를 단순하게 보여준대요.
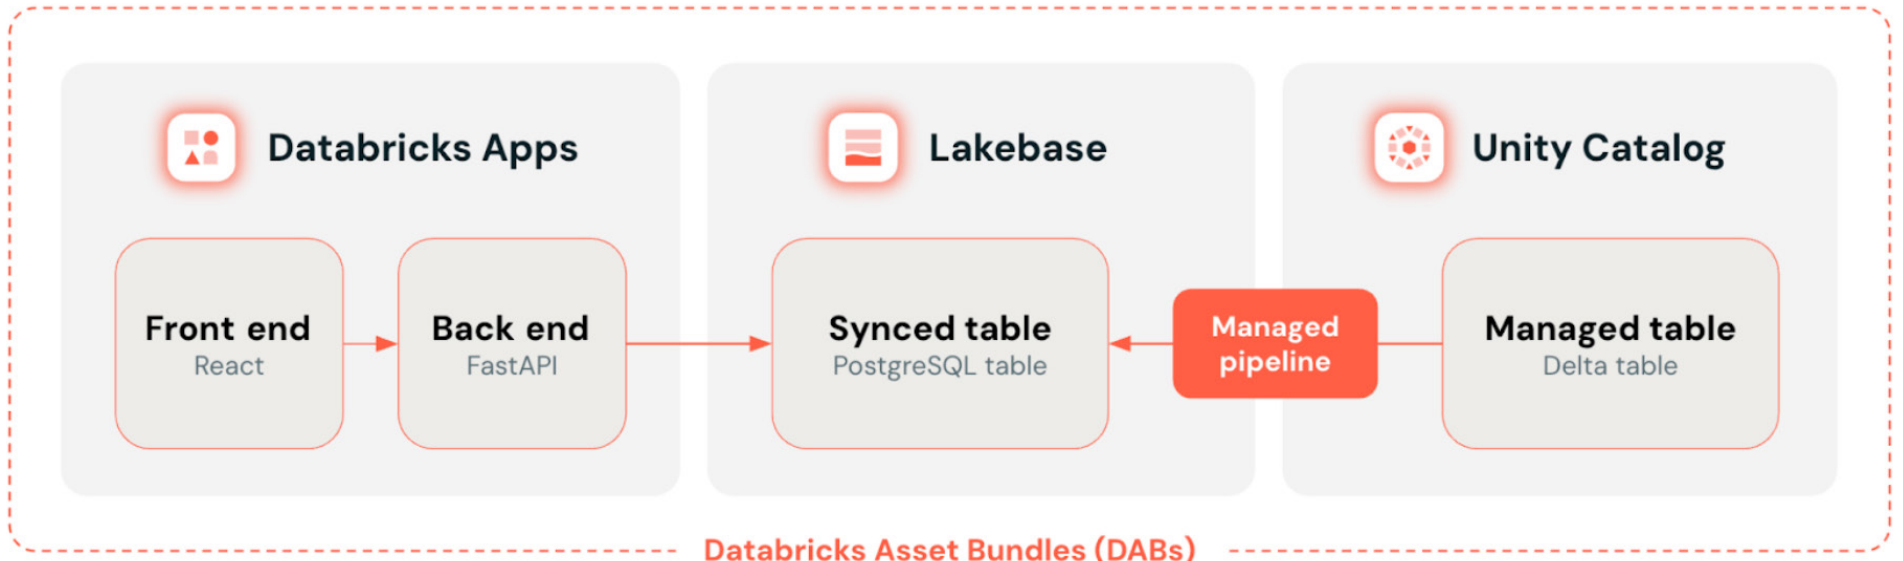
개괄적으로 Databricks Apps는 사용자가 데이터를 탐색하고 시각화하는 프런트엔드 역할을 합니다. Lakebase는 앱이 쿼리하는 Postgres 데이터베이스를 제공하여 동기화된 테이블을 통해 Unity Catalog의 실시간 데이터와 가깝게 유지합니다. DABs는 앱, 데이터베이스, 데이터 동기화 등 모든 리소스를 버전 제어되는 하나의 단위로 정의하고 배포하여 모든 것을 하나로 묶습니다.
주요 솔루션 구성 요소:
- Databricks app: Users interact with a web application built using React, TypeScript, Vite and FastAPI. 앱이 Lakebase Postgres 데이터베이스에 저장된 Unity Catalog 동기화 테이블에서 데이터를 읽어요.
- Unity Catalog 동기화 테이블: 관리형 동기화 파이프라인을 통해 Unity Catalog 테이블과 자동으로 동기화되고 Lakebase 데이터베이스 인스턴스에서 실행되는 읽기 전용 Postgres 테이블입니다.
- Lakebase 데이터베이스 인스턴스: Lakebase 스토리지 및 컴퓨팅을 관리하고 Databricks 앱이 연결할 수 있도록 Postgres 엔드포인트를 제공합니다.
- Unity 카탈로그 테이블:모든 데이터베이스 워크스페이스에서 사용할 수있는 samples.nyctaxi.trips 샘플 테이블에서 복제된 뉴욕시 택시 타기에 관한 데이터를 포함하는 Delta 테이블이에요.
- Databricks Asset Bundles (DABs): 아키텍처의 모든 핵심 요소가 코드로 정의된 번들입니다
예제 앱은 최근 택시 운행을 표 및 차트 형식으로 표시하고 새로운 운행을 자동으로 폴링합니다. 이는 Unity Catalog의 Delta 테이블을 미러링하는 Lakebase 동기화 테이블에서 데이터를 읽습니다.
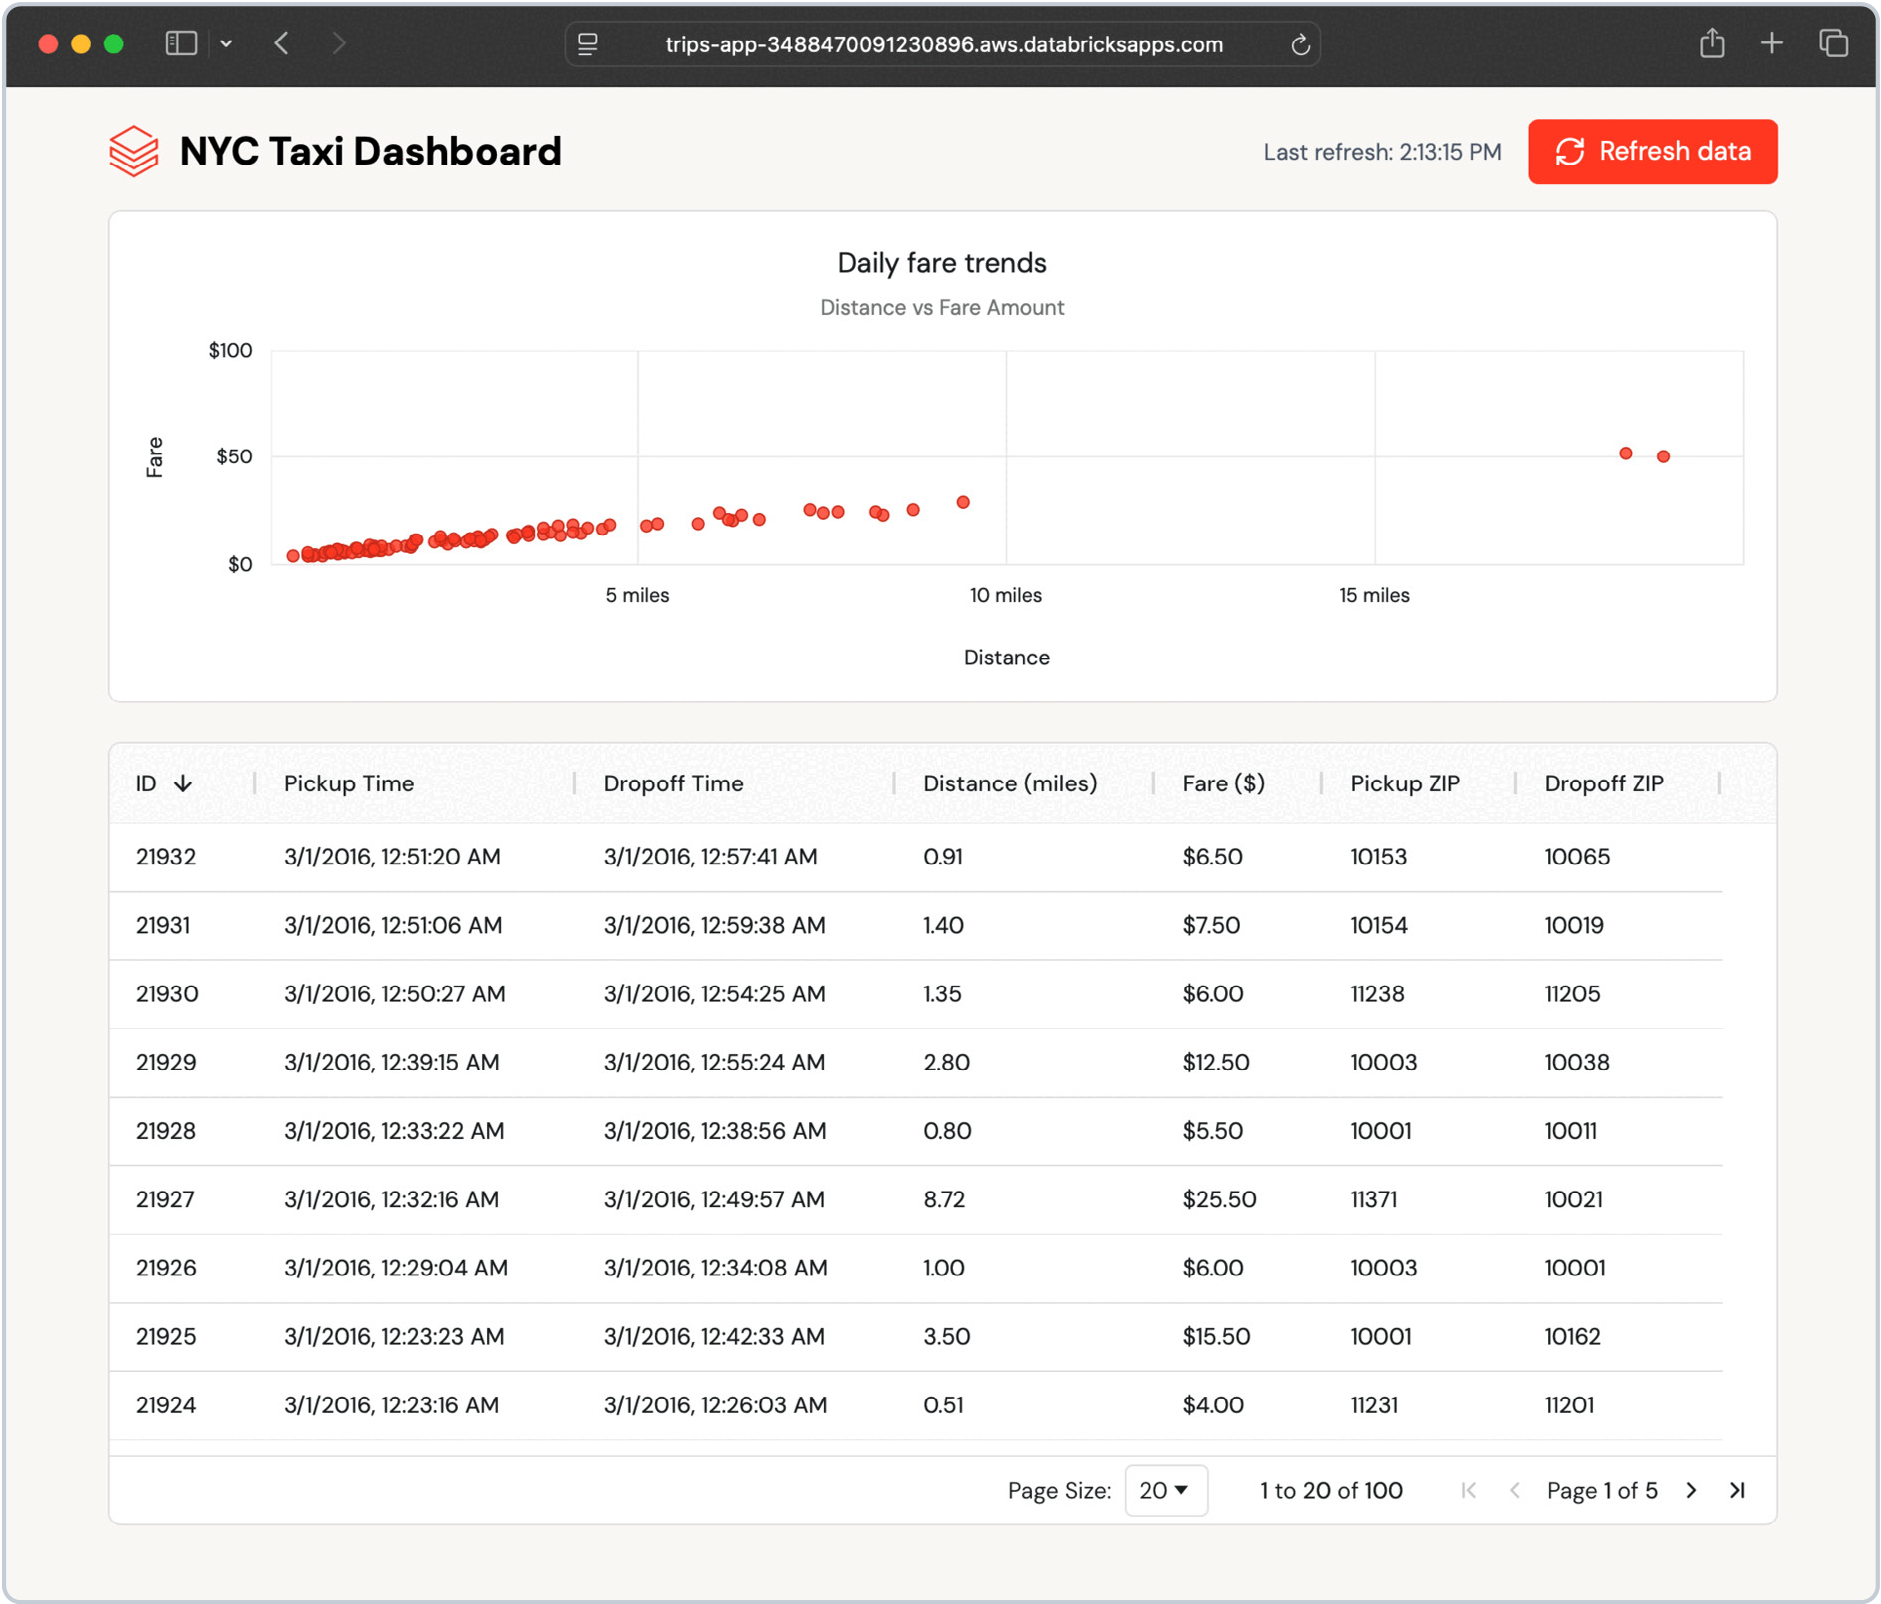
동기화된 테이블은 자동으로 업데이트되므로 Unity Catalog 테이블의 모든 변경 사항은 몇 초 내에 앱에 표시되며, 사용자 지정 ETL은 필요하지 않습니다.
소스 Delta 테이블에 새 데이터를 삽입한 다음 동기화된 테이블을 새로고침하여 이를 테스트할 수 있습니다.
그런 다음 동기화된 trips_synced 테이블의 새로고침을 트리거합니다.
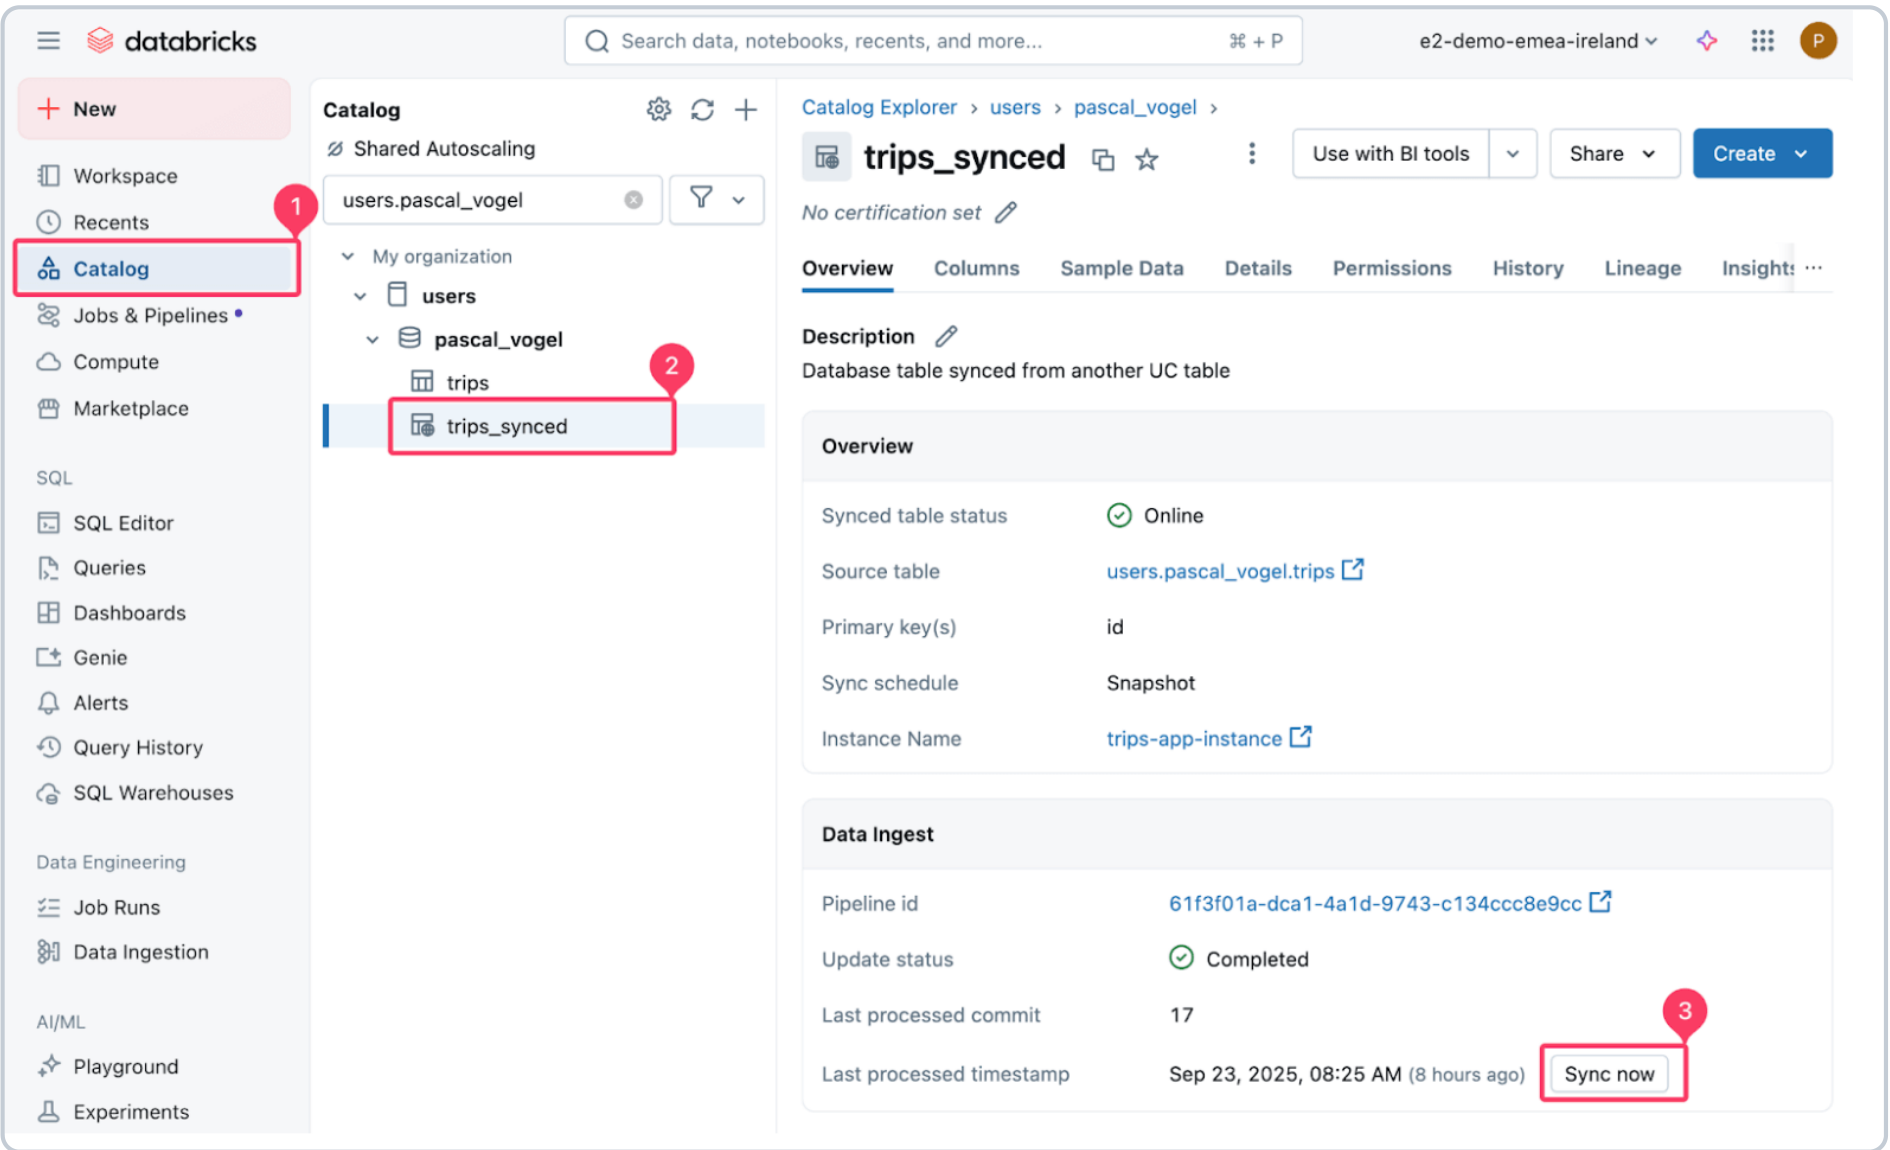
동기화를 지원하는 관리형 파이프라인은 소스 Delta 테이블의 스냅샷 복사본을 만들어 대상 Postgres 테이블에 씁니다.
몇 초 내에 새 레코드가 대시보드에 나타납니다. 앱은 업데이트를 폴링하고 사용자가 원할 때 새로고침할 수 있게 하여, Lakebase가 추가적인 엔지니어링 없이 운영 데이터를 어떻게 최신 상태로 유지하는지 보여줍니다.
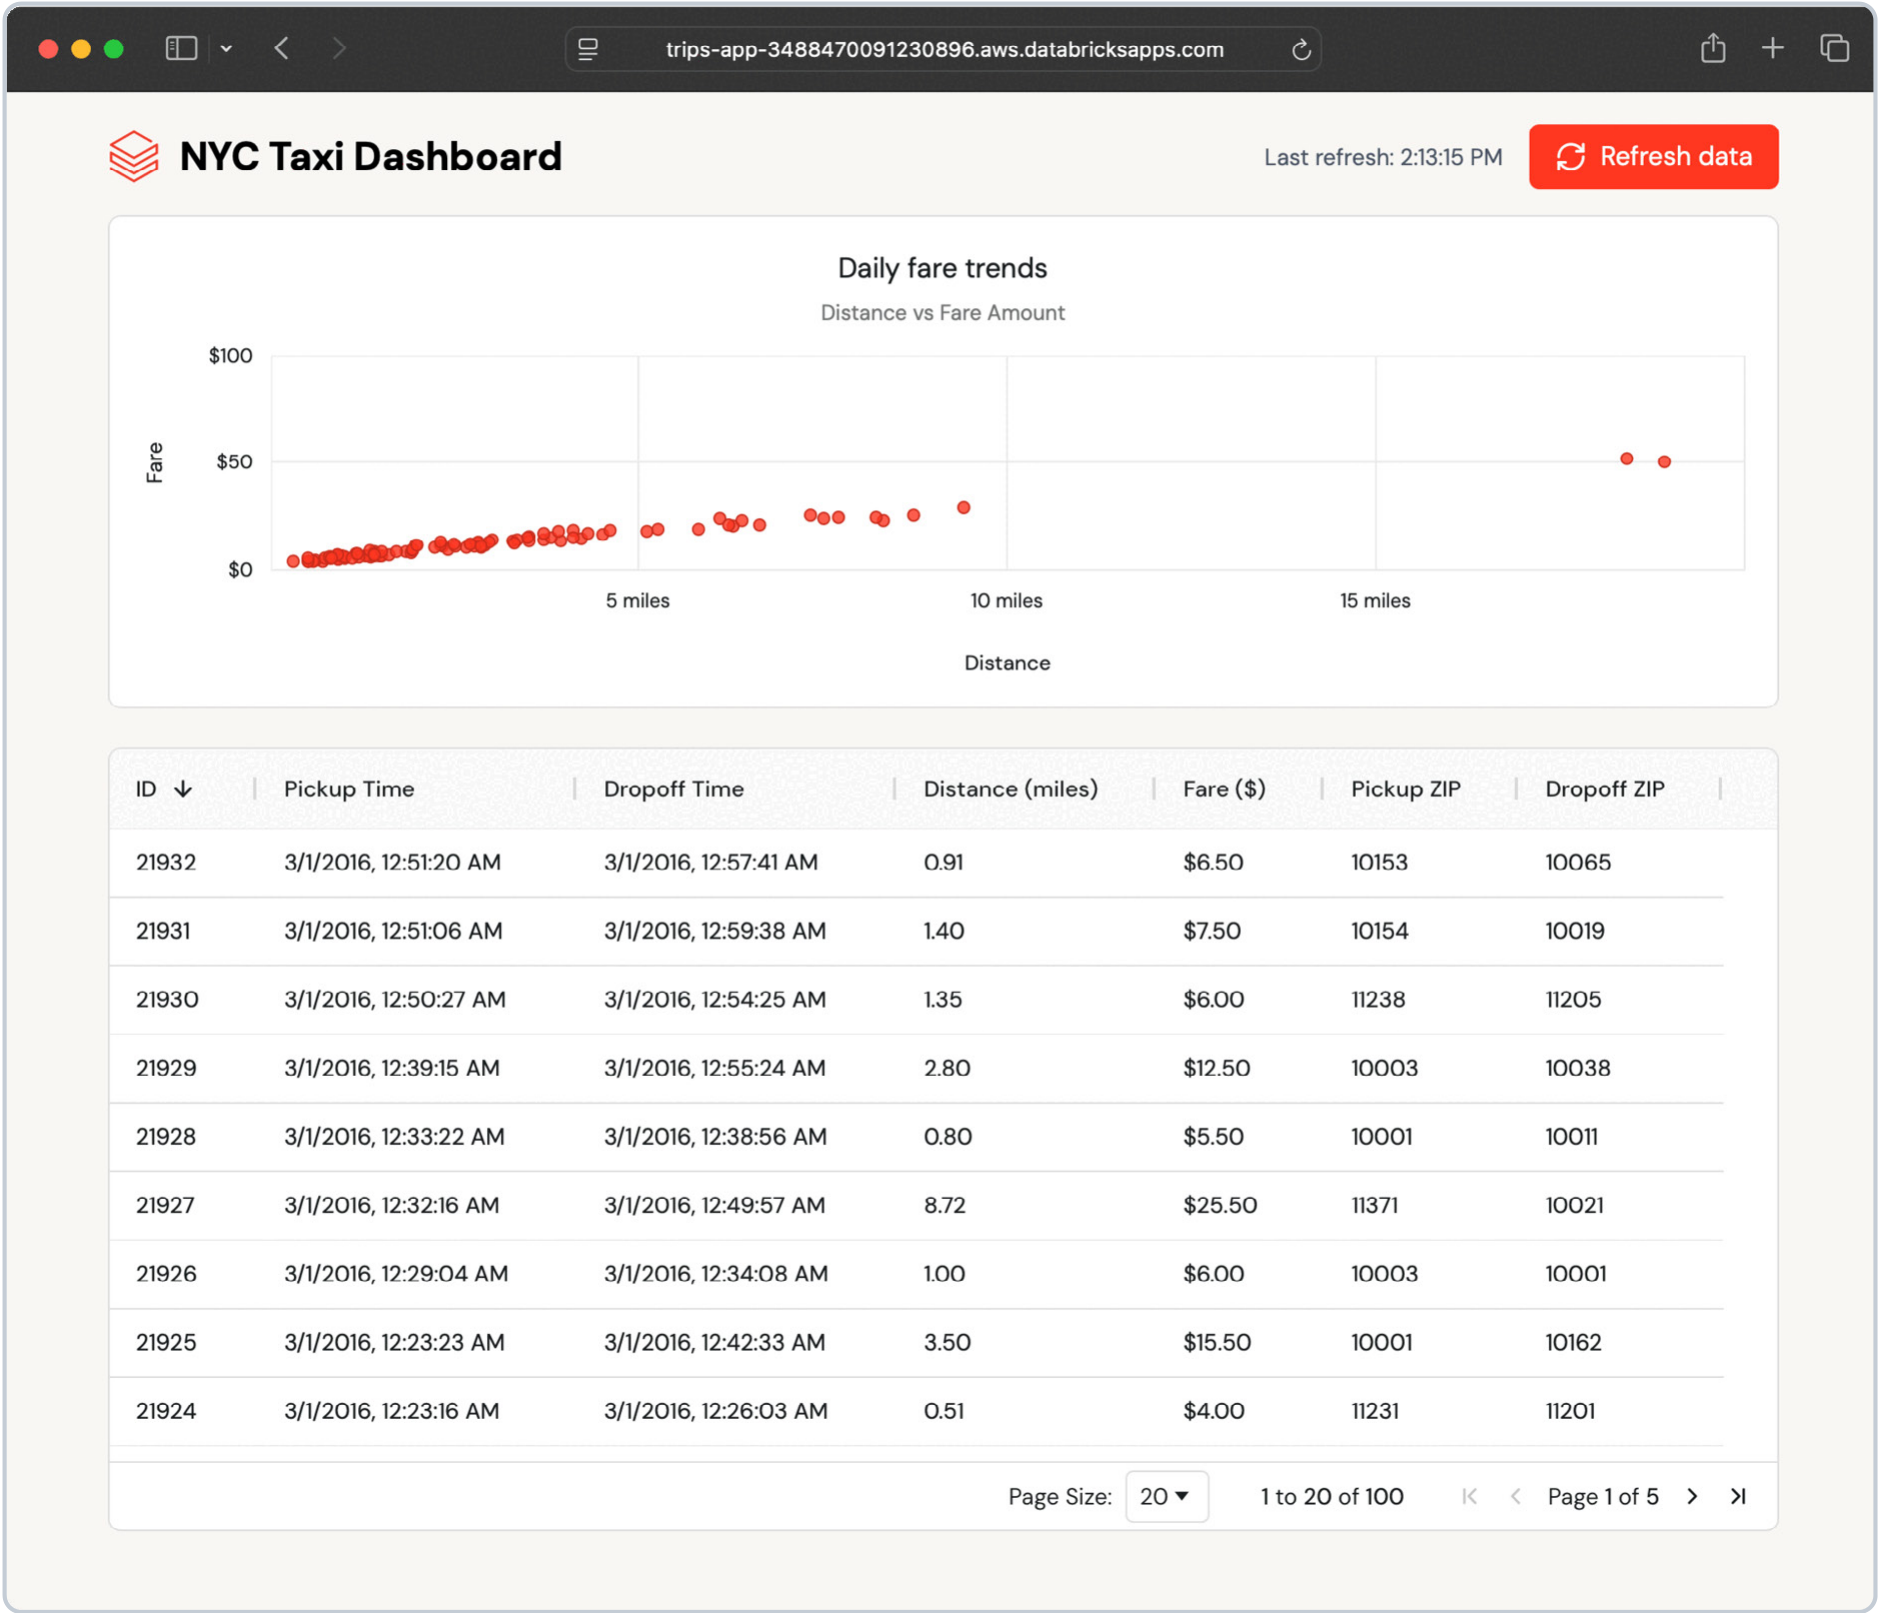
이렇게 원활한 데이터 흐름이 가능한 이유는 Lakebase 동기화 테이블이 모든 동기화를 자동으로 처리하기 때문이에요.
앱의 구조
Databricks 앱에서 솔루션의 다양한 요소가 어떻게 결합되는지 살펴봅시다.
인증 및 데이터베이스 연결
각 Databricks 앱에는 생성 시 할당되는 고유한 Service Principal ID가 있으며, 이 ID를 사용하여 Lakebase를 비롯한 다른 Databricks 리소스와 상호 작용합니다.
Lakebase는 OAuth M2M(machine-to-machine) 인증을 지원합니다. 앱은 Service Principal 자격 증명과 함께 Databricks SDK for Python 의 WorkspaceClient 를 사용하여 유효한 토큰을 얻을 수 있습니다. WorkspaceClient는 1시간 후에 만료되는 수명이 짧은 OAuth 토큰의 새로 고침을 처리합니다.
그런 다음 앱은 Psycopg Python Postgres 어댑터를 사용하여 Lakebase에 연결을 설정할 때 이 토큰을 사용합니다.
앱용 Lakebase 리소스를 사용할 때 Postgres 호스트와 데이터베이스 이름은 Databricks 앱의 환경 변수로 자동 설정됩니다.
Postgres 사용자는 Databricks 앱에 배포된 경우 앱 서비스 주체이거나, 앱을 로컬에서 실행하는 경우 해당 사용자의 Databricks 사용자 이름입니다.
RESTful FastAPI 백엔드
앱의 FastAPI 백엔드는 이 연결을 사용하여 Lakebase를 쿼리하고 동기화된 테이블에서 최신 이동 데이터를 가져옵니다.
FastAPI는 API 엔드포인트를 제공하는 것 외에도 StaticFiles 클래스를 사용하여 정적 파일을 제공할 수도 있습니다. Vite의 빌드 프로세스를 사용하여 React 프런트엔드를 번들링하면 FastAPI로 제공할 수 있는 정적 파일 세트를 생성할 수 있습니다.
React 프론트엔드
React 프런트엔드가 데이터를 표시하기 위해 FastAPI 엔드포인트를 호출합니다.
예제 애플리케이션은 시각화를 위해 ag-grid와 ag-charts를 사용하며 몇 초마다 자동으로 새 데이터를 확인합니다.
Databricks Asset Bundles 리소스 정의
위에 표시된 모든 Databricks 리소스와 애플리케이션 코드는 단일 소스 코드 리포지토리에서 DAB로 유지 관리할 수 있습니다. 이는 또한 모든 리소스를 단일 명령으로 Databricks 작업 공간에 배포할 수 있음을 의미합니다. 자세한 배포 지침은 GitHub 리포지토리를 참조하세요.
이를 통해 소프트웨어 개발 수명 주기가 단순화되고 개발, 스테이징, 프로덕션 환경 전반에서 CI/CD 모범 사례를 통해 배포할 수 있습니다.
다음 섹션에서는 번들 파일에 대해 더 자세히 설명합니다.
번들 구성
databricks.yml은 번들 설정 및 포함된 리소스의 형태로 DABs 번들 구성을 포함합니다.
이 예시에서는 개발 및 스테이징 환경만 정의합니다.
프로덕션 사용 사례의 경우 추가 환경을 추가하는 것을 고려하세요. 더 고급 구성 예제는 Databricks DAB 예제 리포지토리와 DAB 설명서를 참조하세요.
Lakebase 설정 및 Unity Catalog와 동기화
DAB에서 Lakebase 인스턴스를 정의하려면 database_instance 리소스를 사용하세요. 최소한 인스턴스의 용량 필드를 정의해야 합니다.
또한 Unity Catalog 테이블과 Postgres 테이블 간의 관리형 동기화 파이프라인을 설정하는 <a href=\" \">synced_database_table 리소스를 정의합니다.
이를 위해 `source_table_full_name`을 통해 소스 테이블을 정의합니다. Unity 카탈로그의 소스 테이블에는 primary_key_columns 필드에 정의된 업데이트를 처리하기 위한 고유 (복합) 기본 키가 필요해요.
Lakebase의 대상 테이블 위치는 대상 데이터베이스 객체(logical_database_name)와 테이블 이름(name)에 의해 결정됩니다.
동기화된 테이블은 Unity Catalog 객체이기도 해요. 이 리소스 정의에서는 databricks.yml에 정의된 dABS 변수를 사용하여 동기화된 테이블을 소스 테이블과 동일한 카탈로그 및 스키마에 배치해요. 다른 변수 값을 설정하여 이 기본값을 무시할 수 있어요.
이 사용 사례에서는 SNAPSHOT 동기화 모드를 사용합니다. 사용 가능한 옵션에 대한 설명은 이 장의 "고려사항 및 권장사항" 섹션을 참조하세요.
Databricks Apps 리소스
DAB를 사용하면 Databricks Apps 컴퓨팅 리소스를 앱 리소스로 정의하고 애플리케이션 소스 코드를 하나의 번들로 정의할 수 있어요. 이렇게 하면 Databricks 리소스 정의와 소스 코드를 모두 단일 리포지토리에 보관할 수 있어요. 저희의 경우, FastAPI와 Vite를 기반으로 하는 앱 소스 코드는 프로젝트의 최상위 앱 디렉토리에 저장됩니다.
구성은 database.yml 리소스 정의에 정의된 database_name 및 instance_name을 동적으로 참조합니다.
데이터베이스는 DAB에서 정의할 수 있는 지원되는 앱 리소스입니다. 데이터베이스를 앱 리소스로 정의하면 앱 서비스 주체가 Lakebase 인스턴스와 상호 작용할 때 사용할 Postgres 역할을 자동으로 생성해요.
고려 사항 및 권장사항
모듈식 및 재사용 가능한 번들 만들기
이 예제에서는 개발 및 스테이징 환경에 배포하지만 DAB를 사용하면 개발 수명 주기에 맞게 여러 환경을 쉽게 정의할 수 있습니다. Azure DevOps, GitHub Actions 또는 기타 DevOps 플랫폼으로 CI/CD 파이프라인을 설정하여 이러한 환경 전반에 배포를 자동화하세요.
환경별 구성을 정의하려면 DABs 대체 및 변수를 사용하세요. 예를 들어, 비용 절감을 위해 개발 및 프로덕션 환경에 서로 다른 Lakebase 인스턴스 용량 구성을 정의할 수 있습니다. 마찬가지로, 환경별 데이터 지연 시간 요구 사항을 충족하기 위해 동기화된 테이블에 서로 다른 Lakebase 동기화 모드를 정의할 수 있습니다.
Lakebase 동기화 모드 선택 및 성능 최적화
적절한 Lakebase 동기화 모드를 선택하는 것이 비용과 데이터 최신성의 균형을 맞추는 열쇠예요.
| 스냅샷 | Trigger됨 | 연속 | |
|---|---|---|---|
| 업데이트 방법 | 매 실행 시 전체 테이블 교체 | 초기 전체 복사 및 증분 변경 사항 | 초기 로드 및 실시간 스트리밍 업데이트 |
| 성능 | 다른 모드보다 10배 더 효율적 | 비용과 성능의 균형 | 더 높은 비용 — 지속적인 실행 |
| 지연 시간 | 높은 지연 시간 — 예약 또는 수동 | 중간 지연 시간 — 온디맨드 | 가장 낮은 지연 시간 — 실시간, 약 15초 |
| 최적 대상 |
|
|
|
| 제한 사항 |
|
|
|
관리형 동기화 파이프라인이 실패할 경우를 대비해 알림을 설정하세요.
쿼리 성능을 향상시키려면 적절한 인스턴스 용량을 선택하여 Lakebase 데이터베이스 인스턴스의 크기를 적절하게 조정하세요. Postgres의 동기화된 테이블에 쿼리 패턴에 맞는 인덱스를 만들고 사전 설치된 pg_stat_statements 확장 프로그램을 사용하여 쿼리 성능을 조사해 보세요.
프로덕션을 위한 앱 준비
예제 애플리케이션은 폴링 기반 접근 방식을 구현하여 Lakebase에서 최신 데이터를 가져옵니다. 요구 사항에 따라 웹 소켓이나 서버 전송 이벤트를 사용하여 푸시 기반 접근 방식을 구현하여 서버 리소스를 더 효율적으로 사용하고 데이터 업데이트의 적시성을 높일 수도 있어요.
FastAPI 백엔드가 데이터베이스 Trigger할 필요성을 줄여 더 많은 앱 사용자로 확장하려면 query 결과의 인메모리 캐싱을 위해 fastapi-cache와 같은 캐싱 구현을 고려하세요.
권한 부여 및 인증에는 OAuth 2.0을 사용하고, 레거시 개인용 액세스 토큰(PAT)에 의존하지 마세요. 로컬 머신에서 개발하는 동안 Databricks 명령줄 인터페이스(CLI)를 사용하여 OAuth U2M 인증을 설정하면 Lakebase와 같은 라이브 Databricks 리소스와 원활하게 상호 작용할 수 있습니다.
마찬가지로, 배포한 앱은 다른 Databricks 서비스와의 OAuth M2M 인증 및 권한 부여에 관련 서비스 주체를 사용해요. 아니면 앱 사용자를 대신하여 Databricks 리소스에서 작업을 수행하도록 앱 사용자 인증을 설정하세요.
추가적인 일반 및 보안 권장사항은 Databricks Apps 문서의 Databricks Apps 권장사항도 참조하세요.
결론
프로덕션 데이터 애플리케이션을 구축하는 것이 배포, 데이터 동기화, 인프라 관리를 위해 여러 도구를 복잡하게 다루는 것을 의미해서는 안 됩니다. Databricks Apps은(는) 인프라를 관리할 필요 없이 Python 및 Node.js 애플리케이션을 실행할 수 있는 Serverless 컴퓨팅을 제공합니다. Lakebase 동기화 테이블은 Unity Catalog Delta 테이블의 지연 시간이 짧은 데이터를 Postgres로 자동으로 제공하여 맞춤형 ETL 파이프라인의 필요성을 없애줍니다. DAB는 애플리케이션 코드, 인프라 정의 및 데이터 동기화 구성을 환경 전반에 걸쳐 일관되게 배포되는 단일 버전 제어 번들로 패키징할 수 있게 하여 이 모든 것을 하나로 묶어줍니다.
배포 복잡성은 추진력을 저해합니다. 변경 사항을 빠르고 자신 있게 제공할 수 없으면 이터레이션이 느려지고 환경 드리프트가 발생하며 팀 간 조율에 시간을 낭비하게 됩니다. DABs를 사용하여 전체 애플리케이션 스택을 코드로 취급하면 다음과 같습니다.
- CI/CD 자동화 활성화
- 개발, 스테이징 및 프로덕션 환경 전반에 걸쳐 일관된 배포를 보장합니다.
- 팀이 배포 파이프라인과 씨름하는 대신 기능 구축에 집중할 수 있도록 하세요
이렇게 하면 일반적인 배포 문제 없이 프로토타입에서 프로덕션으로 전환할 수 있습니다.
단계별 배포 지침이 포함된 전체 예제는 GitHub 리포지토리에서 확인할 수 있습니다.
시작하기
Databricks 설명서를 참조하여 Lakebase, Databricks Apps 및 DAB에 대해 자세히 알아보세요. Databricks Apps에 대한 더 많은 개발자 리소스는 Databricks Apps Cookbook 및 Cookbook 리소스 컬렉션을 참조하세요.
03 | 지능형 애플리케이션을 위한 트랜잭션 기반
작성자: Jasper Puts 및 Antonio Javier Samaniego Jurado
소개
기존 방식대로 내부 도구나 AI 기반 애플리케이션을 구축하면 개발자는 반복적이고 오류 발생 가능성이 높은 작업의 미로에 빠지게 됩니다. 먼저 전용 Postgres 인스턴스를 가동하고 네트워킹, 백업 및 모니터링을 구성한 다음 사용 중인 프런트 엔드 프레임워크에 데이터베이스를 구축하는 데 몇 시간 또는 며칠을 소비해야 해요. 또한 사용자 지정 인증 흐름을 작성하고, 세분화된 권한을 매핑하고, UI, API 계층 및 데이터베이스 전체에서 이러한 보안 제어를 동기화된 상태로 유지해야 해요. 관리형 클라우드 서비스부터 자체 호스팅 VM까지 각 애플리케이션 구성 요소가 다른 환경에 있어요. 이로 인해 개발자들은 서로 다른 배포 파이프라인, 환경 변수, 자격 증명 저장소를 이리저리 헤매야 해요. 그 결과, 스키마 마이그레이션이나 새로운 역할 추가와 같은 단일 변경 사항이 여러 시스템에 파급되어 수동 업데이트, 광범위한 테스트 및 지속적인 조정이 요구되는 파편화된 스택이 생성됩니다. 이 모든 오버헤드로 인해 개발자들은 제품의 핵심 기능 및 인텔리전스 구축이라는 진정한 부가 가치를 창출하는 데 집중하지 못해요.
Databricks Lakebase 및 Databricks 앱을 사용하면 전체 애플리케이션 스택이 레이크하우스와 함께 위치합니다. Lakebase는 분석 및 AI 워크로드를 지원하는 기본 lakehouse 테이블과 통합되어 짧은 지연 시간의 읽기 및 쓰기를 제공하는 완전 관리형 Postgres 데이터베이스입니다.
Databricks Apps는 Lakebase가 제공하는 동일한 데이터에 자동으로 적용되는 내장된 인증, 세분화된 권한 및 거버넌스 제어와 함께 UI용 Serverless 런타임을 제공합니다. 이를 통해 여러 플랫폼을 연결하거나, 데이터베이스를 동기화하거나, 파이프라인을 복제하거나, 시스템 전반의 보안 정책을 조정할 필요 없이 트랜잭션 상태, 분석, AI를 결합하는 앱을 쉽게 빌드하고 배포할 수 있습니다.
Lakebase와 Databricks 앱을 사용하는 이유
Lakebase와 Databricks 앱은 함께 작동하여 Databricks 플랫폼에서 전체 스택 개발을 간소화합니다.
- Lakebase는 빠른 읽기, 쓰기, 업데이트가 가능한 완전 관리형 Postgres 데이터베이스와 브랜칭 및 지정 시간 복구와 같은 최신 기능을 제공합니다.
- Databricks Apps는 내장된 ID 액세스 제어 및 Unity Catalog, 기타 lakehouse 구성 요소와의 통합 기능을 갖춘 애플리케이션 프런트 엔드를 위한 Serverless 런타임을 제공합니다.
이 두 가지를 결합하면 Lakebase에 상태를 저장 및 업데이트하고, lakehouse의 거버넌스 적용 데이터를 액세스하며, 별도의 인프라를 관리할 필요 없이 안전한 Serverless UI를 통해 모든 것을 제공하는 대화형 도구를 구축할 수 있습니다. 다음 예시에서는 이 설정을 사용하여 간단한 휴가 요청 승인 앱을 빌드하는 방법을 보여 드리겠습니다.
시작하기: Lakebase로 트랜잭션 앱 빌드
이 단계별 안내에서는 관리자가 팀의 휴가 요청을 검토하고 승인하는 데 도움이 되는 간단한 Databricks 앱을 만드는 방법을 보여줍니다. 이 앱은 Databricks Apps를 사용하여 빌드되었으며 요청을 저장하고 업데이트하기 위해 Lakebase를 백엔드 데이터베이스로 사용합니다.
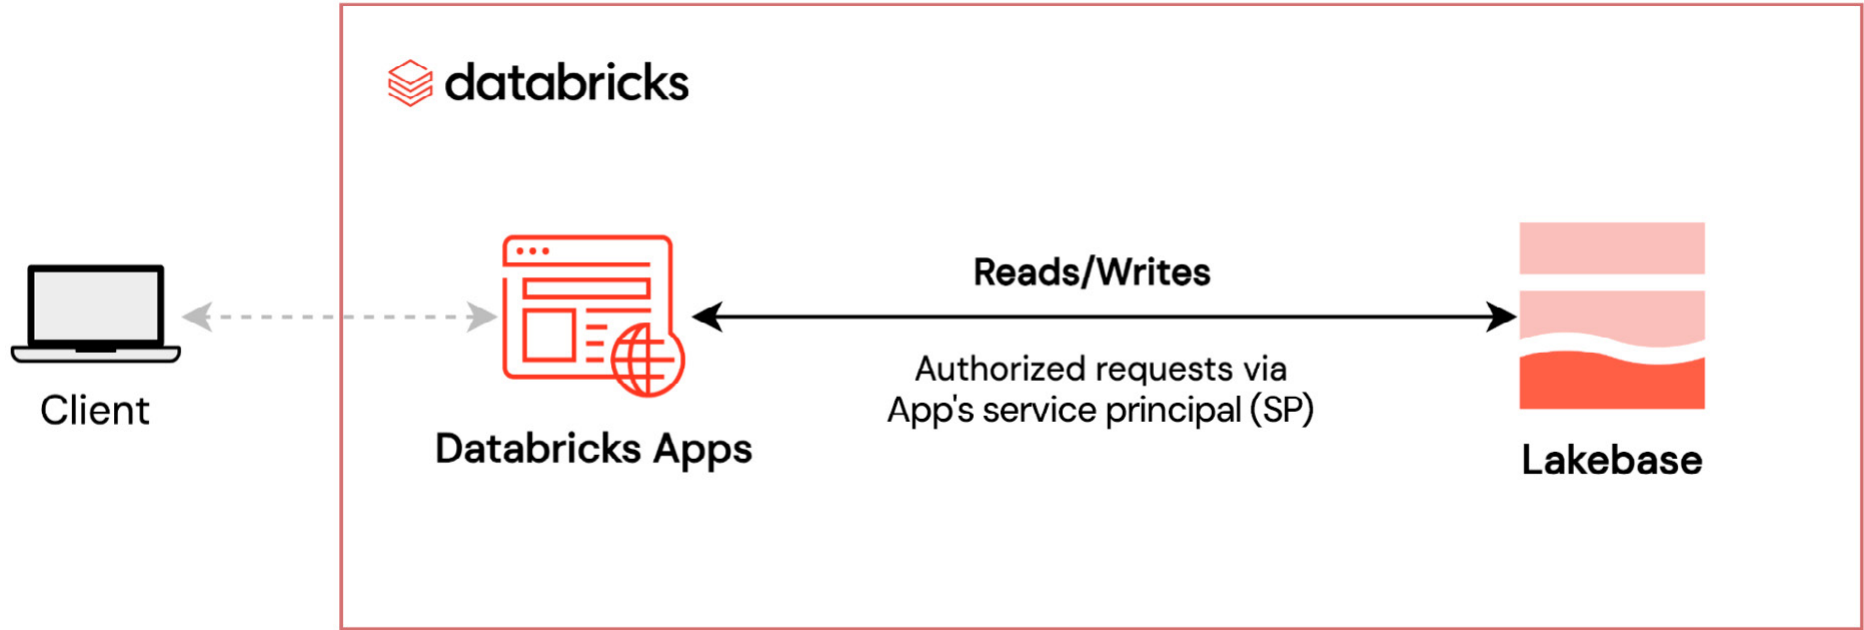
솔루션이 다루는 내용은 다음과 같습니다.
- Lakebase 데이터베이스 프로비저닝
클릭 몇 번으로 Serverless, Postgres OLTP 데이터베이스를 설정하세요. - 2. Create a Databricks app
Build an interactive app using a Python framework — such as Streamlit or Dash — that reads from and writes to Lakebase. - 스키마, 테이블 및 액세스 제어 구성
필요한 테이블을 생성하고 앱의 클라이언트 ID를 사용하여 앱에 세분화된 권한을 할당합니다. - Lakebase에 안전하게 연결하여 상호작용하기
Databricks SDK와 SQLAlchemy를 사용하여 앱 코드에서 Lakebase의 데이터를 안전하게 읽고 쓸 수 있습니다.
이 둘러보기는 최소한의 작동 예제를 통해 빠르게 start 수 있도록 설계되었습니다. 나중에 더 고급 구성으로 확장할 수 있습니다.
1단계: Lakebase 프로비저닝
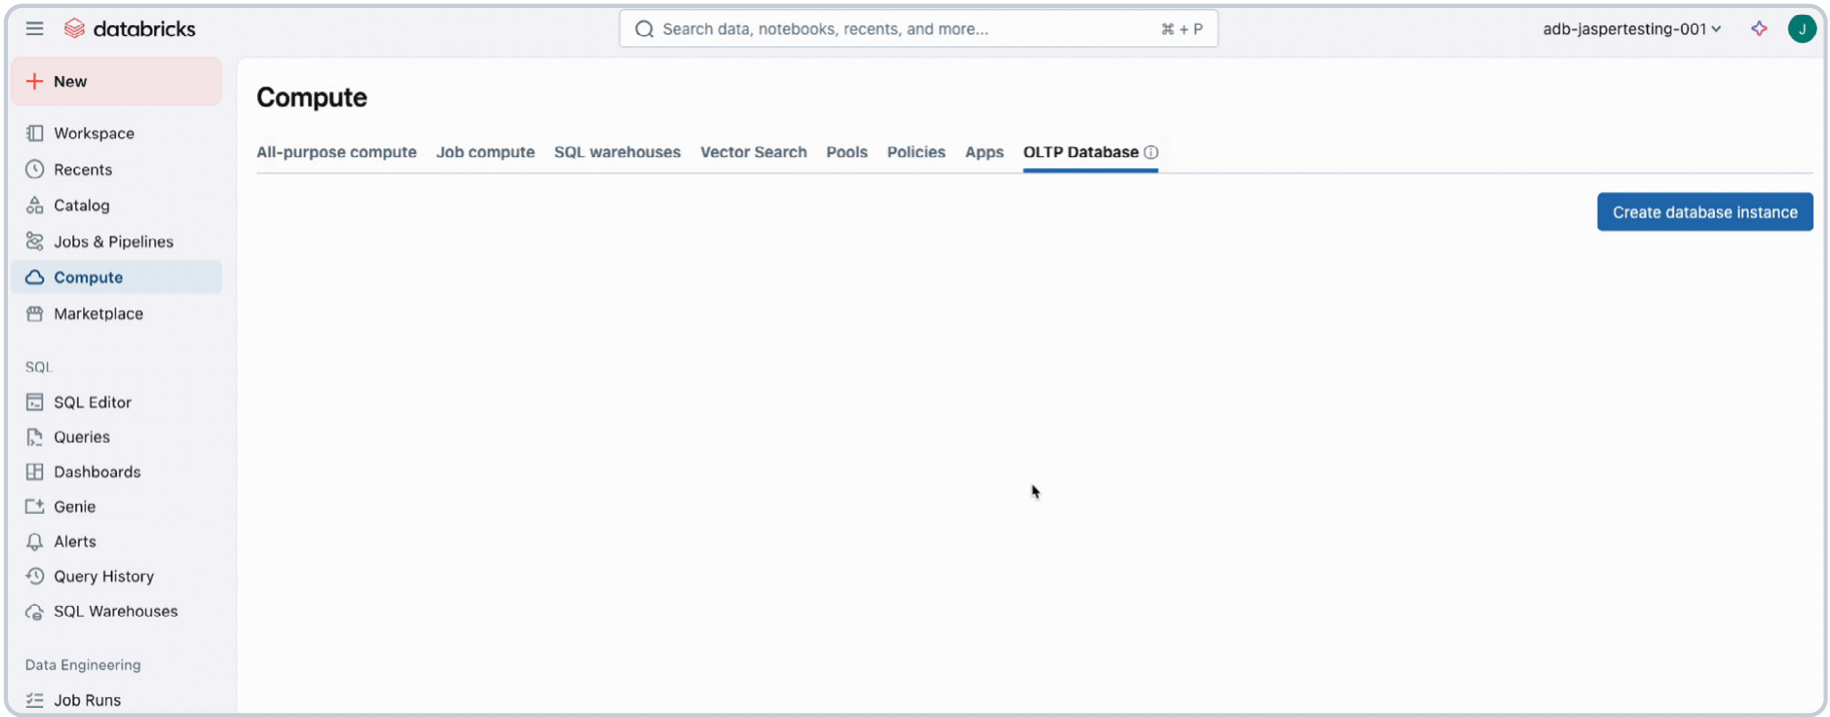
앱을 빌드하기 전에 Lakebase 데이터베이스를 생성해야 합니다. 이렇게 하려면 Compute 탭으로 이동하여 OLTP Database를 선택하고 이름과 크기를 지정합니다. 이렇게 하면 Serverless Lakebase 인스턴스가 프로비저닝됩니다. 이 예에서는 데이터베이스 인스턴스의 이름이 lakebase-demo-instance입니다.
2단계: Databricks 앱을 만들고 데이터베이스 액세스를 추가합니다.
이제 데이터베이스가 있으니 여기에 연결할 Databricks 앱을 만들어 보겠습니다. 빈 앱에서 시작하거나 Streamlit 또는 Flask와 같은 템플릿을 선택할 수 있습니다. 앱 이름을 지정한 후 데이터베이스를 리소스로 추가하세요. 이 예시에서는 미리 생성된 databricks_postgres 데이터베이스가 선택되었습니다.
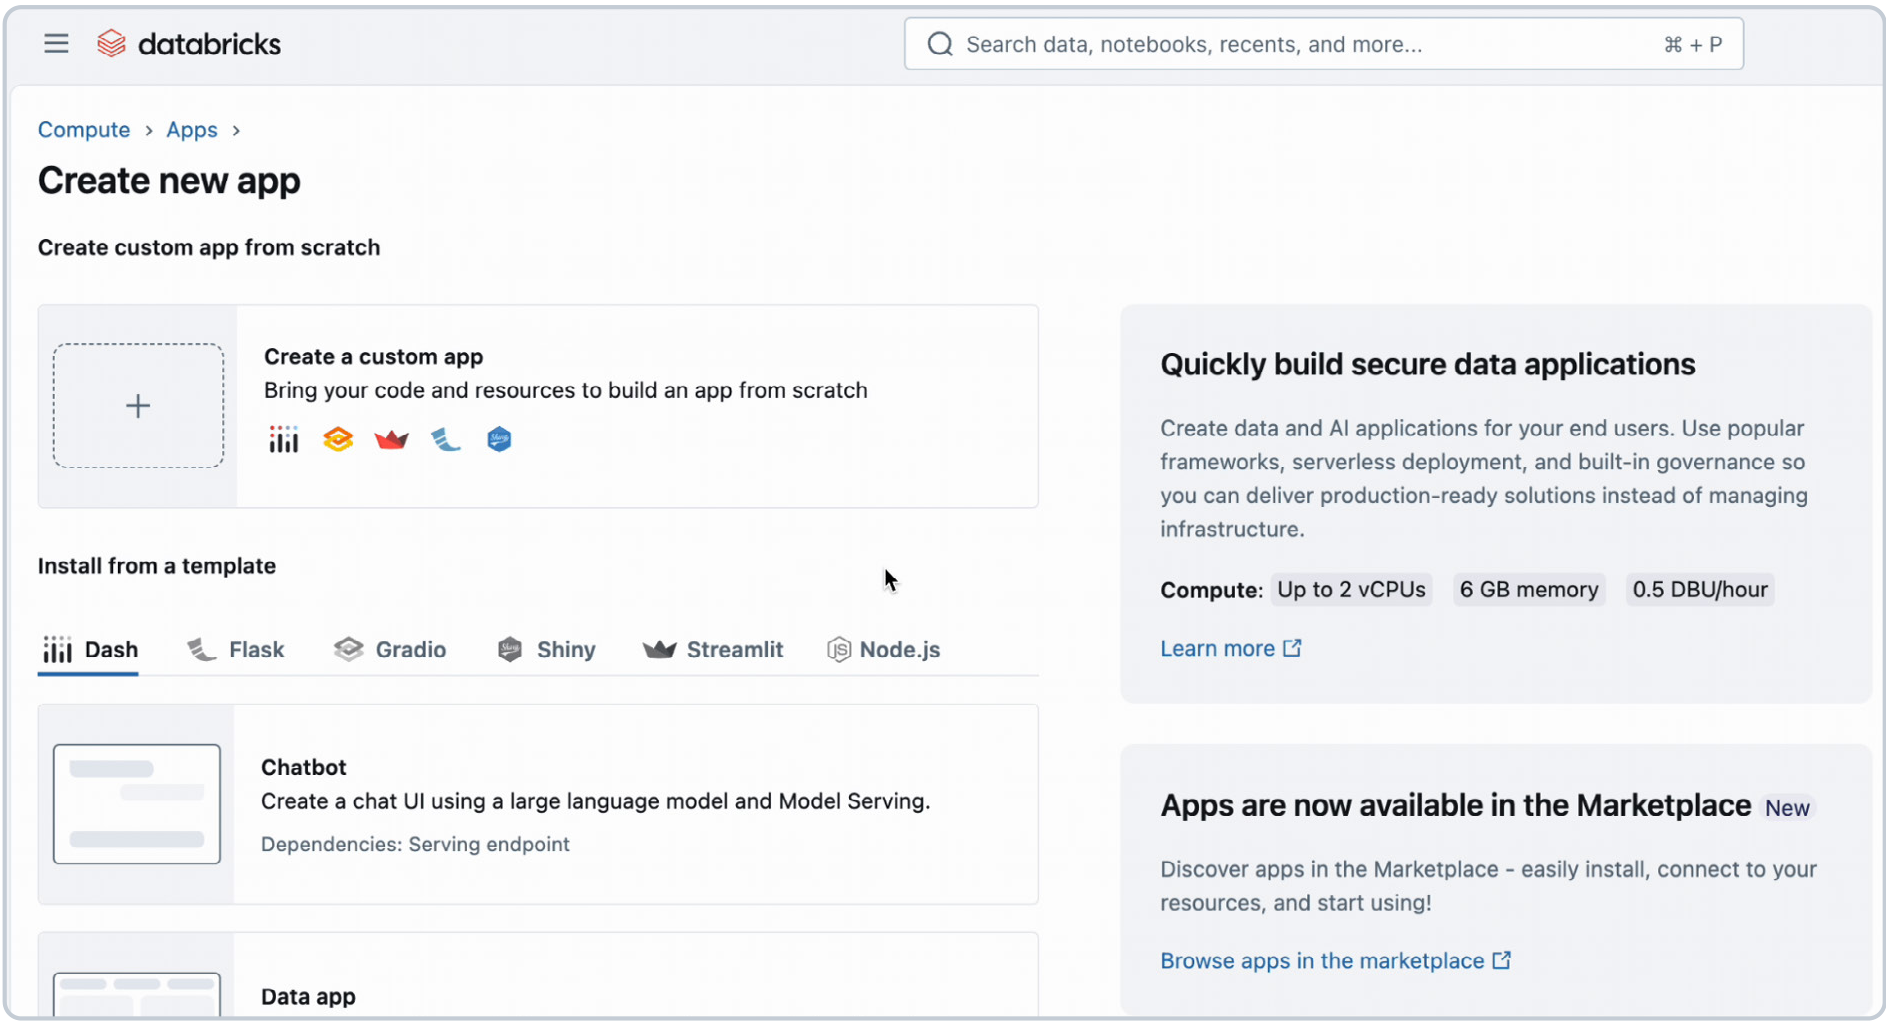
데이터베이스 리소스를 자동으로 추가합니다.
- 앱에 CONNECT 및 CREATE 권한을 부여합니다.
- 앱의 클라이언트 ID에 연결된 Postgres 역할을 생성합니다.
이 역할은 나중에 테이블 수준 액세스 권한을 부여하는 데 사용됩니다.
3단계: 스키마 생성, 테이블 정의 및 권한 설정
데이터베이스가 프로비저닝되고 앱이 연결되면 앱에서 사용할 스키마를 만들고 테이블을 정의할 수 있습니다.

- 앱의 클라이언트 ID 검색
앱의 Environment tab에서 DATABRICKS_CLIENT_ID 변수 값을 복사하세요. GRANT 명세서에 이게 필요해요. - Open the Lakebase SQL editor
Go to your Lakebase instance and click New Query. 그러면 데이터베이스 엔드포인트가 이미 선택된 상태로 SQL 편집기가 열려요.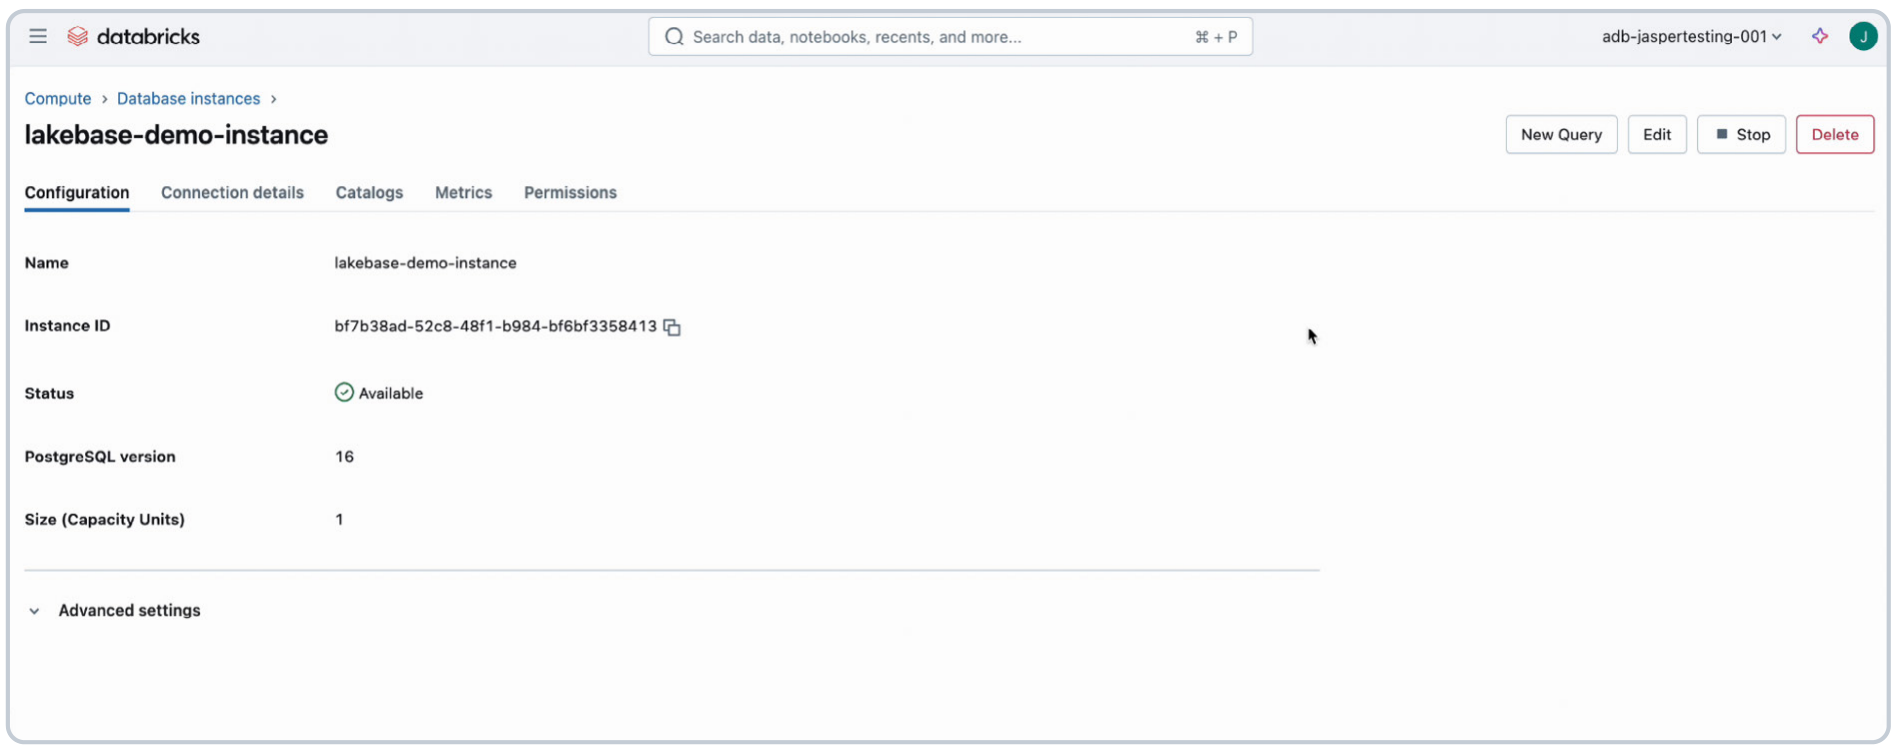
다음 SQL을 실행하세요.
SQL 편집기를 사용하는 것이 이 프로세스를 수행하는 빠르고 효과적인 방법이기는 하지만, 대규모 데이터베이스 스키마 관리는 버전 관리, 협업, 자동화를 지원하는 전용 도구로 처리하는 것이 가장 좋습니다. Flyway 및 Liquibase와 같은 도구를 사용하면 스키마 변경 사항을 추적하고 CI/CD 파이프라인과 통합하며 데이터베이스 구조가 애플리케이션 코드와 함께 안전하게 발전하도록 보장할 수 있습니다.
4단계: 앱 빌드하기
권한이 설정되었으므로 이제 앱을 빌드할 수 있습니다. 이 예시에서 앱은 Lakebase에서 휴가 요청을 가져오고 관리자는 이를 승인하거나 거부할 수 있습니다. 업데이트는 동일한 테이블에 다시 기록됩니다.
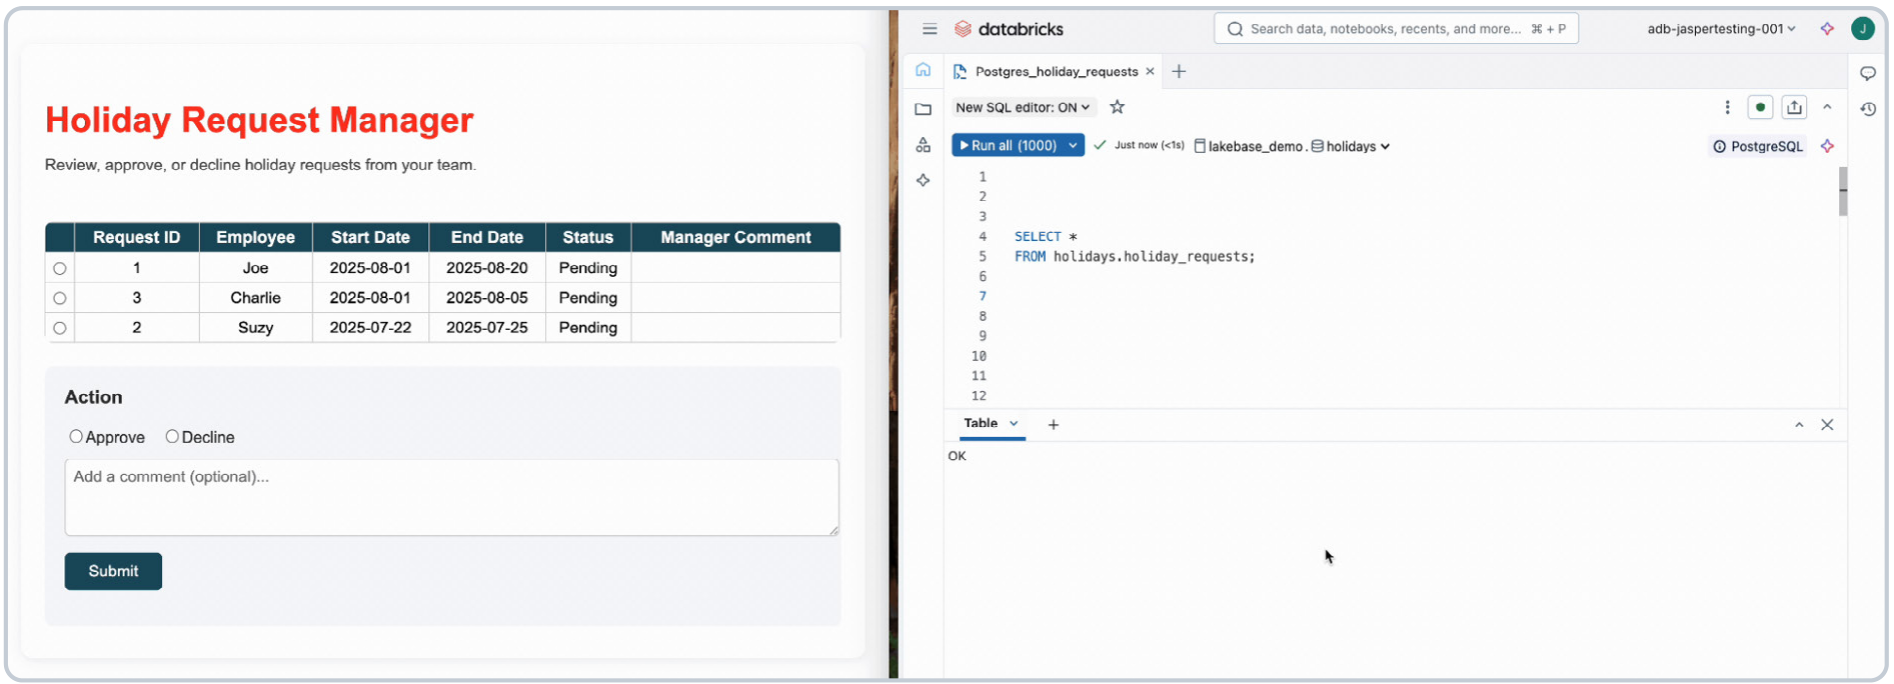
5단계: Lakebase에 안전하게 연결
SQLAlchemy 및 Databricks SDK를 사용하여 보안 토큰 기반 인증으로 앱을 Lakebase에 연결하세요. When you add the Lakebase 리소스를, PGHOST하고 PGUSER가 자동으로 노출돼요. SDK가 토큰 캐싱을 처리합니다.
6단계: 데이터 읽기 및 업데이트
다음 함수들은 휴가 신청 테이블에서 데이터를 읽고 업데이트합니다.
이러한 코드 스니펫은 Streamlit, Dash 및 Flask와 같은 프레임워크와 함께 사용하여 Lakebase에서 데이터를 가져와 앱에서 시각화할 수 있습니다. 필요한 모든 종속성이 설치되도록 하려면 앱의 requirements.txt 파일에 필요한 패키지를 추가하세요. 다음 패키지는 코드 스니펫에서 사용됩니다.
Lakebase로 Lakehouse 확장하기
Lakebase는 완전 관리형 OLTP 데이터베이스를 플랫폼에 직접 통합하여 레이크하우스에 트랜잭션 기능을 추가합니다. 이를 통해 읽기 및 쓰기가 필요한 애플리케이션을 빌드할 때 외부 데이터베이스나 복잡한 파이프라인의 필요성이 줄어듭니다.
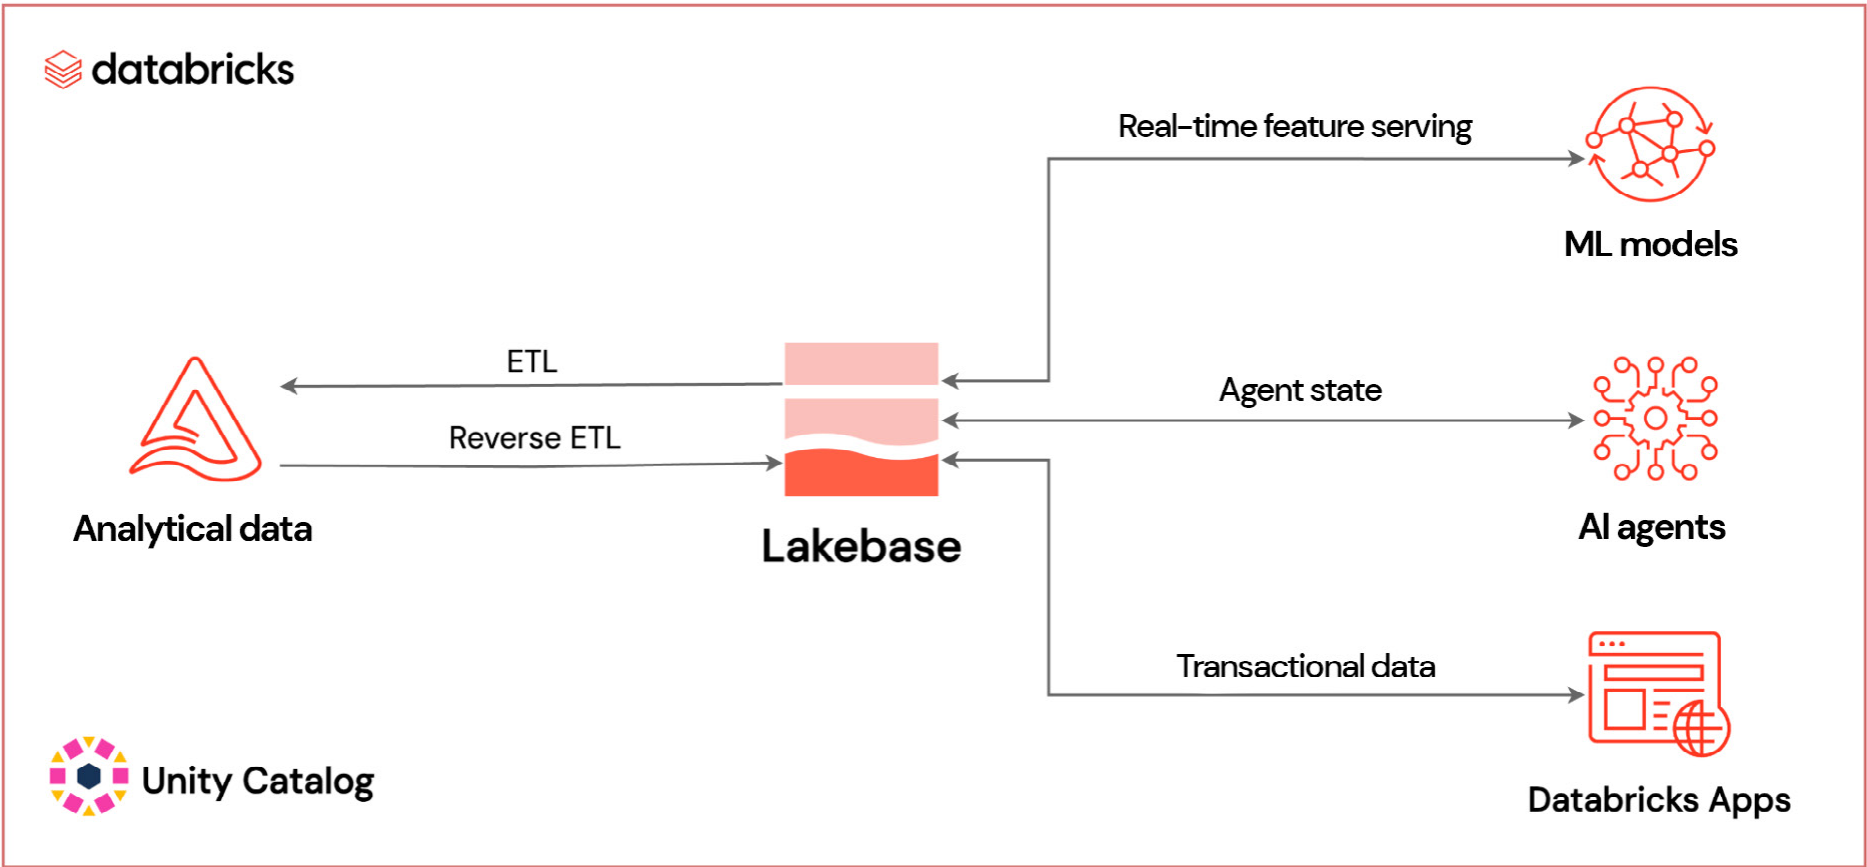
Lakebase는 데이터 동기화, ID 인증, 네트워크 보안 등 레이크하우스의 다른 데이터 자산과 마찬가지로 Databricks와 기본적으로 통합되어 있습니다. 따라서 시스템 간에 데이터를 이동하기 위해 사용자 지정 ETL이나 역 ETL이 필요하지 않습니다. 예를 들어, 다음과 같은 접근 방식이 있습니다.
- Online 특징점 및 동기화된 테이블을 사용하여 분석 피처를 애플리케이션에 실시간으로 다시 제공할 수 있습니다.
- 운영 데이터를 Delta 테이블과 동기화하여 과거 데이터 분석 등에 활용할 수 있습니다.
이러한 기능 덕분에 다음과 같은 프로덕션 등급의 사용 사례를 더 쉽게 지원할 수 있습니다.
- AI 에이전트의 상태 업데이트
- 실시간 워크플로 관리 — 예: 승인, 작업 라우팅
- 추천 시스템 또는 가격 책정 엔진에 실시간 데이터 공급
Lakebase는 이미 다양한 산업에서 맞춤형 추천, 챗봇 애플리케이션, 워크플로 관리 도구와 같은 애플리케이션에 사용되고 있습니다.
요약
Lakebase는 Databricks Apps과 원활하게 작동하고 Lakehouse 데이터와 쉽게 통합되는 트랜잭셔널 Postgres 데이터베이스를 제공해요. 이 솔루션은 외부 OLTP 시스템이나 수동 통합 단계가 필요 없도록 하여 풀스택 데이터 및 AI 애플리케이션 개발을 간소화합니다.
이미 분석 및 AI에 Databricks를 사용하고 있다면 Lakebase를 통해 애플리케이션에 실시간 상호 작용을 더 쉽게 추가할 수 있습니다. 짧은 지연 시간의 트랜잭션, 기본 내장 보안, Databricks Apps과의 긴밀한 통합을 지원하므로 플랫폼을 벗어나지 않고도 프로토타입에서 프로덕션으로 전환할 수 있습니다.
이 예시에서는 다음을 수행하는 방법을 보여드렸습니다.
- Lakebase 인스턴스 설정 및 액세스 구성
- Lakebase에 읽고 쓰는 Databricks 앱을 만들어보세요.
- 최소한의 설정으로 안전한 토큰 기반 인증 사용
- Python하고 SQL을 사용하여 휴일 요청을 관리하는 기본 앱을 만들어보세요.
사용 및 가격에 대한 자세한 내용은 Lakebase 및 Databricks Apps 문서를 참조하세요.
04 | 분석을 애플리케이션으로 전환하기
작성자: Firas Farah 및 Yatish Anand
소개: 분석과 운영의 융합
오늘날의 애플리케이션은 원시 이벤트에만 의존할 수 없습니다. 개인화, 자동화 및 지능형 사용자 환경을 지원하려면 레이크하우스에서 큐레이션되고, 맥락에 맞으며, 실행 가능한 데이터가 필요합니다.
짧은 대기 시간으로 해당 데이터를 안정적으로 제공하는 것은 어려운 과제였으며, 종종 복잡한 파이프라인과 맞춤형 인프라가 필요했습니다.
리버스 ETL이란 무엇인가요?
리버스 ETL은 레이크하우스의 고품질 데이터를 애플리케이션을 구동하는 운영 체제로 동기화합니다. 이를 통해 신뢰할 수 있는 데이터 세트와 AI 기반 인사이트가 개인화, 추천, 사기 탐지 및 실시간 의사 결정을 지원하는 애플리케이션으로 직접 흘러 들어갑니다.
리버스 ETL이 없으면 인사이트가 레이크하우스에 머물러 있어 필요한 애플리케이션에 도달하지 못합니다. 레이크하우스는 데이터가 정리, 보강되고 분석으로 전환되는 곳이지만, 짧은 지연 시간의 앱 상호 작용이나 트랜잭션 워크로드를 위해 구축된 것은 아닙니다. 바로 이 지점에서 Lakebase가 사용됩니다. Lakebase는 신뢰할 수 있는 lakehouse 데이터를 작업이 실행되는 도구로 직접 전달합니다.
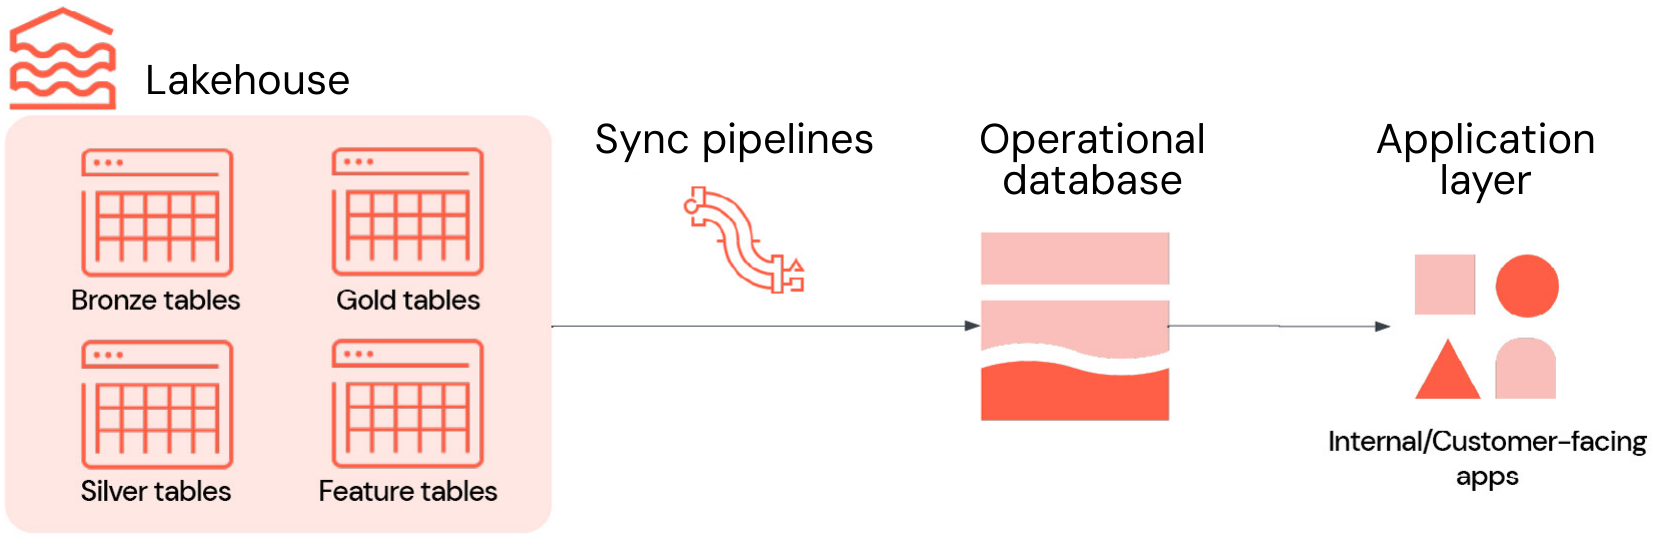
실제로 역방향 ETL은 일반적으로 Lakebase에 모두 통합된 네 가지 주요 구성 요소를 포함합니다.
- Lakehouse: 비즈니스 수준 집계 테이블(골드 테이블이라고도 함), 엔지니어링된 피처 및 ML 추론 출력과 같이 의사 결정을 내리는 데 사용되는 선별된 고품질 데이터를 저장합니다.
- 동기화 파이프라인: 일정 관리, 최신성 보장, 모니터링을 통해 관련 데이터를 운영 매장으로 옮기세요.
- 운영 데이터베이스: high concurrency, 낮은 지연 시간 및 ACID 트랜잭션에 최적화되어 있습니다.
- 애플리케이션: 고객용 애플리케이션, 내부 도구, APIs 또는 대시보드 등에서 인사이트가 행동으로 이어지는 최종 목적지 역할을 합니다.
Reverse ETL의 과제
역방향 ETL은 간단해 보이지만 실제로는 대부분의 팀이 다음과 같은 문제에 직면합니다.
- 부서지기 쉬운 맞춤형 ETL 파이프라인: 스트리밍 인프라, 스키마 관리, 오류 처리, 오케스트레이션이 필요한 경우가 많아요. 부서지기 쉽고 유지하는데 리소스 소모가 많아요.
- 여러 개의 분리된 시스템: 분석 및 운영을 위한 별도의 스택은 관리할 인프라 증가, 추가 인증 계층 및 형식 불일치 위험 증가로 이어집니다.
- 일관되지 않은 거버넌스 모델: 분석 시스템과 운영 시스템은 종종 서로 다른 정책 도메인에 있어 일관된 품질 관리 및 감사 정책을 적용하기 어렵습니다.
이러한 과제는 개발자와 비즈니스 모두에게 어려움을 야기하여 데이터를 안정적으로 활성화하고 지능형 실시간 애플리케이션을 제공하려는 노력을 지연시킵니다.
Lakebase: 손쉬운 역방향 ETL을 위해 default 통합됩니다.
Lakebase는 이러한 장벽을 제거하고 역방향 ETL을 완전 관리형 통합 워크플로로 전환합니다. 고성능 Postgres 엔진, 심층적인 lakehouse 통합 및 기본 내장된 데이터 동기화를 결합하여 추가 인프라 없이도 새로운 인사이트가 애플리케이션으로 흘러 들어가도록 합니다.
레이크베이스의 이러한 기능들은 역방향 ETL에 특히 유용해요.
- 긴밀한 lakehouse 통합: 외부 ETL 작업을 빌드하거나 관리할 필요 없이 lakehouse 테이블의 데이터를 스냅샷, 예약 또는 지속적으로 Lakebase에 동기화합니다. 이는 맞춤형 파이프라인, 재시도, 모니터링의 복잡성을 네이티브 관리형 환경으로 대체합니다.
- 완전 관리형 Postgres: 오픈 소스 Postgres를 기반으로 구축된 Lakebase는 ACID 트랜잭션, 인덱스, 조인 및 PostGIS, pgvector와 같은 확장을 지원합니다. pgAdmin 또는 JDBC와 같은 기존 Driver 및 도구와 연결할 수 있으므로 새로운 데이터베이스 기술을 배우거나 별도의 OLTP 인프라를 유지관리할 필요가 없습니다.
- 확장 가능하고 복원력이 뛰어난 아키텍처: Lakebase는 컴퓨팅과 스토리지를 분리하여 독립적인 확장이 가능하며 10ms 미만의 쿼리 지연 시간과 수천 QPS를 제공합니다. 엔터프라이즈급 기능에는 다중 AZ 고가용성, 특정 시점 복구 및 암호화된 스토리지가 포함되어 자체 관리형 데이터베이스와 관련된 확장성 및 복원력 문제를 해결합니다.
- 통합 보안 및 거버넌스: Lakebase를 Unity 카탈로그에 등록하면 카탈로그 수준의 감사 추적과 권한을 포함하는 운영 데이터를 중앙 집중식 거버넌스 프레임워크로 가져올 수 있어요. Postgres 프로토콜을 통한 액세스는 여전히 네이티브 Postgres 역할과 권한을 활용하므로 더 광범위한 Databricks 거버넌스 모델과 연계하면서 진정한 거래 보안을 보장해요.
- 클라우드 중립적 아키텍처: 워크플로를 재설계할 필요 없이 선호하는 클라우드 환경에서 레이크하우스와 함께 Lakebase를 배포하세요.
Databricks Data Intelligence Platform의 이러한 기능을 통해 Lakebase는 사용자 지정 파이프라인, 독립형 OLTP 시스템 및 별도의 거버넌스에 의존하는 단편적인 리버스 ETL 설정을 대체합니다. 통합되고 성능이 뛰어나며 안전한 서비스를 제공하여 더 적은 운영 노력으로 거버넌스를 유지하면서 분석 인사이트가 애플리케이션으로 더 빠르게 흘러가도록 보장합니다.
샘플 사용 사례: Lakebase로 지능형 지원 포털 구축
실용적인 예시로 Lakebase 기반의 지능형 지원 포털을 구축하는 방법을 살펴보겠습니다. 이 대화형 포털은 지원팀이 예측된 에스컬레이션 위험 및 권장 조치와 같은 레이크하우스의 ML 기반 인사이트를 사용하여 접수되는 인시던트를 분류하도록 돕습니다. 또한 사용자가 각 티켓에 대한 소유권을 할당하고, 상태를 추적하며, 댓글을 남길 수 있도록 합니다.
Lakebase는 예측을 Postgres에 동기화하는 동시에 앱의 업데이트도 저장하여 이를 가능하게 합니다. 이는 분석과 라이브 운영을 결합하는 지원 포털을 생성합니다. 동일한 접근 방식이 개인화 엔진 및 ML 기반 대시보드를 포함한 다른 많은 사용 사례에 적용됩니다.
1단계: 레이크하우스에서 Lakebase로 예측 동기화
ML 예측으로 보강된 인시던트 데이터는 Delta 테이블에 저장되며 스트리밍 파이프라인을 통해 거의 실시간으로 업데이트됩니다. 지원 앱을 구동하기 위해 Lakebase 역방향 ETL을 사용하여 이 Delta 테이블을 Postgres 테이블에 지속적으로 동기화합니다.
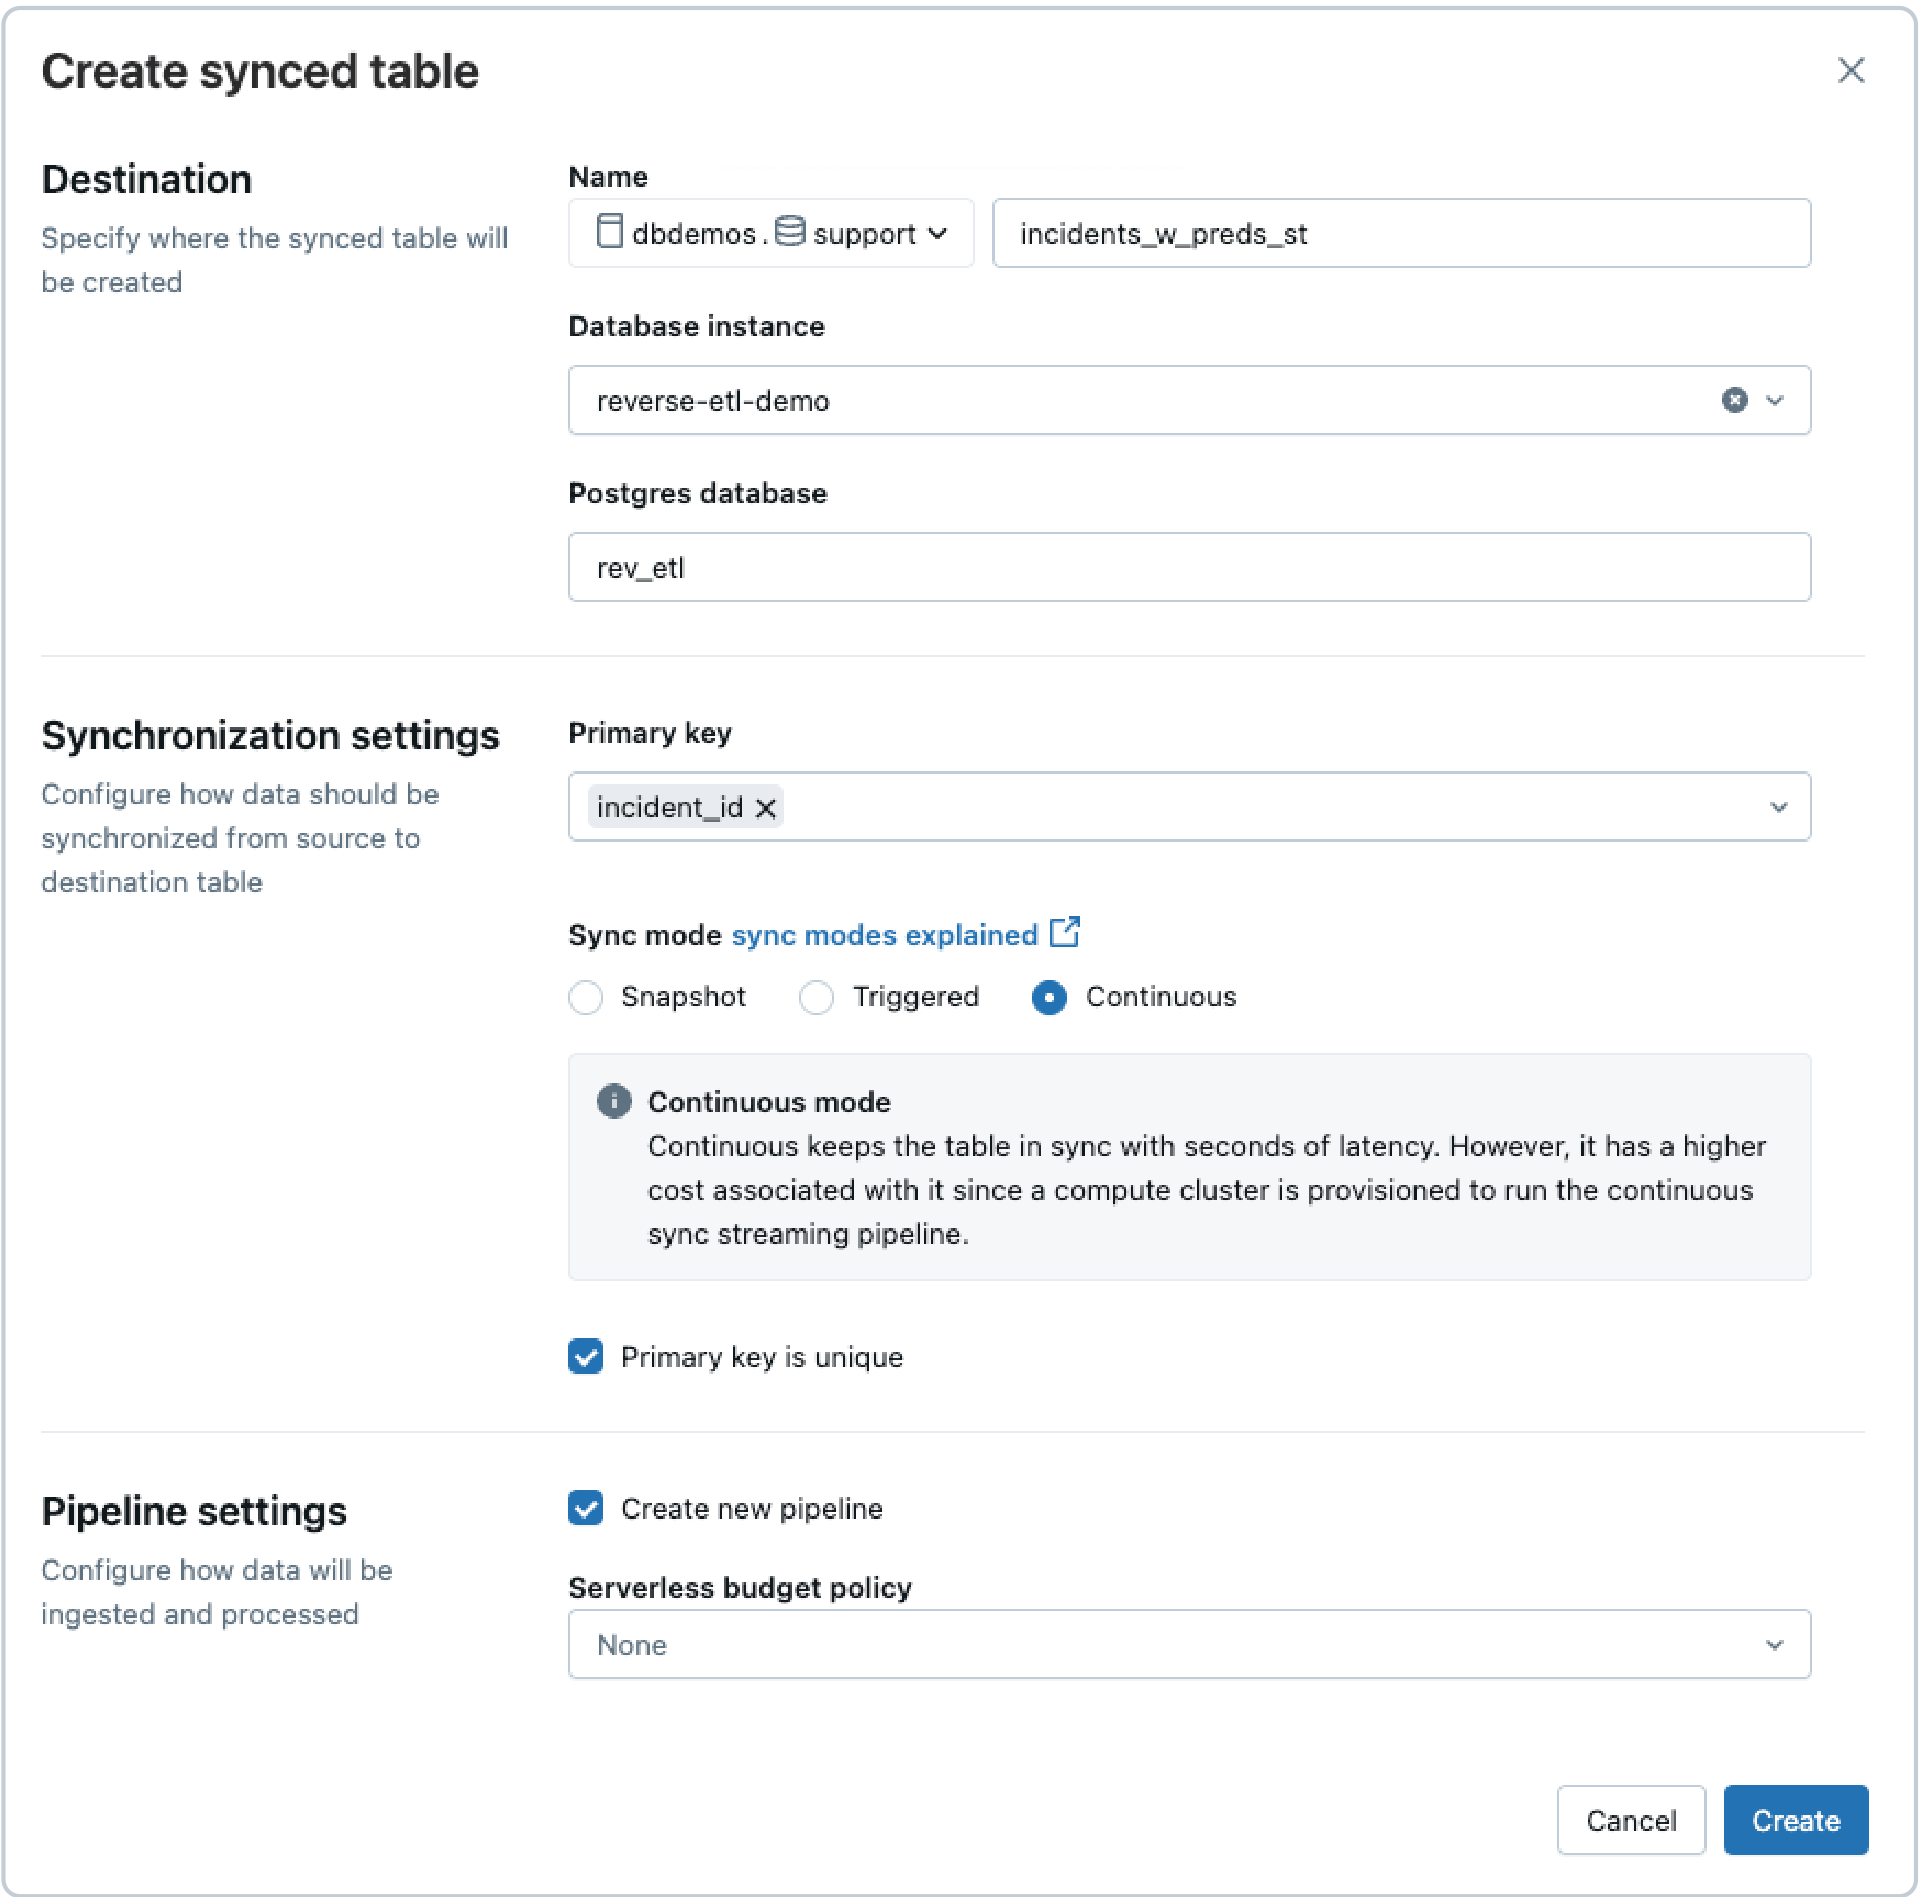
UI에서 다음을 선택합니다.
- 동기화 모드: 지연 시간이 짧은 업데이트를 위한 연속
- 기본 키: incident_id
이를 통해 앱이 최소한의 지연으로 최신 데이터를 반영할 수 있습니다.
참고: Databricks SDK를 사용하여 프로그래밍 방식으로 동기화 파이프라인을 만들 수도 있어요.
2단계: 사용자 입력을 위한 상태 테이블 만들기
지원 앱에는 소유권, 상태, 댓글 등 사용자가 입력한 데이터를 저장할 테이블도 필요합니다. 이 데이터는 앱에서 작성되므로 동기화된 테이블이 아닌 Lakebase의 별도 테이블에 저장해야 합니다.
스키마는 다음과 같습니다.
3단계: Databricks Apps에서 Lakebase 액세스 구성
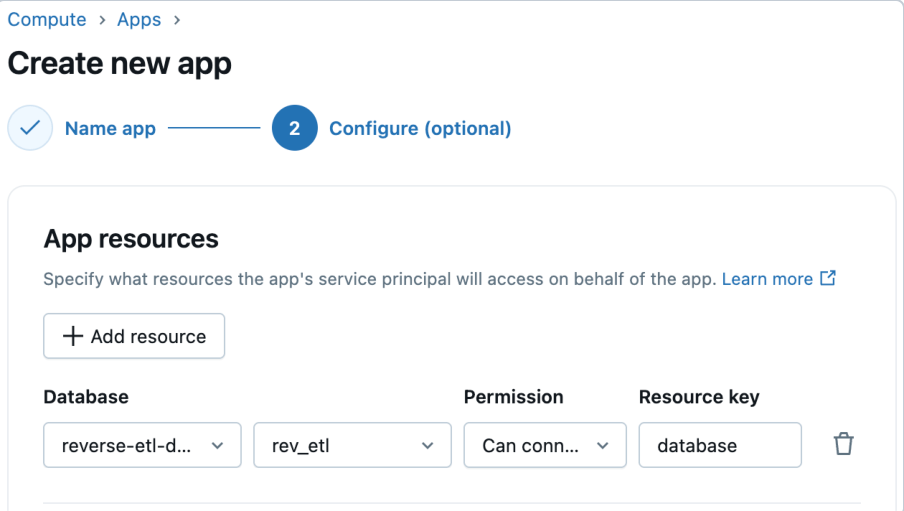
Databricks Apps는 Lakebase와의 최고 수준의 통합을 지원합니다. 앱을 만들 때 Lakebase를 앱 리소스로 추가하고 Lakebase 인스턴스와 데이터베이스를 선택하기만 하면 됩니다. Databricks는 앱의 서비스 주체에 대해 해당하는 Postgres 역할을 자동으로 프로비저닝하여 앱과 데이터베이스 간의 연결을 간소화합니다. 그런 다음 이 역할에 필요한 데이터베이스, 스키마 및 테이블 권한을 부여할 수 있습니다.
4단계: 앱 코드 배포
데이터가 동기화되고 권한이 설정되었으므로 이제 지원 포털을 구동하는 Flask 앱을 배포할 수 있습니다. 앱은 Postgres를 통해 Lakebase에 연결하고 차트, 필터 및 상호 작용 기능을 갖춘 풍부한 대시보드를 제공합니다.
결론
분석적 인사이트를 운영 애플리케이션에 적용하는 데 더 이상 복잡하고 깨지기 쉬운 프로세스가 필요하지 않습니다. Lakebase를 사용하면 리버스 ETL이 완전 관리형 통합 기능이 됩니다. 이는 Postgres 엔진의 성능, 확장 가능한 아키텍처의 안정성, Databricks 플랫폼의 거버넌스를 결합합니다. 지능형 지원 포털을 강화하거나 다른 실시간 데이터 기반 환경을 구축하는 경우에도 Lakebase는 엔지니어링 오버헤드를 줄이고 인사이트에서 실행에 이르는 경로를 단축합니다.
Lakebase에서 동기화된 테이블을 만드는 방법에 대해 자세히 알아보려면 문서를 확인하고 지금 시작해 보세요.
05 | Databricks에서 안전한 실시간 애플리케이션 제공하기
작성자: Sylvia Christin Schumacher
소개
Databricks Lakebase는 지능형 애플리케이션 구축을 위한 운영 데이터베이스를 간소화하는 기능을 크게 향상시켜 줘요. Databricks 앱을 사용하면 바로 사용할 수 있는 거버넌스와 인증을 통해 이러한 데이터와 AI 앱을 프로덕션에 빠르게 배포할 수 있어요.
Databricks 플랫폼과 원활하게 통합되는 완전 관리형 Postgres 서비스인 Lakebase를 통해 개발자는 사용자 지정 ETL 파이프라인, 커넥터 또는 미들웨어 없이 기본적으로 트랜잭션 데이터를 사용할 수 있습니다. Databricks Apps는 인프라 관리를 완전히 제거하고 워크스페이스의 보안 정책과 Unity Catalog 권한을 자동으로 상속하는 관리형 Serverless compute를 제공하여 이를 한 단계 더 발전시킵니다.
과거에는 OLTP와 OLAP 시스템을 연결하는 데 복잡한 데이터 엔지니어링과 맞춤형 통합 레이어가 필요했으며, 애플리케이션을 배포하려면 별도의 DevOps 및 인프라 팀, 서로 다른 CI/CD 파이프라인, 수동 보안 구성이 필요했습니다. Lakebase와 Databricks Apps를 함께 사용하면 이러한 복잡성이 크게 줄어듭니다. 이제 개발자는 트랜잭션 레이어에서 직접 실시간 분석 데이터에 액세스하고 몇 달이 아닌 몇 분 만에 대화형 애플리케이션을 배포할 수 있어 라이브 데이터를 프로덕션용 애플리케이션에 훨씬 쉽게 통합할 수 있습니다.
GenAI 컨텍스트에서 이 조합은 특히 강력합니다. Databricks Apps는 데이터와 모델이 이미 있는 Databricks Data Intelligence Platform에서 직접 실행되는 Streamlit 또는 Gradio와 같은 대화형 AI 인터페이스와 lakehouse 데이터를 고유하게 결합합니다. Lakebase의 트랜잭션 데이터는 내장된 엔터프라이즈 보안 및 거버넌스를 통해 GenAI를 더 빠르게 프로덕션으로 가져오는 실시간 컨텍스트 인식 애플리케이션을 구동하는 핵심 동인이 됩니다.
이 데이터를 앱 인터페이스에 직접 표시함으로써 기업은 새로운 기능을 활용할 수 있습니다.
- AI 어시스턴트는 쉽게 구성할 수 있는 액세스 제어를 준수하면서 실시간 비즈니스 데이터를 참조합니다.
- 사용자는 최신 AI 기반 가이드를 통해 데이터 기반 의사 결정을 내립니다.
- 검색 증강 생성(RAG) 모델은 최신 사실에 기반하여 결과를 생성합니다.
- 워크플로는 항상 사용 가능한 관리되는 애플리케이션을 통해 진화하는 트랜잭션에 맞춰 유지되죠.
이 통합을 통해 GenAI는 최신 팀에 필요한 프로덕션 안정성 및 간소화된 배포와 함께 필요한 시간과 장소에서 완전한 엔터프라이즈 컨텍스트로 작동할 수 있습니다.
이 챕터에서는 보안이 적용되고 CI/CD가 활성화된 Streamlit 앱을 빌드하고 이를 Lakebase에 연결되는 Databricks 앱으로 배포하는 방법을 단계별로 살펴보겠습니다. 이 앱을 통해 사용자는 읽기 전용 인터페이스에서 Unity Catalog의 동기화된 캠페인 메트릭을 탐색할 수 있습니다. 이는 비즈니스 대시보드, 캠페인 모니터링 또는 임시 탐색과 같은 사용 사례를 지원할 수 있습니다.
핵심 기술
- Streamlit: Python용 대화형 UI 프레임워크
- SQLAlchemy: 데이터베이스 액세스를 위한 SQL 툴킷 및 ORM
- Databricks SDK: 보안 OAuth 토큰 관리
- Postgres (Lakebase): 관리형 OLTP 백엔드
- DABs: 선언적 앱 배포 및 CI/CD 통합
- GitHub: 소스 제어 및 파이프라인 자동화
솔루션 개요
이 프로세스는 두 가지 주요 단계로 구성됩니다.
- Lakebase 설정
- Lakebase 인스턴스 생성(Databricks 관리형 Postgres)
- 스냅샷 모드를 통해 Unity Catalog 테이블을 Postgres 인스턴스에 동기화
- Databricks 앱 빌드하기
- UI에는 Streamlit을 사용하세요.
- SQLAlchemy 및 Databricks OAuth를 사용하여 Lakebase에 안전하게 연결
- 관계형 테이블에 대화형 필터 및 뷰 추가
- 버전 제어, 배포 및 자동화를 위해 Databricks Asset Bundles(DABs) 및 GitHub를 사용합니다.
전체 소스 코드 및 배포 지침은 GitHub 리포지토리를 확인하세요.
단계별 가이드
개발을 간소화하려면 로컬 테스트 및 반복 작업을 위해 Cursor를 Databricks Connect와 함께 설정 하는 것을 권장합니다.
1. Lakebase 설정
동기화된 테이블이 있는 Lakebase 인스턴스가 아직 없는 경우 다음 단계를 따르세요.
1. Lakebase 인스턴스 만들기
Lakebase 설명서의 1-7단계를 따라 postgres-campaigns라는 이름의 Lakebase 인스턴스를 만듭니다.
2. GitHub 리포지토리를 클론합니다
리포지토리에는 앱 배포를 위한 다음 파일이 포함되어 있습니다.
- app.py — 기본 Streamlit 애플리케이션
- config.yaml — 데이터베이스 및 테이블 parameter를 위한 중앙 집중식 구성
- generate_campaign_data.ipynb — 캠페인 성과 데이터를 생성하는 노트북
- requirements.txt — Streamlit, SQLAlchemy 및 Databricks SDK를 포함한 모든 Python 종속성
- databricks.yml — DABs용 선언적 배포 구성
- README.md — 설치 및 사용 방법에 대한 명확한 설명서
- gitignore — 리포지토리를 깔끔하게 유지하기 위한 로컬 및 환경별 파일 제외
3. Unity Catalog 테이블 만들기
복제된 GitHub 리포지토리에서 generate_campaign_data.ipynb 스크립트를 엽니다. Notebook 위젯 내에서 카탈로그, 스키마, 테이블 이름을 제공하고 스크립트를 실행하여 가상 캠페인 성과 데이터를 생성합니다.
4. Unity Catalog 테이블 동기화
Synced Tables 기능을 사용하여 Unity Catalog 테이블의 데이터를 자동으로 동기화하는 Postgres의 읽기 전용 테이블을 만듭니다. 동기화된 테이블을 만들려면 여기의 단계를 따르세요. 1단계의 Lakebase 인스턴스로 테이블을 동기화합니다.
- Postgres 데이터베이스: campaign_db
- 테이블 이름: campaign_metrics_synced
- Mode: 스냅샷
이제 다음을 갖추게 됩니다.
- Lakebase 인스턴스: postgres-campaigns
- 동기화된 관계형 테이블: campaign_metrics_synced
2. 앱 배포
이제 사용자의 Lakebase 인스턴스에 연결하여 데이터를 대화형으로 표시하는 Streamlit 앱을 생성합니다.
1. 구성 업데이트
복제된 GitHub 리포지토리에서 데이터베이스 세부 정보로 config.yaml을 편집하세요. 데이터베이스의 연결 세부 정보 탭에서 필요한 정보를 찾을 수 있어요.
2. 종속 항목 설치
3. Databricks 환경 변수 설정
설정 > 개발자 > 액세스 토큰 > 관리 > 새 토큰 생성으로 이동하여 새 개인용 액세스 토큰(PAT)을 받습니다. 다음과 같이 환경 변수를 설정합니다.
4. Postgres 데이터베이스 구성
자체 Postgres 데이터베이스에 연결하려면 app.py에서 DB_CONFIG 섹션을 업데이트하세요.
5. 앱 이름 업데이트
databricks.yml 파일은 앱을 배포 가능한 리소스로 정의합니다. 앱 이름을 입력하세요:
6. DAB를 사용하여 배포
이제 번들 소스 코드를 Databricks 작업 공간의 다음 위치에서 사용할 수 있습니다.
Compute > Apps > <your-app>을 통해 앱으로 이동하고 제공된 링크를 열 수 있습니다. 아직 앱에 데이터베이스 액세스 권한이 없으므로 현시점에서는 데이터를 볼 수 없습니다.
3. 데이터베이스에 대한 앱 권한 구성
1. 앱에서 CLIENT_ID 추출
- Compute > Apps > <your-app>으로 이동
- 앱에서 Environment 탭을 열고 DATABRICKS_CLIENT_ID 값을 복사하세요
2. 앱에 권한 부여
- Postgres 인스턴스(Compute > OLTP Database > >your-instance>)로 돌아가서 새 쿼리를 클릭합니다.
- 편집기에서 선택한 compute가 Postgres compute로 표시되는지 확인하세요.
- 데이터베이스를 "postgres"에서 사용자의 Postgres 데이터베이스(예: postgres-campaigns)로 전환합니다.
- 다음 코드를 실행하세요:
Compute > 앱 > <your-app> 통해 당신의 앱으로 돌아갈 수 있어요. 제공된 링크를 열면 관계형 테이블을 볼 수 있어요.
PostgreSQL과 OAuth 연결의 주요 내용
앱은 Databricks SDK를 사용하여 OAuth 토큰으로 관리형 Postgres 인스턴스에 안전하게 인증합니다.
- 수동 토큰 관리 불필요
- 15분마다 자동으로 토큰을 새로 고칩니다.
- Databricks 워크스페이스 자격 증명을 사용합니다.
학습한 내용
- Databricks OAuth — 앱 인증을 위해 원활하며 프로덕션에 바로 사용할 수 있습니다.
- Streamlit — 비즈니스용 도구를 위한 빠른 프로토타이핑 제공
- Databricks 자산 Bundles(DAB) — 배포 및 롤백을 간소화하며 CI/CD 파이프라인에 필수적입니다
- 동기화 테이블 — Databricks 앱에서 트랜잭션 데이터에 즉시 액세스할 수 있도록 합니다.
직접 해보기
사용자 고유의 데이터에서 시도해 보시겠습니까?
- GitHub 리포지토리 복제
- app.py에서 DB_CONFIG 사용자 지정하기
- databricks.yml에서 your-app-name을 사용자 지정하세요.
- `databricks bundle deploy`를 사용하여 배포
코드 몇 줄로 Databricks Apps에 운영 데이터를 적용하고 필요한 곳에서 팀에 필요한 통찰력을 제공하세요.
지금 바로 지능형 애플리케이션을 만들어보세요. 파이프라인을 구축하거나 서버를 유지 관리할 필요 없이 몇 분 안에 lakehouse 데이터를 Lakebase로 동기화하세요.
06 | Lakebase를 사용하여 대화형 메모리로 AI 에이전트를 구축하는 방법
야티시 아난드, 보 쳉, 캐시 즈드라베프스키, 에반 판디아 , 수잔 피어스 지음
대화형 메모리가 중요한 이유
많은 AI 에이전트는 단일 턴 상호 작용에서는 잘 작동하지만 실제 운영 워크플로에 적용될 때는 어려움을 겪습니다. 사이버 보안에서 조사는 단일 단계로 끝나는 경우가 거의 없으며, 애널리스트는 위협 유형에서 소스 IP로, IP에서 사용자로, 사용자에서 기기로 전환합니다. 이러한 조사는 여러 세션에 걸쳐 진행되는 경우가 많으며 연속성이 필요합니다.
생산 과정에서 에이전트가 효과적으로 작동하려면 상태가 필요합니다. 그들은 이미 일어난 일을 기억하고 전체적인 맥락을 그대로 유지한 채 업무를 재개해야 합니다.
이 장에서는 여러 상호작용에 걸쳐 대화 메모리를 유지하는 사이버 보안 AI 에이전트를 Databricks 플랫폼에서 빌드합니다. 에이전트는 LangGraph 체크포인팅을 사용하여 Lakebase에 실행 상태를 저장하므로, 조사를 원활하게 일시 중지하고 재개할 수 있습니다. Databricks AI Agent Framework를 사용하여 에이전트를 배포하고 Streamlit으로 빌드된 Databricks 앱으로 최종 사용자에게 공개합니다.
에이전트를 위한 상태 레이어로 Lakebase 사용하기
상태 저장 에이전트는 최소한의 대기 시간으로 애플리케이션 상태를 읽고 쓸 수 있는 트랜잭션 데이터베이스가 필요합니다. Lakebase는 Databricks Platform 내에 완전히 통합된 완전 관리형 Postgres 호환 OLTP 서비스로서 이 기반을 제공합니다. Postgres와 호환되므로 별도의 인프라를 구축하지 않고도 검증된 트랜잭션 데이터베이스의 신뢰성과 에코시스템을 활용할 수 있습니다.
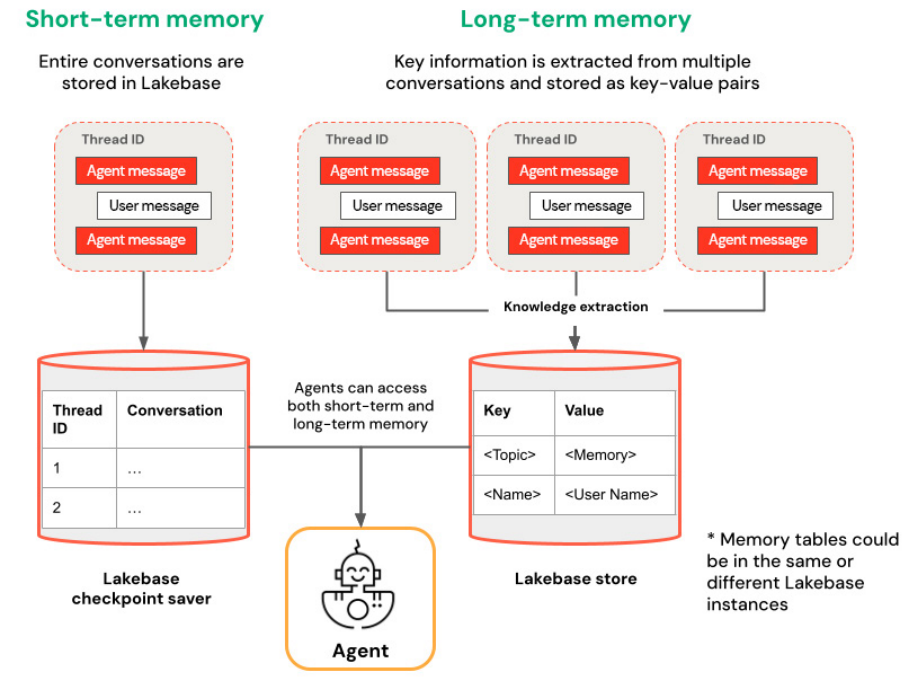
이 솔루션에서 Lakebase는 LangGraph의 체크포인트 저장소 역할을 합니다. 에이전트 실행의 각 단계는 스레드 식별자 아래에 유지되며, 해당 스레드가 다시 참조될 때 에이전트는 이전 메시지, 도구 호출, 중간 상태 등 전체 컨텍스트를 그대로 유지한 채로 재개됩니다. 낮은 레이턴시로 읽기가 가능하므로 에이전트가 이 컨텍스트를 빠르게 검색하여 대화의 응답성을 유지할 수 있습니다.
이 접근 방식을 사용하면 별도의 데이터베이스를 도입하거나 추가적인 운영 복잡성을 관리할 필요 없이 실제 대화형 메모리를 사용할 수 있습니다. 에이전트 로직, 도구, 메모리 및 배포는 모두 데이터 및 AI 워크로드가 이미 실행 중인 동일한 플랫폼에 있습니다.
AI 에이전트를 위한 메모리 패턴
이 챕터에서는 스레드 수준 체크포인트를 통해 구현된 단기 메모리에 중점을 둡니다. 각 대화는 고유한 스레드 식별자와 연결되며, 워크플로가 진행됨에 따라 에이전트의 상태가 증분식으로 저장됩니다. 이를 통해 컨텍스트를 잃지 않고 어느 시점에서든 조사를 재개할 수 있습니다.
Lakebase는 스레드와 사용자에 걸쳐 정보를 유지하는 더 오래 지속되는 메모리 패턴도 지원합니다. 이러한 패턴을 통해 에이전트는 시간이 지남에 따라 지식을 축적할 수 있지만 범위, 보존 및 거버넌스에 대한 추가적인 설계 고려 사항이 발생합니다. 세션 전반에 걸쳐 사용자 기본 설정이나 누적된 결과를 유지하는 장기 메모리에 대한 자세한 내용은 Databricks 설명서의 장기 메모리 섹션을 참조하세요.
아키텍처 개요
이 솔루션은 다음 구성 요소로 구성됩니다.
- Databricks에서 제공되며 추론을 수행하는 채팅 모델
- 거버넌스가 적용된 보안 데이터를 도구로 노출하는 Unity Catalog 함수
- 제어 흐름 및 도구 호출을 관리하기 위한 LangGraph 오케스트레이션
- 에이전트 상태를 위한 트랜잭션 체크포인터로 프로비저닝된 Lakebase
- 패키징 및 배포를 위한 Databricks AI Agent Framework
- 최종 사용자 상호 작용을 위한 Streamlit 기반 Databricks 앱
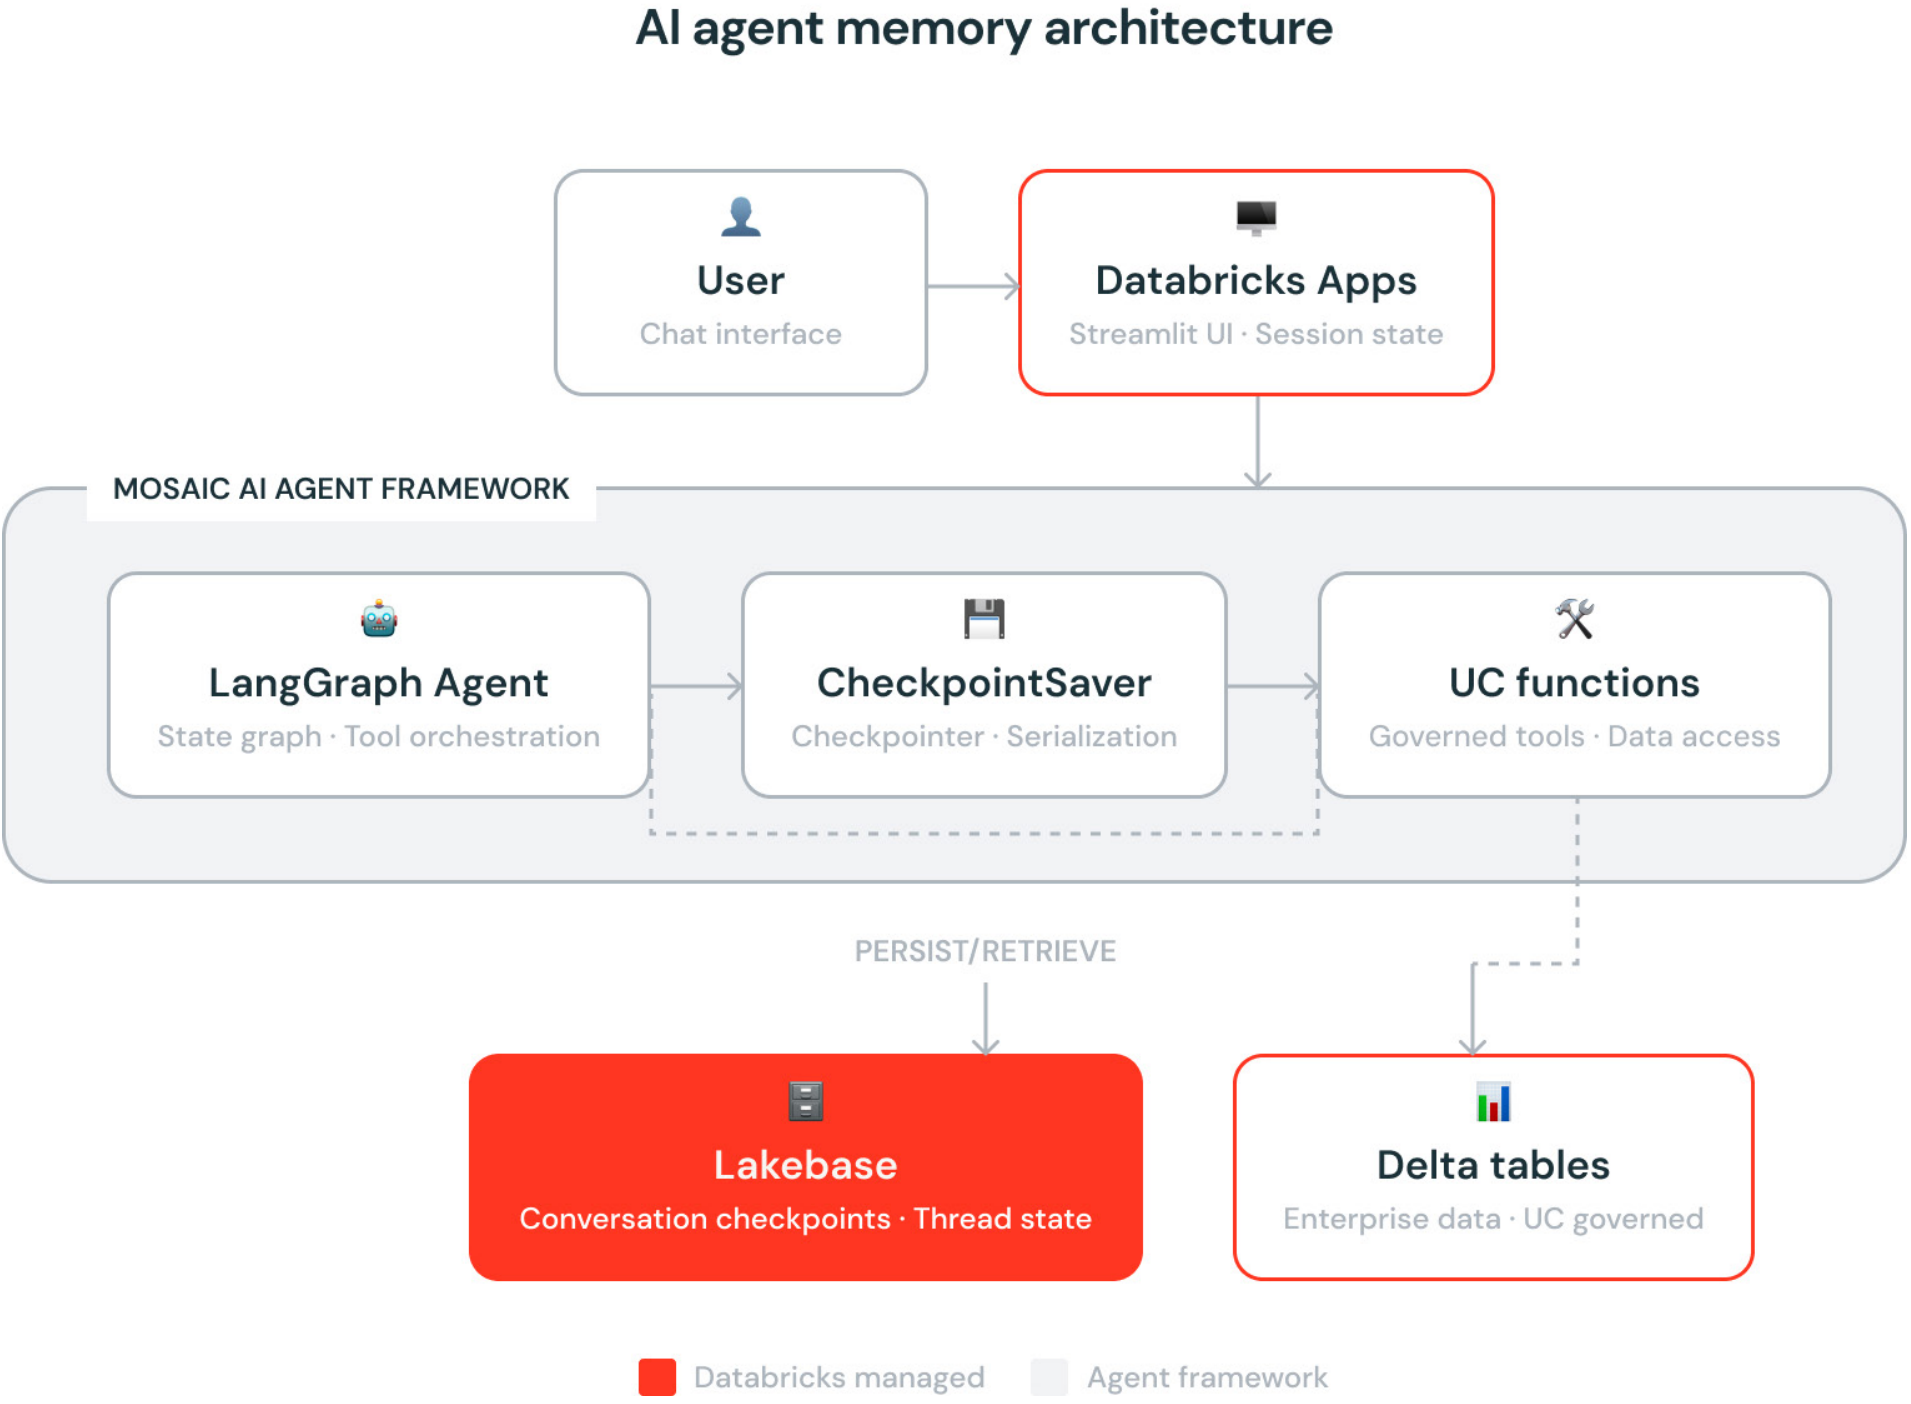
이러한 구성 요소들은 함께 Databricks 플랫폼에서 전적으로 실행되는, 프로덕션에 즉시 사용 가능한 상태 저장 에이전트 아키텍처를 형성합니다.
구현 가이드
사전 요구 사항
이 가이드는 독자가 Databricks 플랫폼에서 AI 애플리케이션을 빌드하는 데 익숙하다고 가정하며, 환경 부트스트래핑보다는 에이전트 아키텍처에 중점을 둡니다.
시작하기 전에 다음을 갖추고 있는지 확인하세요.
- Serverless compute에 액세스할 수 있는 Databricks 워크스페이스
- Unity Catalog 함수 생성 권한
- Lakebase로 프로비저닝된 인스턴스를 생성할 수 있는 권한
- Databricks Model Serving 및 Databricks Apps에 대한 액세스
이 데모에서는 다음 라이브러리를 사용합니다. Databricks Serverless compute의 노트북에서 설정을 실행한 후 단계별로 따라 진행하세요. 전체 작동 솔루션을 갖춘 GitHub 리포지토리는 여기에서 찾을 수 있어요.
1단계: Unity Catalog 함수를 사용하여 관리형 보안 컨텍스트 추가
에이전트는 신뢰할 수 있는 컨텍스트에 의존하여 의사 결정을 내립니다. 사이버 보안 워크플로에서 이 컨텍스트는 주로 구조화된 이벤트 및 ID 테이블에 있습니다. Unity Catalog 함수는 이 데이터를 에이전트에 호출 가능한 도구로 노출하는 안전한 메커니즘을 제공합니다.
이 예제에서는 두 개의 SQL 함수를 만듭니다.
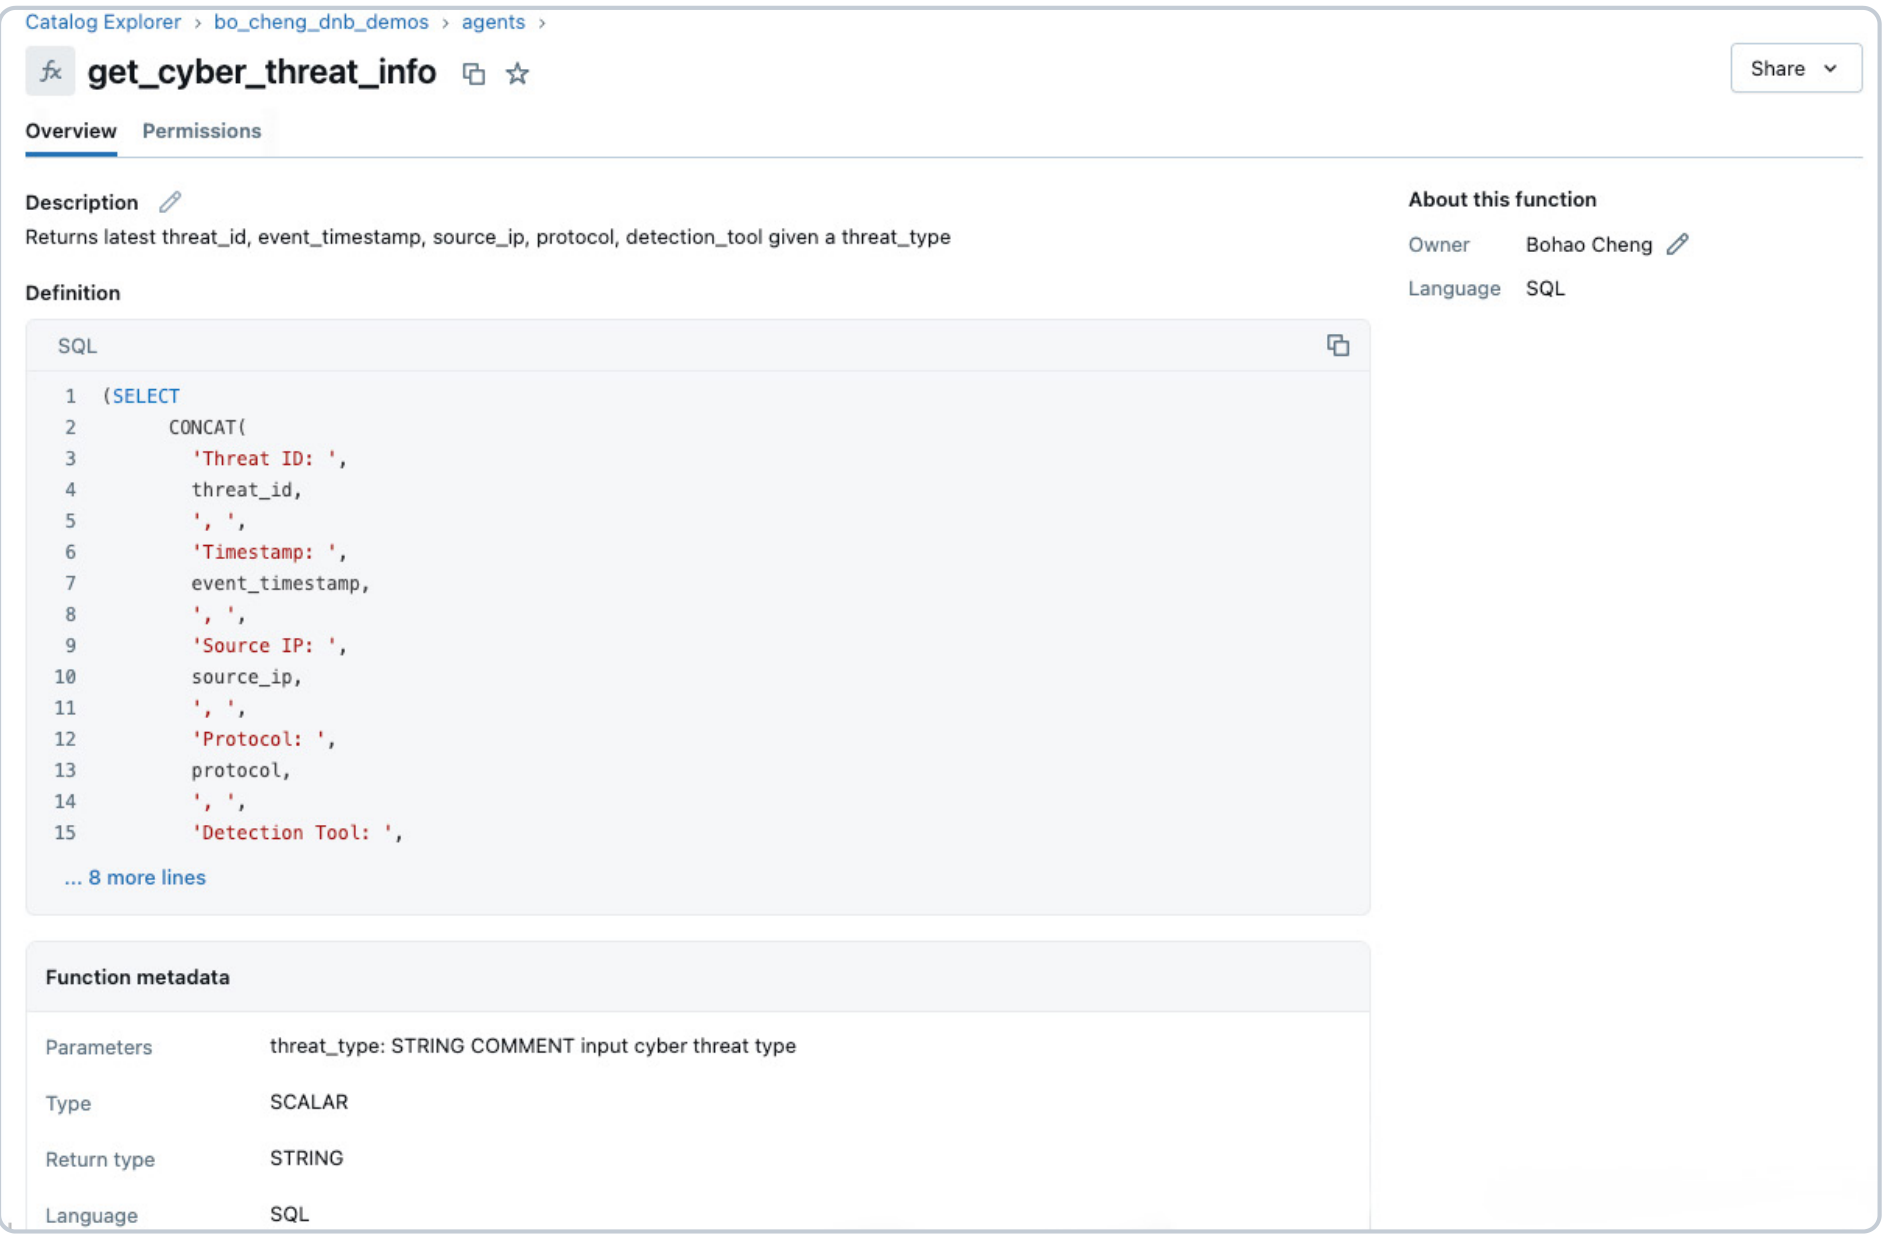
- get_cyber_threat_info는 특정 위협 유형에 대한 가장 최근의 위협 이벤트를 검색합니다.
- get_user_info는 소스 IP 주소와 연결된 사용자 세부 정보를 검색합니다.
이러한 함수는 Databricks SQL(DBSQL)로 작성되고 Unity Catalog의 관리를 받아 일관된 액세스 제어, 감사 및 리니지를 보장합니다.
함수를 생성하면 지정된 카탈로그 및 스키마의 tab 탭 아래에서 해당 함수를 볼 수 있습니다.
2단계: 체크포인팅을 위한 Lakebase 인스턴스 생성
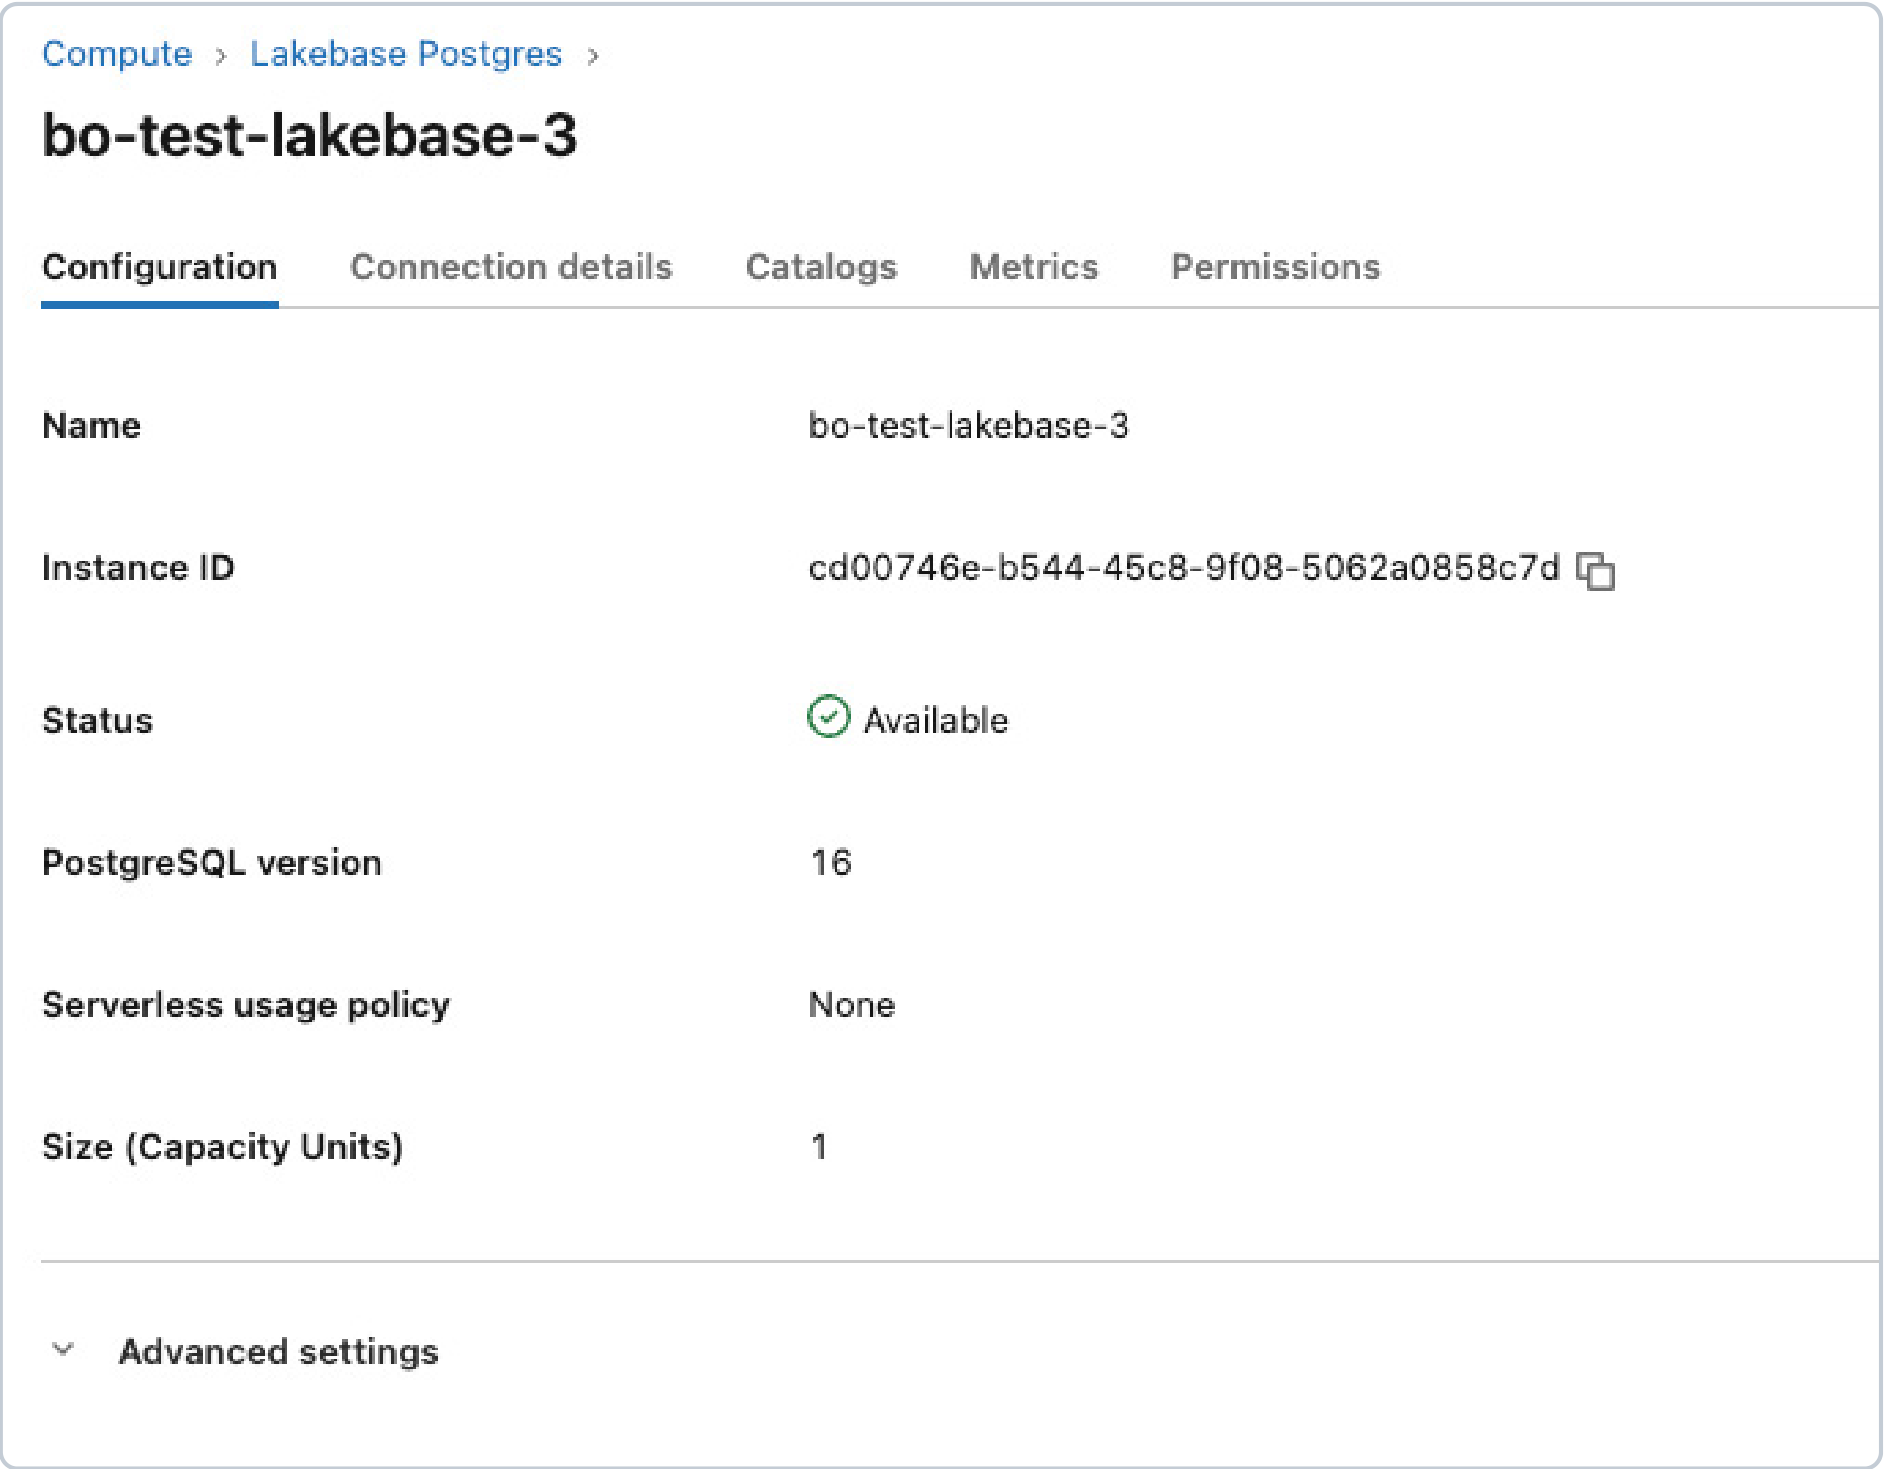
에이전트 상태를 유지하려면 LangGraph checkpointer 역할을 하는 Lakebase 인스턴스를 만듭니다. 외부 Postgres 데이터베이스를 관리하는 대신 Lakebase는 Databricks 보안 및 ID와 직접 통합되는 관리형 트랜잭션 서비스를 제공합니다.
에이전트의 각 실행 단계가 레이크베이스에 작성돼요. 레이크베이스는 지연 시간이 짧은 트랜잭션 워크로드에 최적화되어 있기 때문에 이러한 쓰기는 에이전트의 응답 시간에 최소한의 오버헤드를 추가해요. 체크포인트를 스레드 식별자와 연결함으로써 에이전트는 사용자가 기대하는 응답성을 유지하면서 세션 간에 안정적으로 대화를 재개할 수 있습니다.
이 구현은 랭그래프-체크포인트-포스트그레스 통합을 사용해요. 그래서 랭그래프는 표준 포스트그레스 시맨틱스를 사용하여 에이전트 상태를 레이크베이스에 직접 유지할 수 있어요.
인프라를 표준화하는 방법에 따라 Python용 Databricks SDK를 사용하여 Lakebase 인스턴스를 생성하거나 Databricks 자산 Bundles (DAB)를 사용하여 선언적으로 관리할 수 있습니다.
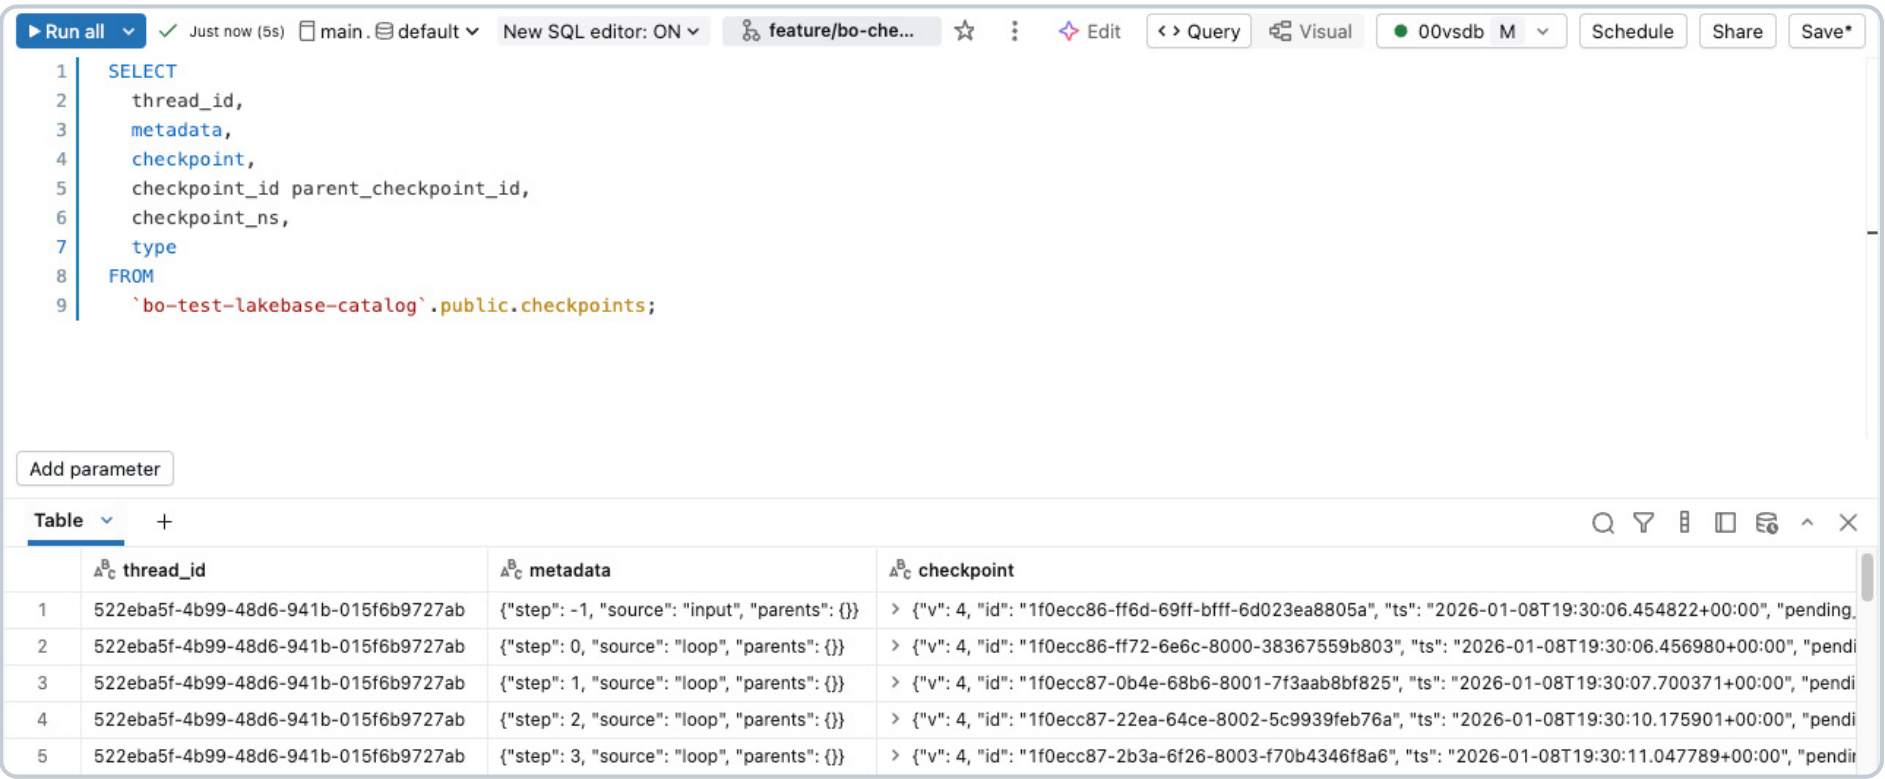
또한 데이터베이스 카탈로그를 생성하면 이제 DBSQL을 사용하여 체크포인트 기록을 쿼리할 수 있습니다.
3단계: LangGraph로 오케스트레이션하고 MLflow로 추적
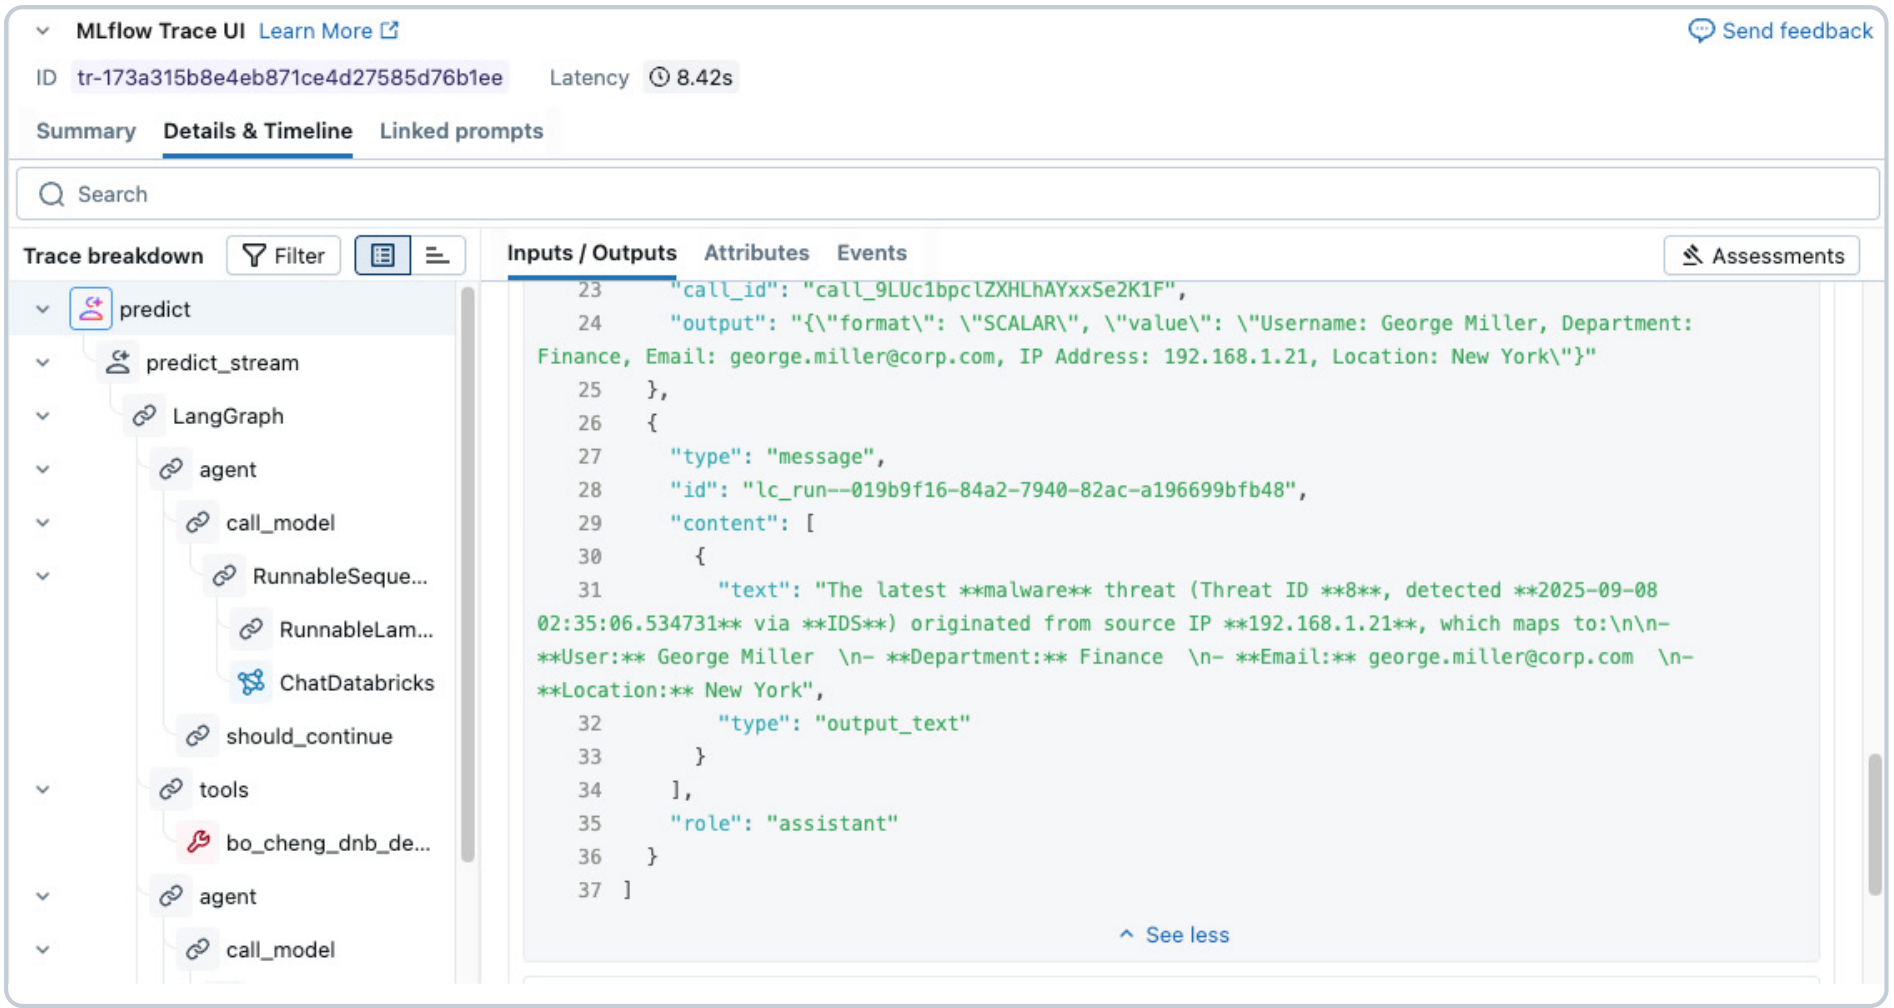
Databricks는 LangGraph 오케스트레이션 프레임워크와 직접 통합됩니다. 따라 하고 있다면 LangGraph 옵션을 선택하세요. LangGraph는 에이전트 동작을 위한 컨트롤 플레인, 즉 언제 모델을 호출하고, 언제 도구를 호출하며, 턴 사이에 상태를 유지하는 방법을 제공합니다. 이 구현에서는 Unity Catalog 도구를 채팅 모델에 바인딩하고 Lakebase 기반 체크포인터를 사용하여 스레드 수준 상태를 저장하고 복원합니다.
배포 전에 MLflow Tracing으로 동작을 검증하세요. 추적을 통해 입력, 출력, 도구 호출 및 중간 단계를 더 쉽게 감사할 수 있으며, 이는 프로덕션에서 에이전트 동작을 디버깅하고 이해하는 데 필수적입니다.
4단계: Databricks AI Agent Framework를 사용하여 에이전트 배포
유효성이 검사되면 Databricks AI 에이전트 프레임워크를 사용하여 에이전트가 패키징되고 배포됩니다. 이를 통해 관리되는 리소스에 대한 인증 통과를 보존하면서 등록, 버전 관리 및 서빙을 간소화할 수 있습니다.
MLflow로 에이전트를 로깅할 때는 모델 서빙 Endpoint, Unity Catalog 함수, Lakebase 인스턴스를 포함한 종속 리소스를 명시적으로 선언하세요. 이를 통해 배포 시 의존하는 자산을 명확하게 파악할 수 있습니다. 다음 코드는 Lakebase와 통합되는 databricks_langchain 단기 메모리 CheckpointSaver를 보여주는 predict 및 predict_stream 함수의 관련 부분만을 보여줍니다. 전체 모델 코드는 GitHub 리포지토리에서 자유롭게 확인해 보세요.
그 후 MLflow의 코드에서 모델 접근 방식을 사용하여 에이전트를 로깅하고 등록해야 합니다.
모델이 기록된 후에는 카탈로그를 사용하여 버전과 아티팩트를 보고, 관련 Unity Catalog 개체를 보여주는 리니지 개요까지 볼 수 있습니다.
![],](https://www.databricks.com/sites/default/files/doc-importer/14/figure-556.png)
마지막으로, 간단한 agents.deploy() 함수 호출을 사용하여 모델 서빙 엔드포인트를 생성하고 SME 평가를 위한 Review App을 인스턴스화할 수 있습니다. 여기서, Lakebase 프로비저닝 인스턴스에 대한 인증을 위해 지정된 Service Principal 클라이언트 ID 및 클라이언트 암호와 같이 에이전트 인증에 필요한 모든 환경 변수를 기록합니다.
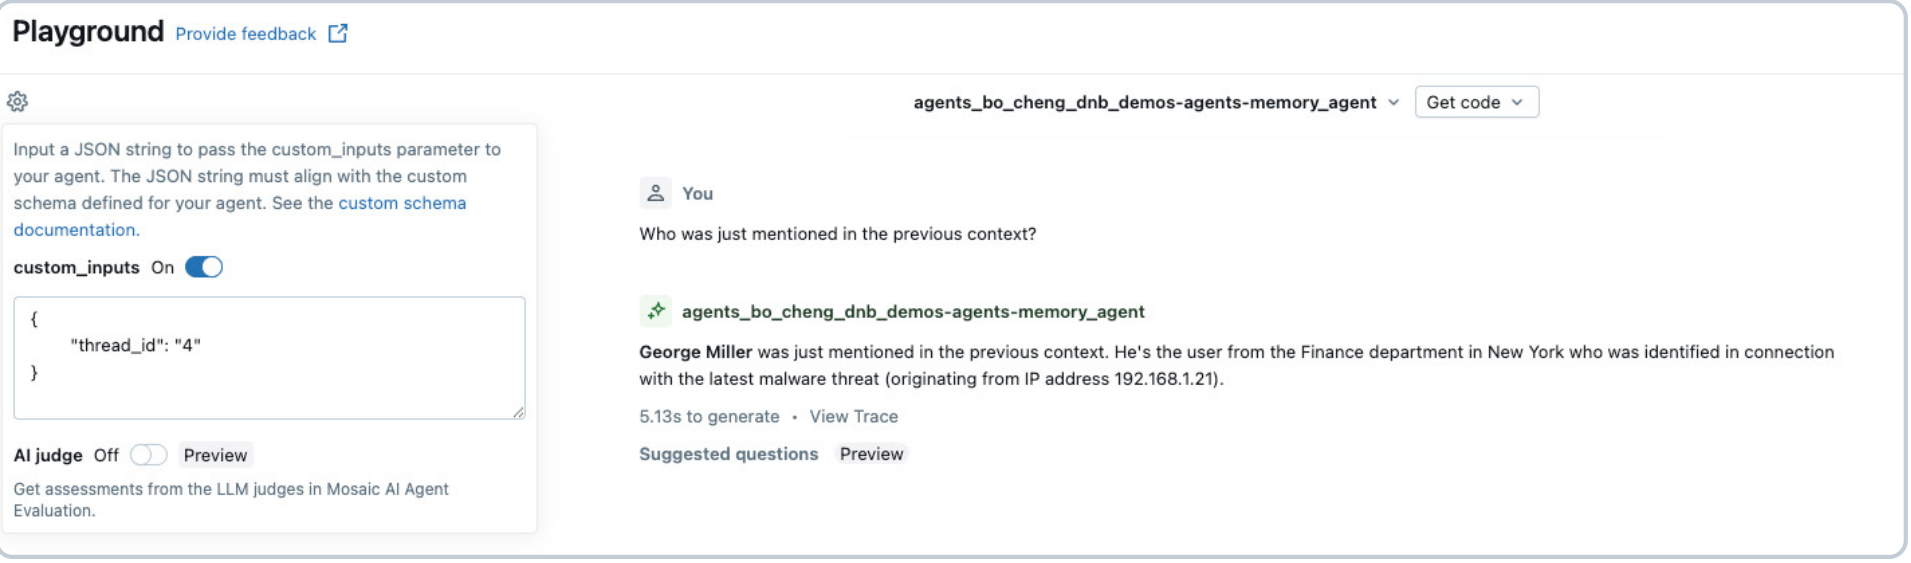
배포 후 최종 사용자에게 공개하기 전에 AI Playground 또는 Review App을 사용하여 에이전트를 테스트할 수 있습니다. Review App은 프런트엔드 Databricks 앱과 통합하기 전에 AI 앱의 느낌을 미리 확인하기 위한 기본 내장 채팅 UI입니다.
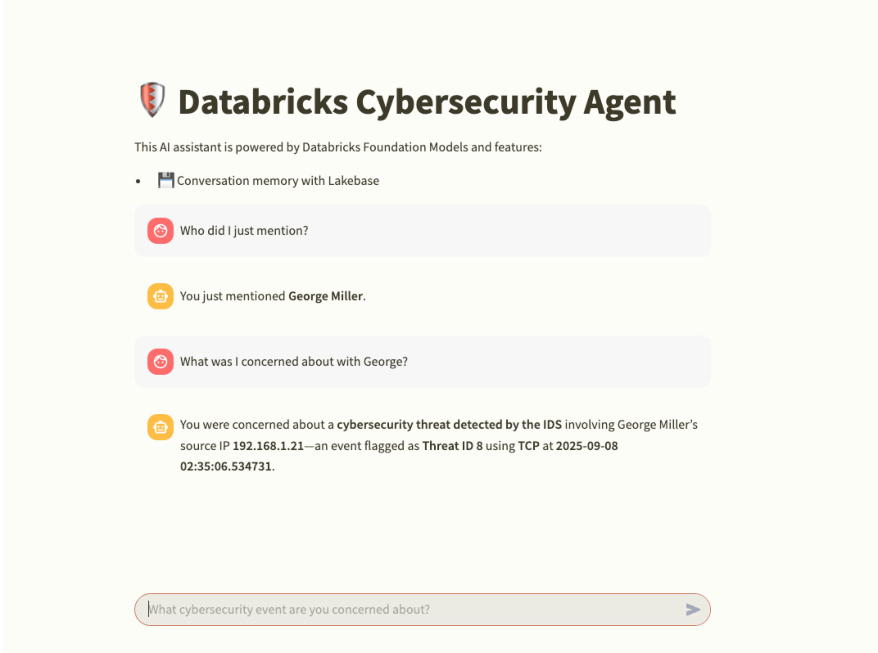
이제 모델 서빙 엔드포인트를 Databricks 앱과 통합할 수 있습니다. Databricks 앱은 Databricks 플랫폼에서 AI 앱을 빌드하는 가장 안전한 방법으로, Streamlit, Gradio, Plotly Dash, Shiny, Flask와 같은 Python 프레임워크를 즉시 지원합니다. 이 사이버 보안 애널리스트 에이전트에는 Streamlit을 사용하고 있습니다.
Databricks Apps는 앱 인증(제공된 Service Principal 사용) 또는 사용자 인증(사용자를 대신하여 앱이 로그인한 사용자의 ID로 작동)의 두 가지 인증 모드를 제공합니다. 어느 쪽이든, MLflow 배포 클라이언트를 사용하여 에이전트의 모델 서비스 Endpoint와 상호 작용해요.
대화형 메모리의 핵심은 thread_id이며, 이는 Lakebase에서 대화의 체크포인트를 함께 묶는 고유 식별자입니다. Streamlit 앱에서 사용자는 사이드바에 기존 thread_id를 입력하여 중단했던 부분부터 정확하게 이전 대화를 다시 시작할 수 있습니다. 다음 그림에서 thread_id는 4이므로 사용자가 앱을 닫았다가 나중에 동일한 식별자로 돌아오면 에이전트는 이전 대화의 전체 컨텍스트를 가지고 대화를 이어갑니다.
thread_id가 제공되지 않으면 앱은 세션용 새 ID를 생성하여 새로운 대화를 시작합니다. 이것은 단기 기억이 어떻게 작동하는지 보여주기 위한 간단한 구현입니다. 프로덕션 환경에서는 일반적으로 앱이 thread_id 지속성을 자동으로 처리하여 각 사용자를 대화 스레드와 연결하므로, 사용자가 수동으로 식별자를 추적할 필요가 없습니다.
결론
상태 저장 메모리는 프로덕션 AI 에이전트에 필수적입니다. 사이버 보안과 같은 도메인에서는 조사가 여러 턴과 세션에 걸쳐 진행되므로 에이전트가 효과를 발휘하려면 컨텍스트를 유지해야 합니다.
이 가이드에서는 LangGraph 체크포인트를 위한 트랜잭션 메모리 계층으로 레이크베이스를 사용하여 데이터브릭스에 상태 저장 사이버 보안 에이전트를 구축했어요. Unity Catalog 함수는 데이터에 대한 통제된 액세스를 제공하고, MLflow는 추적 및 라이프사이클 관리를 지원하며, Databricks AI Agent Framework는 배포를 단순화해요. 이러한 구성 요소가 함께 Databricks 플랫폼에서 완전히 실행되는 엔드 투 엔드 에이전트 아키텍처를 제공해요.
이 패턴은 연속성이 필요한 모든 다단계 워크플로에 광범위하게 적용됩니다. Lakebase를 사용하면 외부 데이터베이스 없이 에이전트에 대화형 메모리를 추가하고, 상태, 거버넌스, 배포를 단일 플랫폼에서 통합하여 유지할 수 있습니다.
리소스
다음은 무엇인가요?