Der eigentliche Engpass in der biomedizinischen Bildgebung sind die Daten, nicht das Modell
Von PACS-Silos zu Multi-Omics: Warum Bildgebungs-AI an Daten ins Stocken gerät und wie Sie das Fundament schaffen, um ihr Potenzial freizusetzen.
von Parastou Eslami und Douglas Moore
- Worum es geht: Eine Perspektive aus der Praxis dazu, warum KI für medizinische Bildgebung in Krankenhäusern, Wissenschaft, Medtech und Pharma hinter den Erwartungen zurückbleibt – und wie eine stärkere Datenbasis in der F&E aussieht.
- Die Herausforderung: Bildgebungsdaten sind die reichhaltigsten, aber am schwersten nutzbaren Daten der Medizin: isoliert in PACS, CROs und Zentrallaboren, schwer zu anonymisieren und selten mit anderen Datenmodalitäten verknüpft, die als Grundlage für Biomarker und Patientenstratifizierung dienen. Der schwierige Teil sind die Daten, nicht das Modell.
- Fazit: Die Zukunft liegt nicht in einem besseren Modell, sondern in der Datenbasis darunter. Verwalten Sie Bildgebungsdaten an einem zentralen Ort, machen Sie sie abfragbar, anonymisieren Sie sie im großen Maßstab und verknüpfen Sie sie mit EHR-, Omics- und Studiendaten (über Governance-gestützte Lakehouse-Muster). Stimmen die Daten, wird das Modell zum einfachen Teil.
Teil I — Das Problem
Vier Sektoren, ein Engpass
Krankenhäuser und Gesundheitssysteme liefern das Rohmaterial. Die Radiologie ist das am stärksten regulierte Gebiet der medizinischen KI: Von den rund 950 KI/ML-gestützten Geräten, die die FDA bis Mitte 2024 zugelassen hatte, waren etwa 723 (ca. 76 %) Radiologie-Tools. Fast alle sind hochspezialisiert und werden von Menschen überwacht; sie übernehmen Triage, Messung, Rekonstruktion oder die Priorisierung von Arbeitslisten. Die eigentliche Schwierigkeit in einem Krankenhaus ist selten das Modell. Es liegt daran, dass die Daten in PACS und herstellerneutralen Archiven gefangen sind, die dafür gebaut wurden, Bilder an ein Anzeigegerät zu liefern – nicht aber, um Forschungsfragen zu beantworten. Das Erstellen einer Kohorte bedeutet, Bilder aus klinischen Systemen zu extrahieren, sie zu anonymisieren (PHI versteckt sich in DICOM-Headern und ist in den Pixeln eingebrannt) und die nötige Rechenleistung für ihre Nutzung zu finden. Das Modell macht nur die einfachen 10 % aus.
Akademische medizinische Zentren sind der Ort, an dem der Großteil der Open Science stattfindet. Das Fachgebiet verdankt einen Großteil seines Fortschritts geteilten Datensätzen wie MIMIC-CXR (377.110 Brust-Röntgenbilder), The Cancer Imaging Archive, fastMRI und dem Imaging-Zweig der UK Biobank sowie Open-Source-Tools wie MONAI, nnU-Net und 3D Slicer. Die Wissenschaft offenbart jedoch auch das Glaubwürdigkeitsproblem des Fachgebiets. Eine bekannte BMJ-Übersichtsarbeit (Nagendran et al., 2020) über Studien zum Vergleich von Deep Learning und klinischem Fachpersonal im Bereich der Bildgebung ergab, dass von 81 Studien nur eine Handvoll prospektiv war oder in einem realen klinischen Umfeld getestet wurde, und dass Code sowie Daten in 93 % bzw. 95 % der Fälle nicht verfügbar waren. Diese Reproduzierbarkeitsschuld geht direkt darauf zurück, wie schwierig es ist, Bilddaten zu teilen und erneut auszuführen.
Medizintechnik- und Geräteunternehmen (GE HealthCare, Siemens Healthineers, Philips, Canon) integrieren KI direkt in den Scanner: Deep-Learning-Rekonstruktionen, die Untersuchungen verkürzen, Dosisreduktion, Triage direkt auf dem Gerät. Ihr schwierigstes Problem ist die Generalisierung. Ein Algorithmus, der auf dem Scanner, der Feldstärke und dem Protokoll eines bestimmten Herstellers trainiert wurde, kann auf dem eines anderen unbemerkt an Leistung verlieren. Das Kuratieren standortübergreifender Trainingsdaten, die die reale Welt widerspiegeln, und der anschließende Nachweis gegenüber Regulierungsbehörden über die 510(k)- und PMA-Pfade bilden sowohl den Wettbewerbsvorteil als auch den Kostenfaktor.
Pharma- und Biotech-Unternehmen betrachten die Bildgebung als Messinstrument. Onkologische Studien stützen sich auf standardisierte Ansprechkriterien wie RECIST, iRECIST und RANO, die zentral und verblindet ausgewertet werden, um Standort-Bias zu eliminieren. Quantitative Bildgebungs-Biomarker können das Ansprechen auf Medikamente früher erfassen als größenbasierte Maße. Nichts davon funktioniert jedoch, wenn eine Messung nicht über Standorte, Scanner und Zeitpunkte hinweg dasselbe bedeutet. Aus diesem Grund erstellt die QIBA der RSNA Profile, die Erfassung und Analyse auf eine definierte Präzision festlegen. Variabilität ist der Feind eines Studienendpunkts.
Vier verschiedene Aufgaben, ein gemeinsamer Engpass. Die Pixel sind überall vorhanden, aber nirgends abfragbar.

Warum Kollaboration alles entscheidet – und warum sie so schwer ist
Keine einzelne Institution verfügt über genügend vielfältige Daten, um ein Modell zu entwickeln, das generalisiert. Die bislang stärkste kollaborative Studie bringt dies auf den Punkt. In der EXAM-Studie (Nature Medicine, 2021) trainierten 20 Institutionen ein gemeinsames Modell zur Vorhersage des Sauerstoffbedarfs bei COVID-19 anhand von Brust-Röntgenbildern und EMR-Daten, ohne dass Patientendaten zwischen ihnen ausgetauscht wurden. Nur die Modellgewichtungen wurden übertragen, und das föderierte Modell gewann im Vergleich zu Monozenter-Modellen durchschnittlich 16 % an AUC und 38 % an Generalisierbarkeit. Die Mechanik ist weniger exotisch als sie klingt: Jeder Standort trainiert lokal, ein Koordinator bildet den Mittelwert der Modellgewichtungen statt der Daten (das klassische Federated-Averaging-Rezept), und sichere Aggregation sowie Differential Privacy verhindern, dass die Datensätze eines einzelnen Standorts aus diesen Gewichtungen rekonstruiert werden können.
Das ist das Versprechen. Die Realität ist, dass Kollaboration aus strukturellen statt technischen Gründen ausgesprochen schwierig ist:
- Datenheterogenität. Unterschiedliche Scanner, Protokolle und Labeling-Konventionen führen dazu, dass „dieselbe“ Untersuchung oft gar nicht dieselbe ist. Föderierte Modelle verlieren bei diesen non-IID, akquisitionsverzerrten Daten an Leistung, sofern nicht gezielt mit Techniken wie Batch-Normalization-Averaging oder standortbewusster Harmonisierung gegengesteuert wird.
- Datenschutz und Governance. Jede institutionsübergreifende Studie erfordert IRB-Genehmigungen pro Standort, Datennutzungsvereinbarungen und eine Anonymisierung, die rechtlich und technisch vertretbar sein muss.
- Keine gemeinsame Grundlage. Konsortien wie MIDRC (unter gemeinsamer Leitung von ACR, RSNA und AAPM) existieren eben genau deshalb, weil Datenerfassung, Kuratierung, Anonymisierung, Labeling und Sharing so schwierig sind, dass sie eine dedizierte nationale Anstrengung erfordern.
Kollaboration in der Bildgebung ist kein Nice-to-have. Sie ist der einzige Weg zu Modellen, die auch außerhalb des Gebäudes funktionieren, in dem sie trainiert wurden – und sie wird fast ausschließlich durch Dateninfrastruktur und Governance begrenzt.
Die Komplexität, die Außenstehende meist nicht sehen
Wenn Menschen von „medizinischen Bildern“ sprechen, denken sie meist an ein Brust-Röntgenbild. Die Realität ist ein Zoo von Formaten und Skalierungen, der allgemeine Daten-Tools an ihre Grenzen bringt.
| Bildgebungstyp | Formate | Dimensionen & Skalierung | Warum allgemeine Tools an ihre Grenzen stoßen |
|---|---|---|---|
| Radiologie — Röntgen, CT, MRT | DICOM, kodierbar in etwa einem Dutzend Transfersyntaxen (unkomprimiert → JPEG 2000 → HTJ2K) | 2D-Röntgen → 3D-CT/MRT-Volumina → 4D dynamisch kardial | Entwickelt, um Untersuchungen zwischen Geräten zu übertragen, nicht für die Massenanalyse; Dekodierer (pydicom, GDCM, pylibjpeg) laufen einzelsträngig – einige wenige Untersuchungen sind trivial, einige Millionen ein Problem verteilter Systeme |
| Digitale Pathologie — Whole-Slide-Images | Herstellerformate: Aperio .svs, Hamamatsu .ndpi, Philips iSyntax (über OpenSlide); fast kein DICOM | Gigapixel — mehrere GB, zehntausende Kacheln, eingelesen als Pyramide in verschiedenen Vergrößerungsstufen | Zu groß, um im Arbeitsspeicher geöffnet zu werden; Färbung und Scannerfarbe variieren von Labor zu Labor und werden so zu einer eigenen Quelle für Modellfehler |
| Ophthalmologie, Dermatologie & andere | OCT-Volumina, klinische Fotografie, jeweils mit eigenen Konventionen | 2D und 3D, modalitätsspezifisch | Ein weiteres Set an Formaten, für die ein Tool für JPEG-Ordner nie ausgelegt war |
„Medizinische Bilder“ sind nicht bloß eine Einheitskategorie – sie sind ein Zoo von Formaten und Skalierungen. Forschungsarchive erreichen Petabytes; groß genug, dass ihre umfassende Anonymisierung ein eigenes Forschungsfeld darstellt.
Es gibt eine zweite Art von Komplexität, die Studien im Stillen scheitern lässt: Die Zahlen selbst sind standortübergreifend nicht vergleichbar. Ein Standardized Uptake Value oder ein Tumorvolumen, das auf zwei Scannern mit zwei unterschiedlichen Protokollen gemessen wurde, ist nicht dieselbe Messung. Aus diesem Grund stützt sich die quantitative Bildgebung auf Standards wie QIBA-Profile und die IBSI-Definitionen für Radiomics-Merkmale – und deshalb scheitert es meist an der Reproduzierbarkeit, nicht an der reinen Genauigkeit.
Ein Tool, das einen Ordner voller JPEGs verarbeitet, kann nichts davon bewältigen. Das ist ein Hauptgrund dafür, dass die Bildgebung bei der Bereitstellung analysefertiger Daten hinter der Genomik und den EHR-Daten zurückgeblieben ist.
Die Bildgebung ist die Spitze eines größeren Problems
Was man leicht übersieht, wenn der Fokus nur auf Bildern liegt: Alles hier Gesagte gilt auch für den Rest der F&E. Die Bildgebung ist lediglich der Bereich, in dem der Schmerz zuerst spürbar wird, weil die Daten dort am größten und ungewöhnlichsten sind.
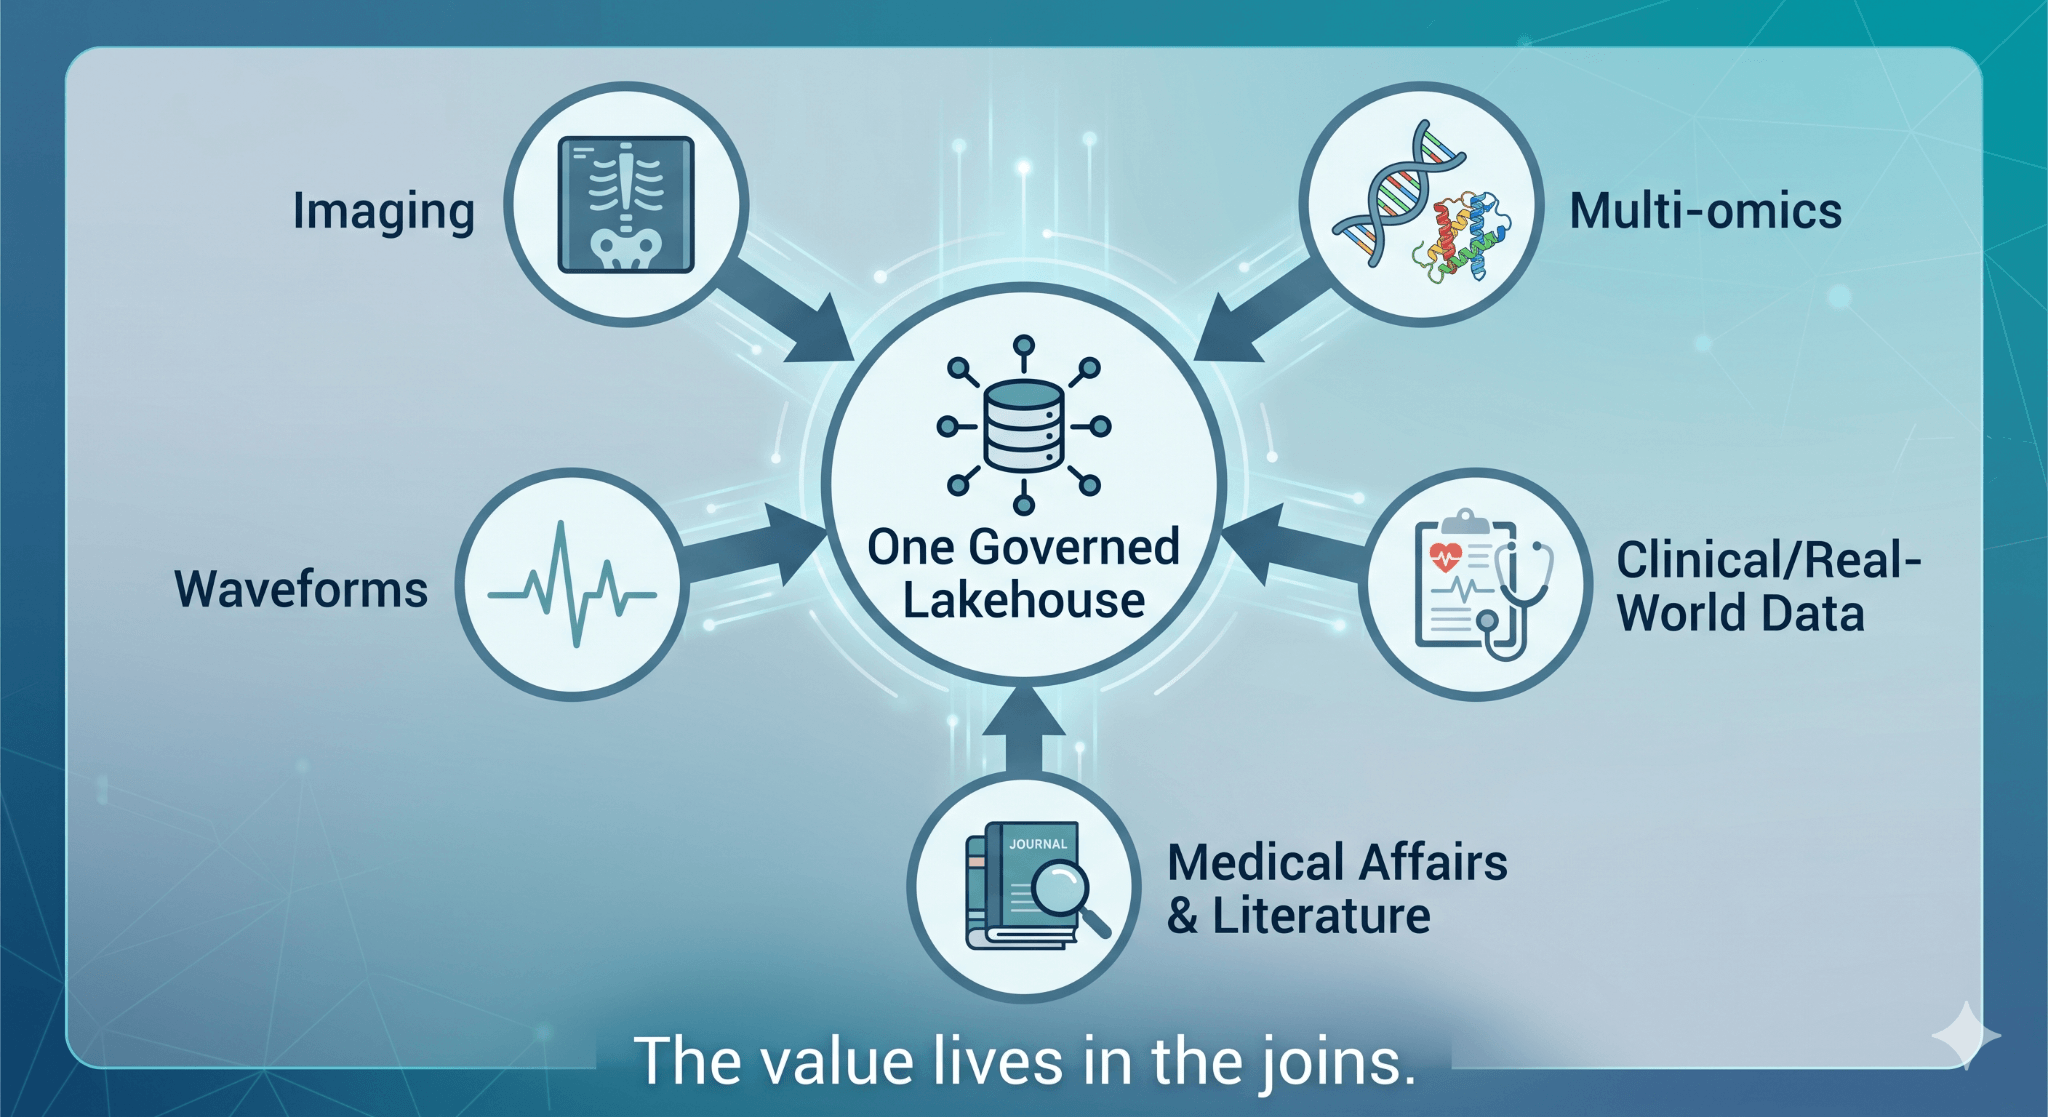
Wenn Sie heute in eine F&E-Organisation der Life Sciences blicken, liegt die eigentliche Grenze bei keinem einzelnen Datentyp. Es ist Multi-Omics – Genomik, Transkriptomik, Proteomik und Metabolomik –, wo jede Disziplin mit eigenen Formaten und Silos aufwartet. Es sind Real-World- und klinische Studiendaten, EHRs, Register und Wellenformen. Es sind Medical Affairs und die Fachliteratur. Die Fragen, die ein Programm tatsächlich voranbringen – welche Patienten ansprechen und warum, was das Bild zusammen mit der molekularen Signatur und dem Behandlungsergebnis aussagt –, liegen in den Verknüpfungen zwischen diesen Domänen, nicht innerhalb einer einzelnen.
Jeder dieser Datentypen leidet unter derselben Problematik wie die Bildgebung. Sie sind reichhaltig, hochdimensional, größtenteils unstrukturiert, in domänenspezifischen Systemen gefangen, schwer zu steuern und noch schwerer zu verknüpfen. Ein Whole-Slide-Image, ein genomic Variant Call und ein Studienendpunkt sind jeder für sich schon komplex genug. Der Mehrwert entsteht, wenn man sie zusammenführt. Das ist ein Problem des Datenfundaments, noch bevor es überhaupt zu einem KI-Problem wird, und genau das schätzen Teams am häufigsten falsch ein.
Dies ist nicht nur eine Geschichte aus dem Gesundheitswesen. Eine jüngste Bain-Analyse zur Frage, warum KI-Budgets weiter steigen, während die Erträge ausbleiben, ergab, dass Datenzugriff und -integration das mit Abstand größte Hindernis für KI sind – genannt von 41 % der Unternehmen und von Vorreitern noch häufiger angeführt als von Nachzüglern. Ihre unverblümte Fazit: Die meisten Organisationen können immer noch nicht zuverlässig auf ihre eigenen Daten zugreifen. Die Medizin macht es lediglich schwerer, davor die Augen zu verschließen.
Teil II — Das Fundament
Hier wird es konkret und technischer. Für Leser, die die Plattform nicht selbst aufbauen, lautet die Kurzfassung schlicht: Governen Sie alles an einem zentralen Ort, machen Sie die Pixel abfragbar, anonymisieren Sie skalierbar und verknüpfen Sie die Bildgebung mit den restlichen Patientendaten. Der Rest dieses Abschnitts zeigt, wie das geht.
Was das Datenfundament tatsächlich leisten muss
Sieht man von den sektorspezifischen Besonderheiten ab, sind die Anforderungen dieselben. Die Plattform muss:
- Unstrukturierte Bilddateien und deren extrahierte Metadaten an einem zentralen Ort verwalten – mit Zugriffskontrollen, Lineage und Auditierbarkeit, die den Fragen einer Regulierungsbehörde standhalten.
- Verarbeiten Sie Petabyte-große, Gigapixel- und mehrdimensionale Daten (2D-Röntgen, 3D-CT/MRT-Volumina, dynamische 4D-Studien, Gigapixel-Pathologie-Präparate) ohne Leistungseinbußen.
- Anonymisieren Sie Daten im großen Maßstab, sowohl in den Headern als auch in den Pixeln.
- Verknüpfen Sie Bilddaten mit EHR, Genomik, Signalformen und Texten, sodass eine einzige Forschungsfrage all diese Bereiche abdecken kann.
- Machen Sie die einrichtungsübergreifende Weitergabe zu einem einfachen Konfigurationsschritt statt zu monatelangen Verhandlungen.
Das zeichnet ein Lakehouse aus. Hier erfahren Sie, wie sich das in der Praxis mit bewährten Mustern auf Databricks umsetzen lässt.
Eine Medallion-Architektur für Pixel
Das mentale Modell, das die Verarbeitung von Bilddaten handhabbar macht, ist dasselbe Medallion-Muster, das Teams bereits für tabellarische Daten verwenden – angepasst für Binärdateien.
- Bronze: Rohstudien landen zunächst in einem zugangsbeschränkten Cloud-Objektspeicher oder Volume, wo als Erstes ein Anonymisierungsjob für Header und Pixel ausgeführt wird. Die anonymisierten Dateien bilden dann die verwaltete Bronze-Schicht in Unity Catalog-Volumes (eine Katalogzeile pro Datei), wobei Auto Loader das inkrementelle Eintreffen übernimmt, sodass neue Studien kontinuierlich einfließen, statt in fehleranfälligen nächtlichen Batches.
- Silver: Die textbasierten DICOM-Tags werden in Delta-Tabellen extrahiert (binäre Blobs wie die Pixeldaten bleiben in der Datei), sodass die in den Dateien verborgenen Metadaten mit einfachem SQL abfragbar werden. Dies ist der Schritt, der aus „Ein Viewer kann es öffnen“ ein „Ein Analyst kann es abfragen“ macht. Der Open-Source-Beschleuniger Pixels macht genau das: Er katalogisiert Dateien parallel und extrahiert Tags im großen Maßstab.
- Gold: Kuratierte, analysebereite Kohorten, verknüpft mit klinischen und Omics-Tabellen und bereit für Training, BI oder behördlich relevante Studien.
Dass dies nicht trivial ist, liegt am Durchsatz. DICOM-Parsing-Bibliotheken nutzen nur einen einzelnen Kern; der Trick besteht darin, sie zu verteilen. In der Praxis bedeutet das pandas-UDFs und mapInPandas zur Verteilung des Parsings über einen Cluster oder eine benutzerdefinierte Spark-Datenquelle. In einer vom Pixels-Team veröffentlichten Arbeit liest eine zipdcm-Datenquelle DICOM-Metadaten direkt aus Zip-Archiven im Speicher, während die Ursprungsdateien komprimiert an Ort und Stelle verbleiben: Sie katalogisierte mehr als 107.000 DICOMs in etwa 3,5 Minuten auf zwei Worker-Knoten mit je 8 Kernen – etwa 7-mal schneller als bisherige Ansätze. Der Engpass verlagert sich von Festplatten- und Netzwerk-I/O auf reine CPU-Verarbeitung – genau das, worin ein Cluster stark ist.

Governance, die jeder Überprüfung standhält
Bilddaten sind die ultimative Herausforderung bei der Governance unstrukturierter Daten – und eine Anforderung, an der die meisten Plattformen stillschweigend scheitern. Unity Catalog-Volumes verwalten die Rohdateien in S3, ADLS oder GCS unter einem dreistufigen Namespace, während die extrahierten Metadaten in Delta landen. Beide unterliegen einem gemeinsamen Zugriffssteuerungs- und Lineage-Modell, das bis zu den mit den Daten trainierten Modellen reicht. So lässt sich auch Monate später noch nachvollziehen, wer auf diese Kohorte zugegriffen hat und was daraus entstanden ist. Durch Sicherheit auf Zeilen- und Spaltenebene sowie attributbasierte Regeln können Organisationen anonymisierte Metadaten breit verfügbar machen, während die zugrunde liegenden Pixel geschützt bleiben.
Bei der Anonymisierung zeigt sich die wahre Komplexität. PHI in Headern wird mit format-erhaltender Verschlüsselung verarbeitet, sodass dieselbe Patientenkennung immer demselben Pseudonym zugeordnet wird. Dieses Detail ist wichtiger, als es scheint: Ein CT-Scan kann so über Datensätze hinweg mit Pathologie- und Laborwerten verknüpft werden, ohne jemals die echte Kennung offenzulegen. Die Vertraulichkeitsprofile des DICOM-Standards legen fest, was entfernt und was beibehalten wird. Das schwierigere Problem sind in Pixeln eingebrannte PHI – etwa der Patientenname in einem Ultraschallbild oder einem gescannten Formular. Klassische Tools wie Presidio verarbeiten Freitext gut, übersehen aber Bilder. Das Entfernen dieser eingebrannten PHI ist Gegenstand aktueller Forschung: Neuere Arbeiten zeigen, dass Vision-Language-Modelle bei der Erkennung und Unkenntlichmachung mittlerweile reine OCR-Pipelines übertreffen (Lee et al., Radiology 2025). Zudem wurden produktive Anonymisierungsmethoden, die die Bereinigung von DICOM-Metadaten mit gezielter OCR auf eingebranntem Text kombinieren, an Hunderttausenden von Bildern über zehn Modalitäten hinweg validiert (Macdonald et al., 2024). Für Pixel hat das Pixels-Team eine Vision-Language-Modell-Pipeline veröffentlicht, die OCR mit einem VLM kombiniert und verteilt über pandas-UDFs ausgeführt wird. Bei einer ausgewogenen Stichprobe aus dem MIDI-B-Benchmark erreichten GPT-4o und Claude 3.7 Sonnet nahezu 100 % Recall und Precision, das Open-Source-Modell Llama 4 Maverick erzielte 100 % Recall zu einem Bruchteil der Kosten, und Spark reduzierte die Anonymisierungszeit von 1.000 Einzelbildern von 105 Minuten auf 6 Minuten. Das Team untersucht außerdem einen schlankeren, reinen VLM-Ansatz, um dies noch weiter zu optimieren.
Training und Bereitstellung auf denselben verwalteten Daten
Sobald die Pixel abfragbar und verwaltet sind, ist die ML-Schicht keine Hürde mehr. Segmentierungs- und Klassifizierungsmodelle werden im selben Katalog wie MLflow-Modelle registriert, mit lückenloser Lineage zurück zur exakten Kohorte, auf der sie trainiert wurden. Speziell für die Bildverarbeitung lassen sich NVIDIA MONAI und VISTA-3D (ein Foundation-Segmentierungsmodell für 127 anatomische Klassen) für automatische Segmentierung und Feinabstimmung einbinden – mit einem OHIF-Viewer, der in eine Databricks App eingebettet ist, sodass Radiologen oder Pathologen Ergebnisse unter dem Sicherheitsmodell der Plattform prüfen, korrigieren und neu beschriften können.
Durch die Active-Learning-Schleife von MONAI Label verbessert jede Korrektur den nächsten Batch. So vermeiden Teams die Falle, erst einen vollständig annotierten Datensatz zu benötigen, bevor sie anfangen können. Die Inferenz läuft entweder als Echtzeit-GPU-Modellbereitstellung (mit Scale-to-Zero, damit selten genutzte Modelle keine GPU-Ressourcen verschwenden) oder als verteilte Batch-Inferenz über Millionen von Studien hinweg. Und da neuere Arbeiten an Pixels einen DICOMweb-Dienst (QIDO-RS, WADO-RS, STOW-RS) mitliefern, kann das Lakehouse direkt in klinische Workflows oder PACS/VNA-Abläufe integriert werden, statt als isolierte Lösung daneben zu stehen.
Sicherheit nachweisen: Validierung, Drift und regulatorische Vorgaben
Ein Modell zu trainieren ist erst der Anfang. Ein Modell, das auf dem Scanner eines Standorts hervorragende Ergebnisse liefert, kann auf dem eines anderen schleichend an Leistung verlieren. Die eigentliche Arbeit besteht daher in der externen Validierung über Standorte, Hersteller und Protokolle hinweg sowie der anschließenden Überwachung auf Drift, wenn Scanner aufgerüstet werden und sich Protokolle in der Produktion ändern. MLflow übernimmt Evaluierung und Tracking. Die größere Herausforderung liegt darin, jedes Modell als versioniertes Asset mit zugehöriger Kohorte, Metriken und Freigaben zu behandeln. Für Anwendungen im klinischen Umfeld kommen Regulierungsbehörden adaptiver KI mittlerweile entgegen. Der Predetermined Change Control Plan (PCCP) der FDA erlaubt es Teams, im Voraus festzulegen, wie ein Modell neu trainiert und aktualisiert werden kann, ohne jedes Mal einen neuen Antrag einzureichen. Good Machine Learning Practice (GMLP) definiert die Erwartungen an Daten, Validierung und Überwachung. Solche Schutzmechanismen direkt in die Datenbasis einzubauen, anstatt sie nachträglich aufzusetzen, unterscheidet eine Demo von einer Lösung, die in Krankenhäusern zum Einsatz kommt.
Zusammenarbeit ohne Datenbewegung
Es gibt zwei ergänzende Wege, um die einrichtungsübergreifende Vielfalt zu erreichen, die sich laut der EXAM-Studie als notwendig erwiesen hat – und beide lösen unterschiedliche Probleme.
Föderiertes Lernen belässt die Daten physisch vor Ort und überträgt nur die Modellgewichte. Verwendet werden Federated Averaging zur Zusammenführung sowie Secure Aggregation und Differential Privacy, damit keine Daten eines Standorts nach außen dringen. Das ist das richtige Werkzeug, wenn Daten aus rechtlichen Gründen nicht verschoben werden dürfen.
Das Lakehouse bietet eine zweite Option, die in der Praxis oft einfacher ist: Mit Delta Sharing und Clean Rooms können Einrichtungen verwaltete Tabellen und Dateien teilen (oder gemeinsame Analysen auf anonymisierten Kohorten ausführen), ohne etwas zu kopieren – basierend auf Credential Vending statt Datenexport. Für viele standortübergreifende Forschungsprojekte ist das Bereitstellen einer verwalteten Kohortenansicht wesentlich unkomplizierter als der Aufbau eines föderierten Trainingsnetzwerks – und beides lässt sich auch kombinieren.
Bilddaten multimodal machen
Erst diese Anforderung macht aus isolierten Bilddaten einen integrierten Bestandteil des Patientenbildes. Da die Metadaten als Delta-Tabellen vorliegen, können Bilddaten mit FHIR- und HL7-Feeds aus der EHR, mit Genomvarianten-Tabellen, Signalformen und klinischen Texten verknüpft werden, wobei die Patientenidentität über die Pseudonymisierungsschicht aufgelöst wird. Gemeinsame Datenmodelle wie OMOP bieten ein einheitliches Schema für Beobachtungsdaten. Darüber hinaus indiziert Vector Search Embeddings für den semantischen Abruf (Pixels bietet sogar eine Funktion, die einen umgangssprachlichen englischen Begriff dem passenden DICOM-Tag zuordnet), und Tools für natürliche Sprache wie Genie ermöglichen es Forschenden, Kohorten per einfacher Frage zu erstellen, statt SQL zu schreiben.
Physiologische Wellenformen sind eine ganz eigene Art von Daten. Ein EKG, eine Blutdruckkurve oder ein IVUS- bzw. OCT-Pullback ist eine hochfrequente Zeitreihe, die hunderte oder tausende Male pro Sekunde abgetastet wird und gewöhnlich in Formaten wie WFDB statt DICOM gespeichert wird. Die technische Hürde liegt in der Ausrichtung: Ein Pullback-Frame oder ein EKG-Schlag hat nur dann eine Bedeutung, wenn er zeitlich mit dem Bild und dem dazugehörigen klinischen Ereignis synchronisiert ist. Das richtig hinzubekommen, ein Resampling durchzuführen, Zeitstempel abzugleichen und die Zeitreihe direkt neben der Studie zu speichern, ist genau die Art von Join, die sich auszahlt, wenn die Frage lautet, warum ein Patient angesprochen hat, und nicht nur ob.
Embeddings ermöglichen außerdem weit mehr als nur die Suche. Bild-Text-Modelle, die auf gepaarten Scans und Befunden trainiert wurden (wie BiomedCLIP und CheXzero), bringen Bilder und Sprache in einen gemeinsamen Vektorraum. So können Systeme ähnliche Fälle abrufen, Befunde ohne explizites Label kennzeichnen oder ein generatives Modell auf den tatsächlichen Bildern und früheren Befunden eines Patienten verankern statt nur auf seinen Trainingsdaten. Genau dieses Muster – Retrieval-Augmented Generation über Bilder und Befunde – macht die Erstellung von Befundentwürfen und Fallzusammenfassungen verlässlich genug, um sie medizinischem Fachpersonal vorzulegen: Das Modell kann auf das verweisen, was es gesehen hat. Das funktioniert nur, wenn Bilder, Befunde und ihre Embeddings unter einem einzigen kontrollierten Dach zusammengeführt sind – was diesen gesamten Beitrag im Kleinen zusammenfasst.
Genau das benötigt auch die neue Welle von Foundation Models. Prov-GigaPath (Nature, 2024), mit Self-Supervision auf 1,3 Milliarden Kacheln aus 171.189 Whole-Slide-Bildern vortrainiert, funktioniert nur mit großen, diversen, Governance-konformen und multimodalen Daten. Datensilos können das nicht liefern. Ein Lakehouse hingegen schon.
Der Mehrwert: Ein Co-Scientist für die Forschung, ein Begleiter für die Klinik
Die greifbare Form all dessen ist kein autonomes System, das jemanden ersetzt. Es ist ein Begleiter – ein KI-Co-Scientist für Forschende und ein Co-Pilot für Ärztinnen und Ärzte –, der auf den eigenen, kontrollierten Daten der Institution basiert und nicht auf dem offenen Internet.
Für Forschende verwandelt ein Co-Scientist-Agent eine Frage direkt in Arbeit. Bitten Sie ihn: „Finde behandlungsnaive NSCLC-Patienten mit einer Baseline-CT, passender Pathologie und EGFR-Status und fasse zusammen, wie sich die Läsionen im Verlauf verändert haben“, und er plant die Schritte, fragt die Bild- und klinischen Tabellen über einen Genie-Bereich ab, ruft ähnliche Fälle mit Vector Search ab, ruft einen Segmentierungs-Endpunkt auf, um die Läsionen zu messen, und stützt seine Zusammenfassung auf die relevante Literatur – wobei jede Aussage bis zu den verwendeten Daten rückverfolgbar ist.
Die neue Klasse von „KI-Co-Scientist“-Systemen setzt genau hier an: Sie hilft bei der Generierung und Priorisierung von Hypothesen, statt nur Suchanfragen zu beantworten. Was eine Bastelei von einem vertrauenswürdigen Partner unterscheidet, ist die Frage, ob sie auf kontrollierten, multimodalen Daten basiert.
Für Mediziner wird dieselbe Technologie zu einem Begleiter, der die Vorarbeit leistet, die eine Radiologin oder ein Onkologe sonst manuell erledigen müsste: Voruntersuchungen des Patienten abrufen, Läsionen messen und vergleichen, relevante Leitlinienkriterien hervorheben und den Befundentwurf zur Prüfung erstellen. Er übernimmt nie die finale Freigabe – das tut der Mensch. Das ist keine Einschränkung, sondern Absicht. Nahezu jede heute zugelassene Bildgebungs-KI ist menschlich überwacht, und ein Begleiter, der seine Arbeit offenlegt und seine Quellen zitiert, macht diese Überwachung zu einer echten Kontrolle statt zu einem bloßen Abnicken.
Was beide Varianten sicher macht, ist das Fundament darunter. Jedes Tool, das der Agent aufruft, ist ein kontrolliertes Objekt – eine Unity Catalog-Funktion, ein Model-Serving-Endpunkt, ein Vector Search-Index, ein Genie-Bereich. So beschränken dieselben Zugriffskontrollen, Lineage-Informationen und Identitäten, die die Pixel schützen, auch das, was der Agent sehen und tun kann. Wenn Sie Spezialisten – einen Radiologie-Agenten, einen Genomik-Agenten, einen Medical-Affairs-Agenten – unter einem Supervisor kombinieren, spiegelt das Agententeam die multimodalen Verknüpfungen wider, die das Datenfundament bereits ermöglicht. Der Begleiter ist der einfache Teil, sobald das Fundament stimmt.
Über die Bildgebung hinaus: Dasselbe Fundament trägt den Rest der F&E
Der Grund, warum dies über die Radiologie hinaus wichtig ist, liegt darin, dass genau dieselbe Architektur den Rest des F&E-Datenbestands aufnimmt. Multi-Omics (Genomik, Transkriptomik, Proteomik, Metabolomik) landet im selben Unity Catalog neben Bild- und klinischen Daten. Es bringt seine eigenen komplexen Formate und Standards mit – VCF für Varianten, BAM und CRAM für ausgerichtete Sequenzierungs-Reads, die GA4GH-Spezifikationen für Interoperabilität sowie Engines wie Glow und Hail für Analysen auf Bevölkerungsebene –, aber das Lakehouse-Muster ist identisch: Dateien verwalten, die abfragbare Schicht extrahieren und mit allem anderen verknüpfen.
Hier klinkt sich auch der NVIDIA-Stack wie BioNeMo und NIMs für Sequenz- und Strukturmodelle ein. Real-World- und Klinische-Studien-Daten, Register und Wellenformen schließen sich ohne Export an Bildgebungskohorten an. Medical Affairs und die Fachliteratur werden zu abfragbarem Text unter derselben Governance und derselben AI/BI- und Genie-Oberfläche. Die Programme, die Fortschritte bringen – diejenigen, die beantworten, welche Patienten ansprechen und warum –, leben in den Verknüpfungen zwischen diesen Domänen. Ein Lakehouse ist die seltene Architektur, die ein Gigapixel-Slide, einen Variant Call und einen Studienendpunkt unter einem einzigen Governance-Modell vereint und gemeinsam abfragbar macht.
Fazit

Teams, die KI und GenAI auf Basis dieser Daten entwickeln, machen immer wieder dieselbe Erfahrung. Ein Modell kann innerhalb einer Woche eine gute Demo liefern. Was danach Monate dauert, ist, die Daten so zu bereinigen, zu verknüpfen, zu anonymisieren und zu verwalten, dass man ihnen vor Forschenden oder Regulierungsbehörden vertrauen kann. Das Datenproblem ist nicht der unansehnliche Teil des Projekts. Es ist das Projekt.
Betrachtet man Bildgebungs-, Omics-, klinische und Medical-Affairs-Daten innerhalb derselben Organisationen, ist die Schlussfolgerung einfach: Der Durchbruch in der medizinischen Bildgebung ist keine bessere Architektur. Es ist ein besseres Fundament. Die Algorithmen existieren. Die Daten existieren – irgendwo. Was fehlte, war eine Möglichkeit, Bildgebung kontrolliert, abfragbar, verknüpfbar und teilbar zu machen und mit allem zu verbinden, was eine Forschungsfrage berührt, ohne auf die vom Medizinbereich geforderte Vertraulichkeit und Sorgfalt zu verzichten.
Die Teams, die in der F&E erfolgreich sein werden, sind nicht diejenigen, die zuerst dem Modell nachjagen. Es werden diejenigen sein, die zuerst die Daten in den Griff bekommen und die KI folgen lassen. Wenn Sie das lösen, wird das Modell zum einfachen Teil – so wie es schon immer war.
Wo Sie anfangen können
Der schnellste Weg, dies zu testen, ist mit Ihren eigenen Daten.
- Beginnen Sie mit dem Open-Source-Beschleuniger Pixels (databricks-industry-solutions/pixels), um einen Ordner mit DICOM-Dateien in kontrollierte, abfragbare Delta-Tabellen zu verwandeln und das Medallion-Muster in Aktion zu erleben.
- Führen Sie es auf Databricks aus. Erstellen Sie einen Workspace, richten Sie Unity Catalog Volumes auf einen öffentlichen Datensatz wie TCIA oder MIMIC-CXR aus und richten Sie die Erfassung, Anonymisierung und einen OHIF-Viewer durchgängig ein, bevor Sie geschützte Daten einbringen.
- Gehen Sie tiefer in die Technik ein hinter den Zahlen hier: die 7-fache Erfassungsgeschwindigkeit, VLM-Anonymisierung und die oben verlinkten MONAI/VISTA-3D-Berichte.
- Skalieren Sie von einer Kohorte auf den gesamten Bestand. Sobald ein einzelner Studientyp erfasst, anonymisiert und mit einer klinischen Tabelle verknüpft ist, lässt sich dasselbe Muster auf Multi-Omics, Real-World-Daten und die darüber liegende Agenten-Schicht ausweiten.
Wenn Ihr Team medizinische Bildgebung oder multimodale F&E auf Databricks entwickelt, würden die Autoren gerne erfahren, wie Sie vorgehen. Nehmen Sie Kontakt auf oder hinterlassen Sie einen Kommentar. Wenn Sie bereit sind, vom Pilotprojekt in die Produktion zu wechseln, kann Ihnen das Databricks Healthcare and Life Sciences Team dabei helfen.
(Dieser Blogbeitrag wurde mit KI-gestützten Tools übersetzt.) Originalbeitrag
Erhalten Sie die neuesten Beiträge in Ihrem Posteingang
Abonnieren Sie unseren Blog und erhalten Sie die neuesten Beiträge direkt in Ihren Posteingang.