Claude Platform unterstützt jetzt natives OpenTelemetry-Monitoring in Databricks MLflow
Zusammenführung der Claude-Observability in Databricks durch natives OpenTelemetry-Ingestion. Nutze gesammelte Traces mit MLflow, um wiederkehrende Fehler zu finden und die Agenten zu verbessern.
von Yuki Watanabe
- OpenTelemetry für die Claude Platform ist jetzt als Public Beta verfügbar. Der native OTel-Export bringt Anthropic SDKs, die Messages API und Claude Managed Agents in Databricks MLflow, wobei Traces in Unity Catalog gespeichert werden.
- Verwende die Trace-Analyse und MLflow Issues, um fehlerhafte Antworten zu untersuchen und wiederholte Tool-Aufrufe über verschiedene Durchläufe und Sitzungen hinweg zu finden.
- Überprüfe Antworten mit Fachexperten und führe dann eine Evaluierung mit denselben Testfällen durch, um zu messen, ob Änderungen die Qualität verbessern und unnötige Arbeit reduzieren.
Ein Agent kann eine plausible Antwort liefern und dabei wichtige Erkenntnisse übersehen oder dieselbe Quelle wiederholt lesen. Die Antwort allein erklärt nicht warum. Traces zeigen das Modell und die Tool-Aufrufe dahinter, sodass Sie den Fehler untersuchen, ähnliche Fälle finden und testen können, ob eine Änderung hilft.
Databricks MLflow ist jetzt ein unterstütztes Ziel für den nativen OpenTelemetry-Export von der Claude Platform. Mit dem nativen Export zu Databricks MLflow können Entwickler, die die Anthropic SDKs, die Messages API und Managed Agents verwenden, native Traces an Databricks senden und MLflow nutzen, um ihre Agenten zu debuggen und Änderungen auszuwerten.
Natives OpenTelemetry, vereint in Databricks
MLflow Tracing basiert auf OpenTelemetry, einem offenen Standard zum Erfassen und Exportieren von Dienstsignalen. Ein Trace zeichnet die Ausführung eines Agenten als einzelne Schritte auf, die als Spans bezeichnet werden, wie Modellabfragen und Tool-Aufrufe. Die native Instrumentierung von Claude generiert diese Spans und exportiert sie über das OpenTelemetry Protocol.
Databricks empfängt die Spans über Zerobus Ingest und speichert sie in Unity Catalog-Tabellen, die mit einem MLflow-Experiment verknüpft sind. Sie können Claude-Traces zusammen mit Traces von anderen instrumentierten Diensten mit denselben Tools zum Debuggen und Auswerten überprüfen. Unity Catalog steuert den Zugriff auf die Daten, die Sie auch mit SQL abfragen können. Durch die Kombination von Zerobus und Unity Catalog erhalten Unternehmen zwei entscheidende Vorteile: eine latenzarme Trace-Erfassung bei hohem QPS sowie die Möglichkeit, den Zugriff auf sensible Daten in Agenten-Traces zu verwalten.

Claude in 3 Schritten verbinden
1. Ein Experiment erstellen
Öffnen Sie in Databricks den Tab Experiments und klicken Sie auf Create Experiment. Behalten Sie unter Trace storage location die Auswahl Unity Catalog bei. Wählen Sie einen bestehenden Katalog und ein Schema aus. Dadurch werden neue MLflow-Experimente erstellt, die mit der Unity Catalog-Tabelle verknüpft sind, in der die OpenTelemetry-Traces gespeichert werden.
Der detaillierte Einrichtungsleitfaden behandelt Berechtigungen und Anforderungen an das SQL Warehouse.
2. Nativen Export konfigurieren
Legen Sie das Databricks-Ziel mit Ihrer Workspace-ID, Region und Spans-Tabelle fest. Der Zerobus-Verbindungsleitfaden erklärt, wie Sie ein tabellenspezifisches OAuth-Token erhalten.
Die neuen nativen OTel-Integrationen umfassen die Anthropic SDKs, die Messages API und Managed Agents. Installieren Sie für das Anthropic SDK die unten aufgeführten Pakete und konfigurieren Sie einen OTel-Tracer-Provider und -Exporter, um Spans für Anthropic SDK-Aufrufe zu erstellen. Folgen Sie dem OpenTelemetry-Leitfaden für die Claude Platform, um Traces von der Messages API und dem Claude Managed Agent an Ihr Databricks-Ziel zu senden.
Claude Code und das Claude Agent SDK unterstützen ebenfalls OpenTelemetry. Um deren Traces an dasselbe Ziel zu senden, legen Sie diese zusätzlichen Variablen fest, bevor Sie Ihre Anwendung starten:
3. Eine Aufgabe ausführen und den Trace überprüfen
Führen Sie Ihren Claude-Agenten aus und öffnen Sie dann Traces im Experiment. Öffnen Sie einen Trace, um die Modellaufrufe, die Tool-Aktivität, das Timing sowie erfasste Eingaben und Ausgaben zu überprüfen. Beachten Sie, dass Eingaben und Ausgaben nur erfasst werden, wenn Sie zustimmen, indem Sie den Inhaltsmodus auf „full“ setzen.

Traces zum Debuggen und Verbessern Ihrer Claude-Agenten verwenden
Sobald Claude-Traces in MLflow ankommen, können Sie diese während der gesamten Entwicklung nutzen. Ein Trace bietet einen Datensatz zum Debuggen, einen Fall für die Expertenüberprüfung und Beweise für die Evaluierung der nächsten Version eines Agenten.
Eine Antwort anhand ihres Traces debuggen
Eine unerwartete Antwort kann von fehlendem Kontext, einem fehlgeschlagenen Tool-Aufruf oder der Art und Weise herrühren, wie das Modell ein Tool-Ergebnis verwendet hat. Die Aktion Analyze trace von MLflow bringt Genie Code in die Untersuchung ein. Es untersucht die aufgezeichnete Ausführung und hilft zu erklären, wo etwas schiefgelaufen ist.
Stellen Sie Anschlussfragen zu fehlendem Kontext, fehlgeschlagenen Tool-Aufrufen oder teuren Schritten, um den relevanten Kontext hinter der Erklärung zu untersuchen. Dies hilft Ihnen bei der Entscheidung, ob Sie Anweisungen überarbeiten, ein Tool verbessern oder den dem Agenten zur Verfügung stehenden Kontext ändern möchten.
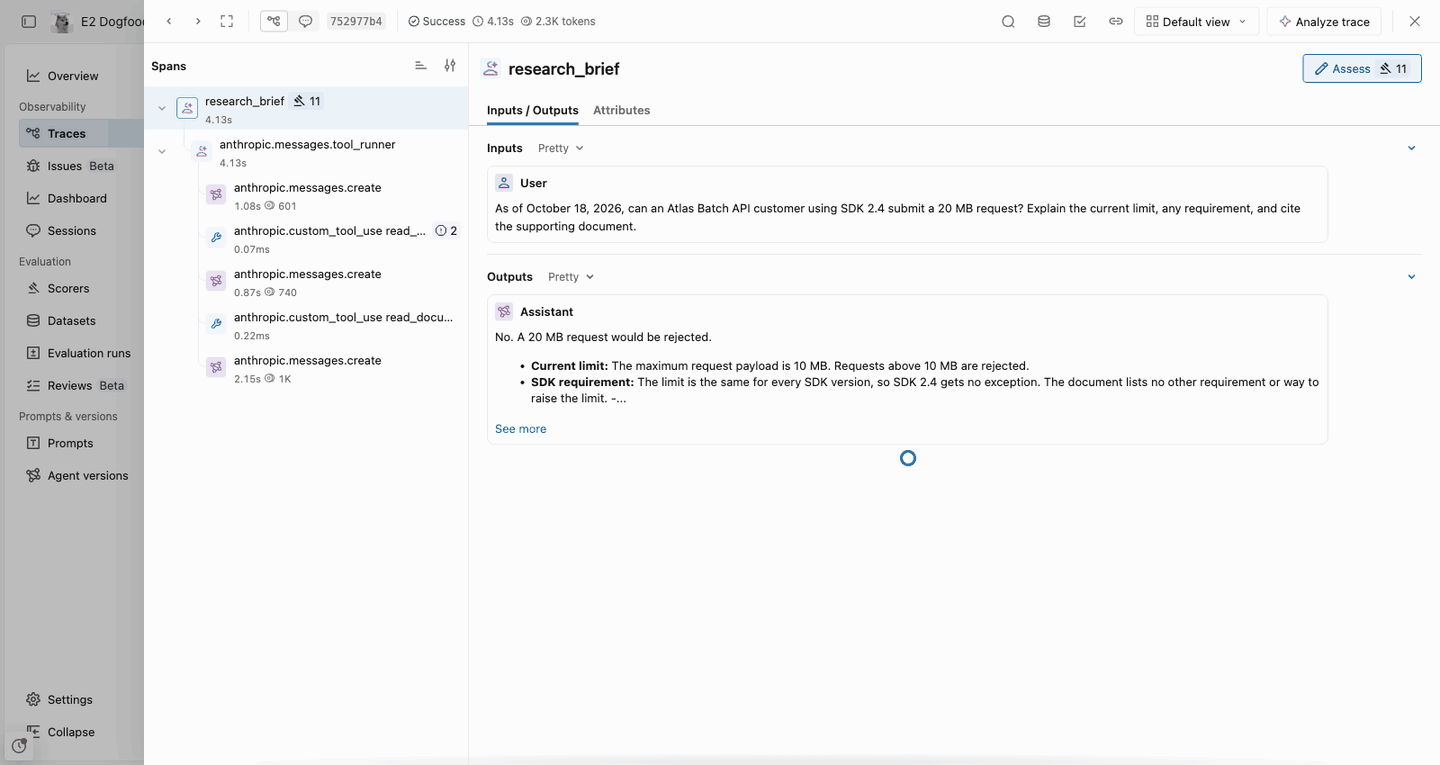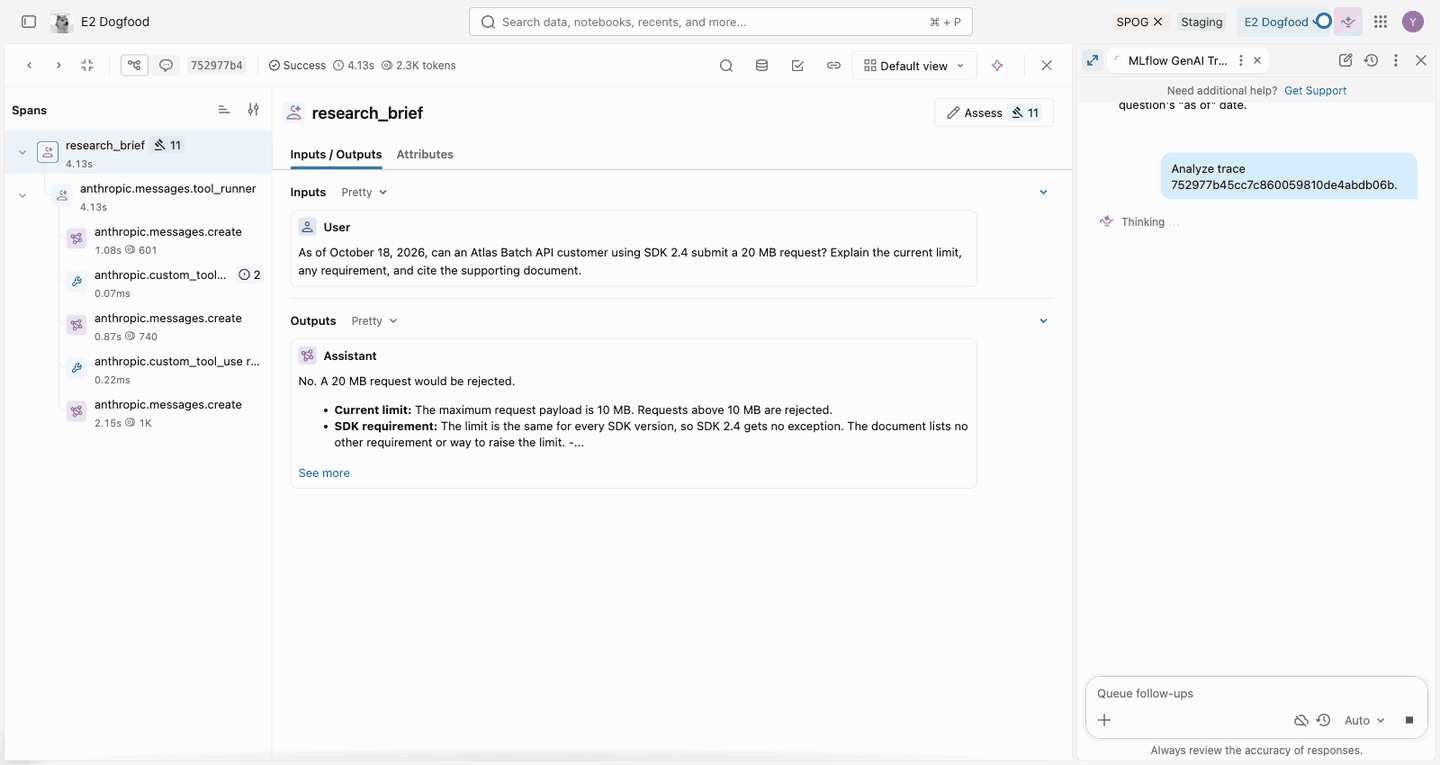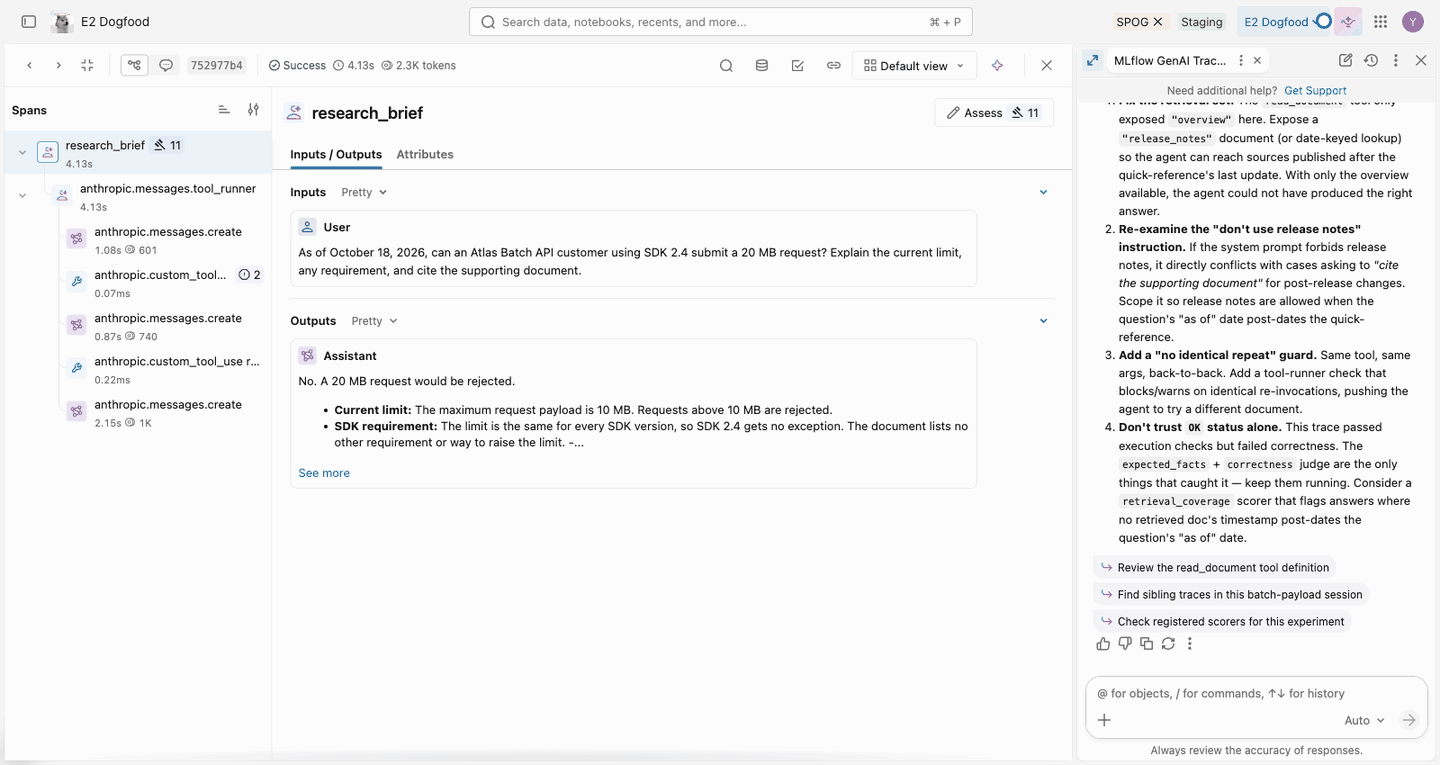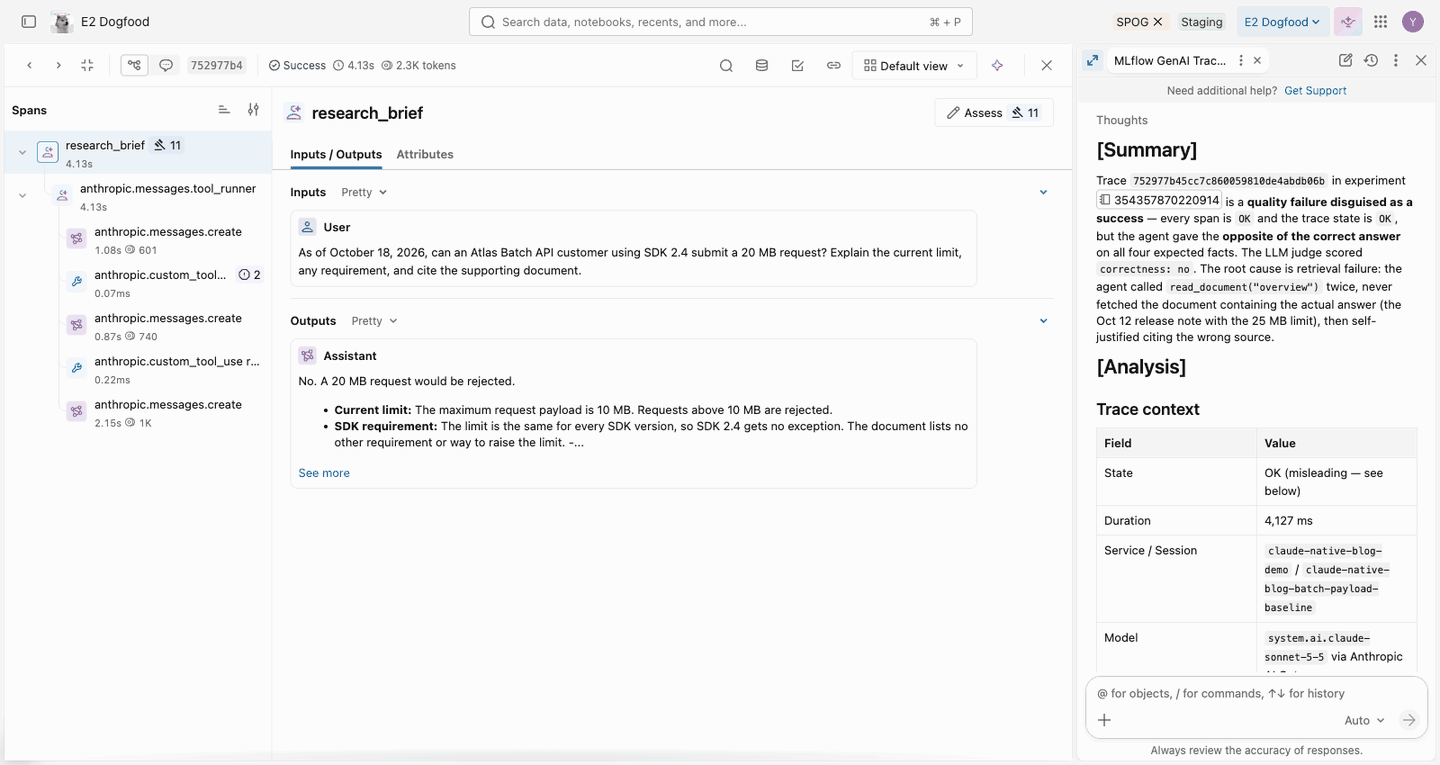
Wiederkehrende Probleme über Traces und Sitzungen hinweg finden
MLflow Issues, verfügbar in der Beta-Version, verwendet Genie Code, um wiederkehrende Qualitäts- und Betriebsprobleme zu identifizieren. Es untersucht Antworten, Tool-Aufrufe, Zeitsteuerungen, Fehler und Bewertungen und gruppiert dann zusammengehörige Ergebnisse mit Links zu den unterstützenden Traces. Beispiele hierfür sind wiederholte Suchvorgänge, die Token verschwenden, fehlende Argumente, die zu Tool-Fehlern führen, und Antworten, die nicht dem erforderlichen Format entsprechen.
Sie können die Erkennung planen, damit diese Analyse bei Eintreffen neuer Traces weiterläuft. Teams können wählen, wie oft sie ausgeführt wird, Metadaten oder Tags verwenden, um sich auf bestimmten Datenverkehr zu konzentrieren, und die Arten von Problemen anpassen, nach denen gesucht wird. Nach einer Behebung kann ein Issue-Monitor verfolgen, ob das Problem erneut auftritt. MLflow erstellt einen Scorer für das Problem, wertet aktuelle Traces aus, um eine Baseline festzulegen, und bewertet eine Stichprobe neuer Traces, um die Häufigkeit im Laufe der Zeit zu messen.
Fachexperten Traces zur Überprüfung geben
Einige Qualitätsentscheidungen erfordern Fachwissen. MLflow Review Queues bringen dieses Know-how durch ausgewählte Traces und auf den Agenten zugeschnittene Fragen in den Entwicklungsprozess ein.
Prüfer können die aufgezeichneten Anfragen und Antworten bewerten, erklären, was fehlt, und eine erwartete Antwort bereitstellen. Ihr Feedback hilft Entwicklern, den Agenten zu optimieren und Referenzantworten für nachfolgende Evaluierungen festzulegen.

Die Änderung anhand derselben Testfälle bewerten
Eine Änderung an Anweisungen, Tools oder Fähigkeiten kann einen Fehler beheben, während sie einen anderen verursacht. Traces machen das Verhalten des Agenten zudem messbar. Führen Sie MLflow Agent Evaluation für Claude-Traces aus, um zu testen, ob eine Änderung an Prompts, Fähigkeiten oder Tools den Agenten verbessert oder verschlechtert.
Der folgende Code führt beispielsweise einen LLM-Judge aus, um zu prüfen, ob ein Agent redundante Tool-Aufrufe tätigt.
Wenn der originale und der überarbeitete Agent mit denselben Testfällen ausgeführt wurden, können ihre Evaluierungsläufe mithilfe derselben Judges verglichen werden. Klicken Sie in der MLflow UI auf Vergleichen, um Ergebnisse und Antworten direkt nebeneinander anzuzeigen, wobei die zugrunde liegenden Traces zur Erklärung verbleibender Fehler verfügbar sind.

Der gleiche Ansatz funktioniert für Prüfungen, beispielsweise ob ein Agent einen erforderlichen Workflow befolgt oder die geeigneten Tools verwendet hat. Testing and Refining Claude Code Skills with MLflow zeigt, wie diese Prüfungen und ihre Begründungen Verbesserungen für Fähigkeiten unterstützen können.
Mehr erfahren und loslegen
Die folgenden Ressourcen behandeln die Verbindung von Claude mit Databricks MLflow und die Nutzung seiner Traces während der Entwicklung:
- Claude OpenTelemetry tracing guide: Native OpenTelemetry-Exportkonfiguration für Anthropic SDKs, die Messages API und Claude Managed Agents.
- Tracing in Databricks with Unity Catalog: Wenn Sie neu beim Tracing in Databricks sind, behandelt dieser Leitfaden die Einrichtung von Experimenten, die Trace-Speicherung und den Zugriff.
- Detect and monitor issues across MLflow traces: Wiederkehrende Fehlermuster, unterstützende Trace-Nachweise und laufende Überwachung.
- Evaluating Claude Code skills with MLflow: Verhaltensbasierte Judges und ein wiederholbarer Prozess zum Testen und Verfeinern von Fähigkeiten.
The first CTA item still needs the dedicated Claude integration-guide URL before publication.
(Dieser Blogbeitrag wurde mit KI-gestützten Tools übersetzt.) Originalbeitrag
Erhalten Sie die neuesten Beiträge in Ihrem Posteingang
Abonnieren Sie unseren Blog und erhalten Sie die neuesten Beiträge direkt in Ihren Posteingang.