Einführung von Agent Memory auf Databricks
von Sirui Sun und Nihit Desai
Heute führen wir Agent Memory auf Agent Bricks ein, der Plattform von Databricks für Agenten-Entwickler. Agent Memory verbessert die Qualität von Agenten und senkt gleichzeitig Kosten sowie Latenzzeiten, indem wichtige Fakten, Präferenzen und Workflows gespeichert werden, an die sich ein Agent erinnern sollte. Es ist ab heute in der Beta-Version verfügbar, läuft auf Lakebase für hohe Zuverlässigkeit sowie geringe Latenz und basiert auf den neuesten Forschungsergebnissen von Databricks im Bereich Memory.
Ohne Gedächtnis laufen Agenten Gefahr, grundlegende Fakten neu herausfinden zu müssen, Benutzerpräferenzen zu vergessen und Fehler zu wiederholen, die bereits korrigiert wurden. Aus diesem Grund entwickeln viele Entwickler eigene Memory-Lösungen, stoßen dabei jedoch auf zahlreiche Designfragen – zum Beispiel: Wo sollten Erinnerungen gespeichert werden? Wie sollten sie synthetisiert werden? Und wie sollen sie nach der Erstellung abgerufen werden?
Um dieses Problem zu lösen, basiert Databricks Agent Memory auf der MemCurrent-Architektur, die von Databricks Research entwickelt wurde. MemCurrent kombiniert drei Zugriffsmuster: Plugins zum automatischen Protokollieren und Laden von Kontext, Tools, die der Agent bei Bedarf aufruft, und eine Offline-Dreaming-Pipeline, die das Gedächtnis im Hintergrund konsolidiert. Das alles wird mit extrem geringer Latenz über Lakebase bereitgestellt. In unseren internen Benchmarks hat die Implementierung dieser Memory-Architektur die Erfolgsquote von Agenten bei realen Unternehmensaufgaben verdreifacht – bei 31 % weniger Token-Verbrauch.
Agent Memory ergänzt das restliche Angebot von Agent Bricks, darunter Agent-Hosting, Databricks Sandbox, Unity Gateway, vorgefertigte MCP-Server sowie Tracing und Evaluierung. Damit erhalten Entwickler alle Infrastrukturfunktionen, die für den Aufbau von Produktions-Agenten erforderlich sind.
Problem: Zustandslose Agenten zahlen doppelt für denselben Kontext
Zwei Probleme treten auf, sobald ein Agent von der Demo-Phase in den täglichen Einsatz übergeht.
- Die Kosten steigen mit jeder erneuten Erkenntnis. Ein zustandsloser Agent leitet das, was er gestern herausgefunden hat, erneut ab: welche Tabelle Nutzungsdaten enthält, was ein internes Akronym bedeutet, welcher Join tatsächlich funktioniert. In einer realen Session aus unserer Forschung benötigte ein Agent 11 Tool-Aufrufe, 8 Sub-Agenten und fast sechs Minuten, um eine Frage zu den Top-Kunden eines Produkts zu beantworten. Am nächsten Tag hätte er all das noch einmal gemacht.
- Agenten werden nie persönlich. Ein Benutzer nennt eine Präferenz, korrigiert einen Fehler oder erklärt, wie sein Team eine Metrik definiert, und der Agent vergisst dies nach Ende der Session. Entweder muss sich der Benutzer wiederholen, oder der Agent wiederholt den Fehler.
Entwickler von Agenten und die Plattform-Teams, die sie betreiben, nutzen gewöhnlich zwei Workarounds. Bei beiden wird jedoch lediglich ein Problem gegen ein anderes eingetauscht:
- Das erneute Einspielen des gesamten Verlaufs in den Kontext funktioniert so lange, bis die Verläufe lang werden. Bei Open-Source-Memory-Benchmarks verbrauchte der vollständige Kontext etwa 12-mal mehr Eingabe-Token pro Frage als ein gut durchdachter Speicher bei gleicher Genauigkeit. Bei den längsten Verläufen schnitt er sogar schlechter ab, da irrelevante Interaktionen den Agenten verwirrten.
- Memory selbst aufzubauen (auf Objektspeichern oder Vektordatenbanken) bedeutet, dass Sie sich selbst um Extraktion, Entduplizierung, Abruf und Zugriffskontrolle kümmern müssen. Erinnerungen veralten, widersprüchliche Fakten häufen sich an und niemand kann sagen, welcher Speichereintrag zu einer schlechten Antwort geführt hat.
Was Teams brauchen, ist ein Gedächtnis, das Agenten gleichzeitig günstiger und persönlicher macht – ohne ein weiteres System aufsetzen zu müssen.
So funktioniert Agent Memory auf Databricks
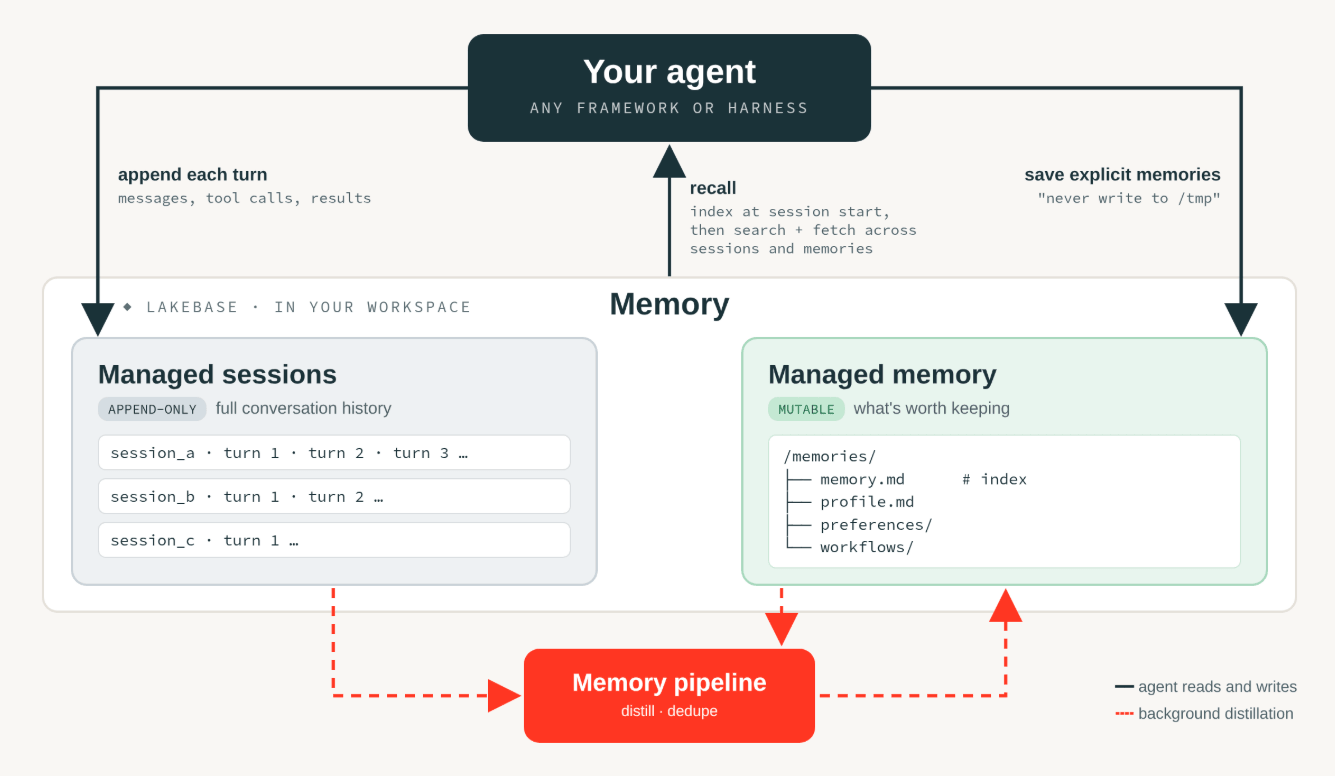
Abbildung 1. Agent Memory auf Agent Bricks. Der Agent hängt jeden Interaktionsschritt an verwaltete Sessions an, ruft Erinnerungen direkt ab und speichert sie, während eine Memory-Pipeline im Hintergrund die Sessions zu einem Langzeitgedächtnis verdichtet.
Agent Memory besteht aus drei Teilen:
- Verwaltete Sessions (Managed Sessions) zeichnen jede Unterhaltung als geordneten Verlauf von Nachrichten, Tool-Aufrufen und Ergebnissen im nativen Format Ihres Frameworks auf.
- Verwalteter Speicher (Managed Memory) bewahrt auf, was sich zu merken lohnt: Profil, Präferenzen, Domänenwissen und Workflows. Zu Beginn einer Session lädt der Agent einen Index dessen, was im Speicher vorhanden ist. Während der Session findet er Details mithilfe einer hybriden Stichwort- und semantischen Suche.
- Memory-Pipelines verdichten Sessions im Hintergrund zu Speichereinträgen – bei Bedarf oder regelmäßig im Hintergrund. Sie extrahieren dauerhafte Fakten und Präferenzen, entfernen Duplikate und ersetzen Fakten, denen neuere Unterhaltungen widersprechen.
Alles läuft auf Lakebase, der serverlosen Postgres-Lösung von Databricks, die in Ihrem Workspace bereitgestellt und von Databricks betrieben wird. Dies stellt sicher, dass das Speichern und Abrufen von Erinnerungen blitzschnell erfolgt und Ihre Speicher mit Ihrem Agent-Traffic skalieren können.
Basiert auf unserer Memory-Forschung
Agent Memory ist eine Produktionsimplementierung von MemCurrent, dem Memory-System, das in MemCurrent: Designing Memory for Enterprise Agents beschrieben wird. Die zentrale Erkenntnis unserer Forscher ist, dass Memory auf zwei Ebenen am besten funktioniert: ein Rohprotokoll des Geschehenen und ein verdichtetes Protokoll dessen, was sich zu merken lohnt – das von einem Hintergrundprozess aktuell gehalten wird, anstatt vom Agenten mitten in einer Aufgabe ad hoc geschrieben zu werden.
So aufgebaut, verbesserte Memory die Qualität und Effizienz gleichermaßen. Agenten absolvierten etwa dreimal so viele Aufgaben wie Agenten ohne Memory, schlossen sie schneller ab und verbrauchten weniger Token. Die gleiche Infrastruktur treibt bereits das Gedächtnis in Genie an, der Natural-Language-Erfahrung von Databricks für Business-Anwender.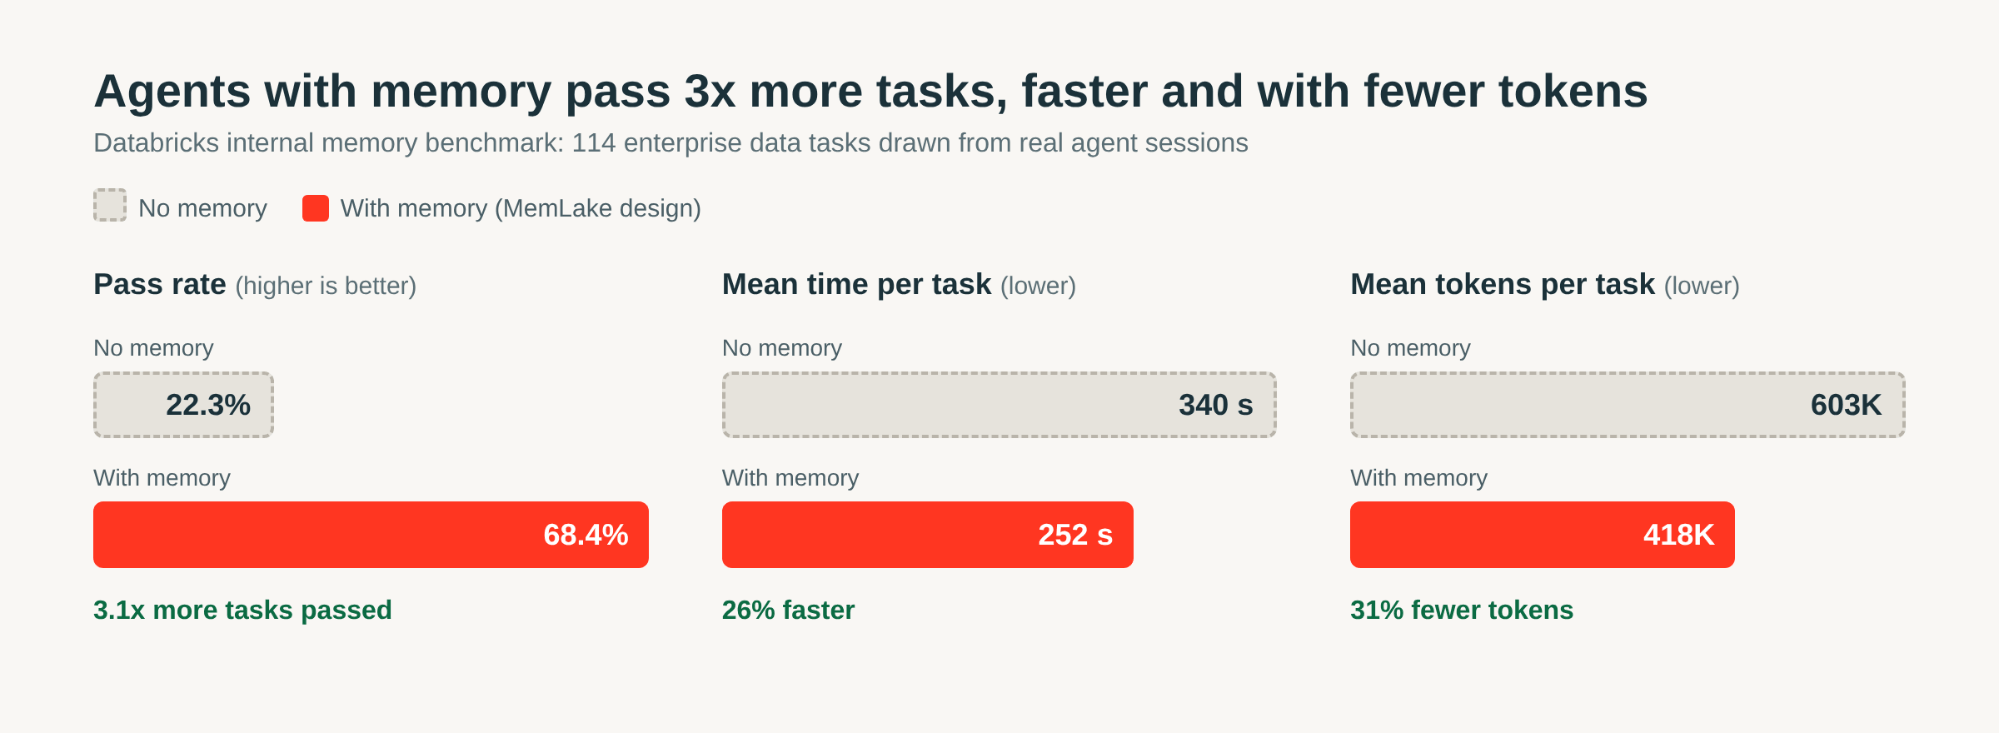
Abbildung 2. Agenten mit und ohne Memory beim internen Memory-Benchmark von Databricks für Unternehmensdaten-Aufgaben. Quelle: MemCurrent-Forschung.
Was sich für Ihre Agenten ändert
- Geringere Kosten pro Aufgabe. Agenten überspringen Arbeiten, die sie bereits erledigt haben. Im obigen Beispiel beantwortete der Agent, nachdem der Workflow im Speicher gesichert wurde, eine verwandte Folgefrage mit nur 2 Tool-Aufrufen in 41 Sekunden – im Vergleich zu 11 Tool-Aufrufen und fast sechs Minuten zuvor.
- Dauerhafte Personalisierung. Präferenzen, Korrekturen und teamspezifische Definitionen bleiben über Sessions hinweg für den jeweiligen Benutzer erhalten, sodass sich niemand mehr wiederholen muss.
- Fehler, die korrigiert bleiben. Agenten erinnern sich an ihre Fehler und können vermeiden, denselben Fehler zweimal zu machen – was wertvolle Zeit und Token spart.
- Memory unter Ihrer Kontrolle. Sessions und Speicher befinden sich in Ihrem Lakebase-Projekt, unabhängig von einem einzelnen Agent-Framework. Entwickler können die Einträge, die ein Agent für jeden Benutzer führt, lesen, exportieren und löschen sowie der Memory-Pipeline Anweisungen geben, was sie aufbewahren soll, wie z. B.: „Dauerhafte Kundenpräferenzen behalten; einmalige Debugging-Notizen ignorieren.“
- Eine Plattform für den gesamten Ablauf. Derselbe Agent nutzt Modelle über Unity Gateway, wird mit der Agent Bricks CLI bereitgestellt und über das Tracing von Agent Bricks nachverfolgt sowie evaluiert – inklusive Memory.
Erste Schritte
Nichts davon erfordert neue Infrastruktur Ihrerseits. Mit der Agent Bricks CLI können Sie in wenigen Minuten einen Agenten mit Memory und Sessions bereitstellen.
Von da an beginnt die nächste Unterhaltung Ihres Agents mit jedem Benutzer mit dem, was er aus den vorherigen gelernt hat. Weitere Informationen finden Sie im Quickstart zur Erstellung eines neuen Agents mit Memory oder in unserem Tutorial zum Hinzufügen von Memory zu einem vorhandenen Agent.
Agent Memory ist ein Teil von Agent Bricks, der Agent-Entwicklungsplattform von Databricks zum Erstellen, Ausführen und Verbessern benutzerdefinierter Agents in beliebigem Umfang mit jedem Modell, Framework oder Harness. Agent Bricks erkunden, um den Rest der Plattform kennenzulernen.
Weitere Ressourcen
- Erstellen Sie einen zustandsbehafteten Agent in unter 10 Minuten mit der Dokumentation zur Agent Bricks-CLI.
- Fügen Sie einem vorhandenen Agent Memory und Sitzungen hinzu mit der Dokumentation zu Agent-Memory und -Sitzungen.
- Lesen Sie die Forschungsergebnisse dahinter in MemCurrent: Designing Memory for Enterprise Agents.
(Dieser Blogbeitrag wurde mit KI-gestützten Tools übersetzt.) Originalbeitrag
Erhalten Sie die neuesten Beiträge in Ihrem Posteingang
Abonnieren Sie unseren Blog und erhalten Sie die neuesten Beiträge direkt in Ihren Posteingang.