Lakebase Postgres: Branch-basierte Wiederherstellungen für schnelle Wiederherstellung im großen Maßstab
Wie Lakebase Postgres langsame Datenbankwiederherstellungen durch nahezu sofortige, Branch-basierte Wiederherstellungen ersetzt, um 100 TB in Sekundenschnelle wiederherzustellen.
von Cassie Murray und Carlota Soto
- Die herkömmliche Datenbankwiederherstellung ist quälend langsam und skaliert schlecht mit der Größe. Sie führt oft zu stundenlangen Ausfallzeiten, während neue Compute-Ressourcen bereitgestellt, große Snapshots heruntergeladen und Logdateien neu eingespielt werden.
- Lakebase Postgres führt Branch-basierte Wiederherstellungen ein – eine Metadatenoperation, die eine Datenbank sofort wiederherstellt, indem sie auf eine unveränderliche Historie in entkoppeltem Speicher verweist, anstatt Daten zu kopieren.
- Die Wiederherstellung einer 100-TB-Datenbank dauert nur Sekunden. Dies macht die Wiederherstellung praktisch sofort verfügbar und ermöglicht es AI-Agenten, Branching- und Undo-Workflows nahtlos zu verarbeiten.
Bei verwalteten OLTP-Systemen waren Wiederherstellungen schon immer quälend langsam, und mit zunehmender Größe werden sie noch langsamer. Das bedeutet oft, dass große Produktionsdatenbanken, bei denen Ausfallzeiten am teuersten sind, am längsten auf eine Wiederherstellung warten müssen.
Die üblichen Behelfslösungen sind schwierig, teuer und risikoreich. Sie erfordern zusätzliche Replikate, zusätzliche Umgebungen und sogar einen DBA bei der Wiederherstellung, was jedoch keinen vollständigen Schutz garantiert. Ein Failover auf ein fehlerfreies Replikat hilft, wenn eine Maschine ausfällt, aber es hilft nicht, wenn der fehlerhafte Schreibvorgang bereits auf dem Standby-System vorhanden ist. Das bedeutet immer noch eine Wiederherstellung, und eine Wiederherstellung kann stundenlange Ausfallzeiten bedeuten.
Dieses Problem wird durch die Architektur traditioneller verwalteter OLTP-Systeme verursacht. Compute und Storage werden als eine einzige Maschine bereitgestellt. Eine Wiederherstellung beginnt mit der Bereitstellung einer neuen Instanz (und schon warten Sie); Snapshots befinden sich im Objektspeicher, während Postgres auf diesem Volume ausgeführt wird, sodass der Snapshot erst auf die Festplatte geladen werden muss (weiteres Warten); das WAL-Replay muss dann die Lücke zwischen dem Snapshot-Zeitpunkt und dem genauen Wiederherstellungszeitstempel schließen (noch mehr Warten). Mit wachsender Datenbank wird dies immer langsamer und teurer.
Die Lakebase-Postgres-Architektur bricht den Monolithen auf und verändert die Wiederherstellungsmechanik. Bei Lakebase sind Compute und Storage entkoppelt, und der Datenbankverlauf wird bereits so im Objektspeicher aufbewahrt, dass direkt darauf verwiesen werden kann. In dieser Architektur werden bei einer Wiederherstellung keine Daten auf eine neue Festplatte kopiert. Stattdessen wird einfach ein Branch zu einem bestimmten Zeitstempel erstellt – ein einfacher Metadatenvorgang statt eines mehrstündigen Kopier- und Replay-Prozesses.
In der Praxis schrumpft die Wiederherstellungszeit auf Sekunden, selbst wenn die Datenbank 100 TB groß ist. Und es ist so einfach, dass ein Agent es erledigen kann.
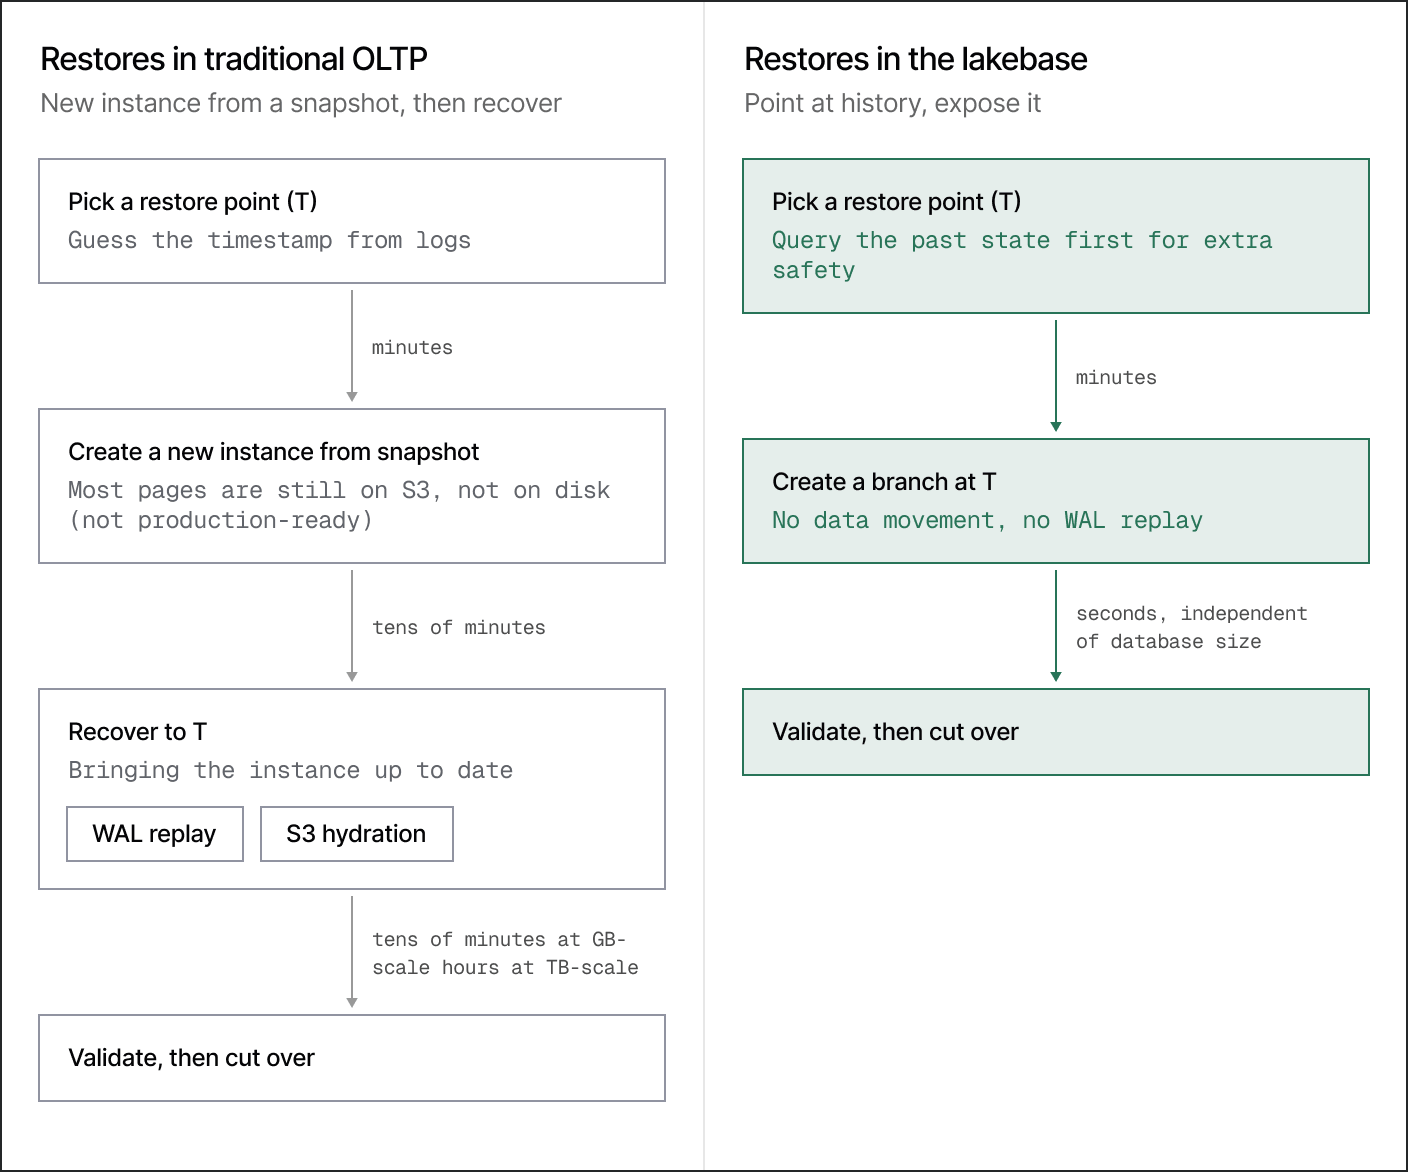
Der traditionelle OLTP-Wiederherstellungspfad (und wo er scheitert)
Die traditionelle Point-in-Time-Wiederherstellung (PITR) von Postgres basiert auf zwei Komponenten: einem Basis-Backup der Dateien und dem archivierten WAL für alles, was nach diesem Backup passiert ist. In einer verwalteten Postgres-Umgebung wie Amazon RDS ist dieses Backup in der Regel ein Snapshot, der im Objektspeicher liegt.
Die „Wiederherstellung aus dem Backup“ zu einem bestimmten Zeitpunkt T ist eigentlich ein Prozess, der aus drei Teilen besteht:
- Eine neue Instanz bereitstellen
- Den letzten nutzbaren Snapshot vor T wiederherstellen
- WAL von diesem Snapshot bis T einspielen
1. Eine neue Instanz bereitstellen
Dies erfordert die Bereitstellung von Compute- und Storage-Volumes (gekoppelt), die mindestens der primären Instanz entsprechen. Eine kleine Instanz kann in wenigen Minuten hochgefahren werden, aber eine große Instanz mit großen EBS-Volumes dauert in der Regel länger, sodass Sie warten müssen, bevor Sie überhaupt mit dem Wiederherstellungsprozess beginnen können.
2. Aus dem Snapshot wiederherstellen
RDS-Snapshots befinden sich in S3. „Wiederherstellen“ bedeutet also, diesen Snapshot aus dem Objektspeicher auf die Festplatte von Postgres zu übertragen.
Dieser Prozess ist bei großen Datenmengen langsam, weshalb RDS nicht auf den Abschluss wartet, bevor die wiederhergestellte Instanz als available bereitgestellt wird. Bei großen Volumes geschieht dies, während sich die meisten Tabellen- und Indexseiten noch in S3 befinden. Aber „verfügbar“ bedeutet nicht, dass sich der Working Set auf dem Postgres-Volume befindet. Wenn eine Abfrage einen Block betrifft, der noch nicht lokal vorhanden ist, ruft das Volume ihn sofort aus S3 ab, während der Rest im Hintergrund weiter geladen wird.
Diese Arten von Abfragen sind mit einer Latenz verbunden, die für eine interne Überprüfung in Ordnung ist, nicht aber für die Produktion. Die Wiederherstellung ist erst abgeschlossen, wenn sich die tatsächlich benötigten Daten auf dem Volume befinden, und das geht bei einer großen Datenbank nicht schnell. Je größer die Datenbank ist, desto mehr Zeit (in Stunden) wird dies in Anspruch nehmen.
3. WAL bis T einspielen
Der Snapshot ist nur zum Zeitpunkt des Snapshots konsistent. Um T zu erreichen, muss Postgres noch die nach diesem Snapshot archivierten Transaktionsprotokolle einspielen. Wie lange dieses Replay dauert, hängt davon ab, wie viel zwischen dem Snapshot und T passiert ist. Ein Snapshot von vor einer Stunde ist viel schneller eingespielt als ein Snapshot von letzter Nacht. Wenn Sie zudem einen schreibintensiven Tag hatten, müssen viele WAL-Daten eingespielt werden. Auch das bedeutet wieder eine lange Wartezeit (zusätzlich dazu, dass die Instanz immer noch Daten aus S3 nachlädt).
Erhebliche Ausfallzeitfenster
Sofern die Datenbank nicht klein ist, ist PITR fast immer ein mehrstündiger Vorgang. Sie müssen den Monolithen bereitstellen, einen Snapshot aus S3 abrufen, das WAL einspielen und warten, bis genügend Daten des Volumes lokal vorhanden sind, um Datenverkehr aufzunehmen.
Während dieses gesamten Zeitfensters kann es zu Ausfallzeiten kommen. Ein fehlerfreies, hochverfügbares (HA) Replikat kann Sie retten, wenn die primäre Instanz ausfällt und das Replikat noch über intakte Daten verfügt. Es schützt Sie jedoch möglicherweise nicht vor den Folgen, die eine PITR erfordern – gelöschte Tabellen und fehlerhafte Schreibvorgänge befinden sich möglicherweise bereits auf dem Standby-System.
Langsame Datenbank-Wiederherstellungen sind schmerzhaft
In einer Umfrage wurden 50 Entwickler, die produktive Postgres-Datenbanken mit mehr als 1 TB betreiben, nach ihren Erfahrungen mit Wiederherstellungen gefragt:
- 59 % hatten in den letzten 12 Monaten einen kritischen Produktionsausfall
- 30 % hatten Ausfallzeiten von mehr als 3 Stunden, bei einigen dauerte es länger als einen halben Tag
- nur 21 % konnten in weniger als 60 Minuten wiederhergestellt werden
Dies führte zu potenziell negativen geschäftlichen Auswirkungen:
- 40 % berichteten von erheblichen Geschäftsunterbrechungen
- 52 % erhielten negatives Kundenfeedback aufgrund des Vorfalls
- 72 % waren nur „einigermaßen zuversichtlich“, dass sie sich bei einem erneuten Ausfall schnell erholen könnten
Branch-basierte Wiederherstellungen eröffnen einen neuen Weg
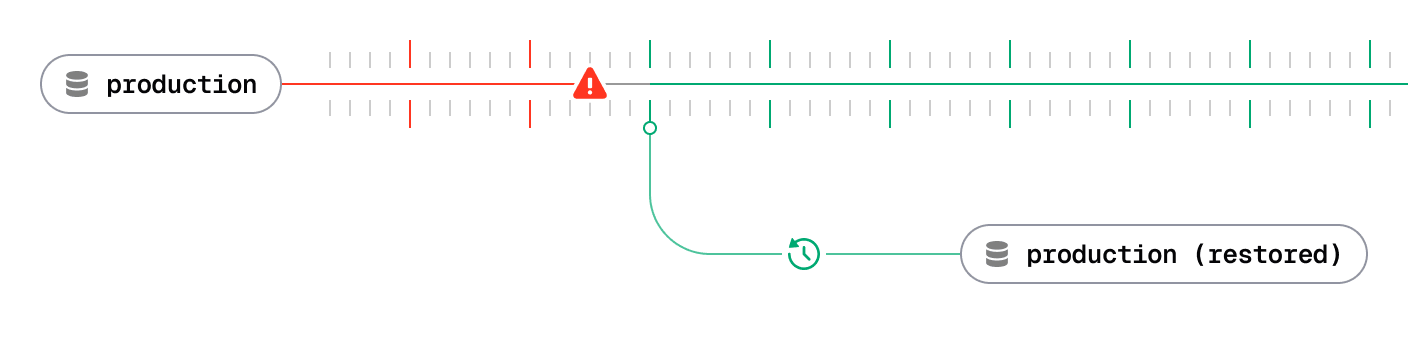
In Lakebase Postgres ermöglicht eine moderne Architektur einen anderen Weg für Wiederherstellungen.
Compute und Storage sind getrennt
Compute und dauerhafter Storage sind voneinander getrennt und über das WAL verbunden. Compute führt Postgres aus, was bedeutet, dass es SQL ausführt, Abfragen plant, MVCC anwendet, Sperren verwaltet und WAL generiert (alle regulären Postgres-Aufgaben). Was es jedoch nicht tut, ist, die dauerhafte Kopie Ihrer Daten zu besitzen.
Der Storage sorgt für Dauerhaftigkeit und Verlauf. Diese Aufgabe ist in drei Teile unterteilt, die von drei verschiedenen Komponenten ausgeführt werden:
- Safekeeper empfangen WAL von Compute. Eine Transaktion ist dauerhaft, sobald ein Quorum von Safekeepern ihren WAL-Datensatz bestätigt hat
- Der Pageserver wandelt WAL in die Seiten um, die Postgres liest. Er kann jede Seite für einen bestimmten Schlüssel bei einer bestimmten LSN rekonstruieren.
- Der Objektspeicher bewahrt den unveränderlichen, langfristigen Verlauf auf. Compute liest ihn nie direkt; der Pageserver liegt dazwischen.
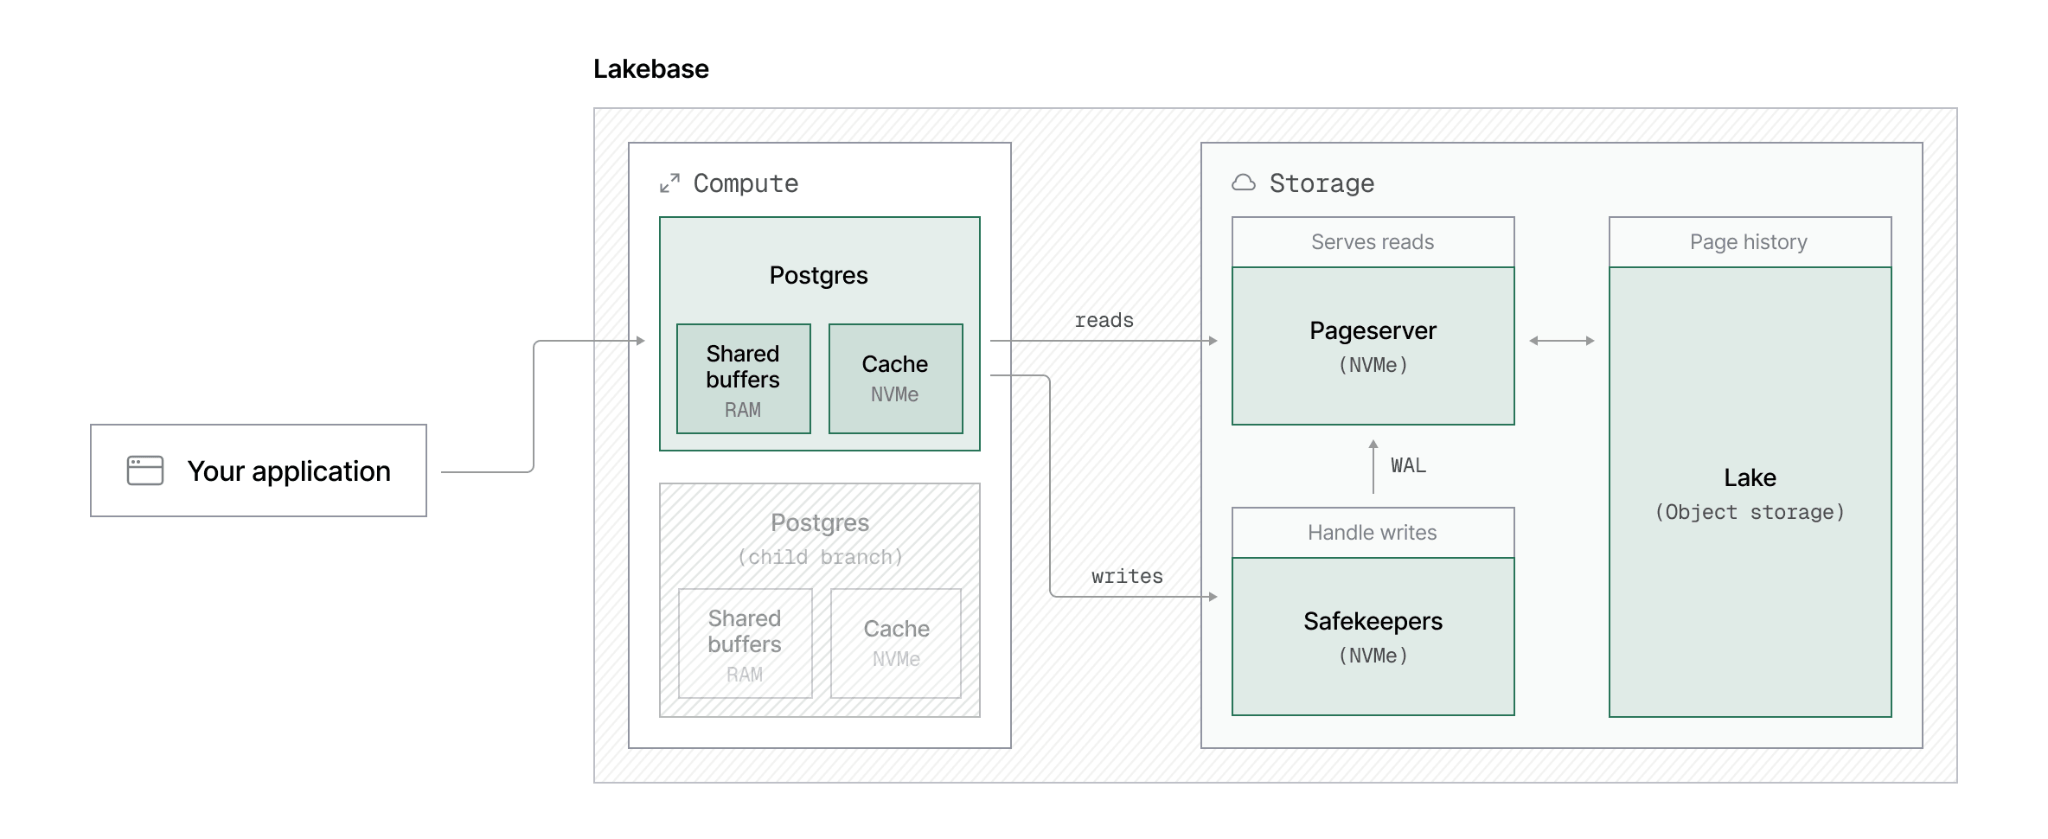
Wenn ein Schreibvorgang eingeht:
- Postgres ändert Zeilen im Speicher und generiert WAL
- Compute streamt dieses WAL an die Safekeeper
- Ein Quorum bestätigt dies, und die Transaktion ist nun dauerhaft
- Der Pageserver wandelt dieses WAL später in Seitenversionen um
- Diese Versionen landen als unveränderlicher Verlauf im Objektspeicher
Der Verlauf wird als adressierbare Timeline gespeichert
Bei diesem Design nimmt der Schreibpfad eine interessante Form an. Die obige Architektur trennt das Committen einer Transaktion von der Materialisierung von Seiten, was vereinfacht ausgedrückt bedeutet: Alte Seitenversionen werden nie überschrieben. Der Verlauf Ihrer Datenbank baut sich als Timeline auf, auf die Sie verweisen können, und nicht als eine einzige Kopie, die Sie verändern.
Eine Wiederherstellung in Lakebase ist ein Branch zu einem bestimmten Zeitpunkt
Auf dem traditionellen Weg bedeutet eine Wiederherstellung meist, diesen vergangenen Zustand in einer separaten Instanz neu aufzubauen. Bei Lakebase gibt es jedoch einen unveränderlichen Storage-Verlauf, auf den verwiesen werden kann, sodass dieser Schritt überflüssig ist und durch ein anderes Primitiv ersetzt wird: einen Branch.
Während traditionelle Wiederherstellungen eine neue Instanz bereitstellen und Daten dorthin kopieren, ist eine Wiederherstellung in Lakebase ein Branch zu einem bestimmten Zeitpunkt im Verlauf. Dieser neue Branch verfügt über ein eigenes, unabhängiges Compute, einen eigenen Connection-String und kann völlig unabhängig von der Produktion abgefragt werden. Es ist kein Replikat der ursprünglichen Instanz, fühlt sich aber genau so an.
So nutzen Sie dieses Primitiv für eine Wiederherstellung:
- Wenn im Haupt-Branch ein Fehler auftritt, wählen Sie einen Zeitstempel in der Vergangenheit (Sie können diesen Zeitstempel tatsächlich überprüfen, bevor Sie sich auf eine Wiederherstellung festlegen, z. B. durch Ausführen von Abfragen)
- Sobald Sie ihn validiert haben, ordnet die Control Plane diesen Zeitstempel dem genauen Punkt im Storage-Verlauf zu (der richtigen LSN), erstellt diesen Branch und bindet Compute an
- Die „wiederhergestellte Datenbank“ ist dieser neue Branch, der praktisch sofort nach dem Klicken auf „Deploy“ verfügbar ist – unabhängig davon, wie viele Daten in der zugrunde liegenden Datenbank gespeichert sind
Da dies das entscheidende Konzept ist, möchten wir es noch einmal betonen:
Der Branch kopiert die Datenbank nicht
Diese Wiederherstellungsmethode macht Datenkopien völlig überflüssig. Der wiederhergestellte Branch muss keine Daten kopieren; er zeigt einfach auf die Image- und Delta-Layer, die bis zu diesem Zeitpunkt bereits existieren.
- In einem Copy-and-Replay-System ist eine Wiederherstellung ein Datenverschiebungsprozess. Die Datenbank ist erst dann „da“, wenn das Kopieren und das WAL-Replay abgeschlossen sind
- In Lakebase ist die „Datenbank“ bereits vorhanden. Eine Wiederherstellung besteht aus Metadaten: ein Zeiger auf einen bestimmten Zeitpunkt in der Historie. Es muss nur noch dieser Zeitpunkt als Branch mit eigener Compute-Ressource bereitgestellt werden
Das Ergebnis: Die Wiederherstellung von 100 TB ist genauso schnell wie die von 10 GB
Der Vorteil ist, dass die Skalierung im Betrieb keinen Schrecken mehr verbreitet. Wenn eine Wiederherstellung lediglich Metadatenarbeit ist, hängt ihre Dauer nicht von der Größe Ihrer Daten ab, und der Mechanismus bleibt immer derselbe.
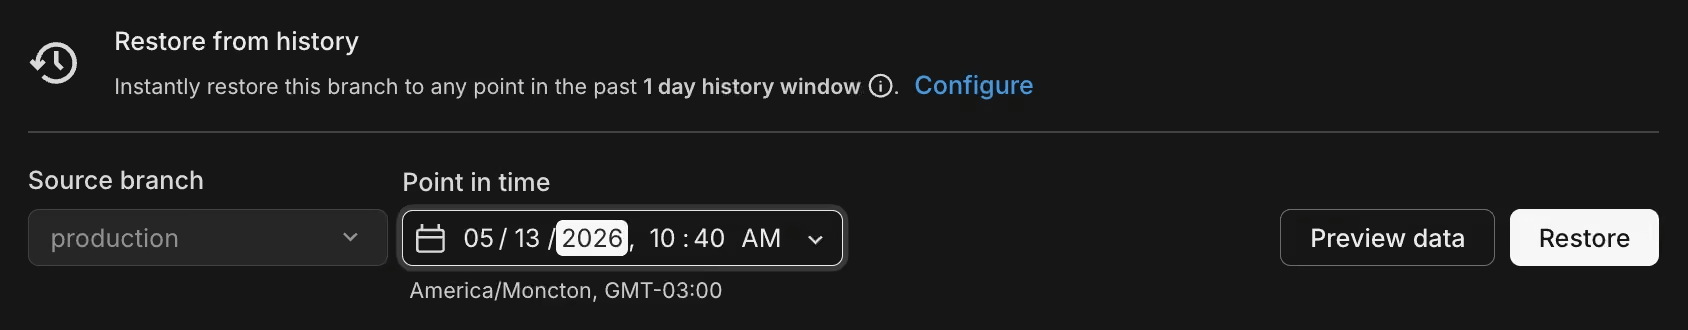
Unabhängig davon, wie groß Ihre Datenbank ist:
- Das Erreichen eines adressierbaren vergangenen Zustands erfolgt nahezu sofort
- Die Validierung dieses Zustands dauert nur so lange wie die Prüfungen und das Lesen der von Ihnen ausgewählten Daten
Ein Mensch oder ein Agent kann nach einem Vorfall immer sofort auf einen abfragbaren vergangenen Zustand zugreifen, selbst bei einer riesigen Postgres-Datenbank.
Agenten können auf Wiederherstellungen aufbauen
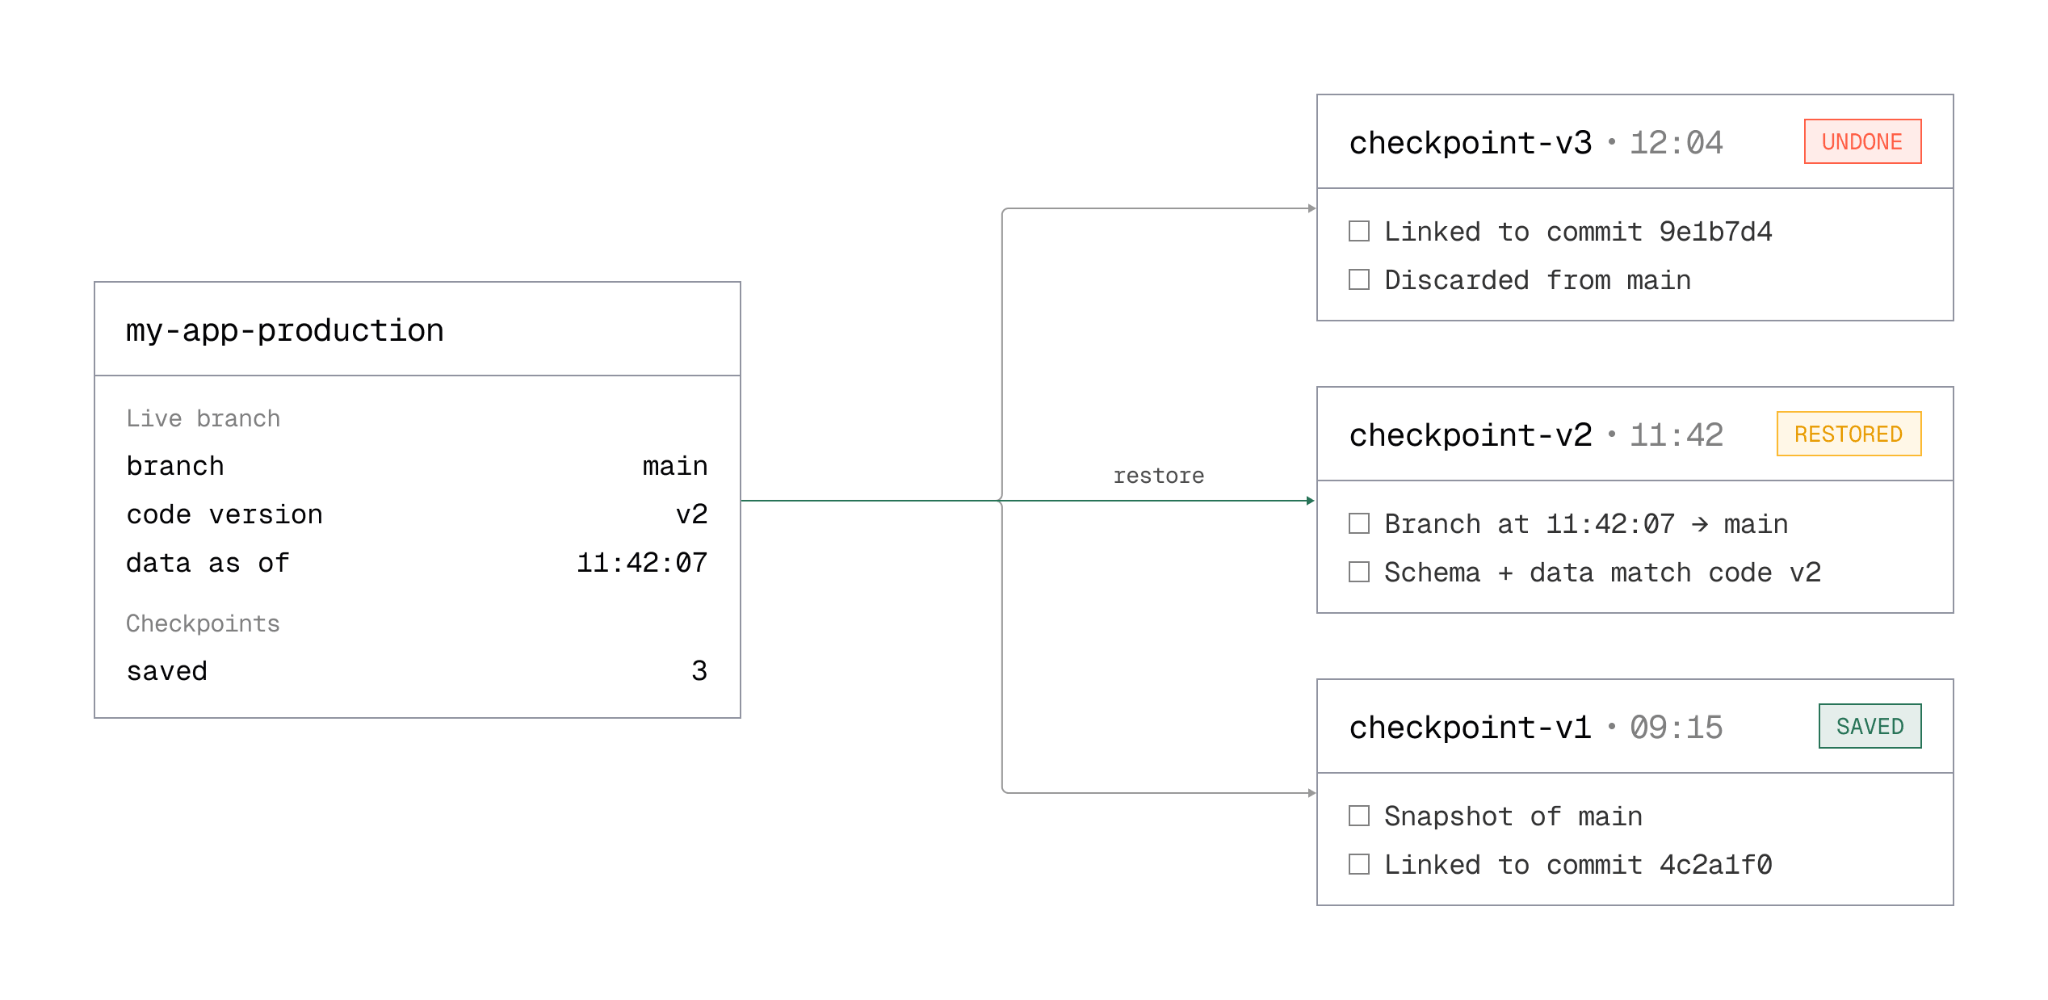
Wiederherstellungen in Lakebase sind ein einfacher Vorgang: Erstellen Sie einen Branch zu einem bestimmten Zeitstempel. Dieser Ablauf ist kurz genug, dass Agenten ihn als gewöhnlichen Tool-Aufruf behandeln können, nicht nur zur Behebung von Vorfällen.
Das ist genau der Teil, den Agenten-Plattformen wie Replit oder v0 nutzen, um Versionierungs- oder Undo-Funktionen zu entwickeln. Eine typische Schleife sieht so aus:
- Der Agent ändert die App, wodurch sich die Datenbank ändert
- Die Plattform speichert einen Checkpoint als Snapshot von main. Sie speichert die Checkpoint-ID neben der Codeversion
- Der Benutzer klickt auf „Rückgängig“ oder wählt eine ältere Version in der UI aus
- Die Plattform sucht nach diesem Checkpoint und stellt ihn auf dem Live-Branch wieder her
- Schema und Daten sind sofort wieder auf der Datenbankversion, die zum „alten Code“ passt
Klassisches PITR ist zu langsam und zu ressourcenintensiv, um Live-Workflows zu unterstützen, aber ein Branch zu einem bestimmten Zeitstempel ist schnell und kostengünstig genug, um Teil des Produkts zu sein.
Die Architektur von Lakebase verändert die Art und Weise der Wiederherstellung grundlegend
Herkömmliche Wiederherstellungen werden mit zunehmender Größe der Datenbank langsamer und ressourcenintensiver. Bei Branch-basierten Wiederherstellungen ist das nicht der Fall. Da die Historie bereits außerhalb von Compute-Ressourcen liegt, können Sie einen vergangenen Zeitpunkt einfach als Branch öffnen, anstatt ihn neu aufzubauen. Unabhängig davon, ob Sie 10 GB oder 100 TB haben, sehen Wiederherstellungen immer gleich aus: Wählen Sie einen Zeitstempel, erstellen Sie den Branch und weisen Sie Compute-Ressourcen zu. Ausfälle im großen Maßstab verlieren so ihren Schrecken.
Probieren Sie es selbst aus: Erstellen Sie eine Lakebase-Postgres-Datenbank, laden Sie eine ordentliche Menge an Daten, führen Sie eine Wiederherstellung durch und fragen Sie sich, wie Sie so lange ohne diese Funktion auskommen konnten.
(Dieser Blogbeitrag wurde mit KI-gestützten Tools übersetzt.) Originalbeitrag
Erhalten Sie die neuesten Beiträge in Ihrem Posteingang
Abonnieren Sie unseren Blog und erhalten Sie die neuesten Beiträge direkt in Ihren Posteingang.