Lakebase Search: State-of-the-Art-Volltext- und Vektorsuche für Postgres
Schnelle, skalierbare und serverlose Suche in Postgres, jetzt allgemein verfügbar
von Zhou Sun, Jinjing Zhou, Keming Yang, Usamoi Cui, Pranav Aurora und Junyu Chen
- Lakebase Postgres enthält jetzt eine integrierte Suchmaschine (GA auf AWS/Azure). Zwei Erweiterungen, lakebase_vector (ANN-Suche) und lakebase_text (BM25), ermöglichen es Ihnen, semantische, Keyword- und hybride Suchen direkt in Postgres parallel zu operativen Daten auszuführen, was ein separates Suchsystem + eine ETL-Pipeline überflüssig macht.
- Es übertrifft pgvector und dedizierte Suchmaschinen im großen Maßstab. In einem Benchmark mit 100 Mio. Vektoren bietet Lakebase den doppelten Durchsatz des nächstbesten Systems, viermal niedrigere Kosten als Cloud-Postgres mit pgvector und 97 % Recall bei einer P99-Latenz von 71 ms. Dies wird durch die Entkopplung von Speicher und Rechenleistung (Compute) sowie die Verwendung von hierarchischem IVF-Clustering + binärer Quantisierung (RaBitQ) erreicht, sodass Abfragen nur auf die benötigten Daten zugreifen.
- Die Architektur ist serverlos und skaliert bis auf Null. Sie zahlen für die Abfragenutzung, nicht für das Datenvolumen. Die Indexerstellung wird von der primären Datenbank ausgelagert, Kaltstarts dauern ca. 1 Sekunde und 100 Mio. Vektoren können auf einer einzigen Recheneinheit bereitgestellt werden, was sie ideal für die stoßartigen Abrufmuster von AI-Agenten macht.
Herkömmliche OLTP-Systeme wurden nicht für die Suchanforderungen von KI-Agenten entwickelt. Sie erfordern eine Suche mit geringer Latenz und hoher Genauigkeit über all Ihre Daten hinweg und führen oft massive parallele Suchen aus. Bisher bedeutete die Lösung dieses Problems, eine eigenständige Suchmaschine über eine ETL-Pipeline provisorisch an die primäre Datenbank anzubinden.
Aber was wäre, wenn Ihre OLTP-Datenbank die Such-Workloads einfach effizient ausführen könnte?
Heute bringen wir eine schnelle und skalierbare Suchmaschine über zwei Erweiterungen zu Lakebase Postgres: lakebase_vector (skalierbare Suche nach ungefähren nächsten Nachbarn) und lakebase_text (BM25-Volltextsuche). Beide Erweiterungen sind auf AWS und Azure allgemein verfügbar.
Mit lakebase_vector ist Postgres jetzt an der Spitze der Vektorsuche. Sie übertrifft die Effizienz und Skalierbarkeit einer dedizierten Suchmaschine. Beim VectorDBBench 100M-Benchmark liefert sie den doppelten Durchsatz des nächstbesten Systems und ist viermal günstiger als ein Cloud-Postgres-Anbieter, der pgvector verwendet – und das noch vor Berücksichtigung zusätzlicher Einsparungen durch automatische Skalierung.
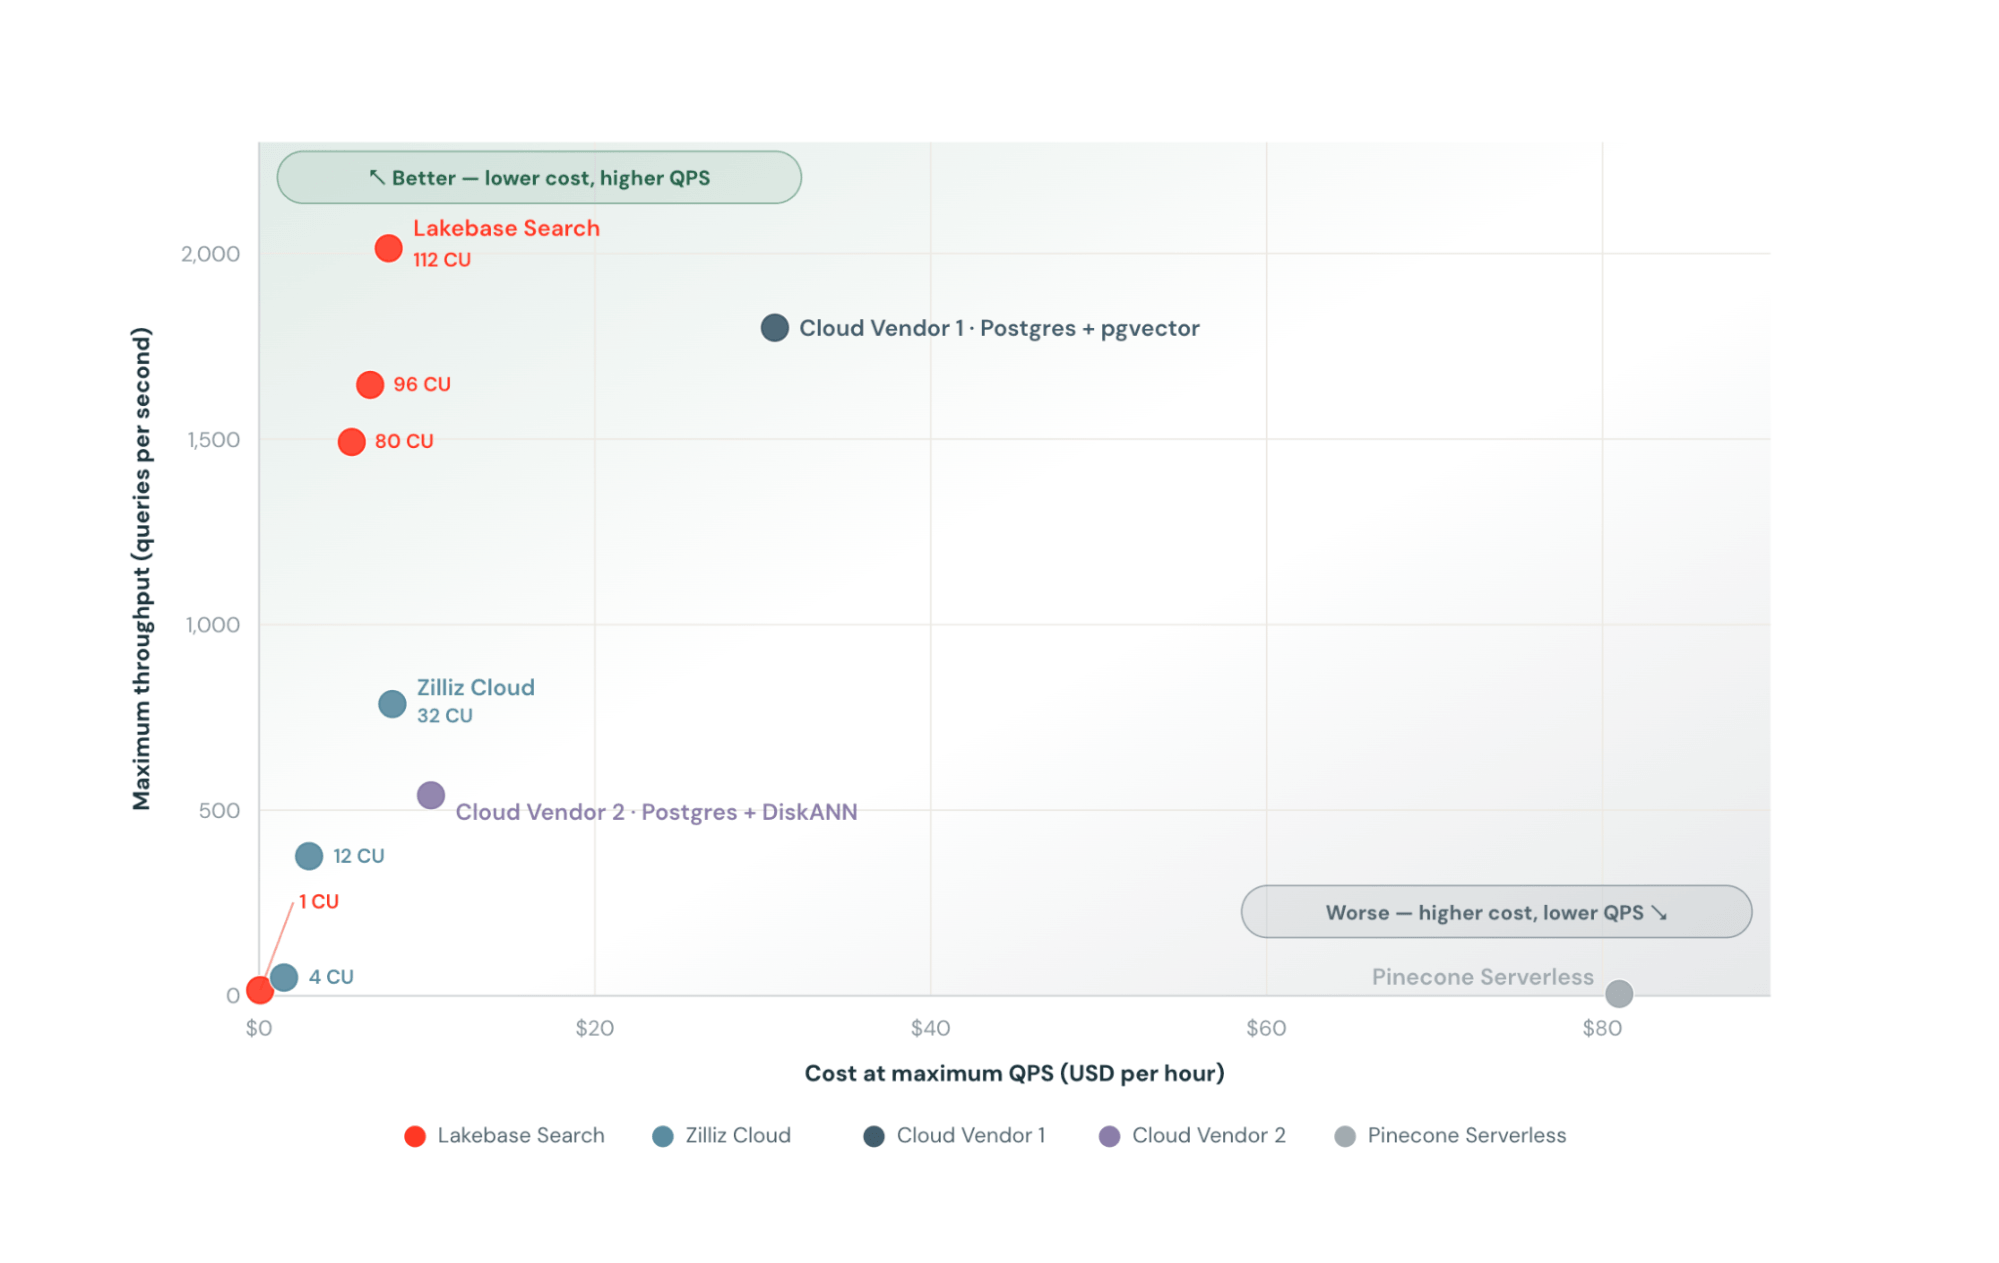
Sie behält diese Leistung bei, ohne Kompromisse bei der Genauigkeit einzugehen. In unseren Tests lieferte lakebase_vector eine P99-Latenz von 71 Millisekunden bei 97 % Recall (die tatsächlichen nächsten Nachbarn wurden in 97 % der Fälle erfolgreich abgerufen).

Lakebase Postgres verfügt nun über modernste Suchfunktionen, und wir haben gesehen, dass Kunden wie Conexiom eine Hybridsuche mit BM25 auf über 100 Millionen Zeilen mit der Hälfte des Rechenaufwands ihres vorherigen pgvector-Setups ausführen. Sie haben nun eine Datenbank für alle OLTP- und Such-Workloads, die vollständig serverlos ist und sich an ihre Anforderungen anpasst.
Lakebase Search bietet uns ein völlig neues Maß an Skalierbarkeit gegenüber pgvector und ermöglicht BM25 in derselben serverlosen Datenbank. Wir nutzen Lakebase, um Daten in großem Umfang mit unseren Agenten zu verbinden. —Jordan Voves, KI/ML-Architekt @ Conexiom
Warum pgvector bei großer Skalierung an seine Grenzen stößt
Für die meisten Postgres-Benutzer beginnt die Suche mit pgvector. Es ermöglicht die Vektorähnlichkeitssuche über Indexalgorithmen wie HNSW und IVFFlat direkt in Postgres, wodurch die Komplexität eines separaten Vektorspeichers vermieden wird. Tatsächlich ist pgvector die am häufigsten installierte Erweiterung in Lakebase Postgres. Wir haben drei häufige Schwachstellen bei Kunden festgestellt, die pgvector in großem Umfang ausführen.
Erstens skalieren die Kosten mit dem Datenvolumen, nicht mit der Nutzung.
pgvector hält seinen Index im Arbeitsspeicher Ihrer Datenbank, um schnell zu sein. Da die HNSW-Suche auf dem Durchlaufen von Graphen per Direktzugriff (Random Access) basiert, Abfragen nur dann in Millisekunden ausgeführt werden, wenn alles perfekt in den RAM passt. Sobald der Index auf die Festplatte ausgelagert wird, werden Abfragen zu einer Kette von zufälligen Lesevorgängen, und die Leistung bricht um das 10- bis 50-Fache ein.
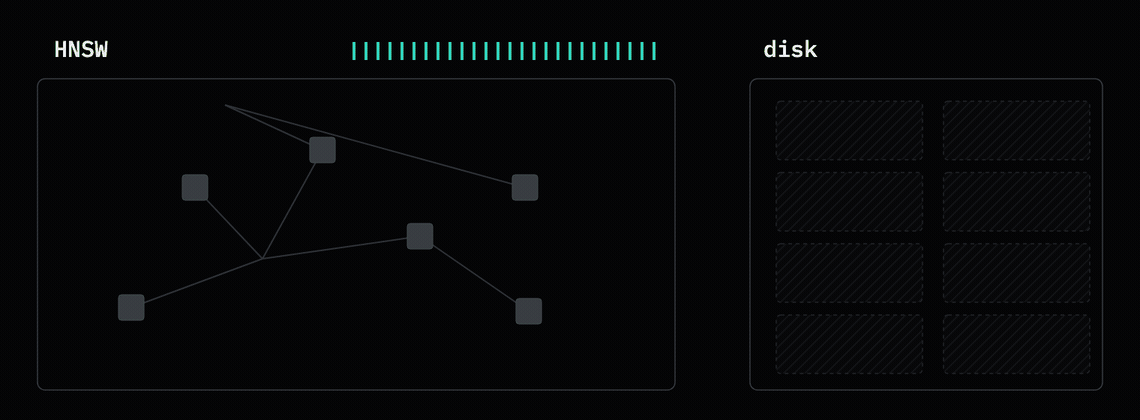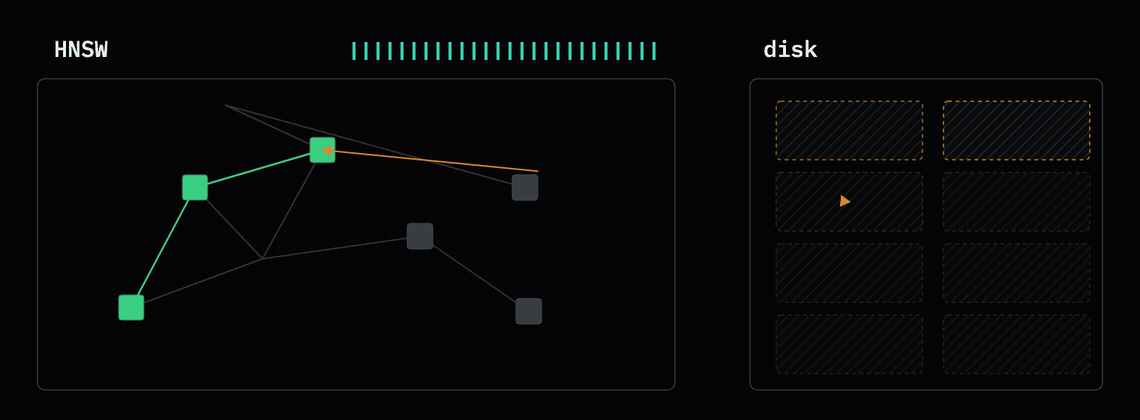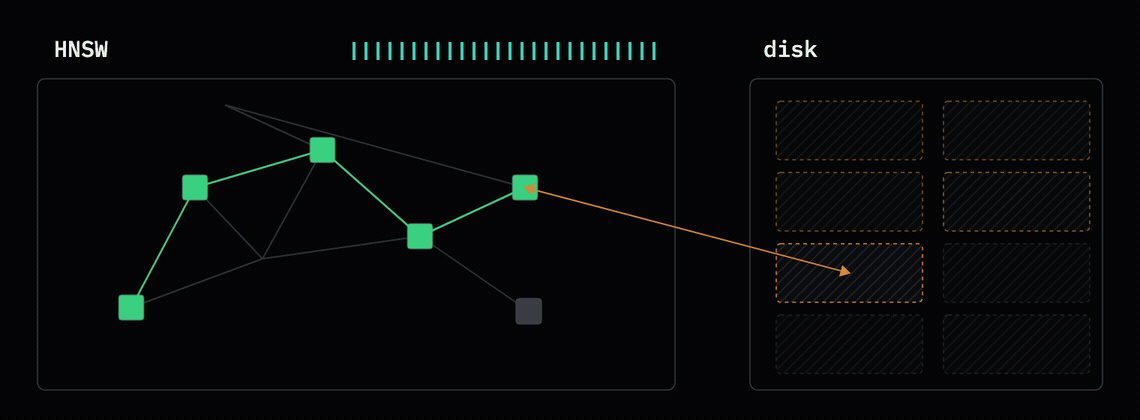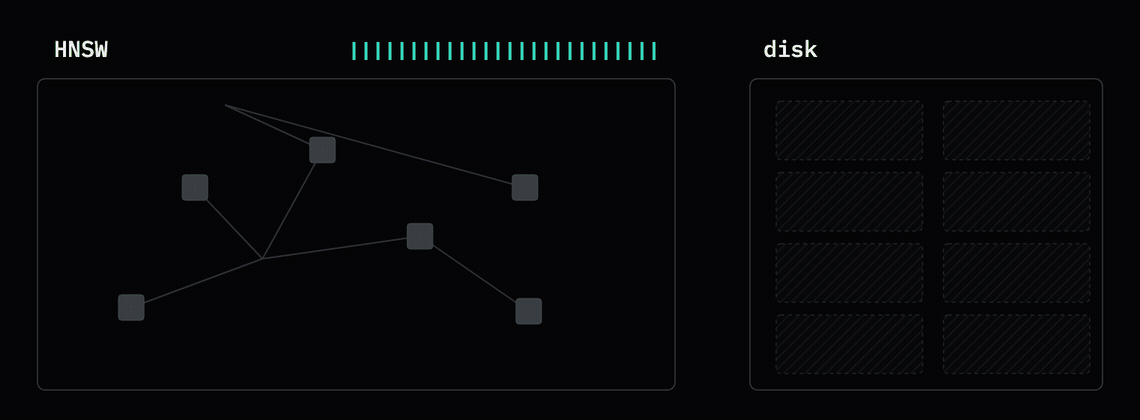
Ein 768-dimensionaler float32-Vektor benötigt unter Berücksichtigung von Graph-Verknüpfungen und Postgres-Overhead etwa 3,3 KB Speicher. Bei 100 Millionen Zeilen benötigen Sie ca. 330 GB RAM, um den Index für Millisekunden-Abfragen im Speicher zu halten. Es gibt kein Konzept eines „Working Set“. Sie stellen Ressourcen für den gesamten Index bereit, unabhängig davon, ob Sie alles oder nichts davon abfragen.
Zweitens ist die Indexpflege teuer und blockiert Ihre Datenbank.
pgvector-Indizes sind durch den Speicher begrenzt, da der HNSW-Graph auf kontinuierlichen Direktzugriff angewiesen ist. Wenn eine Erstellung auf die Festplatte ausgelagert wird, bremsen Millionen von zufälligen I/O-Operationen die Leistung aus – es dauert fast 50 Stunden, um einen pgvector-Index auf einer Standard-Cloud-Instanz zu erstellen.
Das Laden von Daten (Ingestion) leidet unter demselben Engpass. Das Einfügen neuer Vektoren ist langsam und kostspielig, da jeder Schreibvorgang pgvector dazu zwingt, mehrere Ebenen des Graphen mithilfe von Direktzugriffs-Lookups zu durchlaufen und zu ändern.
Zweitens wird das Laden von Daten langsam und kostspielig, da HNSW auf kontinuierlicher Navigation im Graphen per Direktzugriff beruht. Zudem muss jede Ebene des Graphen geändert werden. Daher der HNSW-Index
Die laufende Wartung verschärft das Problem. Da HNSW kein globales Rebalancing bietet, erfordert die Wiederherstellung der Suchqualität ein vollständiges REINDEX, was die Tabelle sperrt und Produktionsschreibvorgänge blockiert.
Drittens gehen Sie Kompromisse bei der Suchqualität ein, um die Leistung zu steigern
Jede pgvector-Abfrage läuft auf einem einzigen Postgres-Backend-Prozess, was bedeutet, dass der HNSW-Index-Scan niemals parallelisiert wird.
Um einen höheren Recall zu erzielen, muss die Engine mehr Graphknoten besuchen, was mehr zufällige Speicherlesevorgänge und Abstandsvergleiche auslöst. Dies erhöht die Latenz und senkt Ihre QPS. Da eine einzelne Suche nicht über mehrere Kerne parallelisiert werden kann, besteht Ihre einzige Option für einen höheren Durchsatz darin, mehr Verbindungen oder Read-Replicas hinzuzufügen.
lakebase_vector bringt skalierbare Vektorsuche zu Postgres
Der Hauptengpass bei pgvector besteht darin, dass der gesamte Index in den RAM einer einzigen Maschine passen muss, um schnell zu sein. Was wäre, wenn das nicht nötig wäre?
Lakebase Postgres bietet uns einen hervorragenden Ausgangspunkt, da es Speicher und Rechenleistung (Compute) voneinander trennt. Beständige Daten liegen in kostengünstigem Cloud-Objektspeicher, während RAM und lokaler NVMe als flüchtige Caches davor geschaltet sind, um ein schnelles Lesen des aktiven Datensatzes (Working Set) zu ermöglichen. Bei dieser Architektur bedeutet ein HNSW-Cache eine Reihe von zufälligen Objektspeicher-Lesevorgängen.
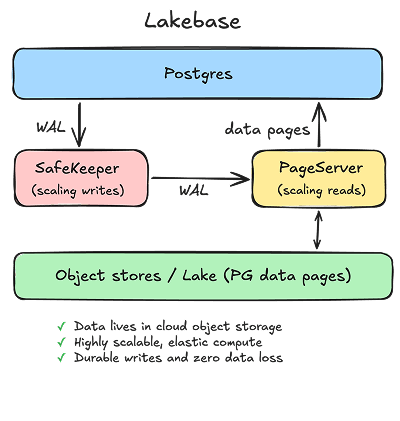
Wir benötigen einen Index, der sowohl im RAM-Cache als auch im kalten Zustand auf dem Objektspeicher schnell ist. Wir nutzen zwei Ansätze:
- Hierarchisches IVF-Clustering. Vektoren werden in Clustern gruppiert, die als zusammenhängende Blöcke gespeichert werden. Eine Abfrage bewertet die Cluster-Schwerpunkte (Centroids) im Speicher und liest dann nur die wenigen vielversprechenden Blöcke – was Hunderte von zufälligen Sprüngen in eine Handvoll großer sequenzieller Lesevorgänge verwandelt.
- Binäre Quantisierung (RaBitQ). Jeder Vektor wird auf ca. 1 Bit pro Dimension komprimiert, was etwa 32-mal kleiner ist als float32. Abfragen scannen die kompakten Codes, um eine engere Auswahl an Kandidaten zu treffen, und bewerten diese begrenzte Auswahl dann anhand der Vektoren mit voller Präzision neu (Reranking).
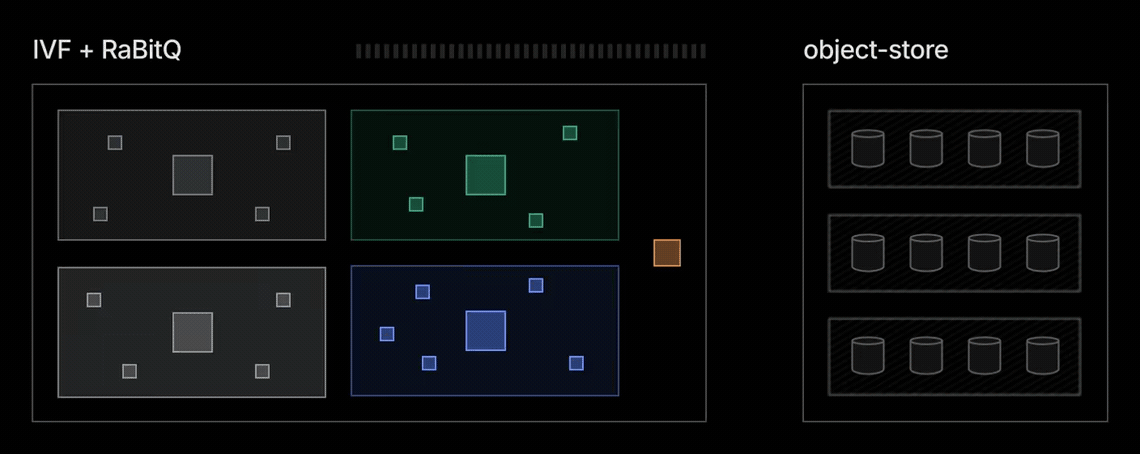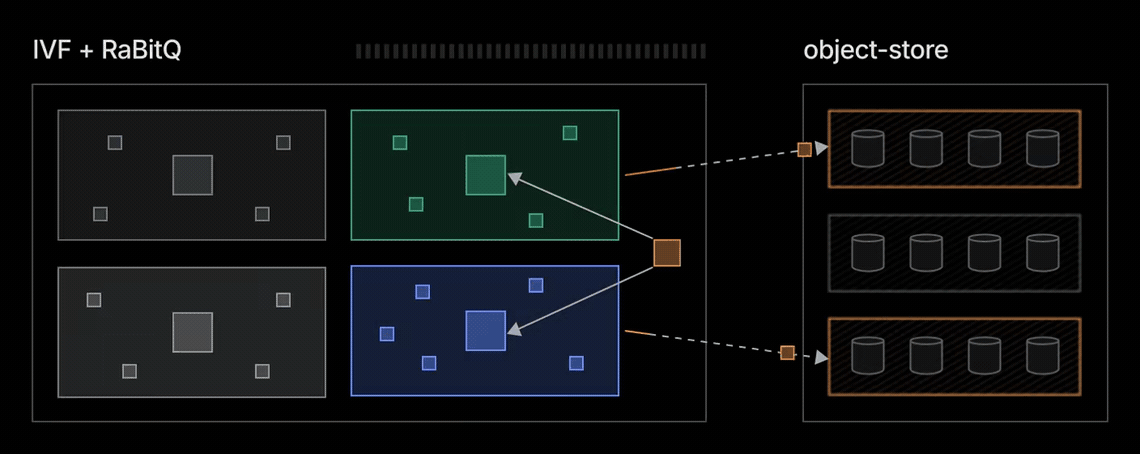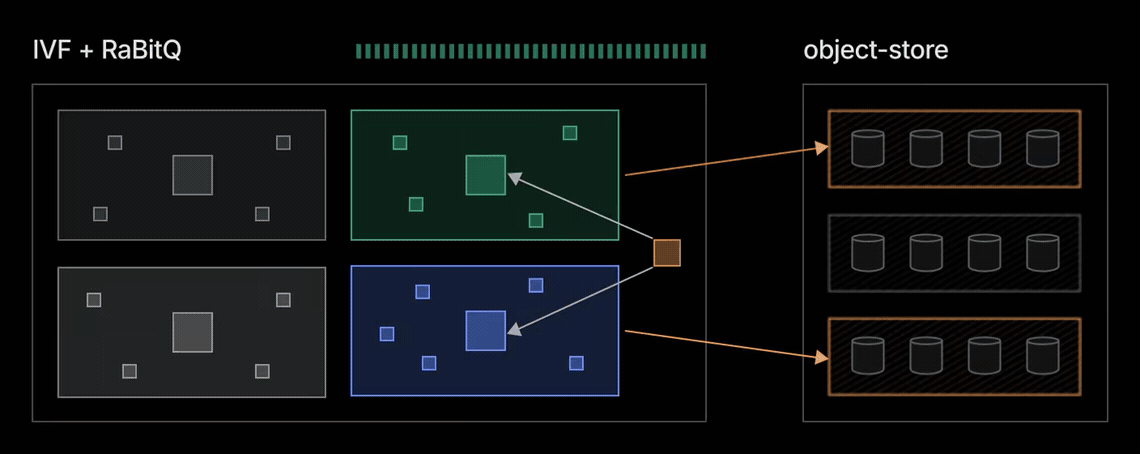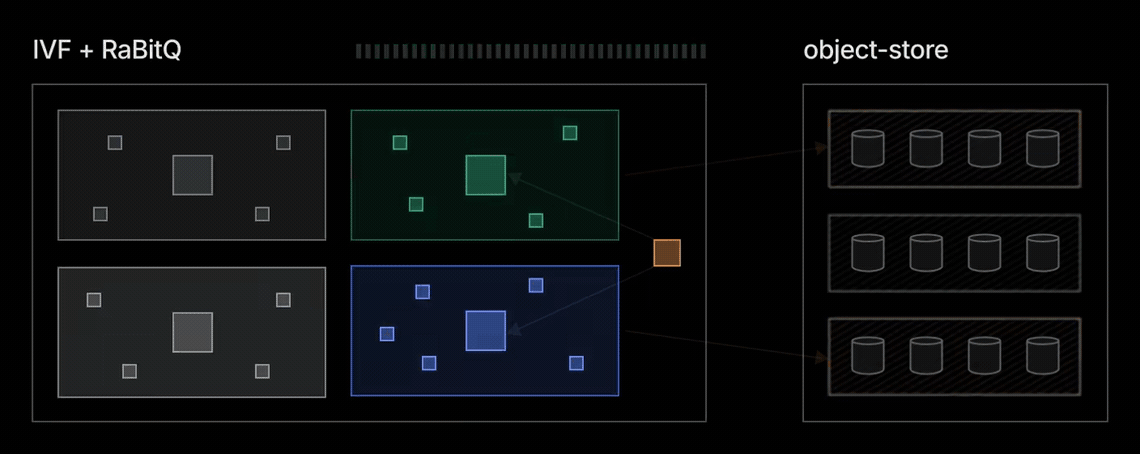
Im Cache-Zustand arbeitet die Suche mit einem winzigen Speicherbedarf unter Verwendung quantisierter Vektoren. Im kalten Zustand rufen Abfragen nur die benötigten Blöcke ab und müssen nicht den gesamten Index durchsuchen. lakebase_vector bietet:
Zahlen Sie nur für das, was Sie tatsächlich nutzen, und skalieren Sie auf Null
Die Entkopplung von Speicher und Rechenleistung macht lakebase_vector vollständig zustandslos: Ein Knoten cacht heiße Daten bei Bedarf, fährt bei Inaktivität auf Null herunter und nimmt den Betrieb bei der nächsten Abfrage wieder auf.
- Im Ruhezustand zahlen Sie nur für den Speicher, was Ihnen niedrige Basiskosten für die Indexierung von Vektoren in Lakebase sichert.
- Kaltstarts sind kostengünstig, da nur die quantisierten Codes und die spezifischen Blöcke, die von einer Abfrage berührt werden, geladen werden. Unser gemessener P90-Wert für die erste Abfrage nach dem Herunterskalieren auf Null liegt bei nur 1,13 Sekunden (100 Mio. × 768 Dimensionen).
- Es ist sogar möglich, 100 Mio. Vektoren auf nur 1 Lakebase Compute Unit (CU) bereitzustellen. Nur der aktive Arbeitsdatensatz muss in den Compute-Knoten zwischengespeichert werden, was Ihnen ein Preismodell bietet, das die tatsächliche Nutzung und Abfrageaktivität widerspiegelt.

Schnelle, ausgelagerte Indexerstellungen
lakebase_vector erstellt Indizes auf eine stärker parallelisierte Weise. Wir trainieren die Zentroide einmal auf einer kleinen Zufallsstichprobe. Dies ist der einzige Schritt, der den gesamten Datensatz betrachtet. Danach wird jeder Vektor unabhängig seinem nächsten Zentroiden zugewiesen, quantisiert und in den Block seines Clusters geschrieben. Dieser Prozess kann über so viele Kerne verteilt werden, wie Ihnen zur Verfügung stehen, und skaliert mit der Rechenleistung.

Wir gehen noch einen Schritt weiter, indem wir die Indexerstellung vollständig aus Ihrer primären Datenbank auslagern. Die Speicherung von Daten in offenen Formaten ermöglicht es unserer LTAP-Architektur, die Indexierung und Wartung an verteilte Engines wie Spark zu delegieren, wodurch die Erstellungszeiten dank paralleler Rechenleistung auf wenige Minuten verkürzt werden. Bleiben Sie dran.
Schnelle, präzise Suche
lakebase_vector erweitert die Kandidatensuche kostengünstig mithilfe kompakter 1-Bit-Codes und führt ein Reranking nur für eine engere Auswahl mit voller Präzision durch. Da die Indexblöcke unabhängig voneinander sind, lässt sich eine einzelne Abfrage über CPU-Kerne parallelisieren, was gleichzeitig einen hohen Recall und eine geringe Latenz liefert.
Die Filterung erfolgt direkt beim Scannen der Clusterblöcke durch lakebase_vector. Das direkte Anwenden von Prädikaten verhindert ein übermäßiges Abrufen von Kandidaten und hält den Recall bei gefilterten Abfragen hoch.
lakebase_text: native BM25-Suche in Postgres
Der Standard-Postgres-Textsuche (tsvector) fehlt der korpusweite Relevanzkontext. lakebase_text bringt natives BM25 zu Postgres, indem Begriffe mit der globalen inversen Dokumenthäufigkeit (IDF) bewertet werden: Seltene Begriffe mit hoher Intention werden stark gewichtet, während häufige Füllwörter abgewertet werden.
Es ist zudem schneller als herkömmliche tsvector- und GIN-Indizes. Durch die Auswertung von Score-Obergrenzen während des Traversierens überspringt die Engine ganze Posting-Blöcke, die die Top-K-Ergebnisse nicht erreichen können.
Die Kombination von lakebase_text mit lakebase_vector ermöglicht eine native hybride Suche direkt in Postgres. In einer einzigen Abfrage können Sie die semantische Vektorsuche mit der BM25-Schlüsselwortrelevanz verknüpfen, Standard-SQL-Filterprädikate anwenden und direkt mit aktiven operativen Tabellen verknüpfen.
Lakebase Postgres ist für die Ära der Agenten gebaut
Agenten haben traditionelle Suchmaschinen an ihre Grenzen gebracht. Sie haben die Vektorsuche zu einer Kernanforderung des Data Stacks gemacht und für extreme Lastspitzen gesorgt, bei denen ein einzelner Workflow in Sekundenschnelle Tausende von gleichzeitigen Abrufanfragen auslösen kann.
Wir haben Lakebase Search speziell für diese neue Realität entwickelt. Lakebase Postgres kann jetzt all Ihre operativen und Such-Workloads bewältigen, unterstützt durch eine serverlose Architektur, die nahtlos von einer Zeile bis zu einer Milliarde Vektoren und von einer QPS bis zu Tausenden skaliert – ganz ohne manuelle Bereitstellung oder Infrastrukturverwaltung.
Wir haben Lakebase Search auf Basis des Feedbacks von Hunderten von Beta-Kunden entwickelt, und die Ergebnisse sprechen für sich:
- Dreimal geringere Datenbankausgaben: Conexiom senkte die Infrastrukturkosten um das Dreifache und erzielte gleichzeitig einen fünfmal höheren Durchsatz im Vergleich zu pgvector.
- Ein einziger SQL-Tool-Aufruf für Agenten: Entwickler ersetzen komplexe Multi-System-Abruf-Pipelines durch einen einzigen SQL-Aufruf für die native hybride Suche, gesteuert durch Standard-Datenbankregeln.
- Einheitliches OLTP und Suche: Teams konsolidieren aktive operative Tabellen und dedizierte Suchcluster in einem einzigen nutzungsbasierten Backend.
Lakebase Search ist ab heute allgemein auf AWS und Azure verfügbar. Wenn Sie bereits eine App oder einen Agenten auf Lakebase entwickeln, aktivieren Sie einfach die Erweiterungen. Wenn Sie Lakebase noch nicht ausprobiert haben, legen Sie heute los.
▎ 📝 Hinweis: Databricks AI Search ist eine verwaltete Suchmaschine für sofort einsatzbereite, qualitativ hochwertige Abrufe – sie ist möglicherweise die bessere Wahl, wenn Sie hervorragende Ergebnisse ohne manuelles Tuning erzielen möchten. Lakebase Search ist die bessere Wahl, wenn Sie all Ihre operativen und Suchdaten in einer einzigen Datenbank konsolidieren möchten.
(Dieser Blogbeitrag wurde mit KI-gestützten Tools übersetzt.) Originalbeitrag
Erhalten Sie die neuesten Beiträge in Ihrem Posteingang
Abonnieren Sie unseren Blog und erhalten Sie die neuesten Beiträge direkt in Ihren Posteingang.