Fertigungsdaten und KI: Die Produktwertschöpfungskette vernetzen
Ermöglichen Sie jeder Phase der Fertigungswertschöpfungskette den Zugriff auf vertrauenswürdige Daten und KI
von Dr. Philip Laserstein und Dr. Max Köhler
- Fertigungsdaten erstrecken sich über eine vernetzte Produktwertschöpfungskette, aber die Systeme zu ihrer Erfassung bleiben nach Funktion und Werk getrennt
- Databricks führt Daten aus unterschiedlichen Systemen zusammen – oder fragt sie direkt an der Quelle ab –, sodass Teams phasenübergreifende Fragen entlang der Wertschöpfungskette beantworten können
- Gesteuerte Semantik, Analysen in natürlicher Sprache und agentenbasierte Anwendungen helfen mehr Menschen, vom Suchen von Daten zum Handeln überzugehen, ohne Data Engineers sein zu müssen
Ein Fertigungsfehler lässt sich selten auf ein einziges System zurückführen. Ein sprunghafter Anstieg des Ausschusses kann mit einer Maschineneinstellung, einer Lieferantencharge, einem Logistikereignis oder einem wiederkehrenden Problem zusammenhängen, das in einem Qualitätssystem erfasst wurde. Dennoch sind die für die Untersuchung erforderlichen Daten meist über Werks-, Funktions- und Systemgrenzen hinweg aufgeteilt.
Vor mehr als 50 Jahren erkannte Dr. Joseph Harrington in seiner Vision des Computer Integrated Manufacturing (CIM), dass die Fertigung von einem vernetzten Informationsfluss über alle Funktionen hinweg abhängt. Heute wird diese Vision Realität, da Daten und KI die einzelnen Phasen der Produktwertschöpfungskette miteinander verbinden.
Die schwierigsten Fragen in der Fertigung sind phasenübergreifende Fragen:
- Welche Lieferantencharge hat die betroffenen Produkte erreicht?
- Ist dieser Fehler schon einmal aufgetreten? Hat die Korrekturmaßnahme gewirkt?
- Welche Kunden oder Servicefälle könnten betroffen sein?
Die Beantwortung dieser Fragen erfordert die Zusammenführung von Daten aus Systemen, die nie für die Kommunikation untereinander ausgelegt waren. Hersteller benötigen keine weiteren isolierten Berichte. Sie brauchen einen vernetzten Informationsfluss über die gesamte Produktwertschöpfungskette hinweg, kombiniert mit der Governance und dem geschäftlichen Kontext, um diese Informationen nutzbar zu machen. Dies ist die Rolle, die eine moderne Daten- und KI-Plattform spielen kann.
Was ist die Produktwertschöpfungskette in der Fertigung?
Die Produktwertschöpfungskette ist die durchgängige Abfolge von Funktionen, die Rohstoffe und Ideen in Produkte verwandelt, die an Kunden ausgeliefert und im Betrieb unterstützt werden. Sie verbindet Forschung und Entwicklung (R&D) und Konstruktion, Einkauf, Produktion und Qualität, Vertrieb und Marketing sowie Aftermarket und Kundendienst. Jede Phase hat ihre eigenen Ziele, Teams und operativen Systeme:
- Forschung und Entwicklung (R&D) und Konstruktion arbeiten mit Product Lifecycle Management (PLM), Computer-Aided Design (CAD), Computer-Aided Engineering (CAE) und Simulation, Testdaten, Anforderungen und technischen Stücklisten (BOMs).
- Der Einkauf arbeitet mit Enterprise Resource Planning (ERP)-Einkauf, Source-to-Pay, Verträgen, Lieferantenrisiken und Lieferantenportalen.
- Produktion und Qualität arbeiten mit Manufacturing Execution Systems (MES), Supervisory Control and Data Acquisition (SCADA)-/Programmable Logic Controller (PLC)-Daten, Prozessdatenarchiven, Quality Management Systems (QMS)/Laboratory Information Management Systems (LIMS) und Instandhaltungssystemen.
- Logistik und Lieferkette arbeiten mit Enterprise Resource Planning (ERP), Warehouse Management Systems (WMS), Transportation Management Systems (TMS), Planungssystemen, Electronic Data Interchange (EDI) und Telematik.
- Vertrieb und Marketing arbeiten mit Customer Relationship Management (CRM), Configure-Price-Quote (CPQ), Preisgestaltung, Händlermanagement, Marketingautomatisierung und E-Commerce.
- Aftermarket und Kundendienst arbeiten mit Servicemanagement, Garantie, Ersatzteilplanung, Daten vernetzter Produkte, Diagnose und Tickets.
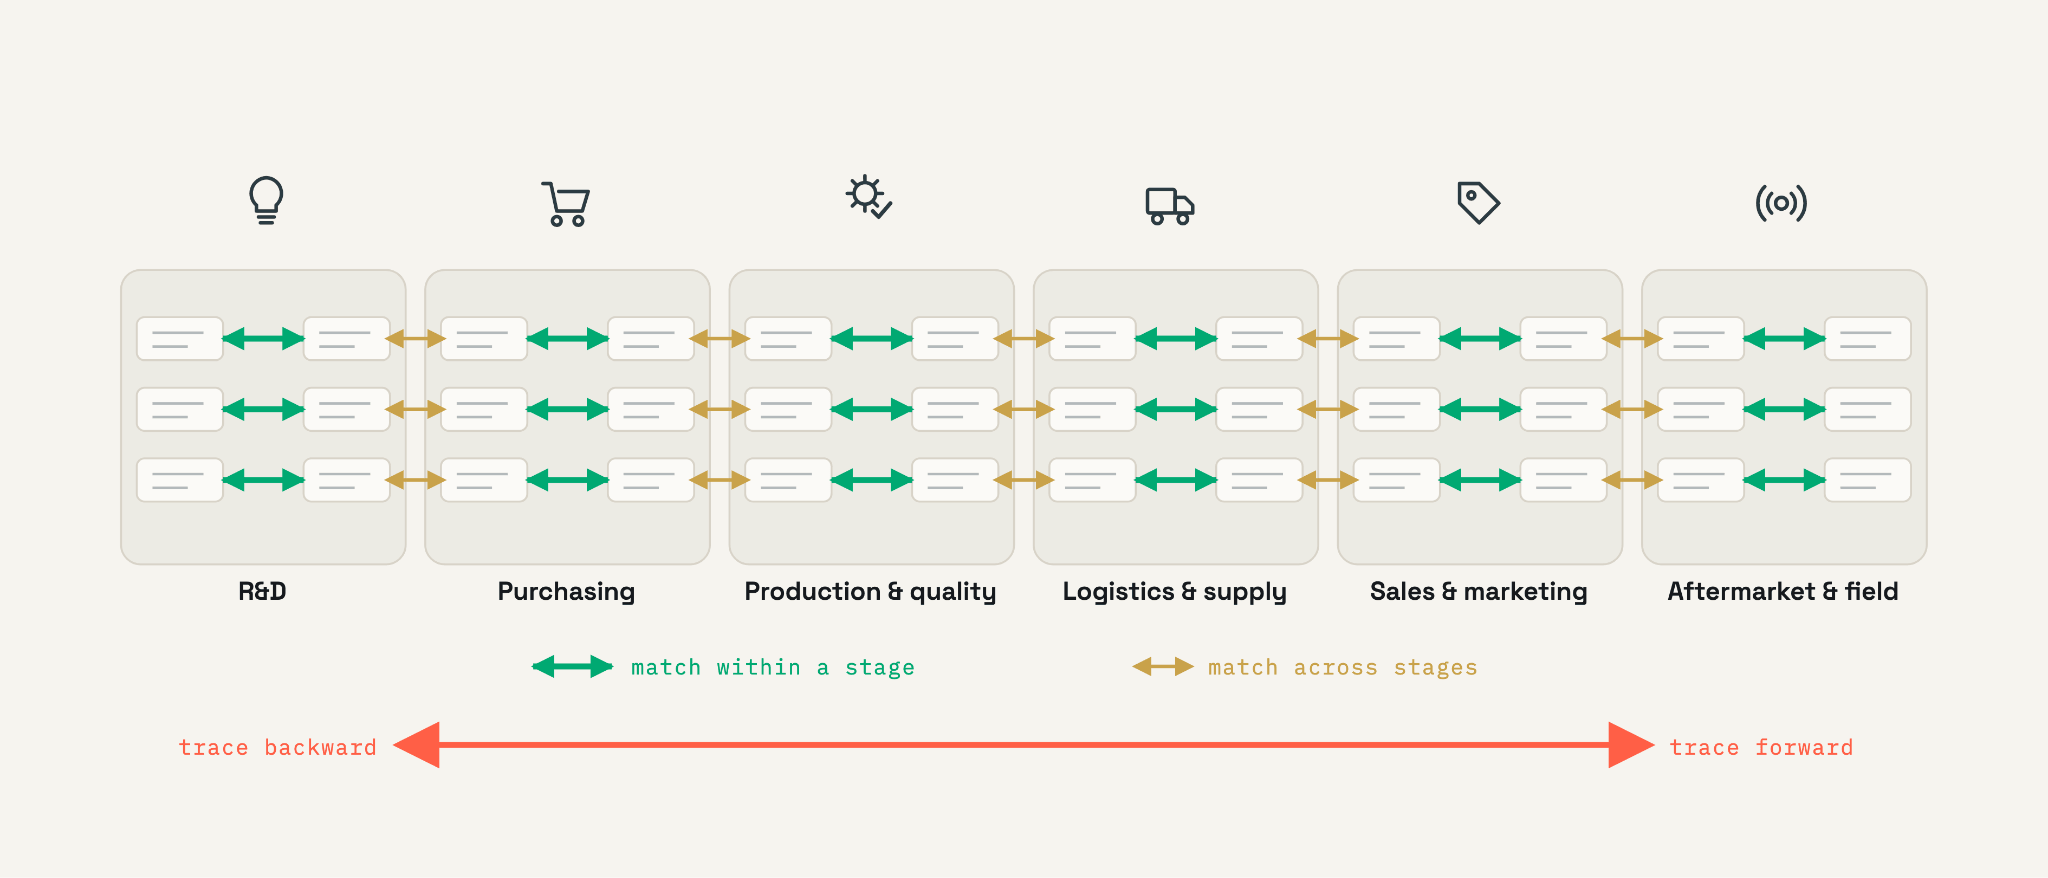
Jede Phase erzeugt wertvolle operative Daten. Die größere Chance liegt darin, eine Erkenntnis aus einem Teil der Kette mit einer Maßnahme in einem anderen Teil zu verknüpfen: ein in der Produktion festgestelltes Qualitätsproblem, das anhand von Logistik- und Lieferantenunterlagen untersucht wird, oder eine Lieferantenwarnung, die bis zu jedem Produkt zurückverfolgt wird, das das betroffene Material erhalten hat.
Warum Systemgrenzen das eigentliche Problem sind
Wenn jede Phase der Wertschöpfungskette isoliert ist, wird eine phasenübergreifende Frage zu einem manuellen Projekt aus Tickets, Exporten und Abstimmungen. Wenn die Daten als ein einziges, kontrolliertes System zugänglich sind, wird dieselbe Frage zu einer einfachen Abfrage.
Beispiel 1: Ein Qualitätsingenieur im Werk muss drei Fragen beantworten:
- Wird ein sprunghafter Anstieg des Ausschusses durch die Charge, die Maschine oder die Einrichtung verursacht, und tritt er auch jetzt noch auf?
- Haben wir diesen Fehler schon einmal gesehen und hat die Behebung Bestand gehabt?
- Warum verschrottet ein Werk weitaus mehr desselben Teils als ein anderes?
Jede Frage erstreckt sich über mehrere Systeme: Datensätze aus dem Manufacturing Execution System (MES), Prozessdatenarchiv-Daten, Lieferanten- und Supplier Quality Management (SQM)-Daten, die Historie des Quality Management System (QMS), Eight Disciplines (8D)-Berichte und oft auch mehrere Werksinstanzen. Heute bedeutet die Beantwortung jeder einzelnen Frage das Erstellen von Tickets, das Ziehen manueller Exporte und die Abhängigkeit von einigen wenigen Spezialisten.
Beispiel 2: Ein Einkaufsanalyst muss drei Fragen beantworten:
- Welche kritischen Teile hängen von einem einzigen Lieferanten ab, der jetzt als Lieferrisiko eingestuft ist?
- Hat sich die Liefertreue und Qualität eines Lieferanten bei den letzten Bestellungen verschlechtert?
- Wenn ein Lieferant ausfällt, welche Produkte, Werke und offenen Bestellungen sind davon betroffen?
Jede Frage erstreckt sich über mehrere Systeme: Enterprise Resource Planning (ERP)-Einkaufs- und Source-to-Pay-Datensätze, Verträge, Lieferantenrisiko-Feeds und Lieferantenportale. Heute kann die Beantwortung jeder einzelnen Frage zu einem kleinen Projekt aus Tickets, Spezialwissen und manuellen Exporten werden.
Die Zusammenführung dieser operativen Datenquellen beseitigt diese Reibungsverluste. Führen Sie die Wertschöpfungskette einmal zusammen, verwalten Sie sie zentral und verwenden Sie eine gemeinsame Kennung – eine Serien-, Chargen- oder Teilenummer – als Join-Key, und schon wird die Rückverfolgbarkeit zu einer einfachen Abfrage. Sechs Fragen, ein grundlegendes Bedürfnis: Daten über Systeme hinweg zusammenzuführen, die nie für eine Verbindung ausgelegt waren, und dem Ergebnis zu vertrauen. Vier Plattformfunktionen machen dies möglich.
Wie Databricks Fertigungsdaten verbindet
Keine störende Migration erforderlich
Eine vernetzte Wertschöpfungskette erfordert keine störende Migration jedes einzelnen Quellsystems. Daten können kopiert werden, wenn dies die richtige Wahl ist, oder sie können an Ort und Stelle verbleiben und dennoch abgefragt werden.
Mit Zero-Copy-Open Sharing und Lakehouse Federation können Unternehmen auf Daten in ihren Quellsystemen zugreifen, ohne für jeden Anwendungsfall eine weitere Extract, Transform and Load (ETL)-Pipeline oder -Kopie erstellen zu müssen. Wenn eine Spiegelung sinnvoll ist, bieten Connectors und Cloud-Objektspeicher einen skalierbaren Weg, um Daten in das Lakehouse zu übertragen.
Die Databricks Data and AI Platform vereint diese Flexibilität mit den Funktionen, die Fertigungsteams benötigen: historische Analysen über Produktions-, Qualitäts- und Lieferdaten hinweg, Verarbeitung mit geringer Latenz für Maschinen- und Fahrzeugtelemetrie sowie Anwendungen, die einzelne Datensätze schnell lesen und schreiben können.
Die vier Funktionen, auf denen die Beispiele aufbauen
Zusammenführung oder Föderierung der Quelldaten ohne störende Migration: Die Frage des Qualitätsingenieurs erstreckt sich über MES, Prozessdatenarchiv, Lieferant und SQM, QMS und 8D-Berichte über Werksinstanzen hinweg; die des Einkaufsanalysten über ERP-Einkauf, Verträge und Lieferantenrisiko-Feeds. Mit Zero-Copy Open Sharing und Lakehouse Federation können diese Daten direkt vor Ort abgefragt und über Connectors gespiegelt werden, wenn das Kopieren die bessere Wahl ist. In jedem Fall ist pro Frage keine neue ETL-Kopie erforderlich.
Orchestrierung und Verfeinerung: Beide Beispiele führen Joins gegen kontrollierte Gold-Tabellen durch, nicht gegen Rohdaten-Exporte. Lakeflow hilft Teams beim Erstellen, Planen und Überwachen von Pipelines, die Roheingaben in vertrauenswürdige, analysebereite Daten umwandeln – in der Regel über Bronze-, Silver- und Gold-Layer.
Governance für Daten und KI: Unity Catalog ist die einheitliche Steuerungsebene (Control Plane) für gespiegelte und föderierte Daten: ein einziges Berechtigungsmodell, vollständige Lineage und Discovery über Daten, Modelle und KI-Agents hinweg, sodass dieselbe kontrollierte Oberfläche beide Beispiele abdeckt. Mit dem Unity Gateway können Sie den KI-Zugriff, die Ausgaben und die Observability für Agents, Tools, Modelle und MCPs steuern.
Agentenbasierte Funktionen: Auf dieser kontrollierten Basis aufbauend ist Genie One ein KI-Kollege, der sich mit Ihren Daten verbindet, Agent Bricks hilft beim Erstellen von KI-Agents auf der Grundlage von Unternehmensdaten, und mit dem Genie App Builder kann jeder Agents und Anwendungen in natürlicher Sprache erstellen. Der Ingenieur und der Analyst können ihre Fragen in einfacher Sprache stellen und erhalten Antworten, die auf den vom Unternehmen anerkannten Definitionen basieren – das Thema der nächsten beiden Abschnitte.
Das praktische Designprinzip ist einfach: Führen Sie die Daten dort zusammen, wo sie einen Mehrwert bieten, föderieren Sie sie dort, wo das Kopieren keinen Sinn ergibt, und verwalten Sie beide über dieselbe Steuerungsebene. Das Ergebnis ist eine Möglichkeit, über verschiedene Fertigungsdatentypen und -phasen hinweg zu arbeiten, ohne für jeden Analyse- oder KI-Anwendungsfall ein neues Silo zu erstellen.
Datenkompetenz verbessern – Daten für mehr als nur Spezialisten nutzbar machen
Eine Plattform ist nur so wertvoll wie die Menschen, die sie nutzen können. In vielen Fertigungsunternehmen versteht eine kleine Gruppe von Experten die werkspezifischen Systeme, während die geschäftlichen Anwender auf Berichte oder Exporte warten.
Die Datenkompetenz (Data Literacy) wächst, wenn Menschen eine praktische Entwicklung durchlaufen: relevante Daten finden, vertrauenswürdige Definitionen verstehen, diese analysieren, Fragen in natürlicher Sprache stellen, kontrollierte Agents oder Anwendungen erstellen und diese Ressourcen mit anderen teilen. Nicht jeder muss ein Data Engineer werden, um teilzuhaben. Diese Entwicklung erfolgt in sechs Schritten, die unten dargestellt sind.

Technologie ist nur ein Teil der Veränderung. Schulungen, Communities of Practice und ein Netzwerk von Champions helfen jedem Bereich, Vertrauen aufzubauen und wiederverwendbare Muster zu teilen. Eine gemeinsame, kontrollierte Datenoberfläche bietet diesen Communities eine konkrete Arbeitsgrundlage: gemeinsame Definitionen, ein einheitliches Vokabular und Antworten, die teamübergreifend wiederverwendet werden können.
Wie „Talk to Data“ in der Fertigung funktioniert (und warum es eine kontrollierte Semantik erfordert)
Der schnellste Weg zur Steigerung der Datenkompetenz besteht darin, die Menschen mit ihren Daten sprechen zu lassen: keine Abfragesprache, die man lernen muss, kein Ticket, das man erstellen muss, und kein Bericht, auf den man warten muss. Analysen in natürlicher Sprache können die Hürde für den Datenzugriff senken, aber eine dialogorientierte Benutzeroberfläche reicht nicht aus. Die Antwort muss auf Definitionen basieren, die das Unternehmen anerkennt.
Beispiel: Einkauf
Eine Frage wie „Welche kritischen Teile hängen von einem einzigen Lieferanten ab, der jetzt als Lieferrisiko eingestuft ist?“ erfordert möglicherweise Kenntnisse über SAP-spezifische Tabellenüberschriften, Joins und Geschäftsregeln. Ein Einkaufsanalyst sollte kein Datenspezialist werden müssen, um dies zu untersuchen.
Die Purchasing Genie Demo macht dieses Muster konkret. Das ausführbare Projekt folgt drei Schritten: kontrollierte Daten vorbereiten, Experten-Agents erstellen und diese dann unter einem Supervisor zusammenführen und als eine kontrollierte App freigeben.

Dieses Muster trennt die Arbeit, die technisches Fachwissen erfordert – das Vorbereiten und Verwalten der Daten – von der Arbeit, die geschäftliche Anwender selbst erledigen können sollten: Fragen stellen, Antworten überprüfen und Maßnahmen ergreifen.
Beispiel: KPI-Berichterstattung
Dasselbe Muster gilt für die tägliche Berichterstattung. Wenn KPI-Definitionen in einer kontrollierten semantischen Schicht liegen, arbeiten sowohl BI-Tools als auch KI mit derselben Geschäftslogik. Genie-Agents beantworten Fragen innerhalb eines Bereichs unter Verwendung dieser vertrauenswürdigen Definitionen, und Agent Bricks fügt sie zu persona-basierten Agents zusammen, die bereichsübergreifend arbeiten. Das Ergebnis: Dieselbe Frage erhält jedes Mal dieselbe Antwort, basierend auf Definitionen, die das Unternehmen anerkennt, anstatt aus komplexen Schemata oder isolierten Berichten abgeleitet zu werden.
Mercedes-Benz Korea wendet dieses Muster in der Praxis an, hier erfahren Sie mehr darüber.
Ein praktischer Weg nach vorn
Vor mehr als 50 Jahren beschrieb Dr. Joseph Harringtons Vision der computerintegrierten Produktion (Computer Integrated Manufacturing) die Fertigung als ein zusammenhängendes System, das durch den Informationsfluss vereint wird. Diese Vision ist heute in großem Maßstab realisierbar.
Das Rezept für die Umsetzung umfasst drei Schritte:
- Die Daten einmal zusammenführen und einmal verwalten mit Unity Catalog als zentraler Steuerungsebene (Control Plane), die sowohl gespiegelte als auch föderierte Datenquellen abdeckt.
- Eine gemeinsame Kennung als Join-Schlüssel verwenden (z. B. eine Serien-, Chargen- oder Teilenummer), sodass Erkenntnisse in einem Teil der Wertschöpfungskette Maßnahmen in einem anderen auslösen können, was eine lückenlose Rückverfolgbarkeit (Traceability) als Abfrage ermöglicht. Welche Kennung geeignet ist, hängt vom Bereich ab: serialisierte Einheiten und VINs in einigen Bereichen, Chargen- oder Losnummern in der Prozessfertigung.
- Menschen mit ihren Daten sprechen lassen, indem der Zugang in natürlicher Sprache auf einer kontrollierten Geschäftssemantik basiert.
Wenn geschäftliche Anwender Fragen in einfacher Sprache stellen und vertrauenswürdige Antworten erhalten können, ist Datenkompetenz kein Privileg einiger weniger Spezialisten mehr, sondern wird zu einer Fähigkeit des gesamten Unternehmens. Das Ergebnis ist nicht ein weiteres Dashboard. Es sind Tausende von Menschen in der gesamten Wertschöpfungskette, die vertrauenswürdige Daten finden, verstehen und danach handeln können.
Häufig gestellte Fragen (FAQ)
Was ist der größte Vorteil der Verknüpfung von Fertigungsdaten über die gesamte Wertschöpfungskette hinweg?
Der größte Vorteil der Verknüpfung von Fertigungsdaten über die gesamte Wertschöpfungskette hinweg ist die Möglichkeit, Fragen zu beantworten, die in einer Phase beginnen und Maßnahmen in einer anderen erfordern. Ein Produktionsfehler kann über die Logistik bis zur verursachenden Lieferantencharge zurückverfolgt werden, oder eine verdächtige Lieferantencharge kann bis zu jedem Produkt nachverfolgt werden, in das sie eingegangen ist. Ohne verknüpfte Daten erfordert jede dieser Untersuchungen tagelange manuelle Arbeit. Mit einem vernetzten Lakehouse wird dieselbe Frage zu einer einfachen Abfrage.
Müssen Hersteller alle Quelldaten zu Databricks migrieren?
Hersteller müssen nicht alle Quelldaten zu Databricks migrieren. Daten können kopiert werden, wenn dies nützlich ist, aber dank Zero-Copy Open Sharing und Lakehouse Federation können Daten in den Quellsystemen verbleiben und direkt vor Ort abgefragt werden. Unity Catalog kann sowohl föderierte als auch gespiegelte Daten verwalten.
Was ist Rückverfolgbarkeit?
Rückverfolgbarkeit (Traceability) verknüpft Fertigungsprozessschritte, Produkte, Materialien und Betriebsaufzeichnungen, sodass Teams von einem betroffenen Produkt zurückverfolgen oder von einem verdächtigen Material vorwärtsverfolgen können. Dies unterstützt eine schnellere Problemlösung und präzisere Rückrufanalysen. Ein Beispiel ist die Rückverfolgung der Serien- oder Chargennummern der hergestellten Produkte.
Was ist LTAP und warum benötigen Hersteller es?
LTAP steht für Lake Transactional/Analytical Processing. Es beschreibt die Ausführung von analytischen und transaktionalen Workloads auf einer einzigen kontrollierten Plattform. Die Fertigung benötigt sowohl umfassende Analysen historischer Daten als auch reaktionsschnelle Anwendungen, die Betriebsaufzeichnungen lesen und schreiben. In der Vergangenheit existierten diese in zwei separaten Stacks, zwischen denen Daten kopiert wurden. LTAP führt beides auf einer einzigen Kopie kontrollierter Daten aus.
Was lässt die Datenkompetenz über die Plattformfunktionen hinaus wachsen?
Funktionen allein reichen nicht aus. Schulungen, Communities of Practice und Champions in jedem Bereich helfen den Menschen, Vertrauen aufzubauen, Muster zu teilen und eine gemeinsame, kontrollierte Datenoberfläche zu nutzen. Die Plattform bietet die Grundlage, eine aktive Community macht daraus eine breite Kompetenz.
Wie wird „Talk to Data“ vertrauenswürdig?
Der Zugang in natürlicher Sprache sollte auf einer kontrollierten Geschäftssemantik basieren: dokumentierte Kennzahlen, Dimensionen, Joins und Definitionen. Genie kann dann Fragen unter Verwendung desselben vertrauenswürdigen Kontexts beantworten, anstatt die Bedeutung aus komplexen Schemata oder isolierten Berichten abzuleiten.
Was ist Lakehouse Federation?
Lakehouse Federation ist eine Funktion von Databricks, mit der Daten in ihrem Quellsystem verbleiben können, während sie dennoch über Databricks abgefragt werden. Dadurch wird die Erstellung zusätzlicher ETL-Pipelines oder Datenkopien vermieden. Die Quelldaten werden über Unity Catalog zusammen mit allen gespiegelten Daten verwaltet, was eine einheitliche Governance-Schicht bietet, unabhängig davon, wo die Daten physisch liegen.
Was ist Unity Catalog im Kontext von Fertigungsdaten?
Unity Catalog ist die einheitliche Governance-Schicht von Databricks für Daten, Modelle und KI-Agents. Sie bietet ein einziges Berechtigungsmodell, vollständige Data Lineage und Erkennung über die gesamte Datenlandschaft hinweg. Für die Fertigung bedeutet dies eine einzige Steuerungsebene (Control Plane), die Produktionsdaten, Qualitätsaufzeichnungen, Lieferantendaten und KI-Agents verwaltet – unabhängig davon, ob diese Daten im Lakehouse liegen oder aus Quellsystemen föderiert werden.
Kann die Plattform hochvolumige Maschinen- und Fahrzeugtelemetrie verarbeiten?
Ja. Die Plattform kombiniert Batch- und Streaming-Verarbeitung. Hochvolumige Maschinen- und Fahrzeugtelemetrie kann als kontinuierlicher Stream mit sehr geringer Latenz erfasst und zuverlässig verarbeitet werden, sodass auf dem Weg keine Ereignisse verloren gehen.
Wie gelangen Daten in Databricks?
Die Datenerfassung (Ingestion) ist einfach gestaltet. Zerobus Ingest unterstützt Push-basiertes Streaming direkt in kontrollierte Tabellen, Lakeflow Connect bietet verwaltete Connectors und Change Data Capture für Geschäftssysteme, und Auto Loader und Structured Streaming verarbeiten Dateien und Ereignisse.
Ist die Plattform offen und Multi-Cloud-fähig?
Ja. Delta-Tabellen werden im Cloud-Objektspeicher gespeichert, wobei Speicher und Rechenleistung (Compute) unabhängig voneinander skalieren. Databricks läuft auf AWS, Azure und Google Cloud, und die Daten landen in offenen Formaten wie Delta Lake und Iceberg.
(Dieser Blogbeitrag wurde mit KI-gestützten Tools übersetzt.) Originalbeitrag
Erhalten Sie die neuesten Beiträge in Ihrem Posteingang
Abonnieren Sie unseren Blog und erhalten Sie die neuesten Beiträge direkt in Ihren Posteingang.