NEAREST BY-Join: Skalierung der Vektorsuche in Databricks Runtime
Wie wir die Vektorsuche als erstklassigen SQL-Join in Databricks integriert haben – mit tiefgehenden Kernel-Optimierungen in Photon und einem Vektorindex in einem offenen Speicherformat.
von Zero Qu, Alexis Schlomer, Akash Nayar, Yingyi Bu und Sergei Tsarev
- NEAREST BY ist ein neuer SQL-Join für die Batch-Vektorsuche: Finden Sie für jede Abfragezeile die k nächsten Zeilen basierend auf Vektorähnlichkeit oder -distanz – exakt oder approximativ.
- Ein fusionierter Photon-Operator mit einem benutzerdefinierten, geblockten GEMM-Kernel optimiert das Distanz-Scoring bis an den maximalen arithmetischen Durchsatz der Hardware.
- Ihr Lakehouse ist gleichzeitig Ihr Vektorspeicher, ohne dass ein separates System synchronisiert oder betrieben werden muss: Der IVF-Vektorindex ist eine gewöhnliche Liquid-Clustered-Delta-Tabelle, die beim Lesen die meisten Partitionen eliminiert.
Die Vektorsuche entstand ursprünglich als Serving-Problem. Der klassische Anwendungsfall ist ein Chatbot oder ein Suchfeld: Ein Query-Embedding geht ein, und das System ist darauf optimiert, die Top-k der nächsten Dokumente innerhalb weniger Dutzend Millisekunden zurückzugeben.
Ein Großteil der Vektorsuch-Workloads auf unserer Plattform ist jedoch von Natur aus batchorientiert – das heißt, exakte oder approximative nächste Nachbarn werden offline im Voraus berechnet, anstatt sie erst zum Zeitpunkt der Anfrage abzurufen. Ein Zahlungsdienstleister gleicht täglich über 100 Millionen Transaktionen mit 140 Millionen Händler-Embeddings für die Entitätsauflösung (Entity Resolution) ab; ein Datenunternehmen reichert jede Nacht zig Millionen historischer Datensätze an; ein quantitativer Fonds führt Batches mit Millionen von Abfragen auf einem Korpus von 50 Millionen Vektoren für das Taxonomie-Tagging aus.
Entitätsauflösung, Deduplizierung, semantisches Tagging, Klassifizierung, Datensatz-Anreicherung, Batch-Empfehlungen – dies sind im Grunde Batch-Workloads: Millionen von Abfragen gegen Millionen bis Milliarden von Vektoren nach einem festen Zeitplan. Der Erfolg bemisst sich daran, ob der Job innerhalb seines SLA zu angemessenen Kosten abgeschlossen wird, und nicht an der Latenz einer einzelnen Abfrage. Diese Workloads erfordern eine völlig andere Architektur für bessere Leistung, Zuverlässigkeit und Kosteneffizienz – deshalb sind wir zu den Grundprinzipien zurückgekehrt.
Anforderungen
- Gesamtdurchsatz vor Latenz pro Anfrage. Der Maßstab für den Erfolg ist der Abschluss des gesamten Batch-Jobs innerhalb seines SLA zu angemessenen Kosten. Daher sollte das Design bei jeder Gelegenheit Latenz pro Anfrage zugunsten des Durchsatzes opfern.
- Skalierung auf beiden Seiten des Joins. Bis zu Hunderte Millionen von Query-Vektoren gegen Milliarden von Basisvektoren. Das System muss alle Ausprägungen von Query- und Basis-Kardinalitäten bewältigen.
- Elastische Parallelität. Batch-Durchsatz entsteht durch horizontale Skalierung. Die Arbeit muss sich sauber auf Hunderte bis Tausende von Kernen aufteilen lassen, und die Rechenleistung sollte sich automatisch an den Job anpassen: hochskalieren für die Ausführung, danach wieder auf null herunterskalieren.
- Maximale Rechenleistung pro Kern. Die Berechnung von Distanz-Scores ist rechenintensiv. Horizontale Skalierung multipliziert nur das, was ein einzelner Kern leistet. Daher müssen die inneren Schleifen nahe am theoretischen Maximum laufen, das durch die arithmetische Bandbreite (FLOPs/s) und die Speicherbandbreite (Bytes/s) der zugrunde liegenden Hardware vorgegeben ist.
- Fehlertoleranz. Ein Job, der stundenlang läuft, muss den Ausfall von Workern, vorübergehende Task-Fehler und Speicherengpässe durch Auslagerung auf die Festplatte (Spilling to Disk) überstehen. Dies sind Eigenschaften einer Execution Engine, keine Features, die wir nachträglich um einen Echtzeit-Serving-Endpunkt herum bauen können.
Die Databricks Runtime erfüllt diese Anforderungen perfekt – eine verteilte, fehlertolerante, elastische Execution Engine, die auf Apache Spark und Photon aufbaut, einer vektorisierten, nativen C++ Query Engine. Genau aus diesem Grund haben wir uns entschieden, die Vektorsuche direkt als natives Engine-Feature zu entwickeln, anstatt uns auf eine separate Infrastruktur zu verlassen.
Architektur
Unsere erste Version der SQL-Funktion VECTOR_SEARCH war darauf ausgelegt, Anfragen an einen externen Echtzeit-Vektorsuch-Endpunkt zu verteilen. Sie wurde als Generate-Knoten implementiert, der jeweils eine Query-Zeile streamte: Jede Zeile verursachte eine Netzwerkanfrage, eine zu deserialisierende Antwort und möglicherweise erneute Versuche (Retries). Das funktionierte zwar, stieß aber an eine Leistungsgrenze – der Durchsatz war durch die Dimensionierung des Echtzeit-Endpunkts begrenzt und nicht durch die Größe des Runtime-Clusters, wodurch die Runtime Engine zu einem bloßen Dispatcher degradiert wurde. Zudem ging dies an der eigentlichen Struktur der Abfrage vorbei. Eine Batch-Vektorsuche besteht nicht aus einer Million kleiner Suchen. Es handelt sich um eine einzige große Abfrage: Finde für jede Zeile auf der linken Seite die k nächsten Zeilen auf der rechten Seite – ein Top-k-Ranking-Join. Das Ausführen enormer Joins ist genau das, worin die Runtime Engine glänzt.
Die native Implementierung der Vektorsuche in der Runtime Engine zahlt sich in zweierlei Hinsicht aus.
- Eine einzige Kopie der Daten. Embeddings verbleiben in Delta-Tabellen im Lakehouse – kein separater Vektorspeicher, keine Synchronisations-Pipeline zur Konsistenzprüfung, kein zweites System, das betrieben und bezahlt werden muss.
- Eine einzige Engine für die Ausführung. Die Suche läuft in einer einzigen Engine, die sich elastisch an den Workload anpasst, mit Kernels, die speziell für Batch-Abfragestrukturen entwickelt wurden. Sie bringen jeden Kern an seine maximale FLOPs-Leistung und lassen die horizontale Skalierung den Rest multiplizieren. Die Engine übernimmt bereits die Fehlertoleranz: Tasks werden automatisch wiederholt, und bei Speicherengpässen wird auf die Festplatte ausgelagert. Keine clientseitige Concurrency-Steuerung, kein Rate Limiting und keine Retry-Schleifen.
Dies führte zu einem bewusst schlanken, aber tiefen Stack: einer neuen Join-Syntax, NEAREST BY, die den Top-k-Ranking-Join zu einer relationalen Operation erster Klasse macht; einem Rewrite, das ihn auf drei Primitive herunterbricht – SIMD-beschleunigte Distanzfunktionen und ein begrenztes Top-k-Aggregat; einem fusionierten Photon-Operator, der den gesamten mittleren Teil des Plans durch einen benutzerdefinierten GEMM-Kernel ersetzt; und einem optionalen IVF-Index, der als gewöhnliche Delta-Tabelle mit Liquid Clustering aufgebaut ist, wodurch APPROX-Abfragen mit denselben Kerneln nur einen Bruchteil der Basisvektoren bewerten müssen.
Die Syntax: Ein Top-k-Ranking-Join
Bestehende Engines haben sich auf zwei Interface-Strukturen geeinigt. Postgres mit pgvector und Snowflake kombinieren Distanzoperatoren mit ORDER BY … LIMIT – für Batch wird dann eine LATERAL-Unterabfrage pro steuernder Zeile benötigt, und dem Optimizer fehlt ein Muster, um zwischen KNN- und ANN-Abfragen zu unterscheiden. Diese Erkennung ist zudem fehleranfällig: Weicht die Abfrage von der erwarteten Struktur ab, verschwindet der schnelle Pfad unbemerkt.
BigQuery stellt eine Tabellenwertfunktion bereit – Batch ist hier zwar erstklassig, aber Spaltenreferenzen sind Strings, die der Parser nicht validieren kann.
Strukturell ist die Batch-Vektorsuche eine binäre relationale Operation: zwei Tabelleneingaben, eine Ausgabe, die beide kombiniert, und ein Top-k pro linker Zeile, das sie verbindet. Die Syntax kodiert diese Struktur als nativen Top-k-Ranking-Join:
Der Join ist asymmetrisch, ähnlich wie LATERAL: Die linke Seite steuert, die rechte Seite wird durchsucht. Die Ranking-Richtung ist explizit: BY SIMILARITY absteigend, BY DISTANCE aufsteigend. LEFT OUTER behält Query-Zeilen ohne Kandidaten bei, und der BY-Ausdruck ist flexibel austauschbar: Jeder sortierbare Skalar über beide Seiten funktioniert, sodass andere Scoring-Ausdrücke dieselbe Klausel später wiederverwenden können.
APPROX und EXACT kodieren eine semantische Vereinbarung. EXACT garantiert die echten Top-k durch vollständige Auswertung; APPROX erlaubt es dem Optimizer, eine approximative Strategie wie einen ANN-Index zu verwenden, sofern anwendbar. Das Erstellen oder Löschen eines Index kann also niemals unbemerkt die Abfrageergebnisse ändern: Nur Abfragen, die explizit APPROX angeben, stimmen einer Approximation zu.
Das Query-Rewrite
NEAREST BY wird in einen logischen Join-Knoten geparst, den der Optimizer auf standardmäßige relationale Operatoren herunterbricht: Das Rewrite versieht jede Query-Zeile mit einer generierten ID, bewertet jedes (Query, Basis)-Paar, behält die k besten pro ID mit einem gruppierten Top-k und gibt die beibehaltenen Zeilen wieder aus:
Semantisch kapselt dies das gesamte Feature: einen Cross-Join, einen skalaren Scoring-Ausdruck und ein gruppiertes Top-k-Aggregat. Da jeder Operator ein gewöhnlicher relationaler Operator ist, lässt sich der Plan wie jeder andere verteilen, auslagern und wiederholen – Korrektheit und Fehlertoleranz ergeben sich von selbst. Was das Rewrite wirklich isoliert, sind die beiden Primitive, durch die die gesamte Ausführungszeit fließt: die Distanzfunktion, die ein Paar bewertet, und das Aggregat, das die k besten jeder Gruppe behält.
Wir haben jeden Operator in diesem Plan nativ in Photon implementiert, plus einen zusätzlichen fusionierten Operator, der speziell für die Vektorsuche entwickelt wurde und den gesamten mittleren Teil des Plans durch einen performanteren, batch-freundlichen Kernel ersetzt.
Die Photon-Kernel
Die Vektorfunktionen
Die Kernbausteine sind eine Familie von Vektor-SQL-Funktionen über ARRAY<FLOAT>-Spalten. Drei davon sind für die Ähnlichkeits- und Distanzberechnung verantwortlich:
| SQL-Funktion | Berechnet | Näher bedeutet |
|---|---|---|
| vector_inner_product(a, b) | 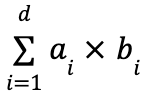 | Höher (BY SIMILARITY) |
| vector_cosine_similarity(a, b) | 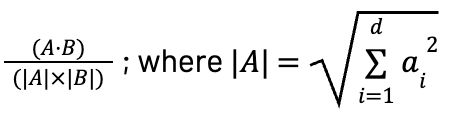 | Höher (NACH ÄHNLICHKEIT) |
| vector_l2_distance(a, b) | 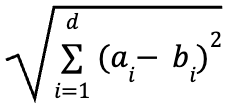 | Niedriger (NACH ABSTAND) |
Zusammen mit den Ähnlichkeits- und Abstandsfunktionen haben wir zwei Norm-Hilfsfunktionen bereitgestellt – vector_norm und vector_normalize – sowie zwei Aggregate, vector_sum und vector_avg. Zusammen decken sie sowohl die Abfrage- als auch die Indexerstellung ab: Die Abstandsfunktionen bewerten Abfragen und weisen Zeilen ihrem nächsten Zentroiden zu, während die Aggregate und Normalisierer diese Zentroiden während des K-Means-Algorithmus neu berechnen.
Photon führt die gesamte Familie als native SIMD-Kernel aus. Jede Metrik basiert im Kern auf Multiplikations-Additions-Operationen, und ein einzelner FMA-Befehl (Fused Multiply-Add) berechnet 𝑎 · 𝑏 + 𝑐 über ein gesamtes Vektorregister pro Ausgabe. Die Kernel wurden basierend auf vier bewussten Designentscheidungen implementiert.
- Von Grund auf portabel. Dieselben Kernel müssen auf jeder Cloud (AWS, Azure, GCP) und jeder von uns unterstützten CPU-Architektur (x86, ARM) laufen. Da sich SIMD-Breite und Befehlssatz unterscheiden, wird jeder Kernel in mehrere ISA-spezifische Klone kompiliert. Der beste, den die CPU unterstützt, wird zur Laufzeit ausgewählt (AVX-512 auf einem modernen Intel-Kern, SVE2 auf Graviton).
- Zero-Copy-Eingabe. Ein ARRAY<FLOAT> liegt innerhalb einer Zeile zusammenhängend vor, sodass jeder Vektor als direkter Zeiger (Raw Pointer) in den zugrunde liegenden Puffer der Spalte eingelesen wird – ohne Kopieren und ohne Indexierung pro Element innerhalb der inneren Schleife.
- Lockerere Float-Semantik. Durch den Verzicht auf die strikte IEEE-Reihenfolge kann der Compiler Multiplikations-Additions-Operationen in FMA-Befehle zusammenführen und die Reduktion in parallele Akkumulatorketten aufteilen, sodass die Schleife nicht auf einer einzigen laufenden Summe serialisiert wird.
- Keine skalaren Operationen in der Schleife. Die inneren Schleifen sind reine vektorisierte Multiplikations-Additions-Reduktionen. Skalare Operationen wie Quadratwurzel (sqrt) und Division werden nur einmal außerhalb der Schleife durchgeführt.
Das Top-k-Aggregat
In einfachem SQL ist ein gruppiertes Top-k eine Fensterfunktion: ROW_NUMBER() OVER (PARTITION BY query ORDER BY score). Dies sortiert jede Partition vollständig und verwirft dann alles außer den obersten k Rängen. Stattdessen haben wir die bestehenden Aggregate max_by / min_by um eine Überladung mit einem dritten K-Parameter erweitert. Die Implementierung basiert auf vier Haupteigenschaften.
- Auswahl mit nur einem Vergleich. Der Aggregationszustand pro Gruppe ist ein begrenzter Heap, dessen Wurzel der Kandidat für den Ausschluss und der Schwellenwert für die Aufnahme ist. Sobald er voll ist, wird jeder Kandidat mit einem einzigen Vergleich akzeptiert oder abgelehnt. Es wird nie eine Sortierung über den Kandidatenstrom ausgeführt.
- O(k)-Zustand. Der Speicherbedarf pro Gruppe ist unabhängig von der Eingabegröße. Eine Abfrage, die für eine Milliarde Zeilen ausgewertet wird, enthält nur einen Zustand von k Zeilen, wobei k bis zu 100.000 betragen kann.
- Späte Materialisierung. Der Heap speichert Indizes, keine vollständig materialisierten Kopien. Ein Kandidat bleibt ein Zeiger in den aktiven spaltenbasierten Batch (Columnar Batch) und wird erst dann in den Aggregatzustand kopiert, wenn er die Wiederverwendung des Batches übersteht.
- Verteilbar. Aggregate haben einen Partial/Merge-Vertrag. Jede Partition gibt ihr lokales Top-k aus, der Shuffle verschiebt diese k-Element-Arrays anstelle von rohen Paaren, und der Merge fügt sie wieder ein. Das Ergebnis ist exakt, da das globale Top-k immer eine Teilmenge der Vereinigung der Teilergebnisse ist.
Das Roofline-Modell
Mit all den oben genannten nativen Kerneln ist der Abfrageplan vollständig photonisiert, aber auf Batch-Ebene immer noch weit von der optimalen Leistung entfernt. Der Grund dafür ist theoretischer und nicht implementierungsbedingter Natur, und das Roofline-Modell ist eine einfache und effektive Methode, dies zu veranschaulichen.
𝑃𝑎𝑡𝑡𝑎𝑖𝑛𝑎𝑏𝑙𝑒 = 𝑚𝑖𝑛(𝑃𝑝𝑒𝑎𝑘, 𝐴𝐼 × 𝐵𝑊)
𝑃𝑝𝑒𝑎𝑘 ist der maximale Rechendurchsatz der Hardware (FLOPs/s), BW ist die Speicherbandbreite (Bytes/s) und 𝐴𝐼 ist die arithmetische Intensität des Kernels (ausgeführte FLOPs pro übertragenem Byte). Trägt man 𝑃𝑎𝑡𝑡𝑎𝑖𝑛𝑎𝑏𝑙𝑒 gegen 𝐴𝐼 auf, erhält man die Roofline: Eine diagonale Speichergrenze trifft am Ridge-Point (Knickpunkt) auf eine horizontale Rechengrenze – das minimale 𝐴𝐼, bei dem ein Kernel rechengebunden (compute-bound) sein kann. Links vom Knickpunkt hilft nur die Übertragung von weniger Bytes pro FLOP; rechts davon ist der Kernel rechengebunden, und die Recheneinheiten selbst stellen das Limit dar. Konkret auf einer m6i.2xlarge-Referenzmaschine (zur Veranschaulichung, die Konstanten verschieben sich je nach Hardware):
| Pro Kern | |
|---|---|
| Rechendurchsatz-Grenze | 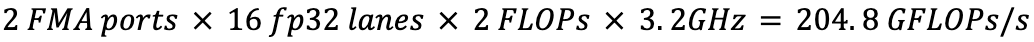 |
| DRAM-Bandbreiten-Grenze | 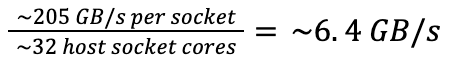 |
| Ridge-Point (Knickpunkt) | 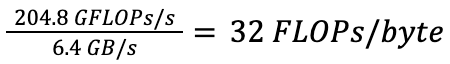 |
*Die L1/L2-Cache-Grenzen liegen 30- bis 60-mal über dem fairen DRAM-Anteil, aber die Basistabelle ist weitaus größer als jeder Cache, sodass jedes Basis-Byte die DRAM-Grenze mindestens einmal überschreitet.
*Die Rechendurchsatz-Grenze skaliert linear mit den Kernen. Ein Cluster aus 64 m6i.2xlarge-Executoren (jeweils 4 physische Kerne) erreicht eine Spitze von 64 x 4 x 204,8 GFLOP/s ≈ 52,5 TFLOP/s bei fp32 FMA.
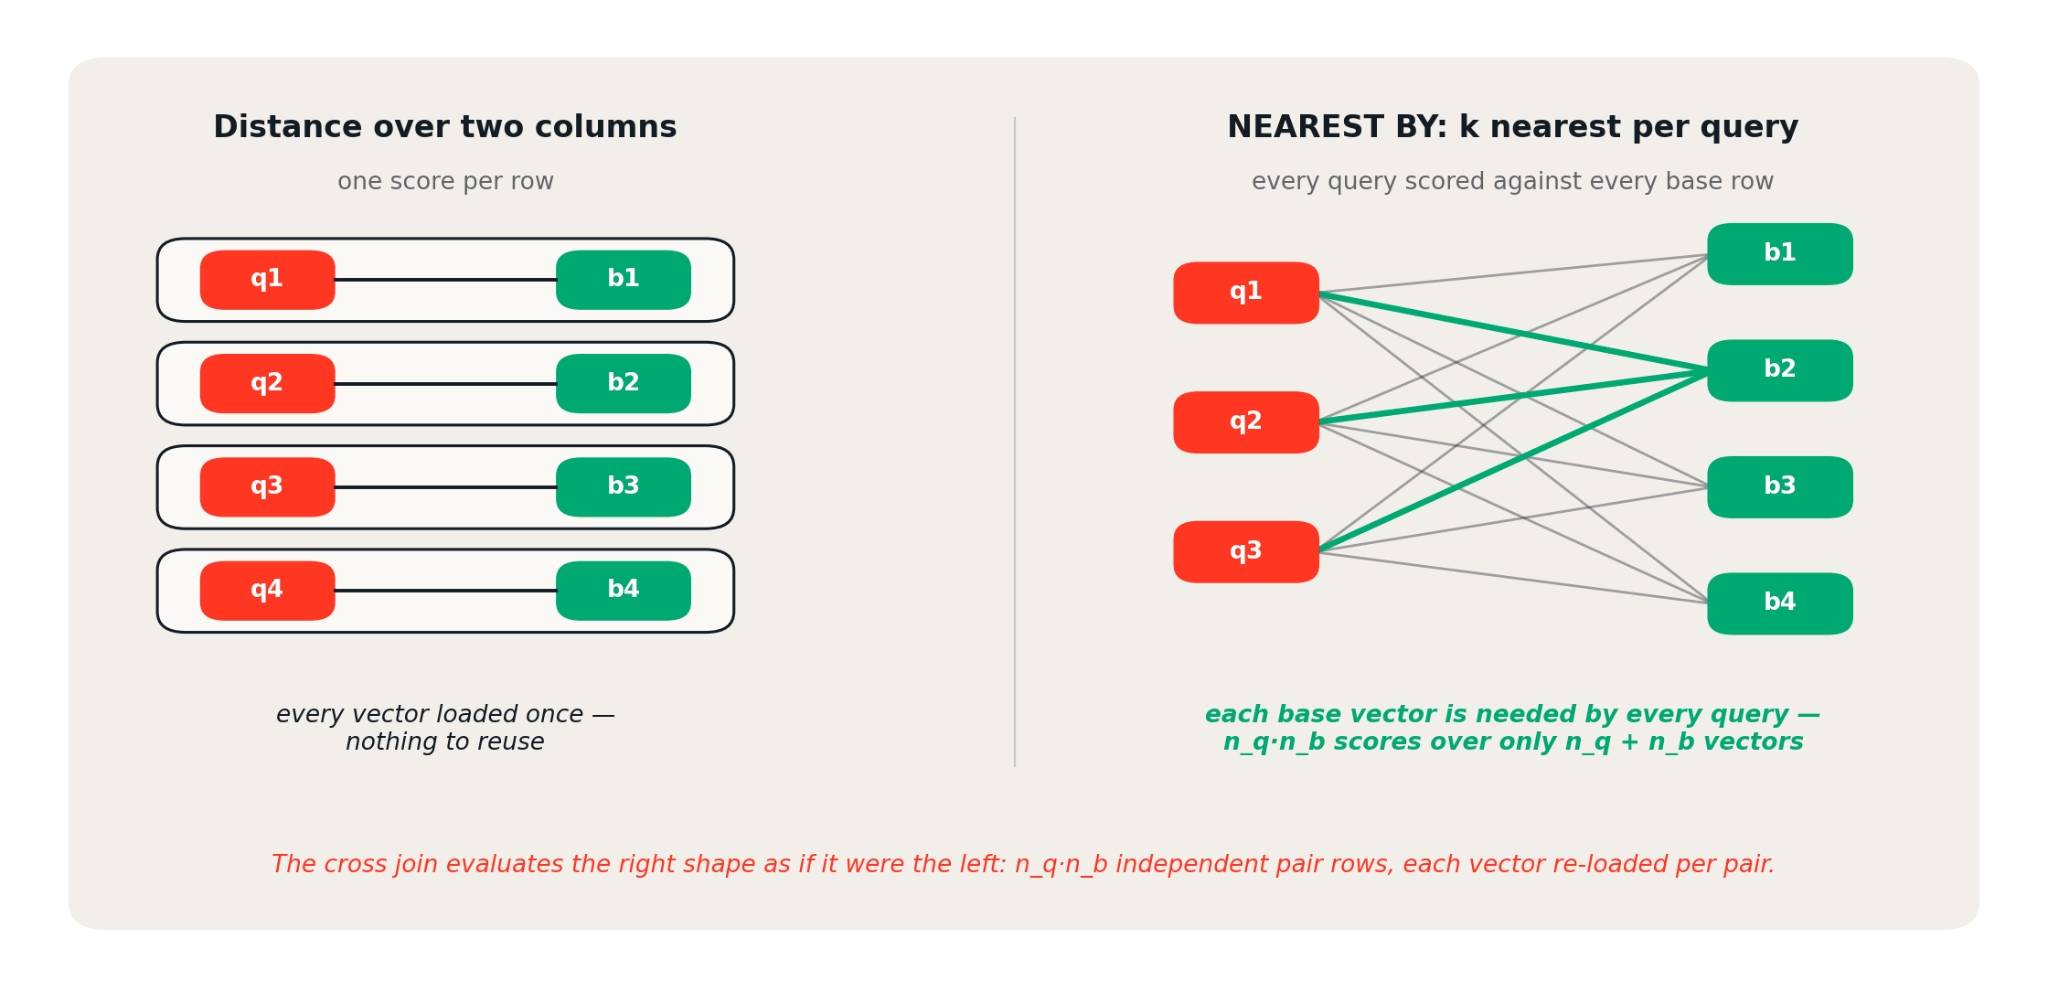
Die Bewertung von zwei ausgerichteten Spalten liefert ein Ergebnis pro Zeile – jeder Vektor wird einmal verwendet, und es findet keine Wiederverwendung statt. Die NEAREST BY-Form liefert 𝑛𝑞 × 𝑛𝑏 Ergebnisse aus nur 𝑛𝑞 + 𝑛𝑏 unterschiedlichen Vektoren, da jeder Basisvektor für jede Abfrage benötigt wird.
Vergleichen Sie nun, was die Vektorsuche beim naiven Plan im Vergleich zu einem wiederverwendungsbewussten Plan überträgt. Die FLOPs sind bei beiden identisch: 2 × 𝑑 × 𝑛𝑞 × 𝑛𝑏, wobei 𝑛𝑞 und 𝑛𝑏 die Kardinalität auf Abfrage- und Basisseite sind und die Embedding-Dimension darstellt.
| Plan | Übertragene Bytes | Arithmetische Intensität (AI) | Skalierung |
|---|---|---|---|
| Paarweiser Cross Join – jeder Operand wird neu geladen und nur einmal verwendet | 2 × 4 × 𝑑 × 𝑛𝑞 × 𝑛𝑏 | 1/4 | 0(1) |
| Fused GEMM – Puffer , einmal streamen | 4 × 𝑑 × 𝑛𝑏 | 𝑛𝑞/2 | 0(𝑛𝑞) |
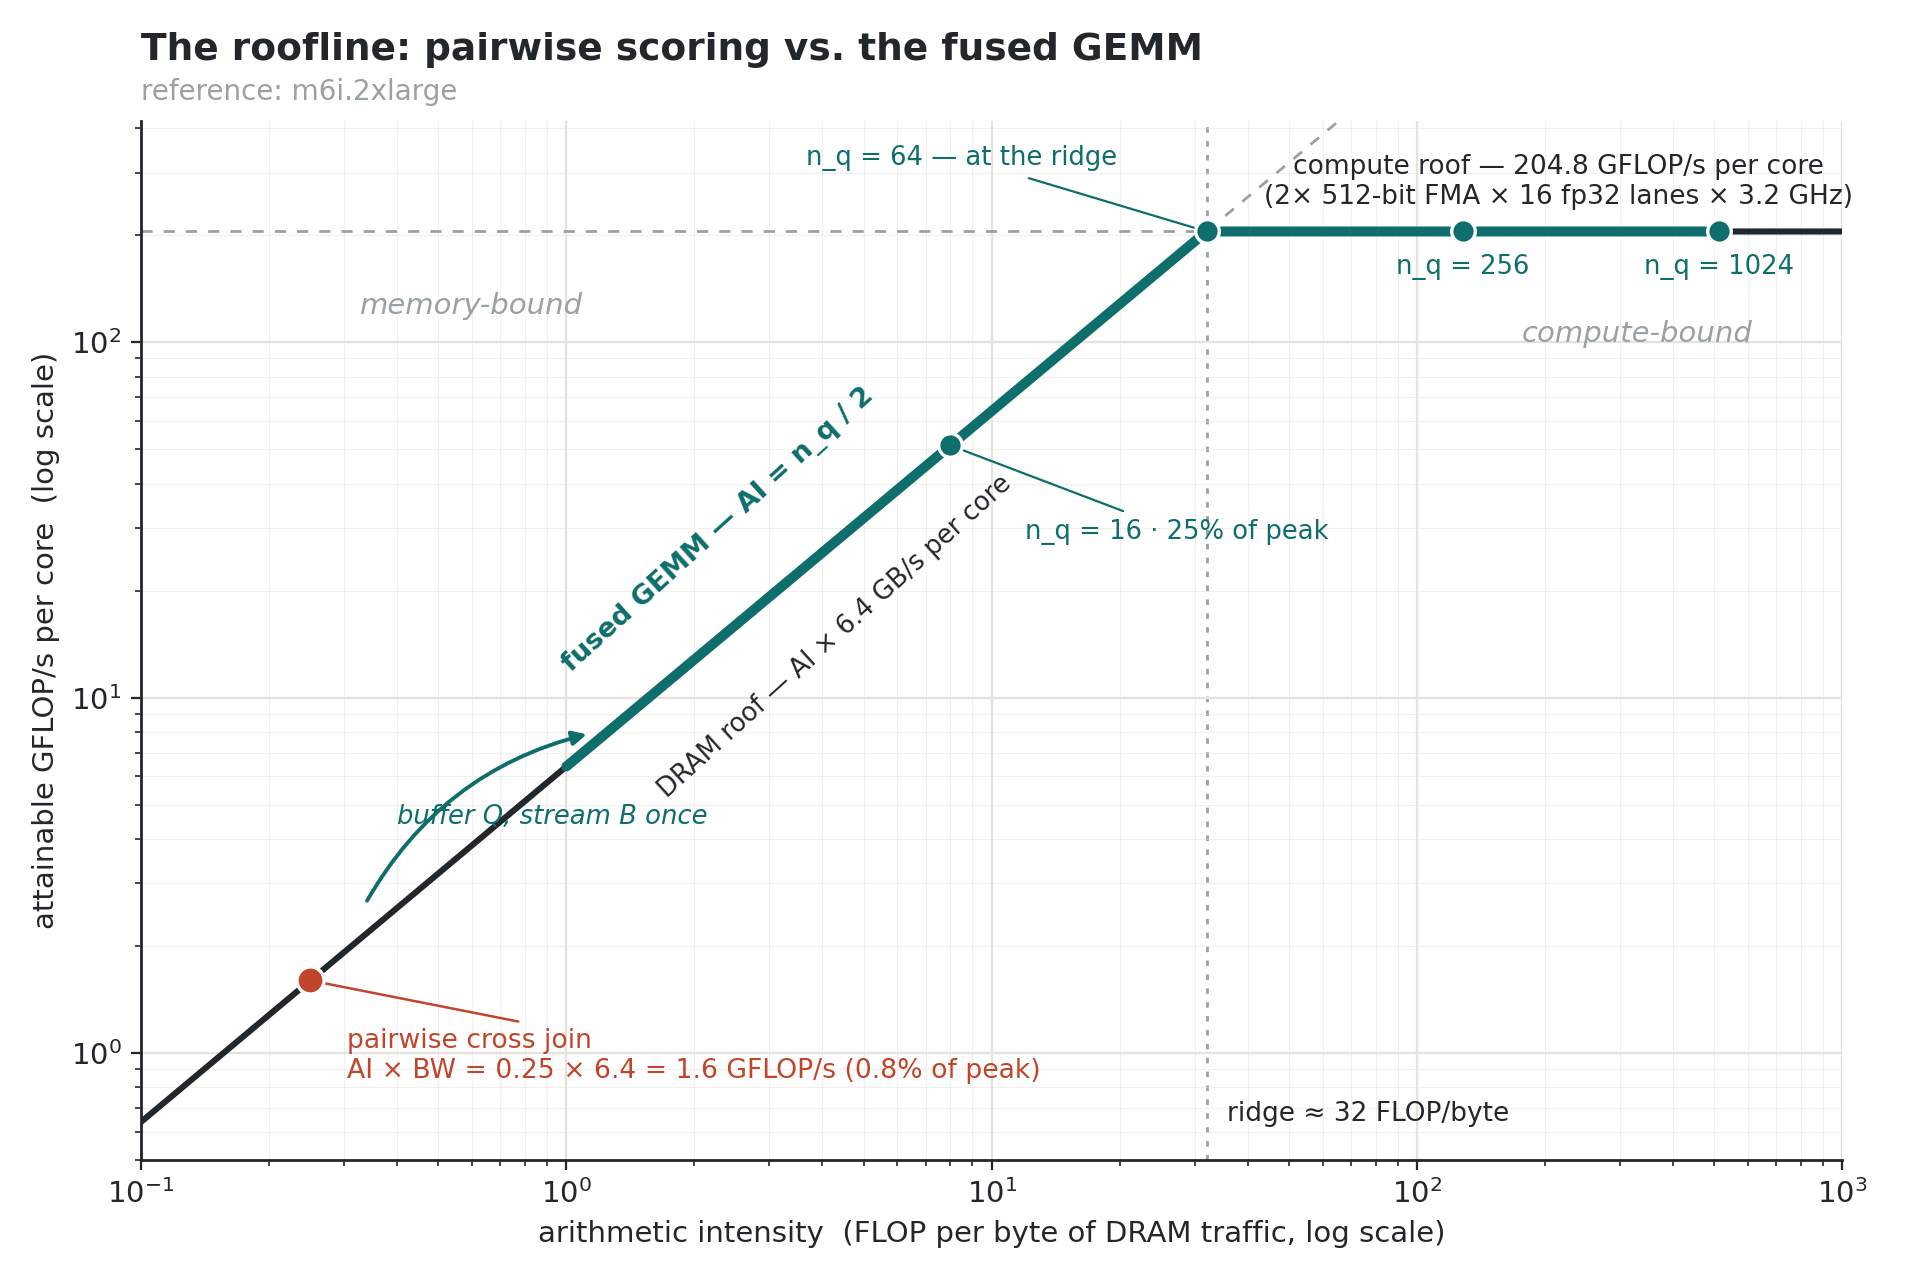
Die paarweise Bewertung ist bei 0,8 % des Spitzenwerts an die DRAM-Steigung gebunden, während die arithmetische Intensität des Fused-GEMM-Kernels mit der Batch-Größe wächst: 𝐴𝐼 = 𝑛𝑞/2. Dadurch kann sie den Knickpunkt bei 𝑛𝑞 = 64 überschreiten und bei größeren Batches die Rechengrenze voll ausnutzen. Die Vektorabstands- und Ähnlichkeitskernel sind für ihre Eingabeform nahezu optimal, aber die naive Planform bietet keine Datenwiederverwendung, die genutzt werden könnte, und Batching kann hierbei nicht helfen: Die Paar-Explosion multipliziert FLOPs und Bytes gleichermaßen. Die Lösung ist ein Fused-Operator-Plan, der es dem Kernel ermöglicht, die Datenwiederverwendung zu nutzen, woraufhin die arithmetische Intensität folgt.
Der Fused-Operator und GEMM-Kernel
Der Fused-Operator ist ein einzelner Photon-Ausführungsknoten, der den Cross Join, die Distanz-/Ähnlichkeitsprojektion und optional das partielle Top-K ersetzt. Er puffert die kleinere Eingabe, streamt die andere in Batches, bewertet Query-by-Base-Kacheln mit einem benutzerdefinierten GEMM-Kernel und verwaltet den Top-K-Status pro Abfrage über Kacheln hinweg, wenn k klein genug ist. Da Top-K integriert (fused) ist, besteht die Ausgabe aus höchstens 𝑛𝑞 × 𝑘 Kandidatenzeilen statt 𝑛𝑞 × 𝑛𝑏 Paaren, die vom nachgelagerten max_by / min_by Merge-Kernel verarbeitet werden. Der Spitzenspeicher pro Task entspricht der gepufferten Seite + einem In-Flight-Batch + 0(𝑛𝑞 × 𝑘) Selektionsstatus. Die Verteilung folgt den Standard-Join-Strategien — Broadcast der kleineren Seite, wenn sie passt, andernfalls Partitionierung beider Seiten und Ausführung von Block-Cartesian.
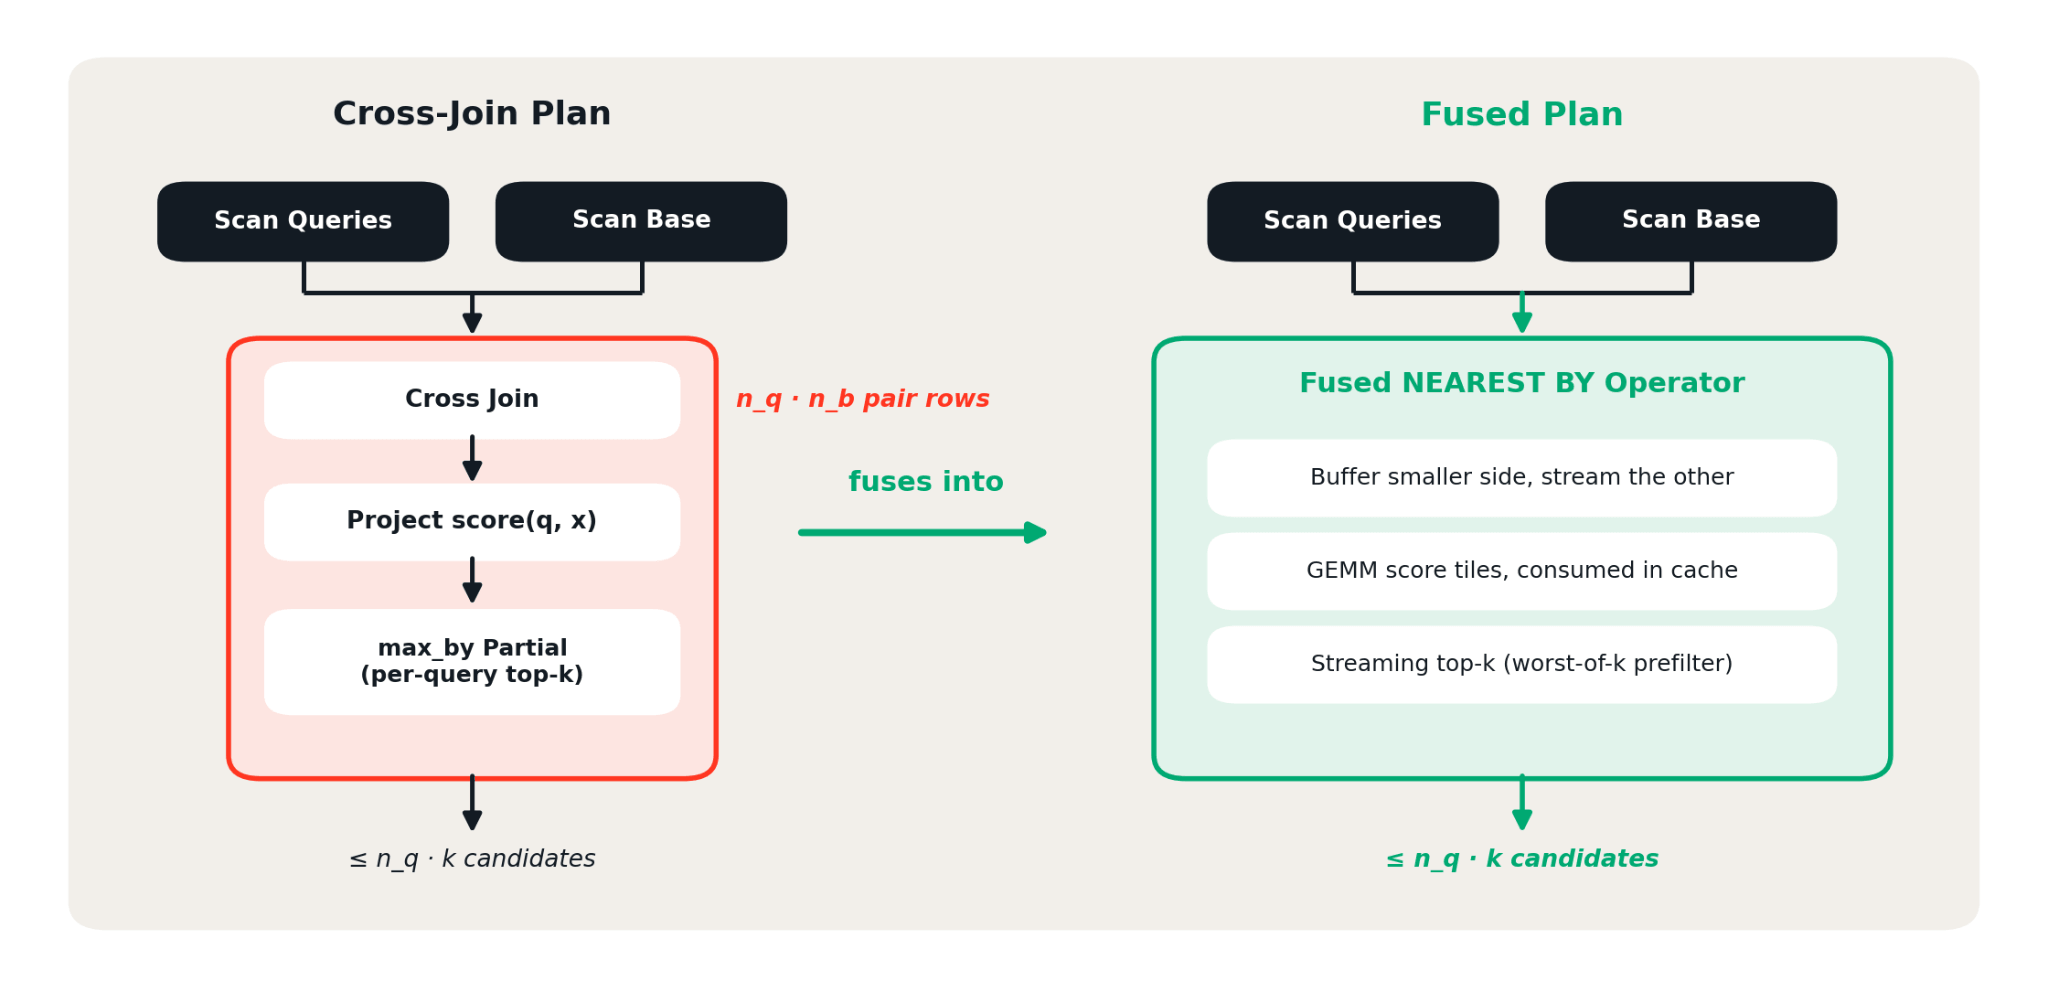
Wie im Roofline-Modell gezeigt, ändert die Fusionierung die im Speicher verschobenen Bytes, nicht die ausgeführten FLOPs. Jeder Basisvektor wird nach dem Laden mit allen gepufferten Abfragen abgeglichen, sodass die arithmetische Intensität linear mit dem Batch wächst und den Referenz-Ridge-Punkt bei 𝑛𝑞 = 64 kreuzt — weit unter den Batch-Größen typischer Produktions-Workloads. Dasselbe gilt, wenn die Basisseite kleiner ist: Die arithmetische Intensität skaliert mit der Seite, die resident bleibt.
Das Überschreiten des Ridge-Punkts ist notwendig, aber nicht ausreichend. Die Byte-Anzahl von 𝑛𝑞/2 ist das direkte Ergebnis des unten beschriebenen Blocked-GEMM-Kernels. Das Überwinden des DRAM-Limits verschiebt den Engpass lediglich nach unten, hin zur Cache-Bandbreite und dann zur FMA-Latenz.
Konkret ist der Kernel ein klassisches Blocked-GEMM über die Score-Matrix 𝐷 = 𝑄 · 𝐵𝑇. Die äußere Schleife bewegt sich jeweils um ein Panel von Vektoren über die Basis vorwärts und packt jedes Panel Dimension-Major für die Wiederverwendung über Abfragekacheln hinweg. Da die Embedding-Dimension selbst in Panels blockiert ist, gleicht die mittlere Schleife jede gepufferte Abfragekachel mit dem gepackten Panel ab, bevor das nächste abgerufen wird. Die innerste Schleife akkumuliert eine kleine Ausgabekachel in Registern über ein Dimensions-Panel hinweg; bei Embeddings, die breiter als ein einzelnes Panel sind, werden die laufenden Teilwerte im Score-Puffer zwischengespeichert und wieder eingelesen, um mit dem nächsten Panel fortzufahren. Jede fertige Kachel wird in einen begrenzten, wiederverwendeten Score-Puffer geschrieben, den das Streaming-Top-K direkt vor Ort (in place) konsumiert, sodass die vollständige 𝑛𝑞 × 𝑛𝑏 Score-Matrix niemals in den DRAM geschrieben wird.
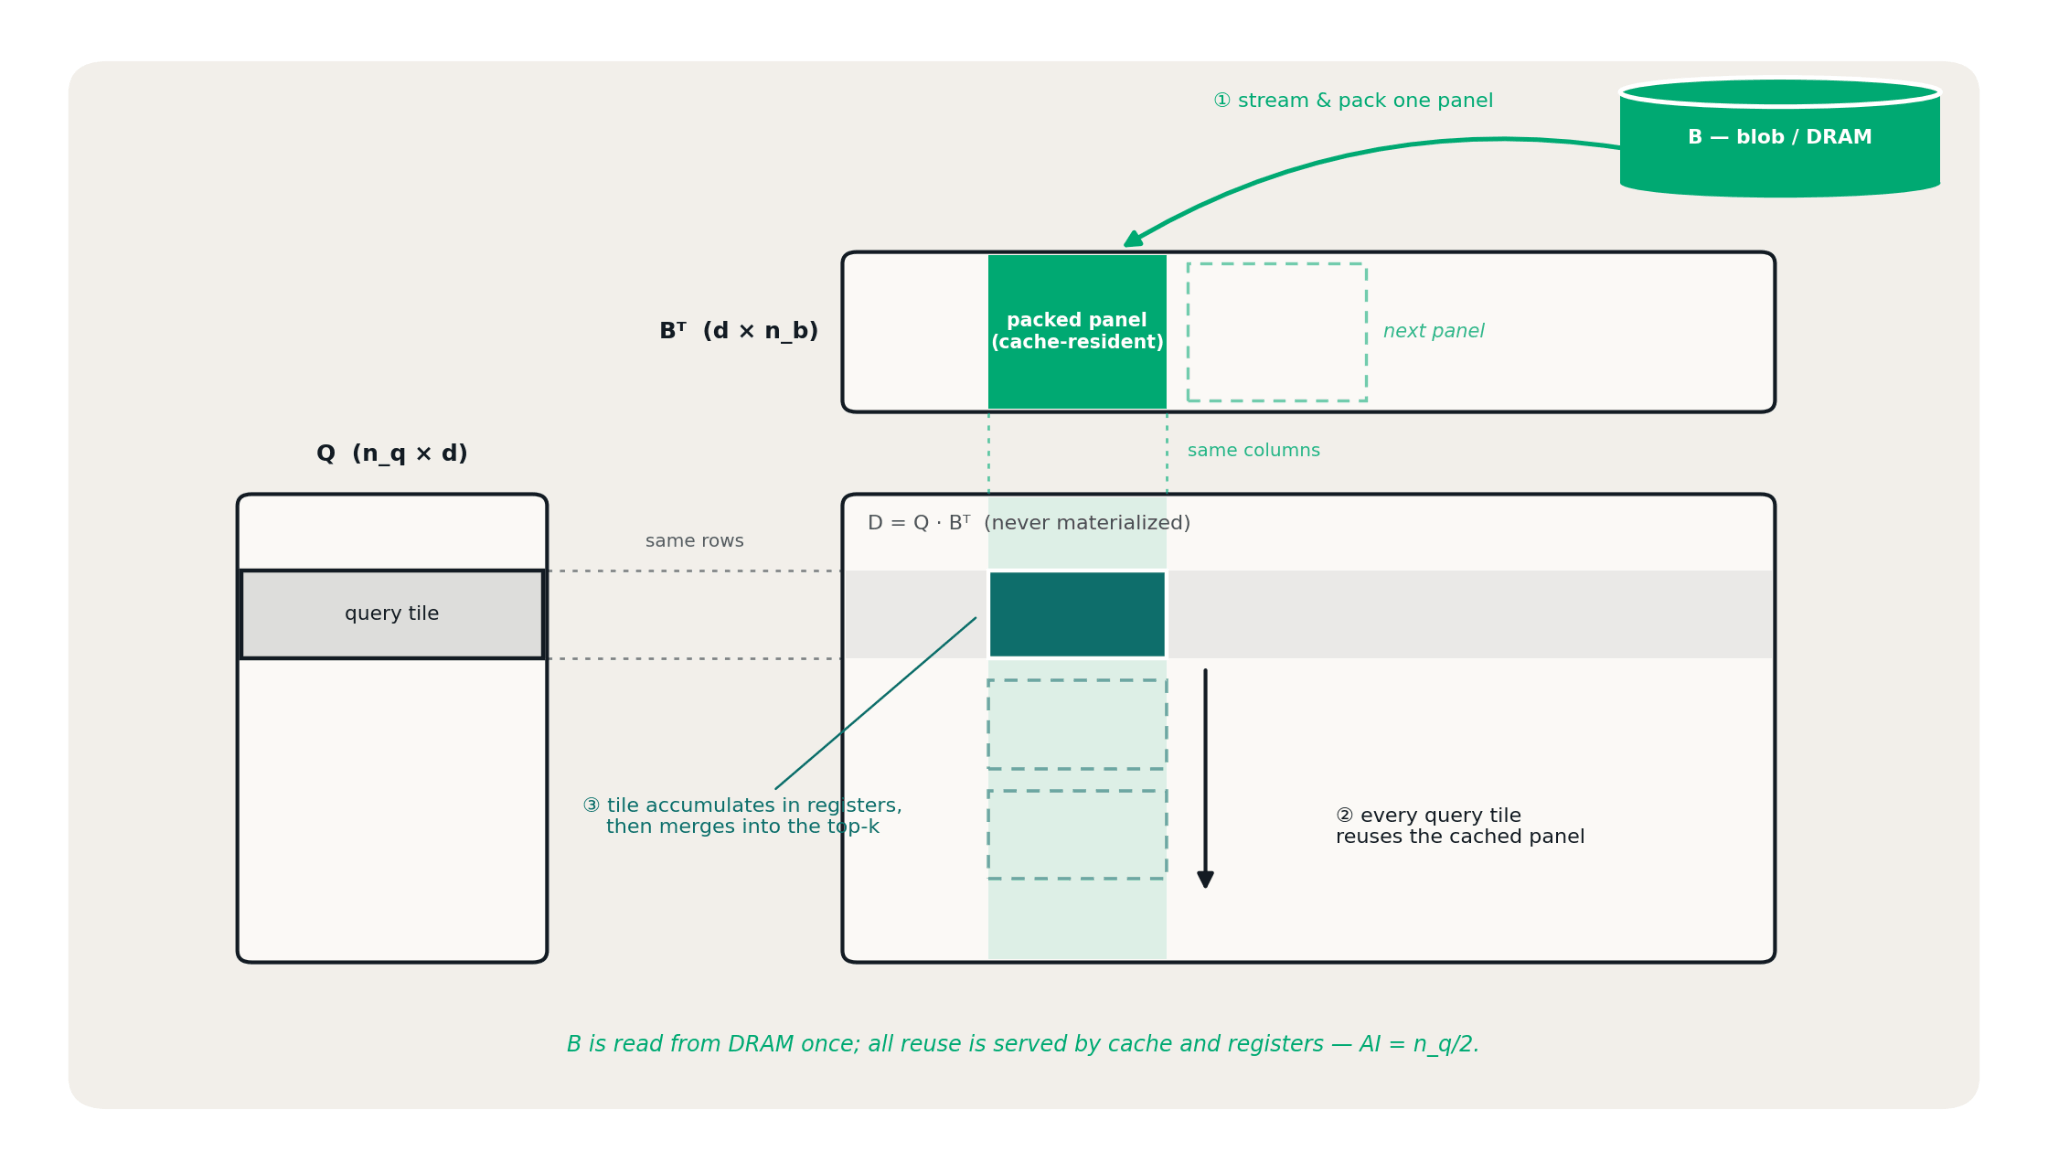
Es gibt zwei Ebenen des Blockings, um die Datenwiederverwendung zu verbessern. Gepackte Basis-Panels werden über Abfragekacheln hinweg wiederverwendet, um CPU-Cache-Hits zu begünstigen, während Register-Blocking dafür sorgt, dass jeder geladene Wert zu mehreren FMAs beiträgt. Jede Kachelgröße gleicht zwei konkurrierende Aspekte aus:
- Packed-Panel-Größe: Das Panel sollte klein genug sein, um problemlos in den Cache zu passen, aber groß genug, um den Overhead für das Speichern und Neuladen von Teilergebnissen zu begrenzen. Jede Grenze entlang der Embedding-Dimension erfordert einen Round-Trip durch den Score-Puffer. Größere Panels reduzieren diesen Datenverkehr, können jedoch die Cache-Misses erhöhen.
- Register-Kachelgröße: Die Akkumulatoren und Operanden sollten in die verfügbaren Vektorregister passen und gleichzeitig genügend unabhängige Akkumulationen bieten, um die FMA-Latenz zu überlappen. Größere Kacheln erhöhen die Datenwiederverwendung und ermöglichen mehr unabhängige Arbeitsschritte, erhöhen aber auch den Registerdruck und das Risiko von Spills in den Speicher.
Die meisten Produktions-Workloads laufen mit einem relativ kleinen k, daher haben wir das Streaming-Top-K für diesen Fall optimiert. Der Selektionsstatus pro Abfrage verbleibt im Fused-Operator, jede Score-Kachel wird noch im Cache mit den Selektionen zusammengeführt, und die vollständige 𝑛𝑞 × 𝑛𝑏 Matrix erreicht nie den DRAM. Sobald eine Abfrage k Einträge enthält, wird ihr schlechtester Score zum Zulassungsschwellenwert, sodass der Merge-Prozess mehrere Scores pro vektorisiertem Vergleich verwerfen kann. Nur die verbleibenden Zeilen werden für die Ausgabe erfasst. Wenn k so groß ist, dass dieser Status zu Speicherengpässen führt, führt der Operator das Blocked-GEMM alleine aus und übergibt die bewerteten Kacheln an das bestehende partielle max_by / min_by. Bei diesem Fallback kostet die Ausgabe eines 𝑓𝑝32-Scores pro Paar 4 Bytes gegenüber 2𝑑 FLOPs, sodass 𝐴𝐼 = 𝑑/2 gilt — immer noch weit über dem Ridge-Punkt für jede realistische Dimension.
Der Vektorindex
Alles bisherige beschleunigt die exhaustive KNN-Suche (K-Nearest-Neighbor); nichts davon ändert etwas daran, dass die exhaustive Suche 0(𝑛𝑞 × 𝑛𝑏) ist — eine Million Abfragen gegen eine Milliarde Zeilen ergibt 1015 Skalarprodukte, und keine Register-Kachel kann einen Exponenten wegamortisieren. Genau dafür sind APPROX und der Vektorindex da.
Der Index basiert auf einem klassischen IVF-Design (Inverted File). Die Indexierung trainiert K-Means über eine Stichprobe des Korpus, um eine Reihe von Zentroiden zu erzeugen. Jede Basiszeile wird ihrem nächstgelegenen Zentroiden zugewiesen, und zur Abfragezeit bewertet jede Abfrage nur die Vektoren in ihren nächstgelegenen Clustern. Das Pruning potenziert sich mit 𝑛𝑏: Bei Milliarden-Skalierung prüft eine Abfrage ≤ 0,1 % des Korpus, was um Größenordnungen weniger Distanzberechnungen bedeutet als bei Brute-Force. Wir haben uns für IVF anstelle von Graph-Indizes entschieden, da unabhängige Cluster-Scans über Executors hinweg parallelisiert werden können und das Layout von Natur aus in spaltenbasierter Speicherung vorliegt, während die Graph-Traversierung eine Kette serieller Abfragen ist.
Physisch ist der Index eine gewöhnliche Delta-Tabelle. Zuweisungszeilen enthalten den Vektor neben seiner Zentroid-ID, und die Tabelle ist per Liquid Clustering nach Zentroid-ID geclustert. Die Kandidaten jedes Clusters liegen zusammenhängend im Blob-Speicher, und Dateien, deren Cluster von keiner Abfrage geprüft wurden, werden vor dem Lesen per Pruning ausgeschlossen. Die Aktualisierung erfolgt transaktional und inkrementell.
Eine APPROX-Abfrage wird auf dieselben Primitive umgeschrieben: Prüfen der Zentroide mit demselben Top-K-NEAREST BY-Join, Equi-Join auf der Zentroid-ID, um jede Abfrage auf ihre geprüften Cluster zu beschränken, Bewertung und Top-K, dann Zusammenführung. Dateien, die seit der letzten Aktualisierung hinzugefügt wurden, werden in einem Kompensationszweig per Brute-Force verarbeitet und in denselben Merge zusammengeführt, sodass ein veralteter Index zwar weniger Pruning durchführt, aber niemals die Suchqualität beeinträchtigt.
Die Abfrageausführung wird durch die Kardinalitäten von Abfrage und Basis bestimmt.
| Szenario | Join-Strategie | Hauptmerkmale |
|---|---|---|
| Kleine Index-Tabelle, kleine Abfrage-Tabelle | BNLJ, Broadcast-Index | Alles im Speicher |
| Kleine Index-Tabelle, große Abfrage-Tabelle | BNLJ, Broadcast-Index | Abfragen bleiben partitioniert und werden gestreamt, Broadcast des Index an alle |
| Große Index-Tabelle, kleine Abfrage-Tabelle | BNLJ, Broadcast-Abfragen | Indexpartitionen werden gestreamt, Broadcast der geprüften Abfragen |
| Große Index-Tabelle, große Abfrage-Tabelle | Equi-Join nach Zentroid-ID, mit In-Place-Shuffle für den Index | Shuffle der geprüften Abfragen nach Zentroid-ID; Nutzung des Liquid Clustering des Index, um einen vollständigen Shuffle des Index zu vermeiden |
Der Fall „groß–groß“ ist der, bei dem sich Liquid Clustering am meisten auszahlt: Nur die Abfrageseite bewegt sich; jede geprüfte Abfrage wird in die Partitionen ihrer Cluster geshuffelt, während die Indexseite direkt Dateien nach den passenden Zentroid-IDs scannt.
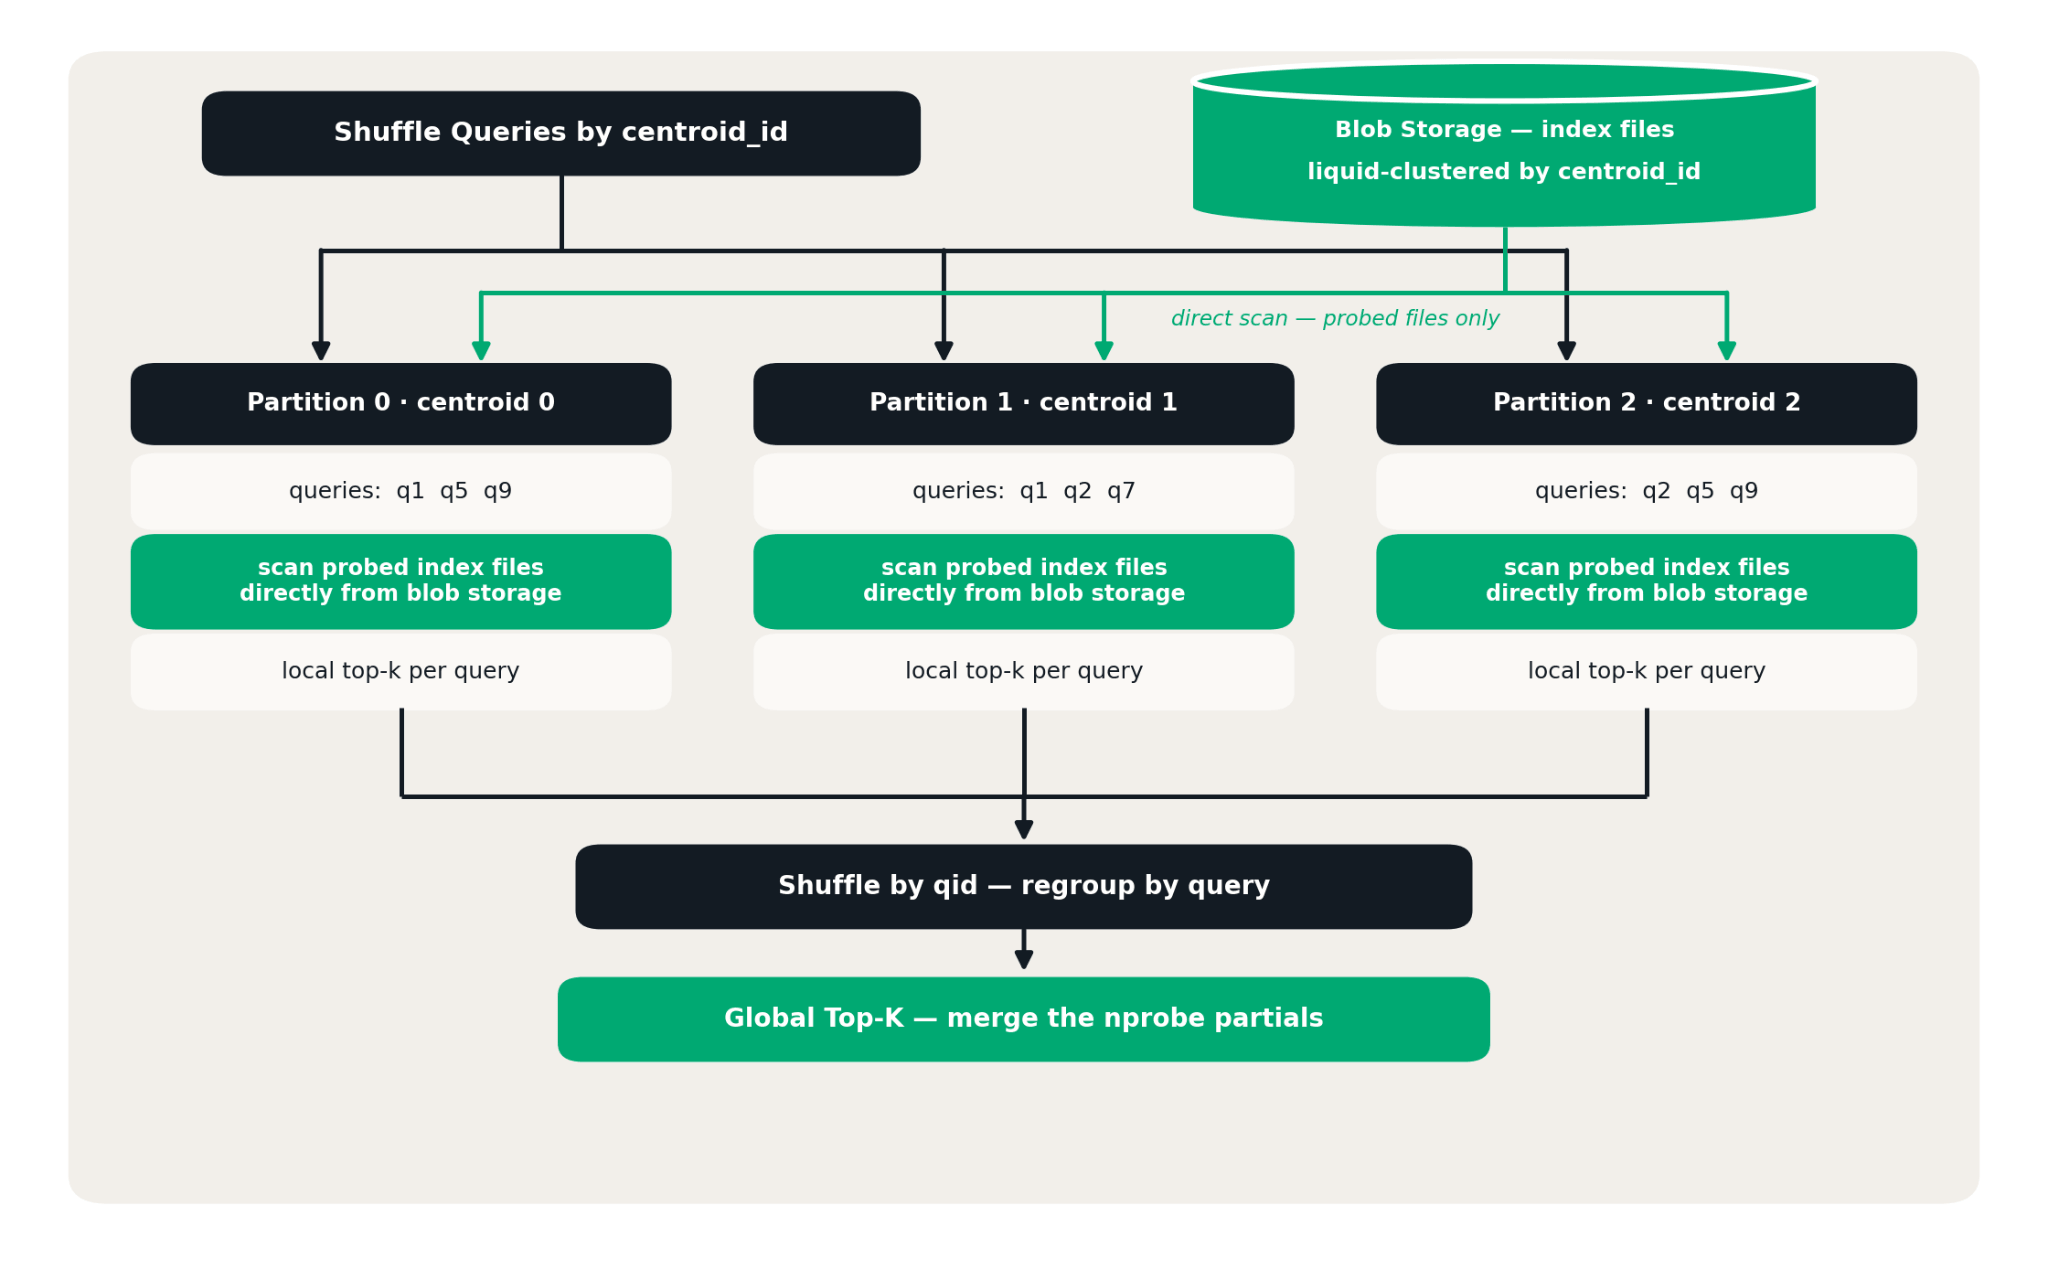
Innerhalb einer Partition kommen die Kandidaten jedes Clusters als dichter, zusammenhängender Block an, sodass derselbe GEMM-Kernel angewendet werden kann. Der exakte Pfad führt ihn einmal global aus; der approximative Pfad führt ihn einmal pro Cluster aus. Lokales Top-K pro Abfrage, Neugruppierung, Zusammenführung der Teilwerte: Der Partial/Merge-Contract des Aggregats tut genau das, wofür er entwickelt wurde.
Das Ergebnis
Wir haben NEAREST BY anhand typischer, bei Kunden beobachteter Workloads evaluiert, mit Basistabellen von 100.000 bis 5 Milliarden Vektoren und Abfrage-Batches von bis zu 10 Millionen Vektoren, mit dem Ziel einer Trefferquote (Recall@K) von mindestens 96 %. Unter Verwendung von indexiertem ANN:
- Semantische Deduplizierung: Ein Self-Join einer Tabelle mit 10 Millionen Datensätzen war in wenigen Minuten abgeschlossen und lieferte Kandidatentreffer für die Duplikaterkennung.
- Klassifizierung und Tagging: Die Suche von 10 Millionen Abfragen in 100.000 Referenzvektoren dauerte weniger als eine Minute und unterstützte die Klassifizierung durch ähnliche gelabelte Beispiele.
- Aktualisierung von Empfehlungen: Ein Batch von 1 Million Abfragen gegen 10 Millionen Katalogvektoren generierte Empfehlungskandidaten in wenigen Minuten.
- Entitätsauflösung und -anreicherung: Die Suche von 1 Million Abfragen in 1 Milliarde Referenzvektoren war in wenigen Minuten abgeschlossen und lieferte Kandidatentreffer für die Verknüpfung von Datensätzen und den Abruf von zusätzlichem Kontext.
Fazit
Die Batch-Vektorsuche benötigte kein neues System – sie musste zu einem First-Class-Citizen des Systems werden, das die Daten bereits verwaltet. NEAREST BY drückt den Workload als das aus, was er strukturell ist: ein Top-k-Ranking-Join. Das Roofline-Modell erklärt, warum der naive Plan speichergebunden ist und was ein schnellerer Kernel dagegen tun muss. Der fusionierte Operator und sein blockiertes GEMM verwandeln diese Analyse in arithmetische Intensität, und der Vektorindex skaliert dies weiter, während er eine gewöhnliche Delta-Tabelle mit Liquid Clustering bleibt. Die neuen Mechanismen sind bewusst einfach, schlank, aber tiefgehend und effektiv gestaltet: eine Join-Klausel, sieben Vektorfunktionen, eine Aggregat-Überladung, ein fusionierter Operator und eine Entscheidung über das Speicherlayout. Alles andere, von Shuffles und Spills bis hin zu Governance und Autoscaling, wird von der Runtime-Engine bereitgestellt, die über mehr als ein Jahrzehnt hinweg entwickelt und gehärtet wurde.
Wenn Sie die Entwicklung komplexer Computersysteme für große KI/ML-Workloads bei Databricks spannend finden, entwickeln Sie gemeinsam mit uns!
Jetzt herunterladen NEAREST BY ausprobieren – Dokumentation lesen
(Dieser Blogbeitrag wurde mit KI-gestützten Tools übersetzt.) Originalbeitrag
Erhalten Sie die neuesten Beiträge in Ihrem Posteingang
Abonnieren Sie unseren Blog und erhalten Sie die neuesten Beiträge direkt in Ihren Posteingang.