PostgreSQL 19 ist auf Lakebase verfügbar
Probier die neuen Funktionen aus: REPACK, Abfrageplan-Empfehlungen, WAIT FOR LSN und mehr
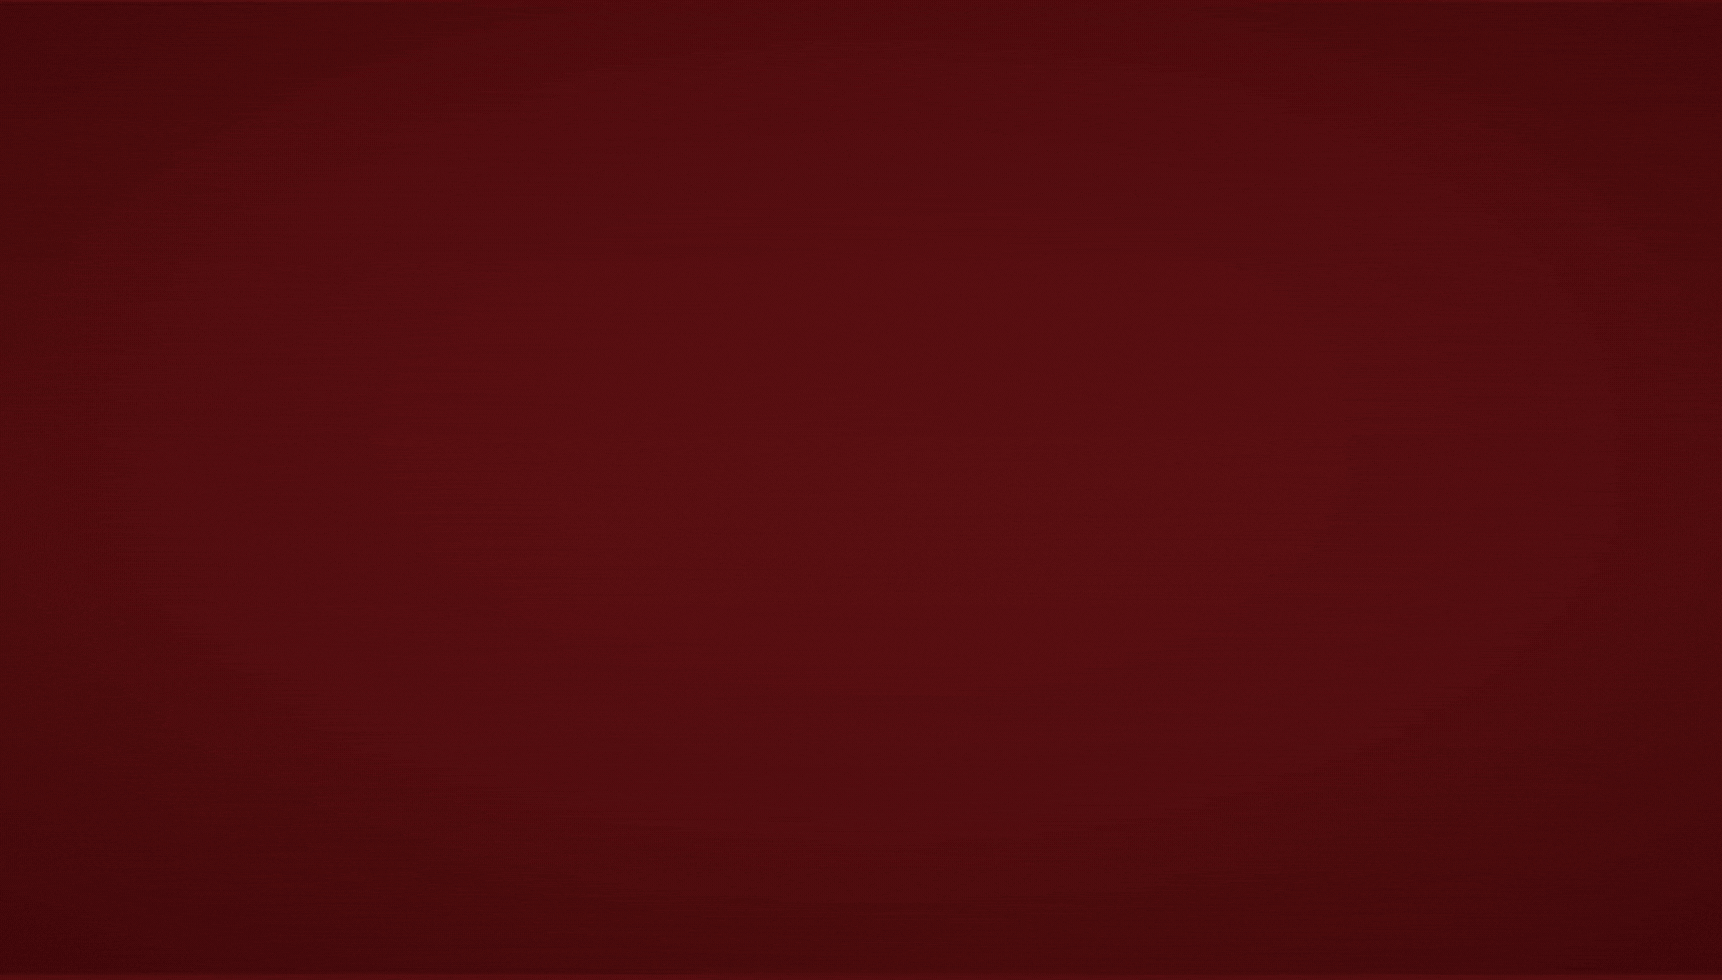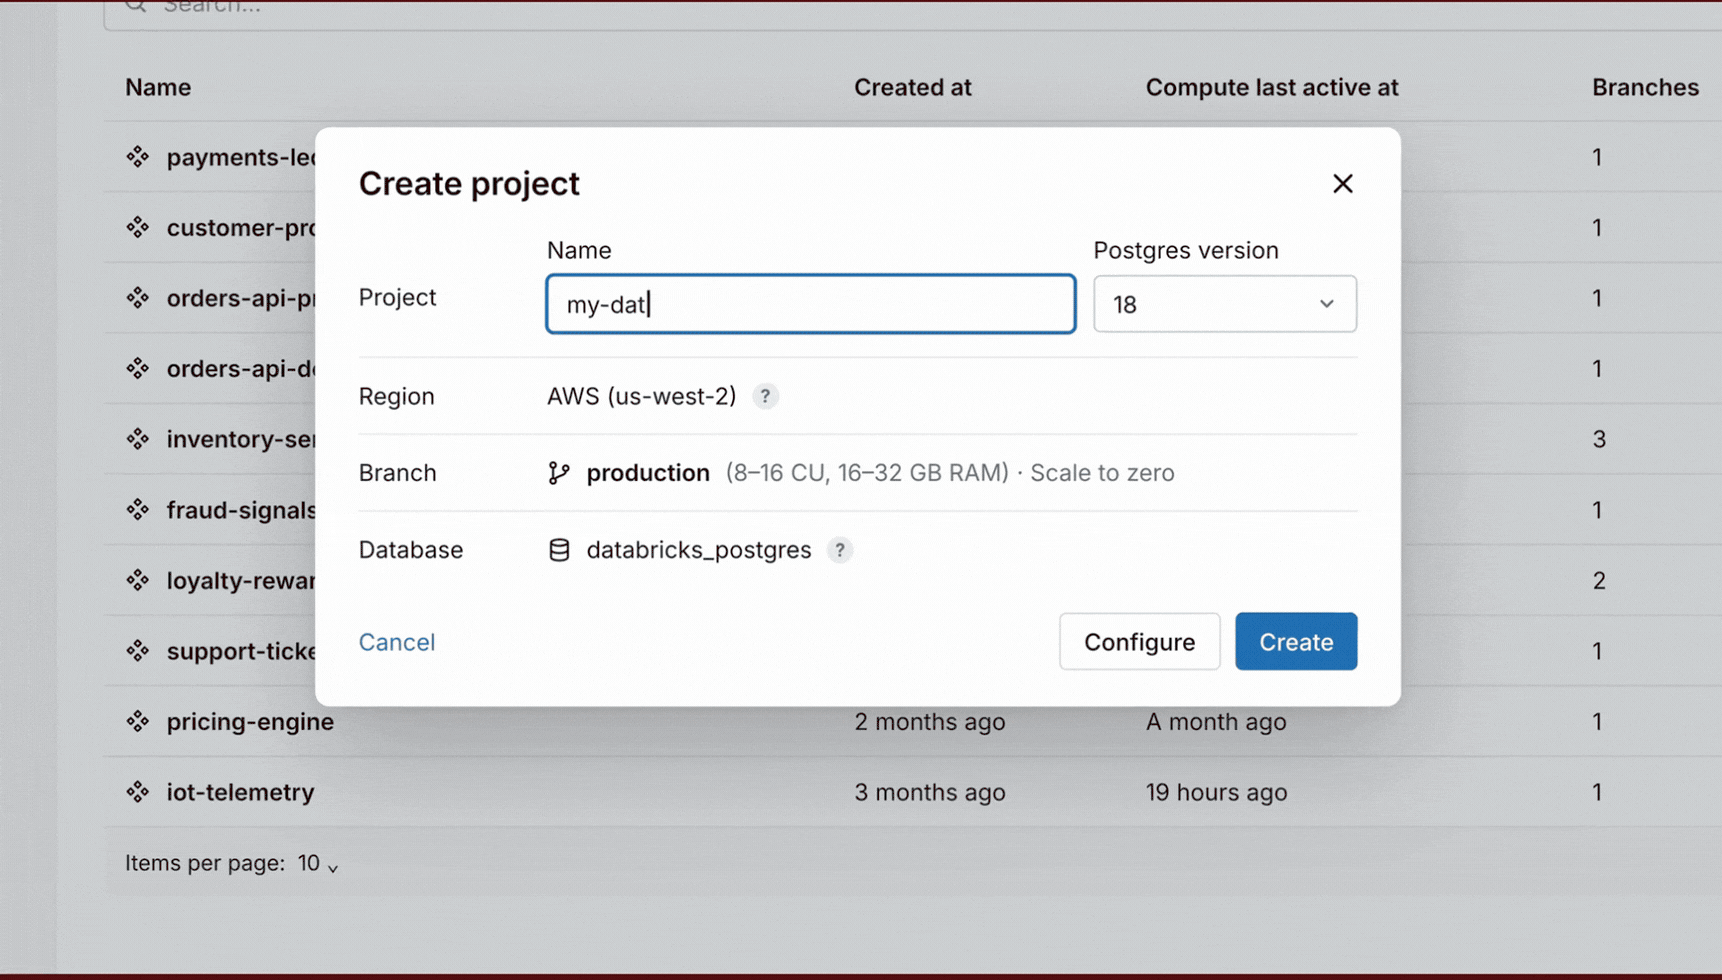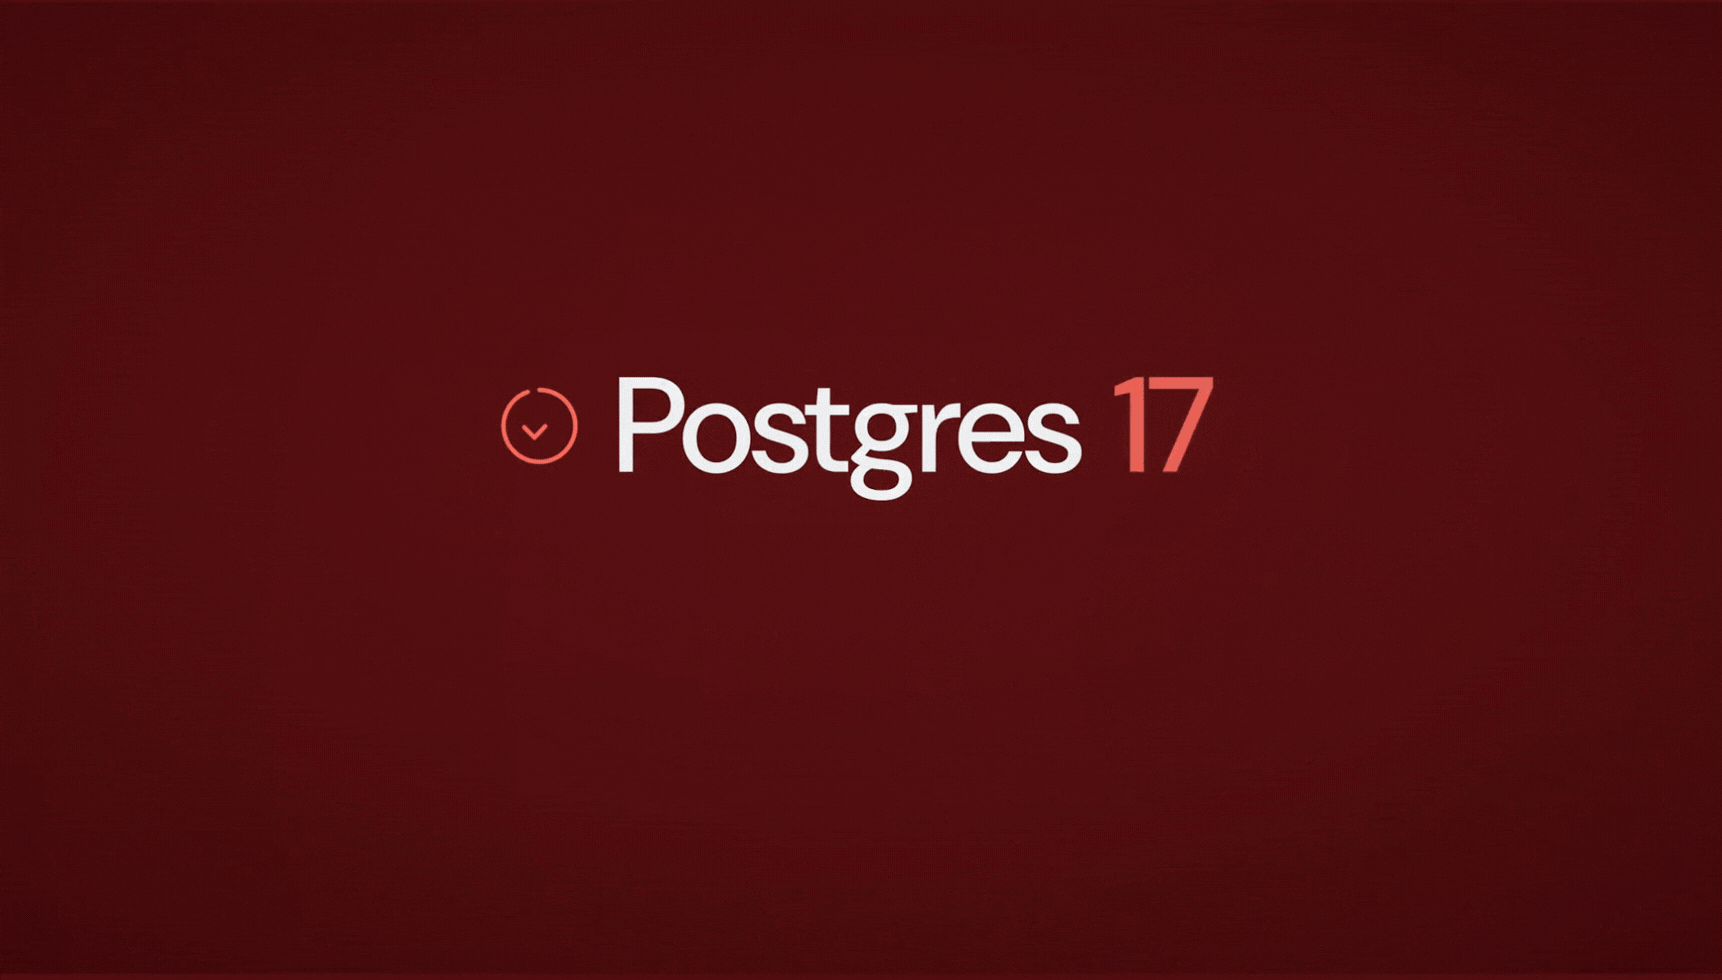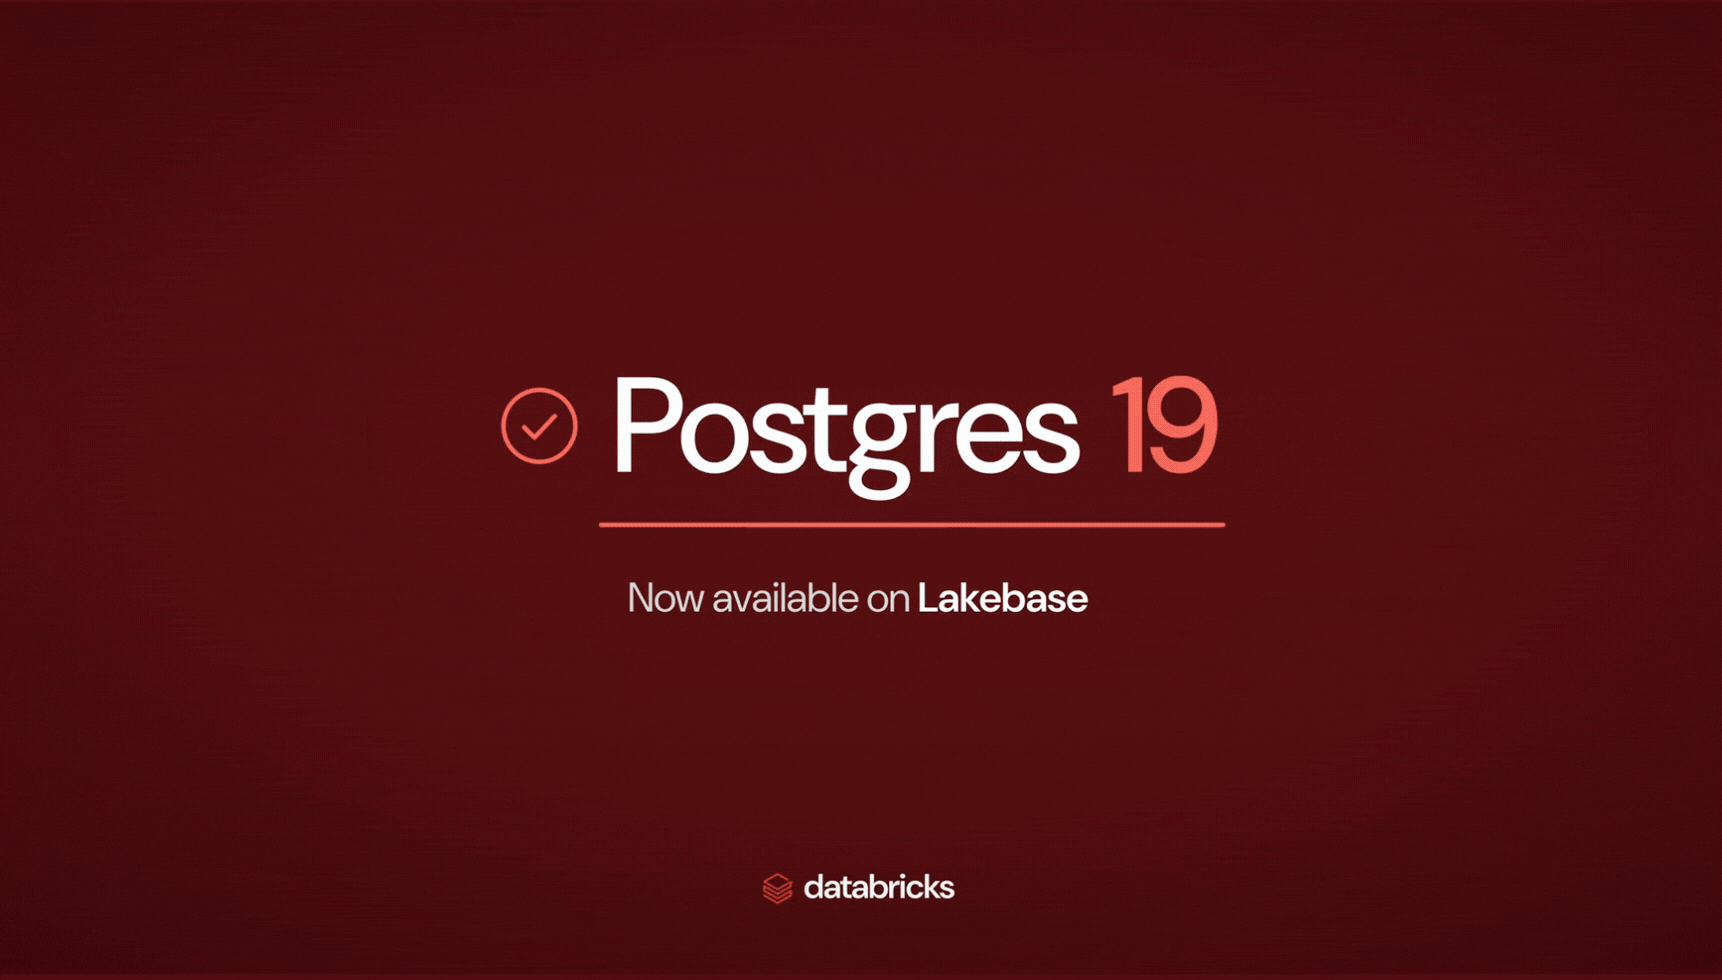
- PostgreSQL 19 ist auf Lakebase am selben Tag verfügbar, an dem es von der Community veröffentlicht wurde. Erstelle einfach ein neues Lakebase-Projekt und wähle PostgreSQL 19 aus, um es auszuprobieren.
- Diese PostgreSQL-Version konzentriert sich auf betriebliche Steuerung. REPACK gibt Speicherplatz frei, während Lese- und Schreibvorgänge weiterlaufen, Abfrageplan-Empfehlungen helfen dir dabei, fehlerhafte Pläne zu stabilisieren, und WAIT FOR LSN ermöglicht dir Read-Your-Writes auf Replikas. Auch die logische Replikation erhält einige Verbesserungen.
- Mehrere Lakebase-Entwickler sind PostgreSQL-Committers und -Contributors, die an dieser Version mitgewirkt haben – von Abfrageplan-Empfehlungen bis hin zu Shared Memory und Release Management.
PostgreSQL 19 ist ab heute GA und bereits auf Lakebase verfügbar. Neue Hauptversionen brauchen oft Wochen, um andere verwaltete PostgreSQL-Dienste zu erreichen. Stattdessen wollten wir unseren Kunden den Zugriff noch am selben Tag ermöglichen.
Mehrere Ingenieure im Lakebase-Team sind PostgreSQL-Committer und -Contributor und haben direkt an diesem Release mitgearbeitet, von Abfrageplan-Ratschlägen bis hin zum Shared Memory, der Gebietsschema-Handhabung und dem Release-Management. Zum Ausprobieren erstellen Sie ein neues Lakebase-Projekt und wählen Sie PostgreSQL 19 als Version aus.
Was ist neu in PostgreSQL 19
PostgreSQL 19 ist ein praxisorientiertes Release. Es gibt keine einzelne herausragende Funktion, die das Wesen von PostgreSQL verändert. Stattdessen widmet sich Version 19 operationalen Problemen, die Datenbankteams bestens kennen: aufgeblähte Tabellen, instabile Abfragepläne, Replikationsverzögerungen, unvollständige Statistiken und Wartungsarbeiten, die in der Produktion nur schwer sicher durchzuführen sind.
Der rote Faden ist die Kontrolle. PostgreSQL 19 bietet Ihnen mehr Möglichkeiten, einzugreifen, wenn die Standardeinstellungen nicht ausreichen, ohne dabei die Ausrichtung des Projekts auf Zuverlässigkeit und vorhersehbares Verhalten aufzugeben.
Die vollständige Liste der Änderungen finden Sie in den Release-Hinweisen zu PostgreSQL 19.
REPACK
PostgreSQL verwendet Multiversion Concurrency Control, sodass ein UPDATE eine neue Zeilenversion erstellt und ein DELETE ein verwaistes Tupel zurücklässt. Routinemäßiges Bereinigen macht diesen Speicher wieder nutzbar, gibt den Speicher jedoch nicht unbedingt an das Betriebssystem zurück oder stellt eine sinnvolle physische Zeilenreihenfolge wieder her. Mit der Zeit können stark aktualisierte Tabellen aufgebläht und schlecht geclustert werden.
Die üblichen Korrekturen waren VACUUM FULL, CLUSTER oder externe Tools wie pg_repack. Die integrierten Befehle funktionieren, beanspruchen jedoch eine ACCESS EXCLUSIVE-Sperre für den gesamten Vorgang, wodurch der normale Zugriff auf die Tabelle blockiert wird.
PostgreSQL 19 fügt REPACK hinzu, wodurch Speicher freigegeben wird, während normale Lese- und Schreibvorgänge während des Großteils des Betriebs fortgesetzt werden. Beispielsweise kann eine Chat-Anwendung ihre messages-Tabelle neu aufbauen und gleichzeitig Zeilen nach Konversation und Sendezeit mithilfe eines vorhandenen Index clustern:
REPACK gibt Speicher frei wie VACUUM FULL; mit USING INDEX ordnet es Zeilen zudem physisch an wie CLUSTER. Mit CONCURRENTLY baut PostgreSQL die Tabelle neu auf, während normale Lese- und Schreibvorgänge fortgesetzt werden, wobei laufende Änderungen durch logische Dekodierung erfasst werden. Anschließend wird eine ACCESS EXCLUSIVE-Sperre angefordert, um verbleibende erfasste Änderungen anzuwenden und die neue Tabellen- und Indexdatei auszutauschen. Diese Phase ist in der Regel kurz, kann jedoch bei einer stark ausgelasteten Tabelle länger dauern.
Es gibt betriebliche Einschränkungen. Das gleichzeitige Umpacken erstellt für die Dauer des Vorgangs einen zusätzlichen Replikationsslot, sodass freie Kapazitäten unter max_repack_replication_slots und eine Tabelle mit entweder einem nicht verschiebbaren Primärschlüssel oder einer geeigneten indexbasierten Replikidentität erforderlich sind. Zudem wird temporärer Speicherplatz für eine Kopie der Tabelle und aller ihrer Indizes sowie möglicherweise eine Sortierdatei in der Größe der Tabelle benötigt. Tabellen mit hohem Aktualisierungs- und Löschaufkommen unterliegen einer zusätzlichen Grenze: Die aktuelle Upstream-Implementierung von PostgreSQL 19 schlägt fehl, wenn mehr als etwa 104 Millionen Tupel in der Zieltabelle aktualisiert oder gelöscht werden, während REPACK (CONCURRENTLY) ausgeführt wird. Dies zählt Änderungen, die während des Umpackens vorgenommen wurden, nicht bereits in der Tabelle vorhandene Zeilen.
Nicht jeder Relationstyp ist zulässig. Lange laufende Transaktionen können die finale Sperre verzögern. Das gleichzeitige Umpacken ist zudem nicht MVCC-sicher: Nach dem Commit können Transaktionen, die Snapshots verwenden, die vor dem Beginn des Umpackens erstellt wurden, die Tabelle als leer betrachten. Das physische Clustering verschlechtert sich zudem, wenn spätere Schreibvorgänge eintreffen.
REPACK CONCURRENTLY erfordert weiterhin Planung, bringt jedoch eine Aufgabe in den Kern, die zuvor mehr Ausfallzeit oder eine Erweiterung erforderte.
Abfrageplan-Ratschläge
Der kostenbasierte Optimierer von PostgreSQL verwendet Tabellenstatistiken und Kostenschätzungen, um einen Ausführungsplan auszuwählen. Meistens funktioniert das gut.
Statistiken beschreiben einzelne Tabellen gut, aber reale Datensätze enthalten oft Beziehungen, die schwieriger zu erfassen sind. Stellen Sie sich vor, Unternehmenskunden machen 0,1 % der Kunden aus, generieren aber 30 % der Bestellungen. Tabellenspezifische Statistiken können diese tabellenübergreifende Korrelation nicht erfassen.
Mit einem Index auf orders.customer_id, schätzt der Planer möglicherweise, dass jeder Unternehmenskunde nur wenige Bestellungen hat, und wählt eine Nested Loop, die den Index wiederholt abfragt. Wenn diese Kunden tatsächlich für 30 % der Bestellungen verantwortlich sind, gibt jede Suche viel mehr Zeilen als erwartet zurück, und ein Hash-Join ist möglicherweise geeigneter.
PostgreSQL 19 fügt pg_plan_advice und pg_stash_advice für diese Situationen hinzu:
pg_plan_advicebeschreibt Planerentscheidungen als Ratschlag, wendet bereitgestellte Ratschläge an und meldet, ob sie befolgt wurden.pg_stash_advicespeichert Ratschläge nach Abfrage-ID und wendet sie automatisch an, wenn eine passende Abfrage geplant wird.
Diese Komponenten fügen keine tabellenübergreifenden Statistiken hinzu und ersetzen nicht den Planer. Stattdessen ermöglichen sie Ihnen ein Eingreifen, wenn eine ungenaue Schätzung zu einem schlechten Plan führt.
Betrachten Sie eine Abfrage, die Bestellungen von Unternehmenskunden zählt:
Hier ist c der Alias für die gefilterte Kundentabelle. Der folgende Ratschlag weist PostgreSQL an, diese Kunden auf der Innenseite eines Hash-Joins zu platzieren:
Wenn PostgreSQL den Ratschlag anwenden kann, EXPLAIN gibt Feedback ähnlich dem Folgenden aus:
matched bedeutet, dass der resultierende Plan dem Ratschlag entspricht. Das bedeutet nicht zwangsläufig, dass der neue Plan besser ist; Sie müssen ihn dennoch anhand der tatsächlichen Workload bewerten.
Im Gegensatz zu Inline-Optimierer-Hinweisen befinden sich Plan-Ratschläge außerhalb des Abfragetextes der Anwendung. Sie können den aktuellen Plan überprüfen, zielgerichtete Ratschläge testen und diese dann nach Abfrage-ID speichern.
pg_stash_advice ist die Komponente, die gespeicherte Ratschläge automatisch anwendet. Erstellen Sie die Erweiterung in jeder Datenbank, bevor Sie deren Funktionen zur Speicherverwaltung verwenden:
Erstellen Sie einen Speicher und verknüpfen Sie den getesteten Ratschlag mit der von EXPLAIN (VERBOSE) gemeldeten Abfrage-ID. Ersetzen Sie <query_id> durch die Kennung aus Ihrem Plan:
Konfigurieren Sie die Datenbank so, dass sie den Speicher für neue Verbindungen verwendet:
Ersetzen Sie appdb durch den Namen Ihrer Datenbank.
Betrachten Sie Plan-Ratschläge als Stabilisator, sobald Sie das Problem diagnostiziert haben. Datenverteilungen ändern sich, zwischengespeicherte vorbereitete Anweisungen verwenden möglicherweise noch eine Weile einen älteren Plan, und der Optimierer hat nach wie vor öfter Recht als Unrecht.
Wenn der Planer unerwartet eine wichtige Abfrage auf einen schlechteren Plan umstellt, bietet PostgreSQL 19 Ihnen eine unterstützte Möglichkeit zur Stabilisierung.
Paralleler Autovacuum und neue Statistik-Ansichten
Autovacuum kann jetzt beim Bereinigen von Indizes parallele Worker verwenden, was durch autovacuum_max_parallel_workers gesteuert wird. Ein neues Bewertungssystem priorisiert geeignete Tabellen basierend darauf, wie dringend sie bereinigt oder analysiert werden müssen.
Neue Statistik-Ansichten zeigen mehr davon, was der Server gerade tut:
pg_stat_lockmeldet Statistiken nach Sperrtyp.pg_stat_recoveryzeigt den Wiederherstellungsstatus.pg_stat_autovacuum_scoreszeigt, wie Autovacuum Tabellen priorisiert.
Auch die Diagnose auf Abfrageebene wird verbessert. EXPLAIN (ANALYZE, IO) meldet asynchrone E/A-Aktivitäten, und auto_explain.log_io kann dieselben Informationen in protokollierten Plänen enthalten.
PostgreSQL 19 meldet außerdem geschriebene Bytes für ganzseitige Bilder in pg_stat_wal, EXPLAIN (ANALYZE, WAL) sowie in Vakuum- und Analyse-Protokollen.
Zusammen machen diese Verbesserungen Leistungsuntersuchungen unabhängiger von Annahmen. Sie können sehen, warum Wartungsarbeiten priorisiert wurden, wo asynchrone E/A stattgefunden hat und wie viele WAL-Bytes von ganzseitigen Bildern stammten.
Logische Replikation
Die logische Replikation ist zu einer Kerninfrastruktur für Change Data Capture, Migrationen, Echtzeit-Bereitstellung und ETL-Pipelines geworden. PostgreSQL 19 schließt mehrere langjährige Lücken:
- Die logische Dekodierung kann ohne Neustart aktiviert werden, wenn
wal_levelaufreplicasteht. Das Erstellen des ersten gültigen logischen Replikationsslots erhöhteffective_wal_levelauflogical, wodurch das aktuell aktive WAL-Level angezeigt wird. - Sequenzwerte können von Publishern zu Subscribern synchronisiert werden.
- Publikationen können alle Sequenzen mit
FOR ALL SEQUENCESenthalten. CREATE PUBLICATION ... FOR ALL TABLES EXCEPT (...)veröffentlicht alle Tabellen mit Ausnahme einer benannten Menge.- Abonnements können Verbindungsdetails von einem
postgres_fdwServer mitCREATE SUBSCRIPTION ... SERVERwiederverwenden. - Die
retain_dead_tuplesAbonnementoption bewahrt genügend Informationen auf, umdetect update_deletedKonflikte zu behandeln, bei denen ein repliziertes Update auf eine Zeile abzielt, die von einem anderen Ursprung gelöscht wurde. Die Erkennung erfordert zudemtrack_commit_timestampauf dem Subscriber, undpg_stat_subscription_statszählt diese Konflikte.
Die Sequenzsynchronisation behebt einen schwierigen Migrations-Grenzfall, insbesondere bei Major-Version-Upgrades, die logische Replikation verwenden. Das Kopieren von Tabellenzeilen ohne Fortschreiben ihrer Sequenzen kann dazu führen, dass ein hochgestufter Subscriber Werte generiert, die bereits existieren, was zu Fehlern wegen doppelter Schlüssel führt.
PostgreSQL kopiert die anfänglichen Sequenzwerte, wenn das Abonnement mit copy_data = true erstellt wird, was dem Standard entspricht. Spätere Sequenzänderungen werden nicht kontinuierlich gestreamt, aktualisieren Sie diese daher unmittelbar vor dem Umstieg:
Dies aktualisiert die dem Abonnement bereits bekannten Sequenzen auf ihre aktuellen Werte auf dem Publisher. Wenn die Publikation neue Sequenzen erhalten hat, verwenden Sie ALTER SUBSCRIPTION ... REFRESH PUBLICATION, um diese hinzuzufügen und ihre Werte vor dem Umstieg zu synchronisieren.
WAIT FOR LSN
Asynchrone Lesereplikate erhöhen die Lesekapazität, ohne dass Primärschreibvorgänge auf sie warten müssen. Der Kompromiss ist die Replikationsverzögerung. Eine Anwendung kann einen Schreibvorgang auf der Primärdatenbank ausführen, sofort von einem Replik lesen und die Zeile nicht finden, weil das Replik das entsprechende WAL noch nicht wiedergegeben hat.
PostgreSQL 19 fügt einen direkten Weg zur Koordination dieses Übergangs hinzu. Ein LSN identifiziert eine Position im PostgreSQL-WAL, und WAIT FOR LSN blockiert das Standby, bis die Wiedergabe mindestens die angeforderte Position erreicht:
Standardmäßig wartet WAIT FOR LSN unbegrenzt darauf, dass das Standby das angeforderte LSN wiedergibt. Andere Modi können darauf warten, dass das WAL geschrieben oder geflusht wird, und Sie können ein Zeitlimit festlegen.
Der Client oder Connection Pooler muss das LSN nach wie vor von der Primärdatenbank zum Replik übertragen. Die Datenbank stellt nun den fehlenden Synchronisationsschritt bereit, sodass das „Read-your-writes“-Verhalten kein Polling oder willkürliches Warten mehr erfordert.
ON CONFLICT DO SELECT
INSERT ... ON CONFLICT DO SELECT bietet Ihnen ein sauberes Get-or-Create-Muster, das sowohl bestehende als auch neu eingefügte Zeilen zurückgibt:
Es ersetzt den DO UPDATE SET col = EXCLUDED.col Workaround, der ein Update durchführt, obwohl sich keine Werte ändern. Dadurch wird eine neue Zeilenversion erstellt und bei jedem Konflikt ein veraltetes Tupel hinterlassen.
JSON-Ausgabe für COPY TO
COPY TO kann jetzt direkt JSON ausgeben. Standardmäßig wird ein Objekt pro Zeile geschrieben, während FORCE_ARRAY die Ausgabe in ein einzelnes JSON-Array einbettet:
Das neue JSON-Format dient nur dem Export, daher akzeptiert COPY FROM es nicht.
Kleinere SQL- und Leistungsänderungen
Schließlich ein paar kompakte Änderungen mit einem Plus an Lebensqualität:
- JSON-Pfadausdrücke erhalten bekannte String-Methoden wie
btrim(),lower(),replace()undsplit_part(). - Die
random(min, max)Familie unterstützt nundate,timestampundtimestamptz, was bei Tests und synthetischen Datensätzen hilft. - Fünf Fensterfunktionen akzeptieren
IGNORE NULLSundRESPECT NULLS. - Wenn
io_method = worker, skalieren E/A-Worker automatisch zwischenio_min_workersundio_max_workers. Fremdschlüsselprüfungen sind schneller, und der Planer und Executor erhalten eine weitere Runde gezielter Optimierungen.
Wir haben auch einige Funktionen verloren
Mehrere wichtige Funktionen wurden während der Entwicklung von PostgreSQL 19 hinzugefügt, aber vor der Veröffentlichung wieder entfernt. Prüfer stellten Korrektheits- oder Designprobleme fest, die zu riskant waren, um sie spät im Zyklus noch zu lösen, weshalb die Community die Funktionen für ein späteres Release zurückgehalten hat.
Einige der Funktionen, die es letztendlich nicht in Version 19 schaffen:
SQL/PGQProperty-Graph-Abfragen.CREATE PROPERTY GRAPHundGRAPH_TABLEhaben Graphenmusterabgleiche über reguläre Tabellen in SQL eingeführt. Am 7. September 2026 rückgängig gemacht.UPDATE and DELETE ... FOR PORTION OF.Temporale Aktualisierungen und Löschungen, die Zeilen aufteilen, um den Verlauf außerhalb des Zielzeitraums zu erhalten. Am 15. September 2026 rückgängig gemacht.ALTER TABLE ... MERGE PARTITIONSundSPLIT PARTITION. Integrierte Befehle zum Zusammenlegen oder Aufteilen von Partitionen. Am 27. August 2026 rückgängig gemacht.GROUP BY ALL. Kurzform für die Gruppierung nach jedem nicht-aggregierten Ausdruck in der Auswahlliste. Am 17. Juli 2026 rückgängig gemacht.- Nicht-Text-Ausgabeformate für
pg_dumpall. Am 18. Juni 2026 rückgängig gemacht. - DDL-Extraktionsfunktionen.
pg_get_role_ddl(),pg_get_tablespace_ddl()undpg_get_database_ddl()wurden am 13. September 2026 rückgängig gemacht.
Vielen Dank an die PostgreSQL-Mitwirkenden
PostgreSQL lebt von seinen Mitwirkenden: Vielen Dank an die Hunderte von Community-Mitgliedern, die in den Release-Hinweisen genannt werden. Ein besonderer Dank geht an die Ingenieure des Lakebase-Teams, die an dieser Version von PostgreSQL gearbeitet haben:
- Robert Haas hat pg_plan_advice und pg_stash_advice geschrieben (letzteres gemeinsam mit Lukas Fittl)
- Heikki Linnakangas hat an einem neuen Mechanismus zur Registrierung von Shared Memory, einer Überarbeitung der Speicherteilsystemzuweisung, Multi-Xact-Korrekturen und dem neuen Standardwert von 128 für max_locks_per_transaction gearbeitet
- Jeff Davis hat die Änderung geschrieben, mit der CREATE SUBSCRIPTION die Verbindungsindetails eines postgres_fdw-Servers wiederverwenden kann, und hat umfangreiche Arbeiten an Gebietsschemata und der Zeichenverarbeitung durchgeführt
- Jonathan Katz hat an der Pressemitteilung zu PostgreSQL 19 mitgewirkt und die Release-Betreuung übernommen
- Matthias van de Meent hat an mehreren Commits gearbeitet, darunter die Änderung der Routinen für statische Indexzugriffsmethoden
- Alexander Lakhin hat mehrere Fehler gefunden und gemeldet
Upgrade auf PostgreSQL 19
Wie bei jeder neuen Hauptversion von PostgreSQL empfehlen wir einen besonnenen Ansatz für das Upgrade. Bevor Sie Produktions-Workloads auf 19.0 migrieren, empfehlen wir Folgendes:
- Testen Sie Ihre eigenen Workloads, Abfragen und Erweiterungen zunächst in einer Entwicklungs- oder Staging-Umgebung auf PostgreSQL 19
- Vergleichen Sie Leistung und Verhalten mit Ihrer aktuellen Version, da Hauptversionen Abfragepläne und Standardeinstellungen ändern können
- Überprüfen Sie, ob die von Ihnen benötigten Erweiterungen für PostgreSQL 19 verfügbar sind (siehe unten).
- Behalten Sie Ihre aktuelle Version in der Produktion bei, bis Sie sich mit den Ergebnissen sicher sind
PostgreSQL 19 ändert zudem einige Standardwerte und das Kompatibilitätsverhalten. Überprüfen Sie diese vor dem Upgrade:
- JIT-Kompilierung ist standardmäßig deaktiviert
- TOAST-Kompression verwendet standardmäßig LZ4 statt pglz
- MD5-Passwortauthentifizierung gibt stärkere Warnungen zur Deprecaten aus
- Die Unterstützung für die RADIUS-Authentifizierung wurde entfernt
- standard_conforming_strings ist immer aktiviert
- pg_upgrade lehnt Cluster mit betroffenen btree_gist-Indizes auf inet oder cidr ab
- Datenbank-, Rollen- und Tablespace-Namen dürfen keine Wagenrückläufe oder Zeilenvorschübe mehr enthalten
Ein Hinweis zu Erweiterungen
Wir haben die meisten der in unserem PostgreSQL 18-Release unterstützten Erweiterungen abgedeckt, aber noch nicht alle sind für PostgreSQL 19 verfügbar. Wir fügen weitere hinzu, sobald sie von den Erweiterungsanbietern bereitgestellt werden. Wenn Ihr Workload von einer bestimmten Erweiterung abhängt, stellen Sie vor der Planung einer Migration sicher, dass diese für PostgreSQL 19 verfügbar ist.
Die Community veröffentlicht in der Regel einige Monate nach einer Hauptversion ihr erstes Minor-Release, sobald der reale Einsatz Fehlerbehebungen und Verbesserungen zutage fördert. PostgreSQL 19.1 wird für Februar erwartet, und viele Teams planen ihre Produktions-Upgrades rund um diesen Release. Dies ist ein gängiges und sinnvolles Vorgehen für jedes .0-Release und trifft auch hier zu.
Unabhängig von Ihrem Zeitplan sind wir für Sie da. Wenn Sie die Upgrade-Planung oder das Testen besprechen möchten, wenden Sie sich an Ihr Account-Team oder den Databricks Support.
Ausprobieren
PostgreSQL 19 ist ab sofort auf Lakebase verfügbar. Erstellen Sie ein PostgreSQL 19-Projekt in Ihrem Workspace, um es auszuprobieren, oder legen Sie mit Lakebase los, wenn Sie neu damit sind.
(Dieser Blogbeitrag wurde mit KI-gestützten Tools übersetzt.) Originalbeitrag
Erhalten Sie die neuesten Beiträge in Ihrem Posteingang
Abonnieren Sie unseren Blog und erhalten Sie die neuesten Beiträge direkt in Ihren Posteingang.