Push-basiertes CDC in Unity Catalog mit Zerobus Ingest und Debezium
Sende Änderungsereignisse vom Open-Source-Debezium-Server direkt an Delta-Tabellen, ganz ohne laufenden Broker
von Victoria Bukta, Omkar Mehta und Wagner Santos
- Debezium Server und Databricks Zerobus Ingest kombinieren sich, um CDC-Ereignisse über eine Push-basierte Architektur direkt in Unity Catalog Delta-Tabellen zu streamen.
- Abgesicherte private Netzwerke, die eingehende Verbindungen blockieren, können Daten nun sicher nach außen replizieren, ohne dass Zwischen-Kafka-Message-Broker oder Pull-basierte Konnektoren erforderlich sind.
- Unternehmen können rohe Datenbankänderungen an das Lakehouse übergeben und so die Infrastruktur, die für den Aufbau aktueller Tabellen für nachgelagerte Analysen benötigt wird, drastisch vereinfachen.
Daten in operativen Datenbanken treiben geschäftliche Entscheidungen voran, und ein Großteil dieser Analysen findet im Lakehouse statt. Die Daten dorthin zu bekommen, ist schwierig, wenn sich die Datenbank in einem privaten Unternehmensnetzwerk, einer vom Kunden kontrollierten Umgebung oder einem eingeschränkten Subnetz befindet, dessen Richtlinien eingehende Verbindungen von externen Diensten blockieren.
Viele Teams benötigen ihre PostgreSQL-Änderungen in Databricks, aber das Team, dem die Datenbank gehört, möchte auch die Erfassung kontrollieren. Dieses Team führt den Prozess aus, der das Write-Ahead-Log liest und entscheidet, welche Verbindungen sein Netzwerk verlassen. Auf der anderen Seite landen die Änderungen in verwalteten Delta-Tabellen, auf denen Pipelines und Analysten aufbauen können.
Debezium ist ein weit verbreitetes Open-Source-Tool, dessen vollständige Bereitstellung Teams selbst übernehmen können, um einen Change Data Capture-Feed aus einer Datenbank zu extrahieren. Es befindet sich neben der Datenbank, liest deren Write-Ahead-Log und leitet Ereignisse nach außen weiter. Zerobus Ingest ist das Ziel, eine Push-Schnittstelle, die Datensätze direkt in Unity Catalog Delta-Tabellen schreibt. Der Open-Source Debezium Server Zerobus-Sink verbindet beide, ohne dass ein herkömmlicher Kafka-Cluster zwischen der Erfassung und dem Lakehouse erforderlich ist.
Entwickler bei NVIDIA und Databricks haben sich zusammengetan, um diesen Sink zu entwickeln, und ihn zum Open-Source-Debezium-Projekt beigetragen. Databricks hat den typisierten Zerobus Ingest-Sink gebaut. Anschließend steuerte NVIDIA den Envelope-Modus bei, der das vollständige Debezium-Änderungsereignis zusammen mit den dazugehörigen Sicherheitsvorkehrungen bei der Zustellung – wie Idempotenzschlüsseln und dauerhaften Bestätigungen, bevor Quell-Offsets vorrücken – bereitstellt. Der Zerobus Ingest-Sink wird ab der Debezium Server 3.7-Version ausgeliefert.
Dieser Beitrag behandelt die jeweiligen Aufgaben von Debezium und Zerobus, den von NVIDIA beigesteuerten Raw-Change-Envelope sowie die Frage, wie gelandete Ereignisse zu Current-State- oder historischen Tabellen werden. Eine praxisnahe Anleitung inklusive eines Live-Durchlaufs von einer lokalen PostgreSQL-Tabelle zu einer Current-State-Tabelle finden Sie im begleitenden How-to-Blog in der Databricks Community.
Die Herausforderung
Das zuverlässige Replizieren von Änderungen aus operativen Datenbanken in das Lakehouse muss mehrere Probleme gleichzeitig lösen:
- Einfügungen, Aktualisierungen und Löschungen zuverlässig erfassen. Eine Zeile, die erstellt, geändert und später entfernt wird, muss für jedes Ereignis einen originalgetreuen Stream erzeugen. Dies muss auch Löschungen einschließen, die bei abfragebasierten „Tabelle kopieren“-Ansätzen regelmäßig übersehen werden.
- Die für die Sortierung benötigten Belege behalten. Nachgelagerte Logik, die den aktuellen Zustand rekonstruiert, muss Änderungen in der Reihenfolge der Quelle anwenden, um die Quellabelle korrekt zu replizieren.
- Eine Überlastung der Quell-Datenbank vermeiden. Das Abfragen der Datenbank nach einem Zeitplan (
SELECT ... WHERE updated_at > ?) erhöht die Abfragelast und lässt sich nur schlecht skalieren. - Mit privaten und vom Kunden kontrollierten Netzwerken arbeiten. Wenn sich die Datenbank hinter einer streng gesicherten Begrenzung befindet, wissen wir, dass es eine Herausforderung sein kann, eine Verbindung zu diesen Systemen herzustellen und die Daten zu laden.
- Vermeiden, Kafka ausschließlich als Transportmittel einzurichten. Kafka ist ein leistungsstarker Event-Bus, aber den Betrieb eines Clusters allein zur Übertragung von CDC-Ereignissen von einer Datenbank in ein Lakehouse bedeutet einen erheblichen Mehraufwand für Teams, die dies ansonsten nicht benötigen.
- Die Daten so ablegen, dass sie einfach verarbeitet werden können. Der Änderungsstream muss in einer Form ankommen, die das Lakehouse verarbeiten und abfragen kann, und nicht in einem Silo, das einen weiteren Exportschritt erfordert.
Angesichts dieser Anforderungen müssen wir mit der Architektur beginnen, über die Daten von der Quelle zum Sink fließen.
Gesamtzielarchitektur
In diesem Blog untersuchen wir eine herkömmliche Message-Bus-Architektur im Vergleich zu einer Architektur mit Zerobus Ingest.
Architektur mit einem Message-Bus: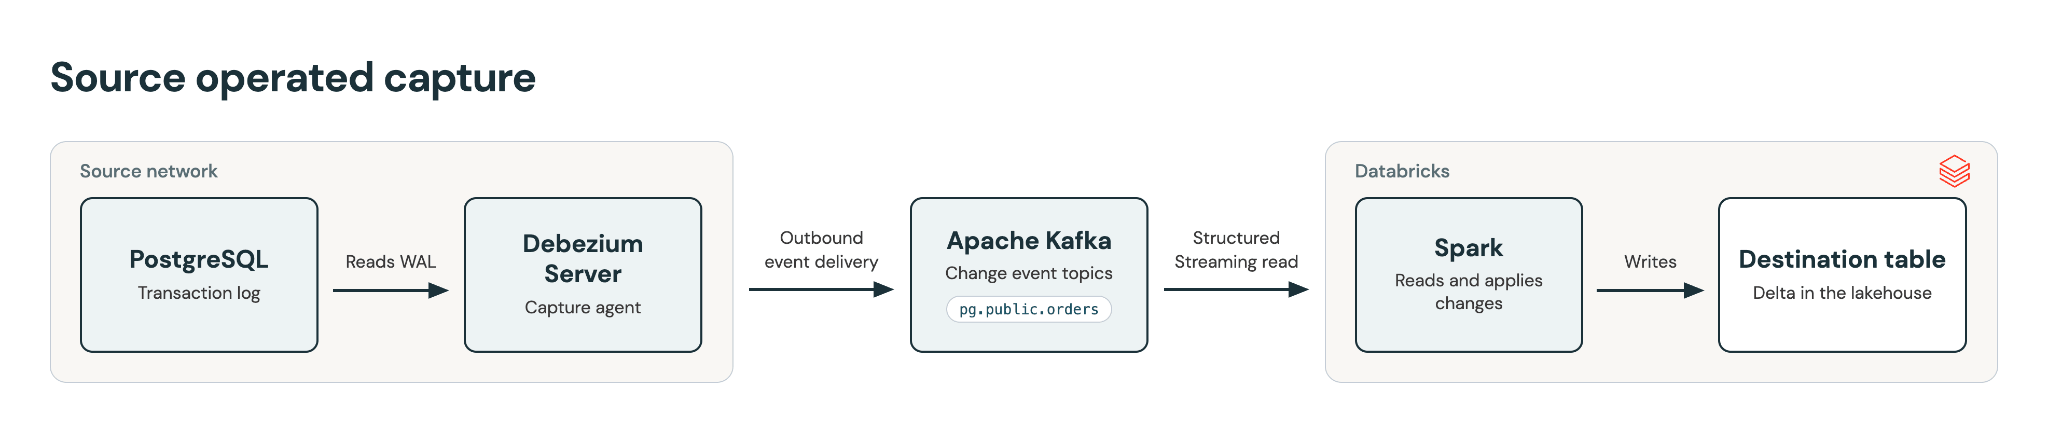
In vielen Unternehmensumgebungen ist die ausgehende Verbindung von innerhalb einer Peripherie viel einfacher zu erlauben als der eingehende Zugriff. Wenn Ihr Team eine Bereitstellung des Agents zur Extraktion von Änderungs-Feeds ausführen möchte, ermöglicht ein lokales Push-Modell den Datenfluss nach außen zu einem Ziel. In einer herkömmlichen Einrichtung wäre dies ein Message-Bus wie Kafka. Der Betrieb von Kafka erfordert Ressourcen für die Kapazitätsplanung, um die Anzahl der Broker vorherzusagen, die zur Bewältigung der Spitzenlast für die physische Skalierung erforderlich sind, sowie um die Anzahl der Partitionen für die logische Skalierung zu schätzen, die Consumer benötigen, um mit der Produktionsrate Schritt zu halten. Dies erfordert ein dediziertes Team mit Erfahrung in der Bereitstellung und Verwaltung dieses Kafka-Systems.
Sobald die Daten in Kafka landen, haben Sie die nächste Aufgabe zu erfüllen: diese Ereignisse in das Lakehouse zu replizieren. Dies könnte durch den Einsatz von Ingestion-Jobs wie mit Spark, dem Kafka Connector oder anderen Tools geschehen. Das Ergebnis ist eine Architektur mit zwei Hops von Debezium zum Lakehouse.
Architektur mit Zerobus Ingest: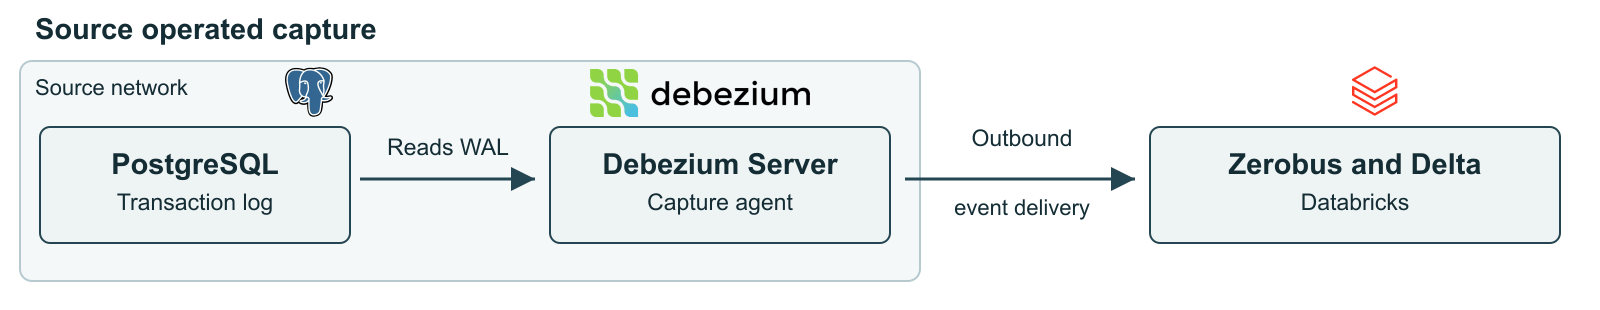
Wenn Ihr einziges Ziel das Lakehouse ist, ermöglicht Ihnen Zerobus, Zwischenschritte wie den Message-Bus zu umgehen. Dies optimiert Ihre End-to-End-Architektur und macht die Bereitstellung und Verwaltung einer Kafka-Infrastruktur für den Datentransport überflüssig. Wenn Sie Zerobus als Sink mit Debezium verwenden, funktioniert es auch während Ihrer Spitzenzeiten ohne Anpassungen weiter.
Was ist Debezium?
Debezium ist eine Open-Source-Plattform für protokollbasiertes Change Data Capture. Anstatt Tabellen abzufragen, liest es das Transaktionsprotokoll einer Datenbank, beispielsweise das Write-Ahead-Log (WAL) von PostgreSQL, das Binlog von MySQL oder die Change Streams von MongoDB. Anschließend gibt es jede Änderung als strukturiertes Ereignis aus. Das Projekt begann im Jahr 2015 und unterstützt heute ein breites Connector-Ökosystem (PostgreSQL, MySQL, SQL Server, Oracle, MongoDB und mehr).
Jedes Änderungsereignis enthält einen konsistenten Envelope:
before— der Zeilenzustand vor der Änderung (null bei Einfügungen)after— der Zeilenzustand nach der Änderung (null bei Löschungen)\op— der Vorgang:c(Erstellen/Einfügen),u(Aktualisieren),d(Löschen),r(Lesen/Snapshot)source— Metadaten: Datenbank, Schema, Tabelle, WAL Log Sequence Number (LSN), Transaktions-ID, Snapshot-Flagts_ms— Zeitstempel des Ereignisses
Debezium belastet die primäre Datenbank aufgrund seines Protokoll-Tailings im Gegensatz zum Polling zur Erfassung von Änderungen mit geringer Latenz nur minimal und bewahrt die Commit-Reihenfolge.
Standalone (Debezium Server) im Vergleich zur Kafka Connect-Bereitstellung
Debezium hat zwei Betriebsmodelle. Eines läuft auf Kafka Connect, und das andere ist ein „Standalone-Server“, der auf einfachem Compute eingerichtet werden kann.
Debezium Server, die eigenständige Laufzeitumgebung, dient als Agent auf Quellseite, der Transaktionsprotokolle ausliest und Änderungsereignisse direkt an Zerobus Ingest von Databricks sendet, ohne dass ein Kafka-Cluster als Transportweg erforderlich ist.
Die Lösung: Debezium + Zerobus Ingest
Wir haben Debezium also als Log-Reader identifiziert. Jetzt müssen wir die Ereignisse in Databricks übernehmen.
Zerobus Ingest ist ein serverloser, Push-basierter Ingestion-Dienst, der Daten direkt in Delta-Tabellen schreibt, die von Unity Catalog verwaltet werden – ganz ohne Message-Broker. Producer stellen eine Verbindung zu einem Zerobus-Endpunkt her und streamen Datensätze, die in einer Delta-Tabelle im offenen Format landen. Der Dienst ist für hohen Durchsatz und stark nebenläufige Workloads ausgelegt. Durch das Überspringen des Message-Brokers können wir die Architektur vereinfachen und den Wartungsaufwand für die Skalierung und Ausführung von Ingestion-Pipelines zur Datenübernahme in den Lakehouse-Bereich reduzieren.
Zusammen mit Debezium sieht Ihre CDC-Pipeline ungefähr so aus:
- Debezium überwacht das Protokoll der Datenbank und konvertiert jede Änderung in ein CDC-Ereignis.
- Zerobus Ingest überträgt diese Ereignisse direkt nach Databricks und schreibt sie in eine Delta-Tabelle – ohne Kafka-Cluster als Zwischentransport.
- Databricks empfängt den Änderungssstrom in einer Delta-Tabelle und kann ihn nachgelagert in bereinigte Tabellen verarbeiten.
Zerobus Ingest unterstützt nur Anhänge (Append-Only). Sobald die Änderungsereignisse eingetroffen sind, besteht der nächste Schritt darin, eine dimensionale Tabelle vom Typ 1 zu erstellen, indem ein Merge durchgeführt wird, um die neueste Version jeder Kombination aus Primärschlüsseln zu erhalten.
Der Beitrag von NVIDIA: der Envelope-Modus
Der Zerobus-Sink in Debezium bietet zwei Tabellenverträge. Der Standardmodus Typed bildet jedes Änderungsereignis auf eine Tabelle mit den Spalten der Quelle ab. Der von NVIDIA beisteuerte Envelope-Modus speichert das vollständige Debezium-Änderungsereignis in einer festen Tabelle mit neun Spalten:
- target_table
- destination
- partition
- operation
- idempotency_key
- key
- value
- source_position
- headers
Datensätze können als JSON (gespeichert in VARIANT Spalten) oder Protobuf kodiert werden.
Der Envelope-Modus behält die Informationen bei, die für die nachgelagerte Verarbeitung erforderlich sind. source_position enthält die Quellpartition und den Offset inklusive der PostgreSQL-LSN. idempotency_key ist ein SHA-256-Identifikator jedes Ereignisses, abgeleitet aus Ziel, Partition, Schlüssel, Operation und Quellenposition, sodass ein erneut zugestelltes Ereignis denselben Schlüssel erhält. Der Schlüssel identifiziert Ereignisse; er sortiert sie jedoch nicht und führt auch keine eigenständige Deduplizierung der Tabelle durch.
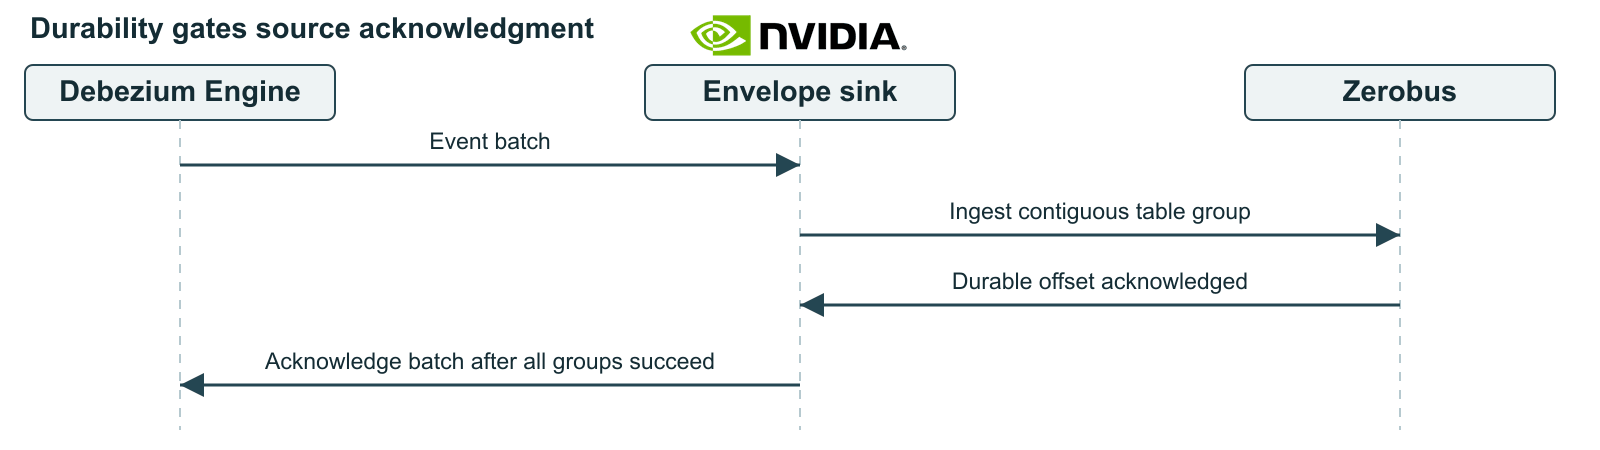
Wenn eine spätere Gruppe fehlschlägt, kann eine frühere dauerhafte Gruppe erneut zugestellt werden. Die Zustellung erfolgt also mindestens einmal (at-least-once), und Duplikate werden nachgelagert mit idempotency_key behandelt. Darüber hinaus filtert der Envelope-Modus nach Ziel und Operation und lehnt übergroße Datensätze vor der Ingestion ab, sodass deren Offset niemals festgeschrieben wird.
Datenmodellierung in Databricks
Sobald CDC-Ereignisse in Delta landen, wandelt ein gängiger Medallion-basierter Ablauf den rohen Datenstrom in etwas um, das Analysten und Anwendungen nutzen können:
- Bronze: Die unveränderten Änderungspereignisse im Eingangszustand. Im Envelope-Modus ist das genau eine Zeile pro Ereignis mit der entsprechenden Operation, Vorher-/Nachher-Zellenbildern, der Quellposition (LSN) und
idempotency_key. - Silver: Analysierte Änderungsdatensätze, dedupliziert nach
idempotency_keyund sortiert nach Quellposition. Eine nutzbare Darstellung der Quelldaten, bei der Einfügungen, Aktualisierungen und Löschungen interpretiert wurden, um den aktuellen Status wiederherzustellen. - Gold: Betriebsdaten werden mit Geschäftsdaten für Berichte (wie Finanzen, Leistungskennzahlen usw.) zusammengeführt.
Zwei Wege zur Gestaltung des Änderungssfeeds sind kurz erwähnenswert:
- Typ-1 (aktueller Status): Das Änderungsprotokoll wird so zusammengefasst, dass jeder Schlüssel seinen neuesten Wert widerspiegelt – ein Abbild des aktuellen Status der Quelltabelle.
- Typ-2 (Historie): Jede Version wird über die Zeit hinweg beibehalten, sodass Sie die Daten in dem Zustand abfragen können, den sie zu einem beliebigen Zeitpunkt hatten.
Der begleitende How-to-Blog in der Databricks Community führt dies Schritt für Schritt anhand einer lokalen PostgreSQL-Tabelle vor. Dabei wird der Debezium Server mit dem Zerobus-Senkenconnector konfiguriert, eine Einfügung, Aktualisierung und Löschung in der Envelope-Tabelle überprüft und anschließend die Typ-1-Tabelle (aktueller Status) mit AUTO CDC erstellt, wobei die Änderungen nach der Quell-LSN sortiert werden.
Fazit
Die Wahl der richtigen CDC-Architektur hängt letztendlich von den Netzwerkbeschränkungen, den betrieblichen Vorlieben und der bestehenden Infrastruktur Ihres Unternehmens ab.
Durch die Kombination von Debezium Server mit Zerobus Ingest können Sie eine lokale Push-Architektur bereitstellen, die Änderungen direkt in Delta-Tabellen streamt, ohne dass Kafka als Zwischentransport für Nachrichten erforderlich ist oder Staging-Bereiche im Cloud-Objektspeicher genutzt werden müssen, was den gesamten Ingress-Pfad vereinfacht.
Dadurch bleibt die PostgreSQL-Erfassung unter der Kontrolle des Teams, dem die Datenbank gehört, während die Daten in Unity Catalog landen.
Erste Schritte
Um diese Pipeline selbst zu erstellen, folgen Sie der Schritt-für-Schritt-Anleitung in der Databricks Community. Sie leitet PostgreSQL-Änderungen über Debezium Server und Zerobus Ingest in eine Unity Catalog-Tabelle weiter und erstellt dann mit AUTO CDC eine Tabelle im aktuellen Zustand. Informationen zur Einrichtung von Zerobus Ingest und anderen Ingest-Schnittstellen finden Sie in der Zerobus Ingest Dokumentation.
Häufig gestellte Fragen (FAQs)
Was ist der Debezium Zerobus Ingest Sink?
Es handelt sich um einen Sink in Debezium Server, der eigenständigen Debezium-Laufzeitumgebung, der Change-Events direkt an Zerobus Ingest sendet. Zerobus Ingest schreibt diese in Unity Catalog-gesteuerte Delta-Tabellen, sodass kein Kafka-Cluster zwischen der Erfassung und dem Lakehouse steht. NVIDIA und Databricks haben gemeinsam an diesem Open-Source-Beitrag gearbeitet.
Was ist der Envelope-Modus?
Im Envelope-Modus wird jedes vollständige Debezium Change-Event in einer festen Tabelle mit neun Spalten gespeichert, anstatt es auf die eigenen Spalten der Quelle abzubilden. NVIDIA hat dies zum Sink beigetragen. Er behält die Operation, den Schlüssel, den Wert, die Quellposition und einen Idempotenzschlüssel für die nachfolgende Verarbeitung bei. Der typisierte Modus ist der Standard.
Liefert der Sink jede Änderung genau einmal?
Nein, die Zustellung erfolgt nach dem Prinzip „mindestens einmal“ (at-least-once). Wenn eine spätere Gruppe von Datensätzen fehlschlägt, kann eine frühere dauerhafte Gruppe erneut zugestellt werden. Jedes Event enthält einen idempotency_key, sodass Sie Duplikate nachfolgend darüber entfernen können.
Wie mache ich aus dem Change-Feed eine Tabelle mit dem aktuellen Zustand?
Verwenden Sie AUTO CDC, um eine Typ-1-Tabelle zu erstellen, die die neueste Version jedes Schlüssels enthält. Ordnen Sie die Änderungen nach der Quell-LSN, damit sie in der Reihenfolge der Quelle angewendet werden. Um stattdessen jede Version über die Zeit zu behalten, erstellen Sie eine Typ-2-Tabelle.
(Dieser Blogbeitrag wurde mit KI-gestützten Tools übersetzt.) Originalbeitrag
Erhalten Sie die neuesten Beiträge in Ihrem Posteingang
Abonnieren Sie unseren Blog und erhalten Sie die neuesten Beiträge direkt in Ihren Posteingang.