RADAR: Gray Failures mit Anomalieerkennung erkennen
Wie Echtzeit-Anomalieerkennung stille, partielle Ausfälle in wenigen Minuten abfängt – und wie Sie dasselbe System auf Databricks aufbauen.
- Graue Ausfälle schlüpfen unbemerkt an grünen Dashboards vorbei und kosten Sie Kunden und Umsatz, noch bevor jemand darauf aufmerksam wird.
- RADAR ist ein vierstufiges, metrikunabhängiges Muster – Zuverlässigkeitsmetriken, Anomalieerkennung, Alarmierung und Ursachenanalyse –, das Databricks bei sich selbst anwendet, um diese Ausfälle innerhalb von Minuten mit einer Präzision von über 90 % und einer um 95 % schnelleren Erkennung abzufangen.
- Sie können dasselbe System auf Databricks für jede Metrik aufbauen – sei es Abrechnung, Conversion oder Modellleistung – und dabei native Komponenten und ein KI-Agenten-Gerüst nutzen.
Einige der schädlichsten Ausfälle sind diejenigen, die Ihr Monitoring nie meldet: Ein Teil Ihrer Kunden scheitert stillschweigend, während jeder Health Check weiterhin als normal angezeigt wird. Diese "Gray Failures" kosten Sie stundenlang User und Umsatz, bevor überhaupt jemand die Zusammenhänge versteht. In diesem Beitrag geht es darum, sie mithilfe von Anomalieerkennung frühzeitig zu erkennen – wie wir das bei Databricks mit einem System namens RADAR machen und wie Sie dasselbe für jede beliebige Metrik aufbauen können, die für Ihr Unternehmen am wichtigsten ist. Er richtet sich an alle, die für die Service-Zuverlässigkeit verantwortlich sind: SREs, Plattform- und Data-Engineers, On-Call-Verantwortliche und die Engineering-Leiter, an die sie berichten.
Wenn alles grün, aber nichts im Lot ist
Stellen Sie sich einen ganz normalen Mittwoch vor. Es ist Ihr Job, einen kundenorientierten Service zuverlässig am Laufen zu halten, und jedes Dashboard an Ihrer Wand ist grün – CPU im grünen Bereich, Latenz in Ordnung, Server laufen, Datenbank ist verbunden. Nach allen Signalen, die Ihr Team überwacht, sieht das System perfekt aus.
Ist es aber nicht.
- 9:30 – Ein routinemäßiges Deployment schleust einen minimalen Bug in Ihren Checkout-Flow ein.
- 9:35 – Bei jedem zwanzigsten Kunden, der mit Kreditkarte bezahlt, schlägt der Vorgang stillschweigend fehl. Nach ein paar Versuchen geben sie auf und gehen.
- 12:40 – Das erste Support-Ticket geht ein. Es sieht aus wie eine weitere falsch eingegebene Kartennummer, also schöpft niemand Verdacht.
- 14:20 – Zwei weitere Tickets zum selben Problem treffen ein.
- 14:25 – Ihr Support-Leiter erkennt das Muster und eskaliert das Problem.
- 16:00 – Die Engineers finden den Bug und spielen einen Fix auf.
Fast sieben Stunden lang behauptete Ihr Monitoring, alles sei in Ordnung, während Kunden absprangen und Umsatz verloren ging.
Was ist ein Gray Failure?
Dieser Mittwoch ist ein Paradebeispiel für einen Gray Failure. Oberflächlich betrachtet sieht alles bestens aus; darunter hat ein bestimmter Teil stillschweigend aufgehört zu funktionieren – und das beeinträchtigt die Kunden, ohne jemals einen Alarm auszulösen.
Zwei Dinge machen Gray Failures so tückisch:
- Sie sind partiell. Es betrifft nicht jeden – nur einen Teilbereich, wie etwa eine bestimmte Kreditkartenart. Es gibt keinen Serverabsturz, den Sie sofort bemerken würden, sondern nur einen unklaren Zwischenzustand, in dem es den meisten Usern gut geht, eine Gruppe aber permanent scheitert.
- Sie weiten sich aus. Was mit einer Handvoll betroffener Kunden beginnt, breitet sich aus. Wenn man nichts unternimmt, stoßen immer mehr Menschen auf dasselbe Problem.
Stellen Sie sich das wie Rauch hinter einer Wand vor. Von außen sieht das Haus gut aus, aber im Inneren breitet sich der Schaden aus – und je länger Sie warten, desto größer wird der Schadensradius. Die Forschung hat auch einen Namen für das zugrunde liegende Problem: Microsofts Gray Failure: The Achilles’ Heel of Cloud-Scale Systems nennt es differenzielle Observability – Ihre Fehlerdetektoren bemerken kein Problem, obwohl Ihre User es ganz klar tun.
Warum es fehlschlägt, auf Kundenmeldungen zu warten
Die meisten Teams gehen mit Gray Failures genau so um, wie es an jenem Mittwoch der Fall war: Sie warten darauf, dass Kunden sich melden. Kundenberichte sind wichtig – sie stehen für echten Ärger auf Nutzerseite –, aber Ihre Kunden sollten nicht Ihr Monitoring-System sein. Sich allein auf Berichte zu verlassen, bringt drei Probleme mit sich:
- Es ist manuell. Jemand muss dieselbe Beschwerde in einem Stapel von Tickets bemerken. Das wird leicht übersehen.
- Es ist verzögert. Bis sich genügend Leute beschweren, damit jemand die Zusammenhänge erkennt, sind bereits Stunden oder Tage vergangen.
- Es ist lautlos. Die meisten betroffenen Kunden erstellen überhaupt kein Ticket. Sie gehen einfach.
Die Lösung besteht nicht darin, keine Tickets mehr zu lesen – tun Sie das ruhig weiterhin. Sie besteht darin, eine automatische Erkennung hinzuzufügen, die ständig läuft und das erfasst, was Menschen übersehen. Konkret wünschen Sie sich ein System, das in dem Moment anspringt, in dem viel mehr Kunden als gewöhnlich zur gleichen Zeit auf dasselbe Problem stoßen.
| Nur Kundenberichte | Zusätzlich automatische Erkennung |
|---|---|
| Manuell – leicht zu übersehen | Erfasst, was Menschen übersehen |
| Verzögert – erst nach Tagen bemerkt | Schnell – in Echtzeit bemerkt |
| Kunden leiden stillschweigend | Meldet den Peak – viele User auf einmal |
Das ist RADAR
Das ist die Idee hinter RADAR – Reliability Anomaly Detection, Alerting, and Root-cause analysis. Wir haben es bei Databricks entwickelt, um Gray Failures in Minuten statt in Stunden zu erkennen. Der Name passt: Wenn die Sicht schlecht ist, wartet man nicht, bis man von etwas getroffen wird – man sucht frühzeitig nach schwachen Signalen.
So richten wir es auf ein besonders nützliches Signal aus: User-Fehler.
Ein Gray Failure äußert sich oft als plötzlicher Anstieg von Fehlern, die wie das Verschulden des Users aussehen. Stellen Sie sich eine Gruppe von Usern in einer Region vor, die plötzlich einen bestimmten Clustertyp nicht mehr hochfahren können. Jede Anfrage schlägt mit INVALID_ARGUMENT fehl – ein Fehler, der höflich sagt: „Das liegt an Ihnen.“
Doch wenn viele User im selben Moment auf denselben „Ihr Fehler“-Fehler stoßen, ist es nicht mehr ihr Fehler. Es ist unserer. Dieser Peak ist genau das Muster, für dessen Erkennung RADAR entwickelt wurde.
Die vier Phasen von RADAR
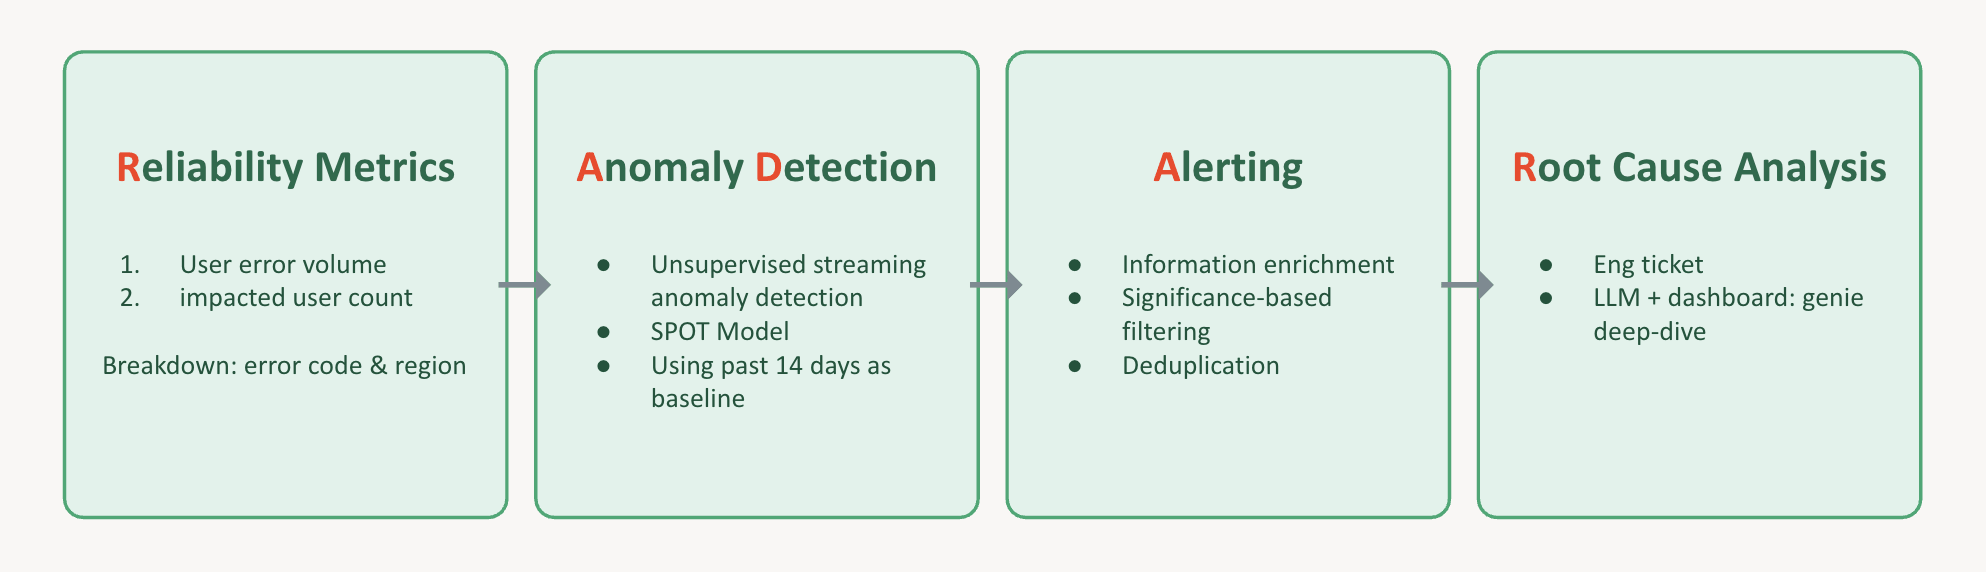
RADAR verwandelt diesen Instinkt in eine Pipeline mit vier Phasen:
- Zuverlässigkeitsmetriken. Erfassen Sie zu jedem Zeitpunkt zwei Dinge: wie viele Fehler auftreten und wie viele verschiedene User von jedem einzelnen betroffen sind. Schlüsseln Sie dies nach Fehlercode und Region auf. Jetzt verfügen Sie über einen reichhaltigen Satz an Zeitreihen, die den Zustand Ihres Services beschreiben.
- Anomalieerkennung. Führen Sie eine Anomalieerkennung für jede dieser Reihen aus, damit das System alles meldet, was ungewöhnlich aussieht – ohne dass Sie manuell eine Vielzahl von Schwellenwerten anpassen müssen. Wir verwenden ein unüberwachtes Streaming-Modell namens SPOT, das aus den letzten 14 Tagen lernt, wie „normal“ aussieht, und anstelle manueller Grenzwerte nur einen einzigen Risikoparameter benötigt. (SPOT stammt aus Siffer et al.s Anomaly Detection in Streams with Extreme Value Theory, KDD 2017.)
- Alerting. Wenn ein Alarm ausgelöst wird, übernimmt die Alerting-Ebene. Sie reichert den Alarm mit Kontext an, filtert irrelevante Meldungen heraus und entfernt Duplikate, damit die Rufbereitschaft nicht unter Kopien desselben Alarms begraben wird. Anschließend wird ein Ticket erstellt, das an das für diesen Fehler zuständige Engineering-Team weitergeleitet wird.
- Ursachenanalyse. Jedes Ticket enthält detaillierte Informationen zur Anomalieanalyse und einen Link zu einem Dashboard, das von einem AI-Assistenten, AI/BI Genie, unterstützt wird. Wer gerade Rufbereitschaft hat, kann direkt und in kürzester Zeit herausfinden, was tatsächlich kaputtgegangen ist.
Was wir erreicht haben
Der Einsatz von RADAR bei uns selbst hat die Art dieser Vorfälle grundlegend verändert. Zuvor haben wir auf Kundentickets gewartet, um solche Vorfälle zu entdecken, was zu tagelangen Verzögerungen führte. Mit RADAR konnten wir die Zeit bis zur Erkennung von Vorfällen um 95 % reduzieren – bei einer Präzision von über 90 % und ohne dass ein Mensch das Muster erkennen musste. Dadurch sind wir in der Lage, den Schadensradius von Gray Failures einzugrenzen.
Richten Sie RADAR auf jede beliebige Metrik aus
Und das ist der Punkt, der für Sie am wichtigsten ist: RADAR ist es völlig egal, um welche Metrik es sich handelt. Wir richten es zufällig auf User-Fehler aus, aber dasselbe Muster funktioniert überall dort, wo eine Zahl stillschweigend abweichen kann:
- Finanzdienstleistungen – Zahlungs- und Transaktionsfehler, Abrechnungsanomalien, Betrugssignale
- Einzelhandel und E-Commerce – Checkout-Conversion, Warenkorbfehler, Lieferzeiten
- Gesundheitswesen und Life Sciences – Patientendurchsatz, Antragsbearbeitung
- Jedes AI-Produkt – Modellleistung und Drift der Datenverteilung, die auftreten, bevor ein Modell sichtbare Fehler aufweist
Es ist dasselbe Muster unter anderen Bedingungen. Überall dort, wo etwas stillschweigend schiefgehen kann, lässt sich RADAR anwenden.
Bauen Sie es selbst auf Databricks
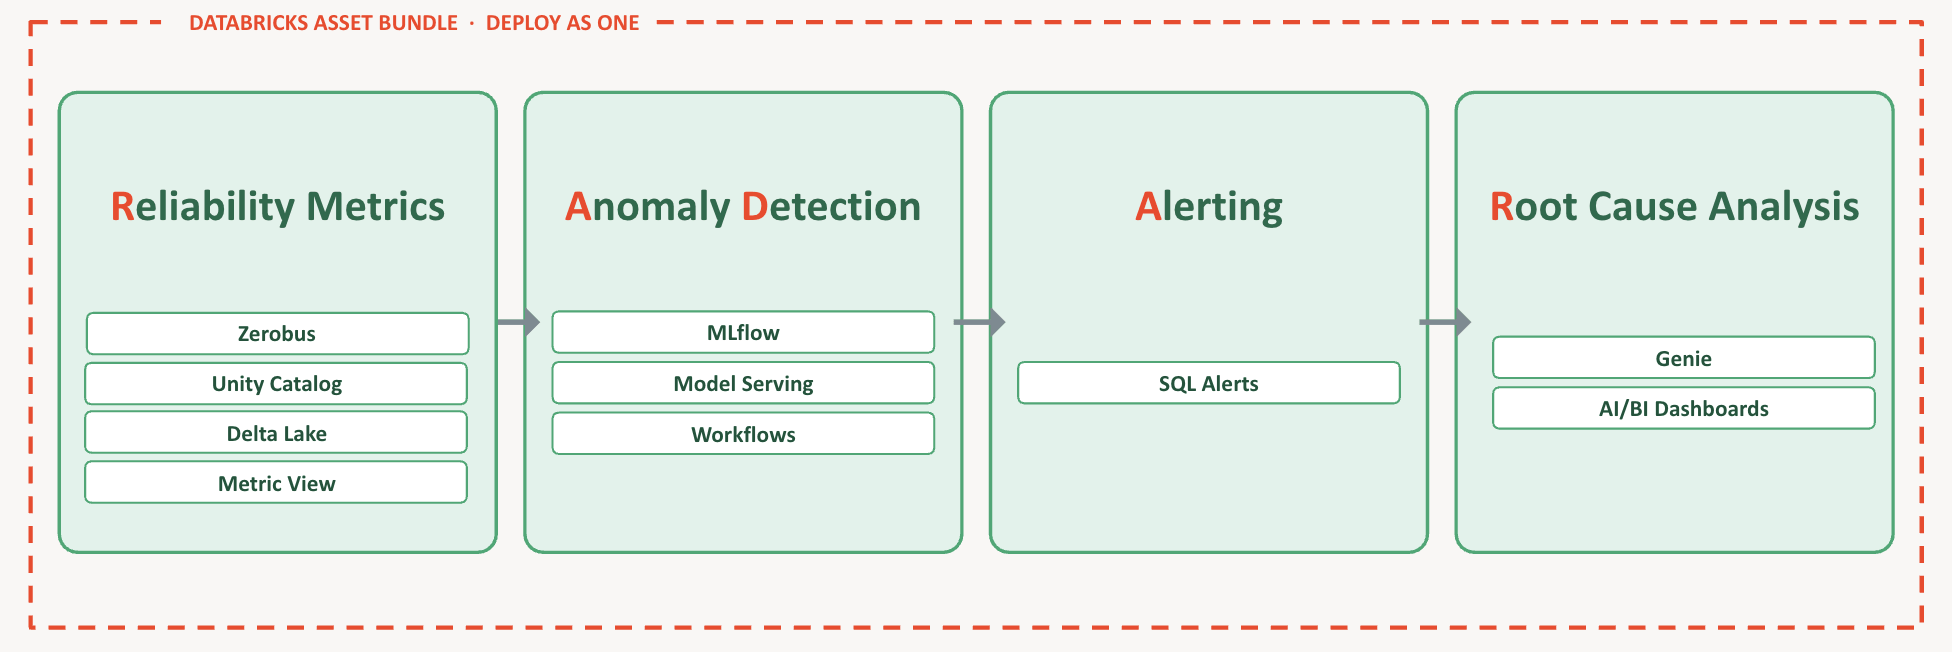
Die beste Nachricht: Jedes Teil, das Sie benötigen, ist bereits auf Databricks vorhanden. Wenn Sie die vier Phasen auf die Plattform übertragen, sieht das so aus:
- Zuverlässigkeitsmetriken – Zerobus für Low-Latency-Ingest, Unity Catalog und Metric View für Governance, Delta Lake für Storage
- Anomalieerkennung — MLflow für das Modelltraining, Model Serving zur Bereitstellung des Modell-Endpunkts und Workflows zur Orchestrierung der wiederkehrenden Jobs
- Alerting — Databricks SQL-Alerts zum Auslösen von Warnmeldungen
- Ursachenanalyse — AI/BI Genie und AI/BI Dashboards
Und das Ganze wird als eine einzige Einheit über ein Declarative Asset Bundle (DAB) bereitgestellt.
All diese Teile manuell miteinander zu verknüpfen, ist der mühsame Teil – also haben wir ihn abgeschafft. Wir haben das gesamte interne RADAR-System auf ein einziges Gerüst reduziert: eine Markdown-Datei, die wie ein Rezept funktioniert und jeden Teil von RADAR einer bestimmten Databricks-Komponente zuordnet (Erfassen und Speichern → eine Delta-Tabelle; Erkennen der Anomalie → ein Job; Warnen und Deduplizieren → ein Ticket; Visualisieren → ein Dashboard).
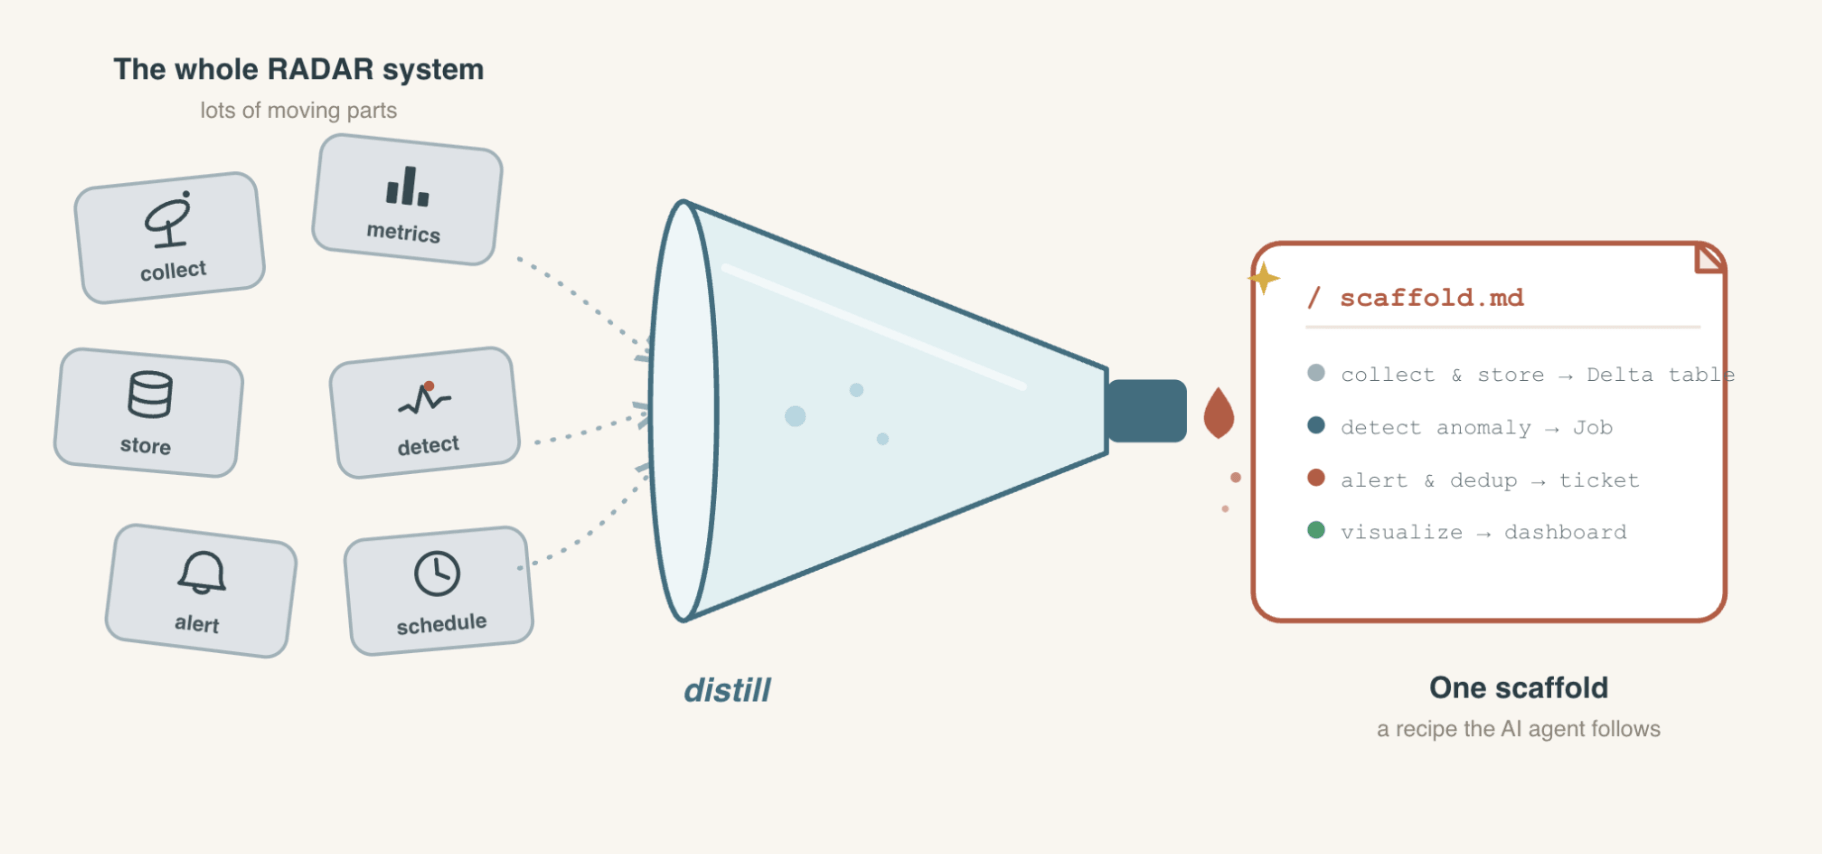
Dann zahlt sich die Arbeit aus. Sie bringen Ihre eigene Metrik mit – wo auch immer Ihr Signal liegt – und übergeben die Metrik, das Gerüst und einen kurzen Prompt an einen AI-Agenten. Er erstellt das gesamte RADAR-System für Sie, live auf Databricks. Sie können den GitHub-Anweisungen folgen, um zu erfahren, wie Sie ein System aus einem einzigen Prompt erstellen.
Wichtigste Erkenntnisse
Zwei Dinge, die Sie mitnehmen sollten:
- Erkennen Sie schleichende Fehler, bevor sie eskalieren. Grüne Dashboards sind kein Beweis dafür, dass bei Ihren Kunden alles in Ordnung ist. Integrieren Sie eine Echtzeit-Anomalieerkennung, damit ein teilweiser, stiller Ausfall in Minuten statt in Tagen sichtbar wird.
- Bauen Sie RADAR auf Databricks für jede Metrik auf, die für Sie wichtig ist. Das Gerüst, die Demo und der Prompt sind alle öffentlich zugänglich – nutzen Sie diese als Ausgangspunkt.
Holen Sie sich das RADAR-Gerüst auf GitHub
Denn das beste Ergebnis ist nicht eine schnellere Reaktion auf verärgerte Kunden – sondern dass Ihre Kunden Ihre Vorfälle gar nicht erst selbst entdecken müssen.
(Dieser Blogbeitrag wurde mit KI-gestützten Tools übersetzt.) Originalbeitrag
Erhalten Sie die neuesten Beiträge in Ihrem Posteingang
Abonnieren Sie unseren Blog und erhalten Sie die neuesten Beiträge direkt in Ihren Posteingang.