Echtzeit-Retail-Intelligence: Entwicklung von E-Commerce-Empfehlungen mit Lakebase und AI Search auf Databricks
Wie eine führende Fashion-E-Commerce-Plattform Millionen von Nutzern personalisierte Produktempfehlungen mit geringer Latenz bereitstellt – vollständig unterstützt durch die Databricks Data Intelligence Platform.
von Sunny Singh
- Eine vollständige Referenzarchitektur für den Aufbau einer mehrstufigen Empfehlungs- und Ranking-Engine auf Databricks – von der Clickstream-Erfassung bis zur personalisierten Bereitstellung in Echtzeit – die eine fragmentierte ML-Infrastruktur durch eine einzige, einheitliche Plattform ersetzt.
- Das System liefert personalisierte Produktempfehlungen mit geringer Latenz, indem es im Voraus berechnete Batch-Empfehlungen mit einem Echtzeit-Scoring-Pfad kombiniert. Dabei werden Databricks AI Search für den Kandidatenabruf, Lakebase für das Online-Feature-Serving und Model Serving für die Inferenz mit geringer Latenz genutzt.
- Durch die Zusammenführung von Data Engineering, Feature-Management, Modelltraining und Echtzeit-Bereitstellung auf einer einzigen, governed Plattform eliminieren E-Commerce-Teams Glue Code, beschleunigen Iterationszyklen und erhalten eine lückenlose End-to-End-Lineage von rohen Clickstream-Daten bis hin zu Produktionsvorhersagen.
Die Chance: Personalisierung als Umsatzmotor
Jede Sekunde, die ein Kunde in einer Fashion-E-Commerce-App verbringt, erzeugt einen Strom von Absichtssignalen – Suchanfragen, Produktansichten, Hinzufügungen zum Wunschzettel, Warenkorb-Interaktionen. Die Plattformen, die diese Signale in Echtzeit in relevante Produktempfehlungen umwandeln, sind diejenigen, die gewinnen. Branchen-Benchmarks zeigen, dass eine effektive Personalisierung die Konversionsraten um 10–30 % steigern und den durchschnittlichen Bestellwert erheblich erhöhen kann.
Dennoch bleibt der Aufbau eines produktionsreifen Empfehlungssystems eine der größten Herausforderungen im ML-Engineering. Er erfordert Echtzeit-Daten-Ingestion, komplexes Feature-Engineering, das Zusammenspiel mehrerer ML-Modelle und eine Serving-Infrastruktur, die in Millisekunden reagiert – und das alles, während Lagerbestand, Standort und Geschäftsregeln synchron gehalten werden.
Dieser Blog stellt eine vollständige Referenzarchitektur für den Aufbau eines solchen Systems auf Databricks vor. Sie basiert auf einer realen Implementierung für eine führende Fashion-E-Commerce-Plattform in Asien, die über 1 Million monatlich aktive Nutzer bei einem Katalog von mehr als 100.000 SKUs bedient.
Systemübersicht: Die Architektur auf einen Blick
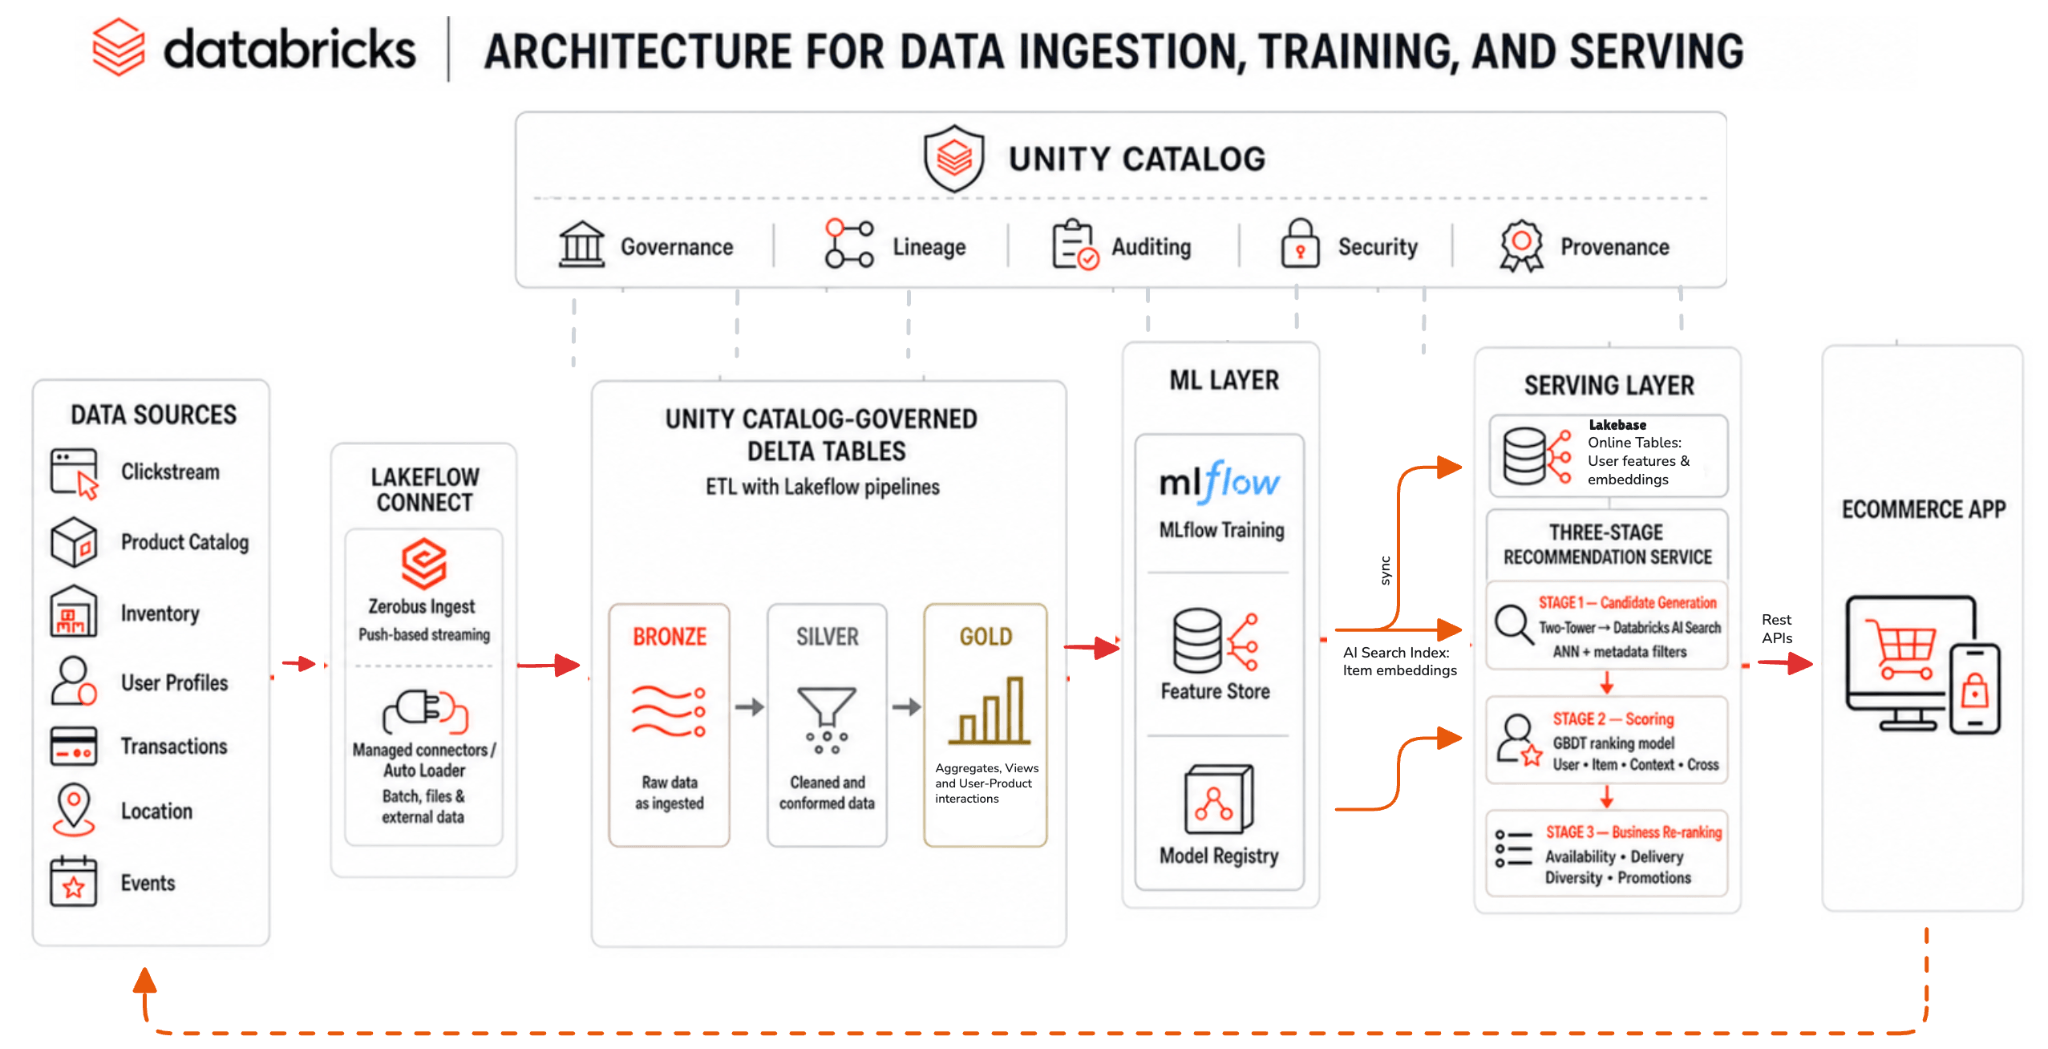
Die Architektur folgt einem einheitlichen Plattformansatz, bei dem jede Komponente – von der Ingestion bis zum Serving – auf Databricks läuft und von Unity Catalog verwaltet wird.
Gesamte Systemarchitektur:
Daten-Ingestion: In Sekundenschnelle vom Clickstream zum Lakehouse
Die Plattform verarbeitet etwa 1.000 Events pro Sekunde – Produktansichten, Suchanfragen, In-den-Warenkorb-Aktionen, Käufe und Sitzungsmetadaten. Lakeflow Connects Zerobus Ingest bildet das Rückgrat für die Ingestion und leitet Events direkt in Delta-Tabellen von Unity Catalog weiter, ohne dass ein selbstverwalteter Message Broker erforderlich ist.
Eine wichtige architektonische Unterscheidung: Clickstream-Daten fließen über Zerobus in das Lakehouse für die Offline-Feature-Berechnung und das Modelltraining. Bei der Echtzeit-Inferenz (Pfad B) hingegen werden In-Session-Nutzersignale – also das, was sich der Kunde gerade jetzt ansieht – direkt als Teil des API-Anfrage-Payloads an den Model Serving-Endpunkt gesendet. Dies umgeht den Lakehouse-Speicher während des Inferenzpfads vollständig und stellt sicher, dass der Echtzeitkontext ohne Ingestion-Latenz verfügbar ist.
Zerobus akzeptiert Daten von jedem standardmäßigen Kafka-Producer-Client (Java, Python, Go) über eine einfache Konfigurationsänderung: Verweisen Sie den Bootstrap-Server auf den Zerobus-Endpunkt, und die Datensätze landen in der Ziel-Delta-Tabelle. Für Teams, die bereits eine Kafka-Infrastruktur betreiben, bietet Structured Streaming mit Declarative Pipelines einen alternativen Pfad mit derselben Downstream-Architektur.
Die Daten fließen in eine Medaillon-Architektur:
Bronze-Layer – Unverarbeitete, reine Append-Only-Event-Streams plus Referenzdaten:
- Nutzersignale:
- Verhalten: Browsing-Verläufe, Suchanfragen, Verweildauer-Muster, Klickhistorie
- Transaktionen: Kaufhäufigkeit, durchschnittlicher Bestellwert, Retourenquote, Verteilung der Ausgaben nach Kategorien
- Präferenzen: Artikel auf dem Wunschzettel, gespeicherte Suchen, Markenaffinitäten, Größenpräferenzen
- Demografie: Alterskohorte, Standort-Cluster, Gerätetyp, App-Engagement-Stufe
- Artikel-Signale:
- Katalog: Kategoriehierarchie, Marke, Preisstufe, Material, Farbe, Saisonalität
- Performance: Konversionsrate, View-to-Cart-Verhältnis, Retourenquote, durchschnittliche Bewertung
- Visuell: Image Embeddings (erfassen Stilähnlichkeiten über Textattribute hinaus)
- Aktualität: Tage seit der Listung, Trendgeschwindigkeit, Bestandsentwicklung
- Kontextuelle Signale:
- Zeitlich: Tageszeit, Wochentag, Nähe zum Zahltag, Feiertage/Schlussverkäufe
- Geografisch: Stadt des Nutzers, nächstgelegenes Logistikzentrum, regionale Stilpräferenzen
- Umgebung: Wetter (beeinflusst Kategoriepräferenzen), lokale Ereignisse
- Sitzung: aktuelle Browsing-Absicht (abgeleitet aus dem Verhalten während der Sitzung)
Silver-Layer – Bereinigt, in Sitzungen unterteilt und angereichert:
- In Sitzungen unterteiltes Nutzerverhalten (Browsing-Verläufe, Verweildauern, Interaktionsmuster)
- Bereinigte Produkt-Features (normalisierte Attribute, Kategoriehierarchien)
- Aggregierte Engagement-Signale (Anzahl der Aufrufe in den letzten 7 Tagen, Trend-Scores, Popularitätsindizes)
- Nutzer-Produkt-Interaktionsmatrizen (implizite Feedback-Signale)
Gold-Layer – Modellbereite Feature-Tabellen und Trainingsdatensätze:
- Nutzer-Feature-Vektoren (Verhaltens-Embeddings, Präferenzprofile, demografische Cluster)
- Artikel-Feature-Vektoren (Produkt-Embeddings, Attribut-Codierungen)
- Trainingsdatensätze (gelabelte Interaktionspaare für das Modelltraining)
- Vorberechnete Empfehlungslisten (im Batch-Verfahren generiert, für schnelles Abrufen gespeichert)
Features werden in unterschiedlichen Intervallen aktualisiert: Verhaltensaggregate werden täglich über geplante Databricks Workflows aktualisiert, während der gesamte Produktkatalog wöchentlich synchronisiert wird. Embeddings für Nutzer und Artikel werden täglich neu berechnet, um sich ändernde Präferenzen und neue Bestände zu erfassen. Der Databricks Feature Store verwaltet sowohl Offline-Features (für das Training) als auch Online-Features (für das Serving) und stellt so die Konsistenz zwischen Training und Serving sicher – dieselben Feature-Definitionen, die beim Modelltraining verwendet werden, sind zur Inferenzzeit automatisch über Lakebase Online-Tabellen verfügbar.
Unity Catalog verwaltet jede Ebene – er bietet Lineage vom rohen Clickstream-Event bis zur endgültigen Vorhersage, die an die App geliefert wird, wobei eine feingranulare Zugriffskontrolle sicherstellt, dass PII geschützt bleiben, während aggregierte Features ungehindert in das Modelltraining einfließen.
Echtzeit-Serving: Zwei Wege zu geringen Antwortlatenzen
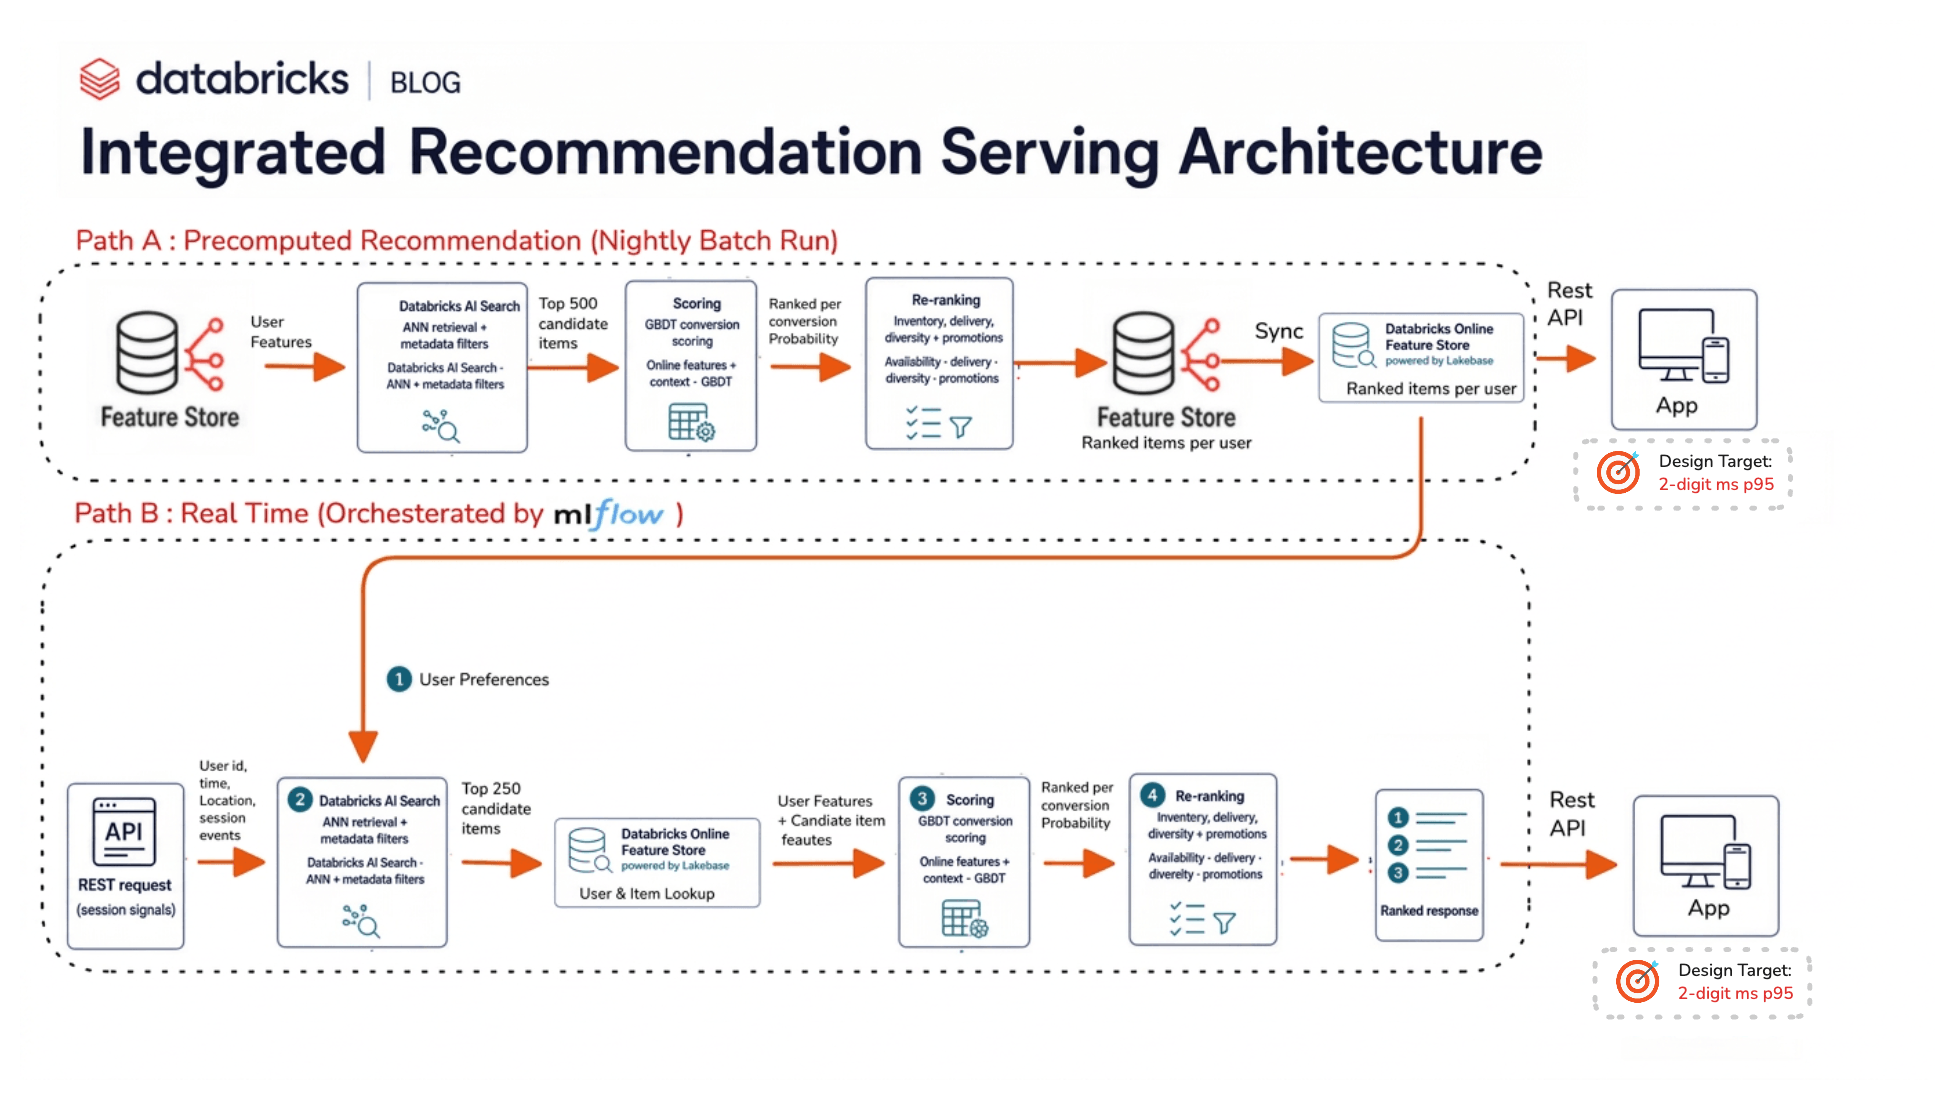
Die Serving-Architektur bietet zwei komplementäre Pfade, die jeweils für unterschiedliche Interaktionsmuster optimiert sind. Pfad A deckt die volumenstarken, vorhersehbaren Oberflächen ab, bei denen eine Vorberechnung sowohl machbar als auch optimal ist. Pfad B deckt die dynamischen, sitzungsabhängigen Oberflächen ab, bei denen die unmittelbare Absicht des Nutzers die Antwort in Echtzeit bestimmen muss.
Pfad A – Vorberechnete Batch-Empfehlungen (< zweistellige ms)
Pfad A bedient die Mehrheit der Empfehlungsflächen – Homepage-Karussells, Rankings auf Kategorieseiten, E-Mail-Kampagnen und Push-Benachrichtigungen. Diese Flächen haben eine Gemeinsamkeit: Die Identität des Nutzers und der Flächentyp sind im Voraus bekannt, sodass die Ergebnisse vorab berechnet werden können.
Ein nächtlicher Batch-Job, der von Databricks Workflows orchestriert wird, führt den vollständigen dreistufigen Funnel offline für jeden aktiven Nutzer aus. Er ruft die neuesten Nutzer-Embeddings ab, führt Batch-ANN-Abfragen auf dem AI Search-Artikelindex aus, um Kandidaten zu generieren, bewertet diese mit dem LightGBM-Modell unter Verwendung von Features aus dem Gold-Layer und wendet Geschäftsregeln an (Bestandsbewertung, Lieferentfernung, Diversität, Promotion-Boosting). Das Ergebnis – eine nach Top-N sortierte Produktliste pro Nutzer (normalerweise 50–100 Artikel pro Fläche) – wird in Lakebase Online-Tabellen geschrieben, indiziert nach Nutzer-ID und Flächentyp.
Beim Serving führt die App ein einfaches Key-Value-Lookup durch: user_id + surface → sortierte Produktliste. Keine Modellinferenz, keine Vektorsuche, kein Zusammenfügen von Features – nur ein direktes Lesen aus Lakebase.
Da der Batch-Job jede Nacht ausgeführt wird, spiegelt Pfad A die Signale und den Lagerbestand des Vortags wider. Für die meisten Oberflächen ist diese Aktualität mehr als ausreichend – langfristige Präferenzen und Markenaffinitäten entwickeln sich über Tage, nicht über Minuten – und neue Produkte, die ihre ersten Embeddings erhalten haben, erscheinen innerhalb von 24 Stunden in den Empfehlungen.
Pfad B – Echtzeit-Scoring unter Berücksichtigung der Sitzung (< zweistellige ms)
Pfad B wird aktiviert, wenn der Empfehlungskontext erst zum Zeitpunkt der Anfrage existiert – „Ähnliche Artikel“ auf einer Produktdetailseite, „Look vervollständigen“-Vorschläge oder dynamisch neu geordnete Suchergebnisse, die sich anpassen, während der Benutzer surft.
Die E-Commerce-App sendet aktuelle Sitzungssignale – in den letzten Minuten angesehene Artikel, aktive Suchanfragen, Warenkorbinhalte und Verweildauer-Muster – direkt als Request-Payload über eine REST-API an den Model Serving-Endpunkt. Der Endpunkt führt den gesamten dreistufigen Funnel synchron innerhalb eines einzigen Anfrage-Antwort-Zyklus aus:
- Stufe 1 – Kandidatenabruf in Echtzeit Der Endpunkt wandelt Sitzungssignale in ein Query-Embedding um – entweder das Item-Embedding des gerade angesehenen Produkts oder ein gemischtes User-Embedding, das das langfristige Präferenzprofil (aus Lakebase) mit dem Verhalten in der aktuellen Sitzung verschmilzt, wobei neuere Signale stärker gewichtet werden. Dieses Embedding wird an Databricks AI Search gesendet, das einen hybriden Abruf durchführt: ANN-Ähnlichkeitssuche kombiniert mit harten Metadatenfiltern (Kategorieberechtigung, regionaler Lagerbestand, Mindestbestandsschwellen). Artikel, die nicht auf Lager oder nicht berechtigt sind, gelangen gar nicht erst in die Kandidatenmenge. AI Search gibt 200–500 Kandidaten in einem einzigen Netzwerk-Roundtrip zurück. Für sitzungsbezogene Oberflächen berechnet der Endpunkt ein gemischtes Query-Embedding – er kombiniert das vorab berechnete langfristige Präferenz-Embedding des Benutzers (abgerufen aus Lakebase) mit einem Sitzungs-Embedding, das von kürzlich angesehenen Artikeln abgeleitet ist, gewichtet nach aktuellen Signalen, um die unmittelbare Absicht zu erfassen. Diese Mischung ist eine einfache Berechnung, die innerhalb des Endpunkts durchgeführt wird, und kein separater Modellaufruf.
- Stufe 2 – Feature-Zusammenstellung und Scoring Die IDs der Kandidatenartikel lösen Point-Lookups in den Online-Tabellen von Lakebase aus, um vorab berechnete User-Features (Verhaltensaggregate, demografisches Segment, Preissensitivität) und Item-Features (Konversionsrate, Trend-Score, Tage seit der Listung) abzurufen. Echtzeit-Kontext-Features (Tageszeit, Gerät, Standort, aktive Werbeaktionen) werden direkt aus der Request-Payload abgeleitet. Der Endpunkt erstellt Feature-Vektoren für jedes Benutzer-Kandidaten-Paar – einschließlich Cross-Features wie der Affinität zwischen Benutzer und Kategorie sowie Überschneidungen bei den Markenpräferenzen – und übergibt diese an das LightGBM-Scoring-Modell, das die Konversionswahrscheinlichkeit in einem einzigen Batch-Inferenz-Aufruf ohne GPU-Ressourcen vorhersagt.
- Stufe 3 – Geschäftsregeln und Re-Ranking Die bewertete Liste durchläuft eine deterministische Re-Ranking-Ebene: Ein bestandsabhängiges Scoring depriorisiert sinkende Lagerbestände, ein Scoring nach Liefernähe bevorzugt nähere Lagerhäuser für eine schnellere Abwicklung, die Diversitätsinjektion verhindert eine Dominanz von Marken oder Kategorien in der endgültigen Liste, und ein Promotion-Boosting hebt Artikel hervor, die auf aktive Kampagnen abgestimmt sind. Die neu geordnete Liste wird auf die angeforderte Größe gekürzt (normalerweise 10–20 Artikel) und als API-Antwort zurückgegeben.
Geschäftsregeln sind konfigurationsgesteuert – Werbegewichtungen, Diversitätsschwellenwerte und Bestandsgrenzen werden zum Zeitpunkt der Bereitstellung aus einer verwalteten Konfigurationstabelle gelesen, sodass kommerzielle Teams die Regeln anpassen können, ohne das Modell neu bereitzustellen.
Der Endpunkt ist als benutzerdefiniertes MLflow PyFunc-Modell implementiert, das die mehrstufige Pipeline intern orchestriert – Abfrage von AI Search, Durchführung von Lakebase-Lookups, Ausführung der LightGBM-Inferenz und Anwendung von Geschäftsregeln innerhalb eines einzigen predict()-Aufrufs.
Eine Fallback-Strategie sorgt für Ausfallsicherheit: Wenn der Echtzeitpfad sein Latenzbudget überschreitet, weicht das System nahtlos auf die Bereitstellung zwischengespeicherter beliebter Artikel oder der vorab berechneten Empfehlungen des Benutzers aus Pfad A aus.
Umgang mit dem Kaltstart-Problem
Jedes Empfehlungssystem muss zwei Kaltstart-Szenarien bewältigen:
Neue Benutzer (kein Browserverlauf): Wenn ein Benutzer zum ersten Mal die Website besucht, erstellt das System ein Standard-User-Embedding aus den verfügbaren demografischen Signalen – Standort, Gerätetyp, Registrierungskontext und allen angegebenen Präferenzen. Dieses Embedding wird für die ANN-Suche im Item-Index verwendet, wodurch der neue Benutzer effektiv in einem Verhaltenscluster mit ähnlicher Demografie platziert wird. Sobald der Benutzer interagiert, nähert sich sein Embedding schnell seinen tatsächlichen Präferenzen an.
Neue Produkte (keine Interaktionsdaten): Wenn eine neue SKU in den Katalog aufgenommen wird, generiert das System ein Item-Embedding aus seinen Attributen – Titel, Kategorie, Marke, Preispunkt und visuellen Merkmalen, die aus Produktbildern extrahiert wurden. Dieses Embedding wird verwendet, um ähnliche vorhandene Artikel im Vektorraum zu finden, und das neue Produkt erbt die anfänglichen Empfehlungs-Scores von seinen nächsten Nachbarn. Neue Produkte erscheinen beim nächsten täglichen Batch-Zyklus in den Empfehlungen.
Modell-Lebenszyklus und kontinuierliche Verbesserung
Modelle werden wöchentlich mit Databricks Workflows neu trainiert, wobei das Experiment-Tracking und die Versionierung über MLflow verwaltet werden. Die Plattform unterstützt das Champion/Challenger-Deployment – neue Modellversionen werden parallel zum Produktionsmodell bereitgestellt, wobei der Datenverkehr basierend auf Online-Leistungsmetriken schrittweise verlagert wird.
Zu den wichtigsten überwachten ML-Metriken gehören:
- AUC-ROC – misst die Fähigkeit des Scoring-Modells, zwischen Artikeln zu unterscheiden, mit denen ein Benutzer interagieren wird und mit welchen nicht
- NDCG@K (Normalized Discounted Cumulative Gain) – bewertet, ob die relevantesten Artikel ganz oben in der Rangliste erscheinen
- Recall@K – misst, welchen Anteil der relevanten Artikel die Phase der Kandidatengenerierung erfolgreich abruft
- Log Loss – verfolgt die Vorhersagekalibrierung und stellt sicher, dass die Werte für die Konversionswahrscheinlichkeit im Laufe der Zeit gut kalibriert bleiben
Diese Modellmetriken werden durch geschäftliche KPIs ergänzt – Klickrate, Konversionsrate und Umsatz pro Sitzung –, die als ultimativer Beleg dafür dienen, dass sich Modellverbesserungen in der Praxis auszahlen.
Die automatische Drift-Erkennung signalisiert, wenn Feature-Verteilungen oder Vorhersage-Score-Verteilungen von den Baselines abweichen, was eine Untersuchung oder ein beschleunigtes erneutes Training auslöst. Serving-Protokolle werden über Identifikatoren auf Anfrageebene mit den Trainings-Pipelines korreliert, um sicherzustellen, dass die Feedbackschleife saubere, Leakage-freie Trainingsdaten für die nächste Modelliteration liefert. Positionsbewusste Trainingstechniken stellen sicher, dass das Modell echte Benutzerpräferenzen lernt und nicht Artefakte der Anzeigeposition.
Erwartete Ergebnisse
Diese Architektur ermöglicht:
- personalisierte Antworten im niedrigen zweistelligen Millisekundenbereich in großem Maßstab, was den Leistungserwartungen moderner Mobile-First-Shopper entspricht
- Täglich frische Empfehlungen, die den neuesten Lagerbestand, Trendprodukte und sich entwickelnde Benutzerpräferenzen widerspiegeln
- Einheitliche Governance vom rohen Clickstream bis hin zu Produktionsvorhersagen, mit vollständiger Lineage und Zugriffskontrolle über Unity Catalog
- Schnelles Experimentieren – neue Modellvarianten können innerhalb von Tagen statt Monaten trainiert, evaluiert und bereitgestellt werden
- Operative Einfachheit – eine einzige Plattform ersetzt das Flickwerk aus separaten Systemen für Ingestion, Feature Engineering, Training und Serving
- Nahtlose Skalierung – von Tausenden auf Millionen von Benutzern ohne Neuarchitektur, unter Nutzung von Serverless-Compute und verwalteter Infrastruktur
Fazit
Der Aufbau einer produktionsreifen Empfehlungs- und Ranking-Engine erfordert nicht mehr das Zusammenflicken von einem Dutzend spezialisierter Systeme. Durch die Vereinheitlichung von Echtzeit-Ingestion (Zerobus), Feature-Management (Feature Store + Lakebase), Modelltraining (MLflow + Workflows), Vektorabruf (AI Search) und Serving mit geringer Latenz (Model Serving) auf einer einzigen, kontrollierten Plattform können sich E-Commerce-Teams auf das Wesentliche konzentrieren: ihre Kunden zu verstehen und das richtige Produkt im richtigen Moment bereitzustellen.
Das Ergebnis ist nicht nur eine Empfehlungs-Engine – es ist eine vollständige, produktionsreife Personalisierungsplattform, die als intelligentes Rückgrat für jedes E-Commerce-Erlebnis dienen kann.
Bereit, Ihre eigene Lösung zu entwickeln? Entdecken Sie die Databricks Recommendation Engine Solution Accelerators, lesen Sie die Dokumentation zu AI Search oder kontaktieren Sie Ihr Databricks-Account-Team für einen Architektur-Workshop.
(Dieser Blogbeitrag wurde mit KI-gestützten Tools übersetzt.) Originalbeitrag
Erhalten Sie die neuesten Beiträge in Ihrem Posteingang
Abonnieren Sie unseren Blog und erhalten Sie die neuesten Beiträge direkt in Ihren Posteingang.