"Regex für Zeilen": Vereinfachung der Mustererkennung in SQL mit MATCH_RECOGNIZE
Nutzen Sie MATCH_RECOGNIZE immer dann, wenn eine Sequenz eine Rolle spielt – von Börsentrends bis hin zu Sensorausfällen und mehr.
von Kent Marten und Sergei Fedorov
- MATCH_RECOGNIZE ist ein neuer SQL-Operator, der in der Public Preview verfügbar ist und es Ihnen ermöglicht, Muster und Sequenzen aus Ereignisdaten zu erkennen.
- MATCH_RECOGNIZE verwendet eine Regex-ähnliche Mustererkennung.
- MATCH_RECOGNIZE ist in vielen Branchen äußerst nützlich, darunter: Finanzdienstleistungen, Cybersicherheit, E-Commerce und Fertigung/IoT
Stellen Sie sich vor, Sie arbeiten im Bereich Cybersicherheit und haben eine Tabelle, in der Anmeldeversuche erfasst werden. Diese Tabelle enthält jeden Anmeldeversuch als Erfolg oder Fehlschlag sowie den Zeitpunkt, an dem der Versuch stattgefunden hat. Sie möchten ungewöhnliche Anmeldemuster finden und stellen sich vielleicht die Frage: „Welche Benutzer hatten aufeinanderfolgende fehlgeschlagene Anmeldeversuche, gefolgt von einem erfolgreichen?“ Es ist eine Herausforderung, diese Art von verdächtigen Aktivitäten mit Standard-SQL zu finden. SQL behandelt Zeilen als ungeordnete Mengen von Fakten ohne Zeitachse, und es gibt kein inhärentes Konzept für eine Abfolge von Ereignissen.
Sie könnten die fehlgeschlagenen Anmeldungen pro Benutzer zählen, aber diese Zahlen helfen Ihnen nicht zu verstehen, ob diese Anmeldeversuche in einem kurzen Zeitraum stattfanden oder über einen Monat verteilt waren. Sie können Ihnen auch nicht sagen, ob direkt nach den Fehlschlägen eine erfolgreiche Anmeldung erfolgte. Um dies in SQL zu tun, erhalten Sie am Ende eine komplexe Abfrage, die mehrere Common Table Expressions (CTEs) miteinander verknüpft, das Zeitfenster am ersten Fehlschlag verankert und dann jede nachfolgende Zeile überprüft.
MATCH_RECOGNIZE vereinfacht dies. MATCH_RECOGNIZE ist jetzt in Databricks-Compute (einschließlich Lakehouse Real-Time) verfügbar und ermöglicht es Ihnen, die gewünschte Sequenz direkt zu beschreiben – wie ein regulärer Ausdruck für Zeilen. Eine einzige SQL-Klausel übernimmt nun den Musterabgleich, und Sie müssen kein übermäßig kompliziertes SQL mehr verwenden, das auf der „Gaps and Islands“-Logik basiert.
Sehen wir uns branchenspezifische Beispiele an, wie MATCH_RECOGNIZE die Sequenzerkennung in verschiedenen Branchen vereinfacht.
Cybersecurity: Identifizierung verdächtiger Anomalien bei der Anmeldung

Wenn Sie in Autorisierungsprotokollen nach Credential Stuffing suchen, kann das bloße Zählen von Anmeldeversuchen zu Fehlalarmen (False Positives) führen. Sie müssen gezielt hochfrequente Spitzen erkennen, wie z. B. 5 oder mehr fehlgeschlagene Anmeldeversuche innerhalb eines bestimmten engen Zeitfensters, unmittelbar gefolgt von einer erfolgreichen Anmeldung.
Standard-Fensterfunktionen wie COUNT() OVER (PARTITION BY user_id ORDER BY event_time) können Ihnen zwar sagen, wie viele Fehlschläge in einem Zeitraum aufgetreten sind, aber sie können ein gleitendes Zeitfenster nicht einfach am ersten Fehlschlag in einer bestimmten Sequenz verankern, noch können sie die Sequenz sauber isolieren, sobald ein Erfolg eintritt.
Mit MATCH_RECOGNIZE können Sie FIRST(FAIL.event_time) direkt im DEFINE-Block verwenden, um den Zeitstempel des ersten fehlgeschlagenen Versuchs zu verankern. Jedes nachfolgende FAIL-Ereignis wird dynamisch überprüft, um sicherzustellen, dass es innerhalb einer Stunde nach diesem ersten Versuch liegt, bevor in den SUCCESS-Status gewechselt wird.
Financial Analysis: Erkennung von V-förmigen Aktientrends
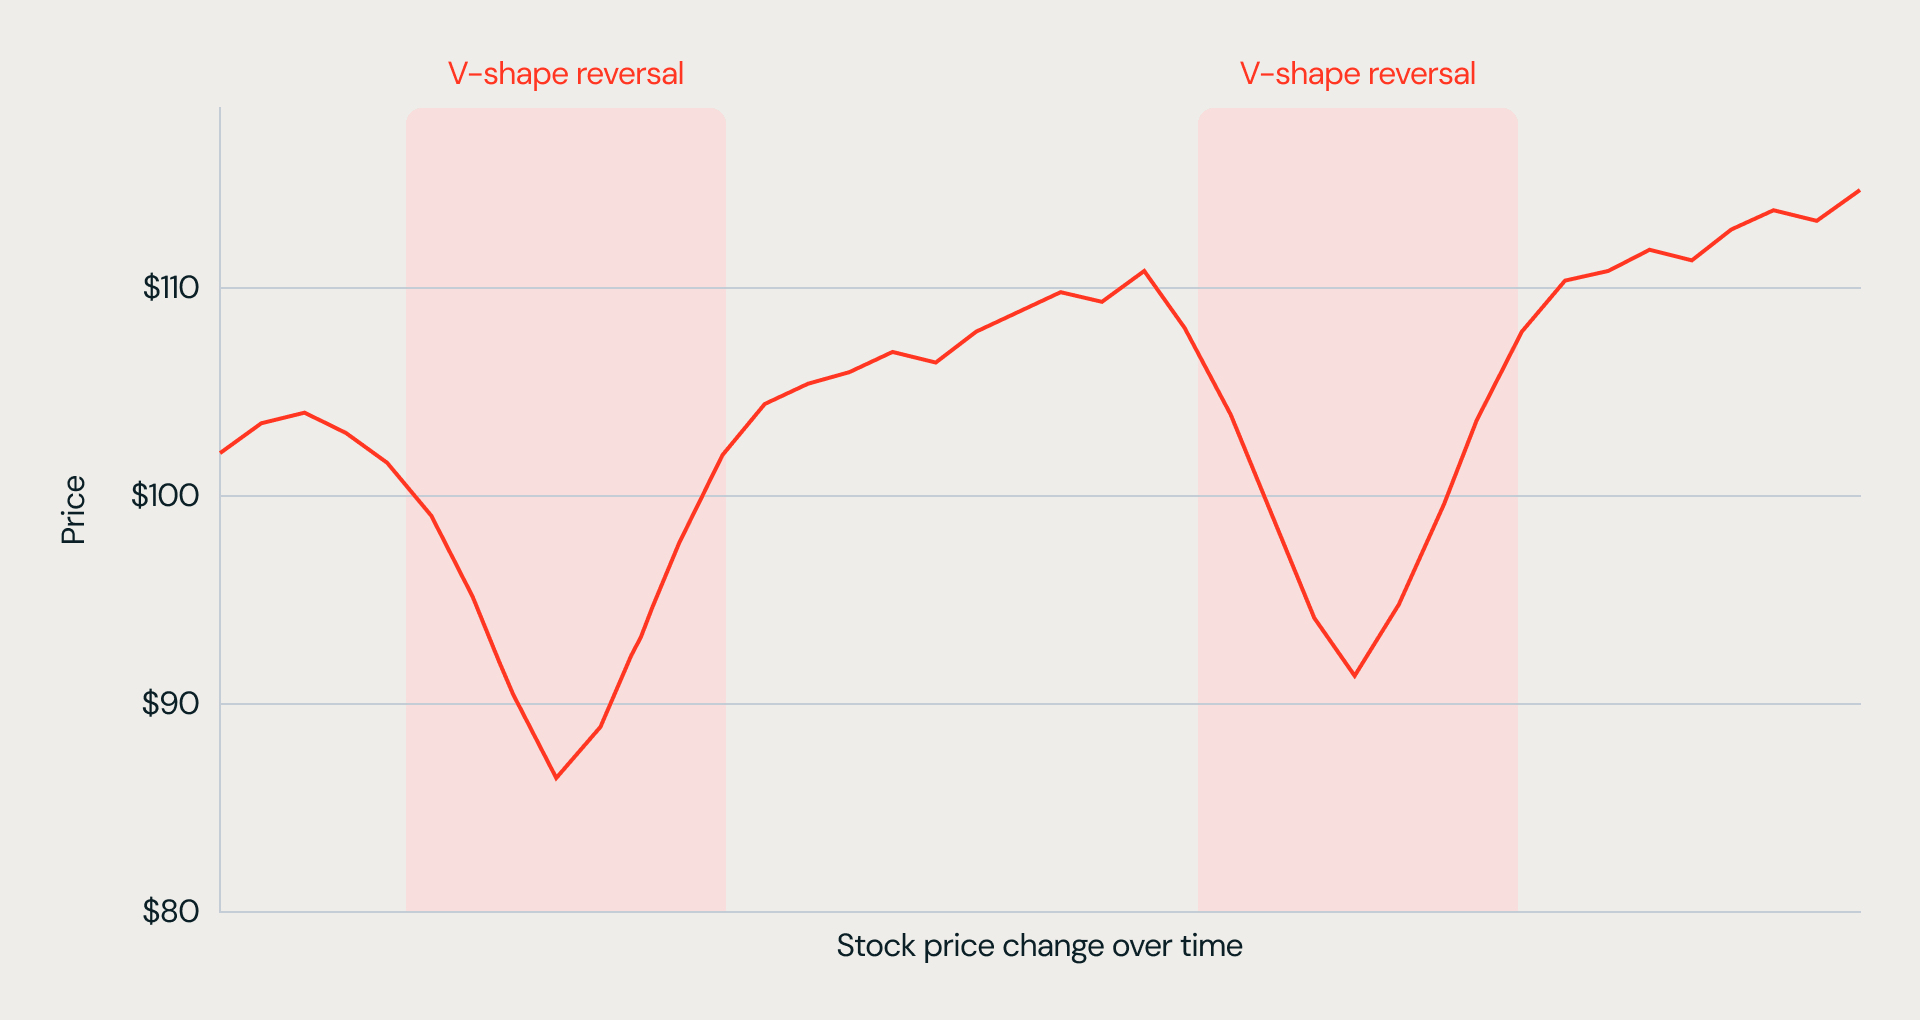
Jeder Marktdatenanalyst interessiert sich für Trendwenden, also Momente, in denen eine Aktie an Wert verliert und dann plötzlich wieder an Wert gewinnt. Diese Form ist als „V-Form“ bekannt. Um sie in Standard-SQL zu finden, muss man auf eine Technik namens „Gaps and Islands“ (Lücken und Inseln) zurückgreifen: Da SQL kein natives Konzept für einen Trend hat, müssen Sie Ihre Zeilen zuerst manuell in „Inseln“ aufteilen (aufeinanderfolgende Abschnitte, in denen sich der Preis in dieselbe Richtung bewegt), bevor Sie überhaupt fragen können, wo eine V-Form beginnt und endet.
In der Praxis bedeutet dies, dass Sie LAG und LEAD verwenden, um jede Zeile mit ihren Nachbarn zu vergleichen, einen laufenden Zähler erstellen, der sich bei jeder Richtungsänderung erhöht (sodass Sie eine Gruppen-ID für jede Insel erhalten), und dann HAVING-Filter schreiben, um die Form und die Grenzen jeder Insel zu bestätigen. Das ist eine Menge Aufwand, nur um eine einfache Frage zu beantworten: „Wo ist der Preis eingebrochen und hat sich wieder erholt?“
Die MATCH_RECOGNIZE-Klausel macht dieses Hilfskonstrukt überflüssig. Sie partitionieren die Daten einfach nach Symbol, sortieren sie nach Zeit und definieren die Form des V-Trends als eine Sequenz von Regex-ähnlichen Zuständen.
E-Commerce: Erkennung von Warenkorbabbrüchen

Produktmanager möchten Benutzer mit hoher Kaufabsicht finden, die den Kauf jedoch nie abschließen. Benutzer, die eine echte Kaufabsicht zeigen, dann aber inaktiv werden, sind ein wertvolles Signal. Die Identifizierung dieser Benutzergruppe kann dabei helfen: zu bestimmen, welchen Benutzern eine Erinnerung gesendet werden soll, das Potenzial und den Prozentsatz, der durch Folgemaßnahmen zurückgewonnen werden kann, leicht zu messen und im Vergleich zu anderen Benutzern in dieser Kohorte neue Erkenntnisse zu gewinnen (z. B. dass ein bestimmtes Produkt zu teuer ist). Ein wertvoller Trichter für abgebrochene Konversionen (Conversion Funnel) verfolgt Benutzer, die:
- Eine Produktseite zweimal oder öfter aufgerufen haben (VIEW 2 oder mehr Male, was auf großes Interesse hindeutet)
- Den Artikel in ihren Warenkorb gelegt haben (ADD_TO_CART)
- Letztendlich die Sitzung abgebrochen haben (unter Verwendung eines Zeitfilters)
Der letzte Schritt basiert nicht auf einem Wert, sondern auf einer Zeitspanne, die auf der Benutzeraktivität basiert. Es gibt keine „Abbruch“-Zeile für den Abgleich oder einen „Checkout-Fehler“ – der Benutzer hört einfach auf. Im traditionellen SQL beweisen Sie ein Negativ mit NOT EXISTS-Unterabfragen, Self-Joins und Fensterfunktionen, um zu zeigen, dass nach dem Hinzufügen der Artikel zum Warenkorb nichts mehr passiert ist und genügend Inaktivitätszeit vergangen ist, um den Warenkorb als abgebrochen zu betrachten.
MATCH_RECOGNIZE drückt „danach ist nichts mehr passiert“ direkt mit dem Ende-der-Partition-Anker $ aus, was dazu führt, dass das Hinzufügen zum Warenkorb das letzte aufgezeichnete Ereignis in der Sitzung ist. Fügen Sie einen Zeitfilter für das Inaktivitätsfenster hinzu, und Sie erhalten eine Timeout-basierte Abbruchregel ohne Self-Joins.
Fertigung / IoT: Vorhersage von Geräteausfällen anhand von Sensordaten

Vorausschauende Wartung basiert auf dem Erkennen von Trends und Mustern. Bei jeder genutzten Maschine neigt die Innentemperatur dazu, anzusteigen. Eine Abfolge von stetigem Temperaturanstieg gefolgt von einer Vibrationsspitze könnte jedoch auf einen bevorstehenden Ausfall hindeuten.
Traditionelles SQL erfordert fortlaufende Zeile-für-Zeile-Vergleiche, um kontinuierlich zu versuchen, einen gefährlichen Trend zu erkennen. MATCH_RECOGNIZE verarbeitet Zeile-für-Zeile-Logik nativ. Innerhalb der DEFINE-Klausel können Sie die Funktionen PREV und NEXT verwenden (die ähnlich wie LAG und LEAD funktionieren). Das bedeutet, dass das Einrichten einer Regel für steigende Temperaturen so einfach ist wie das Schreiben von temperature > PREV(temperature).
Testen Sie Match Recognize noch heute im Lakehouse
Es ist jetzt einfacher denn je, Datenmuster aufzudecken und die Analyse von Ereignissequenzen zu vereinfachen. MATCH_RECOGNIZE ermöglicht es Ihnen, auf logische Weise weniger Code für den Musterabgleich zu schreiben. Diese Klausel ist einfacher zu validieren, leichter zu warten und unkompliziert zu aktualisieren.
- Dokumentation erkunden: Tauchen Sie in die offizielle SQL-Referenz dokumentation ein, um mehr über fortgeschrittene Mustersyntax, Quantifizierer und Kennzahlenaggregate zu erfahren.
- In Ihrem Workspace ausprobieren: Testen Sie die obigen Beispiele an Ihren eigenen Log-Streams, Clickstream-Sitzungen oder Zeitreihen-Telemetriedaten in Databricks SQL oder Lakehouse//RT.
- Legacy-Pipelines migrieren: Identifizieren Sie Ihre komplexesten Fensterfunktionen und Self-Join-CTEs und lassen Sie sich von Genie Code dabei helfen, diese mit einfacheren MATCH_RECOGNIZE-Abfragen neu zu schreiben.
Das beste Data Warehouse ist ein Lakehouse. Unsere nativen Funktionen werden kontinuierlich erweitert und ermöglichen Ihnen leistungsstärkere Analysen auf einer einzigen, einheitlichen Plattform.
(Dieser Blogbeitrag wurde mit KI-gestützten Tools übersetzt.) Originalbeitrag
Erhalten Sie die neuesten Beiträge in Ihrem Posteingang
Abonnieren Sie unseren Blog und erhalten Sie die neuesten Beiträge direkt in Ihren Posteingang.