Skalierung und Betrieb eines großen dbt-Projekts auf Databricks: Das Datenteam von IFCO über Performance, Transparenz und Debugging
von Fernando Muñoz, Ludwig Brummer und Maxim Hammer
- Optimieren Sie inkrementelle dbt-Modelle so, dass bei jedem Durchlauf nur die geänderten Zeilen geschrieben werden. Nutzen Sie dazu Liquid Clustering, eine gezielte Merge-Strategie und Dynamic File Pruning. Dadurch wurde die Laufzeit des Kern-Jobs von IFCO um über 60 % verkürzt und der nächtliche vollständige Refresh überflüssig.
- Diagnostizieren Sie langsame Modelle anhand des tatsächlich ausgeführten Abfrageplans und nicht des kompilierten SQL, da dort die tatsächlichen Ursachen liegen. IFCO hat diese Diagnose in eine wiederholbare Methode verpackt, die für jedes Modell ausgeführt wird.
- Führen Sie das dbt-Projekt als einen Task pro Modell auf Databricks Jobs mit dem Open-Source-Tool databricks-dbt-factory aus, statt als einen einzigen undurchsichtigen Job. Dies bietet Sichtbarkeit pro Modell, gezielte Wiederholungen und erzwungene Tests.
Zusammenfassung
IFCO betreibt einen der weltweit größten Pools für Mehrwegverpackungen mit Hunderten von Millionen Kisten und Paletten. Mit über 2.000 Mitarbeitenden weltweit beschäftigt IFCO mehr als 350 Personen in Deutschland, von denen die meisten am globalen Hauptsitz in Pullach bei München arbeiten. Das Geschäftsmodell ist ein zirkulärer Pooling-Service: Mehrwegbehälter aus Kunststoff (RPCs) transportieren frische Produkte von Erzeugern und Verpackern zu Verteilzentren und Einzelhändlern und kehren dann in die IFCO Service Center zurück, um dort gereinigt, sortiert und erneut in über 50 Länder verschickt zu werden.
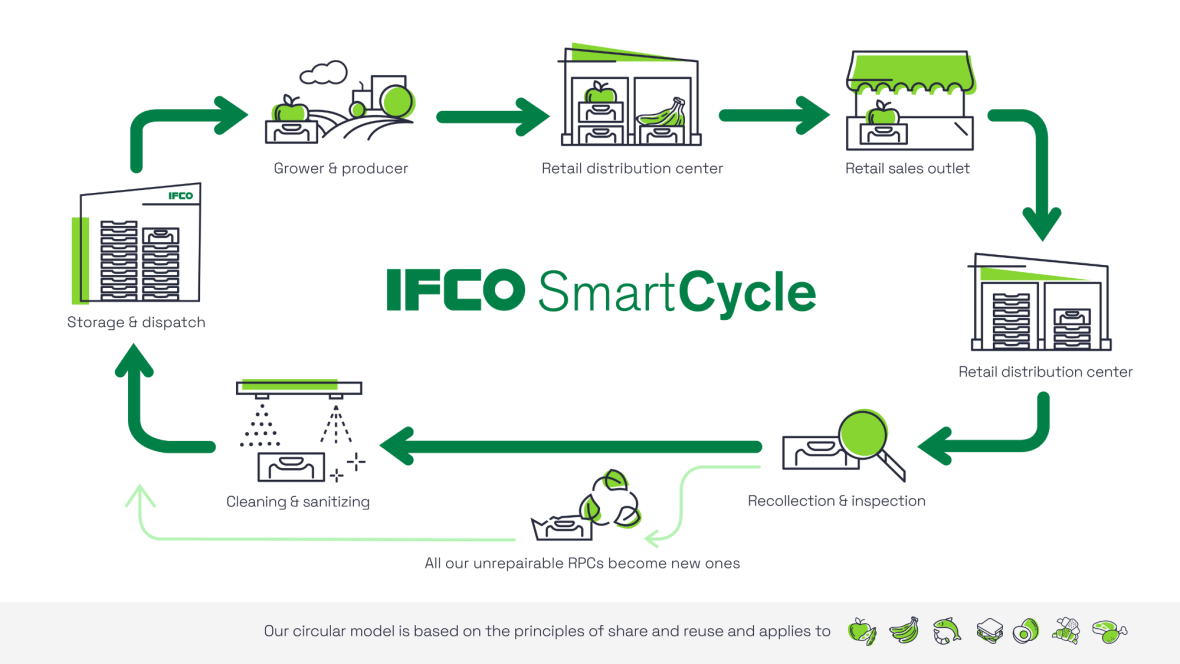
Jede Kiste und jede Palette wird über ihren gesamten Lebenszyklus hinweg nachverfolgt. Daraus speisen sich die KPIs, auf denen das Geschäft basiert: Umlaufzeit, Verlust, Bruch, Reinigungskosten und Poolgröße. Die Umwandlung von Milliarden roher Tracking-Ereignisse in vertrauenswürdige KPIs ist aus drei Gründen schwierig: Es gibt eine enorme Datenmenge, einige Daten kommen unvorhersehbar verspätet an, und wenn sie eintreffen, zwingen sie die Pipeline dazu, bereits gemeldete historische Daten zu korrigieren.
Dieser Beitrag zeigt, wie das Datenplattform-Team von IFCO in Zusammenarbeit mit dem Databricks Forward Deployed Engineering diese Pipeline schneller und kostengünstiger gemacht hat. Die Transformationslogik verbleibt in dbt. Sie läuft auf Databricks, wo jede inkrementelle Einstellung einem konkreten Delta Lake-Schreibverhalten entspricht: welche Spalten die Daten clustern, wie viel der Zieltabelle ein Schreibvorgang betreffen muss und ob Zeilen zusammengeführt oder ersetzt werden. Diese Einstellungen auf der richtigen Datengranularität korrekt vorzunehmen, verkürzte die tägliche Laufzeit des zentralen Semantic-Layer-Jobs um mehr als 60 Prozent und ermöglichte es IFCO, auf einen kostspieligen nächtlichen Full Refresh zu verzichten.
IFCO und die Art des Datenproblems
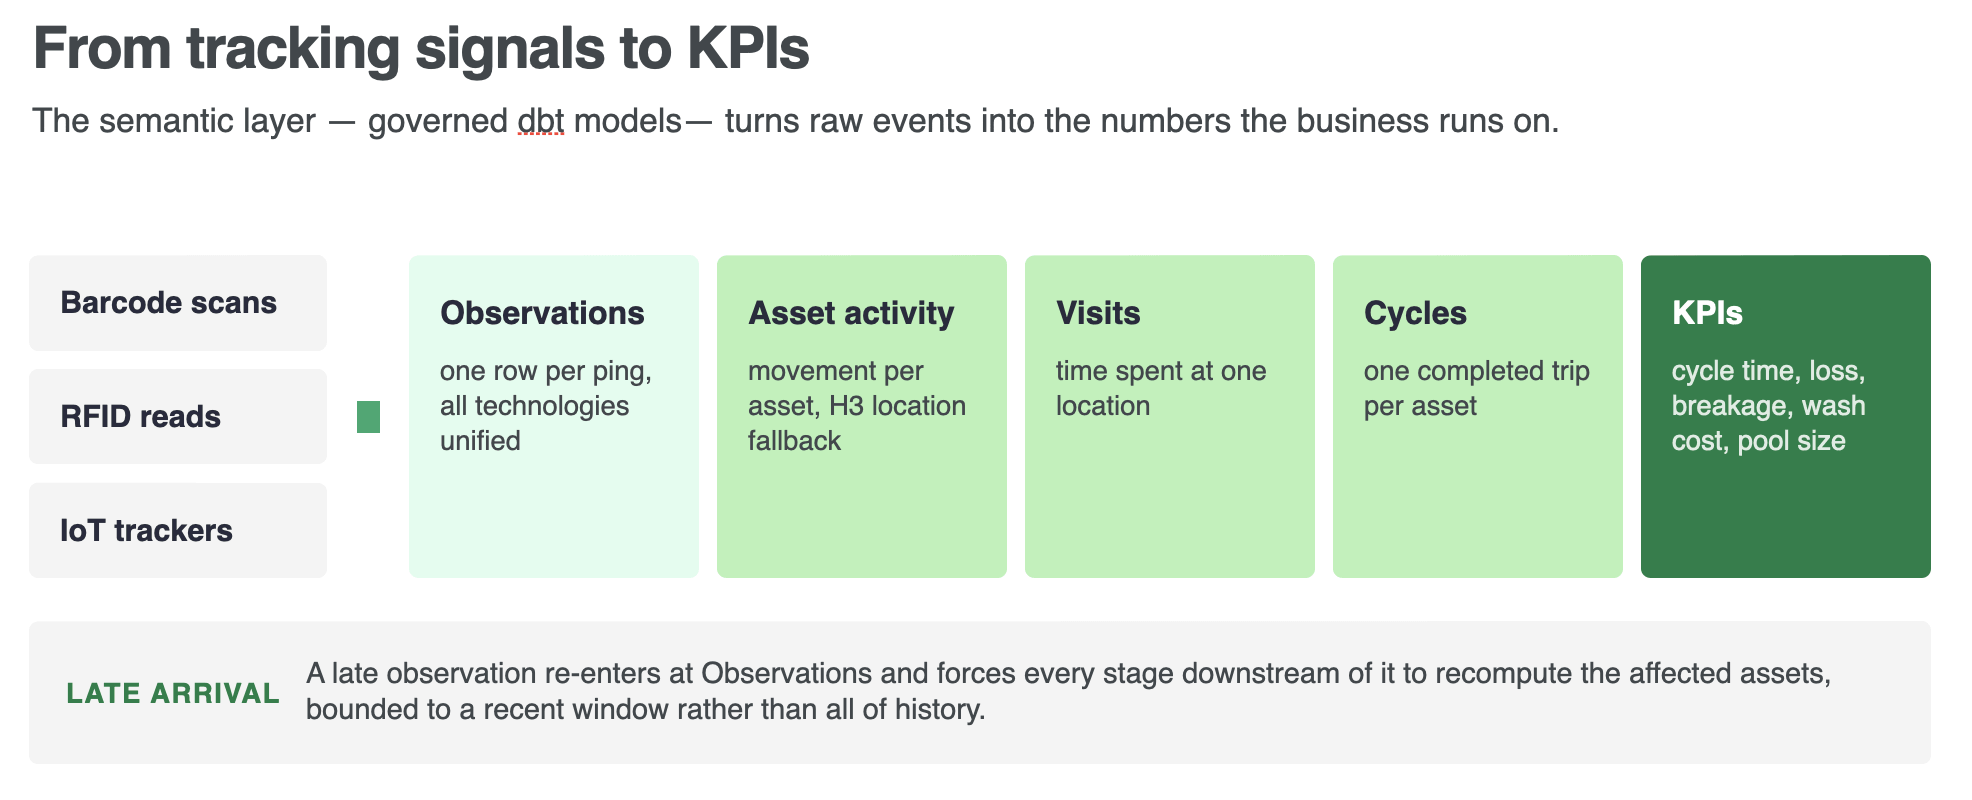
Eine Kiste wird im Laufe eines Jahres viele Male kommissioniert, befüllt, versandt, zurückgegeben, gewaschen und wiederverwendet. Daher muss IFCO wissen, wo sich jedes Asset befindet und was damit geschehen ist. IFCO hat einen Semantic Layer eingeführt, der viele verschiedene Tracking-Signale in einer einheitlichen, kontrollierten Ansicht der Asset-Aktivitäten zusammenführt: Barcode-Scans beim Durchlaufen der Waschanlage, RFID-Erfassungen an den Toren der Laderampen und batteriebetriebene Tracker, die die GPS-Position, Bluetooth-Beacons in der Nähe und die Temperatur melden. (In diesem Beitrag bezieht sich „Semantic Layer“ auf diese kontrollierten dbt-Modelle, die rohe Tracking-Ereignisse in geschäftliche KPIs umwandeln.) Drei Eigenschaften machen dies schwierig.
- Skalierung. Täglich gehen Milliarden von Tracking-Ereignissen ein. Durch die Konsolidierung werden die wiederholten Pings jedes Assets auf weitaus weniger Aktivitätszeilen reduziert, aber die Tabellen, aus denen die KPIs gelesen werden, sind immer noch so groß, dass ein vollständiger Neuaufbau extrem teuer ist.
- Unvorhersehbare verspätete Daten. Die meisten Beobachtungen treffen innerhalb eines erwarteten Zeitfensters ein, aber einige Feeds hinken ohne festen Zeitplan um Wochen, manche sogar um Monate hinterher. Eine Pipeline, die davon ausgeht, dass die heute vorliegenden Daten das vollständige Bild von gestern darstellen, wird unbemerkt fehlerhafte historische Daten liefern.
- Historischer Abgleich. Die Asset-Aktivität ist eine Sequenz, daher füllt eine verspätete Beobachtung nicht einfach nur eine Lücke. Fügt man einen Scan mitten in den Zeitverlauf eines Assets ein, ändert sich alles, was die Pipeline bereits für die Zeit danach ermittelt hat: wohin das Asset als Nächstes transportiert wurde, wann sein Zyklus begann und in welche KPI-Kategorie es fiel. Ein verspätetes Eintreffen zwingt die Pipeline daher dazu, den bereits veröffentlichten Zustand neu zu berechnen, anstatt einfach eine neue Zeile anzuhängen. Das Ziel besteht darin, schnell eine gute Schätzung abzugeben und diese an die Realität anzupassen, sobald verspätete Daten eintreffen, ohne jede Nacht alles neu verarbeiten zu müssen.
Inkrementelle Verarbeitung in großem Maßstab
Ein inkrementelles dbt-Modell besteht im Grunde aus einer Reihe von Delta-Lese- und Schreibverhalten. Der größte Gewinn resultierte aus einem einzigen Prinzip: Jeder Durchlauf sollte so wenige Zeilen wie möglich betreffen und diese so früh wie möglich herausfiltern. Der erste und wichtigste Hebel ist der Lesevorgang selbst, bei dem nur die Dateien und die geänderten Assets gescannt werden, die für einen Durchlauf tatsächlich benötigt werden. Denn jede Zeile, die nicht gelesen werden muss, muss später auch nicht zeit- und kostenintensiv sortiert, geshuffelt und geschrieben werden. Jede der folgenden Techniken ist eine gewöhnliche dbt-Konfiguration, die in ein bestimmtes Delta-Verhalten übersetzt wird.
Clustern Sie nach den Spalten, nach denen Sie filtern und joinen. Liquid Clustering, das auf die Granularität abgestimmt ist, nach der jedes Modell abgefragt wird (bei Asset-Aktivitäten das Asset und das Ereignisdatum), ermöglicht es der Engine, Dateien zu überspringen, anstatt sie zu scannen. Erst dadurch funktionieren die nächsten beiden Techniken.
Wählen Sie die inkrementelle Strategie bewusst aus. Die Strategie bestimmt, wie jeder Durchlauf schreibt. Die Entscheidung hängt von zwei Fragen ab: Hat jede Zeile einen stabilen Schlüssel, und aktualisieren Sie Zeilen direkt (in-place) oder ersetzen Sie eine ganze Gruppe auf einmal? Für schlüsselbasierte Upserts mit hohem Deduplizierungsaufwand ist Merge der Standard. Basierend auf der tatsächlichen Granularität (für Asset-Aktivitäten asset_id und event_date_time) leistet dies zwei Dinge, die ein Bulk-Delete-and-Reinsert nicht kann:
Das Equi-Join-Prädikat aktiviert das dynamische File Pruning: Die Schlüsselwerte im eingehenden Batch überspringen Zieldateien, die keine Übereinstimmung enthalten können, sodass der Schreibvorgang nur den Bereich betrifft, der tatsächlich geändert wird. (DBT_INTERNAL_DEST and DBT_INTERNAL_SOURCE sind die Aliase von dbt für die Zieltabelle und den eingehenden Batch in der generierten Anweisung.) Das Clustern nach denselben Schlüsseln, auf die der Merge abgestimmt ist, sorgt für ein präzises Pruning. Ein Row-Hash-Schutz, ein matched_condition, der einen Surrogat-Hash jeder Zeile vergleicht und das erneute Schreiben von Zeilen überspringt, die sich nicht geändert haben, spart Schreibvorgänge und hält den nachgelagerten Change Feed sauber.
delete+insert ist die Alternative: Es löscht eine gesamte Gruppe von Zeilen anhand des Schlüssels und fügt sie neu ein. Das ist einfacher, wenn ein Durchlauf eine Gruppe als Einheit neu ableitet und die Zeilen keine stabile Identität für einen Abgleich aufweisen – allerdings um den Preis, dass die Gruppe auch dann neu geschrieben wird, wenn sich nichts geändert hat. Bei sehr großen Datenmengen lohnt es sich, beide Ansätze per Benchmark zu vergleichen, anstatt bloße Annahmen zu treffen.
Begrenzen Sie den Schreibvorgang auf ein aktuelles Zeitfenster. Derselbe Prädikatsmechanismus hat noch einen zweiten Nutzen. Anstelle eines Equi-Joins für das File Pruning schränkt eine Zeitbegrenzung den Schreibvorgang auf aktuelle Daten ein. Bei den volumenstärkeren vorgelagerten Modellen gleicht MERGE den Vorgang also mit einem aktuellen Ausschnitt des Ziels ab und nicht mit der gesamten Tabelle:
Da das Prädikat darauf basiert, wann eine Zeile aufgenommen wurde (Ingestion) und nicht, wann das Ereignis stattgefunden hat, wird ein Monate altes Ereignis immer noch erfasst, solange es vor Kurzem eingegangen ist. Das Zeitfenster muss lediglich groß genug sein, um die Spanne zwischen dem Eintreffen der Daten und der Verarbeitung durch diesen Job abzudecken. Wird es zu eng gewählt, werden verspätete Daten unbemerkt übersprungen: Es tritt kein Fehler auf, sie werden einfach nie verarbeitet.
Berechnen Sie nur das neu, was sich geändert hat. Modelle beschränken ihre Arbeit auf die Assets, die von neuen oder verspäteten Daten betroffen sind (identifiziert über ein Ingestion Watermark), und lesen ein größeres Zeitfenster, als sie schreiben. So werden verspätete Ereignisse ohne einen Full Refresh erfasst.
Halten Sie Delta ordentlich. Bei stark beanspruchten inkrementellen Tabellen sollten optimierte Schreibvorgänge (Optimized Writes) und Auto-Compaction aktiviert werden, oder die Tabellenpflege wird an Predictive Optimization übergeben. So hinterlassen häufige Merges keine Leistungseinbußen durch zu viele kleine Dateien.
Die Kunst besteht darin, diese Methoden auf der richtigen Granularität anzuwenden und anschließend anhand des tatsächlichen Abfrageplans (Query Plan) zu überprüfen, ob die Engine wirklich ein Pruning durchführt, anstatt unbemerkt alles zu scannen.
Ein konkretes Beispiel: Konsolidierung von Beobachtungen in Asset-Aktivitäten
Das am stärksten beanspruchte Modell im Semantic Layer ist dasjenige, das die Beobachtungen aller Tracking-Technologien in einem einzigen, standortbezogenen Stream pro Asset konsolidiert. Es ermittelt mithilfe von Window-Funktionen (partitioniert nach Asset und sortiert nach Ereigniszeit), wann sich ein Asset tatsächlich bewegt hat. Wenn eine Beobachtung keinen expliziten Standort enthält, greift es auf die integrierten H3-Funktionen von Databricks SQL zurück. Diese weisen jeden Breitengrad/Längengrad einer hexagonalen Rasterzelle zu, sodass der „gleiche Ort“ zu einem einfachen Vergleich von Zellen-IDs und deren Rasterentfernung wird, anstatt wiederholt komplexe geografische Distanzberechnungen durchzuführen. Dies war mit großem Abstand der größte Einzelfaktor bei der Laufzeit.
Der erste Schritt bestand nicht im Optimieren, sondern darin, zu analysieren, was tatsächlich ausgeführt wurde – und dieser Unterschied ist entscheidend. dbt compile rendert die SELECT eines Modells mit aufgelösten Referenzen (Refs), aber bei einem inkrementellen Modell ist dies nicht die Anweisung, die Databricks tatsächlich ausführt. Hinter diesem kompilierten SELECT generiert und führt dbt eine größere Operation aus: temporäre Views, Scans der Zieltabelle und das abschließende Zurückschreiben in die Tabelle. Der einzige Weg, um herauszufinden, wo Zeit und Arbeitsspeicher verbraucht werden, besteht darin, den tatsächlich ausgeführten Abfrageplan Schritt für Schritt aus dem Abfrageverlauf (Query History) zu lesen, anstatt das kompilierte SQL zu analysieren.
So betrachtet war das Ergebnis des Abfrageplans vernichtend. Das Modell scannte Milliarden von Zeilen, lagerte Hunderte von Gigabyte auf die Festplatte aus (Spilling) und verbrachte etwa 85 Prozent seiner Zeit mit einem einzigen Window-Sort- und Shuffle-Vorgang pro Asset. Im Grunde wurde bei jedem Durchlauf die gesamte Tabelle neu aufgebaut. Dies hatte drei Ursachen:
- Die Menge der „geänderten“ Assets wurde nie kleiner. Ein Upstream-Zeitstempel wurde bei jedem Durchlauf neu generiert, anstatt von der Quelle durchgereicht zu werden, sodass fast jedes Asset neu aussah. Wenn alles als geändert gilt, wird ein inkrementeller Durchlauf unbemerkt zu einem vollständigen Refresh.
- Die Neuberechnung pro Asset war unbegrenzt. Die Fensterfunktionen blickten in der Historie jedes Assets ganz zurück, sodass selbst eine tatsächlich kleine Menge geänderter Daten jahrelange Historie durch die Sortierung schleppte.
- Die Fensterstufe berechnete Spalten, die von der finalen Abfrage nie verwendet wurden, einschließlich eines zweiten, vorausschauenden Fensters, dessen gesamte Ausgabe verworfen wurde.
Jede Behebung ergibt sich direkt aus ihrer Ursache: den echten Ingestion-Zeitstempel durch die Upstream-Modelle durchreichen, damit die geänderte Menge tatsächlich neue Daten widerspiegelt, die Neuberechnung auf ein aktuelles Fenster begrenzen, die ungenutzten Spalten und das vorausschauende Fenster verwerfen, nach der Granularität clustern, nach der das Modell abgefragt wird, und schließlich den gesamten Graphen als parallele, modellspezifische Tasks auf Serverless-Compute ausführen (siehe nächster Abschnitt). Zusammen verkürzten diese Maßnahmen die Laufzeit des Kern-Jobs um mehr als 60 Prozent (fast zwei Drittel) und machten den nächtlichen vollständigen Refresh überflüssig, der zuvor erforderlich war, um die KPIs korrekt zu halten.
Von einer Debugging-Session zu einem wiederholbaren Skill
Die obige Diagnose – den tatsächlich ausgeführten Plan anstelle des kompilierten SQL lesen, die Lese- und Schreibseite überprüfen, jedes Symptom auf eine Ursache zurückführen – ist nicht spezifisch für das Konsolidierungsmodell. Es ist ein Ablauf, den jeder Engineer bei jedem langsamen inkrementellen Modell auf Databricks durchführen würde. Dieser Ablauf wird als Skill verpackt: ein Playbook, das ein AI-Agent bei Bedarf ausführt, sodass die Diagnose mit der Anzahl der Modelle skaliert und nicht mit der Anzahl der Engineers, die sich an die Durchführung erinnern.
Der Skill spiegelt das ausgearbeitete Beispiel Schritt für Schritt wider. Er ruft die tatsächliche Anweisungsfamilie aus dem Abfrageverlauf ab, nicht die Ausgabe von dbt compile, da dies bei einem inkrementellen Modell unterschiedliche Anweisungen sind. Er liest beide Seiten des Durchlaufs: Scan-seitige Metriken (ausgeschlossene Dateien, gelesene Zeilen, Spill) und Schreib-seitige Metriken (geschriebene vs. gelöschte Zeilen), da sich eine Amplifikation nur auf der Schreibseite zeigt. Anschließend prüft er auf dieselben drei Fehlerklassen wie im Konsolidierungsmodell: eine Menge geänderter Daten, die nie schrumpft (ein Upstream-Zeitstempel, der neu generiert statt durchgereicht wird), eine unbegrenzte Neuberechnung pro Asset (ein Fenster ohne Lookback-Limit) und unnötige Arbeit (Spalten oder Fensterdurchläufe, die berechnet, aber im Downstream nie gelesen werden). Jede Prüfung basiert auf einer Metrik oder einem Plansignal, nicht auf einer Vermutung.
Das Ergebnis ist ein Bericht, keine stille Behebung: Jedes Ergebnis wird mit Belegen (gescannte Zeilen, Spill-Bytes, Planknoten) und einer vorgeschlagenen Änderung aufgeführt, und es wird nichts auf ein Modell angewendet, bis es genehmigt wurde. Nach der Genehmigung werden dieselben Vorher-Nachher-Metriken, mit denen die Behebung begründet wurde, beim nächsten Durchlauf erneut gemessen. So schließt der Skill den Kreis, anstatt einfach davon auszugehen, dass die Behebung erfolgreich war.
Der Gewinn ist Konsistenz, nicht Neuartigkeit. Die drei Ursachen für die Laufzeit des Konsolidierungsmodells waren gewöhnlich und unter Last leicht zu übersehen (ein neu generierter Zeitstempel, ein unbegrenztes Fenster, ungenutzte Spalten). Die Ausführung eines Skills zu deren Erkennung kostet praktisch nichts und findet dieselbe Art von Problem beim nächsten Modell, bevor es zu einem Laufzeitproblem von 60 Prozent wird, das eskaliert werden muss.
Ausführen eines großen dbt-Projekts auf Databricks Jobs
Databricks Workflows (Lakeflow Jobs) behandelt dbt als erstklassigen Task-Typ: Ein dbt-Projekt kann neben Ingestion- und Downstream-Schritten in einem einzigen kontrollierten Workflow geplant, ausgeführt und überwacht werden, mit gemeinsamen Wiederholungsversuchen und Benachrichtigungen. Die einfachste Version führt das gesamte Projekt als einen einzigen dbt-Task aus. Das funktioniert, ist aber eine Blackbox: Wenn ein Modell fehlschlägt, schlägt der gesamte Job fehl, ohne dass einzelne Modelle eingesehen, erneut ausgeführt oder überwacht werden können. Bei dieser Größenordnung ist das ein betriebliches Risiko.
Die Lösung besteht darin, den dbt-Graphen als einzelne Databricks-Tasks auszuführen – einen pro Modell, Test, Seed und Snapshot. IFCO generiert diesen Graphen mit databricks-dbt-factory, einer eigenständigen Open-Source-Bibliothek (MIT-lizenziert, auf GitHub and PyPI). Sie liest das dbt-Manifest und ein Job-Template ein und erstellt einen Databricks Asset Bundle-Job mit einem Task pro Knoten. Eine Granularität auf Task-Ebene zahlt sich nur aus, wenn jeder Task schnell und kostengünstig startet, was auf drei Mechanismen zurückzuführen ist:
- Notebook-Task-Typ. Ein kleines, gemeinsam genutztes Runner-Notebook triggert dbt über dessen Python-API. dbt erstellt das SQL und sendet es an das SQL-Warehouse, sodass die Notebook-Compute-Ressource keine Daten verarbeiten muss.
- Basisumgebungen. Eine Basisumgebung ist ein vorkonfigurierter Snapshot einer serverlosen Python-Umgebung. Diese enthält bereits
dbt-databricks, sodass jeder Task darauf aufbaut und die pip-Installation überspringt, die bei einem neuen Task anfallen würde. - Manifest-Injektion. Ein vorkonfiguriertes Manifest wird direkt an dbt übergeben, sodass das Parsing übersprungen wird, und jeder Task schreibt Artefakte in ein privates lokales Verzeichnis. Bei einem großen Projekt, das von vielen Tasks gleichzeitig ausgeführt wird, macht dies den Unterschied zwischen minutenlangem erneuten Einlesen des Projekts und produktiver Arbeit aus.
Da der Overhead gering gehalten wird, bietet der Fan-out dem Betrieb genau das, was er braucht: Transparenz auf Task-Ebene, gezielte Wiederholungen nur des fehlgeschlagenen Modells und seiner Abhängigkeiten, modellspezifisches Logging, Alerting und Testing sowie einen erweiterbaren Runner (Secrets laden, einen Durchlauf mit einem Git-SHA taggen oder mit wenigen Zeilen auf Slack posten). Alles wird als Databricks Asset Bundles über eine pfadsensitive GitHub Actions-Matrix bereitgestellt. Die Laufzeit und die Kosten pro Modell werden über Query-Tags und Systemtabellen in einem Dashboard mit Alerts nachverfolgt, sodass eine Regression innerhalb eines Tages auffällt und nicht erst auf der Monatsrechnung.
Testing und Qualität im großen Stil
Effizienz ist wertlos, wenn sie unbemerkt die Zahlen verfälscht. Deshalb wird Qualität erzwungen und nicht nur erhofft. Jedes Modell hat einen Owner und einen Eindeutigkeitstest. Primärschlüssel werden auf Eindeutigkeit und „Not Null“ mit Fehler-Schweregrad getestet. Modelle mit komplexer Logik (Fensterfunktionen, mehrere Joins, anspruchsvolle Makros) erfordern Unit-Tests. dbt-bouncer blockiert Commits, die dagegen verstoßen, zusammen mit sqlfluff für den Databricks-Dialekt, und Verträge (Contracts) werden auf den Ebenen erzwungen, die von externen Konsumenten gelesen werden.
Dieselbe Disziplin gilt für die Kosten des Testens selbst. Prüfungen von Views werden materialisiert oder in weniger Durchläufe zusammengefasst, da eine View-basierte Prüfung die View bei jedem Durchlauf neu berechnet – grundlegende Prüfungen werden zu Spalten-Constraints und Tests werden auf inkrementelle Daten beschränkt. Lokal greifen Entwickler auf ein Produktionsmanifest zurück, sodass nur geänderte Modelle erstellt werden, während Upstreams aus der Produktion gelesen werden. In der CI werden Unit-Tests und Tests mit Stichprobendaten für die geänderten Modelle vor dem Merge ausgeführt.
Benchmarking
| Metrik | Vorher | Nachher |
|---|---|---|
| Tägliche Laufzeit, Kern-Job | ≈ 7 Stunden | 2 Std. 20 Min., ca. 66 % weniger |
| Nächtlicher vollständiger Refresh | erforderlich, um KPIs korrekt zu halten | eingestellt |
| Gescannte Zeilen pro Durchlauf, Konsolidierungsmodell | ≈ 25 Milliarden (und täglich steigend) | -75 % gescannte Zeilen |
| Tägliche Compute-Kosten | Um 58 % reduziert | |
| Neu berechnete Assets pro Durchlauf | fast der gesamte Pool | ≈ 3–5 % des Pools |
Wie geht es weiter
Die Pipeline läuft heute im Batch-Betrieb: Die Ingestion erfolgt einmal täglich, und der Semantic Layer baut darauf auf, liefert eine erste Schätzung und nähert sich dem Endwert an, sobald verspätete Daten eintreffen. Drei während des Projekts empfohlene Arbeitsschritte würden dies weiter vorantreiben und den Weg für KPIs in Fast-Echtzeit ebnen.
- Nur Änderungen verarbeiten mit Change Data Feed. Der Change Data Feed von Delta ermöglicht es einem Downstream-Modell, nur die Zeilen zu lesen, die sich im Upstream geändert haben, anstatt die Eingaben erneut zu scannen. Auf das Konsolidierungsmodell und seine Abhängigkeiten angewendet, reduziert dies den Abgleichaufwand von „ein aktuelles Fenster scannen“ auf „genau die verschobenen Zeilen verarbeiten“ – der logische nächste Schritt nach der Begrenzung der Neuberechnung.
- Ingestion mit geringerer Latenz. Das einmal tägliche Laden kann auf einen Streaming-Ingestion-Pfad umgestellt werden, etwa mit Auto Loader oder einem Lakeflow Connect-Konnektor mit geringer Latenz, ohne dass Downstream-Komponenten neu strukturiert werden müssen. Das allein verkürzt die Aktualisierungszeit von einem Tag auf wenige Minuten.
- Deklarative Streaming-Transformationen. Dieselbe Transformationslogik kann kontinuierlich als Lakeflow Declarative Pipeline ausgeführt werden, die einen Stream liest, anstatt als nächtlicher Batch. Dabei übernimmt eine zustandsbehaftete Verarbeitung den Abgleich pro Asset, sobald Events eintreffen.
Die entscheidende Frage ist der geschäftliche Bedarf, nicht die Technologie. Wenn eine Metrik tatsächlich innerhalb von Minuten statt erst am nächsten Morgen aktuell sein muss, liefert dieser Pfad sie auf denselben kontrollierten Tabellen mit derselben dbt-definierten Logik. Wenn ein täglicher Refresh ausreicht, ist die Batch-Pipeline bereits die kostengünstigere Lösung.
Fazit
Die Struktur der Lösung basiert auf einer klaren Arbeitsteilung. Die Transformationslogik bleibt in dbt – modular und getestet –, während die Daten im offenen Delta Lake-Format unter einem einheitlichen Unity Catalog-Governance-Modell verbleiben. So überstehen Lineage und Zugriffskontrollen jeden Tabellen-Rebuild, und nichts ist an eine einzelne Query-Engine gebunden. Diese dbt-Logik kompiliert direkt zu den auf Skalierbarkeit ausgelegten Databricks-Funktionen: Liquid Clustering, inkrementelle Delta-Schreibvorgänge, Dynamic File Pruning und H3-Geofunktionen. Führen Sie Diagnosen auf Basis des tatsächlichen Abfrageplans statt des kompilierten SQLs durch, reduzieren Sie die Anzahl der Zeilen, die die kostenintensiven Sortierungen und Shuffles erreichen, und führen Sie das Projekt als Task-Graph pro Modell aus, damit der Betrieb volle Transparenz und sichere Wiederholungen bei minimalem Overhead erhält. Die größten Erfolge resultierten nicht aus größeren Clustern, sondern daraus, dass weniger Arbeit anfiel: weniger Zeilen verarbeiten, weniger Assets neu berechnen und die Tabelle weitaus seltener neu erstellen.
(Dieser Blogbeitrag wurde mit KI-gestützten Tools übersetzt.) Originalbeitrag
Erhalten Sie die neuesten Beiträge in Ihrem Posteingang
Abonnieren Sie unseren Blog und erhalten Sie die neuesten Beiträge direkt in Ihren Posteingang.