Vereinheitlichung der Governance über Engines und Kataloge hinweg im Open Lakehouse
Wie zwei neue Spezifikationen von Apache Iceberg™ Governance so portabel machen wie Ihre Daten
von Daniel Weeks, Ryan Blue und Andrei Tserakhau
- Lesebeschränkungen und Katalog-Labels sind zwei neue Spezifikationen von Apache Iceberg™, die dabei helfen, die Durchsetzung von Richtlinien über verschiedene Engines und Kataloge hinweg zu standardisieren.
- Beide Erweiterungen beseitigen eine fragmentierte Durchsetzung. Lesebeschränkungen delegieren Entscheidungen an vertrauenswürdige Engines; Katalog-Labels machen Governance-Metadaten über föderierte Kataloge hinweg portabel.
- Es gibt nun ein klares Modell für jedes Zugriffsmuster: zentralisierte Durchsetzung für nicht vertrauenswürdige Engines, Lesebeschränkungen für vertrauenswürdige Engines und Katalog-Labels für die Katalog-zu-Katalog-Föderation.
In unseren vorherigen Beiträgen haben wir gezeigt, wie offene Tabellenformate, offene APIs und eine einheitliche Governance zusammenwirken, um die Vision des Open Lakehouse zu vervollständigen. Wir haben auch die engine-übergreifende attributbasierte Zugriffskontrolle eingeführt, mit der in Unity Catalog definierte Richtlinien konsistent durchgesetzt werden können, wenn externe Engines auf verwaltete Daten zugreifen.
Nun beginnt diese Vision in der Open-Source-Welt Gestalt anzunehmen. Die Apache Iceberg™-Community hat kürzlich zwei wichtige Erweiterungen für den Iceberg REST Catalog auf den Weg gebracht: Leseeinschränkungen und Katalog-Labels. Zusammen lösen sie zwei unterschiedliche Herausforderungen: die Delegierung der Durchsetzung an eine externe Engine und die Portabilität des Governance-Kontexts über verschiedene Kataloge hinweg.
In diesem Beitrag werfen wir einen genaueren Blick auf beide neuen Erweiterungen der Spezifikation: wie sie funktionieren, welche zentralen Herausforderungen sie lösen, welche zukünftigen Innovationsmöglichkeiten sie bieten und wann man sie einsetzt.
Leseeinschränkungen: Standardisierung der delegierten Durchsetzung
Leseeinschränkungen adressieren ein häufiges Engine-zu-Katalog-Szenario: Ein Unternehmen verwaltet Daten in einem Katalog und möchte diese über verschiedene Engines oder Tools abfragen.
Für jede verwaltete Abfrage müssen drei Dinge geschehen:
- Der Katalog empfängt die anfragende Identität und den relevanten Kontext, wie z. B. Subjekte, Gruppen, Rollen oder sogar Identitätsattribute wie „Region“
- Er wertet die Richtlinie aus, um zu entscheiden, ob der Benutzer die Tabelle lesen darf und welche Zeilenfilter oder Spaltenmasken gelten.
- Eine vertrauenswürdige Compute-Ebene setzt diese Entscheidung beim Lesen der Daten durch.
Wenn über eine Engine auf Daten zugegriffen wird, können diese Aufgaben auf zwei Arten aufgeteilt werden.
Bei der zentralisierten Durchsetzung verbleiben alle drei Schritte in der Umgebung des Katalogs. Beispielsweise implementiert Databricks eine feingranulare Zugriffskontrolle auf dedizierten Compute-Ressourcen, indem Abfragen transparent über eine sichere Filter-Fleet geleitet werden. Und die Funktion Cross-Engine-ABAC von Unity Catalog erweitert diese Governance auf andere Engines, indem sie die Filter-Fleet hinter die Scan-/Plan-APIs des Iceberg REST-Katalogs schaltet, um Daten zu bereinigen, bevor eine externe Engine wie Apache Spark1 oder DuckDB das Ergebnis verarbeitet.
Bei der delegierten Durchsetzung empfängt der Katalog die anfragende Identität, wertet die Richtlinie aus und gibt die resultierenden Zeilen- und Spaltenbeschränkungen an eine Engine zurück, der er vertraut, diese durchzusetzen. Vertrauen bedeutet hier, dass sich der Katalog darauf verlassen kann, dass die Engine die Einschränkungen durchsetzt und verhindert, dass Benutzer sie umgehen. Engines wie Apache Spark und DuckDB gelten als nicht vertrauenswürdig, wenn Benutzer die Laufzeitumgebung kontrollieren, da diese Benutzer beliebigen Code ausführen oder direkt auf die zugrunde liegenden Daten zugreifen können. Eine sicher konfigurierte Trino-Bereitstellung ist ein Beispiel für eine vertrauenswürdige Engine, da sie eine native Durchsetzung von Zeilenfiltern und Spaltenmasken bietet.
Die delegierte Durchsetzung erfordert einen gemeinsamen Vertrag zwischen dem Katalog und der Engine. Die Iceberg-Community hat Leseeinschränkungen eingeführt, um diesen Vertrag bereitzustellen.
Wie Leseeinschränkungen funktionieren
Wenn ein Reader eine Tabelle über den Iceberg REST Catalog lädt, wertet der Katalog die geltenden Richtlinien für den anfragenden Principal und den Anfragekontext aus. Er kann erforderliche Spaltenprojektionsaktionen und Zeilenfilterausdrücke zurückgeben, und die vertrauenswürdige Engine muss diese Einschränkungen beim Lesen der Tabelle anwenden.
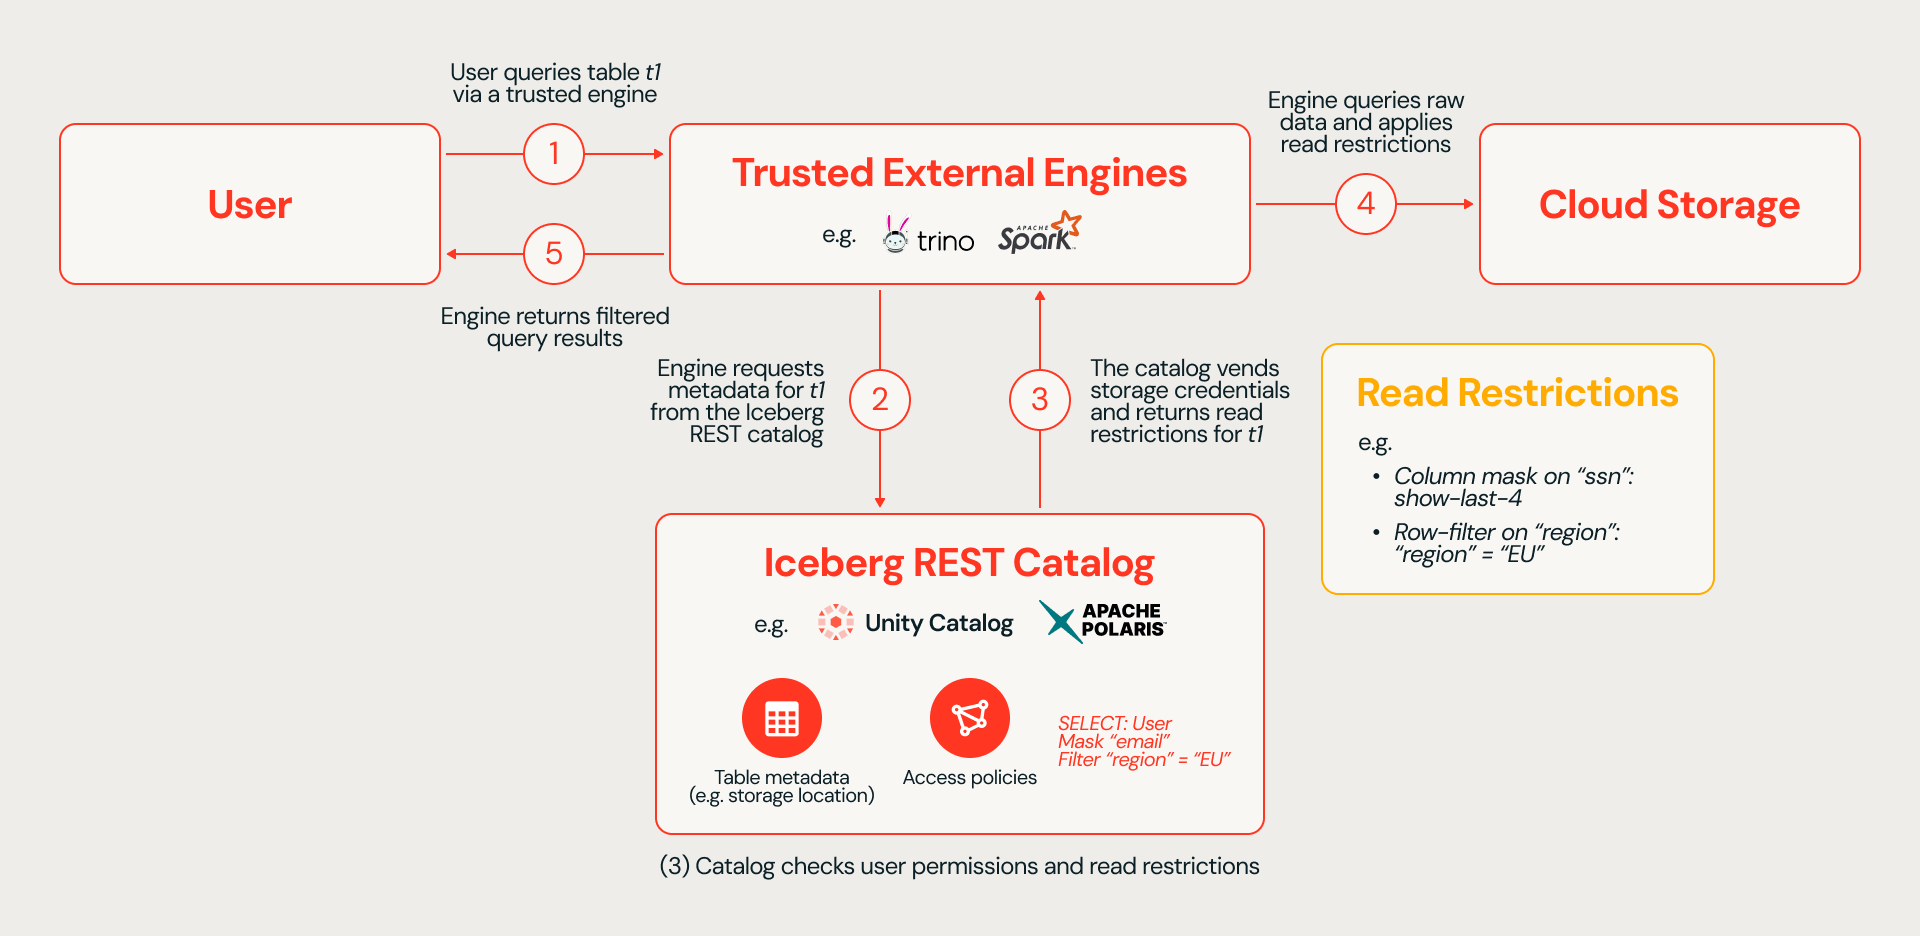
Zwei Designentscheidungen sind wichtig, um den aktuellen Umfang des Vorschlags zu verstehen.
Erstens erhält die Engine die Richtlinie nicht so, wie sie vom Administrator definiert wurde. Stattdessen erhält sie das Ergebnis für einen bestimmten Principal, ausgedrückt als Filter- oder Maskierungsanweisungen, die sie anwenden muss. Dies schafft einen gemeinsamen Durchsetzungsvertrag zwischen der Engine und dem Katalog. Die ursprüngliche Spezifikation definiert ein begrenztes Vokabular: neun vordefinierte Spaltenprojektionsaktionen und standardisierte Zeilenfilterausdrücke wie Vergleiche oder Mengenmitgliedschaften. Viele reale Unternehmensrichtlinien hängen von Unterabfragen, Lookup-Tabellen oder benutzerdefinierten UDFs ab, die im Vokabular der Leseeinschränkungen nicht ausgedrückt werden können. Dies hat eine wichtige Konsequenz: Richtlinien können nur dann dargestellt werden, wenn der Katalog ihr Ergebnis auf das durch den Standard definierte Vokabular reduzieren kann, andernfalls geht die Semantik der Richtlinie verloren.
Zweitens definiert die Spezifikation, was eine vertrauenswürdige Engine durchsetzen muss, nicht aber, wie der Katalog dieses Vertrauen herstellt. Eine Behauptung des Clients reicht nicht aus, daher müssen Systemadministratoren und Implementierungen Sicherheitsmechanismen verwenden, die für ihre Umgebung geeignet sind. In Diskussionen der Iceberg-Community wurden Mechanismen wie mTLS und OAuth in Betracht gezogen, aber das Vertrauen bleibt letztendlich außerhalb des Protokolls (Diskussion in der Iceberg-Community).
Leseeinschränkungen eignen sich am besten für Szenarien mit direktem Zugriff von der Engine auf den Katalog, bei denen die Richtlinien des Quellkatalogs einfach sind und eine vertrauenswürdige Engine die resultierende Entscheidung durchsetzen kann. Viele Implementierungsfragen sind noch offen, z. B. wie eine Engine die Identität und Attribute des Endbenutzers sicher weitergibt, wie ein Katalog den Benutzer von der Engine unterscheidet, die im Namen des Benutzers handelt, und wie Anmeldeinformationen an ihren beabsichtigten Empfänger gebunden werden. Da erste Implementierungen entstehen, freuen wir uns darauf, mit der Iceberg-Community zusammenzuarbeiten, um diese Herausforderungen zu bewältigen und den Standard weiterzuentwickeln.
Katalog-Labels: Governance-Kontext portabel machen
Katalog-Labels adressieren ein anderes Szenario: Governance über föderierte Kataloge hinweg.
Viele Unternehmen verbinden mittlerweile mehrere Kataloge wie Unity Catalog, Snowflake, AWS Lake Formation und Google Cloud Knowledge Catalog über Föderation und offene APIs. Dies ist komplexer als eine Engine-zu-Katalog-Integration, da jeder Katalog seine eigenen Benutzer, Anwendungen und Engines über unterschiedliche Identitätsmodelle, Richtliniensprachen und Semantiken bedient.
Jede einheitliche Governance-Lösung, die auf Unternehmensebene funktioniert, muss:
- Ausdrucksstärke von Richtlinien bewahren. Kunden müssen in der Lage sein, anspruchsvolle Regeln zu definieren, einschließlich attributbasierter Richtlinien und komplexer Unterabfragen, und diese konsistent über heterogene Systeme hinweg durchzusetzen.
- Klare Auditierbarkeit und Rechenschaftspflicht gewährleisten. Jeder Katalog muss die Compliance unabhängig nachweisen können, ohne dass Administratoren Audit-Protokolle über mehrere Systeme hinweg abgleichen müssen.
- Skalieren, ohne einen weiteren Katalogdienst in den kritischen Pfad aufzunehmen. Die berechtigungsbasierte Suche in Katalog A sollte nicht für jeden Benutzer und jedes Asset einen Aufruf von Katalog B erfordern. Beispielsweise sind die meisten Benutzeroberflächen in Unity Catalog berechtigungsbasiert. Das Laden des Katalog-Explorers oder das Bereitstellen einer automatischen Vervollständigung bei der Suche könnte andernfalls Tausende von Entscheidungen pro Benutzer erfordern, die schwer zu cachen sind. Dies verlangsamt die Benutzererfahrung und macht Leistung und Verfügbarkeit von einem anderen Dienst abhängig.
Katalog-Labels, die kürzlich von der Iceberg-Community eingeführt wurden, sind der erste Schritt in Richtung dieser Vision. Labels ermöglichen es Katalogen, schlanke Key-Value-Metadaten auf Tabellen- und Spaltenebene über offene APIs auszutauschen. Labels können darauf hinweisen, dass ein Feld PII enthält, einen Datensatz einer Geschäftsdomäne zuordnen oder semantische Hinweise für KI-Modelle liefern. Da der Vorschlag allgemein gehalten ist, können Labels viele Anwendungsfälle über die Zugriffskontrolle hinaus unterstützen, darunter Suche, Eigentümerschaft, Kostenzuordnung, KI-Kontext und Datenqualität.
Wie Katalog-Labels funktionieren
Wenn ein konsumierender Katalog eine Tabelle von einem bereitstellenden Katalog über die Katalog-Föderation lädt, gibt der bereitstellende Katalog Labels auf Tabellen- und Spaltenebene zurück.
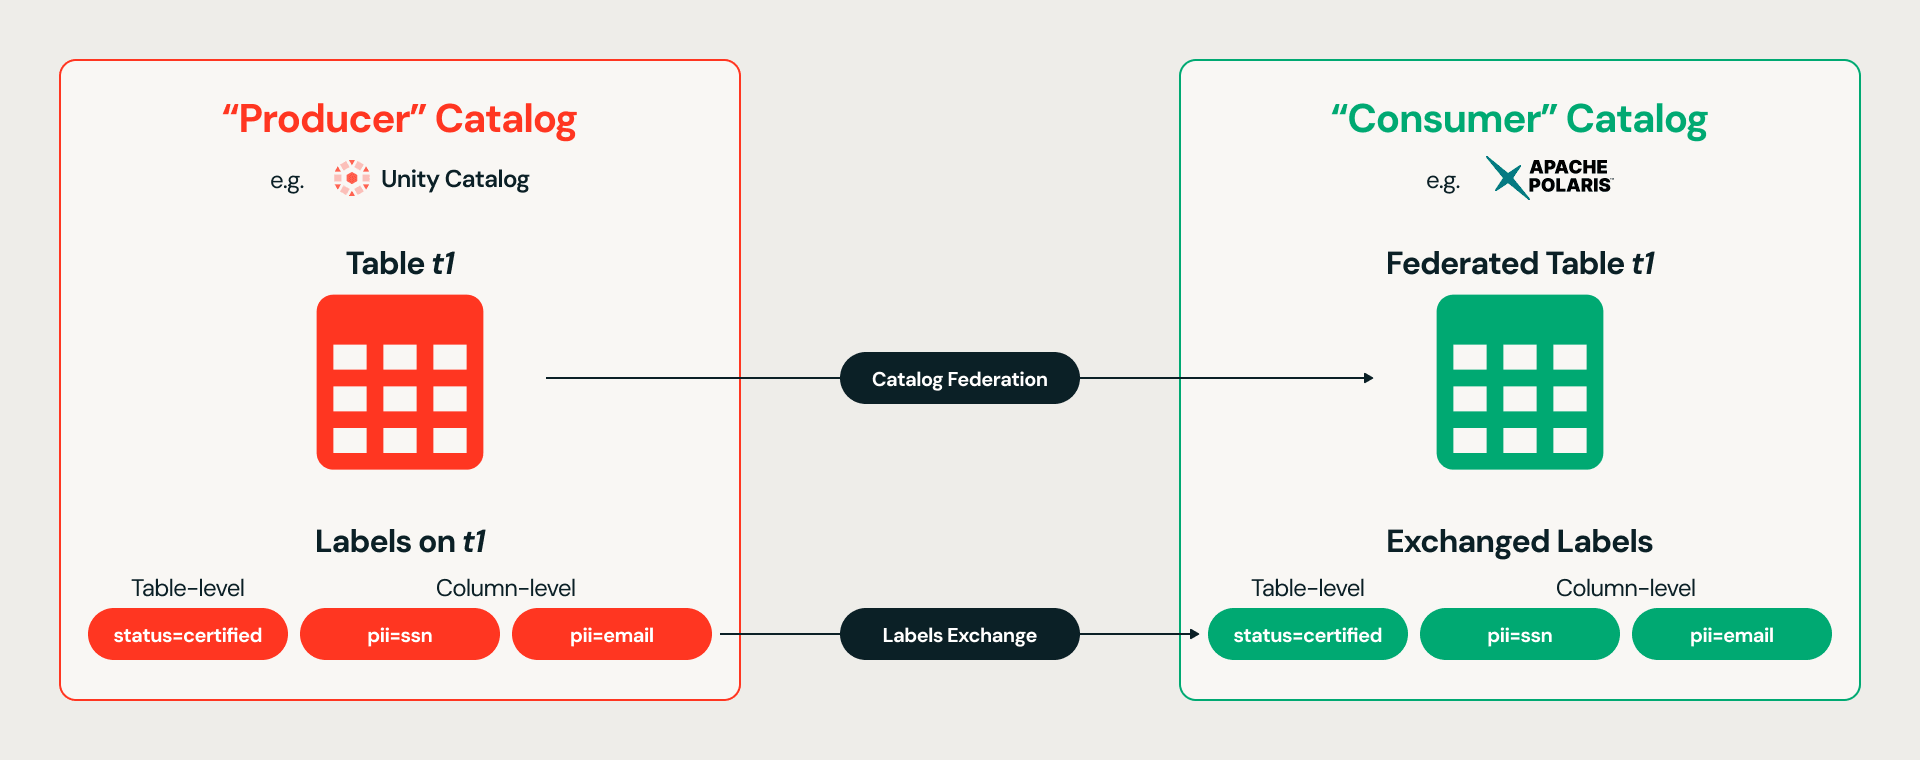
Der konsumierende Katalog ordnet die Labels dann seinen eigenen Klassifizierungen, Attributen oder seinem nativen Tag-Modell zu. Anschließend bewertet er den Zugriff anhand seiner nativen Identitäten und Richtlinien und setzt Kontrollen innerhalb seiner eigenen Laufzeitumgebung durch. Wenn beispielsweise ein bereitstellender Katalog eine ssn-Spalte mit pii=ssn kennzeichnet, kann der konsumierende Katalog eine tagbasierte Richtlinie anwenden, die Spalten mit diesem Label maskiert.
Da die Durchsetzung von Richtlinien lokal bleibt, bewahrt der konsumierende Katalog die Ausdrucksstärke seiner nativen Richtlinien und vermeidet es, bei jeder Zugriffsentscheidung den bereitstellenden Katalog aufzurufen. Jeder Katalog führt zudem unabhängig seine eigenen Durchsetzungsaufzeichnungen und Audit-Protokolle.
Es ist wichtig zu bedenken, dass Labels opake Key-Value-Paare sind. Der Standard definiert keine gemeinsame Semantik oder stabilen Identifikatoren, und die Lineage für Labels erstreckt sich nicht über den Quellkatalog hinaus. Der konsumierende Katalog erhält nur den aufgelösten Schlüssel und Wert, nicht aber die Information, ob das Label für die Suche, die Zugriffskontrolle, die Kostenzuordnung oder einen anderen Zweck gedacht war. Labels machen Metadaten daher portabel, nicht aber deren Bedeutung. Unternehmen benötigen weiterhin gemeinsame Konventionen oder explizite Zuordnungen, um Labels konsistent zu interpretieren.
Katalog-Labels eignen sich am besten für Katalog-zu-Katalog-Szenarien mit Föderation zwischen heterogenen Systemen, bei denen der konsumierende Katalog über ein eigenes Governance-System verfügt und einen wiederverwendbaren Kontext benötigt, anstatt für jeden Benutzer und jede Anfrage eine separate Zugriffsentscheidung zu treffen. Der Grundgedanke ist, dass Governance- und Geschäftskontext, ähnlich wie Tabellenmetadaten, über die Iceberg REST Catalog APIs offen und portabel sein sollten.
Das richtige Modell wählen
Das richtige Modell hängt vom Ziel ab: zentralisierte Durchsetzung für eine nicht vertrauenswürdige Engine, Leseeinschränkungen für eine vertrauenswürdige Engine und Katalog-Labels für den offenen Metadatenaustausch, wenn das Ziel ein anderer Katalog mit einem eigenen Governance-System ist.
Zentralisierte Durchsetzung durch Scan-Planung | Leseeinschränkungen | Katalog-Labels | |
Funktionsweise | Der Quellkatalog bewertet und setzt Richtlinien über einen sicheren Filterdienst durch und gibt nur autorisierte Daten zurück | Zum Abfragezeitpunkt teilt der Katalog der Engine mit, welche Einschränkungen für diesen bestimmten Benutzer und dieses Asset gelten sollen – z. B. „mask_alphanum auf Spalte 12 anwenden“ | Kataloge teilen zusätzliche Governance- oder Geschäftsinformationen über eine bestimmte Tabelle – z. B. „Spalte 12 hat die Klassifizierung pii=ssn“ |
Beste Eignung | Direkter Zugriff von einer nicht vertrauenswürdigen Engine, wie einer benutzergesteuerten Spark- oder DuckDB-Laufzeitumgebung | Direkter Zugriff von Engine zu Katalog, bei dem die Quelle die Richtlinie bewertet und eine vertrauenswürdige Engine das Ergebnis durchsetzt | Föderation zwischen heterogenen Systemen mit eigener Identität, Richtlinie und Durchsetzungslaufzeit |
Identität und Sicherheit | Der Client muss Identitätskonzepte (Rollen, Gruppen usw.) übersetzen und an den Katalog übergeben. Die Durchsetzung verbleibt innerhalb der vertrauenswürdigen Grenzen des Katalogs, sodass nicht autorisierte Daten die Engine nie erreichen. | Der Client muss Identitätskonzepte (Principals, Rollen, Gruppen, Benutzerattribute) in etwas übersetzen, das der Katalog versteht, und diese Attribute als Teil des Anforderungskontexts übergeben | Das Ziel verwendet die Identitäten und Attribute, die es bereits versteht, wodurch der zwischen den Systemen ausgetauschte sensible Kontext reduziert wird |
Skalierung, Leistung und Verfügbarkeit | Die serverseitige Scan-Planung kann den Datenzugriff optimieren. Das Routing gesteuerter Abfragen über eine Filter-Flotte führt jedoch im Vergleich zur Durchsetzung in der konsumierenden Engine zu Latenzzeiten und einer betrieblichen Abhängigkeit. | Der Zielkatalog kann eine gecachete Tabelle nicht mehr für alle seine Benutzer wiederverwenden, da die Tabellenantworten benutzerspezifisch werden. Dies führt dazu, dass Funktionen wie Browsen, Suchen und die automatische Vervollständigung einen Cache pro Benutzer oder einen separaten Aufruf des Quellkatalogs für jede Benutzeraktion erfordern. | Der Governance-Kontext kann gecacht und aktualisiert werden, sodass Suche, Browsen und andere Benutzeroberflächen nativ unterstützt werden |
Governance und Auditierbarkeit | Der Quellkatalog behält die volle Ausdrucksstärke seiner nativen Richtlinien bei und zeichnet die Bewertung und Durchsetzung von Richtlinien in derselben vertrauenswürdigen Umgebung auf | Entscheidungen sind auf das gemeinsame Vokabular des Standards beschränkt. Audit-Protokolle sind sowohl auf das Quell- als auch auf das Zielsystem aufgeteilt. | Das Ziel verwendet seine native Richtlinien-Engine und führt ein lückenloses Protokoll über Bewertung und Durchsetzung |
Fazit | Verwenden Sie dies, wenn der Quellkatalog garantieren muss, dass nicht autorisierte Daten niemals eine nicht vertrauenswürdige Engine erreichen | Verwenden Sie dies, wenn das Ziel eine vertrauenswürdige Engine ist und die Quellrichtlinien vollständig durch Leseeinschränkungen ausgedrückt werden können | Verwenden Sie dies, wenn das Ziel ein anderer Katalog ist, der eine skalierbare Governance mit nativer Geschwindigkeit für seine Benutzer und Engines benötigt |
Wie es weitergeht
Leseeinschränkungen und Katalog-Labels lösen zwei unterschiedliche und wichtige Probleme für die plattformübergreifende Governance. Leseeinschränkungen bieten Katalogen eine standardisierte Möglichkeit, die Durchsetzung an vertrauenswürdige Engines zu delegieren. Katalog-Labels machen Governance und Geschäftskontext über Kataloge hinweg portabel, genau wie Ihre Daten. Zusammen mit der zentralisierten Durchsetzung durch Cross-Engine ABAC bieten diese Unternehmen praktische Optionen, um Daten konsistent über Engines und Kataloge hinweg zu verwalten.
Herzlichen Glückwunsch an die Apache Iceberg-Community zur Annahme beider Vorschläge. Auch wenn noch viel Arbeit vor uns liegt, ist dies ein wichtiger Meilenstein. Wir freuen uns darauf, dass weitere Teile des Ökosystems diese grundlegenden Bausteine übernehmen, und darauf, weiterhin mit der Community zusammenzuarbeiten, um eine einheitliche Governance im gesamten offenen Lakehouse Realität werden zu lassen.
1Die eigenen Sicherheitsrichtlinien von Apache Spark besagen, dass vom Benutzer übermittelter Code ohne Einschränkungen ausgeführt wird und Benutzern die Kontrolle über die ihrer Anwendung zugewiesenen Ressourcen gibt. Eine Spark-Erweiterung kann Leseeinschränkungen implementieren, aber die Bereitstellung gilt nur dann als vertrauenswürdig, wenn Administratoren die Laufzeit kontrollieren und jeden Weg zur Umgehung der Durchsetzung ausschließen, da es an einer API für die Zugriffskontrolle auf Tabellenebene fehlt, geschweige denn an einer für die feingranulare Zugriffskontrolle (Diskussion in der Iceberg-Community).
(Dieser Blogbeitrag wurde mit KI-gestützten Tools übersetzt.) Originalbeitrag
Erhalten Sie die neuesten Beiträge in Ihrem Posteingang
Abonnieren Sie unseren Blog und erhalten Sie die neuesten Beiträge direkt in Ihren Posteingang.