Branching de base de données : le guide du développeur pour les workflows de type Git
Découvrez comment le branching de bases de données apporte des workflows de type Git aux bases de données — en utilisant la copie sur écriture pour créer des environnements isolés et éphémères pour les développeurs, la CI et les agents d'AI.
- Le branching de bases de données crée des environnements isolés via la copie sur écriture, en partageant les données inchangées et en ne stockant que les différences — aucune copie complète n'est nécessaire.
- Il prend en charge les tests de type production, l'isolation de la CI par PR et une récupération facile, avec les migrations (et non les fusions) comme source unique de vérité.
- Il est essentiel pour les agents d'AI qui exécutent de nombreuses branches éphémères ; une utilisation sécurisée nécessite des parents protégés, des données fictives, des TTL et des contrôles d'accès.
Git a fait du développement isolé une référence pour les équipes logicielles. Chaque développeur peut créer une branche, travailler de manière indépendante et fusionner les modifications lorsqu'elles sont prêtes.
Le branching de base de données apporte cette même isolation à la base de données. Il permet aux développeurs, aux tâches d'intégration continue (CI) et aux agents AI de créer des environnements de base de données isolés à partir d'un état de base de données partagé et d'apporter des modifications sans affecter la base de données parente ni les autres branches.
Cela signifie moins de temps d'attente pour les environnements partagés, moins d'échecs de test causés par les modifications d'autres personnes et un retour d'information plus rapide sur les migrations de schéma. En cas de problème, vous pouvez simplement supprimer la branche au lieu de réparer ou de restaurer une base de données partagée.
TL;DR
- Le branching de base de données crée des environnements isolés sans copies complètes de la base de données. Le copy-on-write rend cela possible en partageant les données inchangées et en stockant uniquement ce qui change.
- Le branching de base de données est de plus en plus important pour les agents AI. Il leur offre des environnements isolés pour tester des modifications et expérimenter sans mettre en danger la base de données parente.
- Gérer les branches de base de données en toute sécurité nécessite des contrôles clairs. Protégez les branches parentes, limitez l'accès aux données sensibles, automatisez le nettoyage et veillez à ce que les environnements jetables soient reproductibles.
Qu'est-ce que le branching de base de données ?
Le branching de base de données vous offre un environnement de base de données isolé basé sur l'état d'une autre base de données à un moment précis. La branche commence avec le schéma de la base de données parente et ses données, mais les modifications que vous apportez à la branche n'affectent pas le parent ni les autres branches sœurs.
Si vous connaissez Git, l'idée de base devrait vous sembler familière. Une branche de code vous offre une ligne de développement privée à partir d'un commit connu. Une branche de base de données vous offre un environnement de base de données isolé à partir d'un état de base de données connu.
Une différence importante est que vous ne fusionnez généralement pas les modifications d'une branche de base de données dans la base de données parente. Au lieu de cela, les fichiers de migration restent la source unique de vérité durable. Vous pouvez tester une migration sur votre branche, vous assurer qu'elle fonctionne avec des données réalistes, puis laisser votre pipeline de déploiement appliquer cette même migration à la base de données cible. De cette façon, le branching de base de données rend pratiques des pratiques de longue date telles que la conception évolutive de bases de données, les environnements de base de données par développeur et les migrations contrôlées par version, même lorsque vous travaillez avec des données à l'échelle de la production.
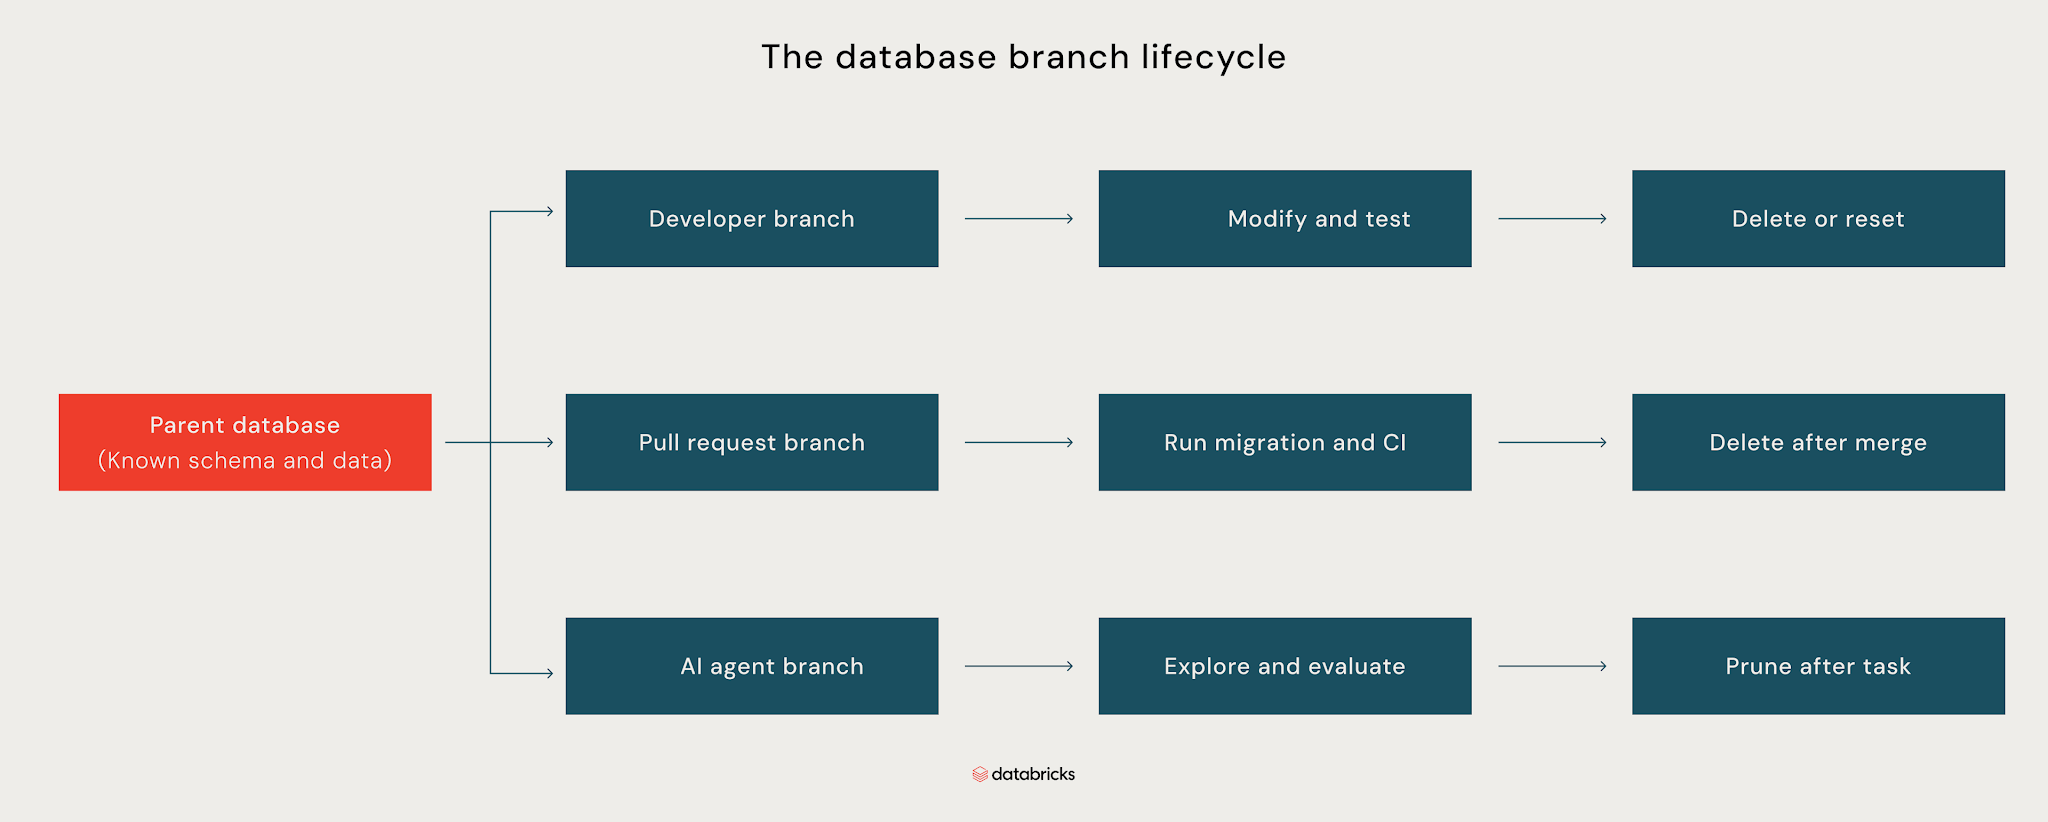
Comme illustré ci-dessus, une base de données parente fournit le schéma et les données connus pour plusieurs branches isolées. Vous pouvez utiliser une branche de développeur pour modifier et tester des changements, une branche de pull request pour exécuter des migrations et la CI, ou une branche d'agent pour explorer et évaluer des modifications. Une fois le travail terminé, chaque branche peut être réinitialisée, supprimée ou élaguée sans affecter la base de données parente ni les autres branches. Le branching de base de données rend ce niveau d'isolation possible grâce au copy-on-write.
Comment fonctionne le branching de base de données avec copy-on-write
Le copy-on-write (CoW) rend le branching de base de données pratique en évitant une copie complète préalable de la base de données. Lorsque vous créez une branche, elle partage initialement les données existantes du parent au lieu de les dupliquer. Les deux peuvent lire les mêmes données sous-jacentes, tandis que les modifications apportées à l'une restent isolées de l'autre. Mais lorsque la branche modifie des données, la couche de stockage crée une nouvelle version des données concernées pour cette branche, tandis que les données inchangées restent partagées avec le parent.
Lakebase utilise cette approche de copy-on-write pour créer des branches de base de données sans dupliquer l'intégralité de la base de données parente. Par conséquent, chaque branche ne nécessite du stockage supplémentaire que pour les données qui divergent de son parent.
Prenons l'exemple d'une base de données de 40 GB. Avec une copie complète traditionnelle, la création d'une branche de développeur et d'une branche de pull request nécessite 80 GB de stockage supplémentaires. Cependant, avec le copy-on-write, les deux branches partagent initialement les données du parent et ne consomment du stockage supplémentaire que lorsqu'elles divergent.
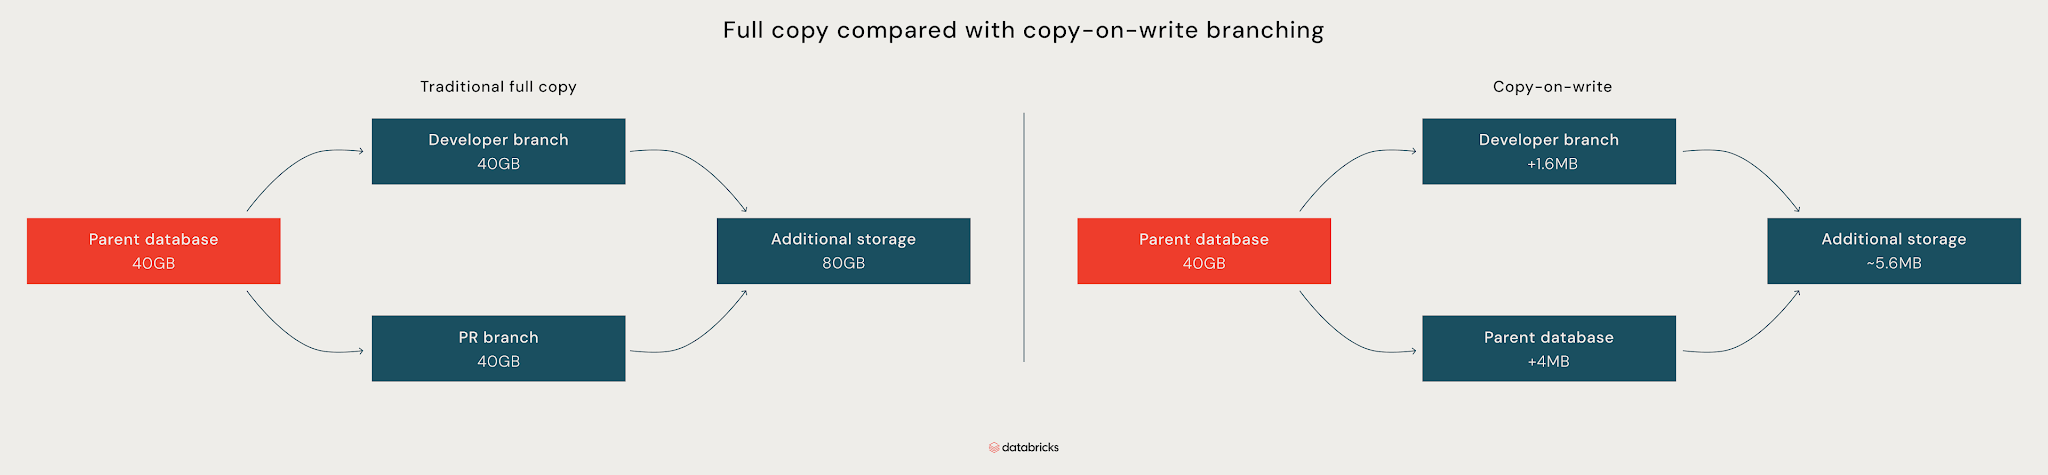
Comme le montre le diagramme ci-dessus, si les modifications dans la branche de développeur ne représentent que 1.6 MB et celles de la branche PR seulement 4 MB, les deux branches n'ajoutent qu'environ 5.6 MB de stockage. Les copies traditionnelles dupliquent l'intégralité de la base de données pour chaque branche, tandis que les branches en copy-on-write partagent les données inchangées et ne stockent que leurs modifications.
Le same principe s'applique lorsque le parent change après la création d'une branche. La branche continue de faire référence à la version originale des données inchangées, tandis que le parent écrit de nouvelles versions des pages qu'il modifie. Cela permet aux deux branches d'évoluer indépendamment sans dupliquer les données inchangées.
Ce que le branching de base de données rend possible
Une fois que vous disposez du branching de base de données, plusieurs flux de travail de développement deviennent beaucoup plus faciles à mettre en œuvre :
Des bases de référence similaires à la production
Vous pouvez créer des branches de base de données à partir d'un instantané de production protégé afin que chaque développeur et tâche de CI démarre à partir du même état connu. Cela vous permet de tester les migrations par rapport à des données réalistes, des contraintes existantes et des tables à l'échelle de la production, plutôt que sur une base de données locale vide ou un environnement de staging obsolète.
Par exemple, une migration comme ALTER TABLE orders ADD COLUMN customer_id UUID NOT NULL peut fonctionner sur une base de données vide mais échouer face à des millions de commandes existantes. La tester sur une branche similaire à la production expose ce problème avant que la migration n'atteigne le staging ou la production. Lorsque la branche devient obsolète, vous pouvez la supprimer et en créer une nouvelle à partir de la même base de référence.
Isolation par PR
Vous pouvez attribuer à chaque pull request son propre environnement de base de données. La CI crée la branche lors de l'ouverture de la PR, applique les migrations proposées et exécute des tests d'intégration sur celle-ci. Lorsque la PR est fermée, le pipeline supprime la branche.
Cela signifie que deux développeurs peuvent apporter des modifications de schéma conflictuelles sans affecter les tests de l'autre. Une PR qui ajoute une colonne, modifie une contrainte ou change un index obtient son propre état de base de données, de sorte que la CI teste la modification de manière isolée plutôt que par rapport à ce qu'un autre développeur fait en staging.
Récupération plus facile en cas d'échec
Les branches facilitent également l'isolation des migrations et des expérimentations ayant échoué. Si un backfill produit des résultats inattendus, qu'un test corrompt des données ou qu'une migration laisse une branche dans un état dégradé, vous pouvez abandonner la branche concernée et en créer une nouvelle à partir du parent au lieu de continuer à travailler avec un environnement de développement contaminé.
Par exemple, vous pouvez tester en toute sécurité une opération destructive telle que DELETE FROM orders WHERE created_at < ... sur une branche, inspecter les résultats et supprimer la branche une fois terminé. La base de données parente reste intacte tout au long du processus.
Pour les développeurs et les équipes DevOps, ces avantages sont déjà convaincants. Cependant, si vous concevez ou exécutez des agents AI, le branching de base de données devient important à une tout autre échelle.
Le guide pratique de l'IA agentique pour l'entreprise

Pourquoi les agents AI rendent le branching essentiel pour l'infrastructure
Les agents AI peuvent avoir besoin de leurs propres environnements de base de données pour tester différentes approches d'une tâche. Ils peuvent créer une branche pour chaque approche, comparer les résultats et supprimer celles dont ils n'ont pas besoin. À l'échelle d'une flotte d'agents, cela peut représenter des centaines ou des milliers d'environnements éphémères exécutés simultanément.
À cette échelle, les copies complètes de bases de données deviennent coûteuses et lentes à provisionner. Le branching de base de données évite cette surcharge, ce qui permet aux agents de créer et de supprimer des environnements au fur et à mesure de leur travail.
Le branching peut également réduire le rayon d'impact des erreurs des agents en leur fournissant un environnement isolé pour tester les modifications. Au lieu d'accorder à un agent un accès en écriture à une base de données de production, vous pouvez lui donner accès à une branche sur laquelle il peut tester des opérations destructives sans affecter le parent.
Comment gérer les branches de base de données en toute sécurité
Les branches de base de données sont plus faciles à gérer lorsque vous les traitez comme des environnements jetables et que vous automatisez leur cycle de vie. Quelques bonnes pratiques permettent de garder ce flux de travail sûr et prévisible :
- Protégez les branches de production et parentes : Limitez les personnes autorisées à écrire sur, réinitialiser ou supprimer les branches de production et autres branches parentes importantes. Les agents et les développeurs doivent plutôt travailler sur des branches enfants.
- Utilisez des données sûres pour les branches éphémères : Évitez de copier des données de production sensibles dans des branches de développement ou d'agent éphémères, à moins que cela ne soit nécessaire et correctement protégé. Dans la mesure du possible, utilisez des données fictives afin que les environnements jetables ne deviennent pas un moyen d'exposer des informations de production.
- Définir une durée de vie (TTL) pour les branches : attribuez un délai d'expiration aux branches éphémères afin que les PR abandonnées, les exécutions de CI ayant échoué et les tâches d'agent interrompues ne laissent pas d'environnements s'exécuter indéfiniment.
- Conserver les migrations comme source unique de vérité : traitez les fichiers de migration comme la source unique de vérité. Testez les migrations sur une branche, examinez-les dans le contrôle de version et appliquez la migration approuvée à la base de données cible plutôt que de promouvoir les modifications apportées directement sur une branche.
- Rendre les environnements reproductibles : considérez les branches comme jetables plutôt que comme des environnements à longue durée de vie nécessitant des réparations manuelles. Conservez la configuration nécessaire pour recréer un environnement dans le contrôle de version afin qu'une branche obsolète ou corrompue puisse être supprimée et recréée à partir de sa branche parente.
- Contrôler l'accès et l'utilisation des ressources : n'accordez aux développeurs et aux agents que les autorisations dont ils ont besoin, et surveillez l'âge des branches, le calcul, le stockage et le nombre d'environnements actifs. Utilisez des outils comme Unity Catalog pour régir l'accès aux données disponibles au sein de ces environnements.
Grâce à ces garde-fous, les équipes peuvent utiliser les branches de base de données comme des environnements jetables pour le développement, l'intégration continue et la livraison continue (CI/CD), ainsi que pour les workflows d'agents. Chaque branche fournit un environnement isolé pour tester les modifications et peut être automatiquement supprimée une fois le travail terminé.
En conclusion
La création de branches de base de données vous offre un moyen pratique de créer des environnements de base de données isolés sans le coût et la complexité de copies complètes. Vous pouvez utiliser les branches pour tester des migrations par rapport à des données réalistes, attribuer sa propre base de données à chaque pull request, récupérer après des échecs d'expérimentation et exécuter des charges de travail basées sur des bases de données en parallèle.
Commencez par un workflow simple, tel qu'une branche par pull request, et automatisez la création et le nettoyage. À partir de là, vous pourrez étendre la création de branches aux environnements de développement et aux charges de travail des agents à mesure que vos besoins évoluent. Prêt à essayer ? Explorez la création de branches de base de données avec Databricks Lakebase ou suivez un tutoriel pratique pour implémenter la création de branches de base de données dans Postgres.
Foire aux questions
Qu'est-ce que la création de branches de base de données ?
La création de branches de base de données crée un environnement de base de données isolé à partir d'une base de données parente à un moment précis. La branche commence avec le schéma et les données du parent, mais les modifications apportées à la branche restent isolées. Grâce au copy-on-write, les branches partagent les données non modifiées avec le parent, ce qui les rend rapides à créer et peu coûteuses à supprimer.
En quoi la création de branches de base de données diffère-t-elle de la création de branches Git ?
L'idée est similaire : les deux vous permettent de créer un environnement isolé à partir d'un état connu et d'apporter des modifications sans affecter l'original. Les branches Git isolent le code source, tandis que les branches de base de données isolent le schéma et les données de la base de données.
Les workflows diffèrent ensuite. Les branches Git sont généralement fusionnées dans la branche principale, ce qui n'est généralement pas le cas des branches de base de données. À la place, vous testez votre migration sur la branche de base de données, puis vous appliquez la migration révisée à la base de données cible via votre processus de déploiement.
Quel est l'objectif de la création de branches de base de données ?
La création de branches de base de données offre aux développeurs, aux tâches de CI et aux agents d'IA des environnements isolés pour tester les modifications sans affecter la production ou d'autres charges de travail. Vous pouvez utiliser les branches pour tester des migrations par rapport à des données réalistes, créer des environnements par PR, récupérer après des échecs d'expérimentation et exécuter plusieurs charges de travail basées sur des bases de données en parallèle.
Quels sont les deux types de création de branches de base de données ?
Les deux approches courantes sont la création de branches par copie complète (full-copy) et la création de branches par copie sur écriture (copy-on-write). La création de branches par copie complète duplique la base de données pour chaque branche, de sorte que le temps de création et les besoins de stockage augmentent avec la taille de la base de données. La création de branches par copie sur écriture partage les données non modifiées avec le parent et ne stocke que les modifications apportées à chaque branche.
Quels types de bases de données prennent en charge la création de branches ?
La création de branches dépend davantage de l'architecture de stockage de la base de données que de son modèle de données. Les bases de données relationnelles, de documents, clé-valeur et de graphes peuvent toutes théoriquement prendre en charge la création de branches, mais l'implémentation et les capacités varient selon la plateforme.
Comment implémenter la création de branches de base de données ?
L'implémentation dépend de votre plateforme de base de données et de votre architecture de stockage. En général, vous avez besoin d'une base de données parente et d'un moyen de créer des branches isolées à partir d'un état de base de données connu. Databricks Lakebase fournit la création de branches de base de données pour le développement, la CI et les workflows d'agents, avec des branches qui peuvent être créées et supprimées selon les besoins. Pour une implémentation pratique, consultez le tutoriel de développement basé sur les branches Databricks.
(Cet article de blog a été traduit à l'aide d'outils basés sur l'intelligence artificielle) Article original
Recevez les derniers articles dans votre boîte mail
Abonnez-vous à notre blog et recevez les derniers articles directement dans votre boîte mail.