Comment tirer le meilleur parti de l'exécution de dbt sur Databricks
Rendez les pipelines dbt sur Databricks plus économiques, plus rapides et plus simples à exploiter.
par Srilekha Dornadula et Luís Cabral
- Évitez d'assembler des outils séparés et conservez l'ensemble du pipeline dans un seul projet dbt sur Databricks, de l'ingestion en continu jusqu'aux définitions de métriques gouvernées
- Orchestrez dbt nativement dans Lakeflow Jobs sans avoir besoin d'un orchestrateur externe.
- Définissez la gouvernance directement dans le projet dbt lui-même, afin que les règles d'accès soient appliquées par Unity Catalog directement depuis les configurations de votre projet.
Des dizaines de milliers d'organisations s'appuient sur dbt pour la transformation des données. Le lieu où vous l'exécutez façonne tout : le coût d'exécution de vos pipelines dbt, leur rapidité de déploiement et la charge opérationnelle qu'ils impliquent. Exécuter dbt sur Databricks offre à vos charges de travail dbt une plateforme ouverte et un pipeline unifié.
Plus de 3 000 organisations exécutent dbt sur Databricks, et la plupart des équipes pourraient en tirer bien plus parti. Ce blog met en avant les pratiques qui rendent les pipelines dbt moins chers, plus rapides et plus simples à exploiter sur Databricks.
Rendez vos pipelines dbt moins chers et plus rapides
Les factures dbt augmentent à cause du travail qu'il n'est pas nécessaire de répéter. Les reconstructions complètes recalculent des données qui n'ont pas changé, le maintien de requêtes rapides nécessite des réglages manuels, et lorsque la facture grimpe, il n'y a pas d'attribution claire aux modèles dbt qui en sont la cause. Adoptez les pratiques de cette section et vos pipelines vont :
- Reconstruire uniquement les données qui ont réellement changé
- Rester rapides sans que vous ayez à choisir ou retravailler les clés de partition
- Exécuter la maintenance des tables automatiquement sans post-hooks
- Tracer chaque dollar de dépense jusqu'à un modèle spécifique
1. Ne construisez que ce qui a changé grâce aux stratégies incrémentielles
La reconstruction complète des tables est le coût le plus important et évitable dans la plupart des projets dbt. Lorsqu'une petite fraction seulement des données change entre deux exécutions, recalculer l'ensemble de la table gaspille vos ressources de calcul et augmente votre facture. Les stratégies incrémentielles de dbt, toutes prises en charge sur dbt-databricks, permettent à chaque modèle de traiter uniquement les nouvelles données, et le bon choix dépend de la façon dont vos données arrivent réellement.
Stratégie | À utiliser quand |
|---|---|
append | Les lignes sont uniquement insérées, jamais mises à jour |
merge | La même clé peut arriver plusieurs fois et doit être mise à jour/insérée (dimensions à changement lent, dédoublonnage, mises à jour tardives) |
replace_where | Le modèle recalcule une fenêtre temporelle étroite à chaque exécution, comme les derniers jours d'activité |
insert_overwrite | Votre requête renvoie des partitions entières |
delete+insert | Vous souhaitez remplacer les enregistrements par clé, sans logique de mise à jour au niveau des colonnes |
microbatch | Données de séries temporelles avec une colonne event_time et des besoins de rattrapage d'historique structuré |
La plupart des projets utilisent par défaut merge lorsqu'une stratégie plus ciblée suffirait. Si vous pouvez décrire les données modifiées avec un prédicat, replace_where fait moins de travail qu'un merge qui doit balayer la cible pour trouver des correspondances. Si vous ne le pouvez pas, incremental_predicates sur le merge réduit considérablement ce balayage.
Chaque stratégie ci-dessus est une décision que vous prenez et devez maintenir. La pratique suivante permet à la plateforme de s'en charger pour vous.
2. Laissez les vues matérialisées gérer l'incrémentation à votre place
Les vues matérialisées automatisent l'incrémentation. Vous pouvez définir le modèle en SQL simple, et Databricks suit les données sous-jacentes qui ont changé et ne rafraîchit que les résultats affectés. Sur dbt-databricks, une vue matérialisée est une matérialisation native, c'est donc un changement de configuration d'une seule ligne :
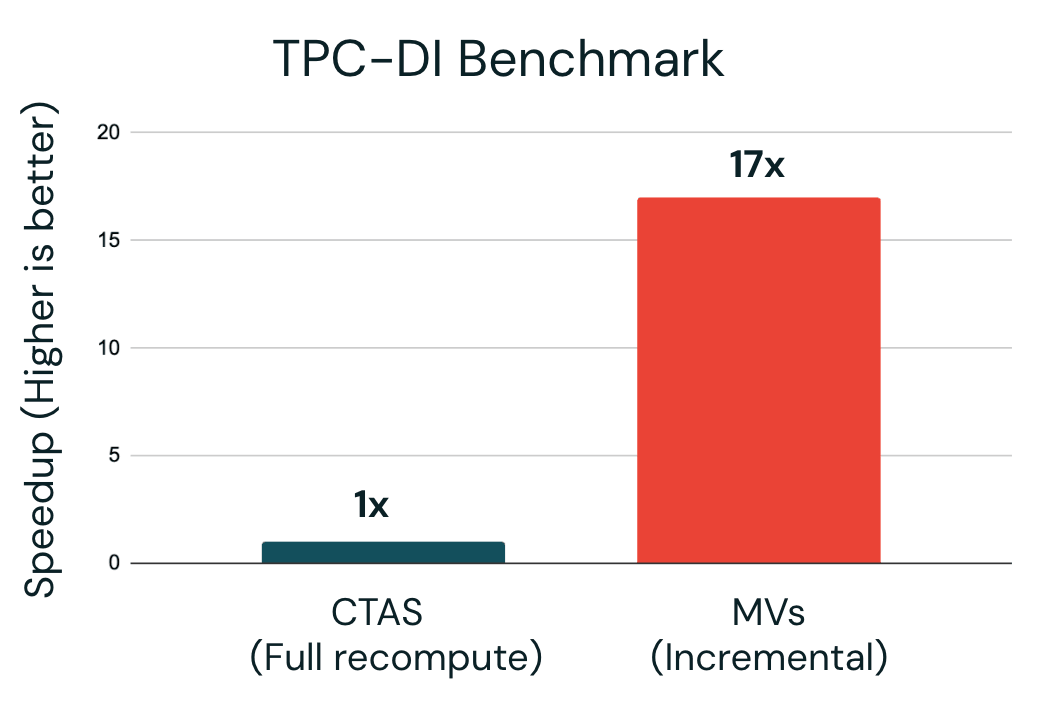
Les vues matérialisées s'adaptent le mieux au niveau de la couche de restitution : agrégations sur des sources qui changent fréquemment, en particulier celles qui coûtent cher, alimentent des tableaux de bord et doivent rester à jour. Dans notre benchmark TPC-DI, le passage de recalculs complets à des vues matérialisées au niveau de la couche de restitution a permis une accélération d'un facteur 17.
3. Automatisez la disposition des données pour l'optimisation des performances
Choisir des clés de partition, les retravailler lorsque les schémas de requêtes changent et planifier OPTIMIZE, VACUUM et ANALYZE dans les post-hooks demandent du temps d'ingénierie.
Predictive Optimization exécute OPTIMIZE, VACUUM et la collecte de statistiques sur les tables gérées automatiquement, en choisissant quoi exécuter et quand, en fonction de la manière dont chaque table est interrogée. Activez-le une fois au niveau du catalogue ou du schéma, et les post-hooks que les projets dbt accumulent habituellement pour la maintenance des tables peuvent être supprimés.
Pour la disposition des données, Liquid Clustering remplace la conception des partitions par une disposition auto-ajustable. Il organise les données en fonction de la manière dont la table est réellement interrogée, évite la prolifération de petits fichiers qui touche les tables sur-partitionnées et s'adapte à l'évolution des schémas de requêtes. Ou laissez Databricks les choisir et les ajuster à partir de l'historique des requêtes grâce au Liquid Clustering automatique (CLUSTER BY AUTO), propulsé par Predictive Optimization. Une seule configuration au niveau du projet regroupe chaque nouvelle table créée par le projet.
Ces deux fonctionnalités sont conçues comme des décisions uniques. Avec les mises à niveau automatiques, les tables gérées dans Unity Catalog continuent de bénéficier des nouvelles optimisations au fur et à mesure que Databricks les déploie.
4. Attribuez chaque dollar grâce aux balises de requête
À la fin du trimestre, le service financier demande pourquoi la facture de l'entrepôt de données a augmenté. Dans la plupart des configurations, personne ne peut répondre, car une requête dans les données d'utilisation ne comporte aucun lien avec le modèle dbt qui l'a émise.
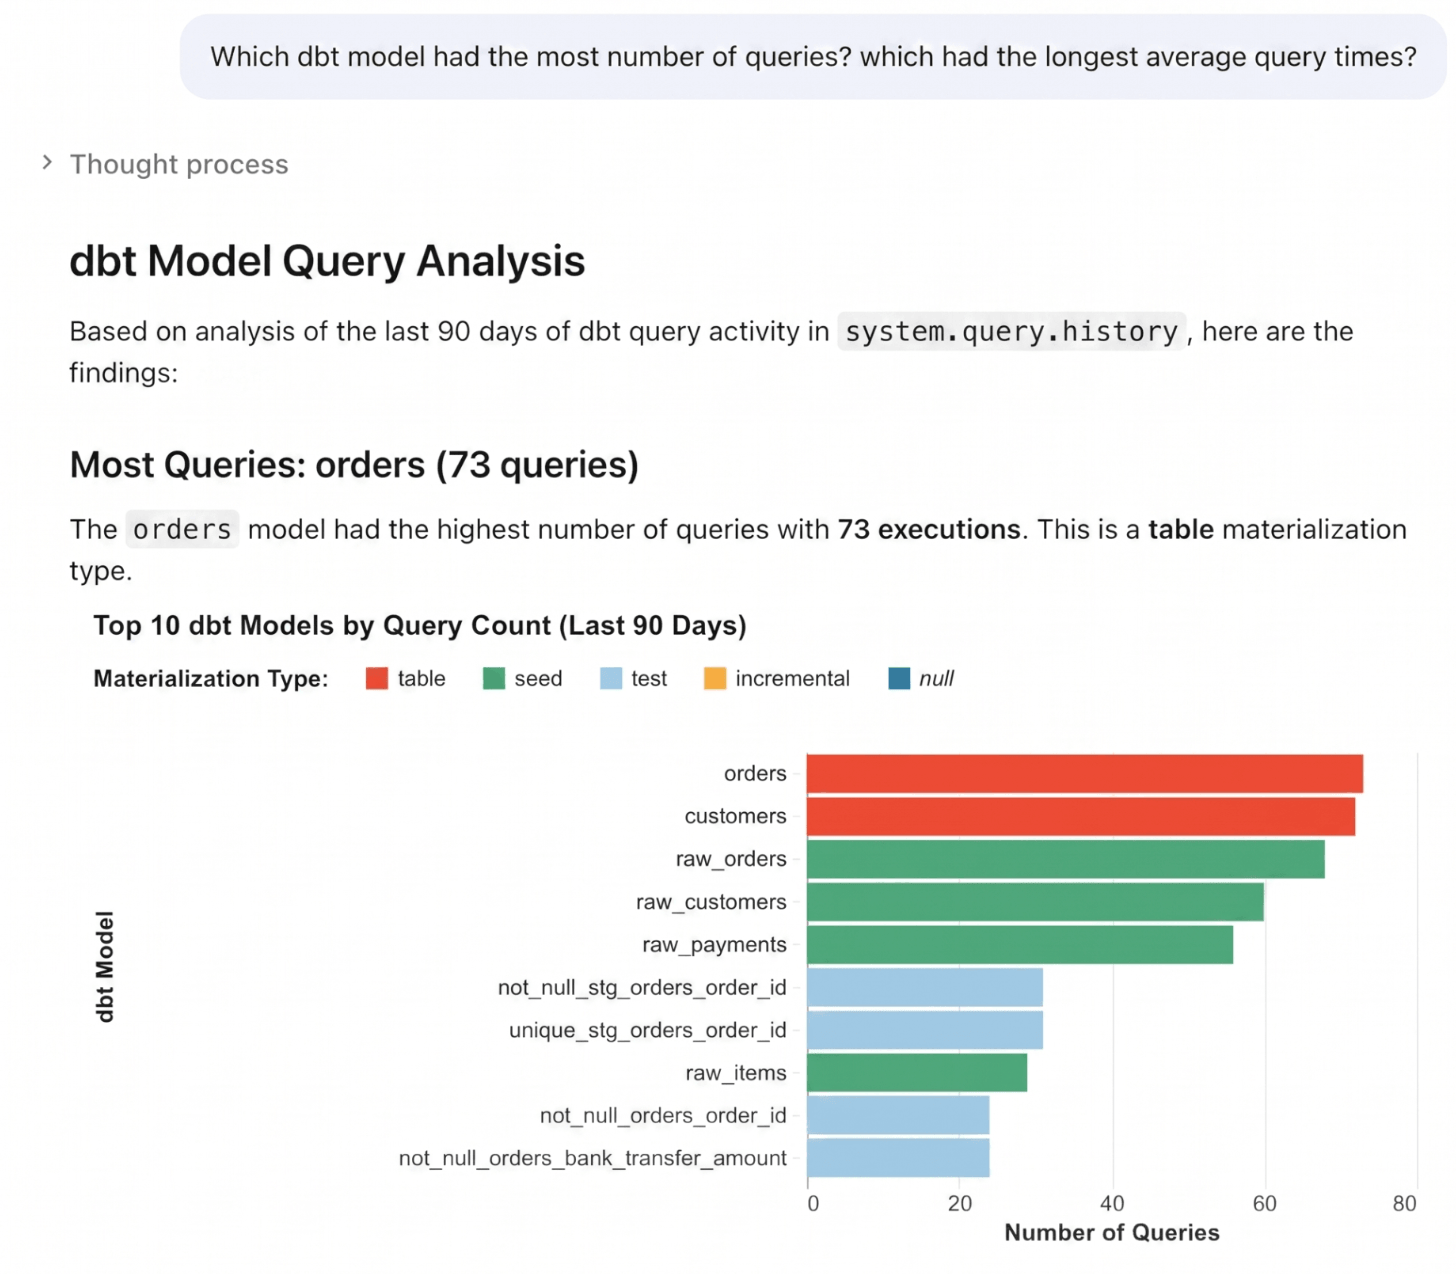
Les balises de requête (query tags) rendent ce lien automatique. Chaque requête exécutée par dbt sur Databricks est automatiquement marquée avec le nom du modèle, la version de dbt et le type de matérialisation. Ajoutez vos propres balises personnalisées pour les dimensions selon lesquelles votre organisation établit ses budgets :
Les balises apparaissent dans system.query.history, et une jointure avec system.billing.usage attribue les dépenses des entrepôts serverless à n'importe quel regroupement pris en charge par les balises : coût par modèle, par équipe, par domaine, par matérialisation. Vous pouvez voir exactement quels modèles coûtent le plus cher.
Simplifiez vos pipelines dbt
Une configuration dbt typique repose sur une superposition d'autres outils : un système distinct pour ingérer les données, un orchestrateur externe pour exécuter le projet, des outils de BI qui redéfinissent chacun les mêmes métriques, et une gouvernance située en dehors de votre projet dbt. Chaque outil est un élément supplémentaire à maintenir et une source potentielle de désynchronisation. Adoptez les pratiques de cette section et un seul projet dbt permettra de :
- Ingérer des données directement dans le projet
- S'exécuter et se déployer depuis Databricks, sans orchestrateur tiers à maintenir
- Fournir une définition de métrique gouvernée unique à tous les outils
- Intégrer ses propres règles de gouvernance, versionnées en même temps que vos modèles dbt
1. Intégrez l'ingestion dans le projet dbt grâce aux Streaming Tables
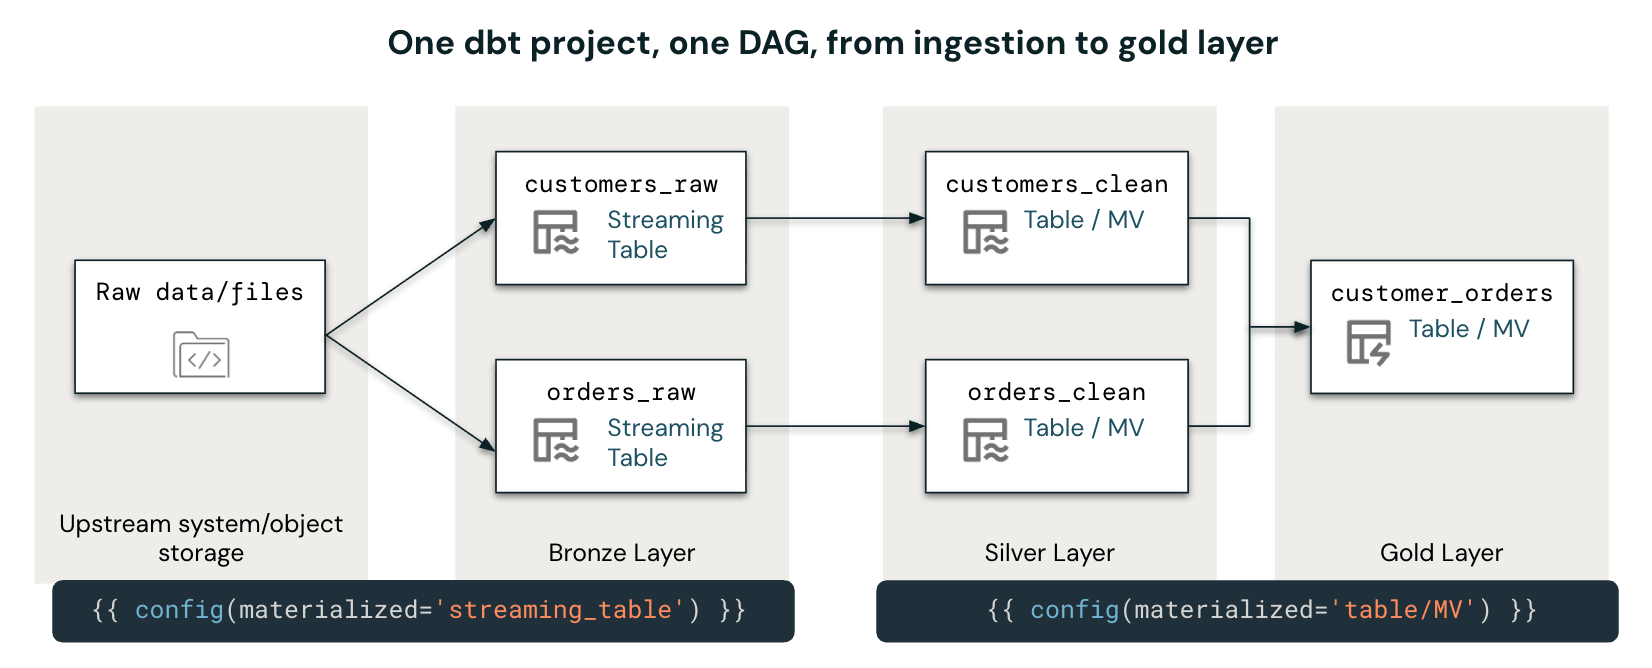
L'ingestion est la partie du pipeline qui résidait traditionnellement en dehors de dbt, ce qui entraînait une architecture fragmentée sans vue d'ensemble du lignage. La matérialisation streaming_table supprime cette division. Un modèle dbt matérialisé sous forme de streaming table récupère de manière incrémentale les nouveaux fichiers ou événements à mesure qu'ils arrivent, de sorte que l'ingestion devient simplement un modèle de plus dans le DAG.
À partir de là, le reste du pipeline (modèles silver et gold) peut faire référence à la streaming table avec ref(), les tests et la documentation s'appliquent à chaque couche, et le lignage couvre l'ensemble du parcours, des fichiers bruts au mart final.
2. Standardisez les métriques avec Unity Catalog Semantics
Chaque outil de BI, agent ou autre consommateur de données crée ses propres définitions de métriques, ce qui entraîne de la confusion et des désaccords entre les parties prenantes. Une vue métrique déplace la définition vers un emplacement gouverné unique : vous déclarez les mesures et les dimensions une fois, et chaque consommateur interroge la même logique.
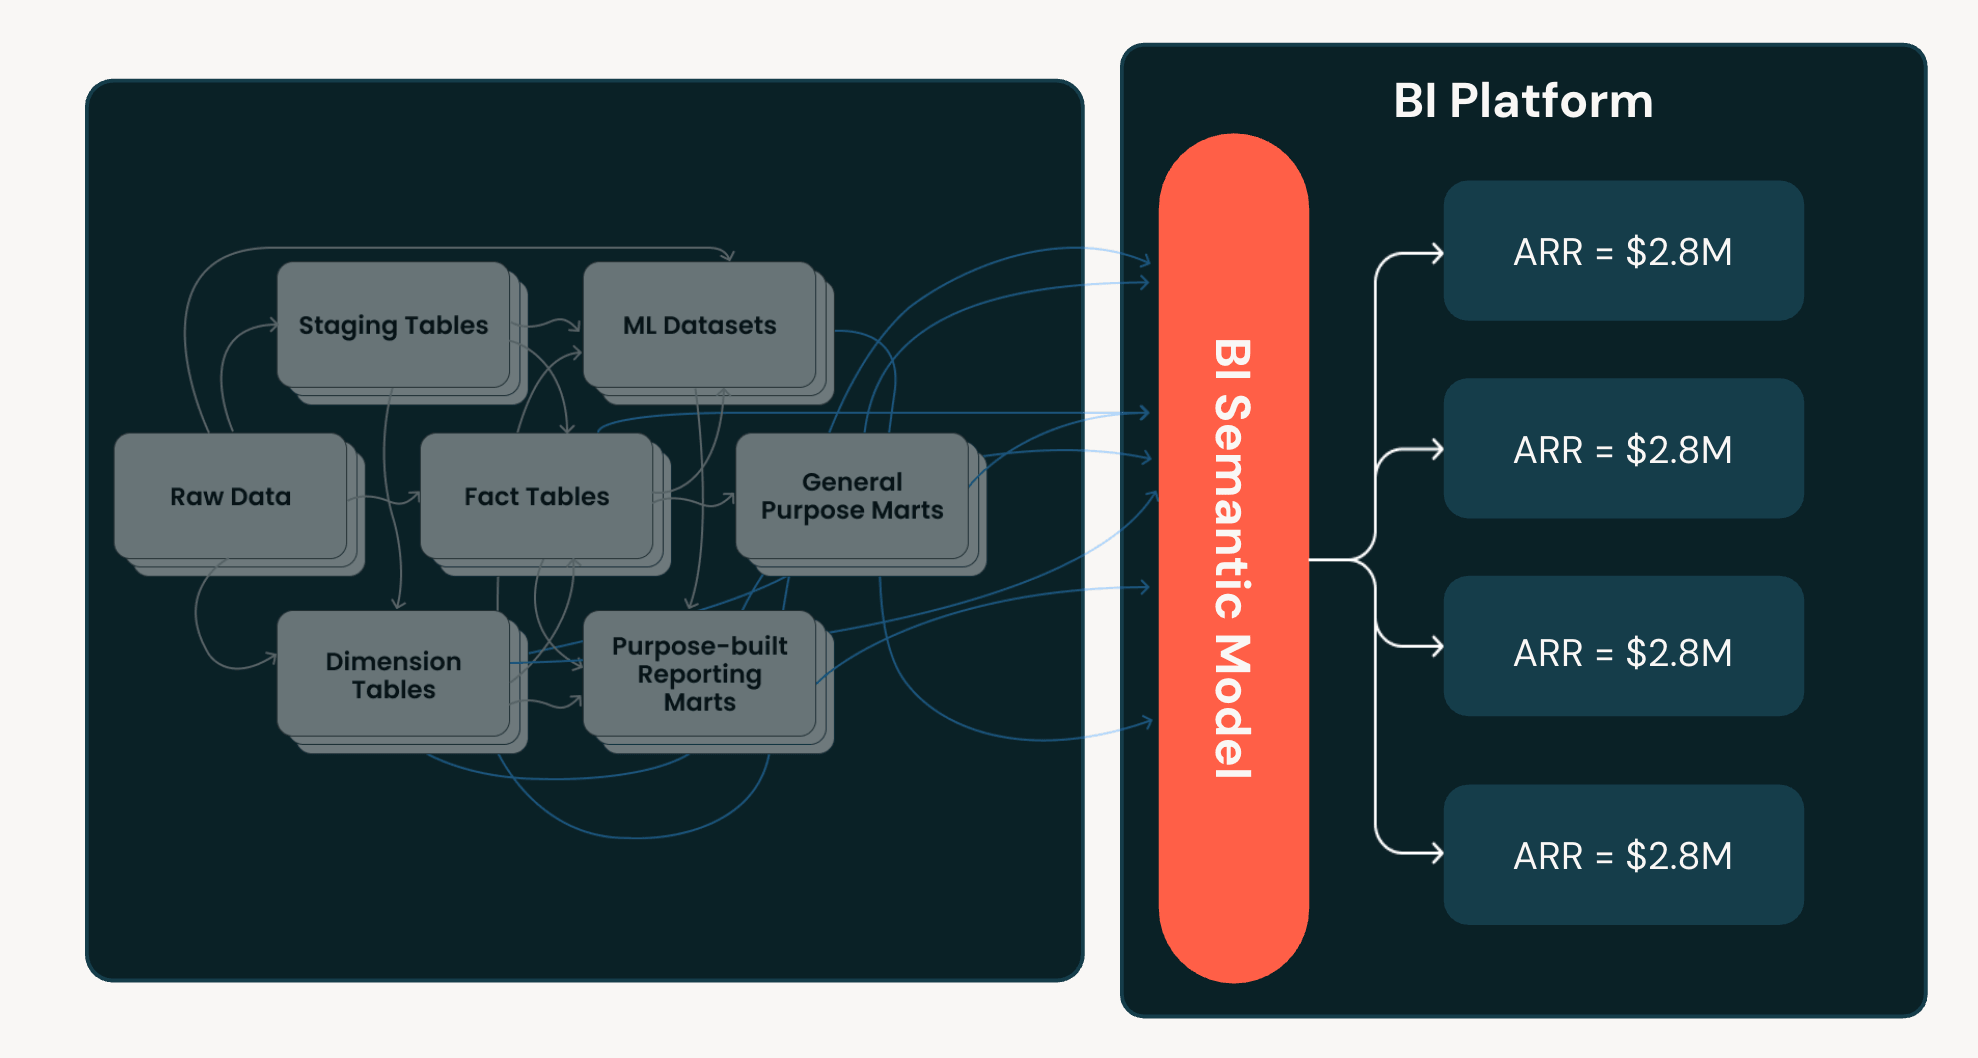
dbt-databricks expose des vues métriques en tant que type de matérialisation natif, ainsi la définition réside dans votre projet dbt, versionnée et révisée comme n'importe quel autre modèle.
Les utilisateurs peuvent choisir leurs propres regroupements au moment de la requête à l'aide de la fonction MEASURE(), ainsi la même définition sert à l'éditeur SQL, aux tableaux de bord BI, aux notebooks et à Genie.
3. Orchestrez dbt en natif via Lakeflow Jobs
Une exécution dbt constitue rarement l'ensemble du pipeline. Lorsque les étapes en amont et en aval résident dans des outils différents, la charge de travail s'accumule : des outils supplémentaires à gérer, financer et sécuriser, avec un lignage éparpillé.
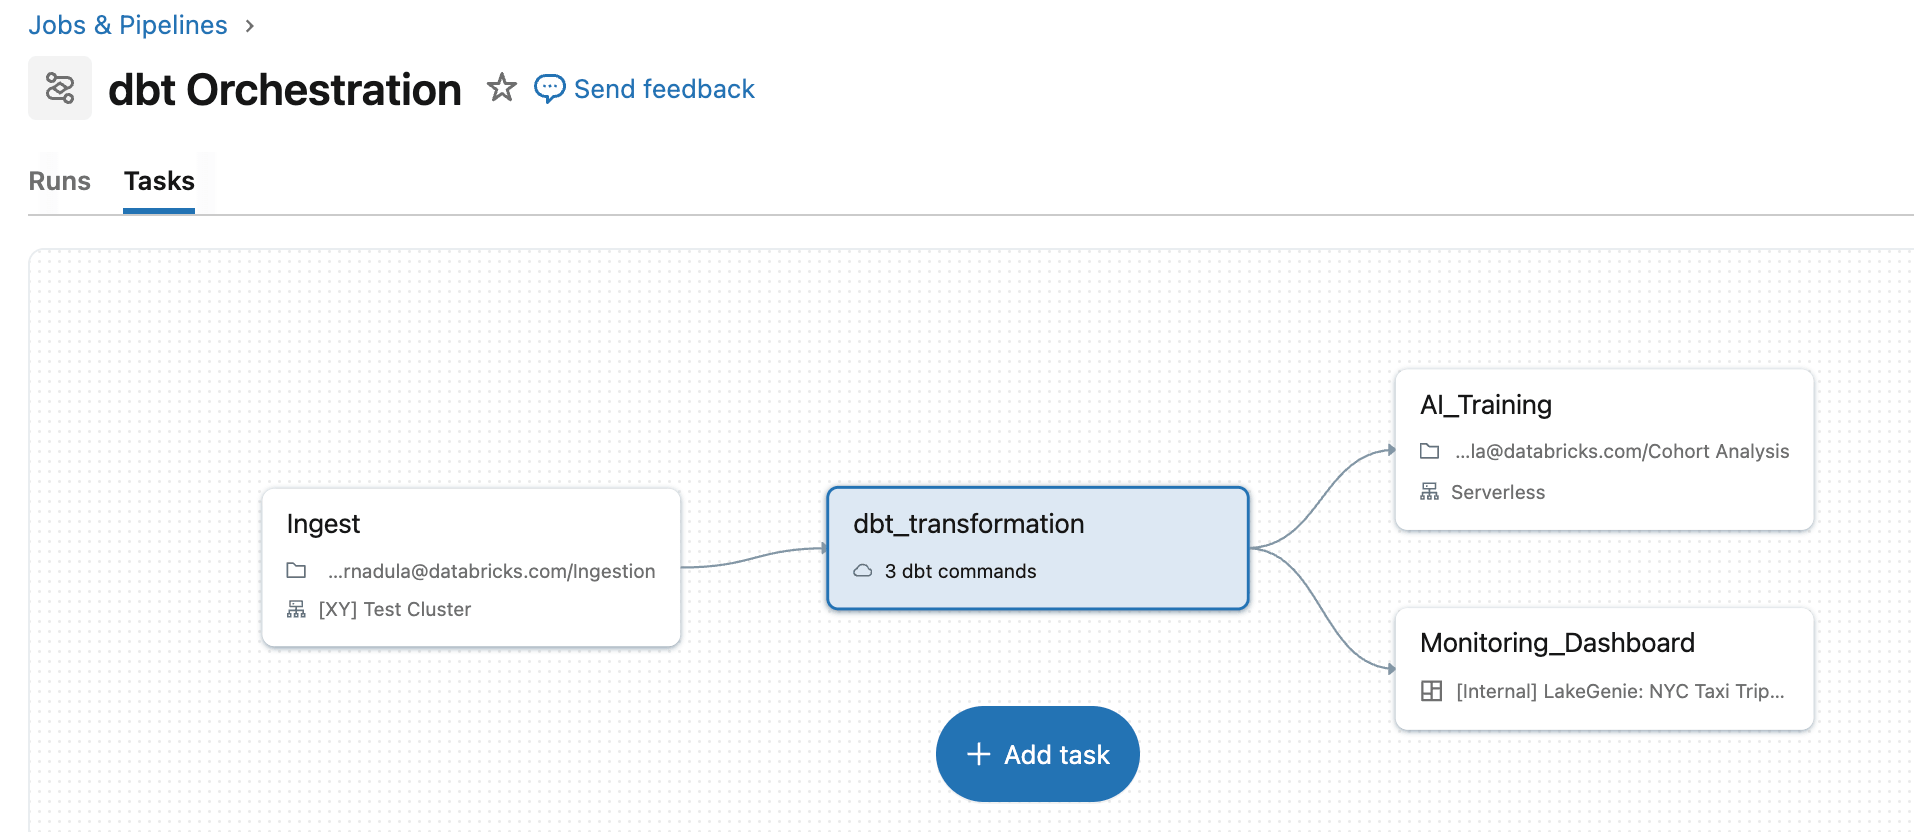
Lakeflow Jobs regroupe tout cela dans un graphe orienté acyclique (DAG) avec dbt comme tâche native. Une tâche d'ingestion alimente la tâche dbt, et les tâches en aval se déclenchent une fois l'exécution terminée, les dépendances étant appliquées par la plateforme. La couche opérationnelle est intégrée avec la planification, les réessais automatiques, l'historique d'exécution et les alertes, sans infrastructure supplémentaire à maintenir. Jobs prend en charge dbt Core et dbt Platform, et la prise en charge de dbt Core v2.0 arrivera prochainement.
4. Déployez sous forme de code avec Declarative Automation Bundles
Un job assemblé manuellement dans l'interface utilisateur est difficile à versionner, réviser ou reproduire. Les Declarative Automation Bundles (DAB) résolvent ce problème en intégrant la définition du job au dépôt de code. Le job Lakeflow, sa planification, ses paramètres de calcul et le projet dbt sont tous déclarés en YAML et déployés sous forme d'un package unique.
Le déploiement avec --target dev crée une copie isolée de l'ensemble du pipeline ; --target prod la promeut.
Les modèles d'un projet ne doivent pas tous s'exécuter à la même fréquence. Marquez les modèles par fréquence dans le fichier YAML de dbt et attribuez à chaque fréquence son propre job qui ne génère que les modèles portant sa balise. Faire passer un modèle d'une fréquence quotidienne à une fréquence horaire se résume à une modification d'une seule ligne :
5. Définissez la gouvernance dans le projet
La gouvernance est généralement configurée après l'exécution de vos modèles, séparément du projet dbt qui construit les données. Comme la gouvernance se situe en dehors de votre projet dbt, elle peut se désynchroniser de vos exécutions dbt.
Définissez la gouvernance dans le projet dbt où résident déjà les modèles. En tant que configuration de projet, elle est livrée avec le code, révisée comme le code, et Unity Catalog l'applique sur chaque requête.
Les balises, les autorisations (grants) et les protections au niveau des lignes et des colonnes peuvent toutes être définies dans la configuration globale du projet dans dbt_project.yml. databricks_tags gère la classification et la politique, grants contrôle qui peut lire la table, et row_filters et column_masks contrôlent ce que chaque utilisateur voit :
À grande échelle, le contrôle d'accès basé sur les attributs (ABAC) élimine la répétition. Définissez une politique sur une balise gouvernée et elle appliquera les bons filtres de lignes et masques de colonnes à chaque table portant cette balise, afin qu'un nouveau modèle balisé pii soit couvert dès sa création. Ne recourez aux filtres et masques par modèle que lorsque la logique est vraiment spécifique au modèle, comme l'isolation multi-tenant.
Le point commun entre ces pratiques est de déléguer le travail opérationnel à la plateforme : traitement incrémentiel, organisation des données, maintenance des tables, application de la gouvernance et orchestration. Ce qui reste dans votre projet dbt, c'est votre logique de transformation testée et sous contrôle de version. Choisissez la pratique qui répond au problème actuel de votre projet et commencez par là.
Rejoignez plus de 3 000 organisations qui utilisent déjà dbt sur Databricks. Lancez-vous avec l'adaptateur dbt-databricks.
(Cet article de blog a été traduit à l'aide d'outils basés sur l'intelligence artificielle) Article original
Recevez les derniers articles dans votre boîte mail
Abonnez-vous à notre blog et recevez les derniers articles directement dans votre boîte mail.