Qu'est-ce que l'AIOps ?
L'AIOps combine l'AI et le machine learning avec l'observabilité pour automatiser les opérations IT. Découvrez ses composants clés, ses avantages, ses cas d'usage et ses défis.
- L'AIOps (Artificial Intelligence for IT Operations) applique l'AI, le machine learning et les données opérationnelles pour détecter les anomalies, corréler les événements, identifier les causes principales et automatiser la réponse aux incidents.
- Il aide les équipes IT et d'ingénierie de plateforme à réduire les risques d'interruption, à limiter la fatigue liée aux alertes, à accélérer la prise de décision et à réduire le temps moyen de résolution (MTTR).
- L'AIOps complète les pratiques d'observabilité et de DevOps en convertissant les signaux bruts du système en intelligence opérationnelle exploitable, tout en conservant une supervision humaine pour les actions à haut risque.
L'intelligence artificielle pour les opérations IT (AIOps) applique l'AI et le machine learning aux opérations IT pour détecter les anomalies, corréler les événements, identifier les causes racines et déclencher des réponses plus rapidement que n'importe quel processus manuel.
Gartner a inventé le terme en 2017. Alors, pourquoi lisez-vous à ce sujet maintenant ?
Parce que l'infrastructure qui fait tourner vos applications en 2026 ne ressemble en rien à ce pour quoi le monitoring traditionnel a été conçu. Vous gérez des centaines de microservices, des dépendances multi-cloud, des charges de travail AI et des systèmes basés sur des agents qui génèrent plus de signaux opérationnels en une heure qu'un ingénieur d'astreinte ne peut en lire en une semaine.
C'est précisément cet écart que l'AIOps est désormais en mesure de combler. Ce guide explique comment cela fonctionne, où il s'intègre et quels éléments évaluer avant de choisir une plateforme.
- L'AIOps applique l'AI et le machine learning aux opérations IT pour détecter les anomalies, corréler les événements, identifier les causes racines probables et permettre une réponse plus rapide aux incidents.
- L'AIOps aide les équipes à réduire le risque d'interruption, à limiter la fatigue liée aux alertes, à accélérer la prise de décision et à accélérer la réponse aux incidents en transformant les données opérationnelles en informations exploitables.
- L'AIOps complète l'observabilité et le DevOps plutôt que de les remplacer, en apportant une intelligence opérationnelle aux ingénieurs AI et de plateforme, tout en conservant une supervision humaine pour les actions à haut risque.
Ce que fait l'AIOps et ce qu'il ne fait pas
L'AIOps analyse les données issues des journaux (logs), des traces, des événements et de la topologie du réseau pour détecter les problèmes et prédire les pannes avant qu'elles ne se transforment en incidents.
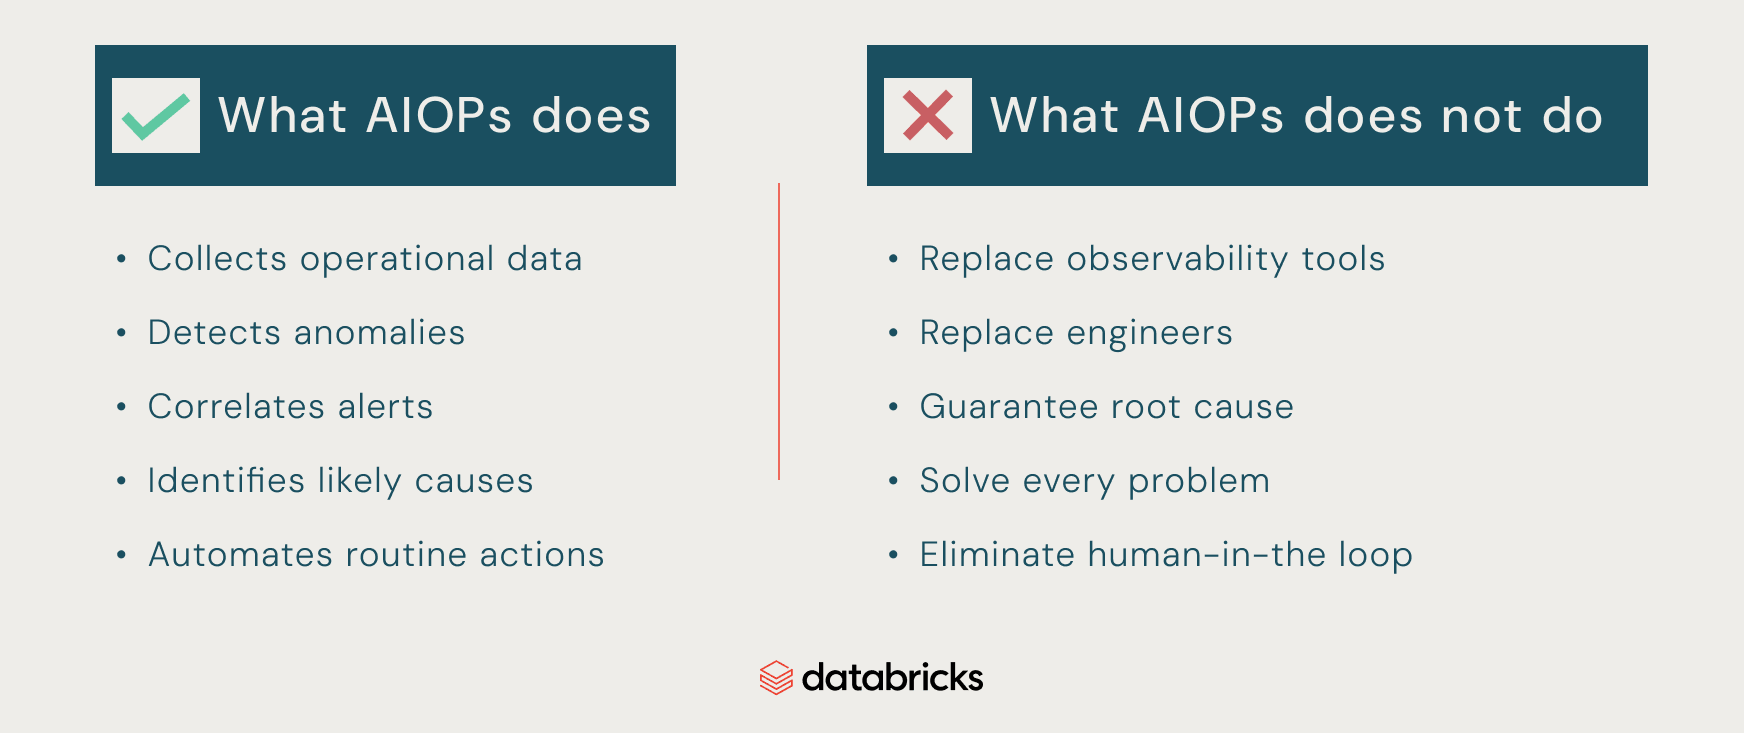
Il se situe entre l'observabilité et l'action. L'observabilité indique ce qui se passe dans les systèmes. L'AIOps récupère ce signal, réduit le bruit, connecte les événements associés et aide les ingénieurs de plateforme à décider de la marche à suivre. Il ne remplace pas l'observabilité, le DevOps ou le jugement humain. Il rend ces trois éléments plus rapides.
Pourquoi maintenant ?
À mesure que l'infrastructure se distribue, le volume de données opérationnelles, la complexité des dépendances et la vitesse du changement augmentent. Les outils de monitoring traditionnels ne répondent plus à ces exigences croissantes et génèrent souvent un bruit excessif, sans contexte clair pour hiérarchiser les menaces. Par conséquent, les équipes de données peinent à identifier les signaux importants avant que les incidents n'impactent les utilisateurs.
Lorsque les équipes exploitent l'AI et le machine learning dans les opérations IT, elles optimisent leurs processus pour :
- Réduire le risque d'interruption : L'AIOps peut détecter les anomalies et corréler les événements associés pour identifier plus tôt les pannes potentielles, aidant ainsi à résoudre les problèmes avant qu'ils ne perturbent les services majeurs et ne provoquent des interruptions.
- Limiter la fatigue liée aux alertes : Le machine learning peut filtrer les alertes répétitives ou de faible valeur et mettre en évidence les événements les plus susceptibles de nécessiter une intervention humaine.
- Accélérer la prise de décision : En ajoutant du contexte aux événements opérationnels et en identifiant les causes racines probables, l'AIOps aide les ingénieurs à comprendre ce qui se passe et à déterminer les prochaines étapes d'investigation.
- Accélérer la réponse aux incidents : Lorsque la correction appropriée est connue, l'AIOps peut recommander ou automatiser des actions telles que le redémarrage de services, la mise à l'échelle des ressources ou le déclenchement de workflows prédéfinis.
Ces facteurs favorisent spécifiquement une détection plus précoce des menaces et une récupération plus rapide. Ils ne signifient pas pour autant que l'AIOps résout tous les goulots d'étranglement de l'automatisation ou élimine le besoin d'ingénieurs.
Quels sont les composants clés de l'AIOps ?
Lors de l'évaluation d'une plateforme d'AIOps, il est important de comprendre ses principaux piliers et leur fonctionnement dans leurs domaines respectifs :
- Ingestion des données : Ici, les plateformes d'AIOps collectent et consolident les données issues des métriques, journaux, traces, événements et alertes provenant de l'infrastructure, des applications et des appareils réseau dans un data lake, un data warehouse ou un lakehouse. Une ingestion de données large et fiable offre à l'AIOps la visibilité nécessaire pour détecter les problèmes dans l'ensemble des environnements IT.
- Normalisation et enrichissement des données : Une fois que l'AIOps a collecté les données de diverses sources, les processus analytiques traitent les données brutes pour mettre en évidence les tendances, prédire les besoins en capacité des environnements et détecter les comportements système inhabituels avant qu'ils ne provoquent des perturbations. Cela offre aux analyses en aval une vue cohérente de ce qui se passe et des points critiques.
- Détection des anomalies. Pour détecter les activités inhabituelles dans les systèmes, les méthodes traditionnelles s'appuient sur des seuils statiques, des limites de CPU et d'autres mesures similaires pour déclencher des alertes. Sans aucun contexte. L'AIOps apprend à quoi ressemble un comportement normal pour chaque métrique, par heure, jour et saison. Ensuite, il ne déclenche des alertes que lorsque ce comportement s'écarte de la référence. Cela donne aux ingénieurs AI plus de temps pour étudier les problèmes potentiels avant qu'ils n'impactent les utilisateurs.
- Corrélation d'événements. Lorsque 10 serveurs différents affichent une utilisation élevée du CPU, l'AIOps connecte les alertes associées au lieu de traiter chaque alerte comme un incident isolé. Cela réduit la fatigue liée aux alertes et permet de se concentrer sur le problème sous-jacent plutôt que sur des centaines d'événements individuels.
- Analyse des causes racines. L'ancienne méthode, qui consiste à suivre individuellement 70 alertes successives, n'est pas viable. L'AIOps comprend la topologie du système, examine les services dépendants lors des alertes et met en évidence la cause racine du problème. À partir des alertes, l'AIOps détermine que le service C est dégradé, tandis que les services A et B ne sont qu'en aval. Cela accélère le dépannage, minimise les interruptions d'activité et fait gagner du temps en évitant une investigation pour chaque incident.
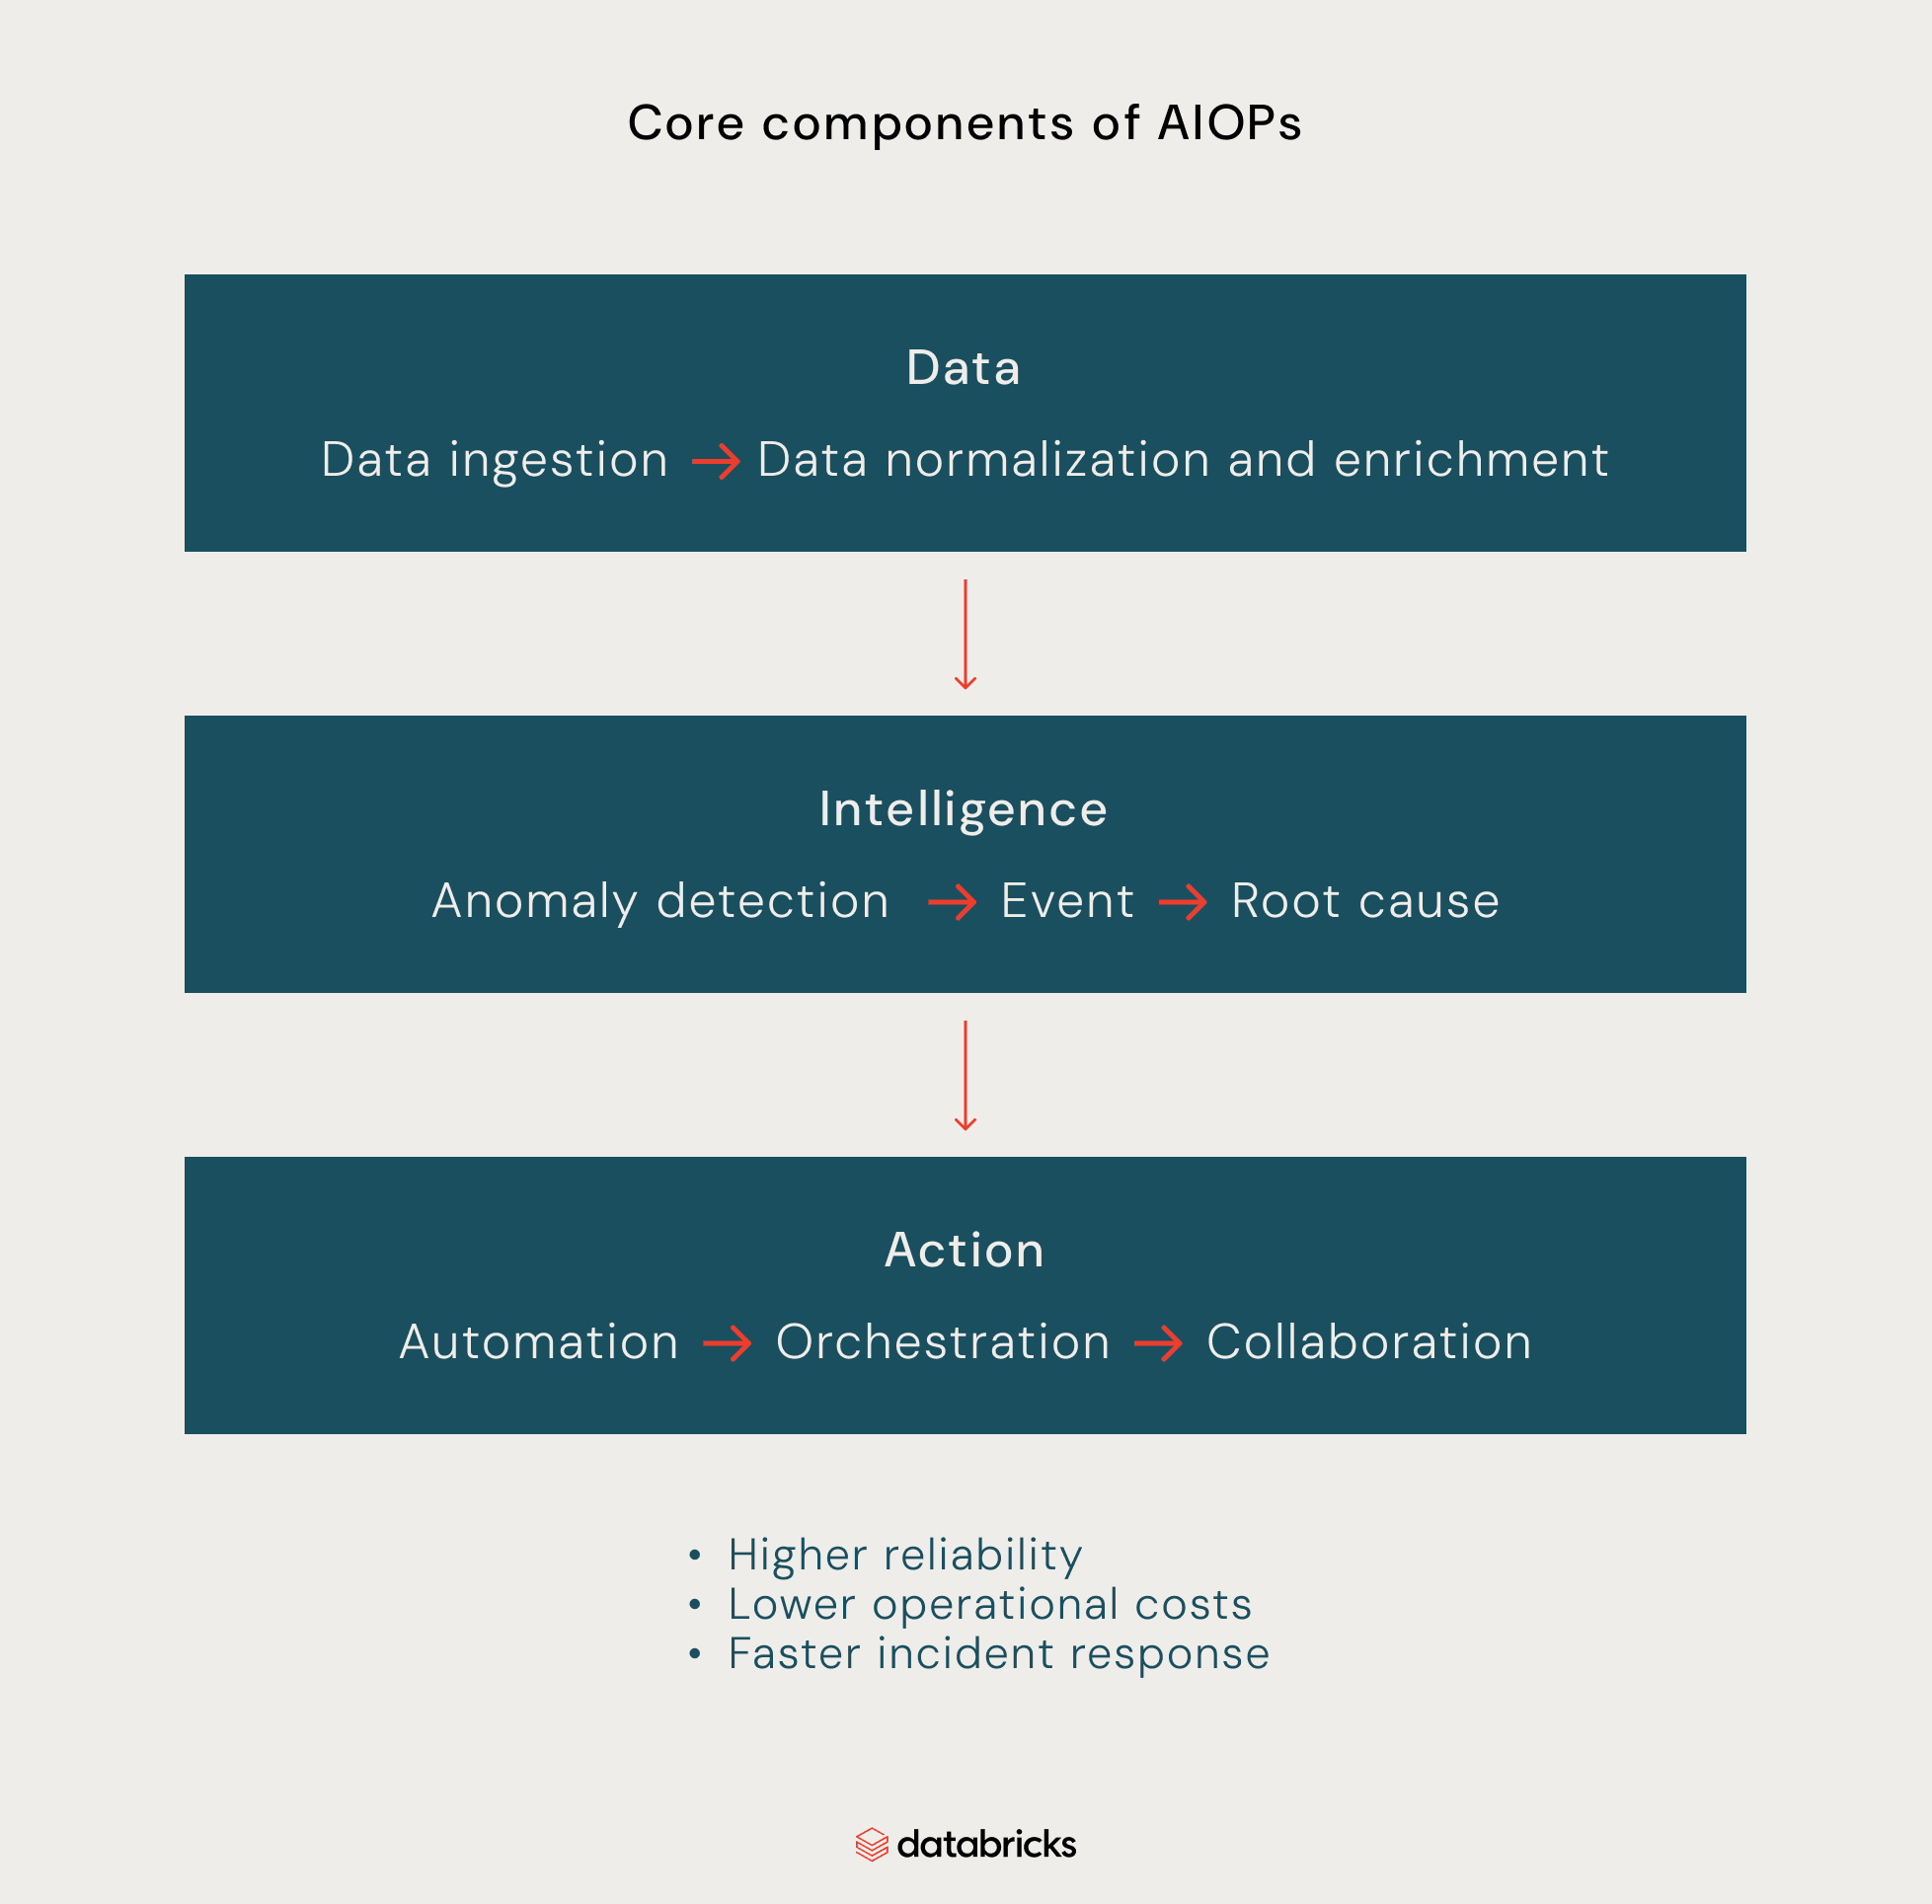
- Automatisation et orchestration. Une fois la cause racine identifiée, l'AIOps transforme ces informations en actions en recommandant ou en exécutant des réponses prédéfinies, telles que le redémarrage d'un service, la mise à l'échelle de l'infrastructure, l'annulation d'un déploiement (rollback) ou l'ouverture d'un ticket. Ce composant réduit l'intervention manuelle, accélère la résolution des incidents et aide à contrôler les coûts opérationnels. Pour des workflows opérationnels plus avancés, Agent Bricks peut aider les équipes à créer et déployer des agents AI qui utilisent les données et les outils de l'entreprise pour effectuer des tâches en plusieurs étapes.
- Workflows de collaboration. Connecte les informations de l'AIOps aux personnes et aux processus responsables de la résolution des incidents. Cela peut inclure le routage des alertes, l'attribution des responsabilités, l'escalade des incidents et la mise à disposition du contexte nécessaire aux ingénieurs pour intervenir.
Une fois ces composants clés présentés, voyons comment ils s'articulent dans la section suivante.
Comment fonctionne l'AIOps ?
Le processus AIOps commence par la collecte de signaux provenant des applications, des infrastructures, des réseaux et des services cloud. Les données subissent ensuite un nettoyage, au cours duquel les signaux en double, incomplets ou incohérents sont organisés dans un format que l'AIOps peut analyser.
Par exemple, votre système détecte que votre application commence soudainement à renvoyer un nombre élevé d'erreurs d'interface de programmation d'application (API). L'AIOps compare le comportement actuel de votre application avec les modèles précédents et signale l'augmentation des erreurs comme inhabituelle.
Grâce à la corrélation d'événements, la plateforme d'AIOps associe les erreurs d'API à d'autres signaux, tels qu'une augmentation soudaine de la charge de la base de données ou un déploiement récent. L'analyse des causes probables examine ensuite ces signaux connectés pour déterminer les causes plausibles. Au lieu de traiter les erreurs d'API, la charge de la base de données et le déploiement comme des événements distincts, l'AIOps identifie le déploiement récent comme la source probable de l'incident.
La dernière étape est la réponse guidée ou automatisée. Selon le workflow, l'AIOps peut recommander une action corrective, ouvrir un ticket, avertir l'équipe concernée ou exécuter automatiquement une réponse prédéfinie, comme l'annulation du déploiement (rollback).
Les actions à plus haut risque devraient nécessiter une intervention humaine (human-in-the-loop) pour permettre aux ingénieurs d'examiner et d'approuver la réponse avant qu'elle n'affecte la production.
Quels sont les principaux types d'AIOps ?
Les types d'AIOps dépendent de ce qui convient le mieux à l'entreprise, de la portée de ses opérations, des systèmes à gérer et du niveau d'interconnexion de l'infrastructure.
Les approches centrées sur un domaine (domain-centric) et indépendantes du domaine (domain-agnostic) sont les deux principaux types d'AIOps. Aucune ne remplace directement l'autre ; elles ont chacune leurs forces et leurs compromis :
L'AIOps centrée sur le domaine se concentre sur un domaine spécifique, tel que la gestion du cloud, les performances réseau ou la surveillance des applications. Une approche centrée sur le domaine est idéale pour résoudre les problèmes liés à un domaine spécifique ; elle offre un contexte plus approfondi et une analyse plus spécialisée au sein de cet environnement.
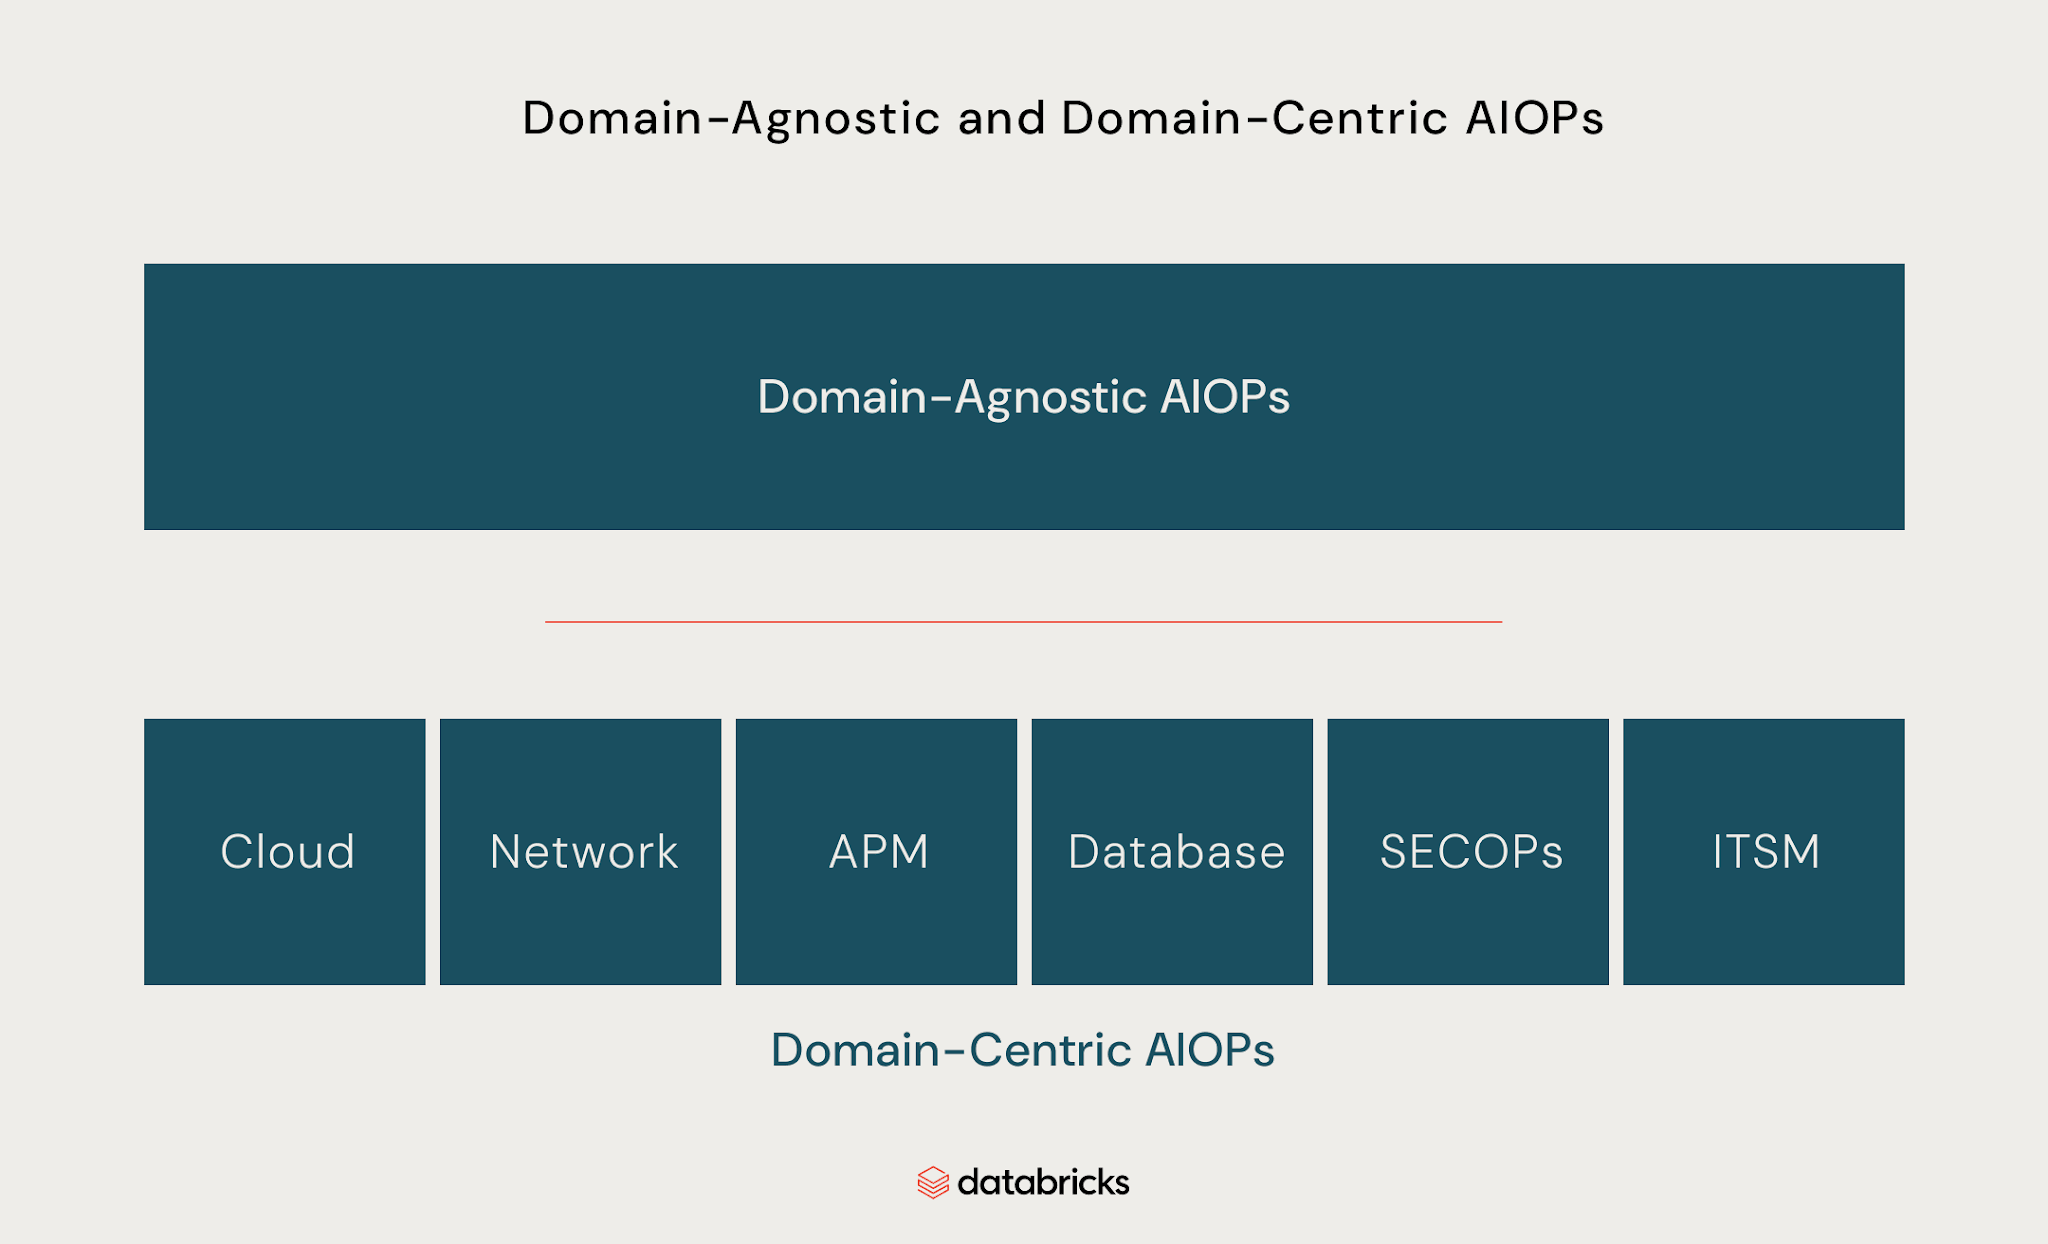
L'AIOps agnostique au domaine fonctionne sur plusieurs environnements IT, collectant et analysant les données de systèmes tels que les applications, les réseaux, l'infrastructure cloud et le stockage. Contrairement à l'approche centrée sur le domaine, les plateformes d'AIOps agnostiques au domaine sont plus adaptées à la résolution de problèmes plus larges. Cela les rend particulièrement adaptées aux organisations qui gèrent des infrastructures complexes et interconnectées où les incidents dépassent souvent les frontières opérationnelles.
L'AIOps centrée sur le domaine peut offrir une plus grande profondeur et une intelligence plus spécialisée au sein d'un seul domaine, tandis que l'AIOps agnostique au domaine offre une plus grande portée et une visibilité plus large sur l'ensemble des systèmes et des outils.
Cas d'usage courants de l'AIOps
Les cas d'usage de l'AIOps couvrent de nombreux aspects des opérations IT ; parmi les applications les plus courantes, on trouve :
Analyse des causes racines
L'AIOps aide à identifier la cause probable d'une panne, d'une erreur ou d'un problème de performance. Plutôt que de traiter un pic d'erreurs d'API comme un incident isolé, l'AIOps peut le corréler avec un déploiement récent, une panne de base de données ou un changement de configuration réseau.
Détection d'anomalies
L'AIOps analyse en continu les données du système pour établir une référence et détecter les écarts susceptibles d'entraîner des incidents et des pannes.
Surveillance des performances
L'AIOps peut surveiller les environnements IT sur le cloud, sur site et hybrides avec des services et des dépendances interconnectés. Cela permet d'identifier les tendances et de hiérarchiser les problèmes grâce à une surveillance constante et à la corrélation des performances.
Adoption et migration vers le cloud
Les migrations vers le cloud introduisent de nouvelles dépendances entre les charges de travail, les API, les services et l'infrastructure. L'AIOps cartographie ces relations, surveille les changements de comportement du système et identifie les goulots d'étranglement potentiels avant qu'ils ne perturbent les services critiques. L'AIOps offre une visibilité plus claire sur les environnements hybrides et multicloud pendant la migration.
Adoption du DevOps
Le DevOps accélère le rythme de développement et de déploiement, mais introduit également des risques opérationnels et des problèmes qui peuvent échapper à l'œil humain. L'AIOps surveille l'activité de déploiement, analyse son impact sur la production et peut déclencher des réponses prédéfinies en cas de problème.
L'AIOps et le DevOps s'adressent à différentes étapes du cycle de vie de la livraison et des opérations logicielles, et sont plus efficaces lorsqu'ils sont intégrés.
Le guide pratique de l'IA agentique pour l'entreprise

AIOps vs DevOps : quelle est la différence ?
Il ne s'agit pas de choisir entre l'AIOps ou le DevOps, mais d'associer l'AIOps et le DevOps. Les deux approches se complètent plutôt que de s'opposer. Le DevOps fournit le modèle opérationnel pour créer, tester et déployer des logiciels, tandis que l'AIOps applique l'intelligence opérationnelle aux systèmes qui les exécutent.
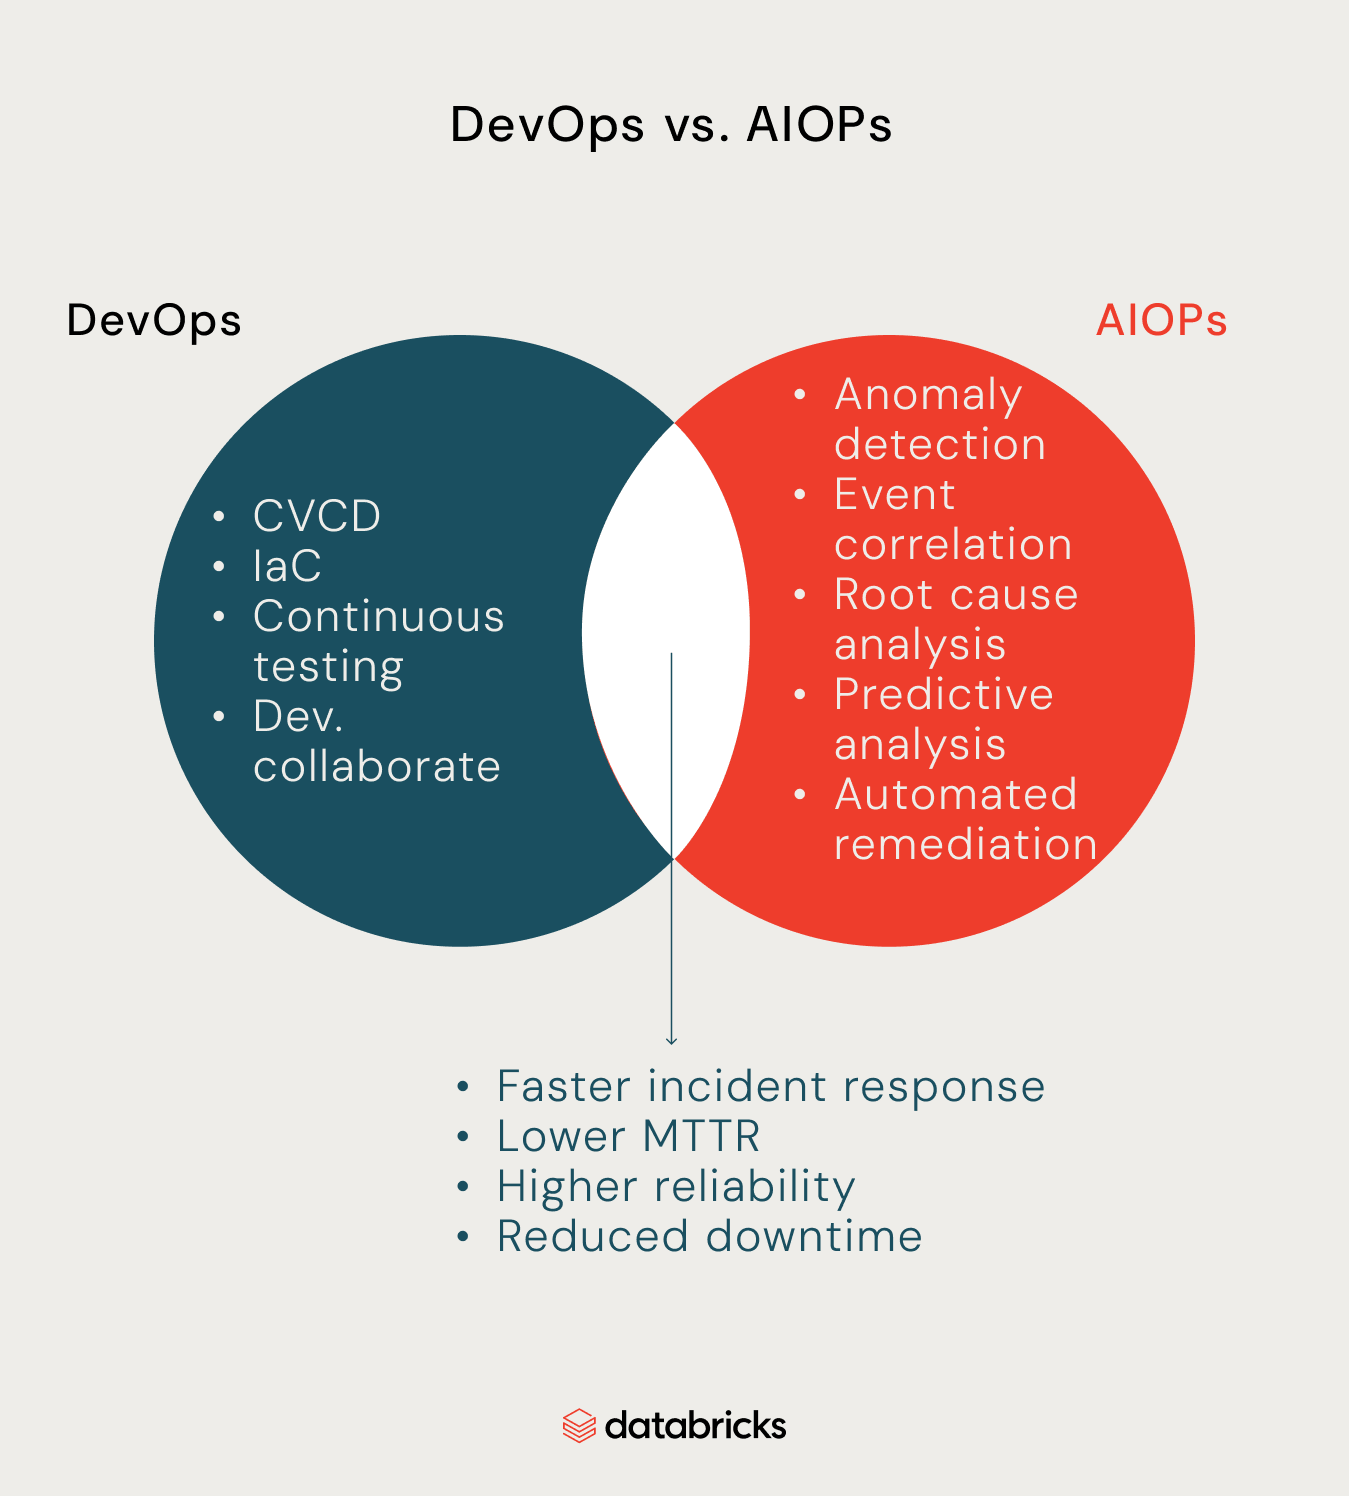
Le DevOps relie le développement et les opérations en automatisant la livraison de logiciels tout en permettant aux développeurs de publier des modifications plus rapidement. L'AIOps étend ce modèle opérationnel en analysant les données de l'infrastructure, des applications et d'autres systèmes pour détecter les anomalies, corréler les événements, identifier les causes probables et faciliter une résolution plus rapide.
| DevOps | AIOps | |
|---|---|---|
| Objectif principal | Livraison de logiciels et collaboration | Opérations IT et intelligence opérationnelle |
| Rôle | Modèle opérationnel et pratiques d'ingénierie | Analyse et automatisation basées sur l'IA |
| Éléments analysés | Code, builds, tests, déploiements | Métriques, logs, traces, événements et alertes |
| Résultats clés | Livraisons plus rapides et plus fiables | Détection, réponse et rétablissement plus rapides |
| Fonctionnement conjoint | Déploie les modifications en production | Surveille et réagit à leur impact opérationnel |
Le DevOps peut déployer une nouvelle version d'application tandis que l'AIOps surveille son impact sur la production. Si le déploiement présente un comportement inhabituel, l'AIOps peut corréler les signaux, identifier la cause probable et soit déclencher une réponse prédéfinie, soit alerter l'ingénieur concerné. Ensemble, ils permettent d'avancer plus rapidement avec une visibilité claire.
Quels sont les avantages de l'AIOps ?
Les principaux avantages de l'AIOps sont un MTTR plus rapide, des coûts opérationnels réduits, une meilleure observabilité et collaboration, ainsi qu'une gestion plus prédictive des ITOps. Chaque avantage est directement lié à la manière dont les ingénieurs de plateforme détectent, comprennent et résolvent les incidents.
- MTTR plus rapide : L'AIOps peut corréler les événements, identifier les causes racines probables et recommander les actions suivantes plus rapidement qu'une investigation manuelle. Cela réduit le temps que les ingénieurs passent à retracer les incidents et permet de rétablir plus rapidement les services affectés.
- Coûts opérationnels réduits : L'AIOps automatise les tâches répétitives de détection, d'investigation et de résolution, réduisant ainsi l'effort manuel requis pour gérer des environnements IT en pleine croissance. Elle peut également aider à prévenir les interruptions de service coûteuses en identifiant les problèmes avant qu'ils ne s'aggravent.
- Meilleure observabilité et collaboration : L'AIOps rassemble les signaux provenant de l'infrastructure, des applications et d'autres systèmes opérationnels dans une vue partagée de la santé du système. Cela donne aux équipes de développement, de sécurité et des opérations IT un meilleur contexte lors de l'investigation des incidents et de la coordination des réponses.
- Gestion prédictive des ITOps : L'AIOps utilise des données opérationnelles historiques et en temps réel pour identifier des schémas pouvant indiquer des pannes futures ou des problèmes de capacité. Les équipes de données peuvent hiérarchiser ces risques et agir avant qu'ils ne se transforment en incidents majeurs.
Ces résultats dépendent de la qualité des signaux reçus par la plateforme d'AIOps, d'une attribution claire de la responsabilité des processus opérationnels et de l'intégration aux flux de travail existants. Sans ces éléments, l'AIOps peut ajouter du bruit et de l'automatisation sans pour autant améliorer la réponse aux incidents.
Malgré ces raisons d'intégrer l'AIOps au sein des organisations, il reste encore certaines contraintes à prendre en compte.
Quelles sont les limites de l'AIOps ?
L'AIOps présente des lacunes à plusieurs égards ; son efficacité dépend de la qualité des données, du contexte disponible pour ses modèles et de la manière dont les ingénieurs IA intègrent ses recommandations dans les flux de travail existants.
- Écarts de qualité des données : Des données incomplètes, incohérentes ou bruitées provenant des logs, métriques, traces, événements et autres sources peuvent produire des corrélations inexactes, des anomalies non détectées ou des alertes inutiles.
- Manque de contexte : Des signaux opérationnels, sans informations préalables sur les dépendances, les déploiements récents, les configurations ou l'impact métier, peuvent amener l'AIOps à identifier une anomalie sans en comprendre correctement la cause ou la gravité.
- Dérive des modèles : Les modèles entraînés sur des schémas historiques peuvent perdre en précision à mesure que les systèmes, les charges de travail et les références opérationnelles évoluent, ce qui nécessite une surveillance et un ajustement continus.
- Risque de sur-automatisation : Les équipes ne peuvent pas automatiser entièrement une étape de résolution complexe sans garde-fous appropriés. Cela risquerait de transformer un incident mineur en un problème plus grave. Les actions à haut risque doivent conserver une supervision humaine.
- Prolifération des outils : L'ajout d'une autre plateforme d'AIOps à une pile de surveillance et d'observabilité fragmentée peut complexifier l'ensemble.
- Faible confiance ou adoption : Les ingénieurs sont moins enclins à s'appuyer sur des recommandations qu'ils ne peuvent pas comprendre ou vérifier. Les équipes de données ont besoin d'une attribution claire des responsabilités, de recommandations explicables et de résultats mesurables avant de déployer l'AIOps sur des opérations critiques.
Les équipes de données et les ingénieurs IA doivent connaître ces limites, car elles permettent de définir les attentes et de les aider à préparer plus efficacement leurs stratégies de gouvernance et de gestion des risques.
Unity Catalog fournit ces stratégies de gouvernance et l'accès aux actifs de données et d'IA dans un catalogue unique, aidant ainsi les équipes à contrôler l'accès aux données sensibles et réglementées.
Comment les organisations peuvent-elles mettre en œuvre l'AIOps ?
Pour que les organisations mettent en œuvre l'AIOps dans leurs opérations IT, il est important de noter qu'il s'agit d'un processus progressif plutôt que d'une transformation radicale. Cela implique de se concentrer sur le séquençage en l'introduisant par étapes, en validant sa valeur et en l'étendant pour instaurer la confiance dans le système.
Commencez par un problème opérationnel à fort impact pour lequel AIOps peut apporter des avantages mesurables, comme la réduction de la fatigue liée aux alertes ou l'amélioration de la réponse aux incidents.
Unifiez les signaux opérationnels pertinents, ajoutez du contexte sur les dépendances et le comportement du système, et commencez par des recommandations avant de permettre à AIOps d'automatiser des actions à plus haut risque. Les équipes qui conçoivent des workflows opérationnels basés sur des agents sur Databricks peuvent utiliser Agent Bricks pour créer et déployer des agents, MLflow pour le traçage et l'évaluation, Unity Catalog pour un accès gouverné, et Unity Gateway pour le contrôle du trafic des modèles et des outils.
Les équipes commencent à faire confiance aux recommandations, à opérationnaliser les workflows et à définir des métriques telles que le MTTR, le volume d'alertes et la fréquence des incidents pour mesurer l'impact. À partir de là, les organisations peuvent étendre AIOps à d'autres systèmes tout en gérant les changements apportés aux outils, processus et responsabilités existants.
Découvrez comment Mosaic AI aide les organisations à gérer et à gouverner l'AI dans l'ensemble de leurs opérations.
Quelles sont les différentes approches d'AIOps ?
Pour déterminer si une approche d'AIOps centrée sur le domaine ou agnostique au domaine est préférable pour l'infrastructure et les processus de votre organisation, tenez compte de la couverture, de la profondeur, des intégrations, de l'effort de configuration et de l'adéquation.
- Couverture : Avez-vous besoin d'AIOps pour un seul domaine opérationnel ou pour plusieurs équipes, systèmes et environnements ?
- Profondeur : Votre équipe a-t-elle besoin d'une intelligence spécialisée pour un domaine particulier, ou d'une analyse plus large de systèmes interconnectés ?
- Intégrations : Cette approche peut-elle se connecter à vos outils existants de surveillance, d'observabilité, de cloud et d'opérations IT ?
- Effort de configuration : Combien de temps et d'efforts opérationnels faudra-t-il pour déployer, configurer et maintenir la solution ?
- Adéquation organisationnelle : Est-elle alignée avec les compétences de votre équipe, les workflows existants, le modèle de responsabilité et les objectifs opérationnels ?
L'examen attentif et la réponse à ces questions offrent aux équipes un meilleur modèle de décision quant à l'approche à adopter. Le bon choix est celui qui correspond à vos exigences opérationnelles.
Prochaines étapes
AIOps applique l'AI et le machine learning aux données opérationnelles pour détecter les problèmes plus tôt, comprendre leur impact et y répondre plus rapidement. Elle fonctionne de manière optimale en tant que couche d'intelligence qui renforce le travail des ingénieurs et les processus existants d'observabilité et d'opérations IT, plutôt que de les remplacer.
Commencez par identifier les domaines dans lesquels AIOps peut apporter le plus de valeur, qu'il s'agisse de la détection d'anomalies, de l'analyse des causes racines, de la réponse aux incidents ou de la surveillance des performances. Évaluez ensuite les données et les intégrations disponibles, proposez des recommandations avant de mettre en œuvre une automatisation à plus haut risque, et mesurez l'impact sur des métriques clés telles que le volume d'alertes et les coûts opérationnels.
Pour créer et gérer des applications basées sur des agents et des grands modèles de langage (LLM), explorez MLflow pour découvrir comment il peut soutenir le cycle de vie de vos applications et vos workflows opérationnels.
Foire aux questions
Que signifie AIOps ?
AIOps signifie Artificial Intelligence for IT Operations. Elle utilise l'AI, le machine learning et les données opérationnelles pour détecter, analyser et résoudre les problèmes IT.
Quelles données AIOps utilise-t-elle ?
AIOps peut analyser les données opérationnelles, y compris les logs, les métriques, les traces, les événements, les alertes, les données de configuration et d'autres signaux provenant des systèmes IT.
En quoi AIOps diffère-t-elle de l'observabilité ?
L'observabilité permet de collecter et de comprendre ce qui se passe dans les systèmes. AIOps s'appuie sur ces signaux opérationnels en appliquant l'AI et le machine learning pour corréler les événements, détecter les anomalies, identifier les causes probables et soutenir ou automatiser les réponses.
En quoi AIOps diffère-t-elle de MLOps ?
AIOps applique l'AI et le machine learning aux opérations IT, tandis que MLOps se concentre sur le développement, le déploiement, la surveillance et la gestion des modèles de machine learning et de leur cycle de vie. Ils résolvent des problèmes opérationnels différents, bien qu'ils puissent se chevaucher dans les organisations qui exploitent des systèmes de ML à grande échelle.
AIOps est-elle un outil ou une pratique ?
AIOps est à la fois une pratique et une catégorie d'outils. La pratique consiste à appliquer l'AI et le machine learning aux opérations IT, tandis que les plateformes d'AIOps fournissent les capacités de traitement des données, d'analyse, de corrélation et d'automatisation nécessaires pour soutenir cette pratique.
(Cet article de blog a été traduit à l'aide d'outils basés sur l'intelligence artificielle) Article original
Recevez les derniers articles dans votre boîte mail
Abonnez-vous à notre blog et recevez les derniers articles directement dans votre boîte mail.