Migliorare l'interoperabilità dei cataloghi con Unity Catalog e il Borderless Lakehouse di Google Cloud
Scopri come Databricks e Google stanno migliorando l'interoperabilità attraverso gli standard aperti.
- I clienti possono accedere alla stessa copia di dati da BigQuery o Databricks senza duplicazioni.
- Google e Databricks sono impegnate in una visione a lungo termine dei metadati di catalogo condivisi.
L'architettura Lakehouse sta diventando sempre più aperta. Quello che è iniziato con i formati di tabelle aperte – Delta Lake e Iceberg – si è evoluto nella federazione dei cataloghi per l'accesso zero-copy su più piattaforme. Grazie alla nostra partnership e ai contributi open source, Databricks e Google Cloud continuano a promuovere i progressi nella community di Open Lakehouse.
Oggi siamo orgogliosi di annunciare un traguardo importante nell'interoperabilità dei cataloghi in collaborazione con Google: i clienti possono ora accedere a una singola copia di dati sia da Unity Catalog che dal borderless Lakehouse di Google Cloud. La partnership tra Databricks e Google Cloud continua a crescere e siamo impegnati a rendere l'interoperabilità bidirezionale semplice e fluida.
Unity Catalog e Lakehouse di Google Cloud: Federazione bidirezionale
Portare i dati da Google Cloud a Databricks è semplice. Con Lakehouse Federation su Google Cloud, ora disponibile a livello generale, i clienti possono montare tabelle Iceberg gestite dal catalogo di runtime Lakehouse di Google Cloud in Unity Catalog per l'analisi in Databricks.
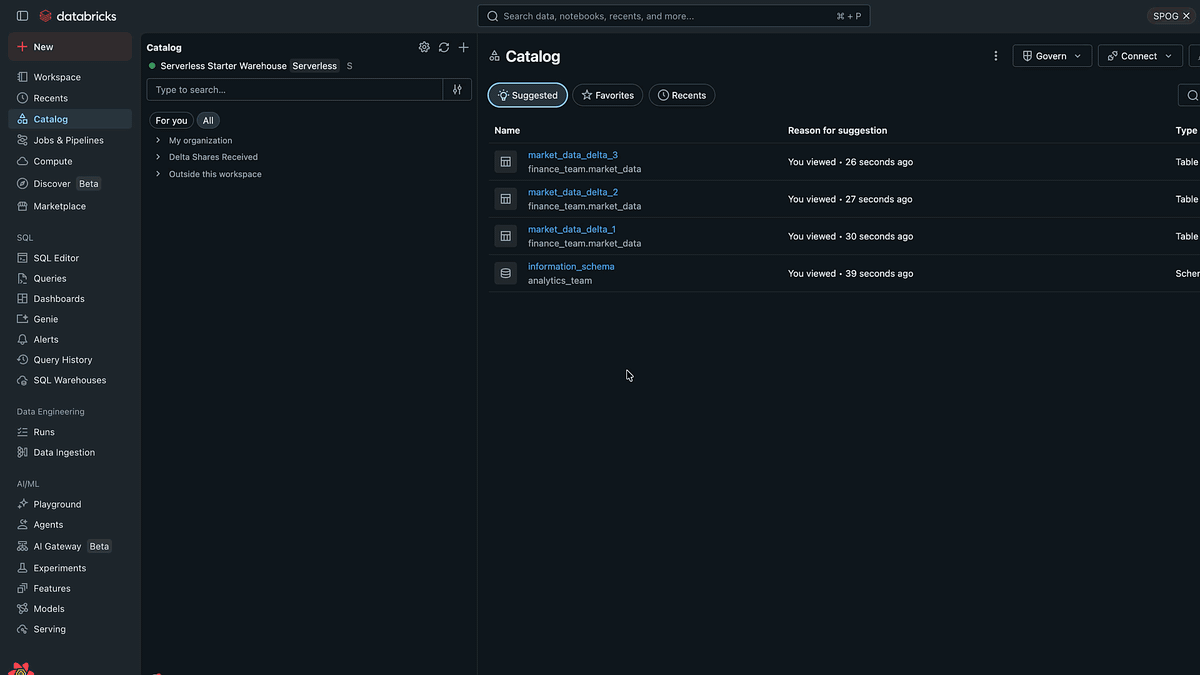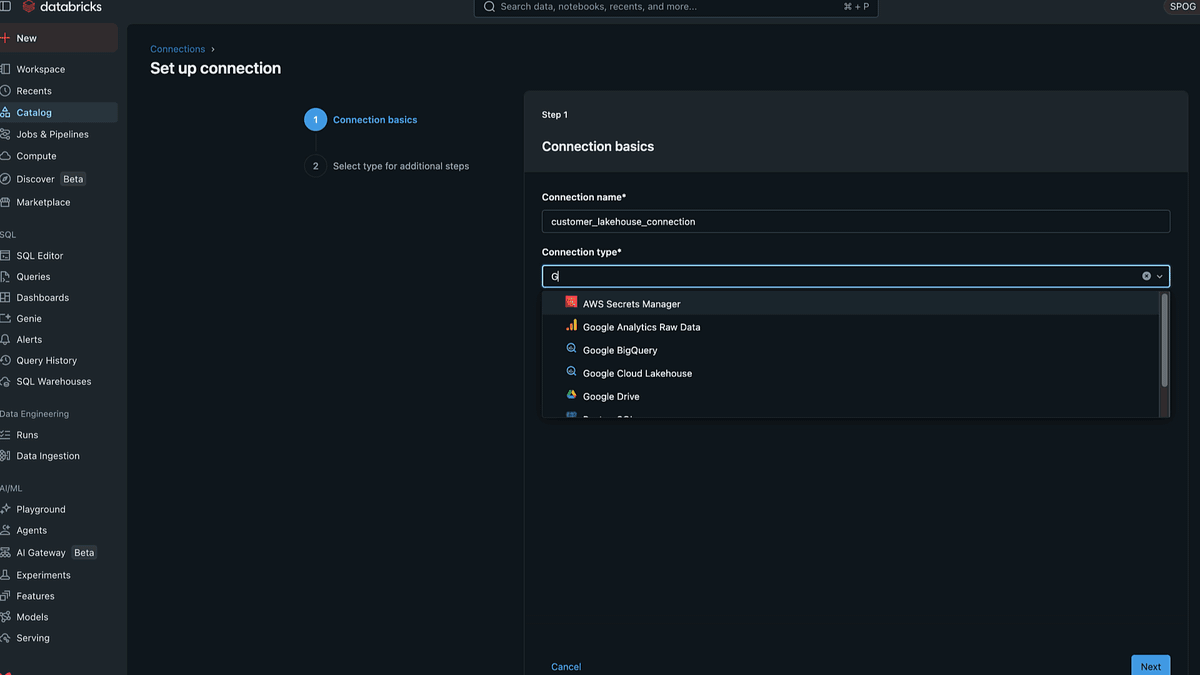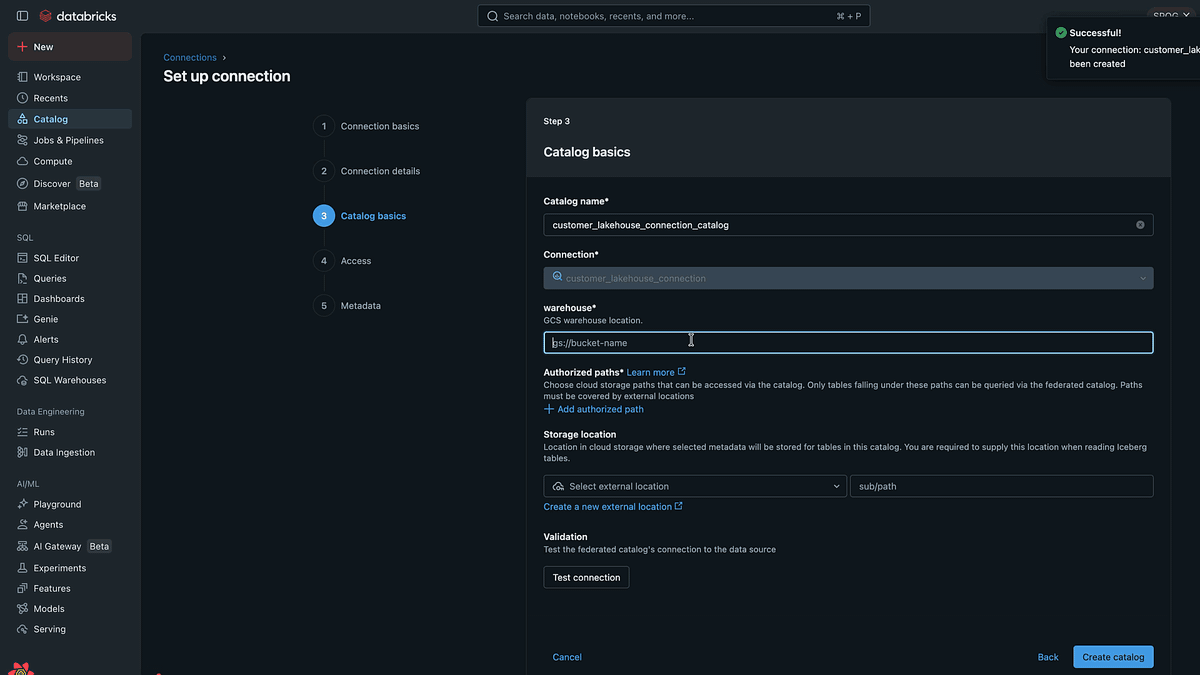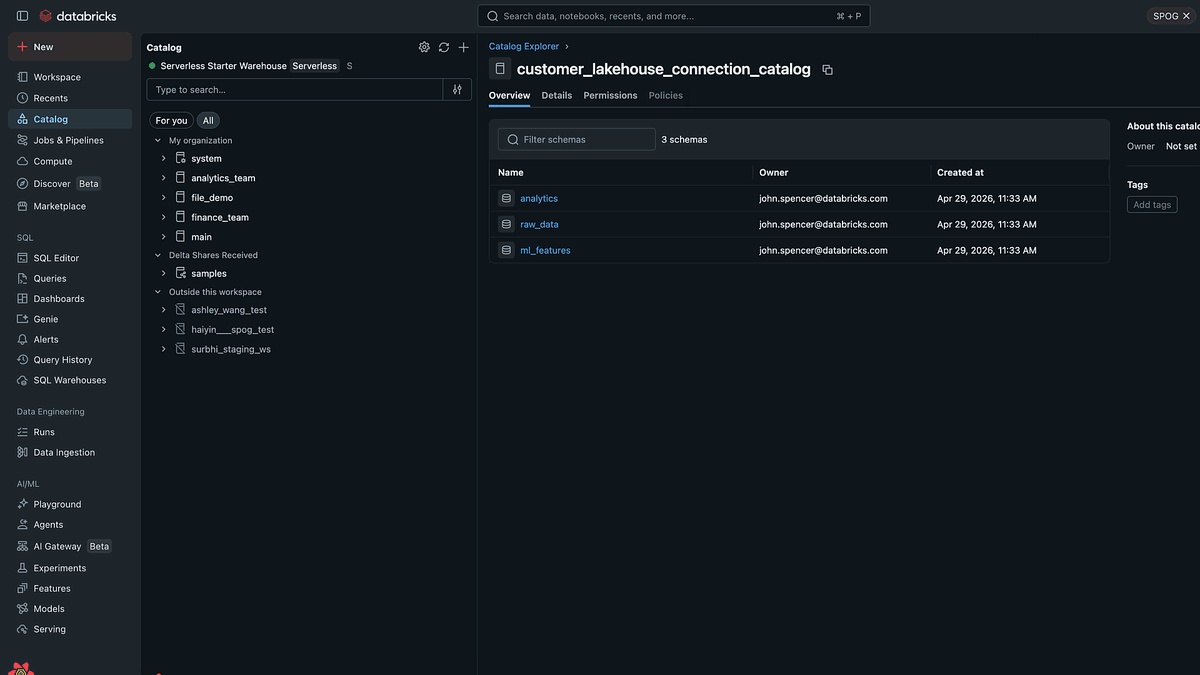
Queste tabelle Iceberg del catalogo di runtime Lakehouse di Google possono quindi essere interrogate da Databricks Lakehouse, il nostro data warehouse serverless, o analizzate tramite Genie, che risponde in modo intelligente alle domande sui dati formulate in linguaggio naturale, senza bisogno di codice o SQL.
L'interoperabilità funziona anche nell'altra direzione. I dati di Databricks possono anche essere portati nel Lakehouse di Google Cloud (scopri di più). Ciò consente ai clienti che utilizzano motori come BigQuery di leggere le tabelle gestite da Unity Catalog senza duplicare i dati.
La prossima frontiera: rendere interoperabili i metadati dei cataloghi
Databricks e Google Cloud stanno facendo grandi passi avanti per rafforzare l'interoperabilità rendendo aperti i metadati dei cataloghi. Crediamo che la semantica di business e di governance debba essere accessibile anziché vincolata a un fornitore specifico. Nella community di Iceberg, abbiamo contribuito a promuovere e implementare le etichette di catalogo, una proposta che consente ai cataloghi di condividere i metadati tramite coppie chiave-valore (note anche come etichette). In questo modo, una tabella contrassegnata come "domain=finance" e "status=certified" con una colonna contrassegnata come "pii=ssn" continua a mantenere i tag anche quando la tabella viene federata da un catalogo all'altro (scopri di più).
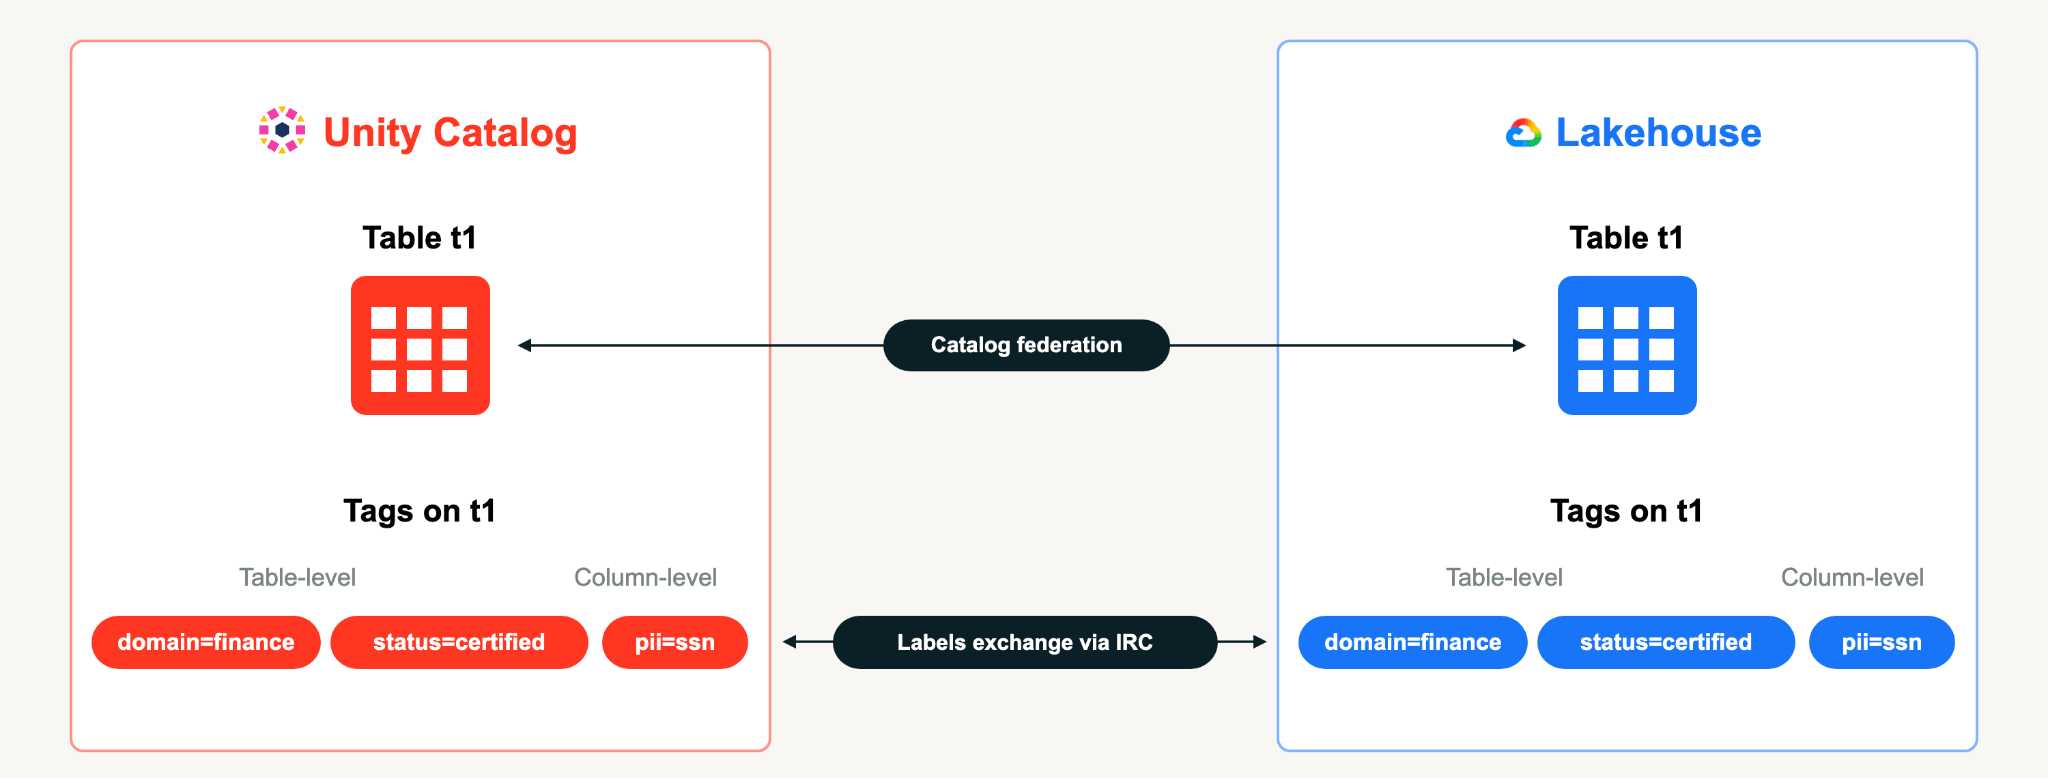
Le etichette condivise sono fondamentali per la governance nell'era degli agenti, poiché i metadati del catalogo possono essere utilizzati per contrassegnare i dati sensibili per il mascheramento e fornire contesto agli agenti che cercano risorse per rispondere a domande sui dati. Attraverso la nostra partnership, Databricks e Google Cloud si impegnano a far progredire la visione della governance aperta. Con la crescita dei volumi di dati e la crescente integrazione degli agenti IA nei flussi di lavoro aziendali, questo impegno condiviso diventa sempre più importante. Ci stiamo muovendo verso un futuro in cui la governance e il contesto di business possono viaggiare insieme ai dati senza che le aziende debbano ridefinirli in ogni sistema.
Inizia oggi
Inizia a usare la federazione dei cataloghi tra Unity Catalog e il borderless Lakehouse di Google Cloud leggendo la nostra documentazione. Puoi anche scoprire di più sulla federazione dei cataloghi di Google verso Unity Catalog qui.
Se sei interessato a condividere le tue esigenze di interoperabilità o a saperne di più sulla nostra visione per l'interoperabilità, contatta il tuo team di account Databricks.
(Questo post sul blog è stato tradotto utilizzando strumenti basati sull'intelligenza artificiale) Post originale
Ricevi gli ultimi articoli nella tua casella di posta
Iscriviti al nostro blog e ricevi gli ultimi articoli direttamente nella tua casella di posta.