Porta Databricks in Kiro IDE con il Databricks Power
Due modi per collegare Kiro IDE alla piattaforma Databricks: i quattro server MCP gestiti da Databricks per partire in 10 minuti, oppure il Databricks Power con le skill ufficiali per agenti per tutte le funzionalità.
- Due modi per collegare Kiro IDE a Databricks: i quattro server MCP gestiti da Databricks (Genie, SQL, Unity Catalog Functions, AI Search) per una configurazione in 10 minuti basata su PAT, oppure il Databricks Power, che installa le skill ufficiali di Databricks per agenti con la Databricks CLI.
- Sviluppo assistito dall'AI basato sui metadati reali del workspace: entrambi i percorsi ereditano i tuoi permessi di Unity Catalog, i filtri di riga e le maschere di colonna, così l'assistente scrive SQL con le tue colonne reali e vede solo ciò che puoi vedere tu.
- Scegli in base all'ambito: il percorso A è la configurazione più leggera per analisti e sviluppatori orientati al SQL; il percorso B apre l'intera piattaforma Databricks (pipeline, job, Agent Bricks, Lakebase, Declarative Automation Bundles) direttamente nell'IDE.
Perché è importante
Lo sviluppo assistito dall'AI va in crisi nel momento in cui l'assistente deve indovinare nomi di colonne, struttura delle tabelle o quali cataloghi puoi leggere. La soluzione è il grounding: collega l'assistente ai metadati in tempo reale del workspace tramite il Model Context Protocol (MCP). In questo modo il SQL che scrive usa le tue colonne reali, i modelli dbt uniscono tabelle reali e ogni query eredita i permessi di Unity Catalog che hai già configurato. L'accesso viene applicato in Databricks, quindi l'AI vede solo ciò che puoi vedere tu.
Due traguardi appena raggiunti rendono tutto questo concreto in Kiro IDE, sviluppato da AWS:
Primo, Kiro è ora un agente supportato dalla Databricks CLI. Dalla CLI v1.20.0, databricks aitools install --agents kiro installa le skill ufficiali di Databricks per agenti in ~/.kiro/skills/. Le skill che prima erano incluse nel Databricks AI Dev Kit sono ora queste skill ufficiali, e le installa la CLI.
Secondo, il Databricks Power nel catalogo Kiro Powers ora installa le stesse skill ufficiali: configura le skill con la Databricks CLI e non include alcun server MCP. Installalo dal pannello Powers; la sua skill di configurazione ti guida nel controllo della CLI, nell'accesso e nell'installazione delle skill.
Insieme ai quattro server MCP remoti gestiti da Databricks già inclusi nella piattaforma, hai due modi per collegare Kiro a Databricks. Entrambi portano allo stesso risultato: gli sviluppatori rilasciano più velocemente analisi, pipeline e workflow di agenti quando l'assistente eredita i permessi reali del workspace invece di indovinare schemi, colonne e permessi.
Perché scegliere Databricks per lo sviluppo assistito dall'AI
I due traguardi qui sopra rendono concreto Kiro × Databricks. Ma ciò che conta davvero è quello che c'è sotto. Quattro elementi fanno di Databricks la base ideale per lo sviluppo assistito dall'AI, qualunque percorso tu scelga.
Unity Catalog ancora l'AI a livello dei dati. Ogni chiamata viene eseguita con i tuoi permessi, che si tratti di uno strumento MCP nel percorso A o di un comando della Databricks CLI eseguito da una skill nel percorso B: i permessi sulle tabelle, i filtri di riga e le maschere di colonna si applicano al SQL e agli agenti Genie, mentre gli indici di AI Search vengono condivisi singolarmente. L'assistente non ha una visione privilegiata dei tuoi dati; vede ciò che vedi tu. Non c'è un livello separato di controllo degli accessi da gestire per l'assistente.
Una sola copia dei dati, un solo insieme di definizioni. Poiché Databricks è un lakehouse, la tabella che l'assistente interroga tramite databricks-sql è la stessa in cui scrive il tuo modello dbt, la stessa esposta dal tuo agente Genie e la stessa letta dalla tua dashboard AI/BI. Non c'è alcuna sincronizzazione tra warehouse e lake che possa interrompersi, né un livello semantico separato da mantenere allineato. Quando l'assistente si basa su samples.tpch.lineitem, usa la stessa definizione di tutti gli altri strumenti.
L'intero stack di AI è integrato, non aggiunto a posteriori. Unity Gateway instrada le chiamate ai modelli. Agent Bricks orchestra workflow multi-agente. MLflow traccia esperimenti e valutazioni. AI Search alimenta il retrieval semantico. Lakebase gestisce lo stato transazionale. Le skill coprono tutto questo (databricks-unity-gateway, databricks-agent-bricks, databricks-mlflow-evaluation, databricks-vector-search e databricks-lakebase), tutto sullo stesso Unity Catalog. Non stai mettendo insieme cinque prodotti; stai usando un'unica piattaforma.
Le skill sono sviluppate da Databricks. I protocolli sono aperti, ma le indicazioni contenute nelle skill sono scritte da Databricks appositamente per il modo in cui lavorano i nostri clienti.
I due percorsi a colpo d'occhio
Aspetto | Percorso A: server MCP gestiti | Percorso B: Databricks Power |
|---|---|---|
Ambito | 4 server: Genie, SQL, Unity Catalog Functions, AI Search | Skill ufficiali di Databricks per agenti, più le skill di MLflow |
Cosa ottieni | SQL in linguaggio naturale, ricerca semantica, esecuzione di funzioni governata | L'ambito del percorso A, più pipeline, job, dashboard, Lakebase, Agent Bricks, Declarative Automation Bundles, MLflow, Model Serving e Apps |
Hosting | Gestito da Databricks (HTTPS remoto) | Skill installate sulla tua macchina dalla Databricks CLI (databricks aitools); nessun server MCP |
Autenticazione | PAT nell'ambiente della shell | Profilo della Databricks CLI, OAuth U2M consigliato |
Configurazione | Modificare ~/.kiro/settings/mcp.json ed esportare le variabili d'ambiente | Installare il Power, poi seguire la sua configurazione guidata della CLI |
Ideale per | Analisti e sviluppatori orientati al SQL che vogliono porre una domanda al proprio warehouse in 10 minuti | Data engineer e sviluppatori di piattaforme che hanno bisogno di tutte le funzionalità di Databricks in un unico IDE |
L'architettura di integrazione a colpo d'occhio
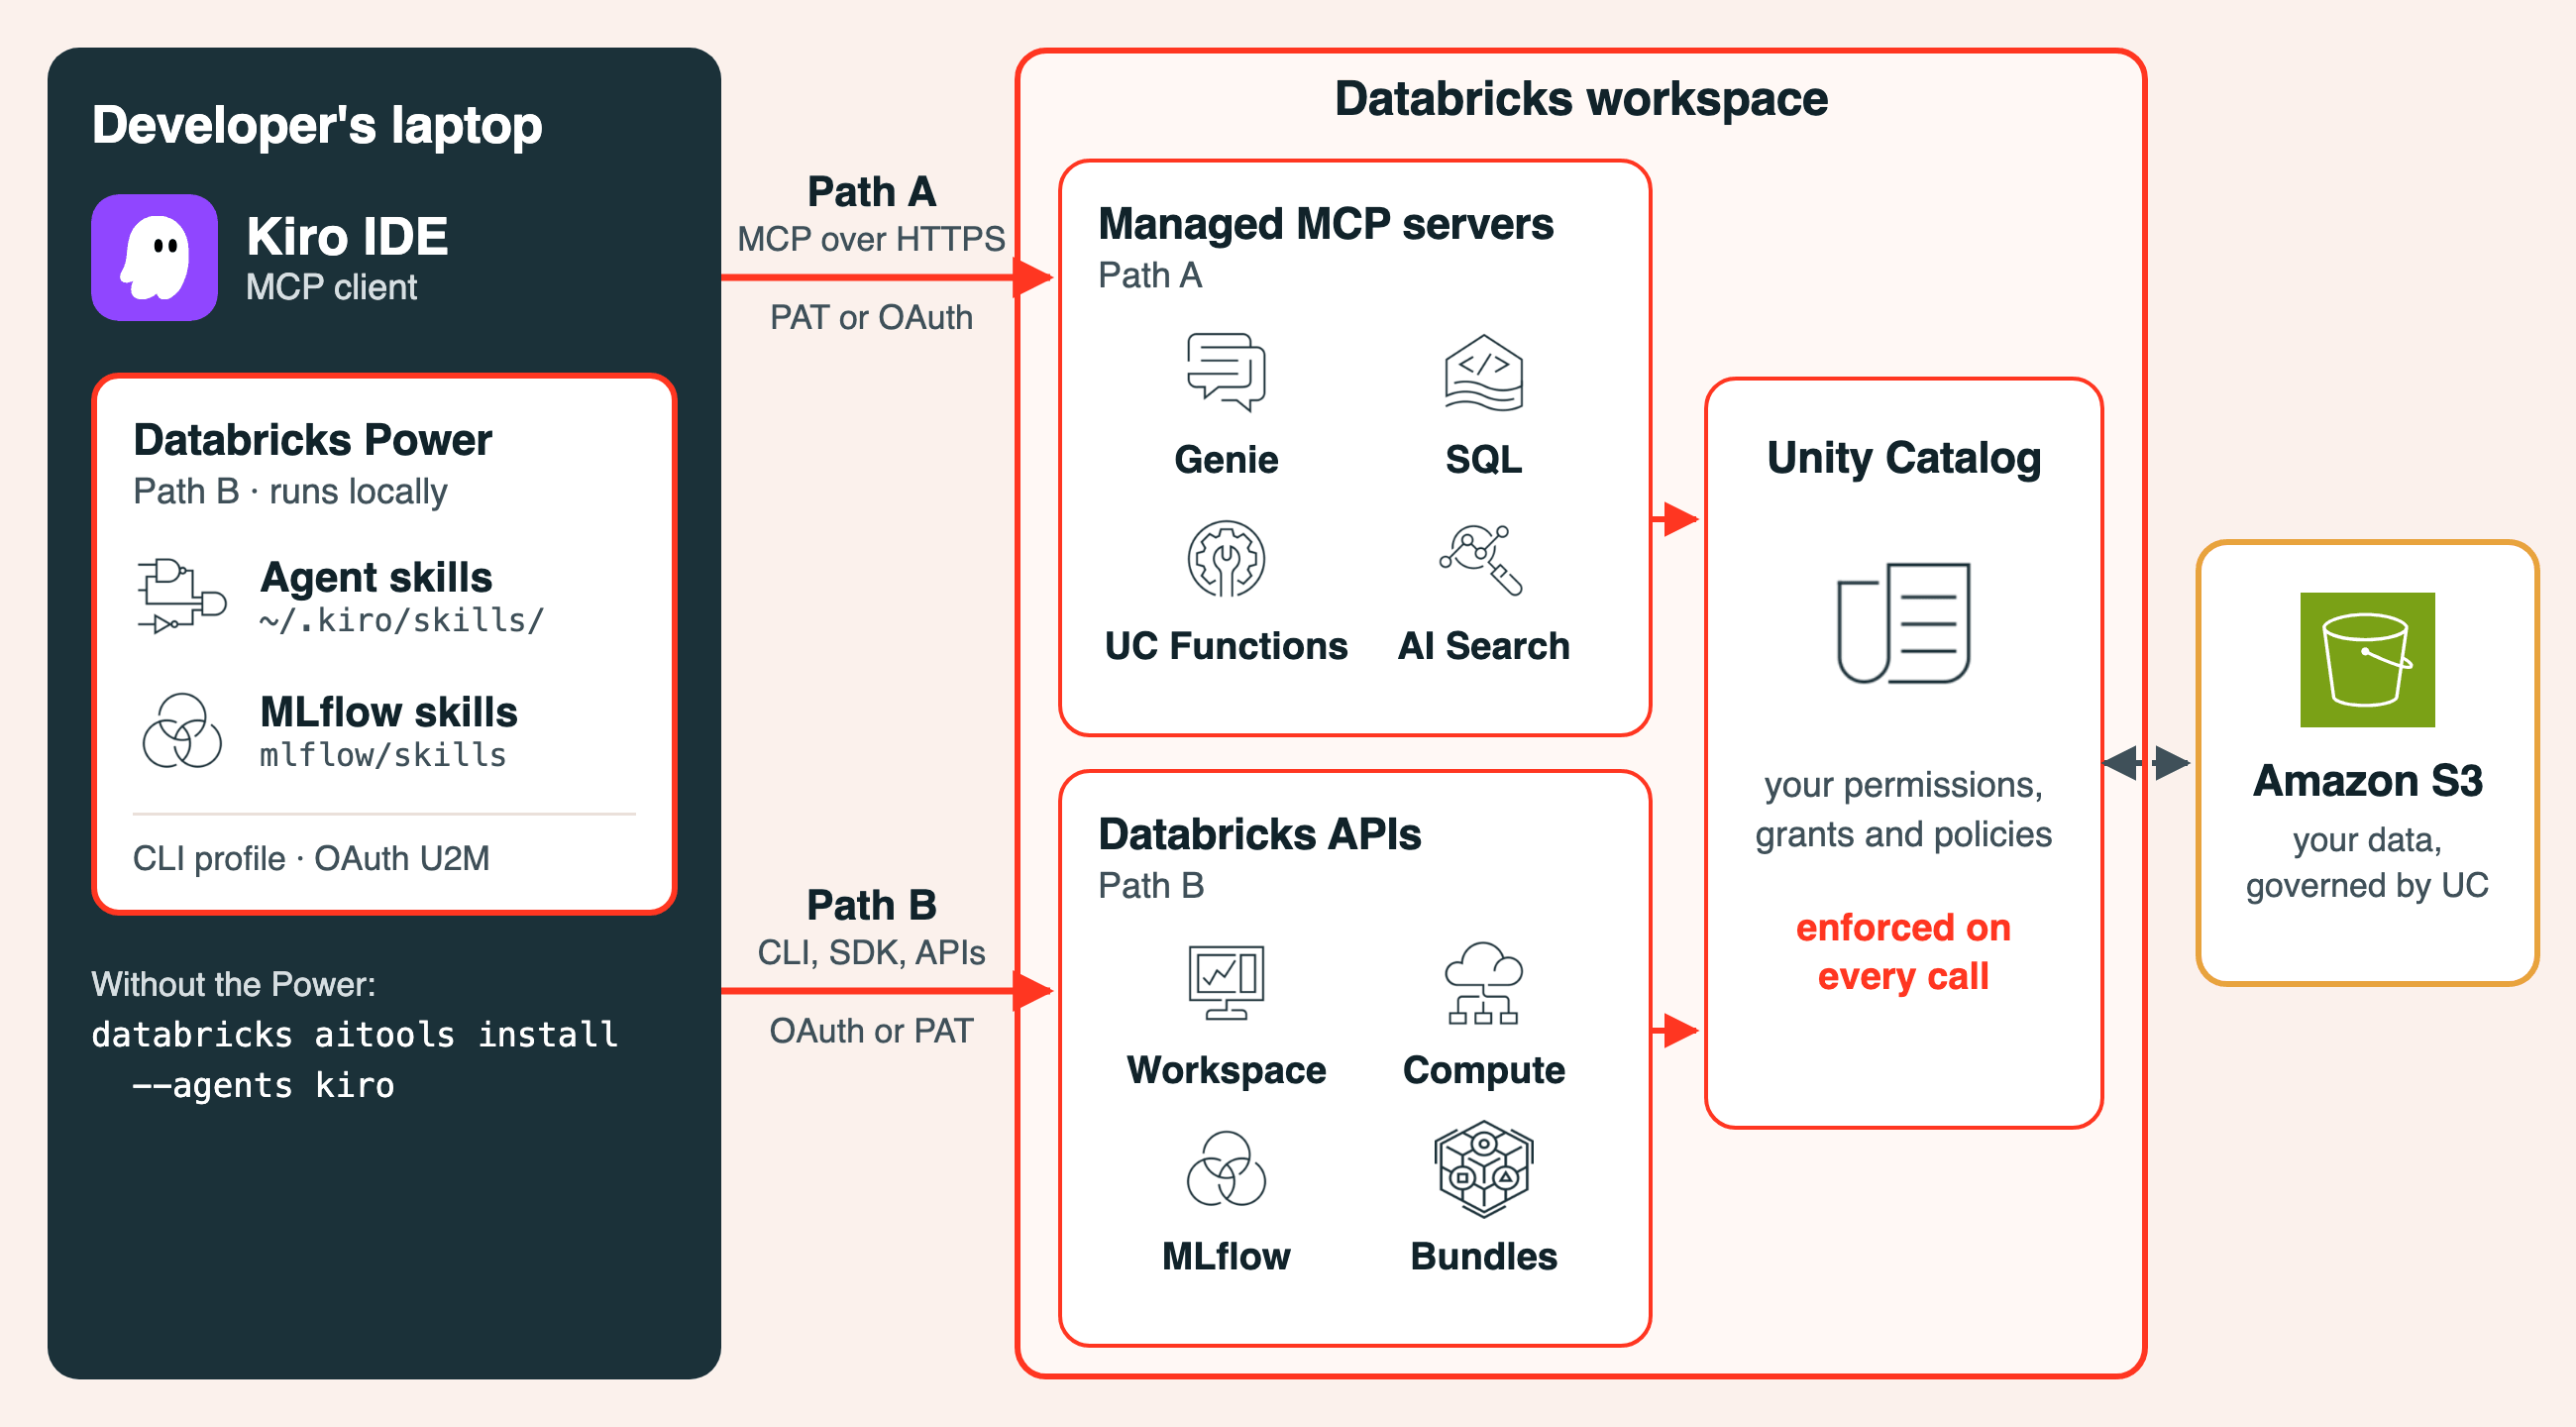
Entrambi i percorsi condividono lo stesso back-end: l'applicazione delle regole di Unity Catalog e l'identità del workspace Databricks. Differiscono per ambito e modello di autenticazione.
Percorso A: collegarsi ai quattro server MCP gestiti
È la configurazione più leggera: un file mcp.json, un Personal Access Token di Databricks e una modifica al profilo della shell. In meno di 10 minuti Kiro comunica con Genie, SQL, Unity Catalog Functions e AI Search.
Per le nuove integrazioni, Databricks consiglia ora gli MCP system.ai tramite Unity Gateway. I quattro endpoint /api/2.0/mcp di questo percorso sono in Public Preview e non sono governati da Unity Gateway. L'accesso continua a seguire i tuoi permessi sulle risorse sottostanti (agenti Genie, tabelle, funzioni, indici e SQL warehouse); rinunci solo al tracciamento di Unity Gateway e ai suoi permessi, policy e guardrail a livello MCP. L'MCP Genie One (system.ai.genie_one_mcp) è disponibile per tutti, e la skill di configurazione del Databricks Power mostra come aggiungerlo a mcp.json. Consulta Databricks-provided MCPs per entrambe le opzioni.
Prerequisiti
- Un workspace Databricks su AWS con Unity Catalog abilitato.
- Un amministratore del workspace ha abilitato Managed MCP Servers nella pagina Previews del workspace. Senza questa impostazione, gli URL riportati di seguito non funzionano.
- Un Personal Access Token (PAT) di Databricks o un token OAuth con ambito per i server MCP che intendi usare (
sql,unity-catalog,genie,ai-search). I PAT inutilizzati vengono revocati automaticamente dopo 90 giorni. - Kiro installato e avviato almeno una volta, in modo che
~/.kiro/esista. - Il nome host del tuo workspace nel formato
<workspace>.cloud.databricks.com.
Generare un PAT di Databricks
Nel workspace Databricks vai su Settings, Developer, Access tokens, Manage, Generate new token. Imposta una scadenza in linea con la policy di rotazione del tuo team. Seleziona solo gli ambiti API di cui hai bisogno; il privilegio minimo è meglio della comodità del «tutto». Copia subito il token. Databricks non lo mostra di nuovo.
Dove Kiro memorizza la configurazione MCP
Kiro legge la configurazione MCP in formato JSON da due ambiti; l'ambito del workspace ha la precedenza su quello dell'utente.
- Ambito utente:
~/.kiro/settings/mcp.jsonsi applica a ogni workspace. - Ambito workspace:
$PWD/.kiro/settings/mcp.jsonsi applica solo al workspace corrente e sostituisce la voce con la stessa chiave dell'ambito utente.
Installazione con un clic dalla directory dei server di Kiro
Apri kiro.dev/docs/mcp/servers/, trova la riga Databricks e fai clic su Add to Kiro. Il browser avvia Kiro e apre una finestra di conferma con una configurazione precompilata. Conferma per scrivere la voce databricks-sql in ~/.kiro/settings/mcp.json. La voce arriva disattivata, con un URL segnaposto e un riferimento alla variabile DATABRICKS_ACCESS_TOKEN. Poi imposta l'URL su ${DATABRICKS_SQL_MCP_URL}, imposta "disabled" su false e crea entrambe le variabili.
Verificare (o aggiungere) la voce databricks-sql
Impostare le variabili d'ambiente
Nel profilo della shell che avvia Kiro (di solito ~/.zshrc su macOS):
Ricarica il profilo (source ~/.zshrc) prima di avviare Kiro. Chiudi completamente Kiro (Cmd+Q su macOS) e riaprilo. Reload Window non rilegge le variabili d'ambiente; lo fa solo il riavvio del processo.
Kiro espande i riferimenti ${...} in mcp.json solo per le variabili d'ambiente che hai approvato. Quando Kiro mostra il suo avviso di sicurezza con l'elenco delle variabili DATABRICKS_*, approvale, oppure aggiungile tu stesso in Settings, Mcp Approved Env Vars.
Aggiungere Genie, Unity Catalog Functions e AI Search
Tutti e quattro i server gestiti da Databricks si collegano come MCP HTTP remoti. L'handshake initialize riesce anche con un URL segnaposto; il server convalida la risorsa solo quando viene richiamato uno strumento. Uno stato connesso ma non funzionante, in cui tools/call restituisce RESOURCE_DOES_NOT_EXIST o PERMISSION_DENIED, è il problema più comune. Esegui prima questi controlli preliminari:
- Genie: verifica che esista un agente Genie e che tu possa aprirlo. Copia il suo ID spazio dalla scheda Settings dell'agente (l'interfaccia lo chiama Agent ID); è il
<genie_space_id>nella tabella degli URL qui sotto. - Unity Catalog Functions: verifica che la funzione esista e che tu abbia
EXECUTE. Elenca le funzioni conSELECT * FROM system.information_schema.routines WHERE routine_type = 'FUNCTION'. - AI Search: verifica che esista un endpoint con almeno un indice accessibile.
- Ambito del PAT: un PAT con ambito workspace può comunque generare
PERMISSION_DENIEDse l'utente non ha accesso alla risorsa specifica: Can View sull'agente Genie, oppureSELECTsull'indice di AI Search (piùUSE CATALOGeUSE SCHEMA). Gli agenti Genie vengono condivisi singolarmente.
Aggiungi le variabili d'ambiente aggiuntive (DATABRICKS_GENIE_MCP_URL, DATABRICKS_UC_FUNCTIONS_MCP_URL, DATABRICKS_AI_SEARCH_MCP_URL) e aggiorna mcp.json con la configurazione completa:
Formati degli URL per server:
Server | Modello di URL |
|---|---|
databricks-genie | https://<workspace-hostname>/api/2.0/mcp/genie/<genie_space_id> |
databricks-sql | https://<workspace-hostname>/api/2.0/mcp/sql |
databricks-uc-functions | https://<workspace-hostname>/api/2.0/mcp/functions/<catalog>/<schema>/<function_name> |
databricks-ai-search | https://<workspace-hostname>/api/2.0/mcp/ai-search/<catalog>/<schema>/<index_name> |
Chiudi e riavvia Kiro. Apri la sezione MCP SERVERS del pannello di Kiro; le quattro voci databricks-* compaiono con indicatori di stato verdi. Fai clic su reconnect per qualsiasi voce rossa e ripeti i controlli preliminari. Prova una prima query a basso rischio nel pannello della chat: «List the catalogs I have access to.»
Percorso B: installare il Databricks Power
I quattro server gestiti coprono SQL, ricerca semantica e analisi in linguaggio naturale, il che basta a molti sviluppatori. Se il tuo workflow comprende pipeline, job, Model Serving, Lakebase, Declarative Automation Bundles, Agent Bricks, dashboard AI/BI, MLflow o Databricks Apps, la configurazione con quattro server ti costringe a fare copia e incolla verso l'interfaccia del workspace tutto il giorno.
Il Databricks Power risolve il problema. Una sola installazione configura le skill ufficiali di Databricks per agenti, che si caricano su richiesta in base all'attività in corso.
Cosa ottieni
Area | Copertura |
|---|---|
SQL & Compute | Eseguire SQL sui warehouse; eseguire Python o Scala sui cluster; gestire il ciclo di vita del compute |
Pipelines & Jobs | Spark Declarative Pipelines (tabelle di streaming, CDC, SCD Type 2, Auto Loader); DAG di job multi-attività |
Unity Catalog | Tabelle, volumi, permessi, tag, credenziali di storage, tabelle di sistema, metric view, External Iceberg Reads |
Dashboard AI/BI | Visualizzazioni, KPI, dashboard analitiche |
Agenti Genie | Esplorazione dei dati in linguaggio naturale su set di dati governati |
Agent Bricks | Knowledge Assistants (RAG) e Multi-Agent Supervisors |
AI Search | Ricerca semantica e RAG con indici gestiti |
Model Serving | Modelli di ML, agenti AI e Foundation Model APIs (FMAPI) con pagamento per token, instradabili tramite Unity Gateway |
MLflow | Esperimenti, valutazioni, strumentazione delle tracce, query sulle metriche |
Lakebase | PostgreSQL gestito, con provisioning dedicato o scalabilità automatica, per carichi di lavoro OLTP |
Databricks Apps | App web full-stack sul Lakehouse |
Declarative Automation Bundles (in precedenza Databricks Asset Bundles) | Infrastructure as code per le risorse Databricks |
Installare il Power
In Kiro (IDE 1.0.288 o successivo), apri il pannello Powers, cerca databricks e installa il Databricks Power. La sua skill di configurazione ti guida poi in quattro passaggi:
- Verificare che la Databricks CLI sia la v1.20.0 o successiva, la prima versione con supporto per Kiro in
databricks aitools, e installarla o aggiornarla se necessario. - Accedere alla CLI con
databricks auth loginoppure riutilizzare un profilo esistente. - Installare le skill con
databricks aitools install --agents kiro --scope global, che le colloca in~/.kiro/skills/. Usa--scope projectper installarle in un solo workspace. - Aggiungere otto skill di MLflow da mlflow/skills (tracciamento, valutazione, analisi delle tracce, metriche), che la CLI non include.
A parte la sua skill di configurazione, il Power non contiene altri contenuti e non include alcun server MCP. La CLI scarica le skill da databricks/databricks-agent-skills, e le aggiorni tu stesso con databricks aitools update.
Autenticazione
Le skill eseguono comandi della Databricks CLI, quindi usano un profilo della Databricks CLI. Per l'uso interattivo, accedi con OAuth user-to-machine: databricks auth login --host https://<your-workspace-url> --profile <profile-name> apre un browser e il token si rinnova automaticamente. L'OAuth con service principal è adatto all'automazione, e i Personal Access Token restano un'opzione; consulta Databricks CLI authentication. La skill di configurazione elenca i tuoi profili esistenti senza mostrare alcun segreto e non ne riutilizza mai uno senza chiedertelo.
Verificare l'installazione
Kiro carica le skill all'avvio di una sessione di chat, quindi apri una nuova sessione e chiedi: «Using the databricks-core skill, which workspace am I connected to?» Una risposta corretta conferma la CLI, il tuo profilo e le skill. databricks aitools list mostra la versione installata di ogni skill.
Aggiornare dall'AI Dev Kit Power
Se hai installato il precedente Databricks AI Dev Kit Power, aggiorna il Power in Kiro, poi esegui i passaggi per le skill e MLflow indicati sopra. Alcuni elementi si trovano fuori dal Power e vanno puliti a mano: una voce databricks di primo livello in mcp.json che esegue databricks-mcp-server/run_server.py, e qualsiasi esportazione di credenziali DATABRICKS_* che la vecchia configurazione ha aggiunto al profilo della shell. Facoltativamente, rimuovi il clone di ai-dev-kit (~/.ai-dev-kit, o la directory indicata in AIDEVKIT_HOME), ma solo se non usi ai-dev-kit per altri agenti o progetti. Elimina la directory invece di eseguire install.sh --uninstall di ai-dev-kit, che rimuove le cartelle delle skill per nome da ~/.kiro/skills/, comprese quelle installate dalla Databricks CLI. La sezione «Migrating from the AI Dev Kit Power» della skill databricks-kiro-setup del Power copre tutti e tre i punti.
Come scegliere tra i due percorsi
Un semplice albero decisionale:
- Esegui solo SQL, fai domande in linguaggio naturale su set di dati governati tramite Genie e cerchi negli indici di AI Search? Usa il percorso A. I quattro server gestiti fanno esattamente questo, e la configurazione richiede 10 minuti.
- Crei pipeline, gestisci job, distribuisci Declarative Automation Bundles, lavori con Lakebase, sviluppi Databricks Apps o richiami Agent Bricks? Usa il percorso B. Il toolkit completo è troppo ampio per essere aggiunto come singoli server MCP remoti.
- Un po' di entrambi? Usali tutti e due. I percorsi A e B non sono in conflitto: il percorso B aggiunge skill, non server MCP, quindi i quattro server del percorso A (
databricks-genie,databricks-sql,databricks-uc-functions,databricks-ai-search) convivono con esso nel pannello MCP di Kiro. La skill di configurazione del Power può anche guidarti nell'aggiunta al tuomcp.jsondi un MCP fornito da Databricks, come Genie One, tramite Unity Gateway.
Per gli sviluppatori che prevedono di lavorare ogni giorno in Kiro su carichi di lavoro Databricks, il percorso B è la scelta migliore a lungo termine. Il percorso A è quello giusto se hai 10 minuti e un SQL warehouse con cui vuoi conversare.
Dal punto di vista di chi sviluppa
I due percorsi hanno un impatto diverso a seconda di chi usa l'IDE. Quattro profili, quattro problemi, quattro risposte.
L'analytics engineer. Passi metà della giornata a interrogare tabelle che non hai mai visto e l'altra metà a fare copia e incolla tra l'editor e l'interfaccia del workspace. Il percorso A risolve tutto in 10 minuti. I server Genie e SQL basano ogni query su metadati di schema reali; l'assistente scrive con le tue colonne reali, senza tirare a indovinare; e ogni risultato eredita i tuoi permessi di Unity Catalog. Basta passare da una scheda all'altra.
Il data engineer. La tua giornata è fatta di pipeline, job, Declarative Automation Bundles e delle promozioni tra ambienti che li accompagnano. Scrivere databricks.yml a mano ed eseguire databricks bundle deploy da un terminale laterale è la strada lenta. Il percorso B è quella veloce. Le skill del Power per pipeline, job e Declarative Automation Bundles generano, convalidano e distribuiscono l'IaC in un'unica conversazione. Spark Declarative Pipelines, CDC, SCD Type 2, Auto Loader: tutto generato a partire dalle tue tabelle reali di Unity Catalog e pronto per il commit.
Lo sviluppatore di AI e agenti. Colleghi chiamate ai modelli, valutazione, governance e orchestrazione degli agenti attraverso tre o quattro strumenti che non concordano del tutto sullo schema. Il percorso B copre l'intera offerta di AI di Databricks: Unity Gateway per il routing e i fallback, Agent Bricks per i supervisori multi-agente e gli assistenti di conoscenza, MLflow per la valutazione e AI Search per il retrieval, il tutto governato end-to-end da Unity Catalog. Il tuo agente eredita gli stessi permessi di chi lo richiama, e le tue tracce di valutazione arrivano nello stesso workspace delle tue esecuzioni di training.
Lo sviluppatore di piattaforme. Gestisci le risorse Databricks come codice, fai promozioni tra dev/stage/prod e ogni settimana rispondi alla domanda «ci sono derive?». La skill Declarative Automation Bundles del percorso B (databricks-dabs), insieme alle skill per la gestione di Unity Catalog, genera il bundle completo, lo convalida e mostra il piano di distribuzione (databricks bundle plan) prima di qualsiasi modifica. Non devi più mantenere un set di YAML a mano e un altro in un documento.
Un workflow che puoi eseguire oggi
Qualunque percorso tu abbia scelto, questo esercizio basa l'assistente su metadati reali del workspace usando il set di dati samples.tpch del catalogo samples integrato.
Chiedi: «What columns and types does samples.tpch.lineitem have, and what is the data distribution by l_shipdate year?»
Kiro restituisce lo schema reale e un istogramma da un'unica query. Nomi di colonne reali e una distribuzione reale, basati sul tuo workspace.
Chiedi: «Draft a dbt model that joins lineitem to orders and aggregates revenue by nation per quarter.»
Kiro genera SQL con i nomi di colonna reali (l_extendedprice, l_discount, o_orderdate) invece di supposizioni. Poiché ha interrogato prima lo schema, conosce i tipi esatti e la granularità.
Chiedi: «Run my new aggregation against samples.tpch and compare the row count to last week's snapshot in poc.gold.revenue_by_nation_qtr.»
Kiro esegue entrambe le query e mette in evidenza le differenze. Se un numero sembra strano, «Show me the lineage for gold.revenue_by_nation_qtr» recupera le tabelle a monte da system.access.table_lineage. Una volta verificato, Kiro genera il JSON del job Databricks per il modello ed elenca i cataloghi e gli schemi coinvolti.
Nel percorso B, lo stesso workflow si estende a «Generate a Declarative Automation Bundle for this job and deploy it to staging», «Create an AI/BI dashboard backed by this aggregation» o «Wire this into a Unity Gateway endpoint with a fallback model», il tutto senza uscire dall'IDE.
Best practice, qualunque sia il percorso
- Autenticazione con privilegio minimo. Genera un PAT distinto per ogni postazione e per ogni set di ambiti. Nel percorso B, per l'uso interattivo preferisci OAuth U2M ai PAT.
- Non fare mai il commit delle credenziali. Conserva
DATABRICKS_ACCESS_TOKENnel profilo della shell o in un gestore di segreti. Non inserirlo mai in unmcp.jsonsotto controllo di versione. - Ambito per progetto. Conserva gli ID degli agenti Genie e i percorsi degli indici di AI Search in
$PWD/.kiro/settings/mcp.json, così ogni progetto porta con sé i propri collegamenti alle risorse. - Affidati ai permessi di Unity Catalog. In entrambi i percorsi l'AI lavora con i tuoi permessi effettivi: permessi sulle tabelle, filtri di riga e maschere di colonna per il SQL e gli agenti Genie, e condivisione per singola risorsa per gli indici di AI Search. Non c'è un livello separato di controllo degli accessi da gestire.
- Riavvia, non ricaricare. Kiro legge le variabili d'ambiente una sola volta, all'avvio del processo. Dopo aver modificato il profilo della shell o aggiunto l'autenticazione, chiudi completamente Kiro (Cmd+Q su macOS) e riaprilo.
Risoluzione dei problemi
«Server not found» o stato rosso su una voce MCP.
Percorso A: controlla echo $DATABRICKS_SQL_MCP_URL nella shell che ha avviato Kiro. Un valore vuoto significa che Kiro non riesce a risolvere l'URL. Verifica che il mcp.json dell'ambito workspace non stia oscurando la configurazione dell'ambito utente. Verifica che il PAT sia ancora valido in Settings, Developer, Access tokens.
Connesso a MCP, ma le chiamate agli strumenti restituiscono RESOURCE_DOES_NOT_EXIST o PERMISSION_DENIED.
È il problema più comune del percorso A. L'handshake initialize riesce con un URL segnaposto perché il server rimanda la convalida della risorsa fino all'invocazione. Ripeti i controlli preliminari per il server specifico (l'agente Genie esiste ed è condiviso con te, la funzione esiste e hai EXECUTE, l'indice di AI Search esiste e hai SELECT su di esso).
Kiro non usa le skill di Databricks (percorso B).
Apri una nuova sessione di chat, perché le skill si caricano all'avvio di una sessione, e verifica che databricks-core/SKILL.md esista in ~/.kiro/skills/. Error: unknown agent "kiro" significa che la Databricks CLI è precedente alla v1.20.0; aggiornala ed esegui di nuovo l'installazione. Se il comando della CLI di una skill non riesce ad autenticarsi, esegui databricks auth profiles e accedi di nuovo con databricks auth login.
Provalo oggi. Il Databricks Power è il modo più rapido per avere l'intera piattaforma (pipeline, job, Lakebase, Agent Bricks e tutto ciò che è descritto sopra) in Kiro. Installalo dal catalogo Kiro Powers su kirodotdev/powers, oppure installa le stesse skill senza il Power eseguendo databricks aitools install --agents kiro con la Databricks CLI v1.20.0 o successiva. Per altri agenti di programmazione, databricks aitools install rileva quelli presenti sulla tua macchina (Claude Code, Cursor, Codex, GitHub Copilot, Gemini CLI e altri); esegui databricks aitools --help per l'elenco aggiornato, oppure consulta databricks/databricks-agent-skills. Per i quattro server MCP gestiti da Databricks, l'installazione con un clic si trova su kiro.dev/docs/mcp/servers/.
Hai un feedback o un problema? Apri una issue: per la configurazione o il packaging del Power, kirodotdev/powers; per le skill per agenti, databricks/databricks-agent-skills; per la Databricks CLI e databricks aitools, databricks/cli. Le leggiamo tutte.
Partner, Lakebase, Genie, Unity Gateway, Agent Bricks, Unity Catalog, MCP, Developer Tools, AI Search, MLOps & LLMOps e Business Intelligence
Ricevi gli ultimi articoli nella tua casella di posta
Iscriviti al nostro blog e ricevi gli ultimi articoli direttamente nella tua casella di posta.