Che cos'è Spark API?
Tre interfacce (RDD, DataFrame e Dataset) che consentono agli sviluppatori di elaborare dati distribuiti su più linguaggi con prestazioni ottimizzate
Archived. This article has not been updated since the publish date above. The dynamic nature of information means that previously accurate content can become outdated or even obsolete over time. Readers are advised to exercise due diligence and cross-check any information found in this blog post before making decisions or adopting any practices based on said information.
- Gli RDD forniscono un controllo di basso livello per l'elaborazione di dati non strutturati con trasformazioni funzionali, mentre i DataFrame organizzano i dati in colonne denominate per operazioni di tipo SQL.
- I dataset combinano la sicurezza dei tipi degli RDD con le ottimizzazioni dei DataFrame, offrendo il controllo degli errori in fase di compilazione e sfruttando l'ottimizzatore Catalyst per un'esecuzione migliorata.
- Spark 2.0+ unifica DataFrame e dataset in un'unica API di alto livello che semplifica lo sviluppo offrendo al contempo prestazioni superiori su Python, Scala, Java e R.
Lavorando con Spark, avrai a disposizione tre API: DataFrame, set di dati e RDD
Cosa sono i set di dati distribuiti resilienti (RDD)?
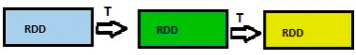
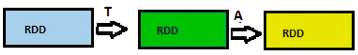
Un RDD, o set di dati distribuiti resiliente, è una raccolta di record con elaborazione distribuita, tollerante agli errori e di natura immutabile. Gli RDD possono essere utilizzati in parallelo ad API di basso livello, mentre la loro funzione "lazy" velocizza l'esecuzione dell'operazione Spark. Gli RDD supportano due tipi di operazioni:
- Trasformazioni - operazioni ritardate ("lazy") che restituiscono un altro RDD, il quale non avvia la computazione a meno che su di esso non venga eseguita un'azione. Alcuni esempi di trasformazioni sono map(), flatmap(), filter()
- Azioni - operazioni che attivano calcoli e restituiscono valori. Alcuni esempi di azioni sono: count, top(), savetofile()
Svantaggi degli RDD
Se scegli di lavorare con gli RDD, dovrai ottimizzarli uno per uno. Inoltre, a differenza dei set di dati e dei DataFrame, gli RDD non desumono lo schema dei dati acquisiti, che andrà quindi specificato.
Cosa sono i DataFrames?
Un DataFrame è una raccolta distribuita di righe in colonne denominate. Per semplificare, può essere paragonato a un foglio di lavoro Excel con intestazioni di colonna, o considerato l'equivalente di una tabella in un database relazionale o di un DataFrame in R o Python. Condivide tre caratteristiche principali con gli RDD:
- Immutabilità - è possibile creare un DataFrame, ma non è possibile modificarlo. È possibile trasformarlo, come avviene con un RDD.
- Lazy Evaluations - un task non viene eseguito finché non viene compiuta un'azione.
- Distribuzione - come gli RDD, i DataFrame sono distribuiti.
Come creare un DataFrame
In Spark i DataFrame possono essere creati in diversi modi:
- Utilizzando diversi formati di dati, ad esempio caricando i dati da file JSON, CSV, RDBMS, XML o Parquet.
- Caricando i dati da un RDD già esistente.
- Specificando programmaticamente lo schema.
Il playbook sull'AI agentiva per l'enterprise

Svantaggi dei DataFrame
Lo svantaggio principale dell'API DataFrame è che non supporta in modo sicuro la compilazione; di conseguenza, l'utente è limitato nel caso in cui la struttura dei dati non sia nota.
Cosa sono i set di dati?
Un set di dati è un insieme di oggetti immutabili e fortemente tipizzati mappati su uno schema relazionale. Un set di dati può essere creato utilizzando oggetti JVM e manipolato tramite trasformazioni funzionali complesse. I set di dati possono essere creati in due modi:
- Dinamicamente.
- Leggendo da un file JSON con SparkSession.
Svantaggi dei set di dati
Lo svantaggio principale dei set di dati è che richiedono la tipizzazione in stringhe.
Risorse aggiuntive
Ricevi gli ultimi articoli nella tua casella di posta
Iscriviti al nostro blog e ricevi gli ultimi articoli direttamente nella tua casella di posta.