I tuoi dati, il tuo storage, le tue regole: una guida del 2026 all'archiviazione delle tabelle gestite di Unity Catalog
I dati delle tue tabelle gestite risiedono nel cloud storage di tua proprietà, in una posizione sotto il tuo controllo
- Le tabelle gestite di Unity Catalog memorizzano i tuoi dati nel cloud storage di tua proprietà, in un percorso impostato dalla posizione di archiviazione gestita sul tuo metastore, catalogo o schema.
- Con il cambiamento delle organizzazioni, i team possono ritrovarsi con dati bloccati in una posizione ereditata che non hanno mai scelto. SET MANAGED LOCATION modifica il punto in cui vengono collocate le nuove tabelle, e la conversione delle tabelle esterne sposta i loro dati nella posizione impostata.
- Mantieni il controllo su dove risiedono i dati delle tue tabelle gestite, che si tratti di un'unica posizione o di un'archiviazione separata per motivi di conformità e attribuzione dei costi.
Le tabelle gestite di Unity Catalog ti consentono di controllare la collocazione dei tuoi dati quando la tua organizzazione ha bisogno di uno spazio di archiviazione separato. A differenza di altre piattaforme di dati, i dati delle tabelle Databricks rimangono in un account di cloud storage di tua proprietà, come il tuo bucket S3, il tuo container ADLS o il tuo bucket GCS.
Le tabelle gestite di Unity Catalog automatizzano la gestione delle tabelle. Sia che tu memorizzi le tue tabelle gestite di Unity Catalog nei formati Iceberg o Delta, Databricks gestisce il layout dei dati, l'ottimizzazione e la pulizia per te dove preferisci, applicando ottimizzazioni automaticamente man mano che le tabelle cambiano.
Questo blog spiega come funziona il modello di archiviazione delle tabelle gestite e come puoi scegliere o modificare una posizione di archiviazione gestita di Databricks.
Le tue tabelle rimangono nello spazio di archiviazione di tua proprietà
Quando utilizzi il tuo cloud storage, i dati delle tabelle gestite vengono memorizzati in un account cloud di tua proprietà. Mantieni la proprietà di tale spazio di archiviazione e la visibilità su come sono organizzati i tuoi dati. Hai la possibilità di ispezionare, controllare e applicare le tue policy sui bucket, oltre a controllare la posizione dei tuoi dati.
A differenza di altre piattaforme con offerte di tabelle gestite o native che conservano le tabelle in uno spazio di archiviazione controllato dal provider o in formati di dati proprietari, con Databricks i tuoi dati rimangono nel tuo account.
Aperto per progettazione
Mantenere i dati nel proprio account cloud è solo una parte di ciò che rende aperte le tabelle gestite su Databricks. Unity Catalog è l'unico catalogo principale del settore che ti consente di essere il proprietario dei tuoi dati con un accesso governato completo in lettura e scrittura su Iceberg e Delta, con la possibilità di federare tabelle di proprietà altrui in formati aperti, utilizzando standard aperti.
Strumenti esterni come Apache Spark™, Flink, Trino, Kafka Connect e Snowflake possono leggere e scrivere su tabelle gestite tramite Iceberg REST Catalog e le API aperte di Unity Catalog. L'accesso sicuro è reso possibile tramite API aperte e il credential vending, consentendo agli strumenti esterni di interagire con i dati governati senza duplicarli. Questo semplifica l'architettura e consente di avere un'unica fonte di verità per i carichi di lavoro di analisi e AI.
Quando utilizzi il tuo spazio di archiviazione, i file rimangono accessibili nel tuo account cloud mentre Unity Catalog ne governa l'accesso.
Controlli tu dove risiedono i tuoi dati
Con las tabelle gestite in Databricks, puoi decidere dove vengono memorizzati i dati delle tabelle gestite. Imposta una posizione di archiviazione gestita una sola volta a livello di metastore, catalogo o schema, e ogni tabella sottostante la erediterà. Il livello più specifico prevale: la posizione di uno schema ha la precedenza su quella del suo catalogo, e quella di un catalogo ha la precedenza su quella del metastore. Puoi impostare un valore predefinito generale e sovrascriverlo ovunque un team o un dominio necessiti del proprio spazio di archiviazione.
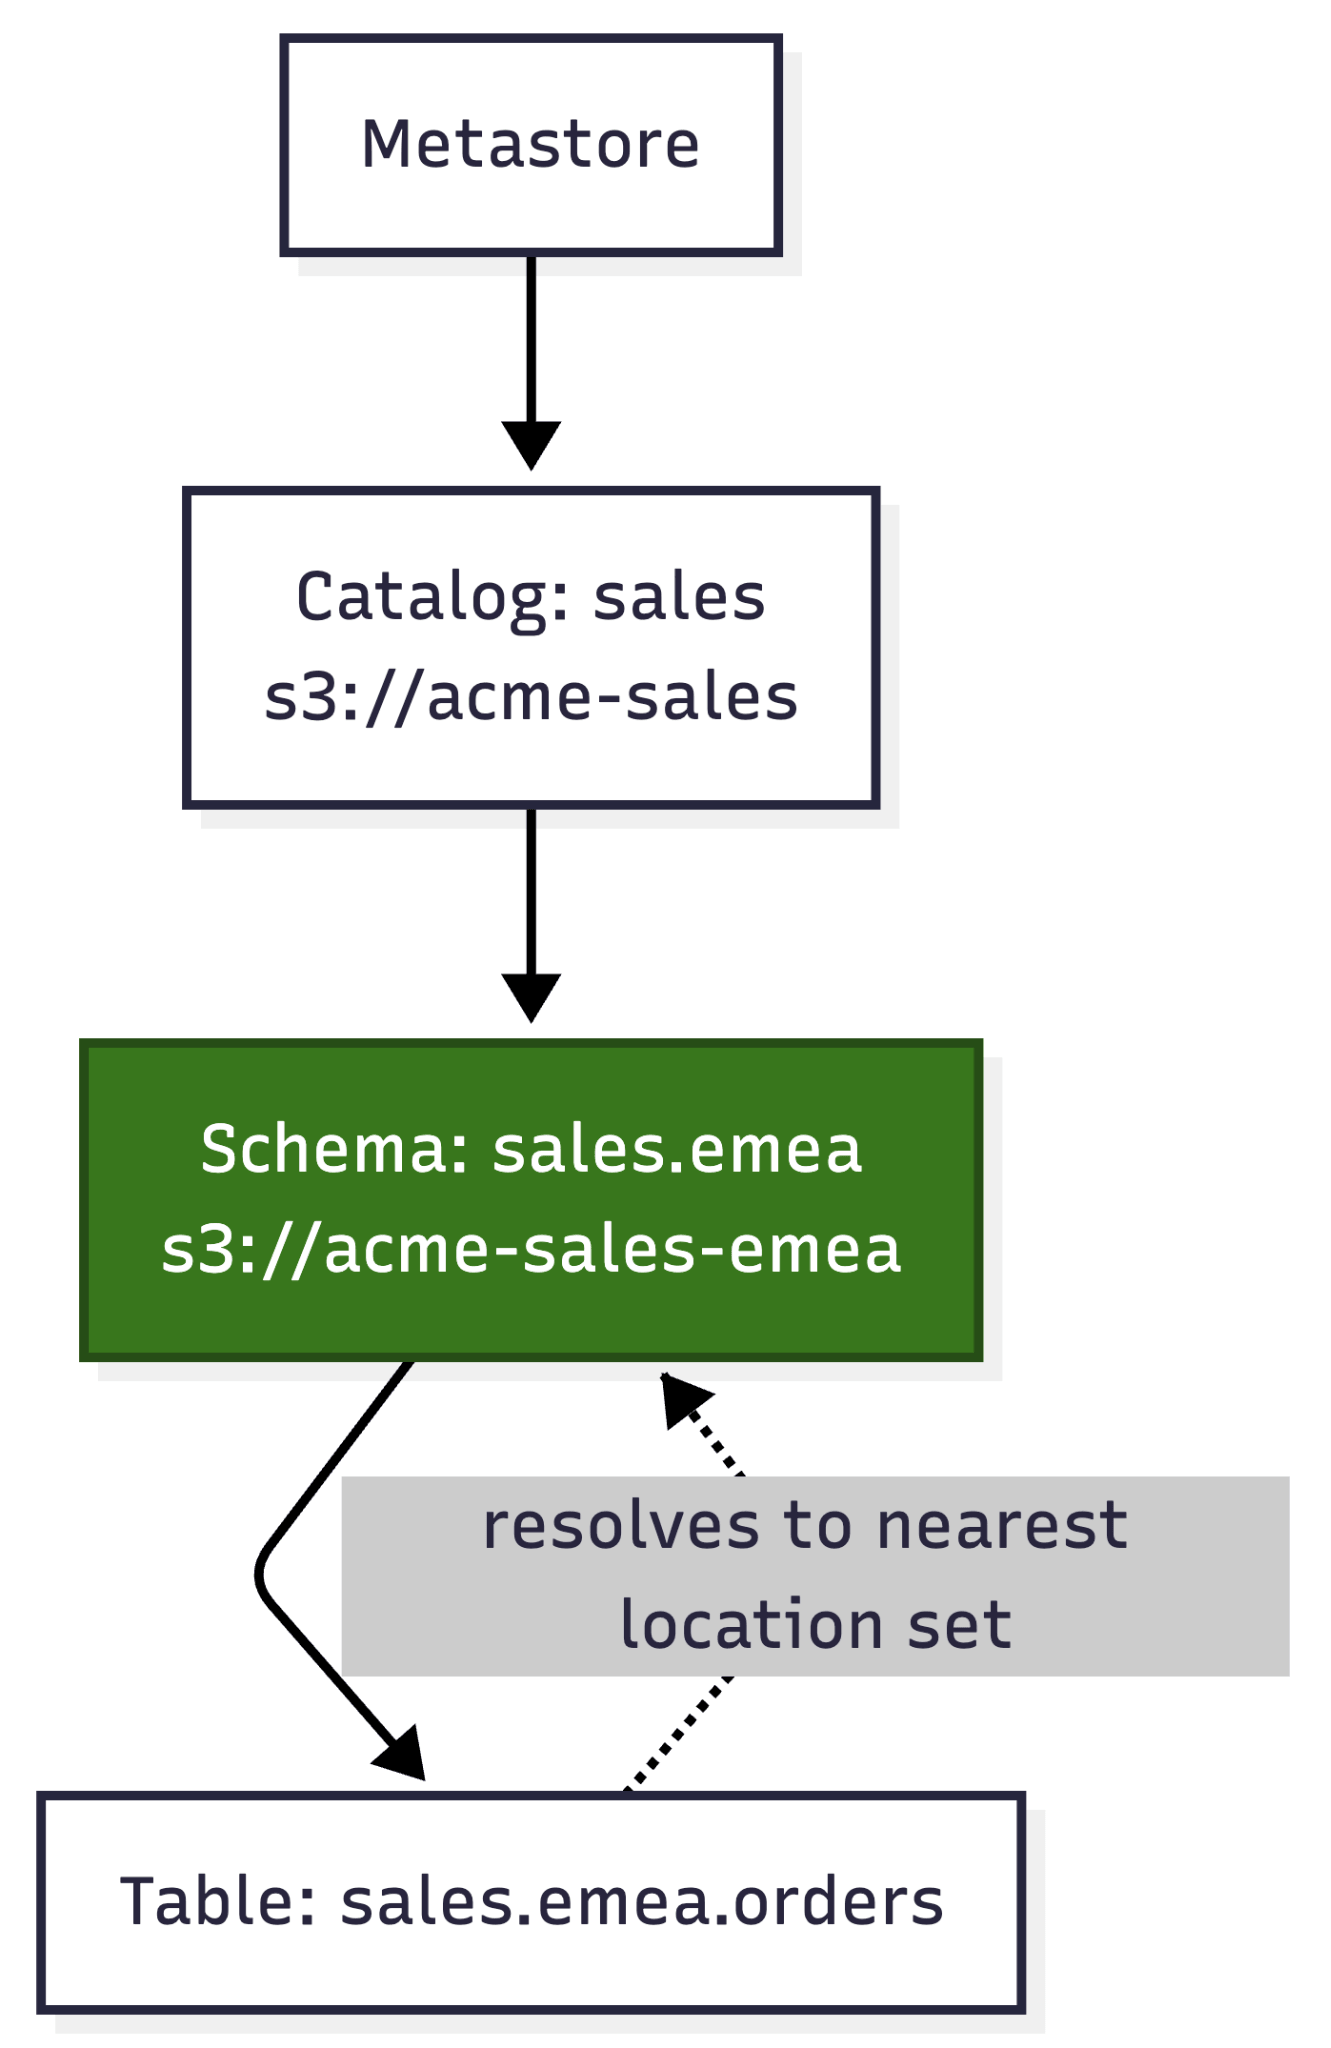
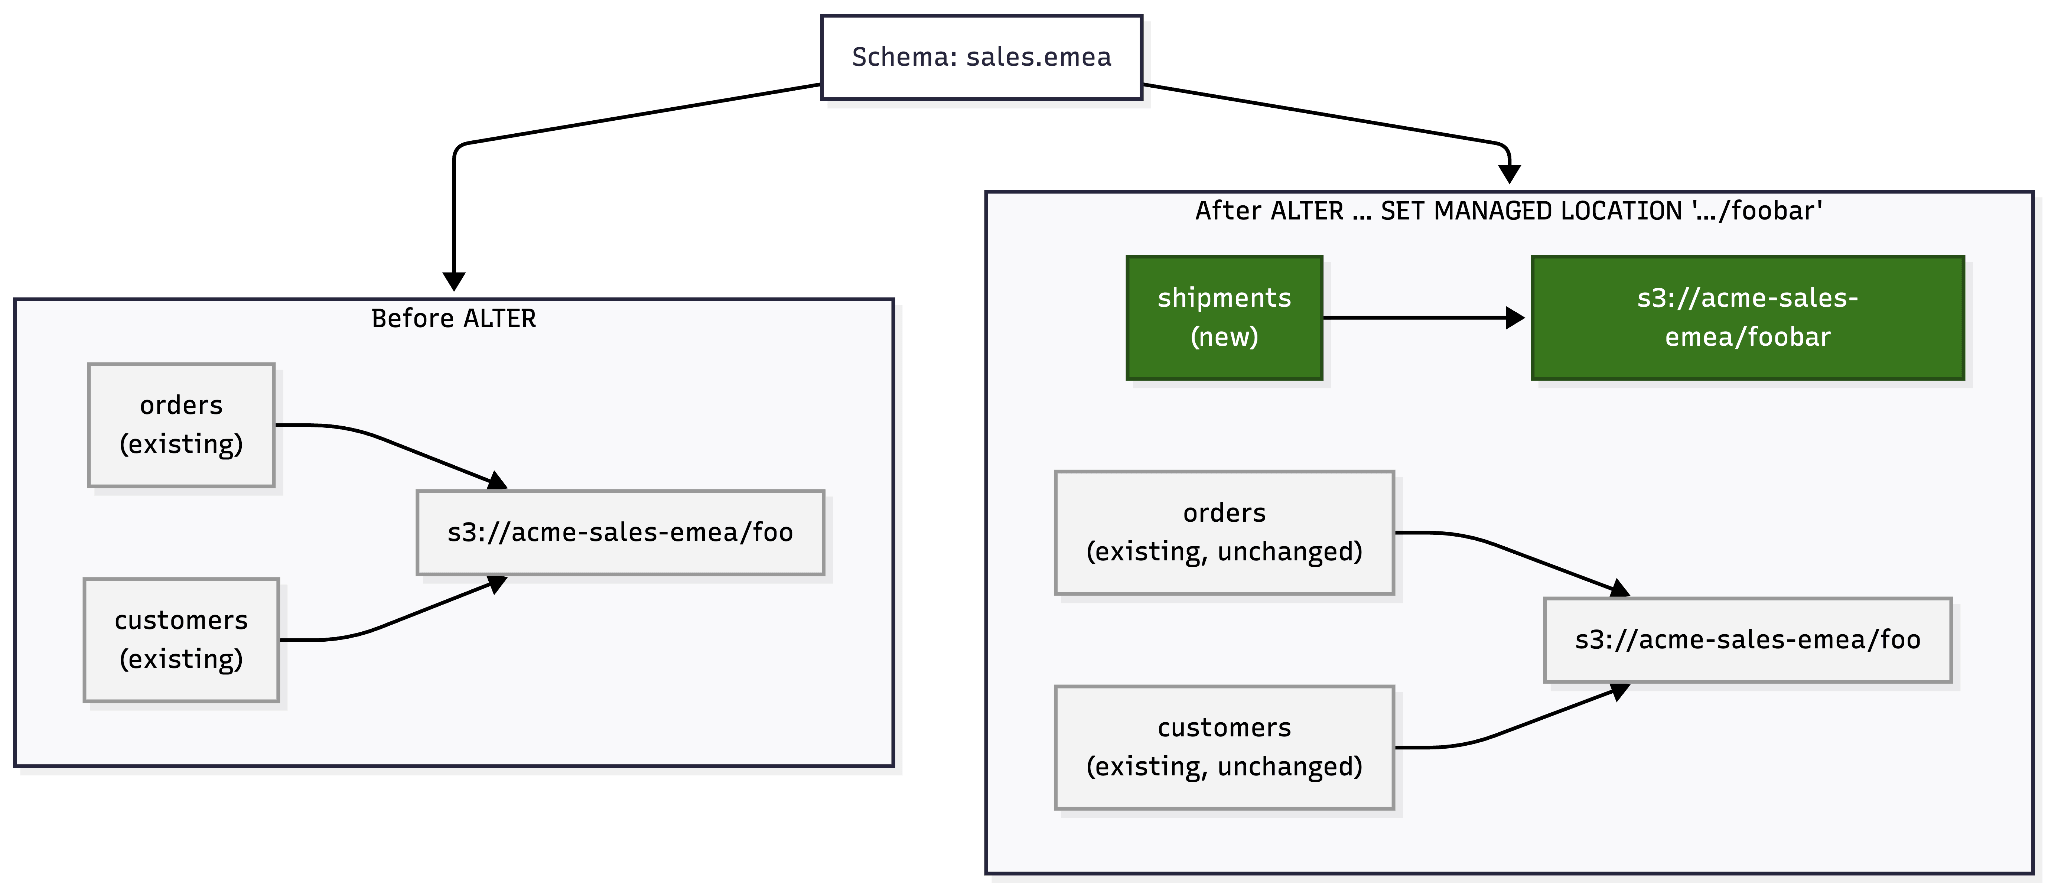
Questo controllo non è fisso al momento della configurazione. Man mano che la tua organizzazione cambia, ALTER CATALOG o ALTER SCHEMA ... SET MANAGED LOCATION indirizza nuove tabelle e volumi verso una nuova posizione, mentre tutto ciò che è già stato scritto rimane dove si trova.
Maggiore controllo quando hai bisogno di uno spazio di archiviazione separato
La maggior parte dei team organizza i propri dati in modo logico, tramite cataloghi e schemi, e non deve mai pensare a dove risiedono fisicamente i file sottostanti: la posizione di archiviazione gestita ereditata dai loro cataloghi e schemi è tutto ciò di cui hanno bisogno. Insieme ai controlli di accesso basati su ruoli e attributi in Unity Catalog, questo approccio soddisfa i requisiti standard di segregazione dei dati del GDPR.
Alcune organizzazioni, tuttavia, necessitano di confini che si estendono fino allo spazio di archiviazione fisico stesso. Una linea di business potrebbe aver bisogno di uno spazio di archiviazione separato per l'amministrazione o l'allocazione dei costi del cloud. Oppure le normative regionali e di conformità potrebbero dettare dove risiedono fisicamente determinati dati. In questi casi, puoi assegnare a un catalogo o schema specifico la propria posizione di archiviazione gestita, in modo che la collocazione fisica dei dati coincida con il confine che la richiede.
Scegli dove memorizzare i dati quando li converti in gestiti
Quando converti una tabella esterna in gestita, i dati vengono memorizzati nella posizione di archiviazione gestita a cui fa attualmente riferimento il suo catalogo o schema. Se quella tabella esterna si trova già in una posizione ad hoc o non standard, potresti volere la tabella gestita altrove, nello spazio di archiviazione che utilizzi oggi per quel dominio.
Durante la conversione, Databricks copia i dati della tabella e il registro delle transazioni nella posizione di archiviazione gestita impostata, in modo che la tabella gestita venga memorizzata dove hai scelto.
Riepilogo
Le tabelle gestite automatizzano la manutenzione delle tabelle, mentre i tuoi dati possono rimanere nello spazio di archiviazione di tua proprietà. Questo differisce da altre piattaforme gestite che conservano i dati delle tabelle in uno spazio di archiviazione controllato dal provider. Puoi controllare la collocazione a livello di metastore, catalogo o schema, modificare la posizione in cui vengono memorizzate le nuove tabelle e scegliere una posizione quando converti una tabella esterna in gestita. I tuoi dati rimangono in formati aperti, accessibili tramite Iceberg REST Catalog e le API aperte di Unity Catalog.
Quando sei pronto per impostare o modificare una posizione di archiviazione gestita, la documentazione sullo spazio di archiviazione gestito illustra i dettagli specifici.
Funzionalità | Databricks Unity Catalog | Altre piattaforme |
Dati memorizzati in uno spazio di archiviazione di proprietà del cliente | ✅ Sì | Spesso proprietario |
Formati di tabella aperti (Iceberg e Delta) | ✅ Sì | Varia in base al formato |
Accesso in lettura/scrittura da strumenti esterni con governance a livello di riga e colonna | ✅ Tramite Iceberg REST Catalog o le API aperte di Unity Catalog | Limitato |
Possibilità di controllare la posizione di archiviazione a livello di catalogo/schema | ✅ SET MANAGED LOCATION | Non comune |
Definizioni
Molti di questi termini riutilizzano le stesse parole, il che rende facile confonderli. Ecco cosa significa ciascuno in questo post.
- Tabella gestita: Una tabella i cui dati e il cui ciclo di vita sono gestiti per te da Unity Catalog. La crei senza una clausola
LOCATION. - Posizione di archiviazione gestita: Il percorso di cloud storage in cui vengono scritti i volumi e le tabelle gestite di un metastore, catalogo o schema. Lo imposti con la clausola
SET MANAGED LOCATION. - Posizione esterna: Un oggetto Unity Catalog che associa un percorso cloud a una credenziale di archiviazione per gestire l'accesso a tale percorso. Le posizioni esterne gestiscono sia le tabelle esterne sia l'archiviazione gestita: una posizione di archiviazione gestita a livello di catalogo o schema si trova all'interno di una di esse.
- Archiviazione di proprietà del cliente: Un'opzione di archiviazione in cui l'archiviazione cloud sottostante si trova nell'account cloud del cliente. Questa opzione costituisce la stragrande maggioranza delle tabelle in Databricks.
- Archiviazione predefinita: Un'opzione di archiviazione alternativa in cui Databricks predispone l'archiviazione cloud sottostante per te, invece di richiedere l'utilizzo del tuo bucket.
- ALTER CATALOG / ALTER SCHEMA … SET MANAGED LOCATION: Il comando che modifica la posizione in cui vengono scritti i nuovi volumi e le nuove tabelle gestite per un catalogo o uno schema. Le tabelle esistenti non subiscono modifiche.
- Conversione da esterna a gestita (ALTER TABLE … SET MANAGED): Il comando che converte una tabella esterna in una tabella gestita. Durante la conversione, i dati e il log delle transazioni vengono copiati nella posizione di archiviazione gestita corrente.
FAQ
1. Dove vengono memorizzati i dati delle tabelle gestite di Unity Catalog, in un'archiviazione di proprietà di Databricks o nel mio account cloud?
Nel tuo account. I dati delle tabelle gestite vengono scritti nell'archiviazione cloud del tuo account, che si tratti di S3, ADLS o GCS, in una posizione di archiviazione gestita impostata sul metastore, sul catalogo o sullo schema. Databricks gestisce il layout e il ciclo di vita della tabella, ma i file sottostanti risiedono in un bucket o in un container di tua proprietà registrato con Unity Catalog, non in un account controllato da Databricks.
2. Le tabelle gestite di Unity Catalog mi vincolano a Databricks?
No. Le tabelle gestite utilizzano formati di tabella aperti, tra cui Iceberg e Delta, che rimangono nell'archiviazione cloud di tua proprietà. I motori esterni possono scrivere e leggere da essi tramite l'Iceberg REST Catalog e le API aperte di Unity Catalog, in modo che i tuoi dati non rimangano intrappolati dietro un'interfaccia proprietaria. Mantieni la proprietà dell'archiviazione, i dati rimangono in formati aperti e l'accesso avviene tramite standard aperti. Le tabelle gestite non comportano un vincolo di dipendenza (lock-in): è assolutamente possibile passare a Databricks o lasciarlo usando le tabelle gestite così come avviene con le tabelle esterne; in entrambi i casi puoi conservare fisicamente i tuoi dati nello stesso posto.
3. Posso conservare determinati dati in un'archiviazione separata per motivi di conformità o residenza dei dati?
Sì. Se necessario, puoi assegnare a uno specifico catalogo o schema una propria posizione di archiviazione gestita, separata da tutto il resto, per conservare i dati di diversi paesi o regimi normativi in archiviazioni distinte, oppure per attribuire i costi di archiviazione a un team o a un'unità aziendale specifica.
4. I motori e gli strumenti diversi da Databricks possono scrivere e leggere dalle mie tabelle gestite?
Sì. Le tabelle gestite sono leggibili o modificabili tramite l'Iceberg REST Catalog e le API aperte di Unity Catalog, consentendo l'accesso a motori esterni come Apache Spark, Trino e Flink. Unity Catalog gestisce la governance per l'accesso all'archiviazione, prevenendo la corruzione dei dati che potrebbe essere causata dal loro aggiramento. L'accesso diretto basato sul percorso è disponibile anche tramite reindirizzamento basato sul percorso e Compatibility Mode.
5. Posso modificare la posizione di archiviazione dei dati delle mie tabelle gestite dopo averla impostata?
Sì. Utilizza ALTER CATALOG … SET MANAGED LOCATION o ALTER SCHEMA … SET MANAGED LOCATION per indirizzare le nuove tabelle verso una posizione diversa ogni volta che cambiano le esigenze di separazione fisica della tua organizzazione: una riorganizzazione, un nuovo bucket, una nuova area geografica. Le tabelle esistenti rimangono esattamente dove sono e le nuove tabelle vengono create nella nuova posizione. Ogni volta che si converte una tabella esterna in gestita, i relativi dati vengono copiati nella posizione impostata, consentendo di spostare i dati nella destinazione corretta come parte dello stesso passaggio.
(Questo post sul blog è stato tradotto utilizzando strumenti basati sull'intelligenza artificiale) Post originale
Ricevi gli ultimi articoli nella tua casella di posta
Iscriviti al nostro blog e ricevi gli ultimi articoli direttamente nella tua casella di posta.