고등 교육을 위한 AI 기반 자문 서비스
제한된 교육 자원을 확장하여 학생들을 최선으로 지원하고 학업 환경 안팎에서 성공을 보장하는 데 Databricks를 어떻게 활용할 수 있을까요?
작성자: Chad Ammirati, Zach Langford , Nicole Wong
- 교육 기관은 대화 녹취 및 분석과 같은 수동 및 자동 작업을 모두 포함하는 상담사 서비스(재정 지원, 입학, 등록)의 콜센터 품질 평가를 확장하는 데 어려움을 겪고 있습니다.
- Databricks는 단일 거버넌스 플랫폼에서 GenAI를 적용하여 대규모로 통화를 녹취하고, LLM-as-a-judge를 사용하여 기관 평가 기준에 따라 상담사 성과를 채점하며, Genie 및 Agent Bricks Knowledge Assistant를 통해 인사이트를 도출합니다.
- 이 블로그에서는 코드 노트북과 자연어 데이터 탐색 도구를 보여주는 Genie 스페이스를 포함한 예시를 통해 이 솔루션을 설명합니다.
문제점
콜센터는 고등 교육에서 중요한 학생 지원 도구입니다. 재정 지원, 입학 및 등록 담당 상담원은 종종 학생이 처음 접하는 연락처이지만, 대규모로 대화 품질을 모니터링하고 유지하는 것은 비용이 많이 들고 어렵습니다.
대부분의 기관은 자체 콜센터를 운영하며 Genesys나 Five9과 같은 고객 서비스 오케스트레이션 도구를 사용합니다. 진짜 문제는 전화 통화 자체가 아닙니다. 통화가 끝난 후에 일어나는 일입니다.
사례 1: 비용 증가 없이 상담원 품질 향상하기. 일반적인 QA 방식은 오케스트레이션 소프트웨어에서 텍스트 변환 결과를 추출하고 무작위 샘플을 수동으로 검토하는 것입니다. 통화량이 많기 때문에 QA 팀은 대개 연간 전체 통화의 약 5%만 평가합니다. 이 범위를 두 배로 늘리려면 팀 규모를 두 배로 늘려야 합니다. 10명 규모의 팀에서 인당 5만 달러의 비용이 든다면, 미미한 개선을 위해 연간 50만 달러의 추가 비용이 발생하는 셈입니다. 비용 문제 외에도, 기본 제공 텍스트 변환 기능은 학생 이름을 잘못 인식하는 경우가 많아 통화 기록을 학생 프로필에 연결해야 하는 다운스트림 대시보드가 제대로 작동하지 않게 만듭니다.
사례 2: 학생들이 겪고 있는 어려움 파악하기. 일부 기관은 체계적인 접근 방식이 전혀 없습니다. 다른 기관들은 텍스트 변환 결과를 청크로 나누고, 주제를 추출하고, 감성을 분석하기 위해 복잡한 NLP 파이프라인을 유지 관리합니다. 이러한 파이프라인은 대규모 환경에서 취약하며, 매주 배치 작업을 실행하는 사이에 구문 목록을 수동으로 관리해야 하고, 학기가 지나가기 전에 관리자가 새로운 문제에 대처할 수 있을 만큼 빠르게 인사이트를 생성하는 경우가 드뭅니다.
LLM 기반 텍스트 변환이 중요한 이유
깨끗하고 제한된 데이터 세트로 학습된 기존 ASR 모델은 억양, 방언, 압축된 전화 오디오, 소음이 심한 환경 등을 처리하는 데 어려움을 겪습니다. 이는 학생 지원 통화에서 흔히 발생하는 상황이며, 특히 외국인 학생 비율이 높은 기관에서 더욱 그렇습니다. 68만 시간 이상의 다양한 다국어 오디오로 학습된 OpenAI Whisper와 같은 파운데이션 모델은 이러한 환경에서 훨씬 더 우수한 일반화 성능을 보여줍니다. 기존 ASR이 완전히 쓸모없어진 것은 아니지만, 이 사용 사례에는 적합하지 않은 도구입니다.
Databricks에서의 AI 접근 방식
여러 고등 교육 기관이 Databricks와의 파트너십을 통해 이 두 가지 문제를 모두 해결하는 것을 확인했습니다. Baylor University가 대표적인 사례입니다. 여기에 소개된 워크플로는 Baylor University가 동일한 과제를 해결하기 위해 사용한 워크플로를 개선한 버전입니다. 핵심 패턴은 더 정밀한 텍스트 변환을 위해 Databricks Model Serving에 OpenAI Whisper를 배포하는 것으로 시작하여, 보강 및 점수 산정을 위해 AI Functions를 레이어로 추가하는 것입니다.
사례 1(상담원 품질)의 경우:
- WhisperAI를 호스팅하여 관리형 서빙 엔드포인트로 사용하고, 일별 또는 주별 배치 작업에서
ai_query()을 통해 대규모로 텍스트 변환을 적용합니다. - LLM-as-a-judge를 사용하여 기관의 QA 루브릭(평가 기준)에 따라 각 텍스트 변환 결과를 평가합니다. 모델은 모든 루브릭 기준을 평가하여 가중치가 적용된 1~5점의 종합 점수, 기준별 점수 및 서술형 평가를 반환합니다. 루브릭 기준은 참조 테이블에서 가져와 프롬프트에 코드화되므로 모든 통화에 동일한 기준이 일관되게 적용됩니다.
- 개선이 필요한 것으로 플래그가 지정된 통화를 QA 팀으로 라우팅하여 무작위 샘플링 대신 표적 검토를 수행합니다.
사례 2(학생 인사이트)의 경우:
- 동일한 Whisper 텍스트 변환 파이프라인을 분기마다 수시간 분량의 오디오에 적용합니다.
- 감성, 주제, 의도를 파악하기 위해
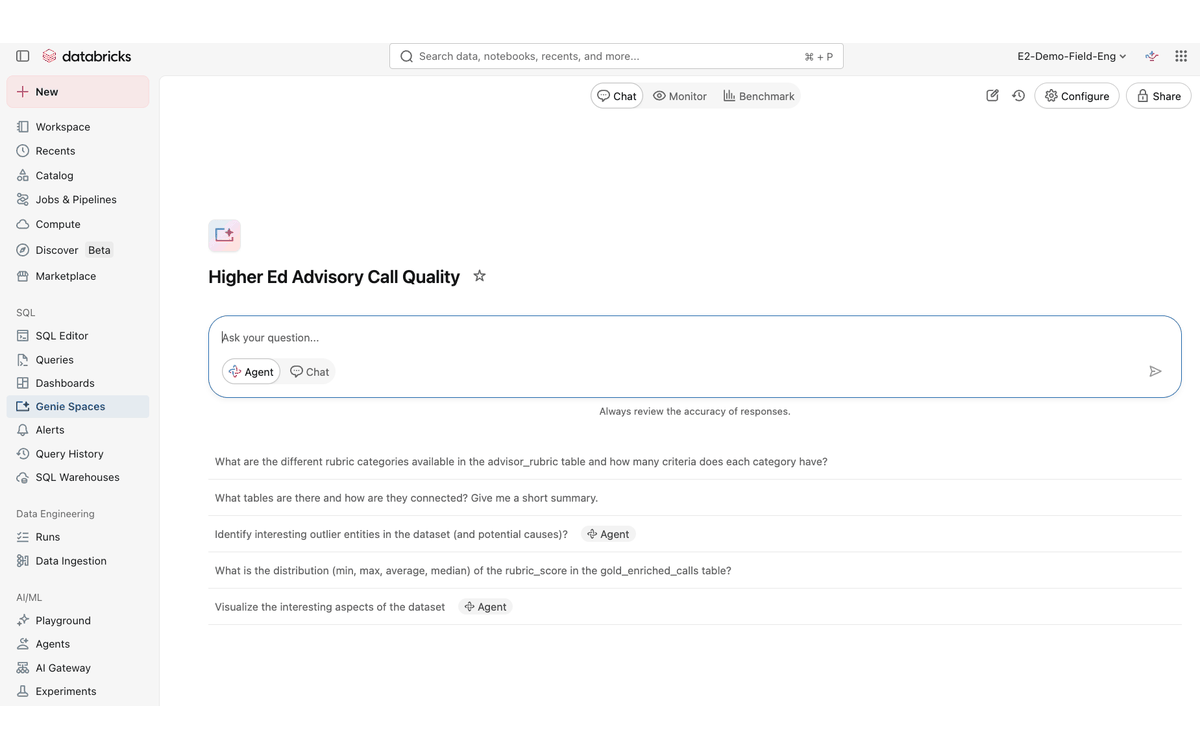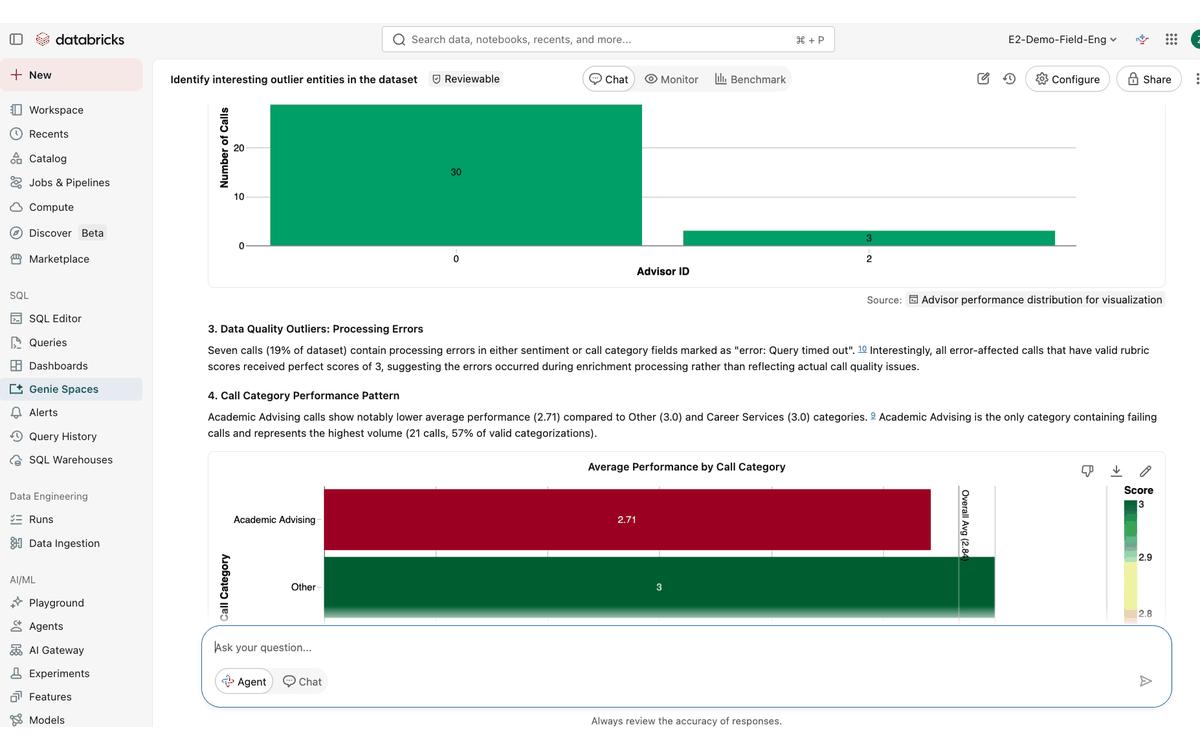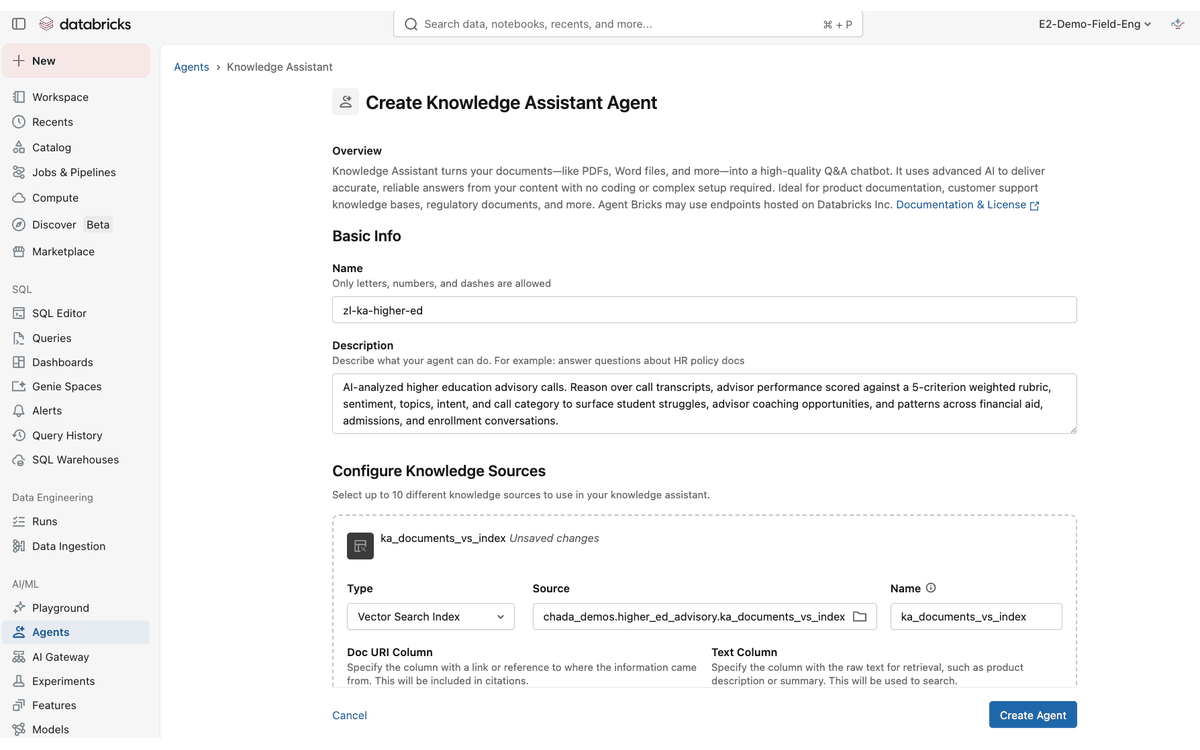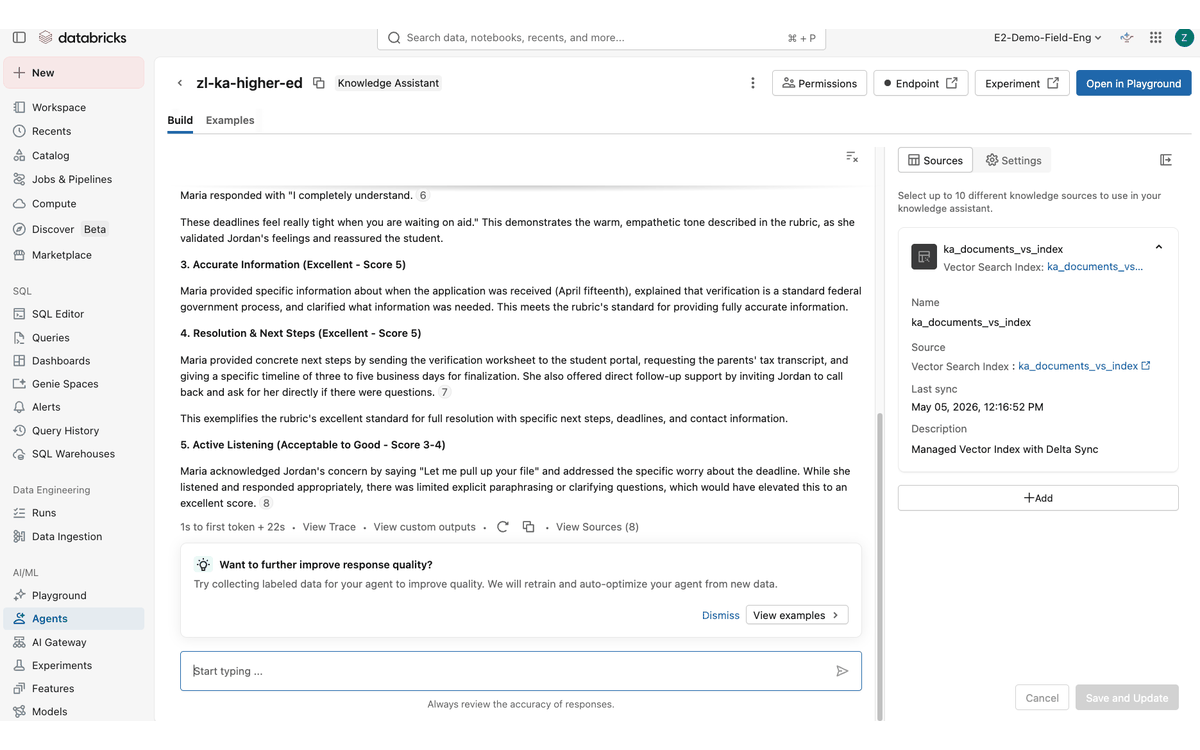
ai_analyze_sentiment()및ai_extract()로 각 통화 데이터를 보강합니다. - 두 가지 상호 보완적인 인터페이스를 통해 결과를 제공합니다. 하나는 근거가 있는 인용구와 함께 원시 텍스트 변환 결과에 대해 비정형 추론("학생들이 재정 지원에서 흔히 겪는 어려움은 무엇인가요?")을 수행하는 Agent Bricks Knowledge Assistant이고, 다른 하나는 정형화된 트렌드 쿼리("이번 분기 카테고리별 평균 감성은 어떤가요?")를 위한 Genie Space입니다.
Databricks에서 이 솔루션이 강력한 이유는 모든 단계(수집, 텍스트 변환, AI 분석, 탐색)가 단일 거버넌스 플랫폼에서 실행되기 때문입니다. Unity Catalog는 세분화된 액세스 제어를 통해 민감한 학생 데이터를 안전하게 보호합니다. ai_query()과 같은 AI Functions는 별도의 추론 인프라 없이 SQL에서 직접 파운데이션 모델을 호출합니다. 여러 도구를 연결할 필요가 없고, 데이터가 거버넌스 경계를 벗어나지 않으며, 별도의 오케스트레이션 레이어도 필요하지 않습니다.
아키텍처

이 솔루션은 거버넌스가 적용된 파이프라인을 통해 클라우드 오브젝트 스토리지의 비정형 오디오를 고정밀 정형 데이터로 변환합니다.
| 단계 | 구성 요소 | 목적 |
|---|---|---|
| 수집 (Ingest) | Auto Loader 및 Volumes | 클라우드 스토리지 오디오를 거버넌스가 적용된 Delta 테이블에 동기화 |
| 텍스트 변환 (Transcribe) | OpenAI Whisper | 비정형 오디오를 고정밀 텍스트로 변환합니다. Model Serving에서 호스팅되며 NVIDIA Canary, Distil-Whisper 또는 기타 Hugging Face ASR 모델로 교체 가능합니다. |
| 보강 (Enrich) | AI Functions + UC SQL Functions | 감성, 주제, 의도, 통화 카테고리 및 LLM-as-a-judge 루브릭 점수 산정 — 각각 거버넌스가 적용된 Unity Catalog SQL 함수로 래핑됨 |
| 오케스트레이션 (Orchestrate) | Model Serving 기반 LangGraph + Claude | UC SQL 함수를 도구로 체이닝하는 추론 에이전트입니다. 관리형 서빙 엔드포인트로 배포되며 AI Playground 또는 REST API에서 액세스할 수 있습니다. |
| 추론 (Reason) | Agent Bricks Knowledge Assistant | 특정 통화에 대한 근거 있는 인용구와 함께 비정형 통화 텍스트 변환 결과에 대해 대화 수행 |
| 탐색 (Discovery) | Genie Space | 정형화된 통화 메타데이터에 대한 자연어 SQL 인터페이스 |
원시 오디오는 Unity Catalog의 Databricks Volumes에 저장됩니다. Whisper는 분산 음성-텍스트 변환을 수행하여 기본 제공 텍스트 변환 기능이 놓치기 쉬운 학생 이름 및 고등 교육 전문 용어와 같은 미세한 차이를 포착합니다. 그런 다음 AI Functions가 감성, 주제, 루브릭 점수로 각 레코드를 보강합니다. 이러한 데이터는 기관 레코드(예: Salesforce의 학생 데이터)와 통합되어 모든 상호 작용에 대한 360도 뷰를 제공합니다.
시작하기
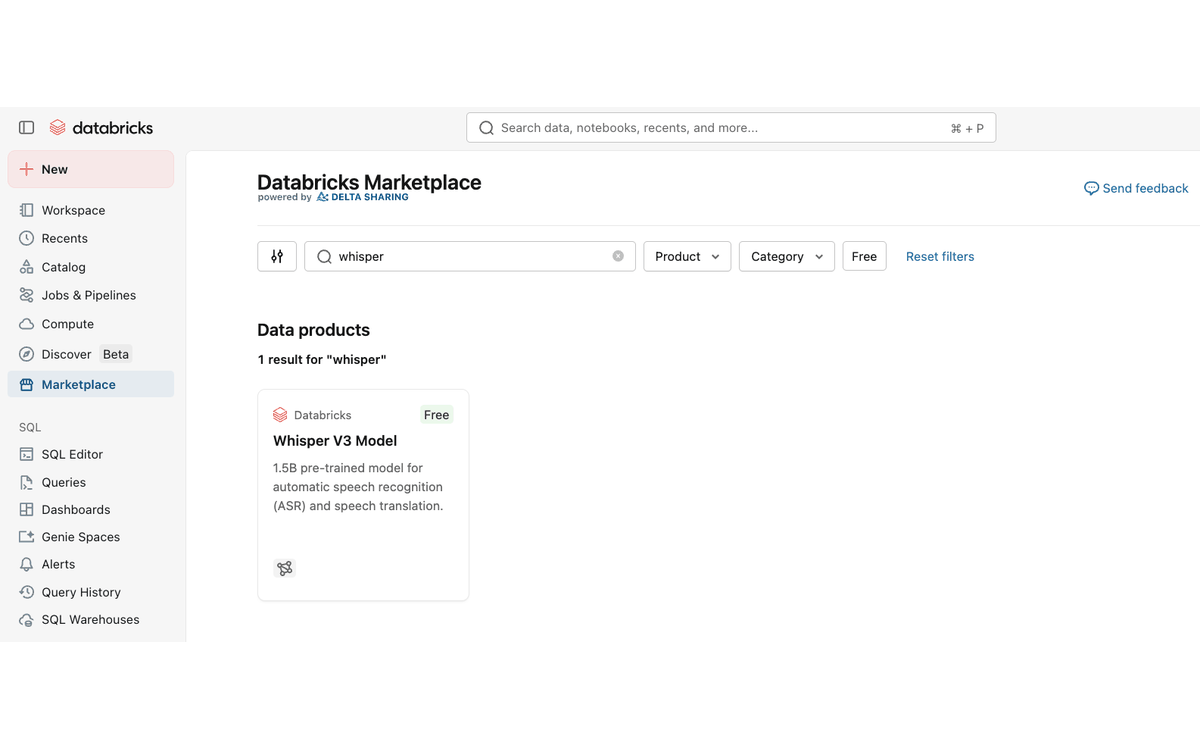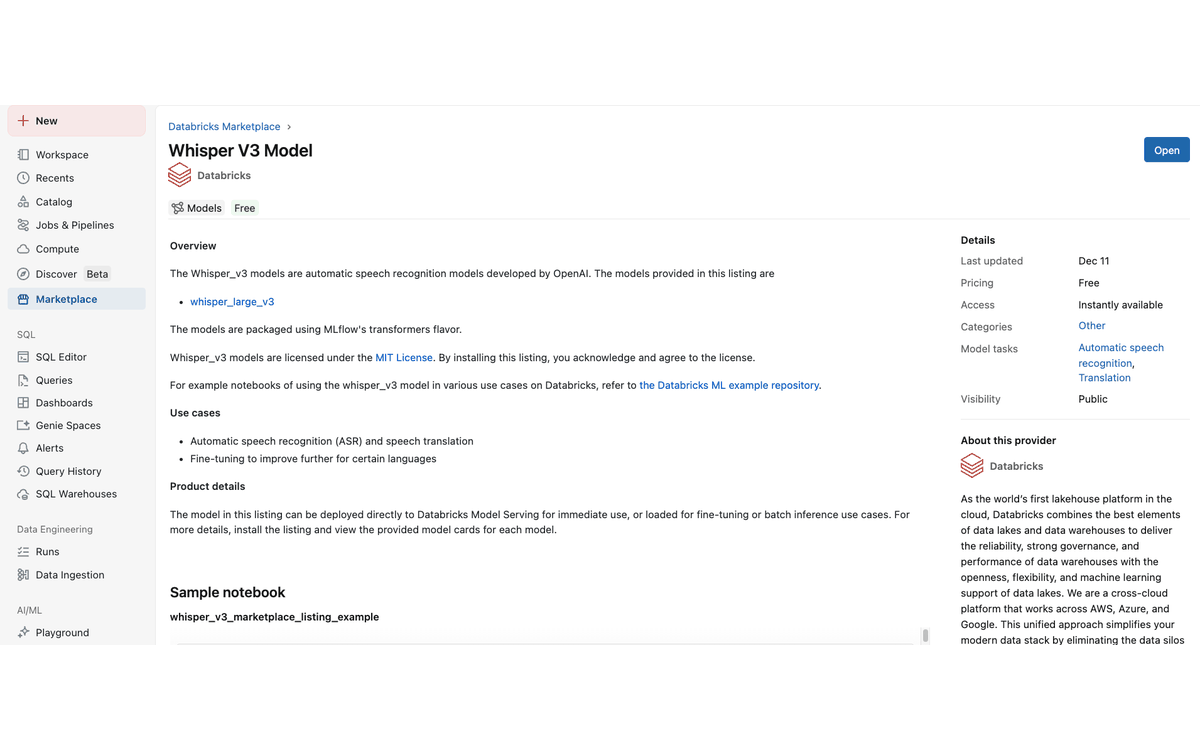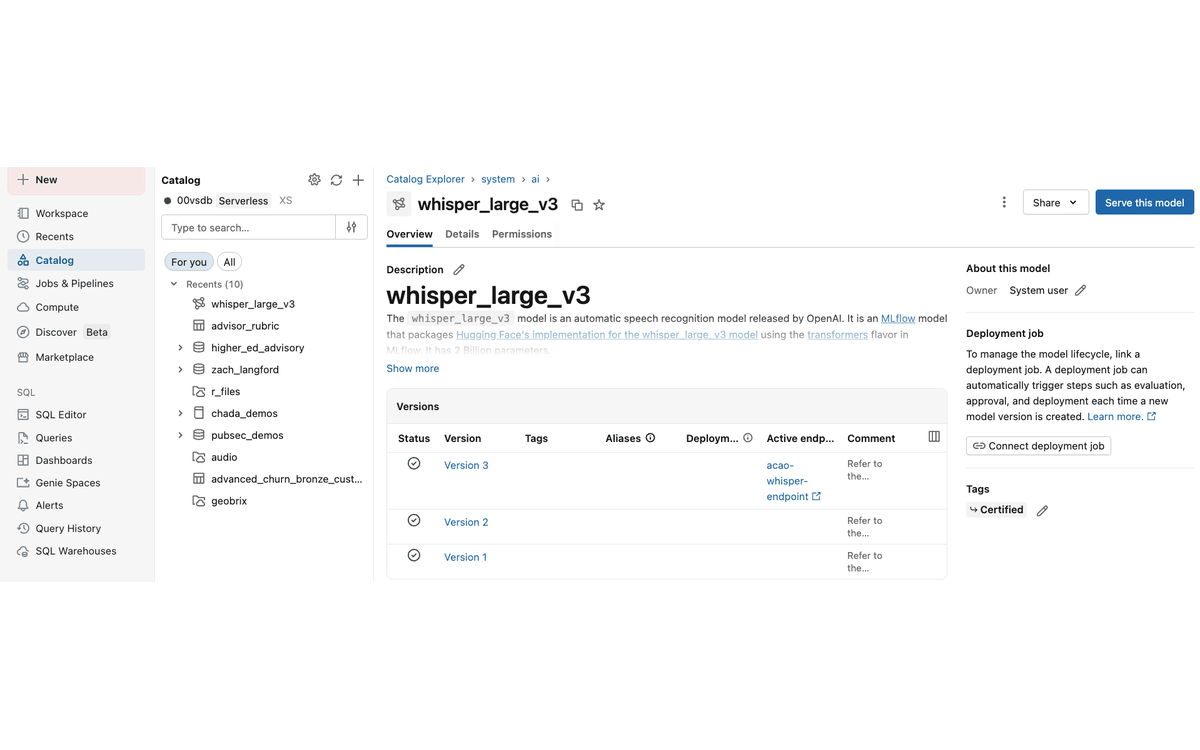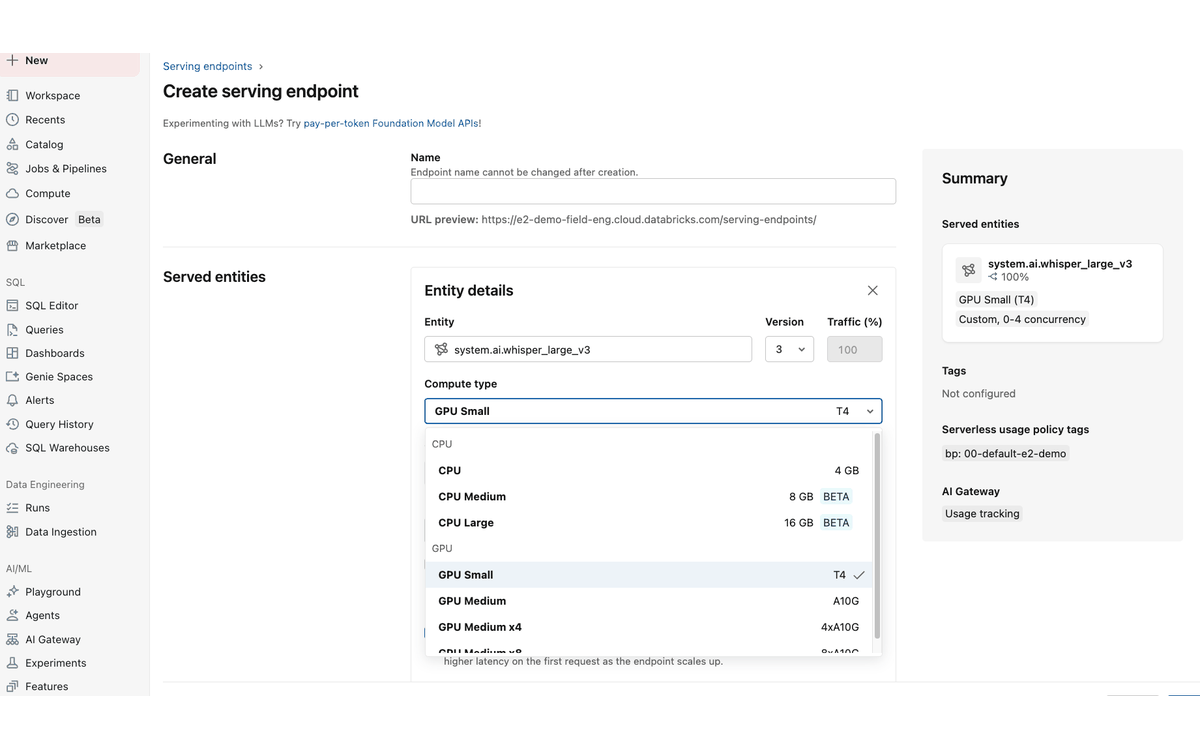
솔루션을 실행하려면 카탈로그/스키마 위젯 값을 업데이트하고 SQL 웨어하우스를 사용할 수 있는지 확인하세요(AI Functions는 서버리스 SQL 컴퓨팅에서 실행되는 ai_query()을 사용합니다). 단일 사용자 클러스터(DBR 15.4 LTS+) 또는 서버리스 환경에 컴퓨팅을 연결합니다.
Whisper의 경우 가장 쉬운 방법은 Databricks Marketplace를 이용하는 것입니다. 마켓플레이스에서 Whisper 모델(예: whisper-large-v3)을 카탈로그에 설치하고 처리량 요구 사항에 맞는 GPU 티어를 사용하여 서빙 엔드포인트로 배포합니다. 에이전트의 LLM 엔드포인트(Claude, Llama)는 기본적으로 제공되는 Foundation Model API 엔드포인트이며, 모든 엔드포인트 이름은 위젯 매개변수를 통해 구성할 수 있습니다.
설정 단계에서는 스키마, Delta 테이블, 상담원 루브릭을 생성하고 12개의 SQL 함수를 모두 등록합니다. 배포 시에는 Auto Loader를 통해 오디오 메타데이터를 수집하고, LangGraph 에이전트를 MLflow로 패키징하여 모델 서빙 엔드포인트로 배포합니다(약 15분 소요). 40개 이상의 엔드투엔드 테스트로 구성된 테스트 도구 모음이 테이블 스키마부터 라이브 엔드포인트 도구 호출에 이르기까지 모든 것을 검증합니다.
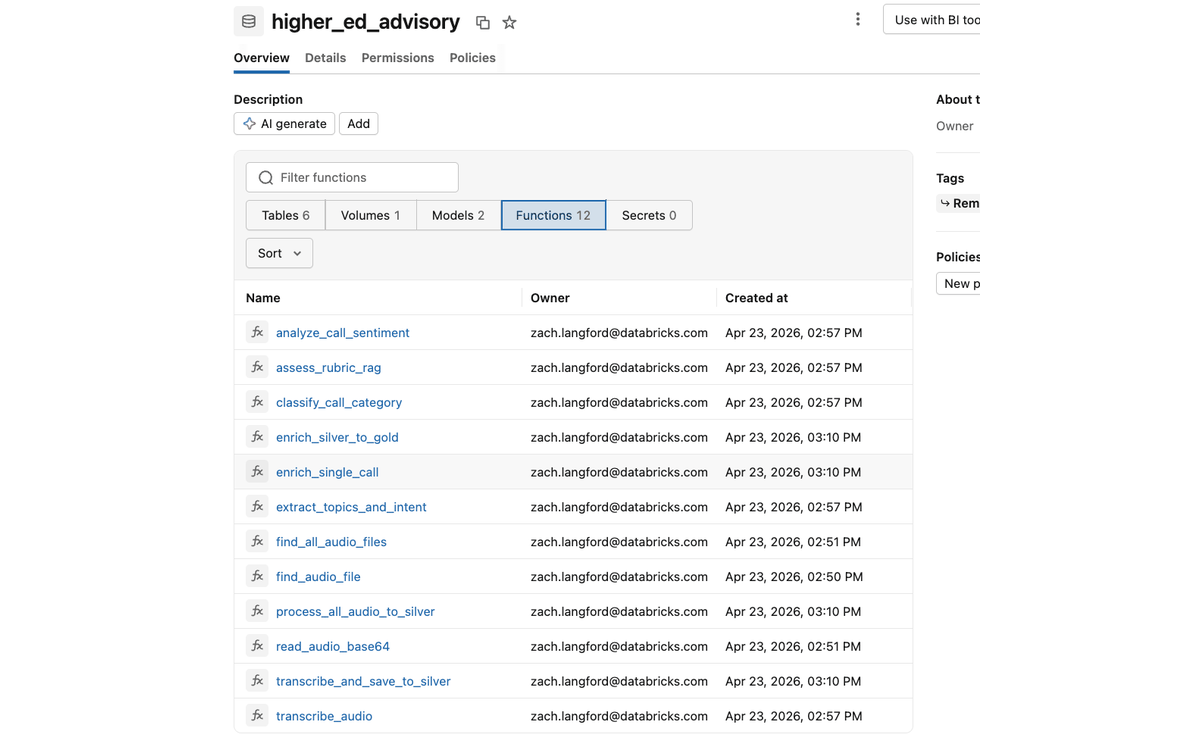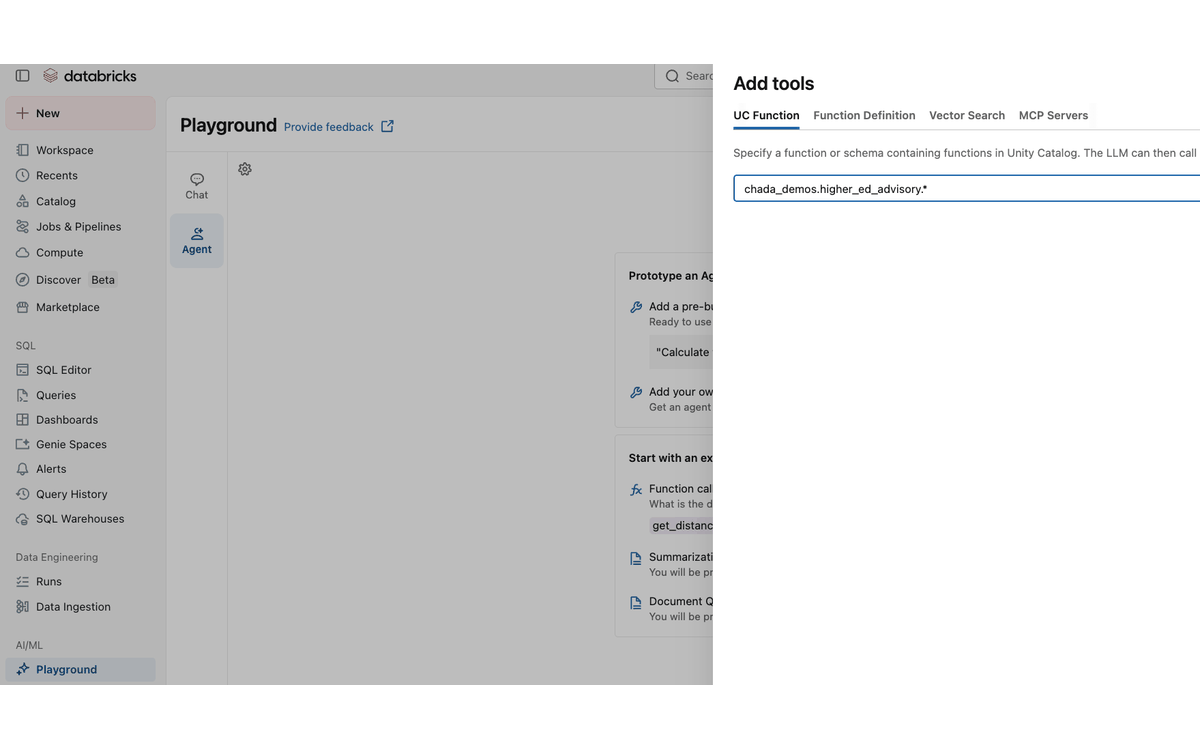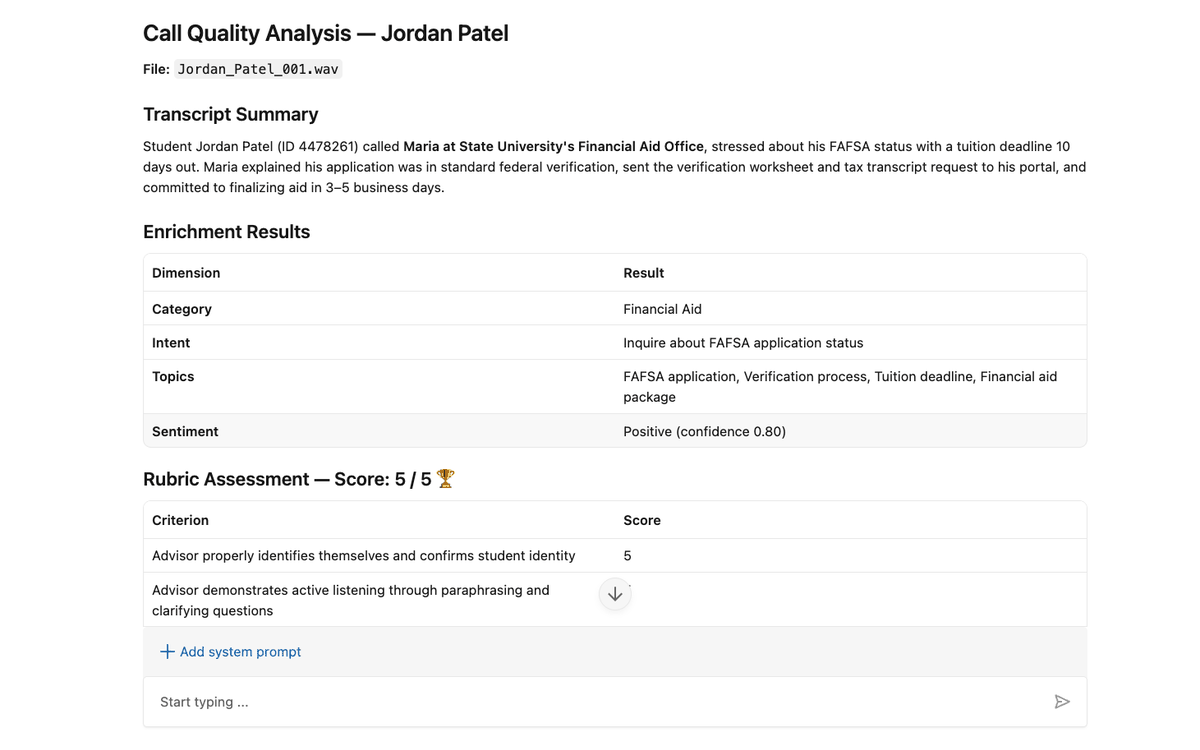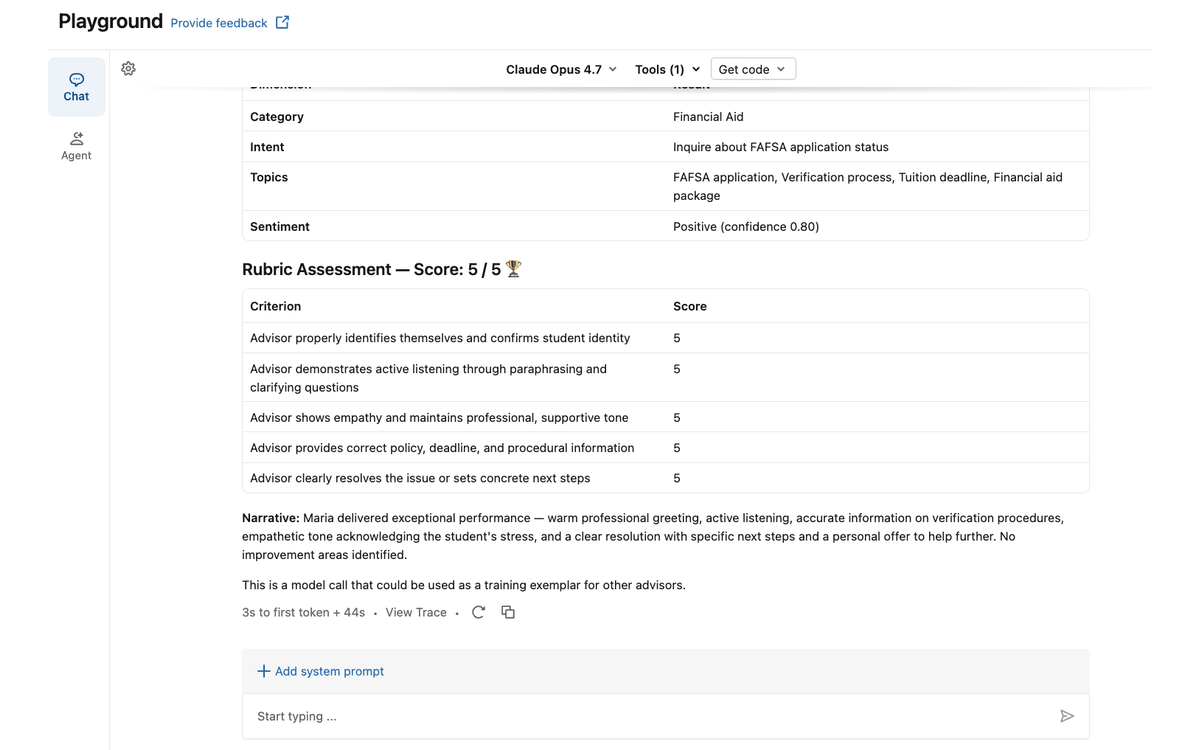
배포가 완료되면 AI Playground에서 에이전트와 상호 작용할 수 있습니다. 엔드포인트를 선택하고 자연어로 질문해 보세요. Playground는 프로토타입 우선 경로도 지원합니다. UC SQL 함수를 파운데이션 모델에 도구로 연결하고, 시스템 프롬프트를 반복 수정한 다음, 작동하는 구성을 Python/MLflow 노트북으로 내보낼 수 있습니다.
그 위에는 두 가지 자연어 인터페이스가 제공됩니다. 정형화된 질문("통화 카테고리별 평균 루브릭 점수는 얼마인가요?")을 위한 Genie Space와 근거 있는 인용구와 함께 비정형 텍스트 변환 결과에 대해 추론("학생들이 재정 지원에서 흔히 겪는 어려움은 무엇인가요?")을 수행하는 Agent Bricks Knowledge Assistant입니다. 이 두 가지를 통해 기술 지식이 없는 상담원, 멘토, QA 관리자도 데이터 SME에게 문의하지 않고도 학생들에 대해 알아볼 수 있습니다. 자세히 알아보기: Genie Spaces (AWS | Azure | GCP) 및 Agent Bricks Knowledge Assistant (AWS | Azure | GCP).
자체 환경에서 이를 탐색해 볼 준비가 되셨나요? GitHub에서 솔루션을 다운로드하여 상담 통화 녹음이 엔드투엔드로 어떻게 수집, 전사, 분석 및 탐색되는지 확인해 보세요. 더 나아가, 생성형 AI 워크플로를 위한 Databricks AI, 안전한 거버넌스를 위한 Unity Catalog, 대화형 분석을 위한 Genie에 대해 자세히 알아보세요. 추가적인 안내가 필요하다면 솔루션 가속기, 제품 문서를 살펴보거나 Databricks에 문의하여 이러한 기능이 귀 기관의 학생 서비스 운영을 어떻게 지원할 수 있는지 알아보세요.
Databricks가 교육, 정부 및 비영리 기관을 어떻게 지원하는지 최신 소식을 계속 받아보시려면 LinkedIn에서 Databricks for Public Sector를 팔로우하세요.
(이 글은 AI의 도움을 받아 번역되었습니다. 원문이 궁금하시다면 여기를 클릭해 주세요)
솔루션, Genie, Agent Bricks, Unity Catalog, Model Serving, Databricks Marketplace , Orchestration
최신 게시물을 이메일로 받아보세요
블로그를 구독하고 최신 게시물을 이메일로 받아보세요.