dbt와 Databricks로 비용 효율적인 실시간 데이터 제공
작성자: Shabbir Khanbhai, 폴 랩파스 , Bilal Aslam
비즈니스가 성장함에 따라 데이터 볼륨은 GB에서 TB(또는 그 이상)로 확장되고, 지연 시간 요구 사항은 몇 시간에서 몇 분(또는 그 이하)으로 단축되어 비즈니스에 신선한 인사이트를 제공하는 데 점점 더 많은 비용이 발생합니다. 과거에는 Python 및 Scala 데이터 엔지니어들이 이러한 요구 사항을 충족하기 위해 스트리밍을 사용했지만, SQL 기반의 dbt 파이프라인을 확장해야 하는 분석 엔지니어에게는 이러한 옵션이 없었습니다.
이제 달라졌습니다! 이 블로그에서는 Databricks의 새로운 스트리밍 테이블과 구체화된 뷰를 사용하여 SQL과 dbt의 단순성으로 비즈니스에 신선하고 실시간 인사이트를 제공하는 방법을 보여드리고자 합니다.
배경
2023 Data + AI Summit에서 저희는 Databricks SQL에 스트리밍 테이블과 구체화된 뷰를 도입했습니다. 이 멋진 기능은 Databricks SQL 사용자가 Delta Live Tables 내에 처음 도입된 강력한 새 테이블 구체화 기능에 쉽게 액세스할 수 있도록 하여, 대규모 쿼리를 점진적으로 처리하고 이벤트 데이터 소스에서 직접 스트리밍하는 등의 작업을 수행할 수 있게 해줍니다.
Databricks 환경 내에서 스트리밍 테이블과 구체화된 뷰를 네이티브로 사용하는 것 외에도, Databricks의 dbt 사용자에게도 유용합니다. dbt-databricks는 Databricks에서 데이터 모델을 구축하는 가장 인기 있는 방법 중 하나가 되었습니다. 이는 Databricks SQL의 모든 강력한 기능, 즉 Photon 컴퓨팅 엔진, 즉시 확장되는 서버리스 SQL 웨어하우스 및 Unity Catalog 거버넌스 모델을 dbt의 변환 프레임워크의 보편성과 함께 활용합니다.
dbt-databricks의 변경 사항
dbt v1.6 이상부터 dbt-databricks는 세 가지 주요 측면에서 발전했습니다:
- 새로운 구체화: "streaming_table" 및 "materialized_view"
- 소스 데이터를 테이블로 스테이징하지 않고 클라우드 데이터 스토리지에서 직접 읽는 새로운 구문
- 윈도우 집계, 워터마킹, 스트림-스트림 조인과 같은 고급 스트리밍 개념에 대한 액세스
참고: 위의 기능을 더욱 개선할 예정인 dbt v1.7.3 릴리스를 기대해 주세요!
Airline Trips 데모에서 이러한 새 기능을 어떻게 사용할 수 있는지 살펴보겠습니다.
Airline Trips 데모
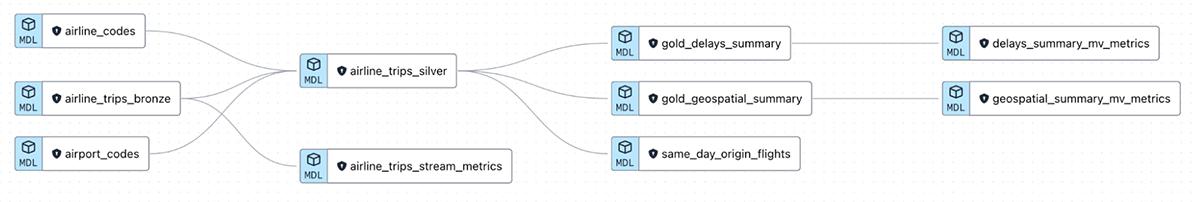
Airline Trips 데모는 대시보드든 AI 모델이든 Databricks에서 최신 비즈니스 인사이트를 위해 실시간 이벤트 데이터를 점진적으로 수집하고 변환하는 방법을 시연하기 위해 만들어졌습니다. 이 데이터셋은 미국 전역에서 발생하는 모든 항공편을 시간에 따라 나타내며, 각 항공편의 출발 및 도착 지연을 캡처합니다.
포함된 도우미 노트북은 이 데이터셋에서 시뮬레이션된 스트림을 설정하며, dbt 프로젝트는 이러한 원시 JSON 이벤트를 가져와 스트리밍 ETL을 통해 구체화된 뷰, 피처 테이블 등의 계층으로 변환하는 데이터 모델을 보여줍니다.
이 리포지토리는 여기에서 공개적으로 사용할 수 있으며, 모든 Databricks 워크스페이스에 기본 제공되는 샘플 데이터를 활용합니다. 자유롭게 따라 해 보세요!
클라우드 데이터 스토리지에서 데이터 수집
스트리밍 테이블을 활용하는 가장 간단한 방법 중 하나는 AWS의 S3 또는 Azure의 ADLS와 같은 클라우드 데이터 스토리지에서 데이터를 수집하는 것입니다. 업스트림 데이터 소스에서 대량의 이벤트 데이터를 생성하고, 이러한 데이터를 일반적으로 json, csv, parquet 또는 avro 형식으로 스토리지 위치에 저장하는 프로세스가 있을 수 있습니다.
저희 데모에서는 외부 당사자로부터 미국에서 발생하는 모든 항공편의 실시간 피드를 받고, 이 데이터가 들어오는 대로 점진적으로 수집하고 싶다고 가정해 봅시다.
파일을 외부 테이블로 스테이징하거나 타사 도구를 사용하여 데이터 소스에 대한 Delta 테이블을 구체화하는 대신, 스트리밍 테이블을 사용하여 이 문제를 해결할 수 있습니다. 다음은 브론즈 항공편 피드를 위한 모델입니다:
주목해야 할 두 가지 주요 사항은 다음과 같습니다:
- 구체화 전략은 'streaming_table'로 설정됩니다.
- 이는 Databricks에서 CREATE OR REFRESH STREAMING TABLE 명령을 실행합니다.
- 클라우드 스토리지에서 읽는 구문은 내부적으로 Auto Loader를 활용합니다.
- read_files()는 지정된 폴더에서 새 json 파일을 나열하고 처리를 시작합니다. dbt를 사용하므로 dbt의 var() 함수를 활용하여 s3 폴더 경로를 동적으로 전달합니다(형식은 "s3://…"입니다).
- STREAM 키워드는 이 위치에서 스트리밍함을 나타냅니다. 그렇지 않으면, STREAM 없이도 read_files()를 materialized='table'과 함께 사용하여 지정된 폴더에서 직접 일괄 읽기를 수행할 수 있습니다.
참고로, Auto Loader는 설정이 가장 적지만, Kafka, Kinesis 또는 Event Hubs와 같은 이벤트 스트리밍 플랫폼에서 직접 스트리밍하여 훨씬 낮은 지연 시간을 얻을 수도 있습니다. 자세한 내용은 여기를 참조하세요.
실버 계층을 위한 데이터 점진적 강화
스트리밍은 수집 단계에서 멈출 필요가 없습니다. 다운스트림에서 일부 조인을 수행하거나 대체 키를 추가하고 싶지만, 컴퓨팅 비용을 절약하기 위해 새 데이터로만 제한하고 싶다면 스트리밍 테이블 구체화를 계속 사용할 수 있습니다. 예를 들어, 공항 코드를 원시 데이터셋에 조인하는 실버, 강화된 항공편 피드를 위한 다음 모델의 스니펫을 살펴보겠습니다:
다시 한번, 스트리밍 테이블 구체화를 활용했으며 모든 로직에 대해 표준 dbt 기능을 사용할 수 있었습니다. 여기에는 다음이 포함됩니다:
- 대체 키 생성과 같은 편리한 바로 가기를 위해 dbt_utils 패키지 활용
- 전체 계보를 유지하기 위해 ref() 문 사용
SQL에서 유일하게 실제 변경된 점은 airline_trips_bronze에 대한 ref() 문 주위에 STREAM() 키워드를 추가하여 이 테이블이 점진적으로 읽히고 있음을 나타내는 것이었습니다. 조인되는 airport_codes 테이블은 전체로 읽히는 매핑 테이블입니다. 이것을 스트림-정적 조인이라고 합니다.
구체화된 뷰를 사용하여 컴퓨팅 효율적인 골드 계층 구축
강화된 실버 테이블이 준비되었으므로, 이제 최종 비즈니스 사용자에게 집계된 인사이트를 제공하는 방법을 고려할 수 있습니다. 일반적으로 테이블 구체화를 사용하면 매번 모든 과거 결과를 다시 계산해야 합니다.
각 실행에서 새 데이터만 처리하는 업스트림 스트리밍 테이블을 활용하기 위해, 이 작업을 위해 구체화된 뷰를 사용합니다!
Databricks에서 좋은 점은 구체화된 뷰를 구축하는 모델이 테이블을 구축하는 모델과 다르지 않다는 것입니다! 매일 지연된 항공편의 비율을 계산하는 골드 계층 구체화된 뷰에 대한 예시를 살펴보겠습니다:
구체화 설정만 변경했습니다!
기억하세요, 구체화된 뷰는 기본 테이블에 변경 사항이 있을 때 점진적으로 새로고침될 수 있습니다. 위의 시나리오에서 새 데이터를 스트리밍함에 따라, 구체화된 뷰는 어떤 그룹이 다시 계산되어야 하는지 결정하고 이러한 그룹만 계산하며 변경되지 않은 집계는 그대로 두고 전체 컴퓨팅 비용을 줄입니다. 이는 항공편 도착 날짜인 ArrDate에 대해 집계하는 예시에서 시각화하기 쉽습니다. 즉, 새 날짜의 데이터는 자연스럽게 새 그룹으로 들어가고 기존 그룹은 변경되지 않은 상태로 유지됩니다.
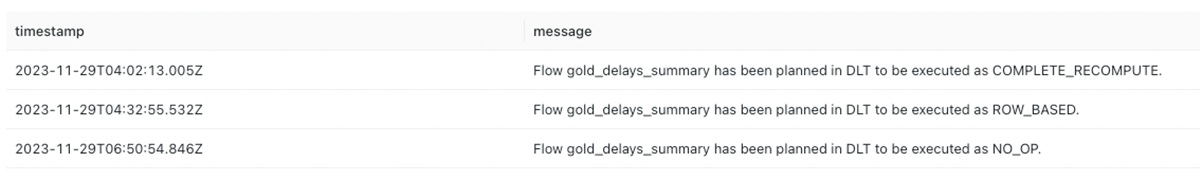
모델을 여러 번 실행한 후 구체화된 뷰의 이벤트 로그(아래 그림 참조)를 분석하면 점진적 처리를 확인할 수 있습니다. 첫 번째 실행은 모든 테이블과 마찬가지로 전체 계산이지만, 새 데이터로 집계를 업데이트하기 위한 두 번째 실행은 행 단위 점진적 새로고침을 활용합니다. 모델의 마지막 실행에서는 업스트림에서 새 데이터가 수집되지 않았음을 인식하고 아무 작업도 수행하지 않았습니다.
데모 리포지토리에서 또 무엇을 기대할 수 있나요?
이벤트 소스에서 바로 BI 준비가 된 Materialized View까지 데이터를 가져오는 기본 사항을 다루었지만, 데모 리포지토리에는 훨씬 더 많은 것이 포함되어 있습니다.
리포지토리에는 데이터가 어떻게 처리되는지 이해하기 위해 Streaming Tables 및 Materialized Views의 로그를 모니터링하는 방법에 대한 예시와, SQL만으로 두 개의 스트림을 stream-stream join으로 결합하는 방법에 대한 이 블로그에서 다루지 않은 고급 예시가 포함되어 있습니다!
시작하려면 리포지토리를 Databricks 환경으로 복제하거나, partner connect를 통해 추가 비용 없이 dbt Cloud를 Databricks에 연결하세요. Materialized Views 및 Streaming Tables에 대한 문서를 통해 더 자세히 알아볼 수도 있습니다.
(이 글은 AI의 도움을 받아 번역되었습니다. 원문이 궁금하시다면 여기를 클릭해 주세요)
최신 게시물을 이메일로 받아보세요
블로그를 구독하고 최신 게시물을 이메일로 받아보세요.