그라운디드 리즈닝 컵(Grounded Reasoning Cup) 현장에서 진행된 AI 에이전트 실시간 평가
우수한 학계 연구팀들이 실시간 대회 환경에서 새로운 기업 문서 코퍼스에 일반화 성능을 보이는 AI 에이전트를 구축한 방법을 알아봅니다.
- Grounded Reasoning Cup은 11개 학술 팀에게 OfficeQA Pro에서 개발된 에이전트를 약 120,000페이지의 미국 재무부 문서를 바탕으로 새로 출시된 벤치마크인 OfficeQA Pro V2에 적용하는 과제를 부여했습니다.
- 결과에 따르면 일반화를 당연하게 가정할 수 없음이 드러났습니다. 익숙한 벤치마크에서 개발된 접근 방식이 새로운 코퍼스로 항상 안정적으로 전이되지는 않았으며, 즉시 사용 가능한 프론티어 에이전트의 평균 정확도는 30% 미만이었습니다.
- 스탠포드 우승 팀은 재사용 가능한 스킬 라이브러리, 타겟팅된 문서 표현 폴백(fallback), 적응형 검증을 결합한 엔드투엔드 에이전트 최적화 전략을 통해 63.3%의 정확도를 달성했습니다.
올해 Databricks는 복잡한 기업형 문서 컬렉션을 바탕으로 추론하는 AI 에이전트의 능력을 평가하기 위해, 동종 최초의 라이브 AI 경진 대회인 Grounded Reasoning Cup을 개최했습니다. 실제 경진 대회 환경에서 새로 공개된 코퍼스(corpus)로 에이전트를 테스트함으로써, Grounded Reasoning Cup은 AI 평가에서 가장 까다로운 질문 중 하나인 '벤치마크에서의 성능 향상이 유사한 실제 작업으로 얼마나 잘 일반화(generalize)되는가?'에 대한 답을 찾는 데 기여하도록 설계되었습니다.
이번 대회에는 미국과 캐나다 전역에서 선정된 11개의 우수 대학 팀이 참가했으며, 이들은 OpenAI, Anthropic, Google DeepMind를 포함한 프론티어 연구소의 리소스 및 멘토링 지원을 받았습니다. 두 달 동안 각 팀은 경제적 가치가 높은 기업의 워크플로우를 반영하도록 설계된 Databricks의 대표적인 근거 기반 추론 벤치마크인 OfficeQA를 활용하여 에이전트를 개발하고 최적화했습니다. 대회 당일, 참가 팀들은 자신들이 개선한 성능이 실제로 일반화되는지 테스트하기 위해 새로 공개된 근거 기반 추론 벤치마크인 OfficeQA Pro V2에 해당 시스템을 실시간으로 적용하는 과제를 수행했습니다.
스탠포드(Stanford) 대학 팀은 63.3%의 정확도를 기록한 시스템으로 우승을 차지하며, 평균 참가 팀 대비 약 +22점, 평균 프론티어 에이전트 오프라인 베이스라인 대비 약 +35점 높은 점수를 기록했습니다. 상위권 팀들은 문서 전처리, 타겟팅된 검색(retrieval), 병렬 에이전트, 구조화된 도구 사용 및 검증을 통해 상당한 성능 향상을 보여주었습니다. 동시에 전체 질문의 18.8%는 어떤 팀도 해결하지 못해, 기업용 근거 기반 추론 분야에서 앞으로 발전할 여지가 얼마나 많이 남아 있는지를 여실히 보여주었습니다.
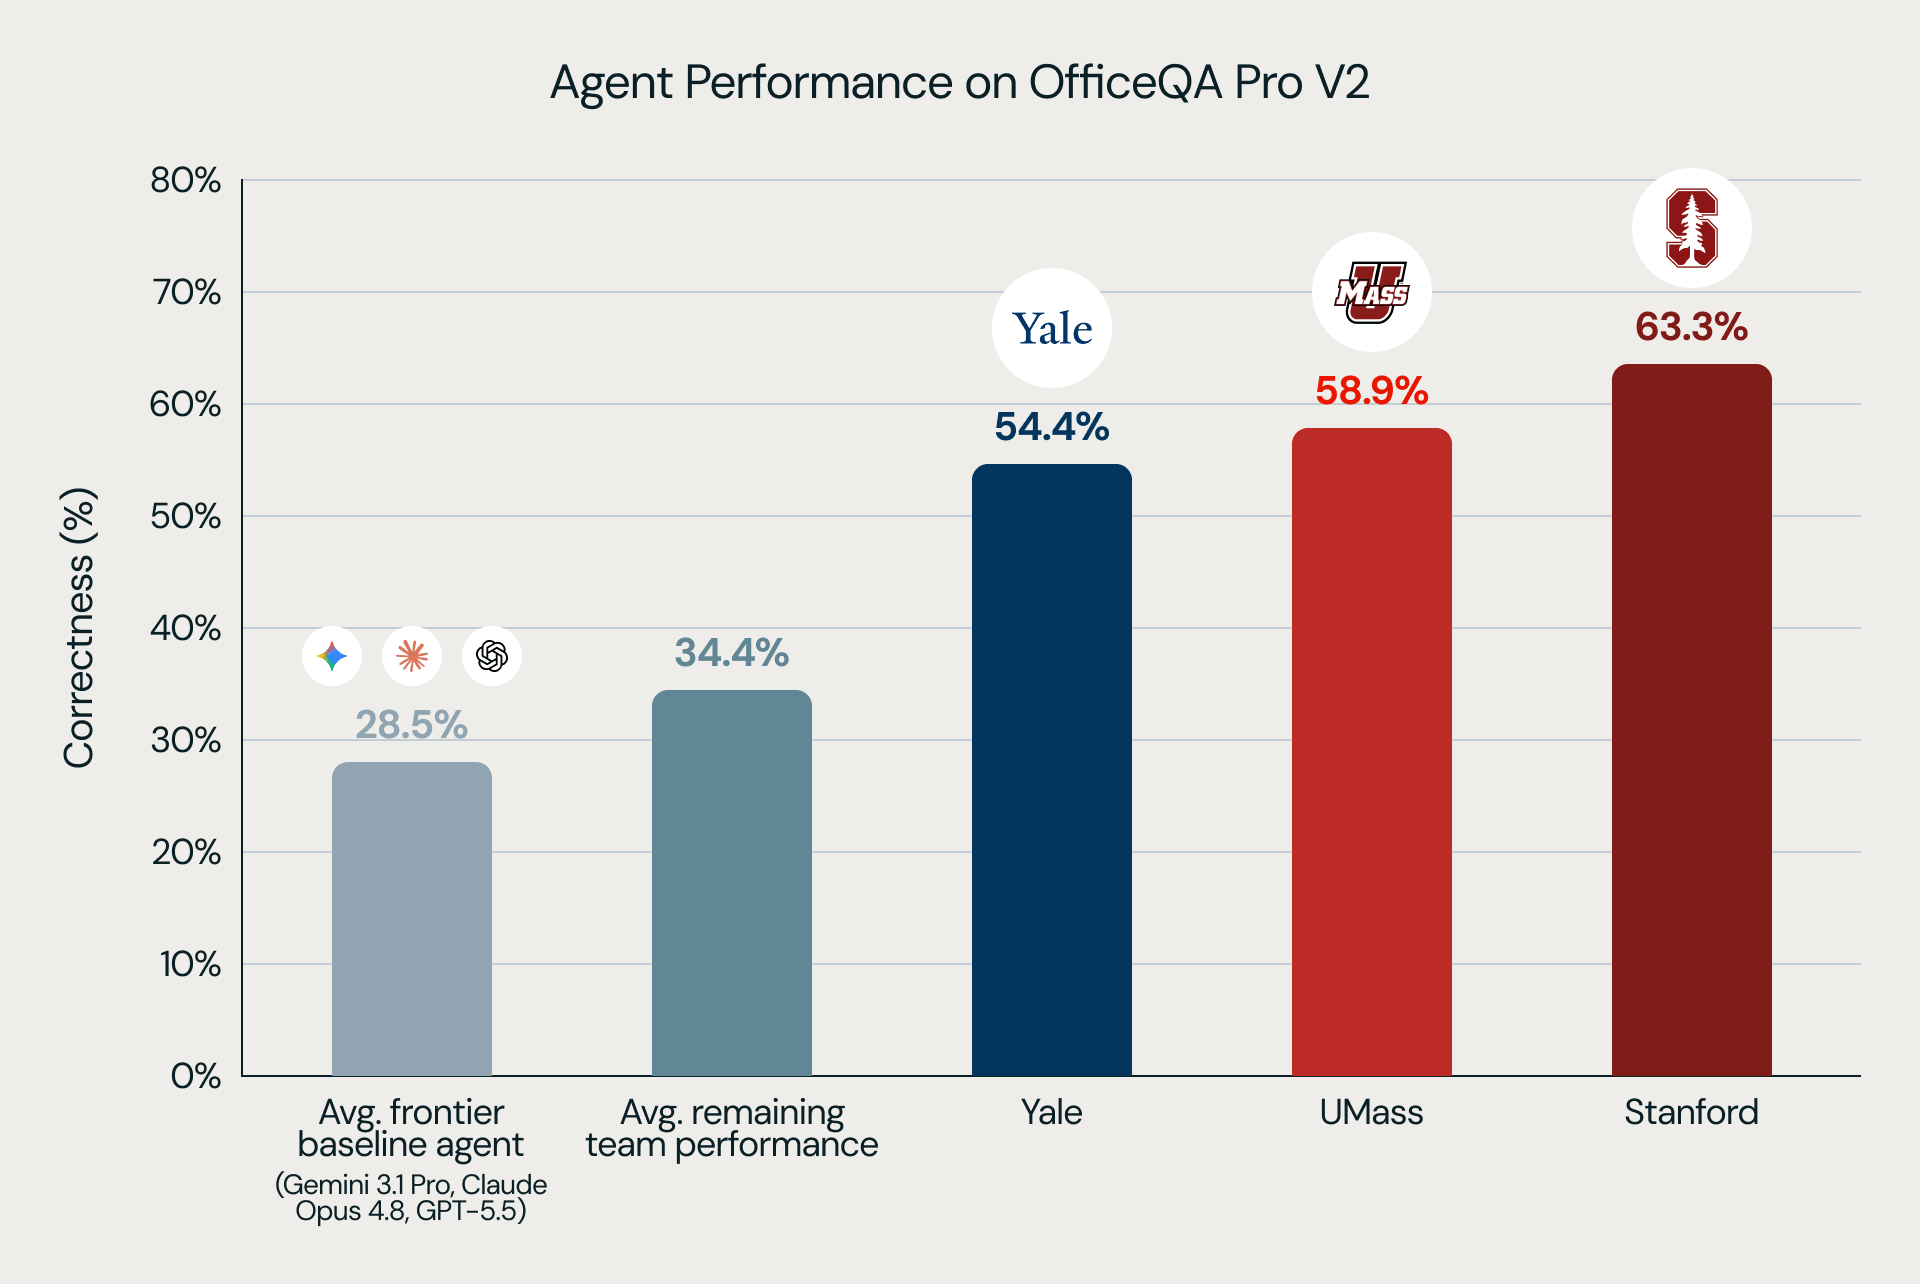
이 블로그 포스트에서는 대회를 요약하고, Grounded Reasoning Cup의 우승 팀인 스탠포드(Stanford), 매사추세츠 대학교 애머스트(UMass Amherst), 예일(Yale) 대학 팀의 에이전트 최적화 전략과 인사이트를 공유합니다.
주요 결과는 다음과 같습니다.
- 일반화에는 대표성을 지닌 홀드아웃(held-out) 평가가 필요합니다. OfficeQA에서 개발된 기술이 새로운 벤치마크로 항상 안정적으로 전이되지는 않았습니다. 이는 솔루션이 새로운 예시로 잘 일반화되는지 확인하기 위해 OfficeQA Pro V2와 같은 홀드아웃 테스트 세트를 활용하는 것이 얼마나 중요한지 강조합니다.
- 에이전트 성능은 모델뿐만 아니라 전체 시스템에 좌우됩니다. 동일한 모델을 사용한 최고 득점 팀과 최저 득점 팀 간의 평균 격차는 30.4점이었습니다. 파싱, 검색(retrieval), 도구 사용, 검증, 병렬 처리 및 운영 인프라 모두가 에이전트의 엔드투엔드(end-to-end) 근거 기반 추론 작업 성공 여부를 갈랐습니다.
- 기업용 근거 기반 추론은 아직 해결해야 할 과제가 많습니다. 우승 팀들조차 벤치마크의 검색, 파싱 및 분석 요구 사항 중 상당 부분에서 어려움을 겪었으며, 이는 지속적인 연구와 개선의 여지가 많이 남아 있음을 뜻합니다. 실무자분들이 공개된 OfficeQA 벤치마크 스위트를 활용하여 이 분야의 연구를 계속 발전시켜 나가기를 권장합니다.
대회 구성
Grounded Reasoning Cup의 목표는 우수한 대학 팀들을 모아 근거 기반 추론(grounded reasoning)에 대한 일반화 가능한 접근 방식을 개발하는 것이었습니다. 이는 대규모의 (종종 독점적인) 문서 컬렉션에서 얻은 증거를 사용하여 복잡한 질문에 답하는 기업 환경의 흔한 작업입니다.
소속 대학을 대표하는 2~4인 규모의 팀들은 OpenAI, Anthropic 또는 Google DeepMind의 업계 파트너와 매칭되어 개발 기간 동안 모델 사용 권한과 멘토링을 지원받았습니다. 각 팀은 약 두 달 동안 자신들이 적합하다고 판단하는 방식을 자유롭게 사용하여 에이전트를 구축할 수 있었으나, 단 한 가지 제약 조건으로 파트너 연구소의 모델 제품군만 전적으로 사용하여 에이전트를 구동해야 했습니다. 이 기간 동안 팀들은 유사한 근거 기반 추론 작업으로 일반화될 수 있다고 믿는 새로운 기술들을 평가하기 위해 OfficeQA 벤치마크를 활용했습니다.
대회 당일, 팀들은 실시간으로 새로 공개된 벤치마크에 자신들의 에이전트를 적용하는 과제를 부여받았습니다. 대회는 다음과 같은 규칙에 따라 진행되었습니다.
- 벤치마크 공개: 새로운 코퍼스(미국 재무부의 세입세출 계정)는 대회 시작 불과 36시간 전에 공개되었습니다. 이를 통해 팀들이 데이터를 처리하고 인덱싱할 시간을 확보하는 동시에, 새로운 벤치마크에 방법론이 과적합(overfitting)될 기회를 제한했습니다.
- 설계 제약 조건: 배정된 업계 연구소 파트너의 모델을 사용하는 한, 팀들은 어떤 에이전트 프레임워크, 코퍼스 버전, 검색 전략, 도구 사용 설정 또는 휴먼 인 더 루프(human-in-the-loop) 워크플로우든 자유롭게 사용할 수 있었습니다.
- 형식: 대회는 라운드당 15개의 질문이 주어지는 15분짜리 라운드 6개로 구성되었습니다. 라운드가 진행될수록 난이도가 점차 높아졌습니다.
- 채점: 정답당 1점을 획득했습니다. 낮은 대기 시간(latency)을 장려하기 위해, 특정 질문에 가장 먼저 정답을 제출한 팀에게는 0.25점의 속도 보너스가 추가로 부여되었습니다. 가장 까다로운 질문들로 구성된 최종 라운드에서는 점수가 2배로 계산되었습니다. 또한 각 팀은 대회 기간 동안 총 3번의 재제출 기회를 가졌으며, 이를 통해 이전 답변을 수정할 수 있었습니다.
팀 성과 및 학습 내용
이번 대회를 통해 한 가지 분명해진 점이 있습니다. 7개월 전 OfficeQA 벤치마크를 출시한 이후 기업형 문서 코퍼스에 대한 근거 기반 추론 성능이 향상되었지만, 여전히 해결해야 할 과제가 많다는 것입니다. 평균 팀 점수는 약 41%였으며, 상위 3개 팀은 50% 이상의 정확도를 기록했고 스탠포드 팀은 63.3%의 정확도로 우승을 차지했습니다. 이러한 결과는 상위 팀들의 인상적인 성과를 보여주는 동시에, 앞으로 탐색해야 할 발전 여지가 여전히 많이 남아 있음을 시사합니다.
우승 팀들의 전략
각 팀은 독특한 접근 방식을 취했지만, 상위 3개 팀이 구축한 에이전트 전반에서 몇 가지 공통된 패턴이 나타났습니다. 우수한 시스템들은 신중한 문서 전처리, 타겟팅된 검색, 구조화된 도구 사용, 답변 검증 단계를 결합하는 경향이 있었습니다. 많은 경우, 성능은 단일 모델 호출보다는 문서를 파싱하는 방식, 증거를 검색하는 방식, 중간 계산을 수행하는 방식, 제출 전 답변을 검증하는 방식 등 주변 시스템에 더 크게 좌우되었습니다. 성능이 가장 뛰어난 시스템들이 일반적으로 이러한 공통점을 공유하는 한편, 아래에 설명된 것처럼 각 팀은 고유하고 창의적인 전략을 적용했습니다.
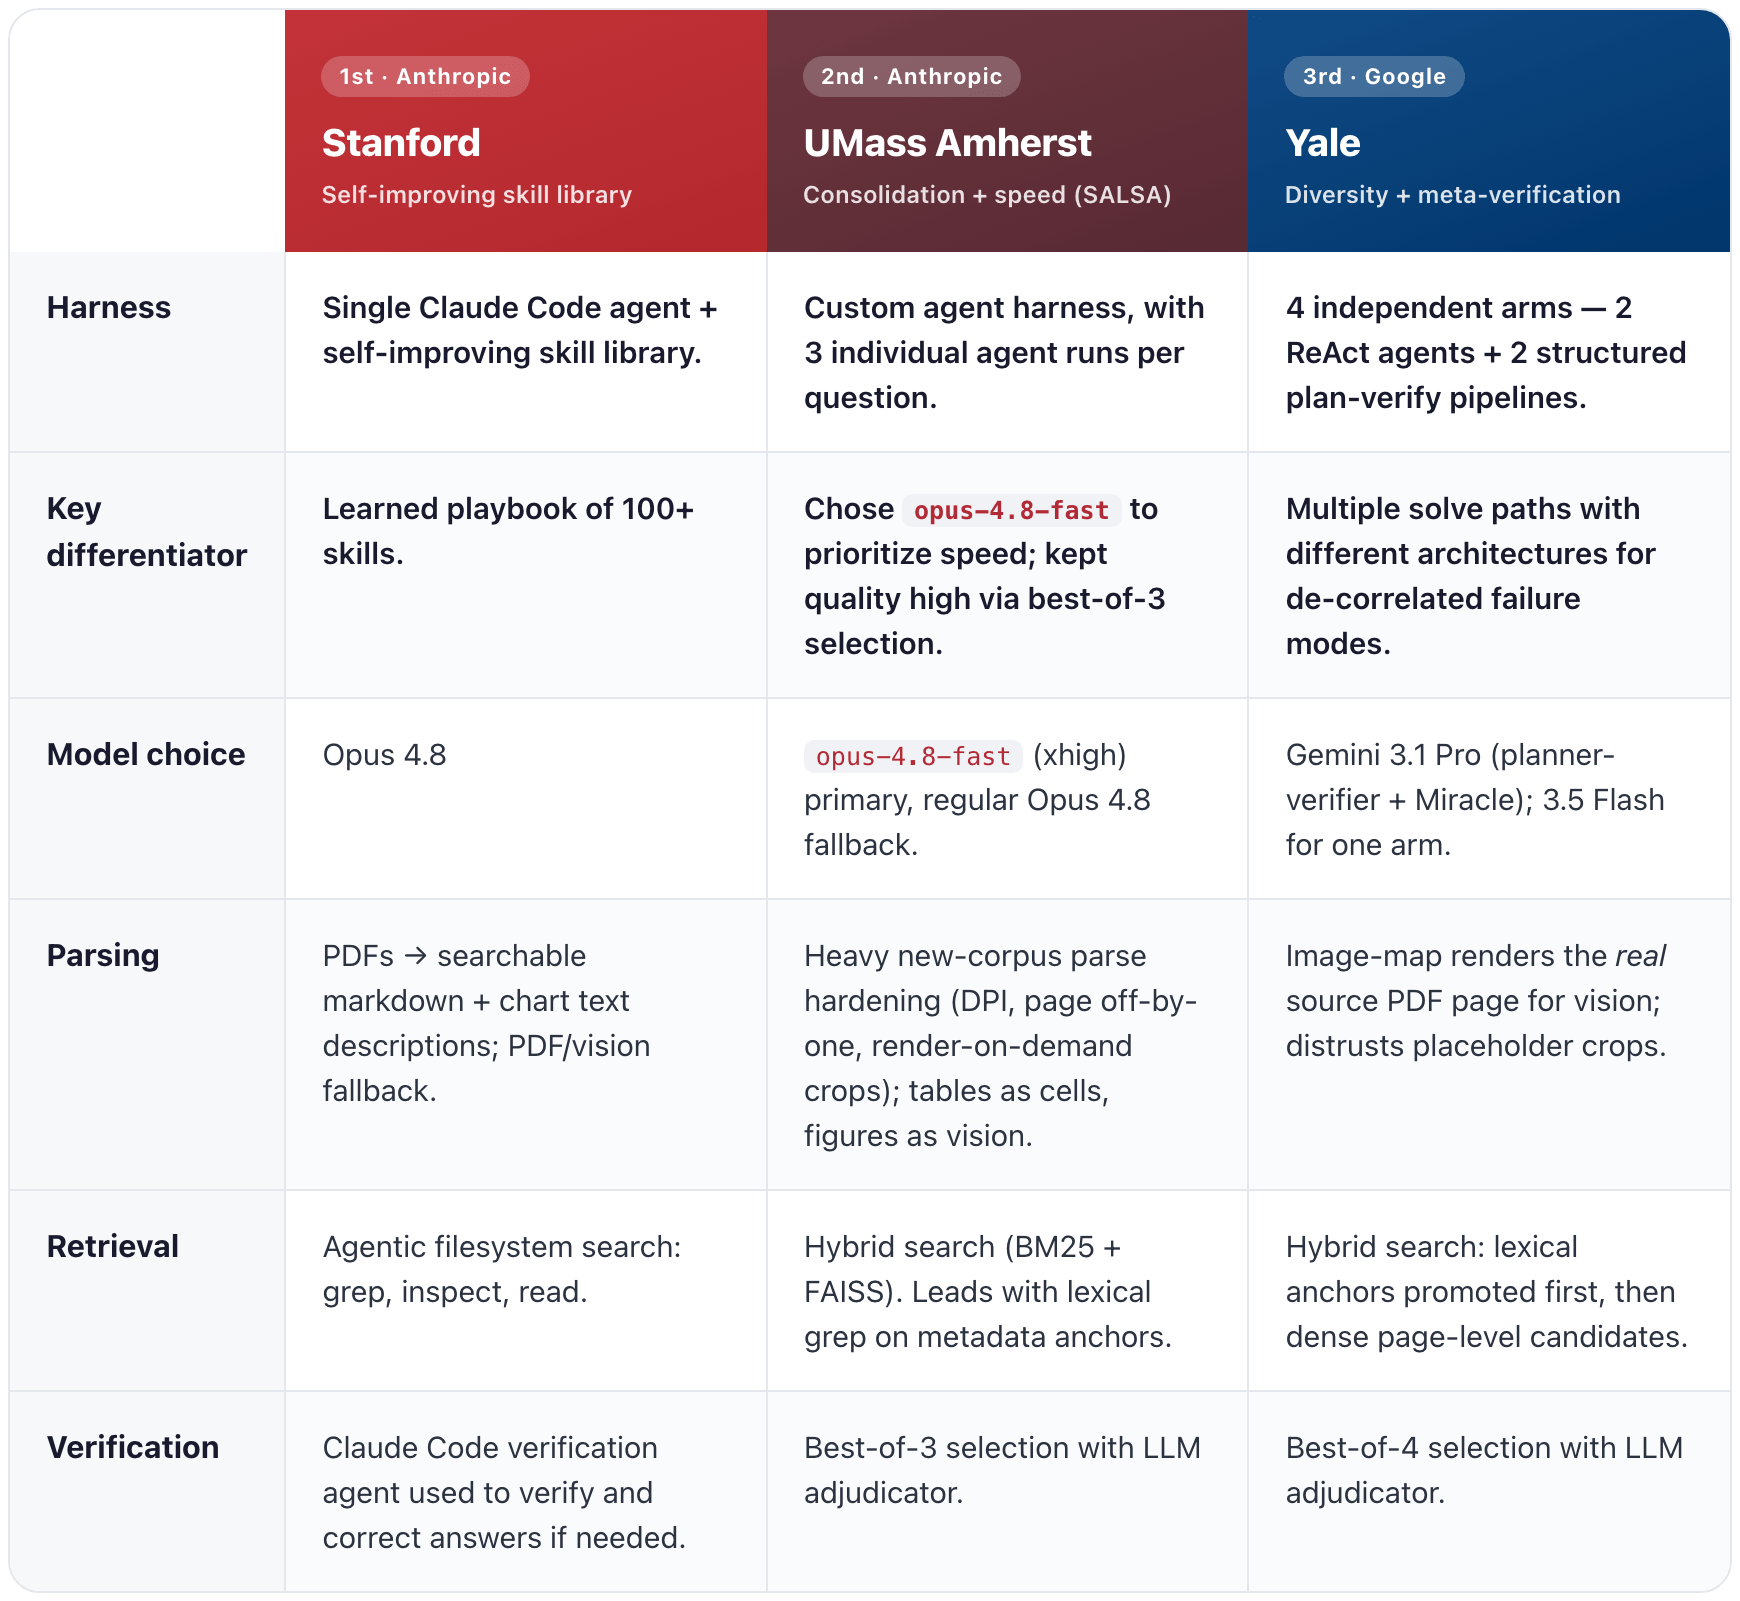
1위: 스탠포드 대학교 (Stanford University)
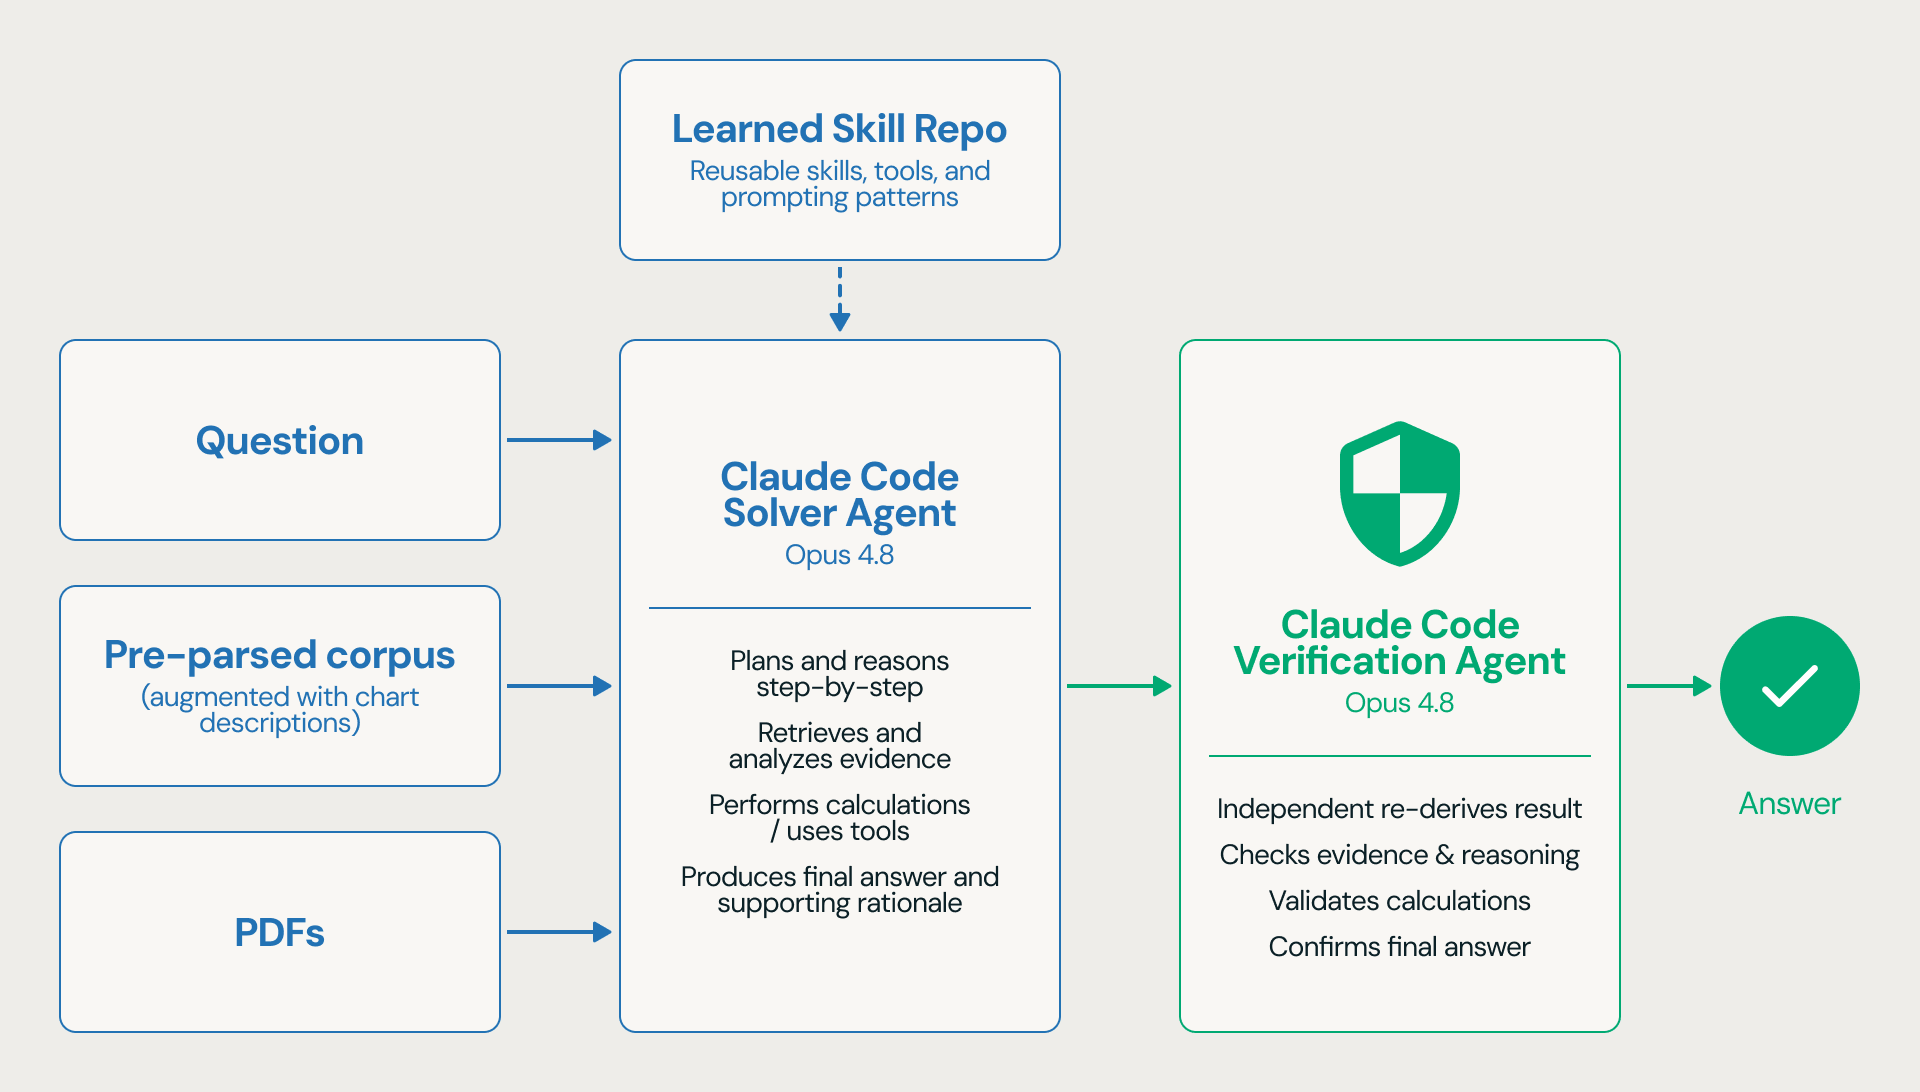
스탠포드 팀의 우승 비결은 흔히 발생하는 근거 기반 추론 실패 사례를 재사용 가능한 운영 절차로 변환하여, 자신들의 Claude Opus 4.8 Claude Code 에이전트가 이를 학습하고 대회 문제에 적용할 수 있도록 한 데 있었습니다. 공개된 OfficeQA 벤치마크를 활용한 개발 과정(Opus 4.8 및 사용 가능한 경우 Fable 5를 사용한 절제 실험 포함)에서, 팀은 오답의 원인을 에이전트의 정확한 실수 지점까지 반복적으로 추적했습니다. 그런 다음 이러한 패턴을 표 위치 파악(table localization), 답변 포맷팅, 흔히 쓰이는 금융 용어 명확화 등의 기술(skill)로 전환했습니다. 또한 파싱된 코퍼스 텍스트와 마크다운 스타일의 문서 표현 중 언제 검색할지, 그리고 파싱된 텍스트에 전체 컨텍스트가 부족할 때 언제 원본 PDF로 대체(fallback)할지 결정하는 기술도 통합했습니다. 대회 당일까지 스탠포드 팀은 약 100개 이상의 기술이 담긴 플레이북으로 에이전트를 무장시켰습니다. 이들은 시도한 88개 질문 중 57개에서 정답을 맞히며 정확도 면에서 모든 팀을 앞섰습니다.
이러한 철저한 준비에도 불구하고 Stanford는 대회 도중 전략을 조정해야 했습니다. 첫 세 라운드에서 팀은 다른 Claude Code 에이전트를 검증기(verifier)로 사용하여 중간 값을 다시 추출하고, 데이터 계보(data lineage)를 통해 수정된 값을 추적하고 단위 스케일링을 처리하는 등의 일반적인 실패 모드를 확인했으며, 불일치가 발견되면 계산을 수정(patch)했습니다. 하지만 해당 라운드에서 속도 보너스를 두 번밖에 받지 못하자, Stanford는 마지막 세 라운드에서 이 추가 검증 단계를 제거했습니다. 이 변화로 대기 시간(latency)이 크게 단축되어 팀이 14개 문제에서 속도 보너스를 획득하고 역전의 발판을 마련하는 데 도움이 되었습니다. 그럼에도 불구하고 검증기는 마지막 라운드에서 결정적인 역할을 했습니다. Stanford는 마지막 제출을 통해 답변을 수정하기 위해 검증기를 다시 켰고, 결국 최종 우승을 차지했습니다.
2위: UMass Amherst
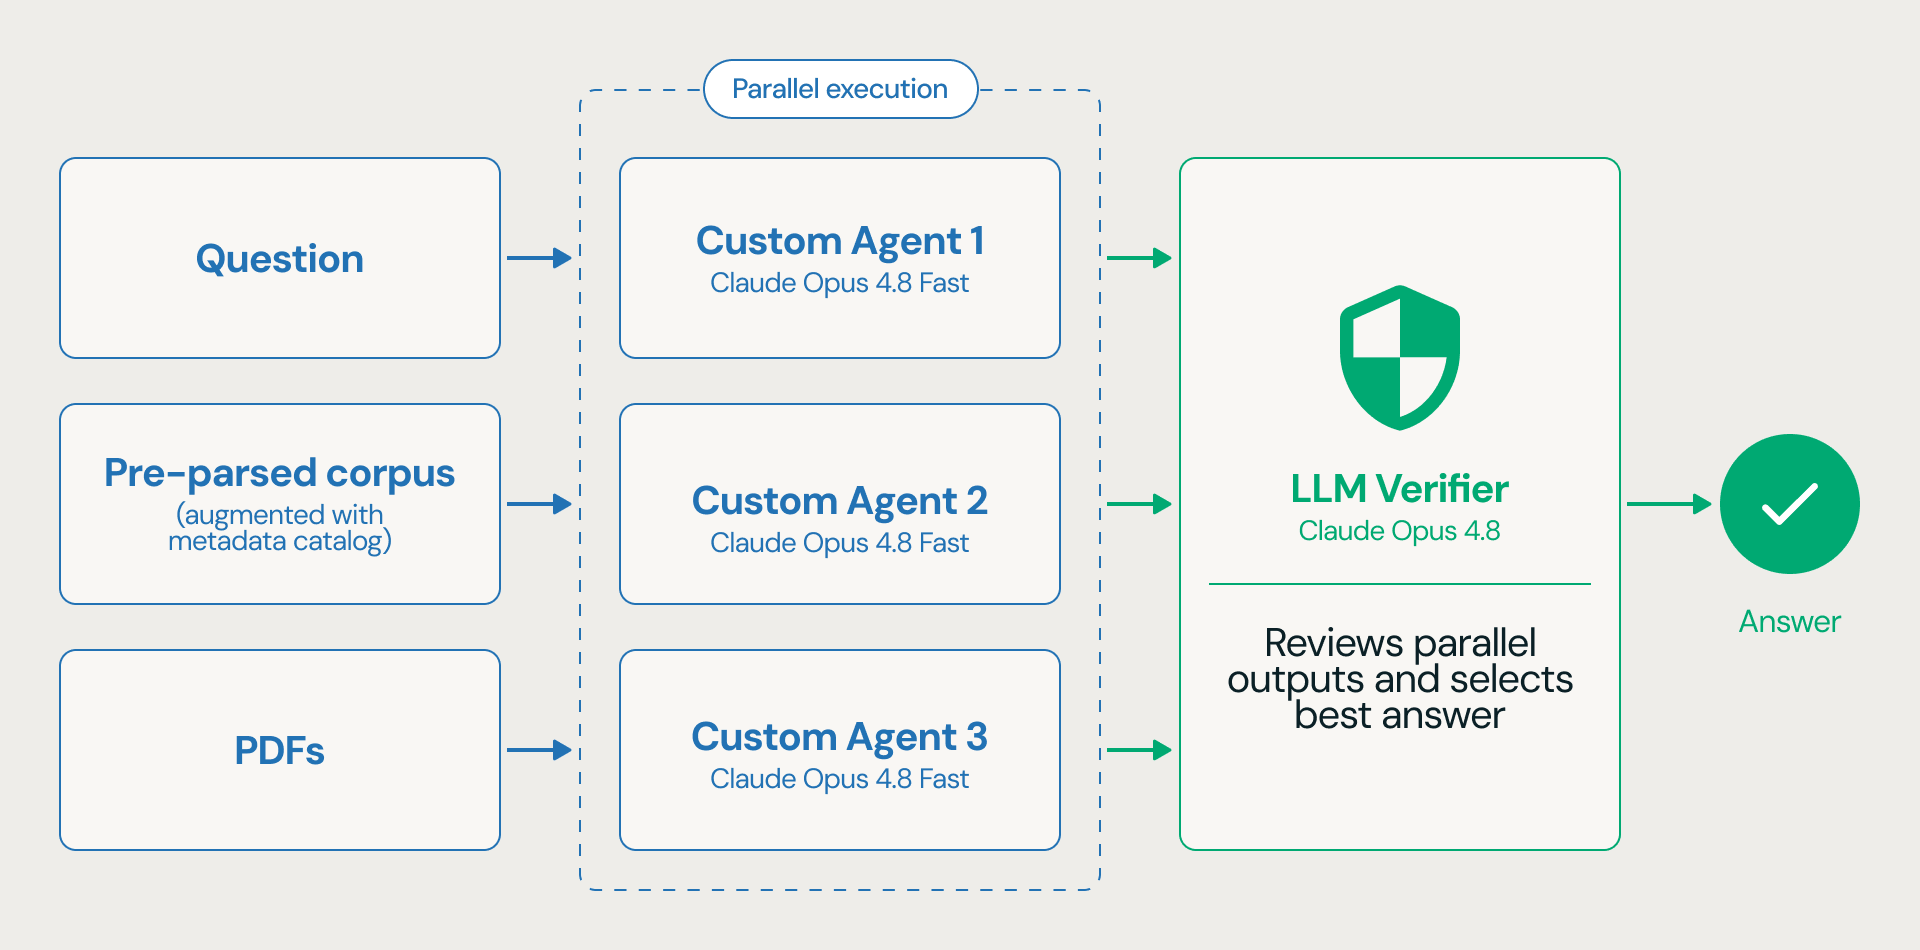
UMass 팀은 속도에 승부를 걸었습니다. 이들은 Claude Opus 4.8 Fast를 기본 모델로 사용하고 코퍼스(corpus)를 전처리하여 파싱된 문서에 대한 빠른 검색 및 필터링이 가능한 메타데이터 카탈로그를 생성했습니다. 낮은 대기 시간을 유지하면서 답변 품질을 높이기 위해 각 문제에 대해 세 개의 에이전트를 병렬로 실행한 후, 최종 Opus 검증 호출을 통해 최선의 답변을 선택했습니다.
이 전략 덕분에 UMass는 정답에 대한 평균 제출 시간이 4분으로 가장 빨랐으며, 이는 전체 팀 평균인 8분 30초의 절반도 되지 않는 시간이었습니다. 그 결과, 가장 먼저 정답을 맞힌 팀에게 주어지는 0.25점짜리 속도 보너스를 36회 획득했는데, 이는 2위인 Stanford의 16회보다 두 배 이상 많은 수치였습니다. 이 보너스 덕분에 UMass는 전반전까지 Stanford에 10.25점 차로 앞서 나갔고, 마지막 라운드에 진입할 때도 3.75점의 우위를 유지했습니다. UMass는 경기 종료 56초 전까지 이 리드를 지켰으나, 가장 까다로운 문제에서 Stanford의 더 느리지만 정확한 에이전트가 결정적인 역할을 하며 역전하여 결국 Stanford가 1.75점 차로 승리했습니다.
UMass의 접근 방식은 더 빠른 모델, 문서 전처리, 테스트 시간 스케일링(test-time scaling)이 어떻게 결합하여 정확도를 크게 희생하지 않으면서도 매우 낮은 대기 시간을 달성할 수 있는지 보여줍니다.
3위: Yale University
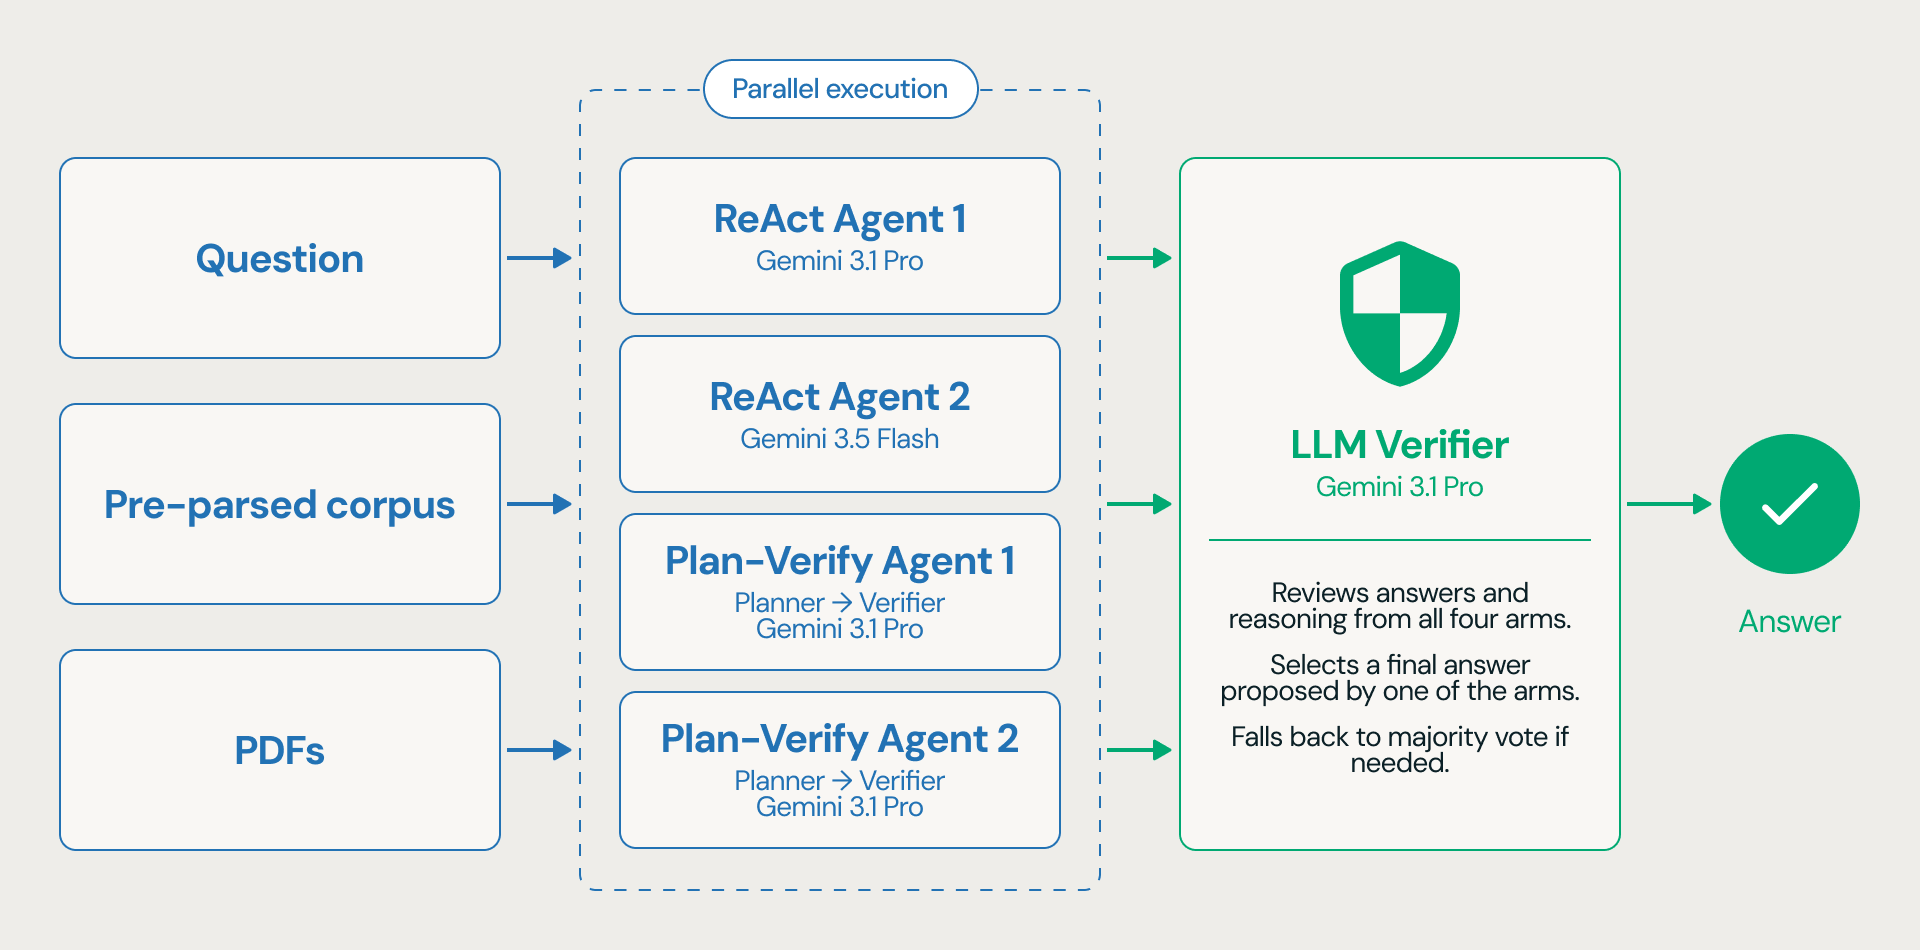
Yale 팀은 개별 에이전트가 실패하더라도 견고함(robustness)을 유지할 수 있도록 설계된 멀티 암(multi-arm) 검증 하네스를 구축했습니다. 이 시스템은 두 가지 에이전트 전략에 걸쳐 4개의 독립적인 암을 병렬로 실행했습니다. 두 개의 암은 자율 ReAct 에이전트를 사용했으며, 하나는 Gemini 3.1 Pro를, 다른 하나는 Gemini 3.5 Flash를 기반으로 작동했습니다. 나머지 암은 더 구조화된 플래너-검증기(planner-verifier) 파이프라인을 사용했으며, 모든 LLM 호출에 Gemini 3.1 Pro를 사용했습니다. 이 파이프라인에서 플래너는 원본 문서를 검사하고 맥락화하여 질문에 답하는 데 필요한 근거가 포함된 스크래치패드(scratchpad)를 구성했습니다. 그런 다음 검증기가 인용된 출처를 확인하고 최종 계산을 수행했습니다.
Gemini 3.1 Pro 메타 검증기가 네 개의 암 모두에서 생성된 답변과 추론을 검토하고 최종 응답을 선택했습니다. 근거가 없는 새로운 답변이 도입될 위험을 줄이기 위해, 메타 검증기는 기존 암 중 하나가 제안한 답변만 선택할 수 있었습니다. 그렇게 할 수 없는 경우 시스템은 다수결(majority vote) 방식으로 대체(fallback)했습니다. Yale은 독립적이고 부분적으로 상관관계가 해제된 실패 모드를 가진 고유한 에이전트 아키텍처들을 결합함으로써 일관되고 근거 있는(grounded) 검증을 강조했습니다. 이 접근 방식을 통해 Yale 팀은 90개 문제 중 49개를 맞추며 3위를 차지했고, 대회 6개 라운드 중 4개 라운드에서 정확도 상위 3위 안에 올랐습니다.
우승 팀 전략 요약
이러한 우승 접근 방식의 핵심 시사점 중 하나는 엔드투엔드(end-to-end) 근거 기반 추론(grounded reasoning) 작업에 에이전트를 성공적으로 적용하려면 모델 선택뿐만 아니라 전체적인 시스템 사고가 필요하다는 점입니다. 우승 팀들의 접근 방식 전반에 걸쳐 몇 가지 핵심 설계 레버가 특히 중요한 것으로 나타났습니다.
- 파싱 품질: 상위 팀들은 미리 파싱된 문서를 사용했으며, 추가 메타데이터(예: 차트 설명 또는 페이지 수준 메타데이터)를 포함하도록 이러한 파싱된 표현을 확장하는 경우가 많았습니다. 또한 파싱된 텍스트가 불완전할 때 대체할 수 있도록 원본 PDF로 돌아가는 경로를 보존했습니다. OfficeQA Pro V2에 대한 자체 연구에서,
ai_parse로 문서를 사전 파싱하는 것이 기본 프론티어 에이전트 대비 Genie의 성능을 24.0포인트 향상시키는 데 크게 기여한다는 것을 확인했습니다. - 검색(Retrieval) 품질: 우수한 성능의 시스템은 일반적인 top-k 청크 검색에만 의존하지 않았습니다. 대신 하이브리드 접근 방식을 위해 밀집 검색(dense retrieval)과 결합된 형태의 어휘 검색(lexical retrieval, 예: grep)을 사용했습니다.
- 도구 사용: 성공적인 에이전트들은 일반적으로 검색, 문서 검사, 계산, 비교 및 제출 작업을 특화된 도구에 위임했습니다.
- 검증 전략: 여러 팀이 답변 품질을 높이기 위해 검증 에이전트 또는 LLM 호출을 통한 명시적인 검증 확인 단계를 구축했습니다.
- 견고한 하네스(Harness): 실시간 마감 압박 속에서 정답이 제시간에 실제로 제출되도록 하려면 전처리, 재시도 로직, 병렬 처리, 제출 스캐폴딩(scaffolding)과 같은 운영상의 세부 사항이 필수적이었습니다.
이러한 요소들은 모델이 마감 압박 속에서 올바른 근거를 안정적으로 찾고, 올바른 계산을 수행하며, 올바른 답변을 제출할 수 있는지 여부를 결정했습니다.
영향 및 향후 계획
요약하자면, Grounded Reasoning Cup의 결과는 다음과 같은 광범위한 교훈을 보여줍니다.
- 일반화(Generalization)는 가정하는 것이 아니라 테스트해야 합니다. OfficeQA에서의 개선 사항이 OfficeQA Pro V2로 항상 이어지지는 않았으며, 프론티어 에이전트들은 여전히 평균적으로 문제의 절반 미만을 맞췄습니다. 익숙한 벤치마크에서의 발전이 반드시 새로운 코퍼스나 작업 분포로 이어지는 것은 아닙니다.
- 대표성 있는 홀드아웃(held-out) 평가가 중요합니다. 이러한 평가는 중요한 일반화 형태를 평가해야 하며, 이상적으로는 작업의 핵심 특성(즉, 문서에 대한 근거 기반 추론)을 고정된 상태로 유지하면서 코퍼스와 같이 변경될 수 있는 작업 요소를 다양화해야 합니다. OfficeQA Pro V2를 설명하는 게시물에서 당사는 고객 워크플로에 대한 지식과 합성 데이터를 결합하여 이러한 대표성 있는 평가를 신속하게 확장하는 방법에 대해 논의합니다.
- 에이전트 성능은 전체 시스템에 달려 있습니다. 성능은 모델뿐만 아니라 파싱, 검색, 도구 사용, 검증, 기본 데이터 및 인프라의 품질에 따라 달라집니다. 우승 팀들은 이러한 구성 요소를 종합적으로 최적화했습니다. 마찬가지로,
ai_parse와 같은 도구를 사용하여 문서를 사전 파싱하고 추가적인 하네스 최적화 전략을 사용할 때 Genie는 기본 프론티어 에이전트보다 훨씬 뛰어난 성능을 발휘합니다.
Databricks의 첫 번째 Grounded Reasoning Cup에 참여하여 이 분야를 발전시키는 데 기여해 주신 OpenAI, Google DeepMind, Anthropic을 비롯한 모든 팀과 업계 후원사들에 감사드립니다. 또한 새로운 코퍼스를 식별하고 OfficeQA Pro V2에 적합한 문제를 만드는 데 도움을 준 것부터 대회 자체를 함께 진행한 것까지 지속적인 파트너십을 보여준 USAFacts에도 감사드립니다. 마지막으로, 대회 벤치마크의 기초가 되는 미국 수입 및 지출 계정(U.S. Accounts of Receipts and Expenditures)을 식별하는 데 도움을 주고 이 데이터 세트를 최초로 응집력 있는 컬렉션으로 공개해 준 미국 재무부(U.S. Treasury)에 감사드립니다.
저자: Krista Opsahl-Ong, Arnav Singhvi, Josh Joseph, Jasmine Collins, Ivan Zhou, Brooke Wenig, Denny Lee, Michael Bendersky, Erich Elsen, Xing Chen, Matei Zaharia
(이 글은 AI의 도움을 받아 번역되었습니다. 원문이 궁금하시다면 여기를 클릭해 주세요)
데이터 사이언스 및 ML, 기술, 인사이트 , 이벤트
최신 게시물을 이메일로 받아보세요
블로그를 구독하고 최신 게시물을 이메일로 받아보세요.