Databricks에서 dbt를 최대한 활용하는 방법
Databricks에서 dbt 파이프라인을 더 저렴하고 빠르고 단순하게 운영하세요.
작성자: Srilekha Dornadula , Luís Cabral
- 별도의 도구를 이어 붙일 필요 없이 스트리밍 수집부터 거버넌스가 적용된 메트릭 정의까지 전체 파이프라인을 Databricks의 단일 dbt 프로젝트에서 유지하세요.
- 외부 오케스트레이터 없이 Lakeflow Jobs에서 dbt를 네이티브로 오케스트레이션하세요.
- dbt 프로젝트 자체에서 거버넌스를 정의하여 프로젝트 설정에서 바로 Unity Catalog를 통해 액세스 규칙이 적용되도록 하세요.
수만 개의 조직이 데이터 변환을 위해 dbt에 의존하고 있습니다. 어디에서 실행하느냐에 따라 dbt 파이프라인의 실행 비용, 제공 속도, 운영 작업의 양 등 모든 것이 달라집니다. Databricks에서 dbt를 실행하면 dbt 워크로드에 개방형 플랫폼과 통합 파이프라인을 제공할 수 있습니다.
3,000개 이상의 조직이 Databricks에서 dbt를 실행하고 있으며, 대부분의 팀은 훨씬 더 큰 효과를 얻을 수 있습니다. 이 블로그에서는 Databricks에서 dbt 파이프라인을 더 저렴하고, 더 빠르게, 더 간단하게 운영할 수 있는 모범 사례를 소개합니다.
dbt 파이프라인을 더 저렴하고 빠르게 만들기
dbt 비용은 반복할 필요가 없는 작업 때문에 증가합니다. 전체 재구축은 변경되지 않은 데이터를 다시 계산하고, 쿼리 속도를 빠르게 유지하려면 수동 튜닝이 필요하며, 비용이 급증할 때 이를 유발한 dbt 모델 추적이 명확하지 않습니다. 이 섹션의 모범 사례를 도입하면 파이프라인을 다음과 같이 개선할 수 있습니다.
- 실제로 변경된 데이터만 재구축
- 파티션 키를 직접 선택하거나 수정하지 않고도 빠른 속도 유지
- post-hook 없이 테이블 유지 관리를 자동으로 실행
- 모든 지출 비용을 특정 모델까지 추적
1. 증분 전략으로 변경된 사항만 구축
전체 테이블 재구축은 대부분의 dbt 프로젝트에서 가장 크게 줄일 수 있는 비용 요소입니다. 실행 간에 데이터의 극히 일부만 변경될 때 전체 테이블을 다시 계산하는 것은 컴퓨팅 자원을 낭비하고 비용을 증가시킵니다. dbt의 증분(incremental) 전략은 dbt-databricks에서 모두 지원되며, 각 모델이 새로운 데이터만 처리하도록 합니다. 적절한 전략은 데이터의 실제 도착 방식에 따라 달라집니다.
전략 | 사용 케이스 |
|---|---|
append | 행이 삽입만 되고 업데이트되지 않는 경우 |
merge | 동일한 키가 두 번 이상 도착할 수 있어 업서트(upsert)가 필요한 경우(서서히 변화하는 차원, 중복 제거, 지연 도착 업데이트) |
replace_where | 모델이 실행될 때마다 지난 며칠간의 활동과 같이 좁은 시간 창을 다시 도출하는 경우 |
insert_overwrite | 쿼리가 전체 파티션을 반환하는 경우 |
delete+insert | 열 수준 업데이트 로직 없이 키 기준으로 레코드를 교체하려는 경우 |
microbatch | event_time 열이 있고 체계적인 백필(backfill)이 필요한 시계열 데이터의 경우 |
대부분의 프로젝트는 더 구체적인 전략으로 충분함에도 기본값으로 merge를 사용합니다. 서술어(predicate)로 변경된 데이터를 설명할 수 있다면, replace_where는 일치하는 항목을 찾기 위해 대상을 스캔해야 하는 merge보다 적은 작업을 수행합니다. 그렇지 못한 경우, merge에 대한 incremental_predicates를 통해 스캔 범위를 대폭 줄일 수 있습니다.
위의 모든 전략은 직접 결정하고 유지 관리해야 하는 사항입니다. 다음 모범 사례를 적용하면 플랫폼이 이를 알아서 처리하도록 맡길 수 있습니다.
2. 구체화된 뷰(Materialized view)로 증분 처리 자동화
구체화된 뷰(Materialized View)는 증분 처리를 자동화합니다. 일반 SQL로 모델을 정의하면 Databricks가 변경된 기본 데이터를 추적하여 영향받는 결과만 새로 고칩니다. dbt-databricks에서 구체화된 뷰는 네이티브 구체화 방식이므로 설정 한 줄만 변경하면 됩니다:
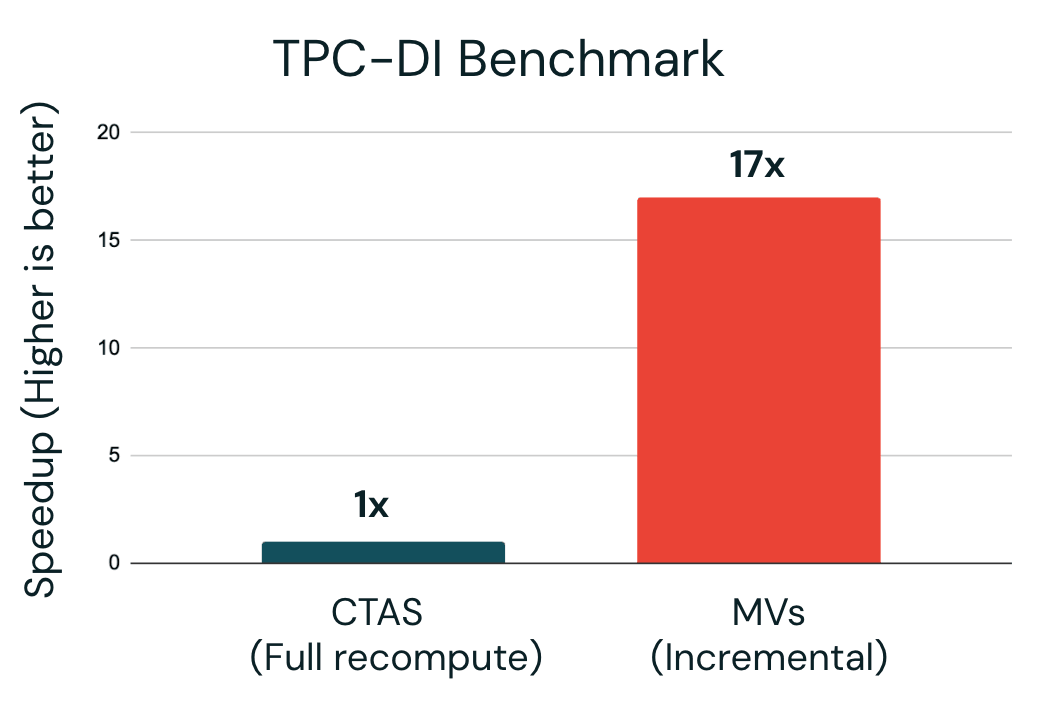
구체화된 뷰는 서빙 레이어에 가장 잘 어울립니다. 자주 변경되는 소스에 대한 집계, 특히 대시보드를 지원하고 최신 상태를 유지해야 하는 비싼 연산에 적합합니다. TPC-DI 벤치마크 테스트에서 서빙 레이어의 전체 재계산을 구체화된 뷰로 전환했을 때 17배의 속도 향상을 기록했습니다.
3. 성능 튜닝을 위한 데이터 레이아웃 자동화
파티션 키 선택, 쿼리 패턴 변경 시 파티션 키 수정, post-hook에서 OPTIMIZE, VACUUM, ANALYZE 스케줄링 모두 많은 엔지니어링 시간이 소요됩니다.
예측 최적화(Predictive Optimization)는 각 테이블의 쿼리 방식을 기반으로 실행 항목과 시점을 선택하여 관리형 테이블에서 OPTIMIZE, VACUUM 및 통계 수집을 자동으로 실행합니다. 카탈로그나 스키마 수준에서 한 번 설정해 두면 테이블 유지 관리를 위해 dbt 프로젝트에 쌓이던 post-hook을 제거할 수 있습니다.
데이터 레이아웃의 경우, Liquid Clustering이 파티션 설계를 자율 튜닝 레이아웃으로 대체합니다. 테이블의 실제 쿼리 방식을 바탕으로 데이터를 구성하고, 과도한 파티셔닝으로 발생하는 작은 파일 급증 문제를 방지하며, 쿼리 패턴 변화에 맞게 적응합니다. 또는 예측 최적화로 작동하는 자동 Liquid Clustering(CLUSTER BY AUTO)을 통해 Databricks가 쿼리 기록에서 이를 선택하고 조정하도록 할 수 있습니다. 프로젝트 수준 설정 하나로 프로젝트가 구축하는 모든 새 테이블을 클러스터링할 수 있습니다.
두 기능 모두 한 번의 설정만으로 작동하도록 설계되었습니다. 자동 업그레이드를 사용하면 Unity Catalog 관리형 테이블이 Databricks에서 새로 출시하는 최적화 기능을 지속적으로 적용받을 수 있습니다.
4. 쿼리 태그로 모든 지출 비용 추적
분기 말이 되면 재무팀에서 웨어하우스 비용이 왜 증가했는지 묻곤 합니다. 대부분의 환경에서는 사용량 데이터의 쿼리가 이를 실행한 dbt 모델과 연결되어 있지 않기 때문에 아무도 대답할 수 없습니다.
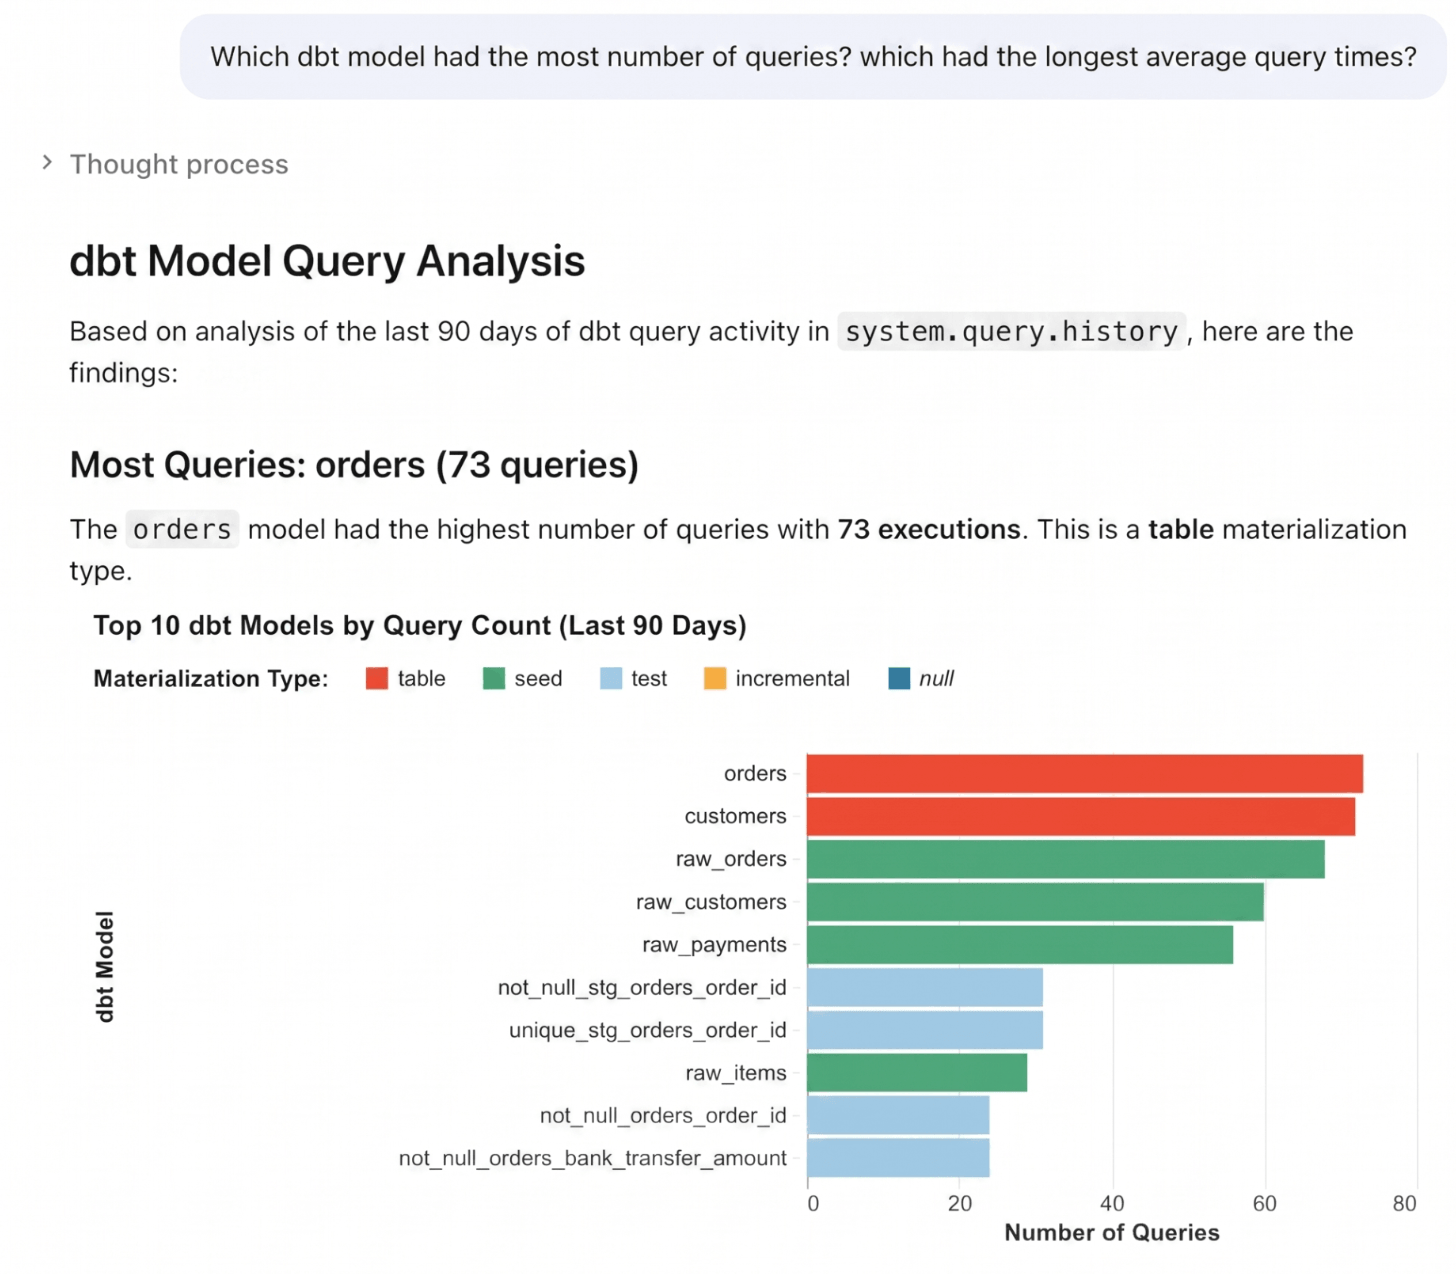
쿼리 태그를 사용하면 이 연결이 자동으로 수행됩니다. dbt가 Databricks에서 실행하는 모든 쿼리에는 모델 이름, dbt 버전, 구체화 유형이 자동으로 함께 기록됩니다. 조직에서 예산을 편성하는 차원에 맞게 커스텀 태그를 추가해 보세요:
태그는 system.query.history에 표시되며, system.billing.usage와 조인하면 서버리스 웨어하우스 비용을 태그가 지원하는 모든 그룹별(모델별, 팀별, 도메인별, 구체화별 비용)로 할당할 수 있습니다. 어떤 모델이 가장 많은 비용을 차지하는지 정확히 확인할 수 있습니다.
dbt 파이프라인 단순화하기
일반적인 dbt 설정은 다양한 다른 툴의 스택에 의존합니다. 데이터를 수집하는 별도의 시스템, 프로젝트를 실행하는 외부 오케스트레이터, 동일한 메트릭을 제각각 재정의하는 BI 툴, dbt 프로젝트 외부에 존재하는 거버넌스 등입니다. 이것들은 각각 추가적인 관리 부담이 되며, 데이터 불일치가 발생할 수 있는 원인이 됩니다. 이 섹션의 지침을 적용하면 단 하나의 dbt 프로젝트로 다음 작업을 수행할 수 있습니다:
- 프로젝트로 직접 데이터 수집
- 유지 관리할 서드파티 오케스트레이터 없이 Databricks에서 직접 실행 및 배포
- 모든 툴에 하나의 거버넌스 적용된 메트릭 정의 제공
- dbt 모델과 함께 버전을 관리하며 자체 거버넌스 규칙 적용
1. Streaming Tables로 dbt 프로젝트 내 수집 통합
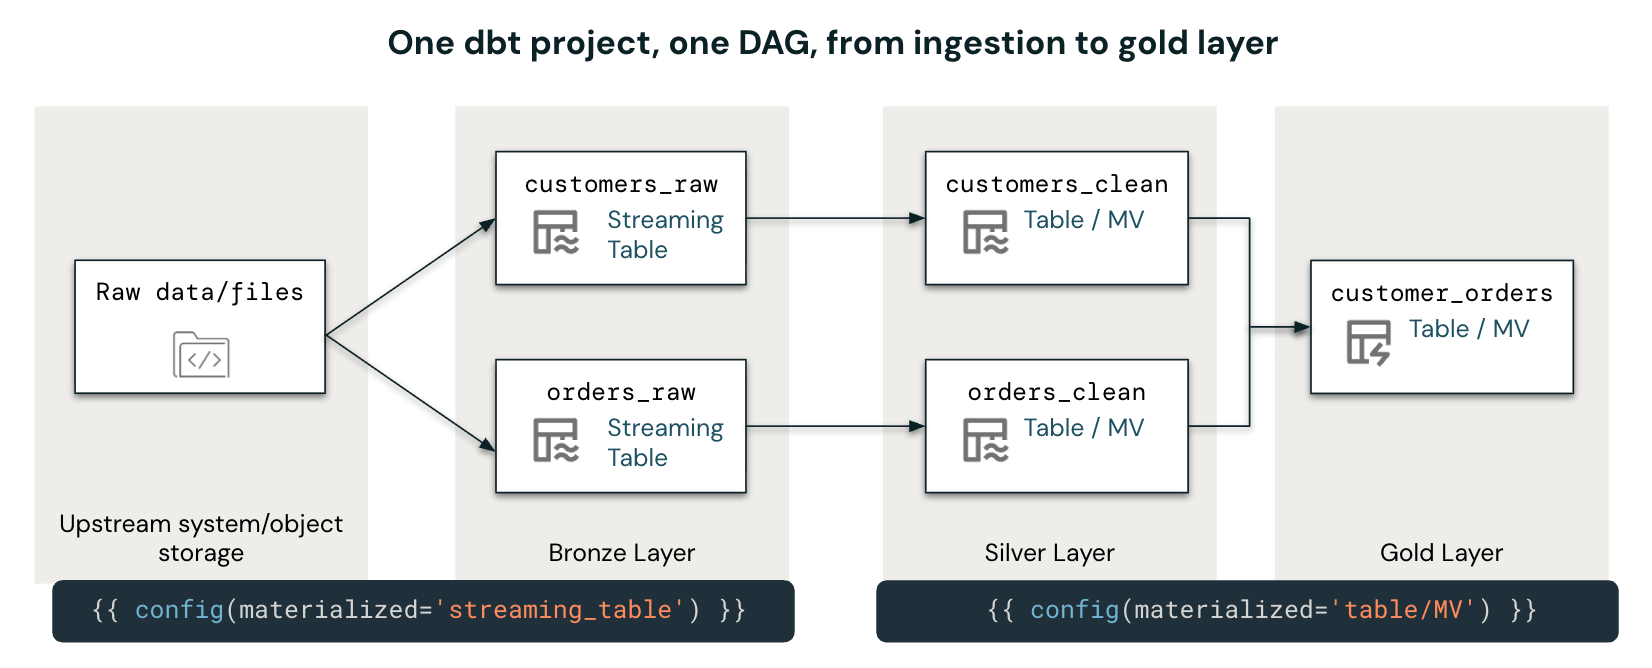
데이터 수집은 전통적으로 dbt 외부에 존재하는 파이프라인 영역이었기 때문에, 전체 계보(lineage)를 한눈에 파악할 수 없는 분리된 아키텍처가 만들어졌습니다. streaming_table materialization은 이러한 분리를 해결합니다. 스트리밍 테이블로 구체화된 dbt 모델은 새 파일이나 이벤트가 도착하는 즉시 증분 방식으로 가져오므로 수집 단계가 DAG 내의 또 다른 모델이 됩니다.
여기에서 파이프라인의 나머지 부분(실버 및 골드 모델)은 ref()을(를) 사용해 스트리밍 테이블을 참조할 수 있고, 테스트 및 문서화가 모든 레이어에 적용되며, 계보는 원시 파일부터 최종 마트까지의 전체 경로를 포괄합니다.
2. Unity Catalog Semantics로 메트릭 표준화
모든 BI 툴, 에이전트 또는 기타 데이터 소비자는 자체적인 메트릭 정의를 작성하므로 이해관계자 간의 혼란과 불일치가 발생합니다. metric view를 사용하면 정의를 단일 거버넌스 위치로 이동할 수 있습니다. 즉, 측정값과 차원을 한 번만 선언하면 모든 소비자가 동일한 로직을 쿼리하게 됩니다.
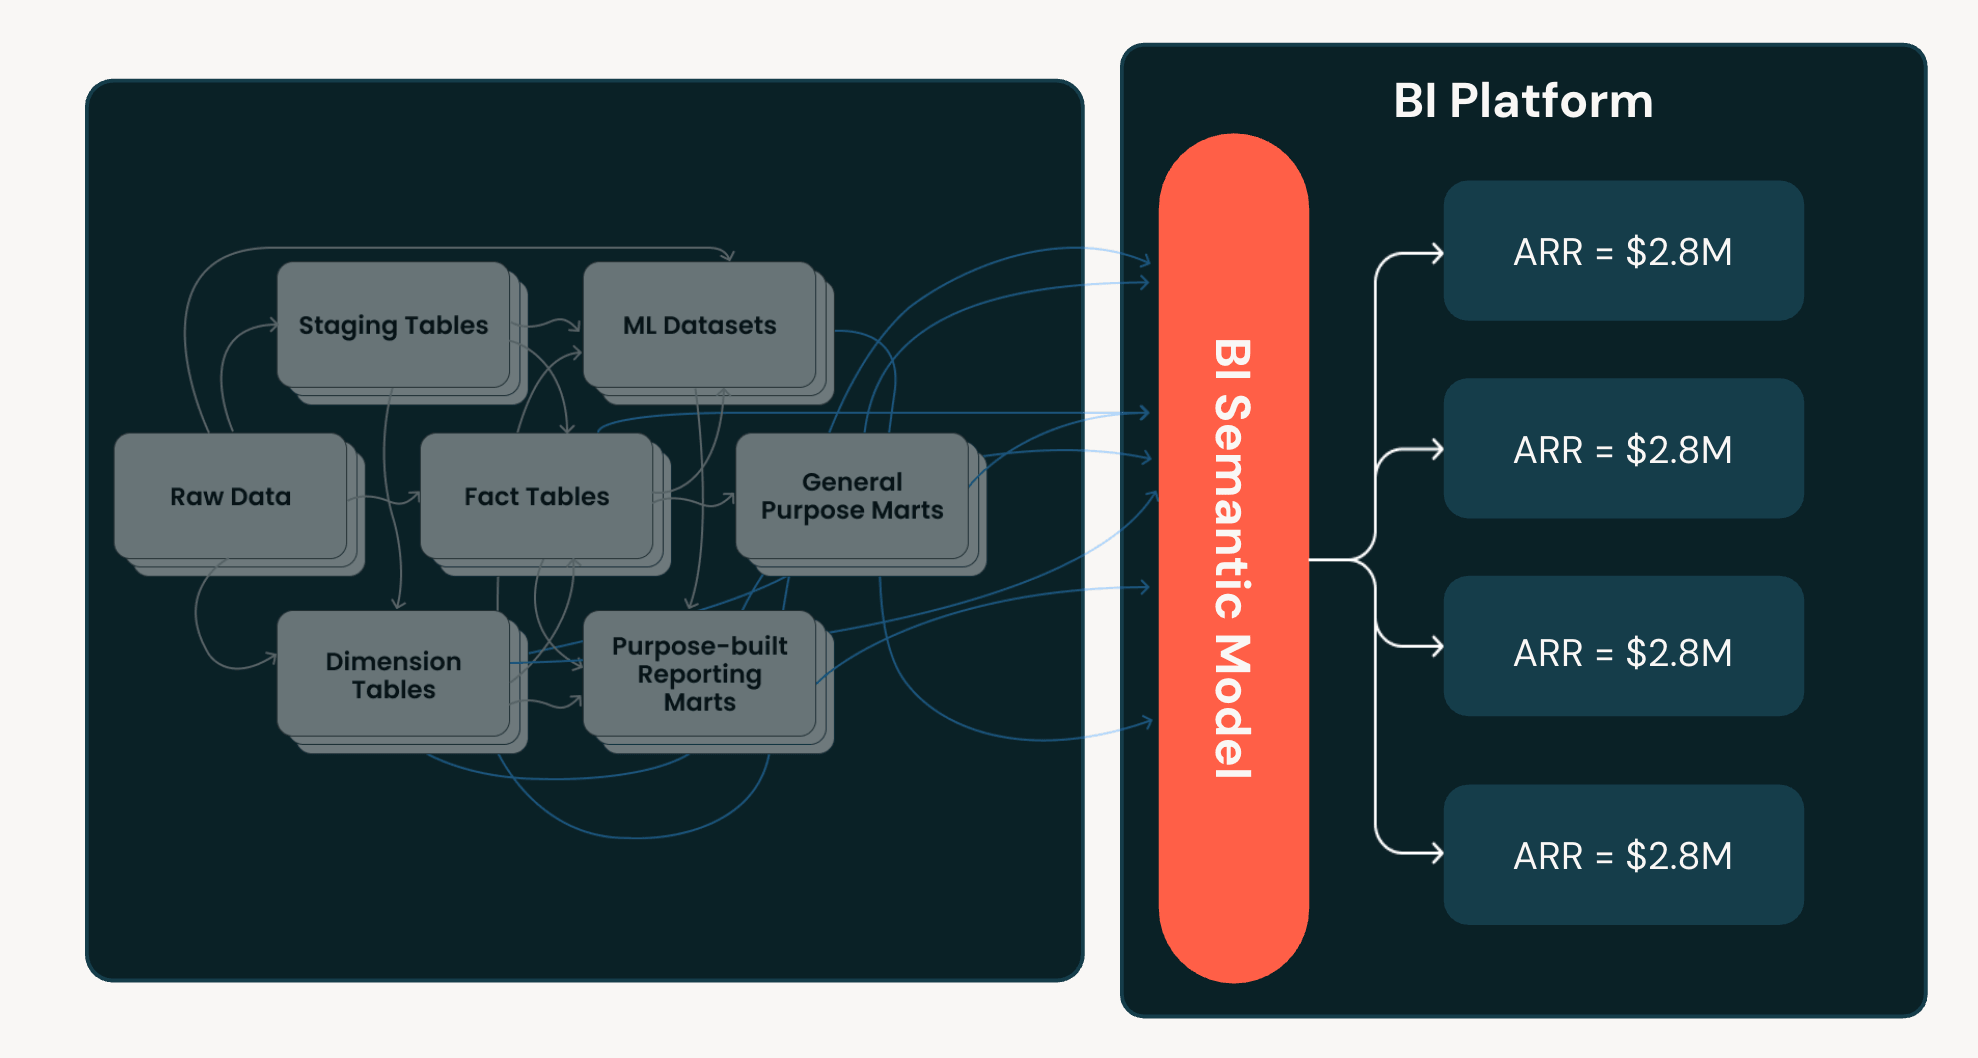
dbt-databricks는 metric views를 기본 구체화 유형으로 제공하므로 다른 모델과 마찬가지로 dbt 프로젝트 내에서 정의를 관리, 버전 관리 및 검토할 수 있습니다.
사용자는 쿼리 시점에 MEASURE() 함수를 사용해 원하는 그룹화를 선택할 수 있으므로 동일한 정의가 SQL 에디터, BI 대시보드, 노트북 및 Genie에 모두 제공됩니다.
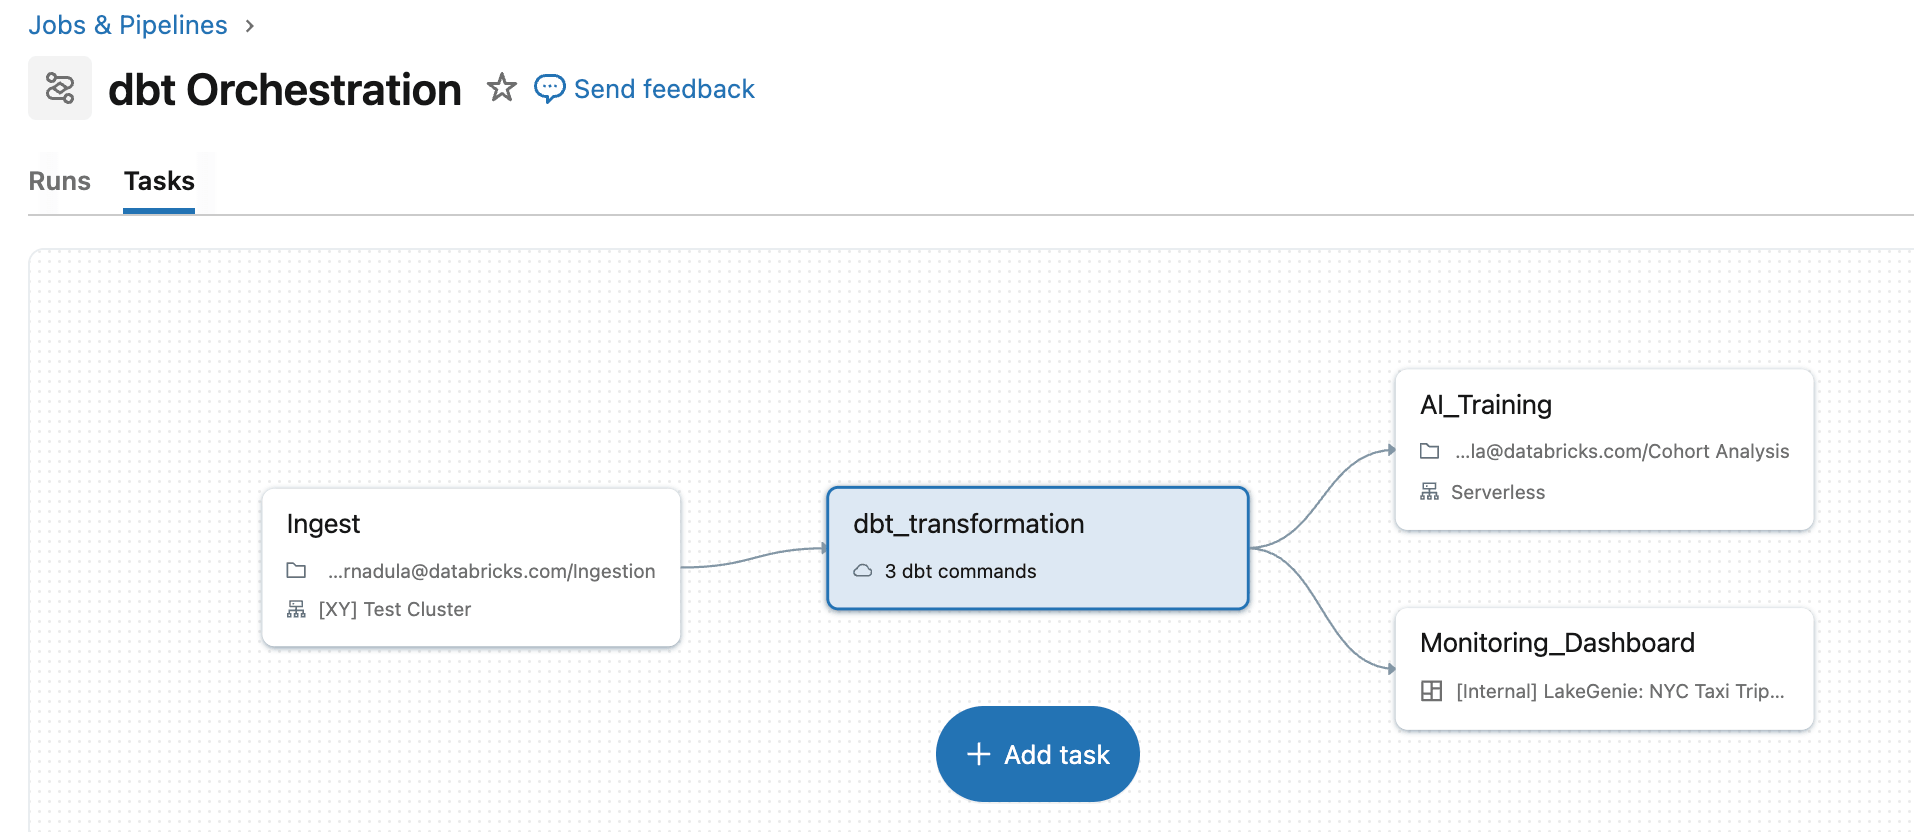
3. Lakeflow Jobs를 통해 기본적으로 dbt 오케스트레이션
dbt 실행만으로는 전체 파이프라인인 경우가 드뭅니다. 업스트림 및 다운스트림 단계가 서로 다른 툴에 존재하는 경우 관리, 비용 부담, 보안 적용을 위한 추가 툴이 늘어나고 계보가 파편화되어 오버헤드가 누적됩니다.
Lakeflow Jobs는 기본 태스크로 dbt를 지원하여 이를 단일 DAG(비순환 방향 그래프)로 통합합니다. 수집 태스크가 dbt 태스크에 데이터를 제공하고 완료 시 다운스트림 태스크가 트리거되며, 종속성은 플랫폼에 의해 적용됩니다. 예약, 자동 재시도, 실행 기록, 알림 기능이 내장된 운영 레이어가 제공되므로 유지 관리할 추가 인프라가 필요하지 않습니다. Jobs는 dbt Core 및 dbt Platform을 지원하며, dbt Core v2.0 지원도 곧 제공될 예정입니다.
4. Declarative Automation Bundles로 코드 형태 배포
UI에서 수동으로 구성한 작업은 버전 관리, 검토 또는 재현이 어렵습니다. Declarative Automation Bundles(DABs)는 작업 정의를 코드 리포지토리의 일부로 만들어 이 문제를 해결합니다. Lakeflow Job, 일정, 컴퓨팅 설정, dbt 프로젝트가 모두 YAML로 선언되어 하나의 패키지로 배포됩니다.
--target dev(으)로 배포하면 전체 파이프라인의 격리된 사본이 생성되고, --target prod은(는) 이를 프로모션합니다.
프로젝트 내의 모든 모델을 모든 일정에 따라 실행할 필요는 없습니다. dbt YAML에서 주기(cadence)별로 모델에 태그를 지정하고, 각 주기마다 해당 태그가 지정된 모델만 빌드하는 자체 작업을 부여하세요. 모델을 일별에서 시간별로 이동하는 작업이 한 줄 수정으로 해결됩니다:
5. 프로젝트 내 거버넌스 정의
거버넌스는 일반적으로 데이터를 빌드하는 dbt 프로젝트와는 별도로 모델이 실행된 후에 구성됩니다. 거버넌스가 dbt 프로젝트 외부에 위치하므로 dbt 실행과 동기화가 맞지 않을 수 있습니다.
모델이 이미 포함되어 있는 dbt 프로젝트 내에서 거버넌스를 정의하세요. 프로젝트 구성 형태로 코드와 함께 제공되고 코드처럼 검토되며 Unity Catalog가 모든 쿼리에 대해 이를 적용합니다.
태그, 권한(grants), 행 및 열 수준 보호는 모두 dbt_project.yml의 프로젝트 전반 구성을 통해 정의할 수 있습니다. databricks_tags는 분류 및 정책을 구동하고, grants는 테이블을 읽을 수 있는 사람을 제어하며, row_filters 및 column_masks는 각 사용자가 볼 수 있는 항목을 제어합니다:
대규모 환경에서는 속성 기반 액세스 제어(ABAC)를 통해 반복 작업을 줄일 수 있습니다. 거버넌스 태그에 하나의 정책을 정의하면 해당 태그가 지정된 모든 테이블에 적절한 행 필터와 열 마스크가 적용되므로, pii 태그가 지정된 새 모델은 빌드되는 즉시 적용됩니다. 멀티테넌트 격리와 같이 로직이 특정 모델에만 국한되는 경우에만 모델별 필터 및 마스크를 사용하세요.
이러한 사례들의 공통적인 핵심은 증분 처리, 데이터 레이아웃, 테이블 유지 관리, 거버넌스 적용, 오케스트레이션과 같은 운영 작업을 플랫폼에 맡기는 것입니다. dbt 프로젝트에 남는 것은 버전 관리되고 테스트를 거친 변환 로직입니다. 현재 프로젝트에서 겪고 있는 문제점을 해결하는 모범 사례를 선택하여 시작해 보세요.
이미 Databricks에서 dbt를 실행 중인 3,000개 이상의 조직과 함께하세요. dbt-databricks 어댑터로 시작해 보세요.
(이 글은 AI의 도움을 받아 번역되었습니다. 원문이 궁금하시다면 여기를 클릭해 주세요)
최신 게시물을 이메일로 받아보세요
블로그를 구독하고 최신 게시물을 이메일로 받아보세요.