대규모 AI 코딩 비용 관리
작성자: Patrick Wendell, Akshat Bhatia, Vinay Gaba, 에릭 엘센 , Ivan Zhou
AI 코딩 도구는 엄청난 가치를 제공합니다. Databricks에서는 에이전트 기반 코딩(agentic coding)을 통해 추적하는 모든 속도 지표가 눈에 띄게 향상되었으며, 일부 팀에서는 생산성이 몇 배나 증가했습니다. 하지만 AI 도구를 대규모로 도입하는 거의 모든 기업이 동일한 장벽에 부딪혔습니다. 바로 기하급수적으로 증가하는 비용입니다. 이러한 비용 상승 곡선은 지속 불가능하며, 방치할 경우 결국 매출을 넘어서게 될 것입니다. 이러한 지출 폭발로 인해 기업들은 모순적인 상황에 직면해 있습니다. 한편으로는 AI 전환을 최대한 추진하고 직원들에게 강력한 도구를 제공하기를 원하면서도, 다른 한편으로는 AI가 제공하는 효율성 향상 효과를 약화시키거나 심지어 역전시킬 위험이 있는 총비용 프로필을 감당해야 하는 상황입니다.
다행히도 초기에 대규모로 도입한 몇몇 기업들은 이 문제를 해결하는 일련의 접근 방식에 합의하여 두 가지 핵심 과제(dual mandate)를 달성했습니다. 바로 (a) 마찰을 최소화하면서 AI 도구에 대한 광범위한 액세스를 제공하는 것과 (b) 사용자당 총비용을 대략 고정된 범위 내로 유지하는 것입니다. 이 블로그 글에서는 Databricks에서의 경험과 Stripe, Coinbase, Uber, Ramp를 포함한 여러 디지털 네이티브 기업들과의 대화를 바탕으로 검증된 비용 관리 기법을 소개합니다. 아래 표는 현재 사용되는 기법과 그에 따른 비용 절감 효과를 요약한 것입니다. 수치는 개발 팀을 대상으로 한 비공식 설문조사를 바탕으로 한 대략적인 방향성 지표입니다.
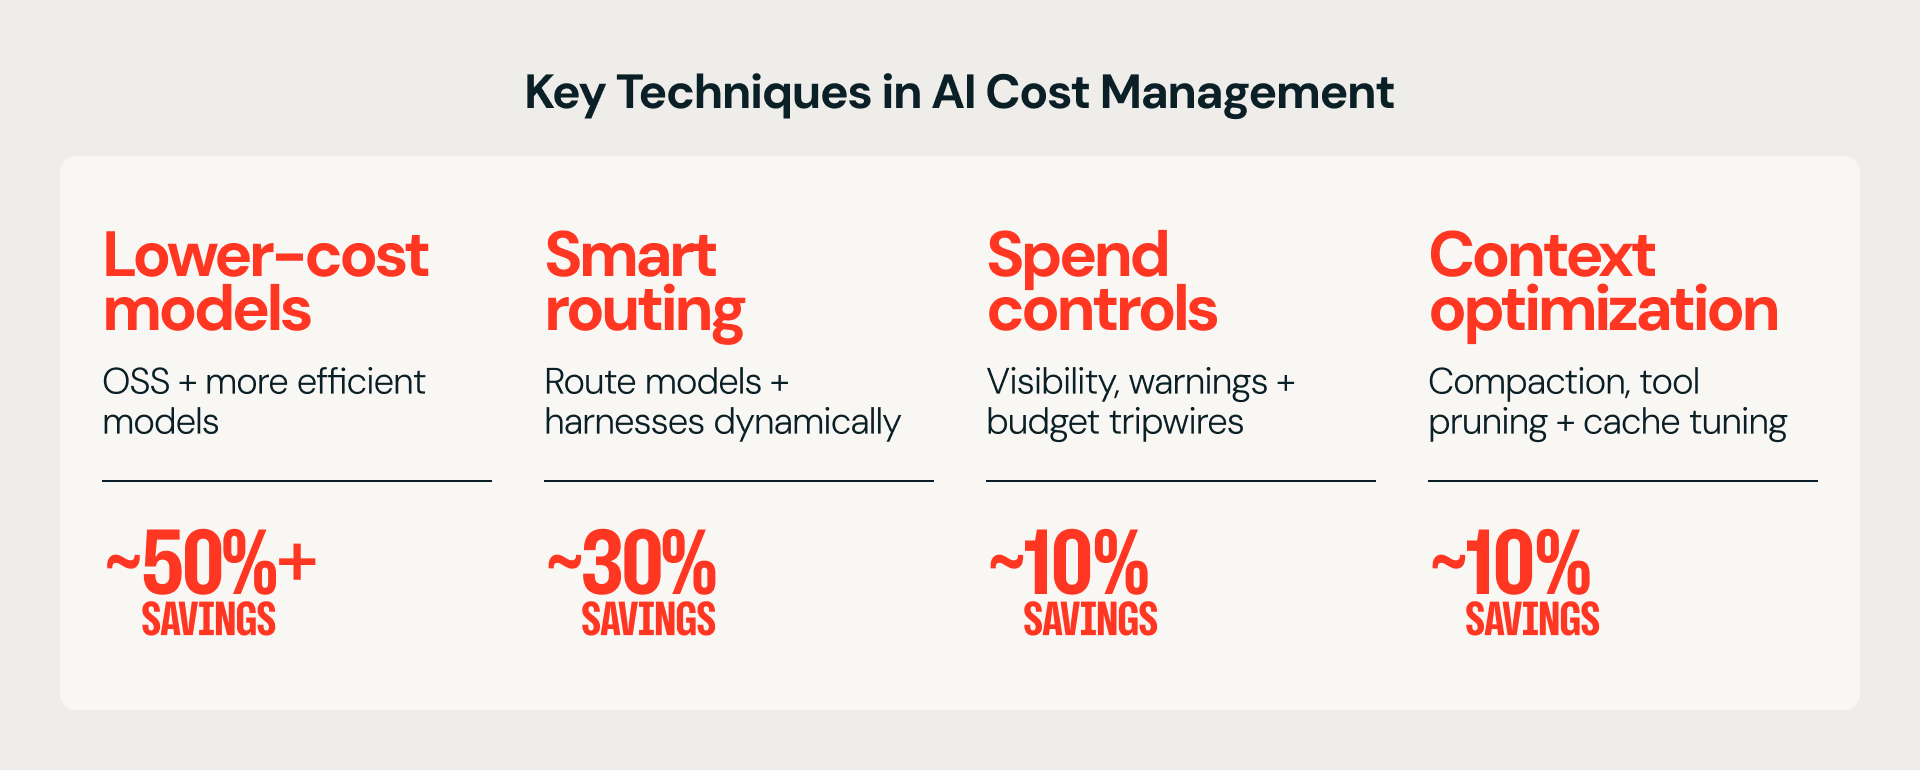
이러한 기법 중 일부는 많은 기업이 이미 사용하고 있는 소프트웨어로 쉽게 구현할 수 있습니다. 다른 기법들은 새로운 인프라가 필요하며, 특히 최종 사용자 클라이언트를 수정하거나 모델 간에 트래픽을 전환하는 기술이 그렇습니다. Databricks에서는 핵심 인프라 구성 요소인 최종 사용자 메타 하네스(Omnigent)와 AI Gateway(Unity AI Gateway)를 오픈 소스로 공개하거나 무료로 제공하고 있습니다. 완전성을 기하기 위해 이 글에서는 저희가 대화를 나눈 다른 기업들이 사용하는 소프트웨어도 함께 다룹니다.
코딩 모델을 위한 '효율성 전선(Efficiency Frontier)'
코딩 지출을 줄이는 가장 큰 단일 비용 레버는 새로운 모델이 출시될 때 더 효율적인 모델로 전환하는 것입니다. 이 점에 대해서는 논의해 볼 가치가 있습니다. 단순히 '더 저렴한 모델'이라는 설명 뒤에는 모델 비용과 품질 사이의 미묘한 관계가 숨겨져 있기 때문입니다.
구어적으로 프론티어 모델(frontier model)은 '가장 지능이 높은 모델'을 의미하며, 프론티어 연구소(frontier labs)는 주로 최고 수준의 지능을 발전시키는 데 집중합니다. 이제 프론티어 모델은 수학이나 사이버 보안 분야의 새로운 문제를 해결할 수 있습니다. 하지만 AI를 대규모로 배포할 때는 다른 종류의 전선이 더 중요해집니다. 바로 효율성 전선(efficiency frontier)입니다. 효율성 전선은 특정 지능 수준에서 가장 합리적인 가격대를 제공하는 모델 그룹으로 정의됩니다. 대부분의 일상적인 코딩에는 수학적 증명이나 새로운 보안 인사이트가 필요하지 않으므로, 결과적으로 중요한 것은 일반적인 소프트웨어 엔지니어링 작업의 품질 기준을 충족하는 모델의 비용입니다. 이러한 '효율성 전선'은 지능 전선보다 훨씬 빠르게 발전하고 있으며, 거의 매주 이전 모델보다 가격 대비 성능(단위 가격당 지능)이 더 우수한 새 모델이 출시되고 있습니다.
비용 레버 #1: 오픈 소스 및 저비용 모델로 전환
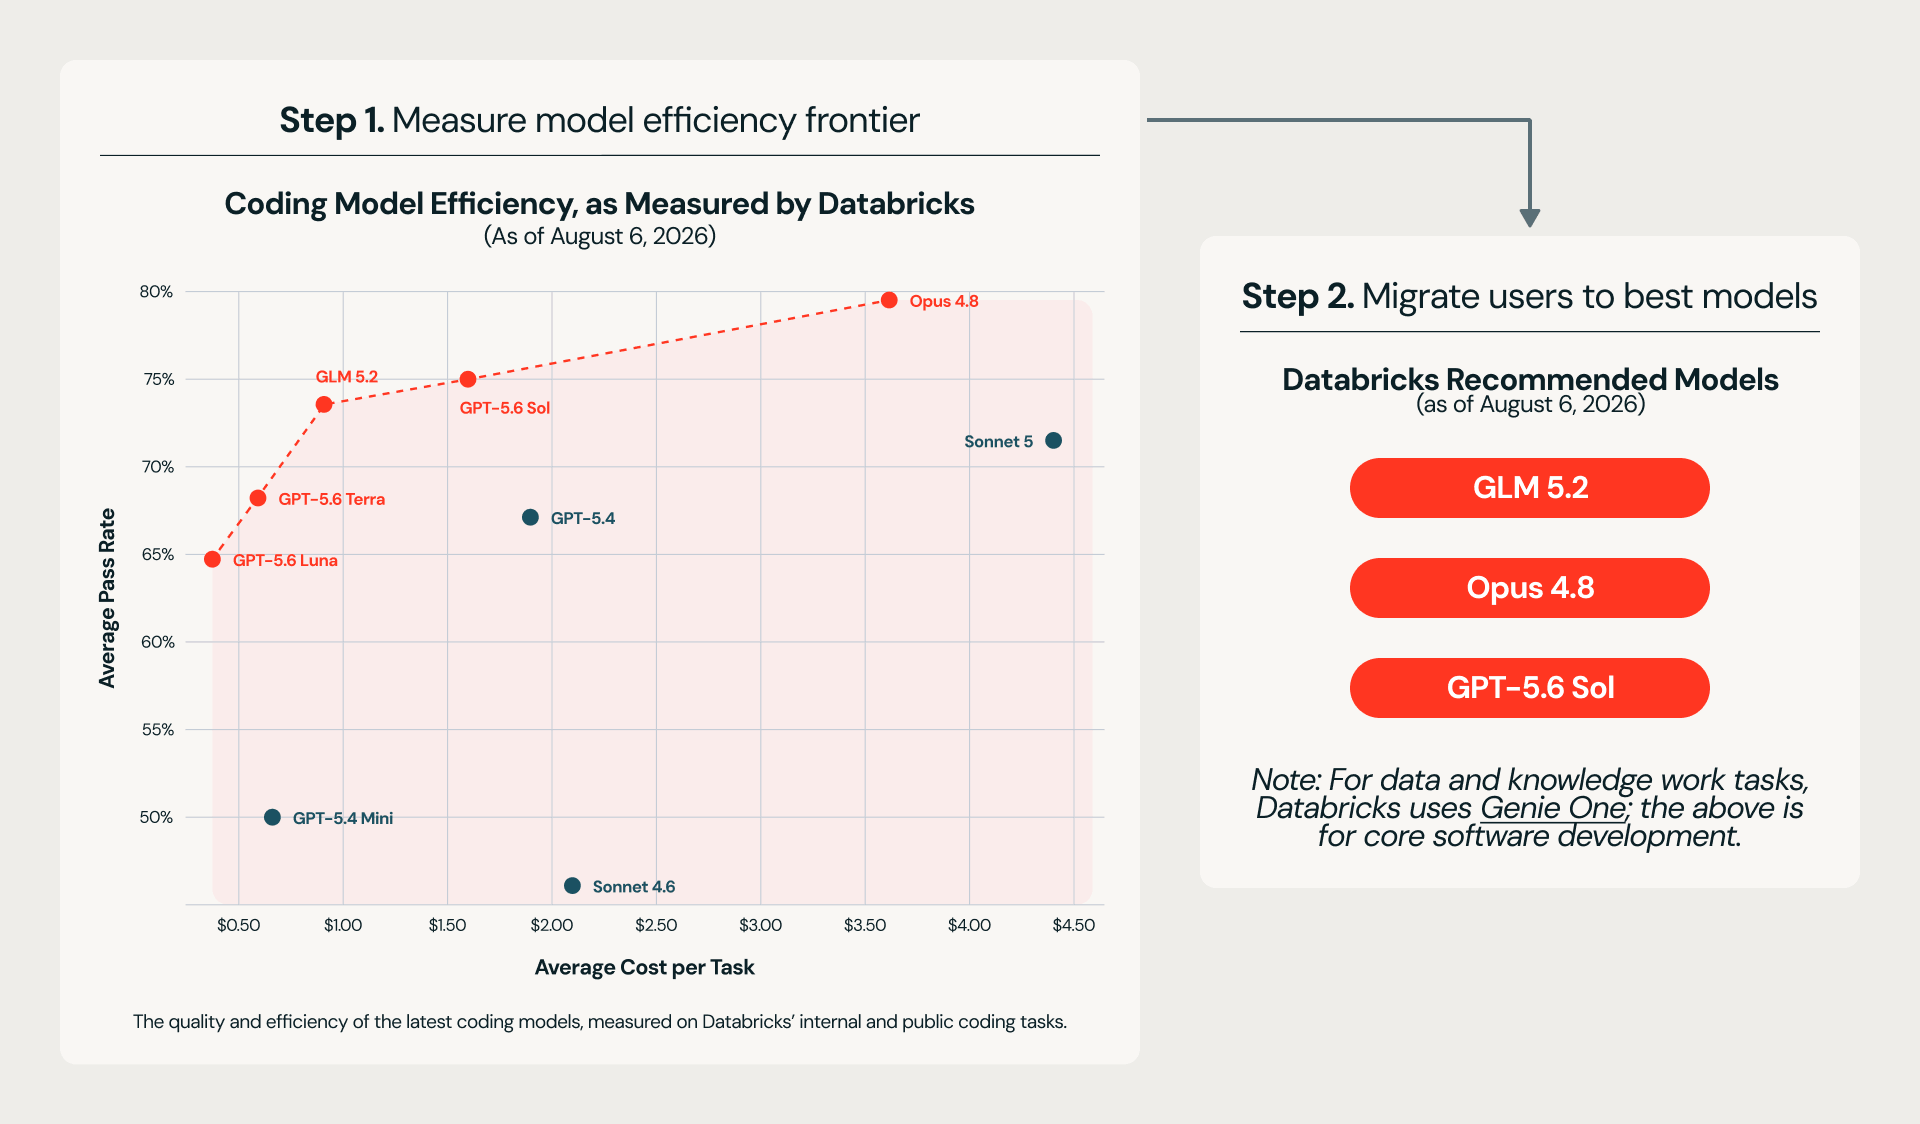
더 새롭고 효율적인 모델을 빠르게 도입하는 것은 모든 기법 중에서 가장 큰 비용 절감 효과를 가져옵니다. 하지만 이러한 이점을 누리려면 기업은 먼저 어떤 모델이 실제로 기존 모델보다 우수한지 파악해야 합니다. 공개 벤치마크는 코딩 작업에서의 실제 성능을 제대로 반영하지 못하기 때문에 이는 어려울 수 있습니다. 새로운 모델을 평가하기 위해 많은 기업이 자체 내부 개발 환경을 더 잘 대변한다고 생각하는 자동화된 평가 방식을 구축했습니다. Databricks는 최근 이러한 벤치마크의 예시를 발표했으며, 여기서 GLM 모델의 매우 경쟁력 있는 가성비(가격 대비 성능)를 확인했습니다. 이 벤치마크 결과를 바탕으로 내부 개발자들에게 GLM을 배포했습니다. 종종 새로운 모델이 효율성 전선을 확장하지 못하는 경우도 있으며, 평가에서 부정적인 결과가 나오는 경우도 많습니다. 예를 들어 Stripe는 Opus 4.7이 비용은 증가시키는 반면 Opus 4.6에 비해 품질을 유의미하게 향상시키지 못한다는 사실을 발견했습니다. 따라서 그들은 내부적으로 Opus 4.7을 제공하지 않기로 결정했습니다. Databricks 역시 Opus 5.0과 4.8을 비교했을 때 비슷한 비용 대비 성능 저하를 확인했습니다.
하네스 및 모델 유연성
가장 큰 비용 절감 효과는 새로운 모델로의 전환에서 오기 때문에, 모델 유연성을 허용하는 최종 사용자 도구를 도입하는 것이 비용을 낮게 유지하는 데 중요한 요소가 되고 있습니다. 특정 모델과 함께 가장 흔히 사용되는 도구를 하네스(harness)라고 합니다. 독점적인 프론티어 모델은 특정 하네스와 잘 작동하도록 공동 설계되는 경우가 많아지고 있으며, 이는 특정 하네스가 특정 모델과 '더 잘 작동함'을 의미합니다. 기업이 모델 독립성을 유지하고자 할 때 취할 수 있는 접근 방식은 크게 두 가지가 있습니다.
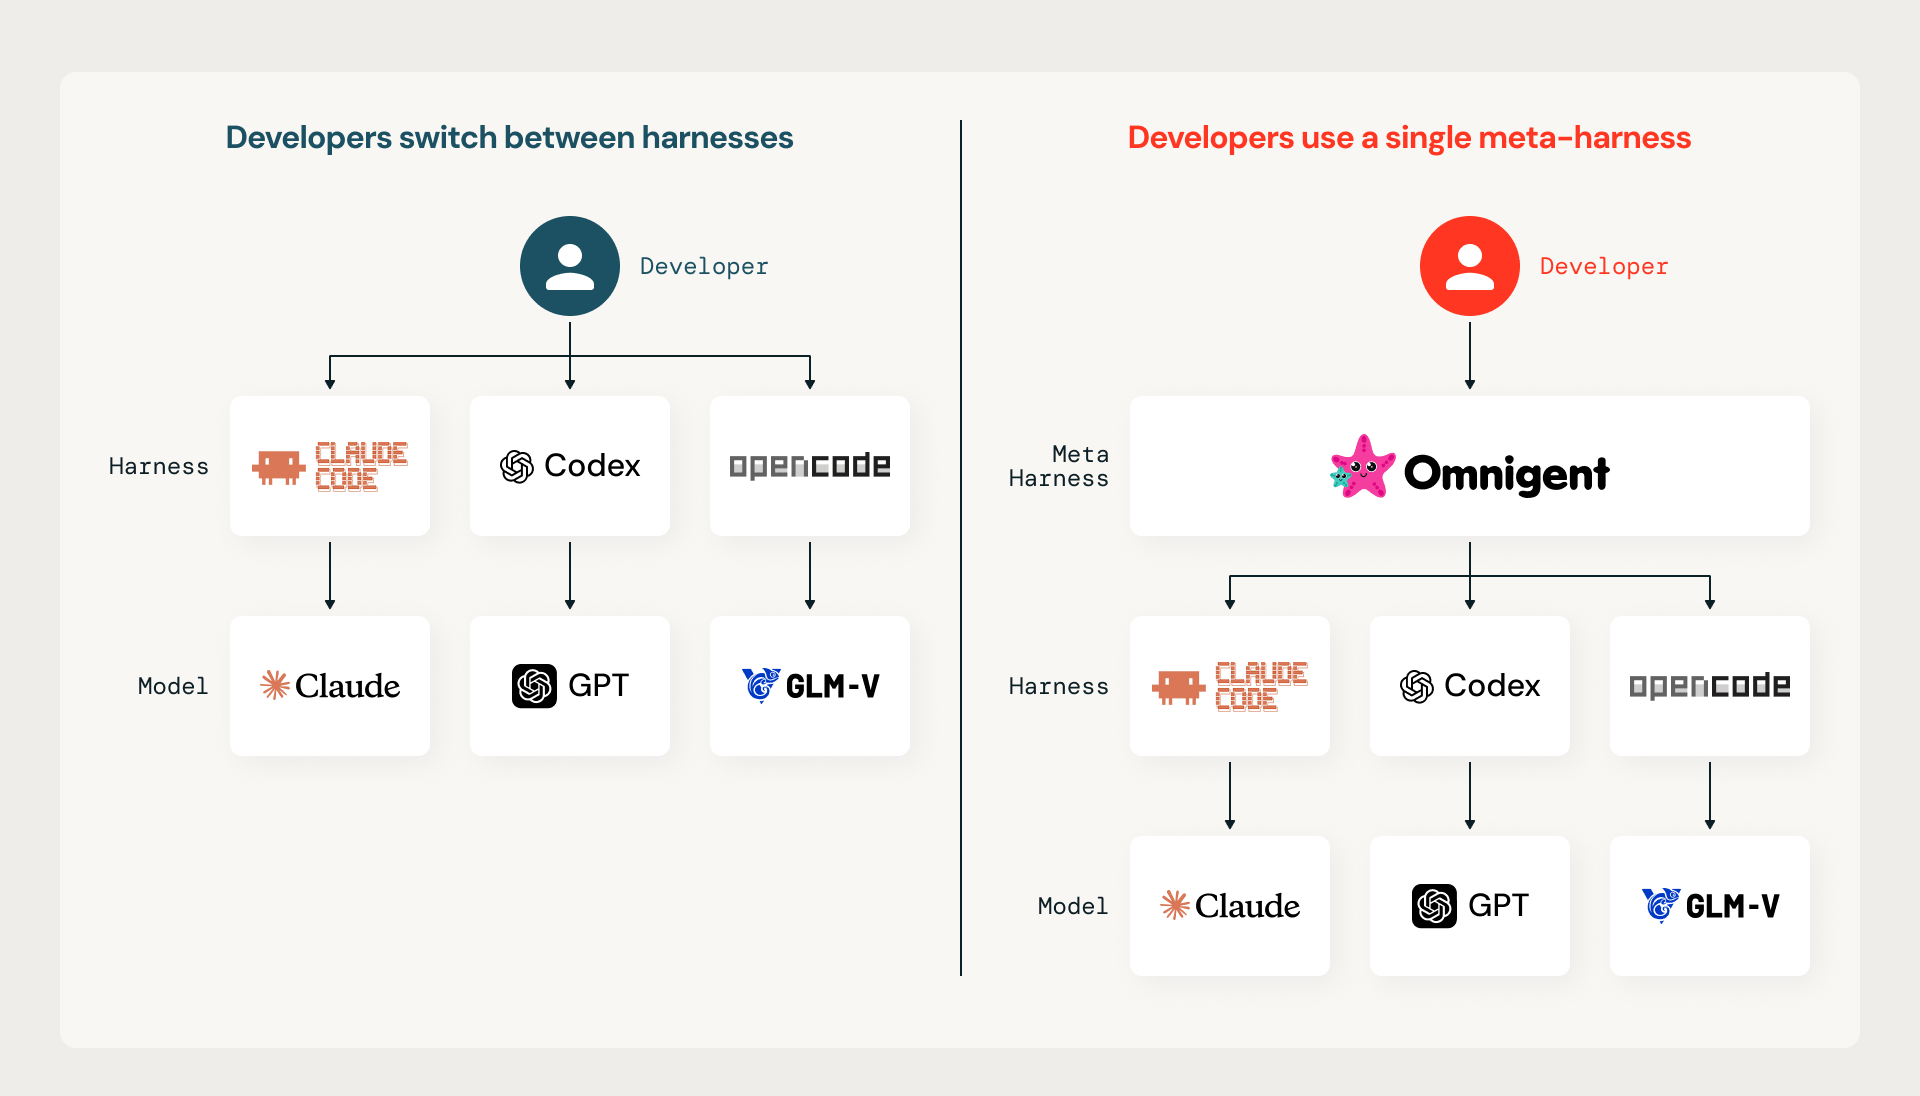
사용자에게 하네스를 전환하도록 요청하기. 한 가지 접근 방식은 개발자에게 여러 하네스(Claude Code, Codex 또는 Cursor)를 제공한 다음, 회사가 더 저렴한 모델로 지출을 전환하고자 할 때 하네스 간에 전환하도록 요청하는 것입니다. 이를 통해 사용자는 가능하면 선호하는 하네스에서 작업할 수 있지만, 이 방식의 단점은 개별 개발자의 전환 비용이 높을 수 있다는 점입니다. 전환 비용이 너무 높아지면 하네스 자체가 특정 모델 제품군에 대한 사실상의 락인(lock-in) 요인이 되어 더 경쟁력 있는 모델로 지출을 전환하는 능력이 제한됩니다.
메타 하네스 사용하기. 새롭고 점점 더 인기를 얻고 있는 접근 방식은 개발자에게 공통된 사용자 경험을 제공하는 동시에 기본 하네스(독점 및 오픈 소스 모두)로 요청을 발송하는 메타 하네스(meta-harness)를 사용하는 것입니다. 이 접근 방식은 모델 및 하네스 독립성을 보장하는 동시에 개발자의 전환 비용을 줄여줍니다. Databricks에서는 Omnigent를 활용하는 개발자의 기본 모드입니다. 저희가 대화를 나눈 일부 기업은 자체 개발 툴체인과 통합되는 맞춤형 내부 메타 하네스를 구축했습니다.
비용 레버 #2: 동적 요청 및 작업 라우팅
사용자가 작업에 적합한 모델을 직접 선택하도록 하는 대신, 자동 모델 및 도구 선택을 통해 에이전트 기반 코딩 워크플로에서 효율성을 더욱 극대화할 수 있다는 연구 결과가 늘어나고 있습니다. 라우팅 접근 방식은 크게 세 가지 범주로 나뉩니다.
- 요청 수준 라우팅: 상태 저장 프록시(stateful proxy)가 클라이언트(예: 코딩 하네스)와 기본 파운데이션 모델 사이에 위치합니다. 이 프록시는 각 추론 요청에 답변할 수 있는 가장 저렴한 모델로 요청을 라우팅하려고 시도합니다. 에이전트 기반 사용 사례의 라우팅은 대규모 컨텍스트 워크로드에서 콜드 캐시 히트(cold cache hit) 비용이 매우 높기 때문에 서버 측 캐싱도 고려해야 합니다. 새로운 제품들이 라우팅 분야에서 초기 단계의 유망한 결과를 보여주고 있습니다. 예로는 Cursor Router, OpenRouter의 AutoRouter, Ramp의 Router 기능, 그리고 Unity AI Gateway에 탑재된 Databricks 자체의 스마트 라우팅(Smart Routing) 기능이 있습니다.
- 작업 수준 라우팅(메타 하네스): 클라이언트 측 프로세스가 작업의 복잡성에 따라 사용자 작업을 서로 다른 하네스로 발송합니다. 사용자 작업은 "이 구성 요소의 이름을 X에서 Y로 변경"(간단한 작업)이거나 "지연 시간을 줄일 수 있는 설계 고려 사항 탐색"(복잡한 작업)과 같은 개방형 작업일 수 있습니다. 흔히 메타 하네스(Meta Harness)라고 불리는 디스패처는 작업에 어떤 수준의 기본 모델이 필요한지 검토한 다음, 해당 엔드투엔드 작업 전체를 모델에 위임합니다. Omnigent은 이러한 패턴을 지원하는 메타 하네스의 한 예입니다.
- 에스컬레이션/위임 패턴: 단일 하네스가 두 개의 모델(비싸고 지능이 높은 모델과 저렴한 작업자 모델)을 쌍으로 구성합니다. Claude의 Advisor Tool과 같은 일부 접근 방식에서는 저렴한 모델이 작업을 주도하다가 더 높은 성능이 필요하다고 판단되면 에스컬레이션(상신)합니다. 반대 패턴도 존재합니다. Cognition의 Devin Fusion에서는 고비용 모델이 메인 루프 역할을 하며 저렴한 모델에 작업을 선택적으로 아웃소싱합니다.
Databricks의 내부 결과에 따르면, AI Gateway 스마트 라우터(Smart Router)는 작업 세트에서 가장 비싼 모델의 품질과 거의 일치하면서도 평균 작업 비용을 지속적으로 30% 이상 절감할 수 있는 것으로 나타났습니다. 저희가 대화를 나눈 다른 기업들도 비슷한 결과를 얻었습니다.

비용 절감 레버 #3: 개발자에게 가시성, 경고 장치, 예산 제공
이 글 전체가 “사용자에게 월별 예산을 쥐어주고 끝내라”는 말로 시작해서 끝나지 않았다는 점이 놀라울 수도 있습니다. 특정 지출 임계값에서 사용이 완전히 차단되는 엄격한 예산(Hard budgets)은 저희가 인터뷰한 모든 기업에서 대개 최후의 수단으로만 사용되고 있었습니다. 엄격한 토큰 예산이 AI 지출 관리에 그리 효과적이지 않은 데는 두 가지 이유가 있습니다. 첫째, 개발자가 예산 한도에 도달했을 때 AI 툴에 대한 액세스를 완전히 차단해 버리면 생산성에 치명적인 타격을 줄 수 있습니다. 회사와 직원 모두 실제로 그런 결과를 원하지는 않습니다. 둘째, ‘지출이 많은’ 사용자 중 적어도 일부는 실제로 AI를 통해 엄청난 효율성 향상을 달성하고 막대한 결과물을 만들어내고 있는 핵심 인재들이기 때문입니다. 이러한 사용자들의 의욕을 꺾는 것은 오히려 역효과를 낳습니다.
따라서 대부분의 기업은 사용자 지출에 엄격한 상한선을 두는 대신, 최종 사용자에게 가시성을 제공하고 지출이 증가함에 따라 단계적으로 제약을 늘려가는 더 세분화되고 점진적인 방식을 채택하고 있습니다.
가시성: 저희가 대화를 나눈 모든 기업은 사용자에게 현재 지출 현황에 대한 실시간 피드백을 제공하는 메커니즘을 갖추고 있었으며, 많은 기업이 더 저렴한 모델을 사용하여 비용을 줄이는 방법에 대한 구체적인 팁이나 인사이트도 함께 제공하고 있었습니다. 사용자는 가장 높은 ROI를 얻을 수 있는 툴을 선택하는 데 영향을 미치고 싶어 할 수 있으므로, 모든 툴에 걸친 지출 현황을 볼 수 있도록 하는 것이 중요합니다.
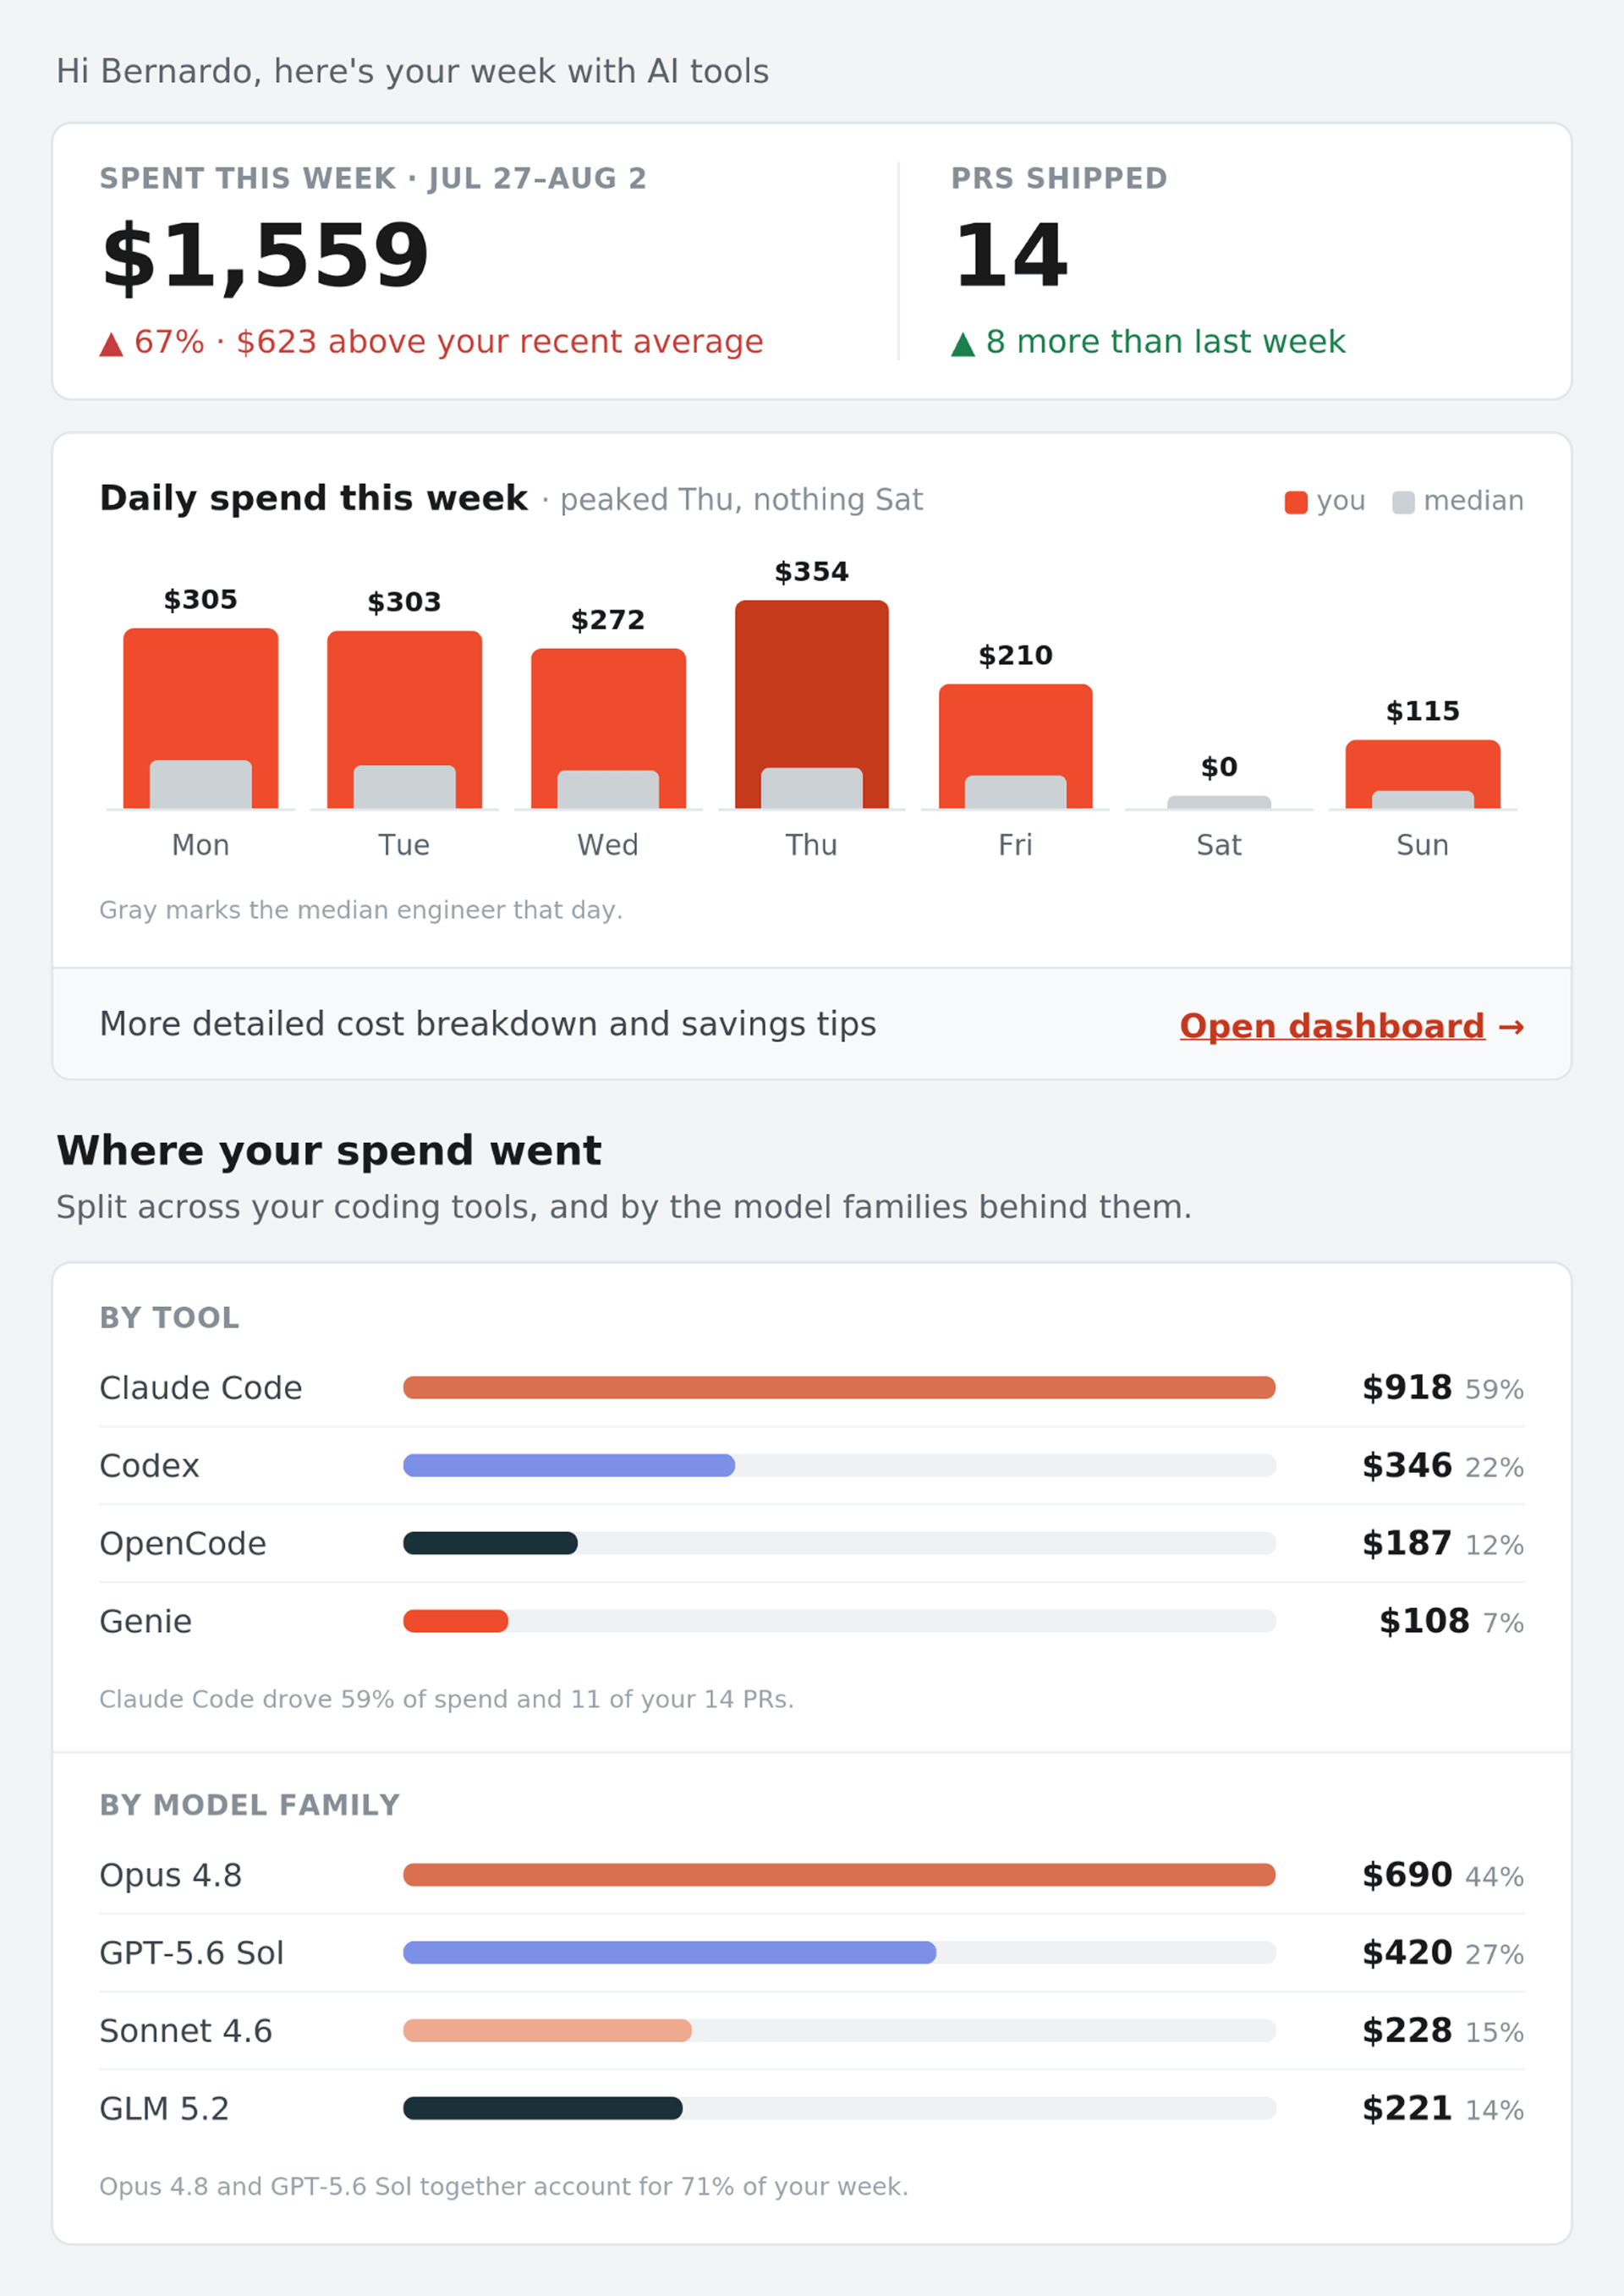
실시간 지출 현황을 보여주는 Databricks의 개발자 대시보드
- 지출 게이트(Spend Gates): 개발자는 지출 수준이 높아짐에 따라 특정 조치를 취하거나 승인을 요청하도록 요구받을 수 있습니다. 가장 단순한 형태의 지출 게이트는 사용자가 자체적으로 해제(self-cleared)할 수 있는 게이트로, 지출 속도가 특정 임계값을 초과하여 증가하고 있음을 경고하는 역할을 합니다. Databricks에서는 이러한 자체 해제형 게이트가 실수로 발생하거나 의도치 않은 지출을 방지하는 데 유용한 메커니즘임을 확인했습니다. 더 나아가 (보통 관리자 결재 라인을 통해) 명시적인 예산 승인을 요구하는 추가 게이트를 도입할 수도 있습니다.
- 다운시프팅(Downshifting): 개발자가 지출 게이트에 도달하면 토큰 액세스를 완전히 차단하는 대신 더 저렴한 모델로 다운시프트(전환)할 수 있습니다. 가장 저렴한 모델은 최첨단 지능형 모델보다 훨씬 더 저렴하기 때문에, 이 기법을 사용하면 개발자가 막대한 지출을 계속 발생시키지 않으면서도 작업을 계속 진행할 수 있습니다.
- 일시 중단(Suspension): 극단적인 경우, 대부분의 시스템은 사용자의 모든 토큰 액세스를 완전히 일시 중단하는 기능을 유지하고 있습니다. 앞서 언급했듯이 이는 대개 일시적인 조치일 뿐이며, AI를 효율적으로 활용하는 방법에 대해 대화를 시작하는 계기가 됩니다.
비용 절감 레버 #4: 토큰 오버헤드 줄이기
사용자가 AI 코딩 에이전트에 비교적 간단한 요청(예: “이 버그를 조사해서 해결해 주세요.”)을 입력하면, 에이전트는 이어서 방대한 양의 관련 컨텍스트를 수집하고, 수많은 툴을 호출하며, 코드베이스를 검색하고, 회사에서 제공한 기술이나 시스템 정보를 통합합니다. 비용이 많이 드는 LLM 추론이 일어날 때쯤이면 사용자의 초기 입력문은 AI 시스템에 입력되는 데이터의 극히 일부에 불과하므로, 결국 비용의 대부분은 사용자가 명시적으로 포함하지 않은 컨텍스트가 차지하게 됩니다. 컨텍스트 비대화(context bloat)를 줄이는 기술은 아직 초기 단계이지만, 다음과 같은 몇 가지 유망한 접근 방식이 탐색되고 있습니다.
- 활성 컨텍스트의 더 빈번한 압축(compaction/compression)을 강제 적용합니다.
- ‘덜 수다스러운’(토큰 효율성이 더 높은) 하네스(harness)를 사용하거나, 기존 하네스를 튜닝하여 토큰 오버헤드를 줄입니다.
- 자주 사용하는 툴을 감사(audit)하고 세부 정보 출력(verbosity)을 줄입니다.
- 개발자가 작업을 더 작은 개별 단위로 나누어 컨텍스트 범위를 줄이도록 권장합니다.
컨텍스트가 커지면 프롬프트 캐싱(caching) 역시 전반적인 성능에 중요한 역할을 합니다. 독점 및 오픈 소스 LLM 모두 프롬프트 캐싱을 활성화하고 캐시 저장 기간을 조율할 수 있는 설정을 제공합니다. 캐시 쓰기에는 비용이 들지만, 캐시된 읽기는 추론당 비용을 대폭 줄일 수 있습니다. 이러한 트레이드오프는 회사의 특정 워크로드에 따라 달라지므로, 기본 캐시 설정을 수동으로 튜닝하여 전반적인 캐시 히트율(cache hit rate)을 높이면 전체 비용을 획기적으로 개선할 수 있습니다.
Databricks에서는 하네스 및 캐싱 설정을 비교적 간단하게 튜닝하는 것만으로도 개발자의 체감 품질 저하 없이 생성되는 토큰 수와 관련 비용을 거의 50%나 줄일 수 있었습니다. 저희는 이 분야의 기술을 계속 탐색하고 있으며, 앞으로도 의미 있는 추가 최적화가 가능할 것으로 보고 있습니다.
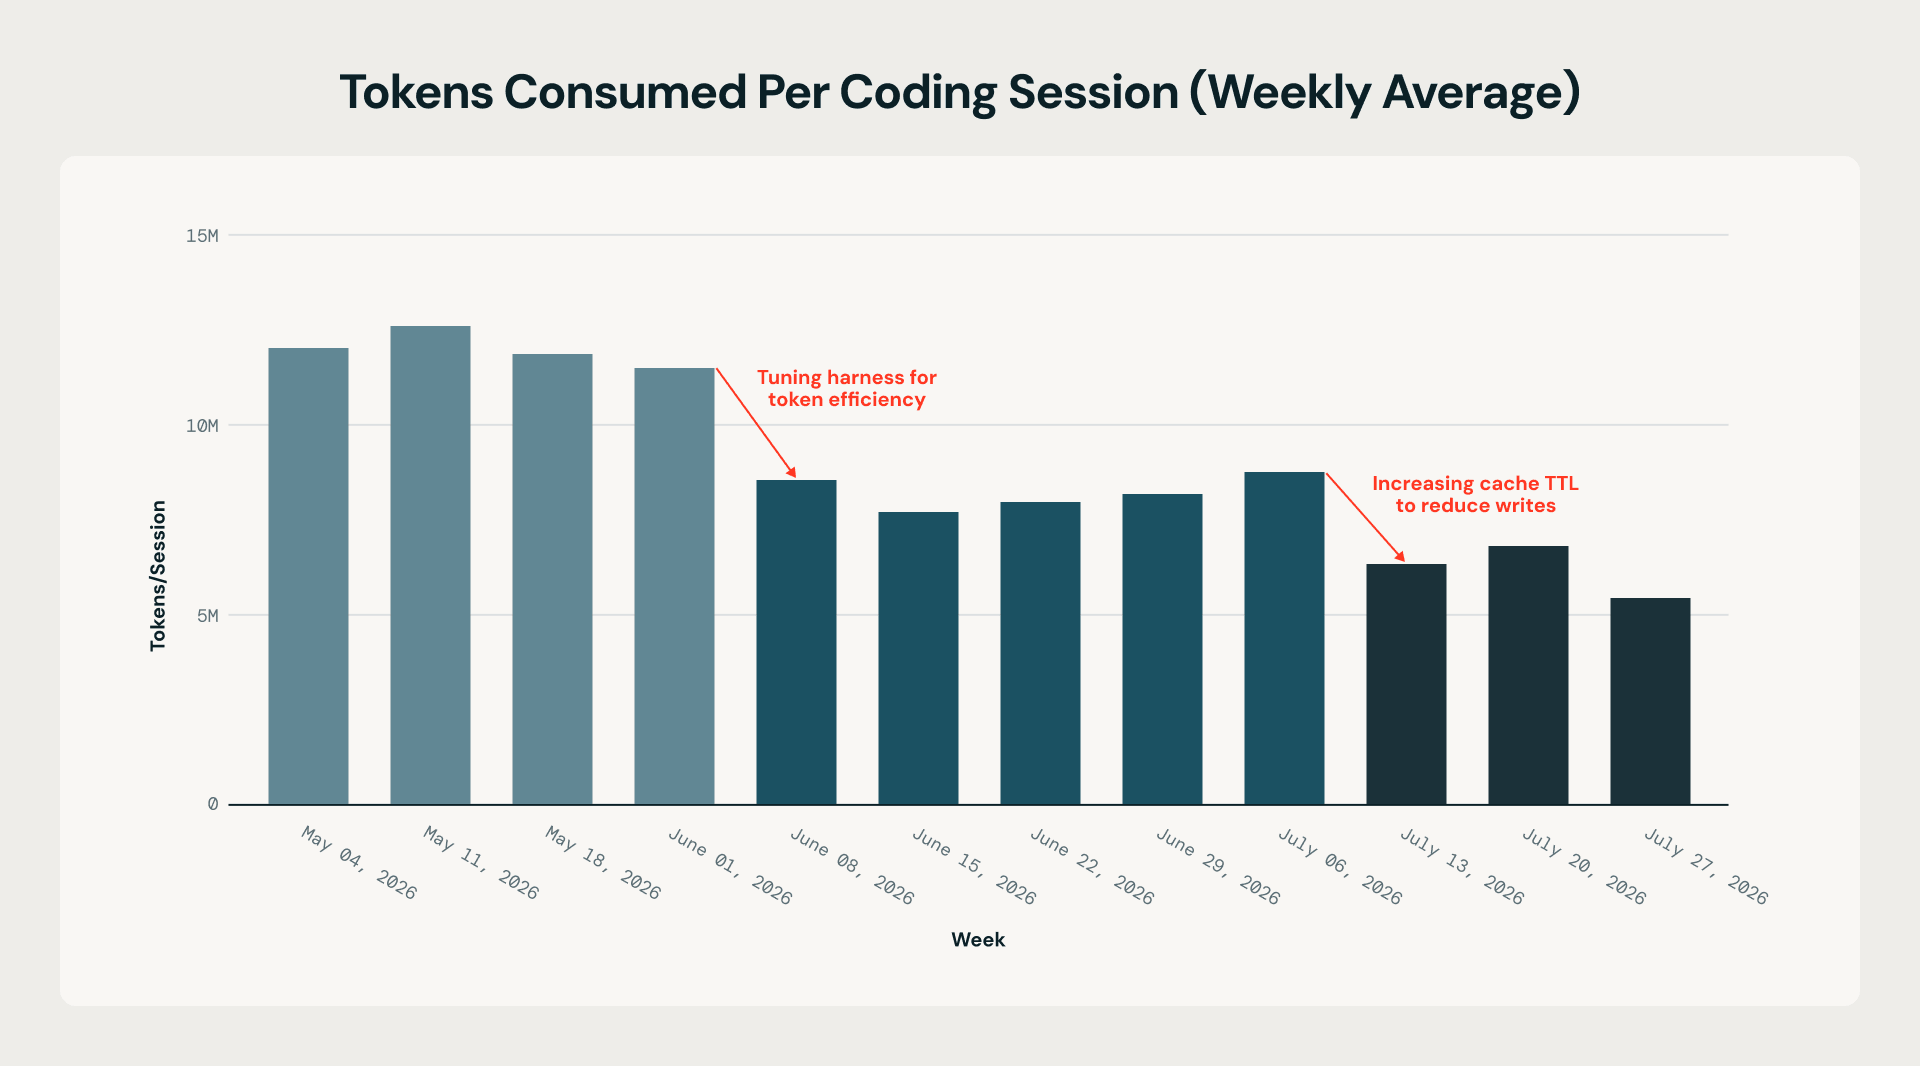
불필요한 추론 호출을 제거하고 캐시 쓰기를 줄임으로써 세션당 토큰 수를 획기적으로 감소시켰습니다.
AI Gateway 디자인 패턴
위의 기술들에는 여러 암묵적인 기술적 요구사항이 있었습니다. 새로운 모델을 신속하게 활용하려면 기업은 ‘모델 메뉴’를 중앙에서 관리할 수 있는 위치가 필요하며, 최종 사용자는 모델 믹싱을 지원하는 툴체인을 갖추어야 합니다. 여러 AI 툴에 걸쳐 예산 가시성을 제공하려면 통합된 비용 관측성(observability) 기능이 있어야 합니다. 컨텍스트 비대화를 관리하려면 일반적인 툴 호출 출력을 관찰하고 압축 또는 축소를 강제할 수 있는 방법이 필요합니다. 이러한 요구사항들은 통칭하여 AI Gateway라고 부르는 새로운 범주의 인프라 소프트웨어를 통해 해결되고 있습니다. AI Gateway는 다음과 같은 모든 작업이 이루어지는 중앙 집중식 공간입니다.
- 기반 모델(독점 및 OSS 모델 모두 포함)에 대한 용량 관리 및 액세스 프록시 처리
- 점진적 제약 수준 및 모델 다운시프팅과 같은 복잡한 예산 정책을 포함한 예산 추적 및 집행
- 모델 허용 목록(allow-lists), 압축 설정 및 기타 로컬에서 조정되는 요소를 적용하기 위한 최종 사용자 툴의 구성 관리
- 후속 효율성 분석 및 벤치마크를 위한 코딩 세션 추적(trace) 로깅
Databricks에서는 이러한 모든 기능을 구현하기 위해 Unity AI Gateway에 크게 의존하고 있습니다.
종합하자면
AI 코딩 비용의 기하급수적인 증가는 피할 수 없는 일이 아니며, 해결 가능한 엔지니어링 및 거버넌스 문제입니다. 비용을 성공적으로 통제한 기업들은 공통된 플레이북을 공유합니다. 바로 지능의 한계(intelligence frontier)보다는 효율성의 한계(efficiency frontier)를 끊임없이 추구하고, 모델 유연성을 유지하는 툴을 도입하며, 작업을 수행할 수 있는 가장 저렴한 모델로 스마트하게 라우팅하고, 엄격한 예산 대신 가시성과 점진적 제약을 도입하며, 실제 지출의 대부분을 차지하는 토큰 오버헤드를 줄이는 것입니다. 이러한 기법 중 어느 것도 AI 도입을 가치 있게 만들었던 생산성 향상을 희생하도록 요구하지 않습니다. 이 기법들을 결합하면 조직은 예측 가능한 비용 범위 내에서 마찰이 적고 광범위한 액세스를 제공한다는 두 가지 요구사항을 모두 충족할 수 있습니다.
기업이 비용을 관리할 수 있는 툴을 제공하기 위해 일련의 새로운 인프라 추상화가 등장하고 있습니다. Databricks에서는 비용 관리 스택의 핵심 구성 요소를 오픈 소스 또는 무료 소프트웨어 제품으로 출시했습니다. 중앙 관리를 위한 Unity AI Gateway와 개발자 툴링을 위한 Omnigent가 바로 그것입니다. 수천 개의 기업이 매일 이러한 구성 요소를 사용하고 있습니다. 기술 환경이 빠르게 진화하는 만큼, 더 많은 기업이 연구 결과를 공유하고 기술을 비교해 보시기를 권장합니다.
감사의 말: 이 글에 대한 의견과 검토를 제공해 주신 Uber, Stripe, Coinbase, Ramp의 인프라 리더분들께 감사드립니다. 이 글의 초기 초안에 대해 피드백을 주신 Thrive Capital에도 감사드립니다.
(이 글은 AI의 도움을 받아 번역되었습니다. 원문이 궁금하시다면 여기를 클릭해 주세요)
공지사항, 모범 사례 , Benchmarks
최신 게시물을 이메일로 받아보세요
블로그를 구독하고 최신 게시물을 이메일로 받아보세요.