Spark Declarative Pipelines를 사용하여 여러 스트리밍 플랫폼에서 데이터를 동시에 처리합니다.
단일 ETL 파이프라인을 통해 여러 클라우드의 다양한 스트리밍 플랫폼을 간편하게 관리하고 활용하세요.
작성자: Uday Satapathy, 디판카르 쿠샤리 , Akash Jaiswal
오늘날 조직의 가장 중요한 과제 중 하나는 비즈니스 속도에 맞춰 의사결정을 내릴 수 있도록 지원하는 것입니다. 비즈니스 팀과 자율 의사결정 시스템은 원본 이벤트가 발생하는 즉시(실시간 또는 준실시간으로) 의사결정을 내리고 신속하게 대응하는 데 필요한 모든 정보를 필요로 하는 경우가 많습니다. 스트림 처리 용어로는 이벤트라고 하는 이러한 정보는 소스에서 목적지로 비동기식으로 중계되며, 일반적으로 메시지 브로커 또는 메시지 버스를 통해 이루어집니다.
조직이 성장하고 팀이 다른 팀으로 확장됨에 따라 메시지 브로커의 사용 패턴, 수, 다양성이 증가합니다. 인수합병 시나리오에서 기업은 종종 새로운 메시지 브로커를 인수하게 되며, 이는 기존 데이터 엔지니어링 프로세스와 통합되어야 합니다. 수많은 메시지 브로커, 프로듀서, 컨슈머 및 데이터 엔지니어링 파이프라인을 일관되게 관리하는 것은 전문성을 갖춰야 하는 기술, 클라우드 플랫폼, 프로그래밍 언어의 수로 인해 어려울 수 있습니다.
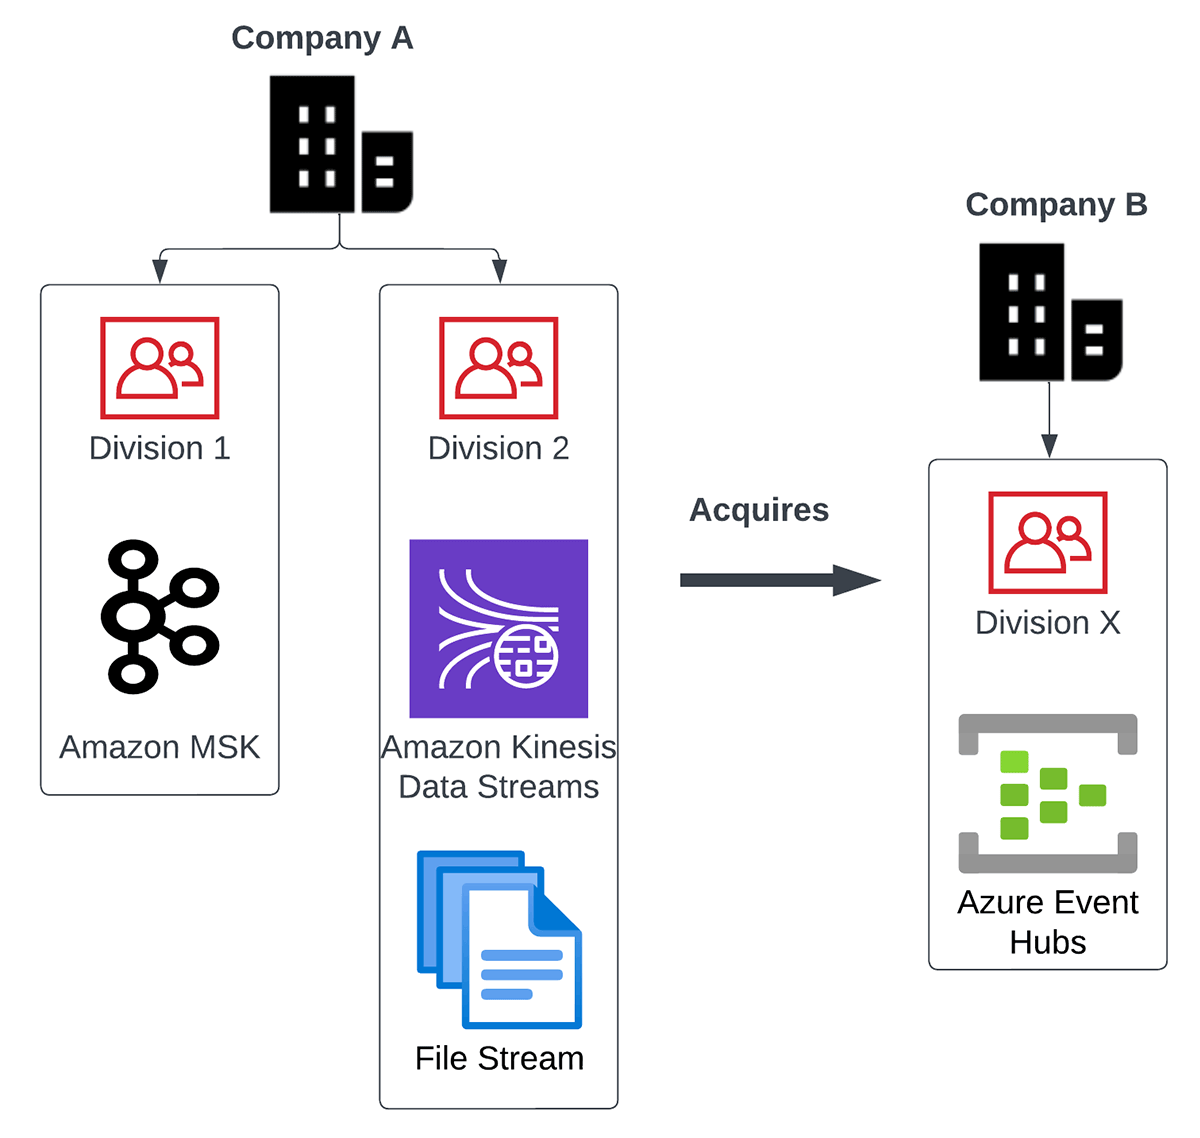
예를 들어 멀티 스트림 유스 케이스를 살펴보겠습니다. 다음과 같은 글로벌 대기업의 상황을 상상해 보세요.
- Amazon Kinesis Data Streams와 Amazon Managed Service for Kafka (MSK)라는 두 개의 별도 메시지 브로커를 사용하는 두 개의 주요 사업부가 있습니다.
- 내부적으로 Azure Event Hubs를 사용하는 다른 소규모 제품 회사를 인수했습니다.
- 또한 csv 또는 json 파일의 연속적인 스트림 형태로 들어오는 주요 데이터 소스가 있습니다.
아래 다이어그램은 위에서 설명한 멀티 스트림 유스 케이스를 보여줍니다.
이러한 시나리오에서 이 모든 데이터를 처리하는 데 있어 몇 가지 주요 과제는 다음과 같습니다.
- 이러한 다양한 데이터 소스와 그 기술을 어떻게 통합할 것인가?
- 확장과 유지가 쉽도록 데이터 엔지니어링 시스템을 어떻게 구축할 것인가? 각 기술마다 전문 인력을 채용할 것인가?
- 이러한 기술적 난제를 해결하는 과정에서 데이터의 의미를 파악하고 더 빠른 의사결정을 지원한다는 최종 목표를 잊지 않도록 하려면 어떻게 해야 할까?
- 동일한 데이터 처리 시스템을 통해 배치와 스트리밍 요구사항을 모두 충족할 수 있도록 어떻게 보장할 것인가?
이 블로그를 통해 Spark Declarative Pipelines (SDP)를 사용하여 이러한 문제를 쉽고 깔끔하게 해결할 수 있는 방법을 시연해 보겠습니다. Databricks Lakehouse Platform의 Spark Declarative Pipelines을 사용하면 고품질의 배치 및 스트리밍 데이터 파이프라인을 간단하게 만들고 관리할 수 있습니다.
멀티 스트림 유스 케이스
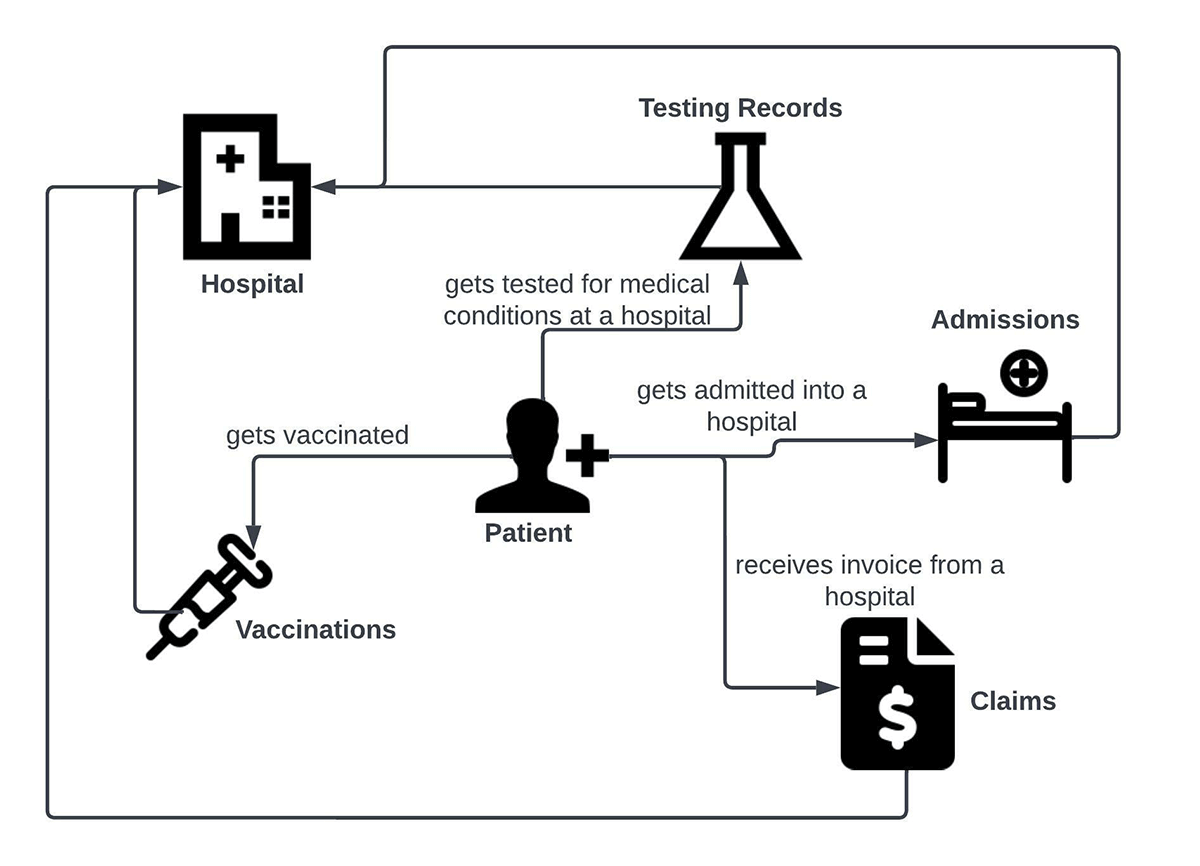
SDP를 통한 멀티 스트림 처리 시나리오를 시연하기 위해 헬스케어 도메인 유스 케이스를 상상해 보겠습니다. 유스 케이스의 중심에는 환자가 있습니다. 환자는 병원이라는 다른 엔티티와 다음과 같은 상호작용을 완료합니다.
- 병원에서 질병에 대한 예방 접종을 받습니다.
- 병원에서 질병에 대한 검사를 받습니다.
- 특정 질병으로 병원에 입원합니다.
- 청구 프로세스를 통해 치료에 대한 인보이스를 받습니다.
이러한 상호작용은 아래의 비즈니스 유스 케이스 다이어그램으로 나타낼 수 있습니다.
이러한 상호작용에 관여하는 엔티티는 아래의 엔티티 관계(ER) 다이어그램 형태로 나타낼 수 있습니다. 앞으로 데이터 웨어하우징 차원 모델링 어휘의 팩트(Facts)와 차원(Dimensions) 용어를 충분히 사용할 것입니다. ER 다이어그램에서 환자와 병원은 차원 테이블인 반면, 입원, 예방 접종, 검사 기록 및 청구에 대한 데이터는 팩트 테이블 형태로 표현됨을 알 수 있습니다.
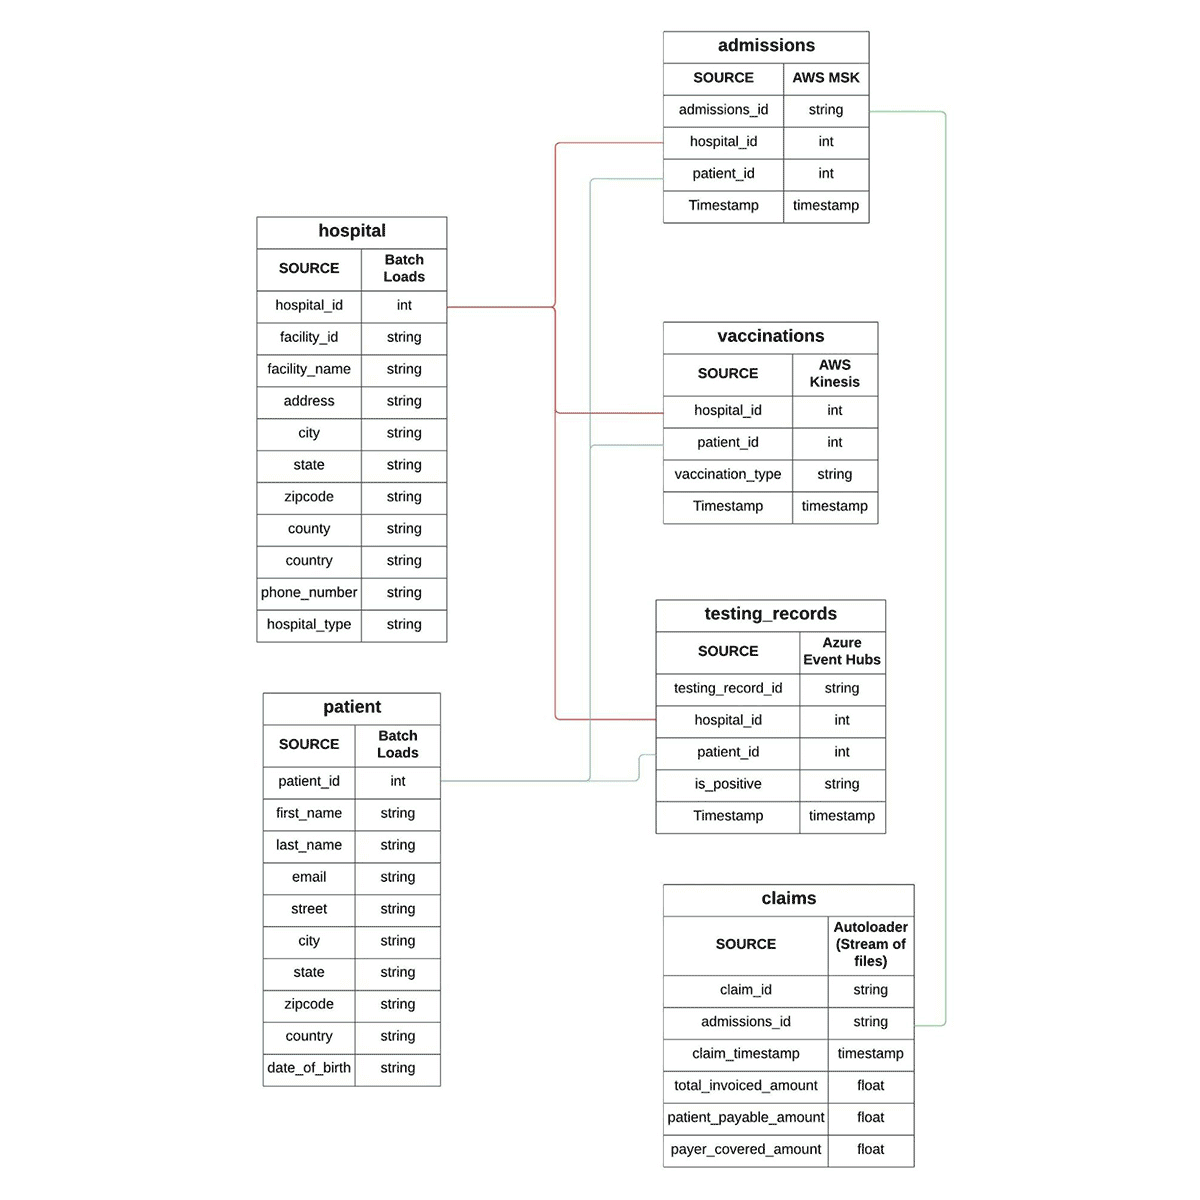
입원, 예방 접종, 검사 기록 및 청구에 대한 팩트 데이터가 서로 다른 메시지 브로커를 통해 들어온다고 가정해 보겠습니다. 이 블로그에서는 업계에서 인기 있는 Apache Kafka(Amazon MSK), AWS Kinesis Data Streams 및 Azure Event Hubs를 선택했습니다. 스트림 처리 시나리오를 보여주는 네 번째 방법은 일련의 파일을 증분 방식으로 테이블(이 경우 Delta lake)에 수집하는 것입니다. 이를 위해 Databricks Autoloader를 선택했습니다. 이 정보를 바탕으로 이제 환자의 상호작용 다이어그램을 관련 데이터 소스로 업데이트할 수 있습니다.
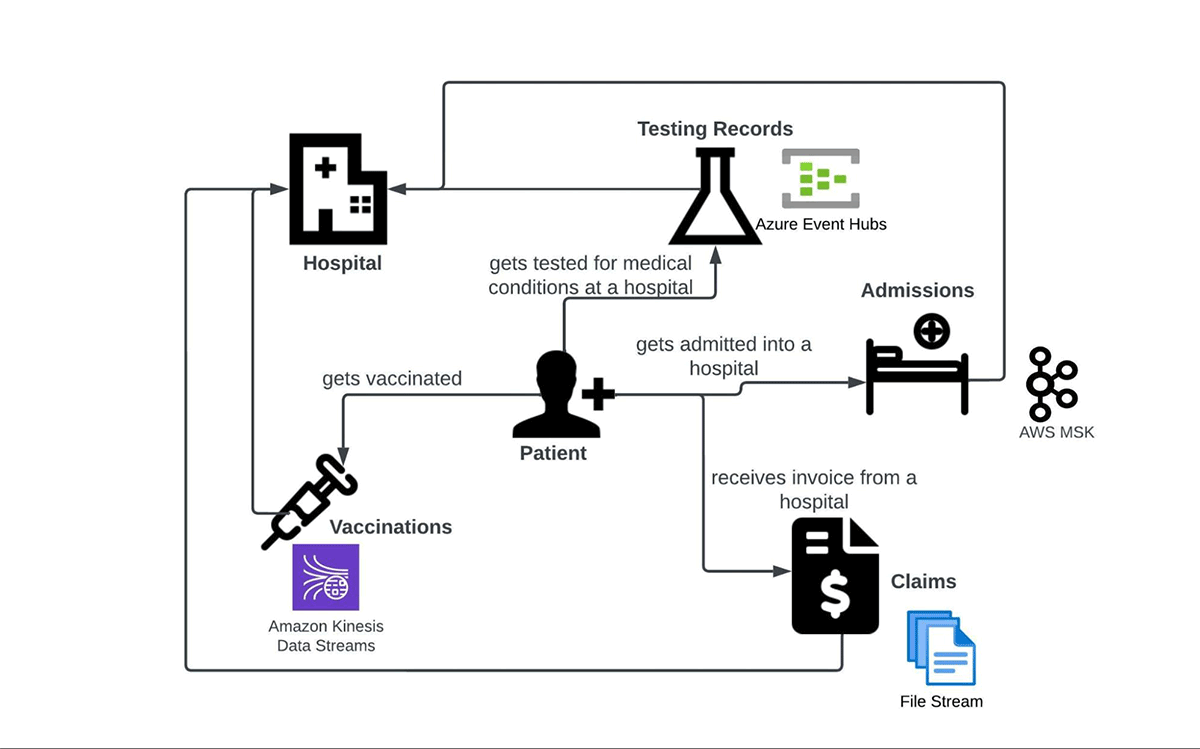
아래는 표 형식으로 요약된 데이터 소스입니다.
| 팩트 | 데이터 소스 |
| 입원 | Amazon MSK (Apache Kafka) |
| 검사 기록 | Azure Event Hubs |
| 예방 접종 | AWS Kinesis Data Streams |
| 청구 | 파일의 증분 스트림 |
다음 섹션에서는 단일 SDP 파이프라인이 위의 스트리밍 소스에서 데이터를 동시에 수집하고 ETL을 수행하는 방법을 시연하겠습니다. 이 블로그에서는 리소스와 파이프라인을 설정하기 위해 AWS 인프라를 사용했지만, Azure 및 GCP와 같은 다른 퍼블릭 클라우드에서도 유사하게 시나리오를 구성할 수 있습니다.
SDP를 통한 멀티 스트림 처리
아래 다이어그램은 일반적인 SDP 파이프라인의 모습을 보여줍니다. 다양한 소스에서 들어오는 스트리밍 데이터의 수집과 변환이 이 블로그의 범위를 요약하지만, 주목할 만한 SDP의 추가 기능도 있습니다. 예를 들어, 데이터 품질 관리는 팀이 특정 '기대치(expectations)'를 통과한 데이터만 처리할 수 있도록 돕는 핵심 기능입니다. 그런 다음 팀은 잘못된 데이터에 대해 시정 및 예방 조치를 취할 수 있습니다. SDP의 다른 이점으로는 관리형 체크포인팅과 향상된 자동 스케일링이 있습니다. 이러한 기능 및 기타 기능에 대한 자세한 내용은 Spark Declarative Pipelines concepts 문서를 참조하세요.
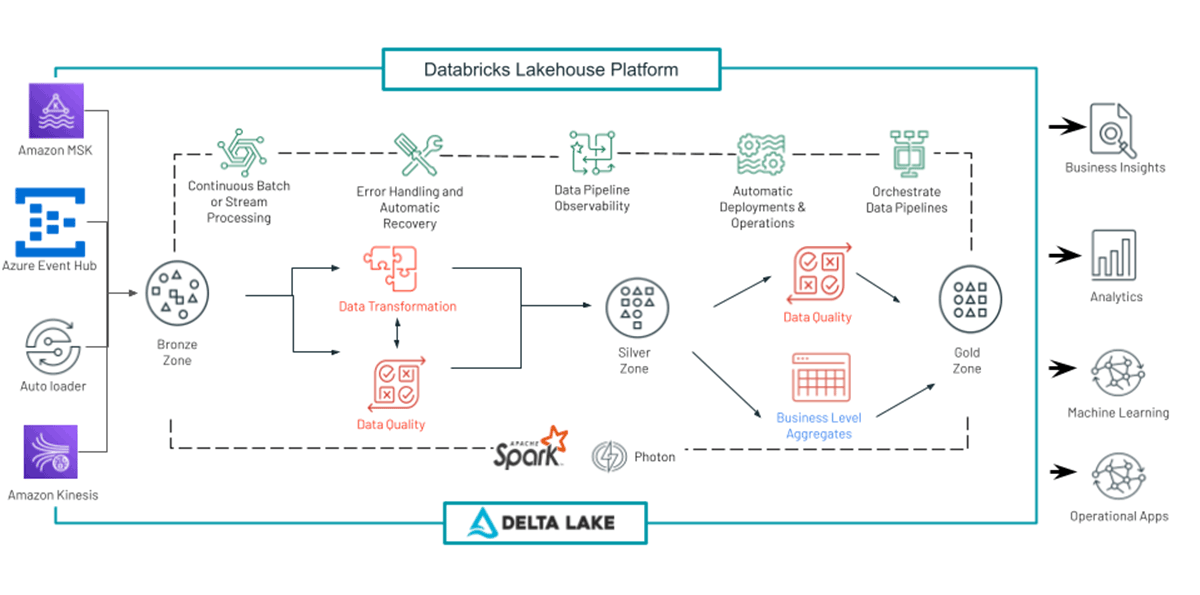
멀티 스트림 처리 SDP 파이프라인(편의상 sdp_multistream_consumer라고 함)에는 다음과 같은 작업이 포함됩니다.
- 메시지 브로커의 스트리밍 데이터를 delta lake 테이블의 원본 레이어에 로드합니다.
- 원본 데이터에 스키마를 파싱하고 적용하여 메시지 페이로드에서 의미 있는 팩트(팩트 테이블)를 생성합니다.
- BI 및 분석 팀이 소비할 수 있도록 집계된 데이터셋을 생성합니다. 이는 다양한 팩트 및 차원 테이블을 조인하고 생성된 레코드를 슬라이싱 및 다이싱하여 수행됩니다.
SDP 파이프라인은 다음과 같은 모드로 작동하도록 구성할 수 있습니다.
- 연속(Continuous): 라이브 클러스터가 데이터가 도착하는 즉시 연속적인 방식으로 처리를 수행합니다. 지연 시간이 가장 중요한 스트리밍 시나리오에 권장됩니다.
- 트리거(Triggered): 원하는 일정에 따라 클러스터가 가동되며 해당 시점에 사용 가능한 데이터를 처리합니다. 더 이상 처리할 대기 중인 데이터가 없으면(특정 시간 지속 시간 임계값 동안) 클러스터가 종료됩니다. 이 모드는 지연 시간보다 비용 절감과 처리량이 우선시될 때 권장됩니다.
이 블로그에서는 두 가지 이유로 연속(continuous) 모드를 사용합니다. 첫 번째는 데이터가 실시간으로 수집되고 처리되는 '진정한' 스트림 처리 시나리오를 시연하기 위해서입니다. 두 번째는, 이 블로그를 작성하는 시점 기준으로는 Apache Spark용 Amazon Kinesis Data Streams 커넥터가 트리거 모드의 경우처럼 일괄(batch) 수집 모드(예: trigger once 또는 available now)를 지원하지 않기 때문입니다. 하지만 곧 지원될 예정입니다.
또 다른 강조할 점은 일반적으로 프로덕션 설정에서 원시 데이터가 수집되면 데이터 정제, 변환, 집계 등 데이터 분석, 히스토리 분석, 예측 분석과 같은 비즈니스 유스케이스를 위해 여러 단계의 처리와 보강 과정을 거친다는 것입니다. 아키텍처의 각 레이어를 거치면서 데이터의 구조와 품질이 점진적으로 향상되는 과정을 Medallion Lakehouse Architecture라고 부릅니다. Medallion 아키텍처는 주요 유스케이스를 위한 모범 사례이지만, 이 블로그를 간단하게 설명하기 위해 데이터 변환 과정은 건너뛰고 비즈니스 유스케이스를 지원하는 데이터 분석을 수행하는 단계로 넘어가겠습니다.
이제 SDP를 사용하여 여러 스트리밍 시스템의 데이터를 한꺼번에 Delta Lake로 수집하고, 해당 데이터를 분석하여 의미 있는 인사이트를 도출하는 스트리밍 데이터 수집 방법을 살펴보겠습니다.
스트림에서 데이터 수집하기
이 섹션에서는 여러 스트리밍 플랫폼에서 데이터를 수집하는 방법을 보여줍니다.
Amazon MSK에서 데이터 수집하기
Amazon Managed Streaming for Apache Kafka(Amazon MSK)는 Apache Kafka를 사용하여 스트리밍 데이터를 처리하는 애플리케이션을 빌드하고 실행할 수 있는 완전 관리형 서비스입니다. Amazon MSK는 클러스터 생성, 업데이트, 삭제와 같은 제어 평면(control-plane) 작업을 제공합니다.
이 블로그에서는 다음 구성의 MSK 클러스터를 사용했습니다.
- 클러스터 유형 - 프로비저닝됨(Provisioned)
- 브로커 총 수 - 2
- Apache Kafka 버전 - 2.5.1
- 브로커 유형 - kafka.m5.large
- 가용 영역 수 - 2
- 브로커당 EBS 스토리지 볼륨 - 300 GiB
- 클라이언트와 브로커 간 암호화:
- TLS 암호화 - 사용함
- 일반 텍스트(Plaintext) - 사용함
AWS 환경에서 인증하기 위해 SDP 클러스터에 인스턴스 프로필을 연결했습니다. 이 인스턴스 프로필은 역할 정의에 구성된 대로 적절한 읽기/쓰기 권한을 가진 IAM 역할을 참조합니다.
파이프라인 sdp_multistream_consumer는 MSK 토픽 admission의 병원 입원(Hospital Admission) 데이터셋을 msk_admissions_tbl_raw라는 이름의 delta lake 테이블로 수집합니다. 입원 팩트에 대한 kafka 페이로드(문자열로 표현된 바이너리)는 다음과 같습니다:
수집을 위해 파이썬 노트북에서 다음 코드를 사용했으며, 이를 SDP 파이프라인 sdp_multistream_consumer에 연결했습니다.
파이프라인 sdp_multistream_consumer는 시작되면 원하는 데이터베이스/스키마 내에 msk_admissions_tbl_raw 테이블을 생성하고, admission 토픽에서 읽은 데이터로 테이블을 채웁니다. 그런 다음 해당 토픽에 새로운 데이터가 기록될 때마다 추가 데이터를 계속해서 수집합니다.
Kafka 토픽에서 수집된 4개의 필드 외에도, msk_admissions_tbl_raw 테이블에 msk_event_timestamp 컬럼을 추가했습니다(Kafka에서 생성된 이벤트 timestamp에서 파생됨). 메시지는 바이너리 형식의 Kafka 페이로드 value 필드에서 수신됩니다. 다운스트림 프로세스에서 파싱할 수 있도록 문자열로 변환해야 합니다.
Amazon Kinesis에서 수집하기
Amazon Kinesis Data Streams를 사용하면 실시간 스트리밍 데이터를 간편하게 수집, 처리, 분석할 수 있습니다. 데이터는 머신러닝, 분석 및 기타 애플리케이션을 위한 비디오, 오디오, 애플리케이션 로그, 웹사이트 클릭스트림, IoT 텔레메트리 데이터 등이 될 수 있습니다. 이 블로그에서는 다음 구성의 Kinesis 데이터 스트림을 사용했습니다.
- 데이터 스트림 이름: test_vaccination_data
- 용량 모드: 온디맨드(On Demand)
- 쓰기 용량: 200 MiB/초 또는 200,000 레코드/초(기본 최대값)
- 읽기 용량: 400 MiB/초(기본값)
더 나은 처리량을 위해, 프로덕션 시나리오에서는 Databricks Runtime Kinesis 커넥터의 Amazon Kinesis 향상된 팬아웃(EFO) 기능을 사용할 수 있습니다.
유스케이스에서 test_vaccination_data 스트림은 환자의 예방 접종 팩트(이벤트)를 전달합니다. 아래는 샘플 페이로드입니다:
Kinesis 데이터 스트림에서 Lake house의 랜드링 존으로 데이터를 소비하기 위한 SDP 코드는 다음과 같습니다:
파이프라인 sdp_multistream_consumer는 Kinesis 데이터 스트림에서 사용 가능한 데이터로 타겟 테이블 kinesis_vaccination_tbl_raw를 채우고, 데이터를 다시 읽지 않도록 체크포인트를 수행합니다. 메시지는 바이너리 형식의 Kinesis 페이로드 data 필드에서 수신됩니다. 다운스트림 프로세스에서 파싱할 수 있도록 문자열로 변환해야 합니다.
Azure Event Hubs에서 수집하기
Azure Event Hubs는 Microsoft에서 제공하는 인기 있는 스트리밍 플랫폼입니다. Event Hubs는 AMQP, HTTPS, Apache Kafka와 같은 읽기 및 쓰기를 위한 여러 프로토콜을 지원합니다. 이 블로그에서는 Spark용 Kafka 커넥터가 추가 라이브러리 없이 Databricks Runtime에 기본적으로 포함되어 있으므로, SDP 파이프라인 sdp_multistream_consumer가 Event Hubs의 Kafka 인터페이스를 사용하여 메시지를 소비합니다. Event Hubs 네임스페이스에는 2개의 처리량 단위를 사용하는 표준 가격 책정 계층을 사용하고 있습니다.
Azure 문서에서는 네임스페이스를 이벤트 허브(Kafka 용어로는 토픽)의 관리 컨테이너로 설명합니다. 우리가 관심을 갖고 있는 Event Hub(일명 토픽)는 환자의 실험실 검사 결과와 관련된 이벤트를 전달하는 testing_records_stream입니다. 각 메시지는 다음과 같습니다:
testing_records_stream 이벤트 허브에서 메시지를 가져오는 SDP 코드는 Amazon MSK를 사용한 수집 패턴과 매우 비슷합니다(결국 둘 다 Kafka 프로토콜을 사용하니까요).
SDP 파이프라인은 Event Hubs에서 테스트 레코드 메시지를 증분 방식으로 읽어와 eventhubs_testing_records_tbl_raw Delta Lake 테이블에 새 행으로 추가합니다. 메시지는 이진 형식의 Kafka 표면 페이로드 필드 값으로 수신됩니다. 다운스트림 프로세스에서 파싱할 수 있도록 문자열로 변환해야 합니다.
Auto Loader를 통한 파일 수집
Auto Loader는 업계에서 가장 강력하고 안정적인 데이터 파일 수집 도구 중 하나입니다. 추가 설정 없이 클라우드 스토리지에 새 데이터 파일이 도착하는 대로 효율적으로 증분 처리합니다. 현재 JSON, CSV, PARQUET, AVRO, ORC, TEXT 및 BINARYFILE 파일 형식을 수집할 수 있습니다.
Auto Loader를 사용하면 소비자가 cloudFiles라는 Structured Streaming 소스를 설정할 수 있습니다. 설정 옵션에는 클라우드 스토리지 파일 경로, 파일 필터링 패턴, Azure Queue Storage, AWS SQS, AWS SNS 등의 큐를 위한 파일 도착 이벤트 옵션이 포함됩니다. SDP 파이프라인은 이러한 옵션을 사용하여 새 파일이 도착할 때마다 자동으로 수집하며, 해당 디렉터리에 이미 있는 파일도 함께 처리할 수 있는 옵션을 제공합니다. Auto Loader는 SDP 파이프라인에서 Python과 SQL을 모두 지원합니다. 고객들은 Auto Loader를 사용하여 수십억 개의 파일을 처리하며 데이터를 마이그레이션하거나 테이블을 백필해 왔습니다. 시간당 수백만 개의 파일을 실시간에 가깝게 수집할 수 있도록 확장됩니다.
이 블로그에서는 다음 예제를 사용하여 Auto Loader로 환자 청구 데이터를 수집했습니다.
sdp_multistream_consumer 파이프라인에서는 아래 코드에 나오는 것처럼 소스 위치에 환자 청구 JSON 파일이 도착하는 즉시 Auto Loader를 통해 수집됩니다.
수집된 데이터를 분석하여 비즈니스 인사이트 도출하기
앞서 언급했듯이 이 블로그에서는 Amazon MSK, Amazon Kinesis Data Streams, Azure Event Hubs, Databricks Auto Loader라는 네 가지 서로 다른 소스에서 환자 데이터셋을 이미 수집했습니다. 간결함을 위해 데이터 변환 부분은 스키마 적용(schema enforcement)으로 제한하고, 비즈니스 유스케이스를 지원하기 위해 이 데이터셋에 대한 데이터 분석을 진행하겠습니다.
이 블로그를 위해 두 가지 비즈니스 분석 유스케이스를 만들었습니다. 사용자가 SDP로 생성된 Delta Lake 테이블을 사용하여 데이터 분석을 수행하고 비즈니스 질문에 답하는 방법을 보여주는 것이 목적입니다.
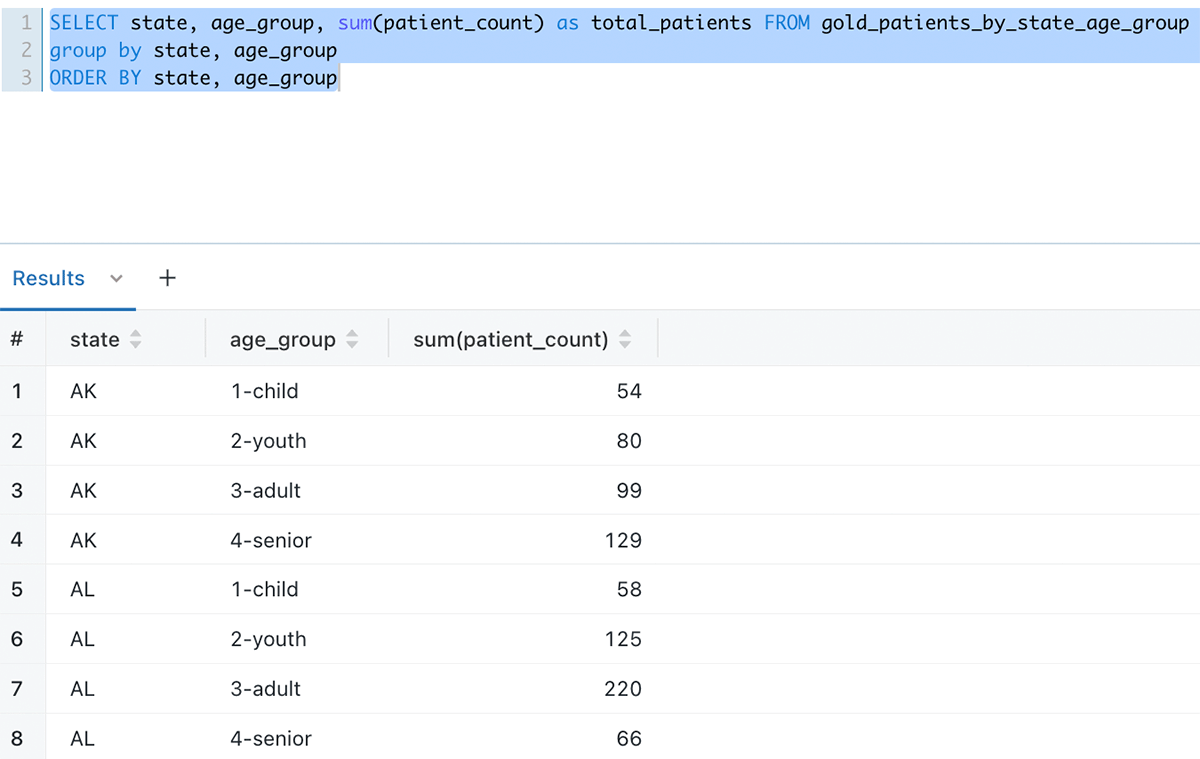
코로나 백신 접종 후 코로나 확진 판정을 받은 환자 수(주별 및 연령대별)
gold_patients_by_state_age_group 테이블은 SDP를 통한 데이터 수집을 통해 채워진 테이블들을 조인하여 SDP에서 생성됩니다. 수집 계층에 새로운 데이터가 도착하면 연속적인 SDP 파이프라인이 해당 데이터를 수집 계층에 가져와 데이터 분석을 위해 이 gold_patients_by_state_age_group 테이블을 업데이트합니다. --
Databricks SQL 쿼리 편집기를 통해 쿼리했을 때 데이터가 어떻게 보이는지 아래에서 확인하세요.
도시별 및 주별 월간 입원 건수
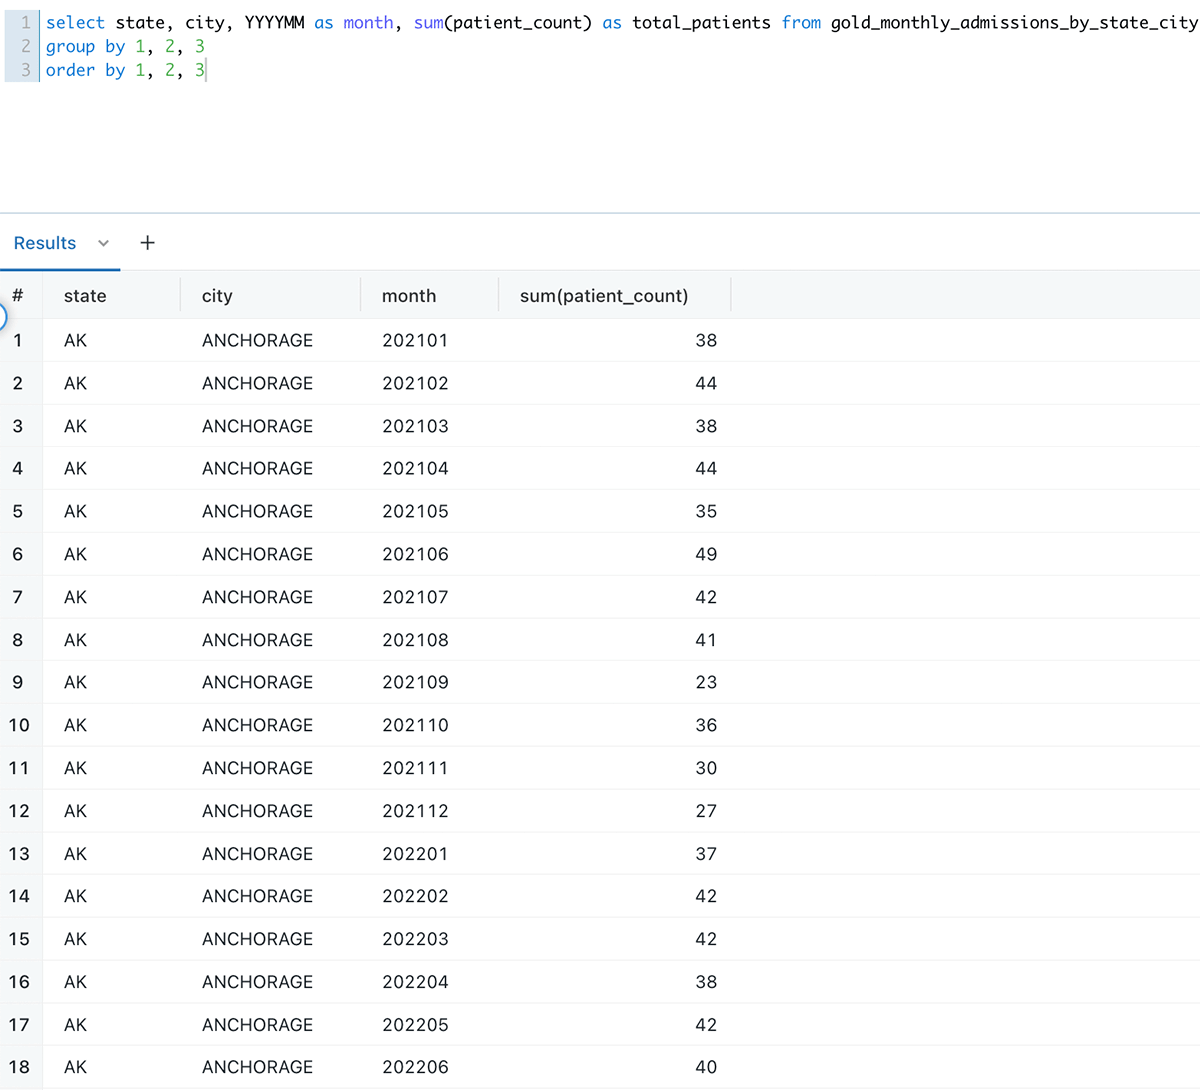
도시 및 주별 월간 입원 건수는 gold_monthly_admissions_by_state_city 테이블을 쿼리하여 지원하는 또 다른 유스케이스입니다.
Databricks SQL 쿼리 편집기를 통해 데이터를 조회하면 다음과 같이 나타납니다:
SDP 파이프라인의 엔드투엔드 뷰
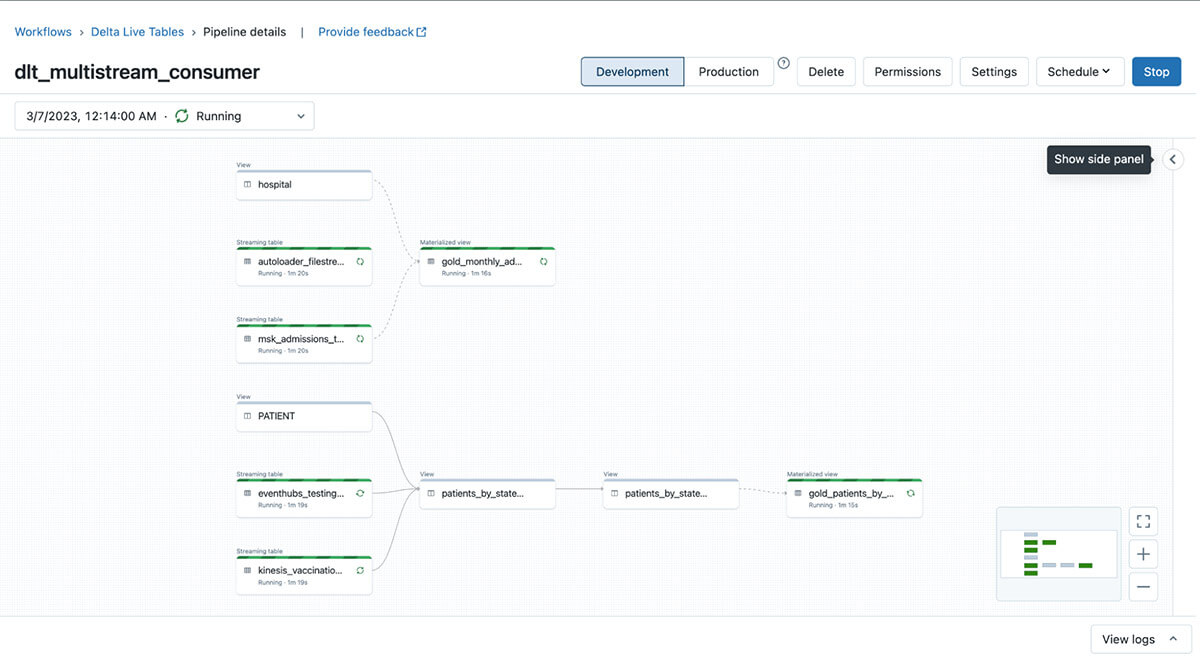
SDP의 주요 기능 중 하나는 파이프라인에 포함된 코드 아티팩트 간의 모든 테이블 수준 종속성을 탐색하여 계보 그래프 형태로 표시하는 기능입니다. 이 그래프는 '실시간'으로 작동합니다. ETL 작업이 진행됨에 따라 성공한 작업은 녹색으로, 오류가 발생한 작업은 빨간색으로 표시됩니다. 지속적으로 실행되는 SDP 데이터 파이프라인의 스크린샷은 다음과 같습니다:
결론
이 블로그에서는 Databricks Spark Declarative Pipelines를 사용하여 단일 데이터 파이프라인으로 여러 클라우드의 다양한 스트리밍 플랫폼에서 데이터를 수집하고 활용하는 방법을 살펴보았습니다. ETL 프로세스는 데이터가 도착하는 즉시 지속적으로 이루어집니다. 변환을 통해 생성된 데이터는 비즈니스 질문에 대한 답을 얻기 위해 데이터 분석을 수행하는 데 지속적으로 활용될 수 있습니다. 이러한 솔루션은 전체적인 기술 아키텍처를 크게 단순화하고 유지 관리 및 확장을 쉽게 만들어 줍니다. Databricks가 SDP에 새로운 기능을 정기적으로 추가함에 따라, 고객들 사이에서 ETL 워크로드용으로 널리 채택되고 있습니다. 지금 바로 Spark Declarative Pipelines를 사용해 보세요.
(이 글은 AI의 도움을 받아 번역되었습니다. 원문이 궁금하시다면 여기를 클릭해 주세요)
최신 게시물을 이메일로 받아보세요
블로그를 구독하고 최신 게시물을 이메일로 받아보세요.