오픈 레이크하우스란 무엇일까요? 오픈 데이터 표준에 대해 알아봅니다.
엔드투엔드 오픈 레이크하우스: 정의, 참조 아키텍처, 복제하여 바로 실행할 수 있는 오픈 소스 스택을 제공합니다. 오픈 포맷, 오픈 엔진, 통합 거버넌스를 지원하며 특정 벤더에 종속되지 않습니다.
작성자: Lisa Cao
- 오픈 레이크하우스는 모든 레이어(오픈 포맷, 오픈 엔진, 통합 거버넌스)가 오픈 표준을 기반으로 구축된 데이터 레이크하우스로, 특정 벤더에 종속되지 않고 전체 스택을 직접 구성, 운영 및 소유할 수 있습니다.
- 커밋 이력을 보여줄 수 없다면 "오픈"은 단지 말뿐인 라벨에 불과합니다. Databricks는 Apache Spark, Delta Lake, Unity Catalog, MLflow의 최초 제작자들이 설립했으며, Apache Iceberg의 주요 기여자이기도 합니다.
- 저희는 2인 규모의 ETL부터 멀티 클라우드 거버넌스 및 프로덕션 AI 에이전트까지 확장 가능한 단일 참조 아키텍처를 개발했습니다. 모든 레이어는 자체 호스팅이 가능하고 상호 호환되므로 벤더 종속이 전혀 없습니다.
오픈 레이크하우스는 모든 레이어(스토리지, 테이블 포맷, 엔진, 카탈로그, 그 위의 ML 및 AI 도구)가 개방형 표준을 기반으로 구축되어 어떤 레이어도 단일 벤더에 종속되지 않는 데이터 레이크하우스입니다.
데이터 레이크하우스는 데이터 레이크의 저렴하고 확장 가능한 스토리지와 데이터 웨어하우스의 관리 기능 및 트랜잭션 보장을 결합한 것입니다. 오픈 레이크하우스는 여기에 한 가지 조건을 더 추가합니다. 바로 아키텍처의 모든 레이어가 개방형 표준을 기반으로 구축되어야 한다는 점입니다. 데이터, 데이터를 처리하는 엔진, 이를 거버닝하는 카탈로그, 그 위에서 모델과 애플리케이션을 빌드하는 도구가 모두 오픈 소스이므로 그 어떤 것도 단일 벤더에 의존하지 않습니다.
"오픈"이라는 단어는 자주 사용되지만, 항상 정직하게 사용되는 것은 아닙니다. 그렇기 때문에 그 개념을 명확히 정의할 필요가 있습니다. 어떤 포맷이 오픈이라고 불리면서도 실제로는 단 하나의 엔진을 통해서만 실용적으로 사용할 수 있는 경우가 있습니다. 카탈로그가 오픈이라고 불리면서도 여전히 하나의 플랫폼에 종속되어 있을 수 있습니다. 스토리지는 데이터 전송(egress) 요금으로 인해 이동 비용이 비싸지기 전까지만 이식성을 유지합니다. 오픈 레이크하우스는 모든 수준에서 이러한 제약이 제거될 때 실현됩니다. 최근에는 이러한 개방성이 데이터 위에 구축되고 있는 AI 및 에이전트 워크로드로도 확장되었습니다.
오픈 레이크하우스는 데이터 레이크 및 데이터 웨어하우스와 어떻게 다른가요?
오픈 레이크하우스는 데이터 웨어하우스의 신뢰성과 데이터 레이크의 저렴한 스토리지를 하나의 아키텍처로 결합한 후, 다른 두 시스템에는 없는 한 가지 규칙을 추가합니다. 바로 모든 레이어가 개방적이고 상호 호환되어야 한다는 점입니다. 데이터 웨어하우스는 보고를 위해 정제되고 구조화된 테이블을 보관하며, 강력한 거버넌스를 제공하지만 비용이 많이 들고 비정형 데이터를 수용할 공간이 거의 없습니다. 데이터 레이크는 원시 파일, 로그, 이미지 등 그 외의 모든 데이터를 저렴하고 대규모로 보관하지만, 트랜잭션, 스키마 보장 또는 강력한 거버넌스가 부족합니다.
레이크하우스는 갑자기 나타난 것이 아닙니다. 수년 동안 팀들은 두 시스템을 나란히 유지하면서 데이터를 서로 복사하고 두 개의 서로 다른 데이터 버전을 조율해야 했습니다. 데이터 레이크하우스는 이 둘을 통합하여 저렴한 레이크 스토리지에 웨어하우스 스타일의 관리와 트랜잭션을 직접 적용했습니다. 오픈 레이크하우스는 이 아이디어의 다음 단계입니다. 통합된 아키텍처를 유지하면서 위의 규칙을 추가하므로, 어떤 레이어도 단일 벤더에 종속되지 않고 웨어하우스의 신뢰성과 레이크의 경제성을 모두 누릴 수 있습니다.
| 기능 | 데이터 웨어하우스 | 데이터 레이크 | 오픈 레이크하우스 |
|---|---|---|---|
| 스토리지 비용 | 높음 | 낮음 | 낮음 |
| ACID 트랜잭션 | 예 | 아니요 | 예 |
| 거버넌스 및 스키마 | 강력함 | 약함 | 강력함 |
| 개방형 포맷, 엔진 선택 | 아니요 | 부분적 | 예 |
| 단일 카피 상의 BI, ML 및 AI | 주로 BI | 주로 ML | BI, ML 및 AI |
오픈 레이크하우스 vs. 독점적 레이크하우스: 어떤 차이가 있나요?
오픈 레이크하우스와 독점적 레이크하우스의 차이는 결국 한 가지 질문으로 귀결됩니다. 바로 '누가 내 데이터를 읽을 수 있고, 어떤 엔진이 그 데이터에서 실행될 수 있는가'입니다. 독점적 레이크하우스는 단일 벤더만 읽을 수 있는 포맷으로 데이터를 저장하므로, 도구를 전환하려면 모든 데이터를 다시 작성하거나 다시 내보내야 할 수 있습니다. 오픈 레이크하우스는 호환되는 모든 엔진이 읽을 수 있는 개방형 포맷으로 데이터를 저장하므로, 데이터를 다시 작성하지 않고도 쿼리 엔진을 추가, 교체 또는 제거할 수 있습니다.
| 요소 | 오픈 레이크하우스 | 독점적 레이크하우스 |
|---|---|---|
| 데이터 포맷 | 개방형 표준 | 벤더 전용 |
| 엔진 선택 | 호환되는 모든 엔진 | 벤더 전용 엔진만 가능 |
| 벤더 종속성 | 낮음 | 높음 |
| 카탈로그 | 개방형, 이식 가능 | 독점적 |
| 비용 제어 | 멀티 엔진 유연성 | 단일 벤더에 종속됨 |
레이크하우스를 개방형으로 만드는 것은 무엇인가요?
오픈 레이크하우스와 독점적 레이크하우스를 구분하는 세 가지 요소는 개방형 포맷, 개방형 엔진, 통합 거버넌스입니다.
먼저 개방형 포맷부터 시작합니다. 데이터는 Apache Parquet®와 같은 개방형 파일 포맷 위에 놓인 개방형 테이블 포맷인 Delta Lake 및 Apache Iceberg®에 저장됩니다. 사양이 공개되어 있으므로 단일 벤더의 런타임뿐만 아니라 이를 구현하는 모든 엔진이 데이터를 읽고 쓸 수 있습니다.
다음은 개방형 엔진입니다. 처리를 수행하는 시스템도 오픈 소스입니다. Apache Spark®는 단일 런타임에서 배치, 스트리밍, SQL 및 머신러닝을 지원하며, 그 아래의 테이블이 개방형이기 때문에 DuckDB, Trino 또는 PyIceberg와 같은 엔진이 복사본을 만들지 않고도 동일한 데이터에서 작업할 수 있습니다.
통합 거버넌스는 팀들이 과소평가하기 쉬운 부분입니다. 하나의 카탈로그가 모든 포맷과 엔진에 대한 액세스 제어, 계보(lineage), 감사를 처리하므로, 데이터를 다루는 각 도구 내부에서 거버넌스를 재구축하는 대신 데이터 자체에 거버넌스가 결합됩니다. Unity Catalog이 그 역할을 수행합니다.
이 모든 것을 결합하면 스토리지 레이어부터 서빙 레이어까지 완전히 개방된 환경이 구축됩니다. 하단의 오브젝트 스토리지, 그 위의 개방형 테이블 포맷, 개방형 처리 엔진, 거버넌스를 위한 개방형 카탈로그, 그리고 최상위의 분석, 머신러닝 및 AI 애플리케이션을 위한 개방형 도구까지 모두 포함됩니다.
"오픈"은 오픈 소스와 같은 의미인가요?
꼭 그렇지는 않으며, 그 차이는 중요합니다. 오픈 소스는 프로젝트 코드에 대한 라이선스를 설명합니다. 레이크하우스 관점에서의 '오픈'은 더 광범위합니다. 개방형 파일 및 테이블 포맷, 개방형 API 및 도구 연결을 위한 표준 방식, 그리고 여러 엔진이 동일한 데이터에서 작동하는 생태계를 포괄합니다. 플랫폼이 오픈 소스 프로젝트로 구축되었더라도, 예를 들어 자체 엔진만 잘 읽을 수 있는 레이아웃으로 데이터를 저장함으로써 데이터를 가둘 수 있습니다. 개방성을 검증하는 진정한 방법은 간단합니다. 호환되는 모든 도구로 데이터를 읽을 수 있고, 데이터를 다시 작성하지 않고도 도구 간에 이동할 수 있어야 합니다.
개방형 테이블 포맷 vs. 오픈 레이크하우스: 어떤 차이가 있나요?
이 두 용어는 혼용되어 사용되곤 하지만, 서로 다릅니다. 개방형 테이블 포맷은 하나의 레이어입니다. 오브젝트 스토리지의 파일 위에 데이터베이스와 유사한 기능(신뢰할 수 있는 업데이트, 스키마 변경 및 이력)을 추가합니다. 오픈 레이크하우스는 해당 레이어를 둘러싼 모든 것, 즉 그 아래의 스토리지와 그 위의 컴퓨팅, 카탈로그 및 거버넌스를 의미합니다. 테이블 포맷은 하나의 구성 요소입니다. 레이크하우스는 전체 스택입니다.
| 측면 | 개방형 테이블 포맷 | 오픈 레이크하우스 |
|---|---|---|
| 범위 | 단일 레이어 | 전체 아키텍처 |
| 역할 | 파일에 테이블, 업데이트, 이력 추가 | 스토리지, 포맷, 컴퓨팅, 거버넌스 결합 |
| 예시 | Apache Iceberg, Delta Lake | 해당 포맷을 기반으로 구축된 전체 플랫폼 |
| 제공 기능 | ACID, 스키마 진화, 타임 트래블 | 단일 데이터 카피 상의 분석, BI, ML, 거버넌스 |
표에 사용된 두 가지 용어에 대한 설명입니다. ACID는 테이블을 손상시키지 않고 데이터 변경이 안정적으로 완료됨을 의미하며, 타임 트래블은 이전 시점의 데이터 상태를 조회하거나 복원할 수 있음을 의미합니다.
어떤 개방형 표준이 오픈 레이크하우스를 구동하나요?
이 레퍼런스 아키텍처는 5개의 오픈 소스 표준을 기반으로 구축되었으며, 각 표준은 중립적인 재단(Apache Software Foundation 또는 Linux Foundation)에서 관리하고 스택의 서로 다른 레이어를 담당합니다. 오픈 레이크하우스의 신뢰성은 이를 구성하는 프로젝트의 신뢰성에 달려 있으며, 이들은 틈새 프로젝트가 아닙니다. 이미 업계의 상당 부분이 채택하고 있는 표준이며, 대부분 Databricks에서 개발되었습니다. 이는 단순한 자랑이 아니라 검증 가능한 사실입니다. 2026년 초 기준, Apache Spark는 Fortune 500 기업의 약 80%에서 사용되고 있으며, 대규모 데이터 처리를 위해 가장 널리 채택된 엔진입니다. MLflow는 월간 다운로드 수 3,000만 건을 돌파했습니다. Delta Lake와 Apache Iceberg는 프로덕션 환경에 있는 레이크하우스 테이블의 대부분을 차지하고 있으며, 특히 Delta Lake는 가장 큰 설치 기반(installed base)을 보유하고 있습니다.
이들을 모두 합치면 GitHub 스타 수가 9만 개 이상이며, 월간 다운로드 수는 수천만 건에 달합니다. 각 프로젝트의 현재 현황(2026년 초 기준 GitHub 스타 수)은 다음과 같습니다.
| 프로젝트 | 레이어 | 채택 현황 |
|---|---|---|
| Apache Spark® | 처리 엔진 | GitHub 스타 43k+개, Fortune 500 기업의 약 80%가 사용 중 |
| Delta Lake | 테이블 포맷 | GitHub 스타 8k+개, 개방형 테이블 포맷 중 가장 큰 설치 기반 보유 |
| Apache Iceberg | 테이블 포맷 | GitHub 스타 8천 개 이상, 업계 전반에서 채택된 REST 카탈로그 |
| Unity Catalog | 거버넌스 | GitHub 스타 3천 개 이상, LF AI & Data Foundation에 기부됨 |
| MLflow | ML 및 AI | GitHub 스타 2만 6천 개 이상, 월간 다운로드 수 3천만 회 이상 |
Apache Spark
Apache Spark®는 처리 엔진입니다. 이 엔진은 2009년 UC 버클리 AMPLab에서 이후 Databricks를 설립한 팀에 의해 개발되었으며, Apache Software Foundation에 기부되어 대규모 데이터 처리를 위해 가장 널리 사용되는 엔진 중 하나가 되었습니다. 하나의 Spark 런타임이 배치 작업, 스트리밍, SQL, 머신러닝을 모두 처리하므로, 팀은 각 워크로드 유형마다 별도의 시스템을 유지 관리할 필요 없이 단일 엔진만 운영하면 됩니다. 레이크하우스에서 Spark는 원시 데이터를 읽고, 단계별로 정제한 다음, 그 결과를 오픈 테이블로 다시 기록합니다.
Delta Lake
Delta Lake는 오브젝트 스토리지가 단순한 파일 더미가 아닌 데이터베이스처럼 작동하도록 만드는 테이블 포맷입니다. 일반 Parquet 파일 위에 ACID 트랜잭션, 스키마 강제 적용, 타임 트래블 기능을 추가하여, 동시 작업이 서로의 쓰기 작업을 손상시키지 않으며 특정 과거 시점의 테이블 상태를 쿼리할 수 있습니다. 동반 라이브러리인 Delta Kernel은 읽기 및 쓰기 로직을 엔진에 구애받지 않는 컴포넌트로 패키징하여, Spark 이외의 엔진에서도 이 포맷을 더 쉽게 지원할 수 있도록 합니다. Delta Lake는 Databricks에서 개발되었으며 현재도 주요 기여자로 참여하고 있으며, Linux Foundation 프로젝트로 관리됩니다.
Apache Iceberg
Iceberg는 매우 큰 분석용 테이블과 엔진 간의 원활한 이동을 위해 구축된 두 번째 테이블 포맷입니다. Databricks가 아닌 Netflix에서 시작되었으며, 현재 널리 채택된 Apache 프로젝트입니다. Databricks는 Tabular 인수를 통해 합류한 Iceberg 창립 팀을 포함하여 주요 기여자로 참여하고 있습니다. 테이블 사양과 REST 카탈로그 덕분에 여러 엔진이 동일한 테이블을 쉽게 공유할 수 있으며, 이것이 둘 이상의 쿼리 엔진이 사용되는 곳마다 이 포맷이 등장하는 이유입니다. Delta Lake와 Iceberg를 모두 지원한다는 것은 팀이 첫날부터 하나의 포맷만 선택하고 그 결정을 평생 유지할 필요가 없음을 의미합니다.
Unity Catalog
Unity Catalog는 거버넌스 레이어입니다. 액세스 정책, 자격 증명 발급, 리니지를 한곳에서 관리하며, 엔진은 데이터를 우회하지 않고 이를 통해 데이터에 액세스합니다. 규칙이 특정 엔진 내부가 아닌 카탈로그에 존재하기 때문에 Spark, DuckDB 또는 다른 클라이언트 중 어디서 쿼리가 오든 액세스 제어와 리니지가 일관되게 유지됩니다. Unity Catalog는 Databricks에서 개발되었으며 현재 LF AI & Data Foundation 산하의 오픈 소스 프로젝트이며, Databricks에서 관리형 버전으로도 제공됩니다. 오픈 소스 릴리스는 관리형 제품보다 최신 버전이며 일부 거버넌스 기능은 아직 완성되는 중이므로, 요구 사항에 맞는지 오픈 소스 프로젝트를 확인해 보는 것이 좋습니다.
Unity Catalog가 유일한 오픈 카탈로그는 아닙니다. Apache Polaris, Project Nessie, Hive Metastore, AWS Glue가 동일한 역할을 수행하며, Iceberg REST 카탈로그가 이들 간의 공유 인터페이스로 부상하고 있습니다. 오픈 레이크하우스는 이 중 어떤 것이든 사용할 수 있습니다. 이 참조 아키텍처는 데이터, ML 및 AI 자산을 하나의 모델 아래에서 함께 거버넌스하기 때문에 Unity Catalog를 사용하지만, 카탈로그 레이어는 완전히 교체 가능합니다.
MLflow
MLflow는 머신러닝 및 AI를 위한 레이어입니다. 실험 추적, 모델 패키징, 모델 레지스트리, 평가 및 서빙을 처리하며, 이제 동일한 메커니즘이 AI 에이전트에도 적용되어 에이전트의 활동을 추적하고, 평가기를 기준으로 출력을 점수화하며, 예산 제한 및 가드레일이 있는 게이트웨이를 그 앞에 배치합니다. 별도의 스택을 따로 두지 않고 데이터를 거버넌스하는 동일한 오픈 플랫폼에서 모델과 에이전트를 실행하는 것이 이 버전의 레이크하우스가 가진 큰 차별점입니다. MLflow는 Databricks에서 개발되었으며 현재도 주요 기여자로 참여하고 있으며, Linux Foundation 프로젝트입니다.
오픈 레이크하우스의 레이어들은 어떻게 함께 작동하나요?
레이어들은 오픈 인터페이스를 통해 연결되므로 독점적인 기술 없이도 서로 잘 어우러지며, 다른 레이어에 영향을 주지 않고 어느 하나를 교체할 수 있습니다. 이것이 바로 다섯 개의 프로젝트를 하나의 아키텍처로 통합하는 비결입니다.
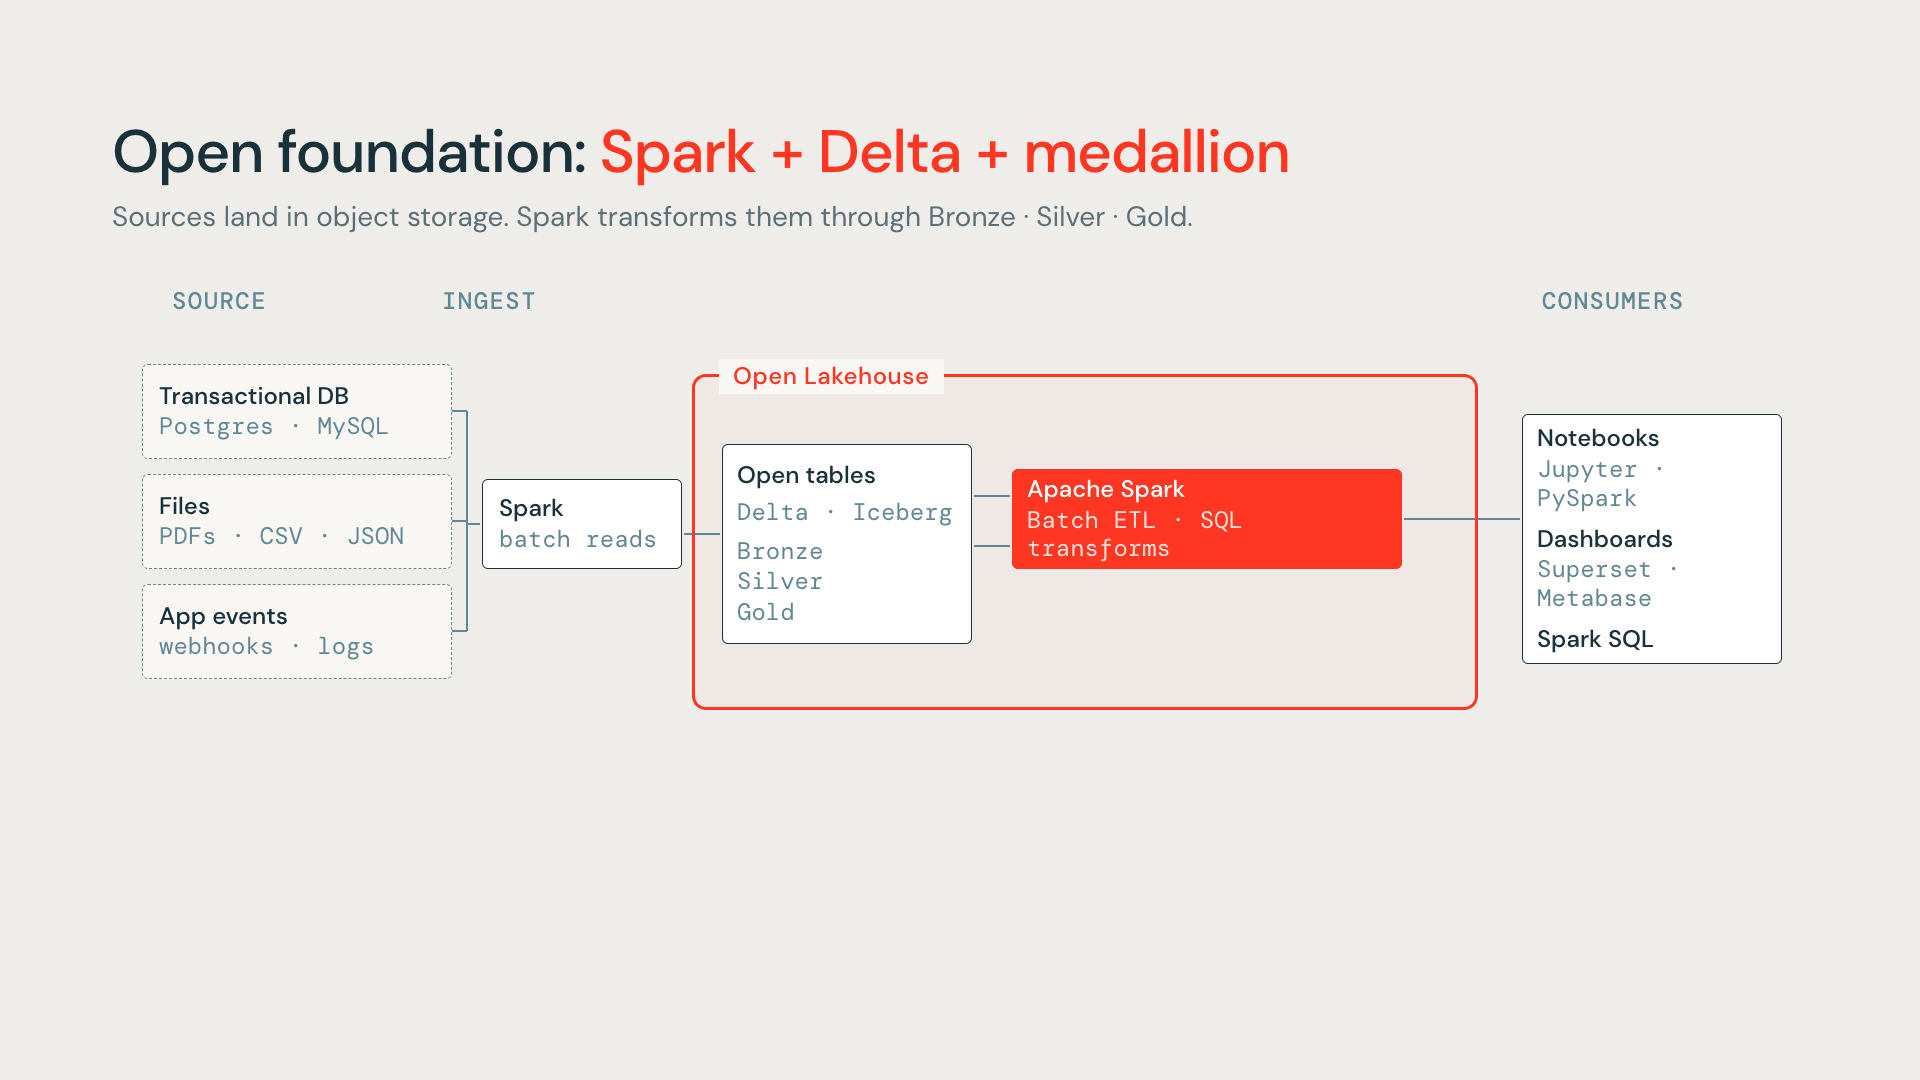
데이터부터 시작해 보겠습니다. Spark는 테이블을 Delta Lake 또는 Iceberg 형태로 오브젝트 스토리지에 기록합니다. 이러한 포맷은 오픈되어 있고, Delta Kernel과 Iceberg REST 카탈로그가 이를 중립적인 방식으로 노출하기 때문에 다른 엔진도 동일한 파일을 직접 읽을 수 있습니다. 먼저 독점 저장소로 데이터를 복사할 필요가 없으며, 나갈 때 내보내기 단계도 필요하지 않습니다.
거버넌스는 이 모든 것을 아우릅니다. 모든 엔진은 Unity Catalog를 통해 데이터에 액세스하므로, 한 번 작성된 정책이 모든 곳에 적용됩니다. 새로운 쿼리 엔진을 도입할 때도 액세스 규칙과 리니지를 처음부터 다시 만들 필요 없이 카탈로그를 가리키도록 설정하기만 하면 됩니다.
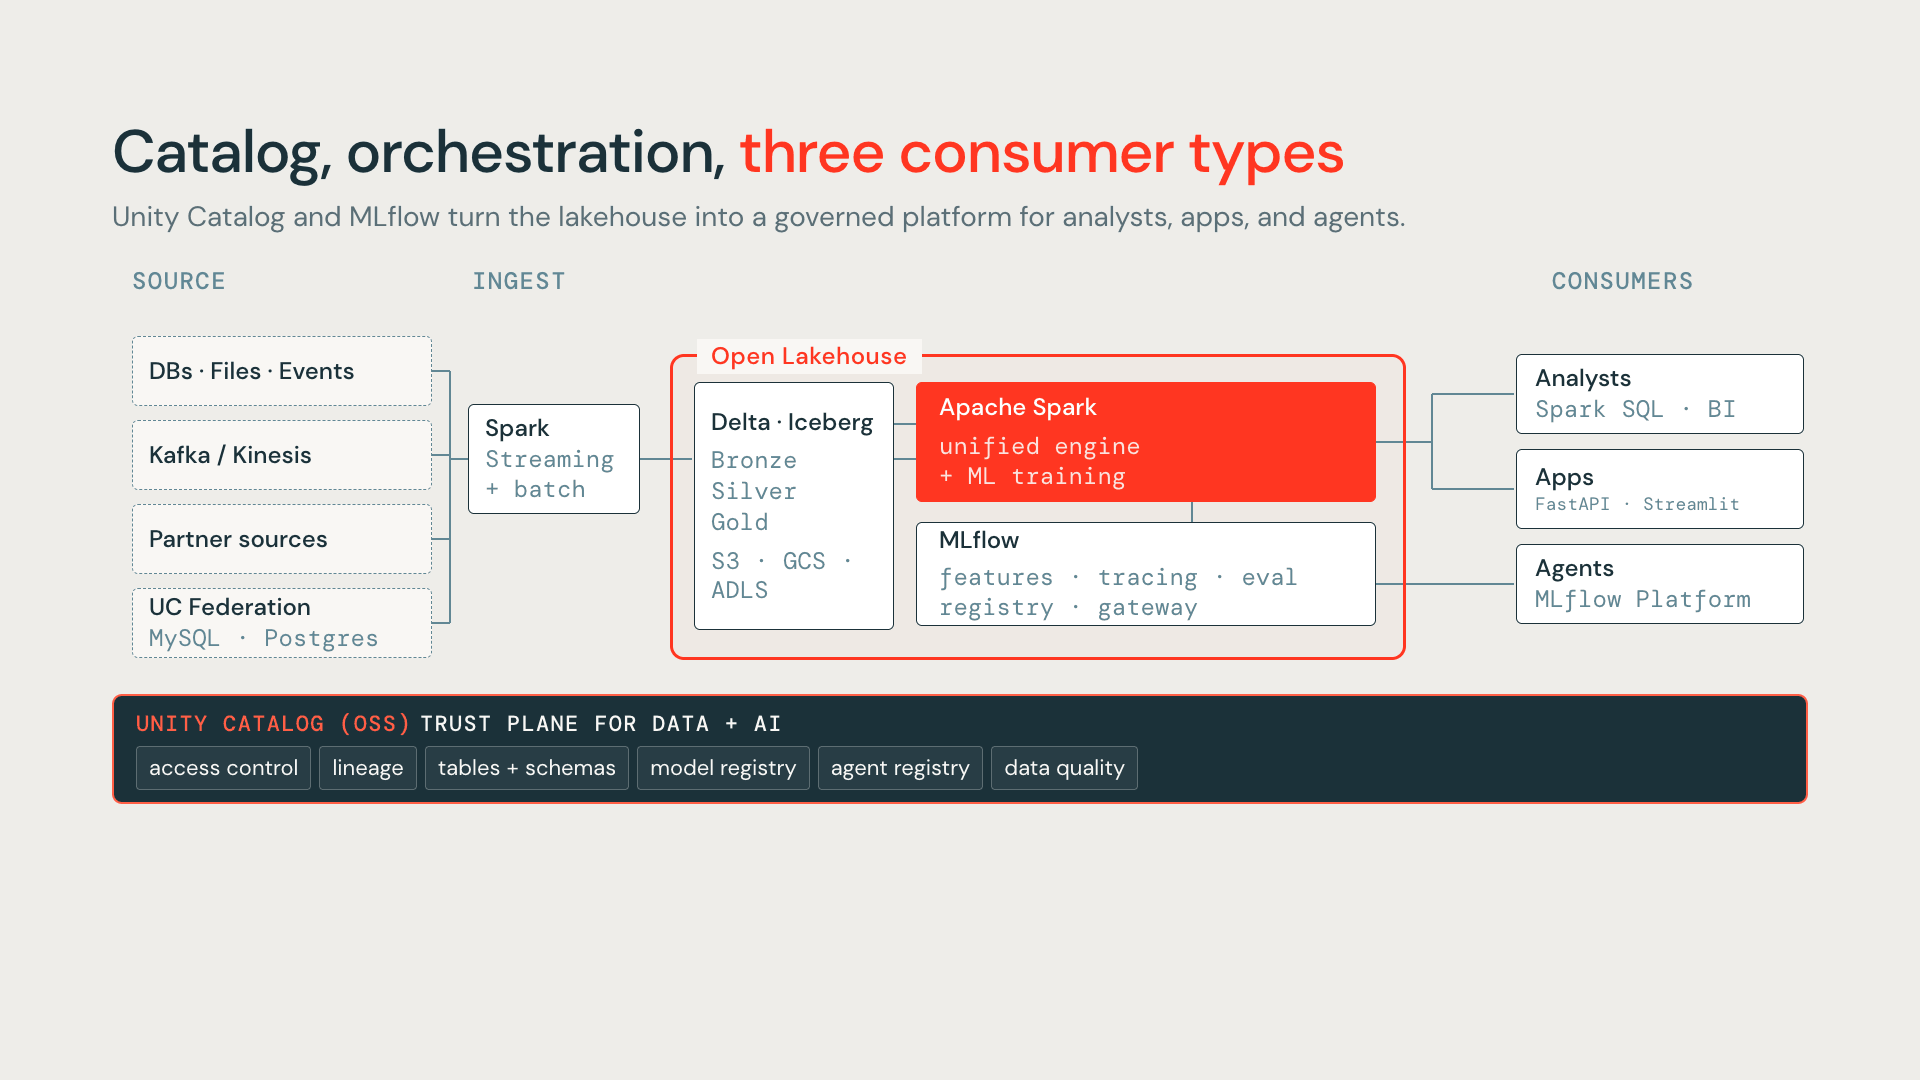
모델과 에이전트는 거버넌스가 적용된 동일한 데이터를 활용합니다. MLflow에서 학습된 모델은 Spark가 생성한 Gold 테이블을 읽습니다. 질문에 답변하는 에이전트는 인간 분석가와 동일한 정책에 따라 Unity Catalog를 통해 쿼리합니다. 원시 입력부터 배포된 모델 또는 에이전트의 답변까지 연결하는 리니지가 그 과정에서 기록됩니다. AI 레이어는 마지막에 임시방편으로 덧붙여진 것이 아니라, 다른 모든 요소와 마찬가지로 거버넌스가 적용된 동일한 영역을 통해 읽고 씁니다.
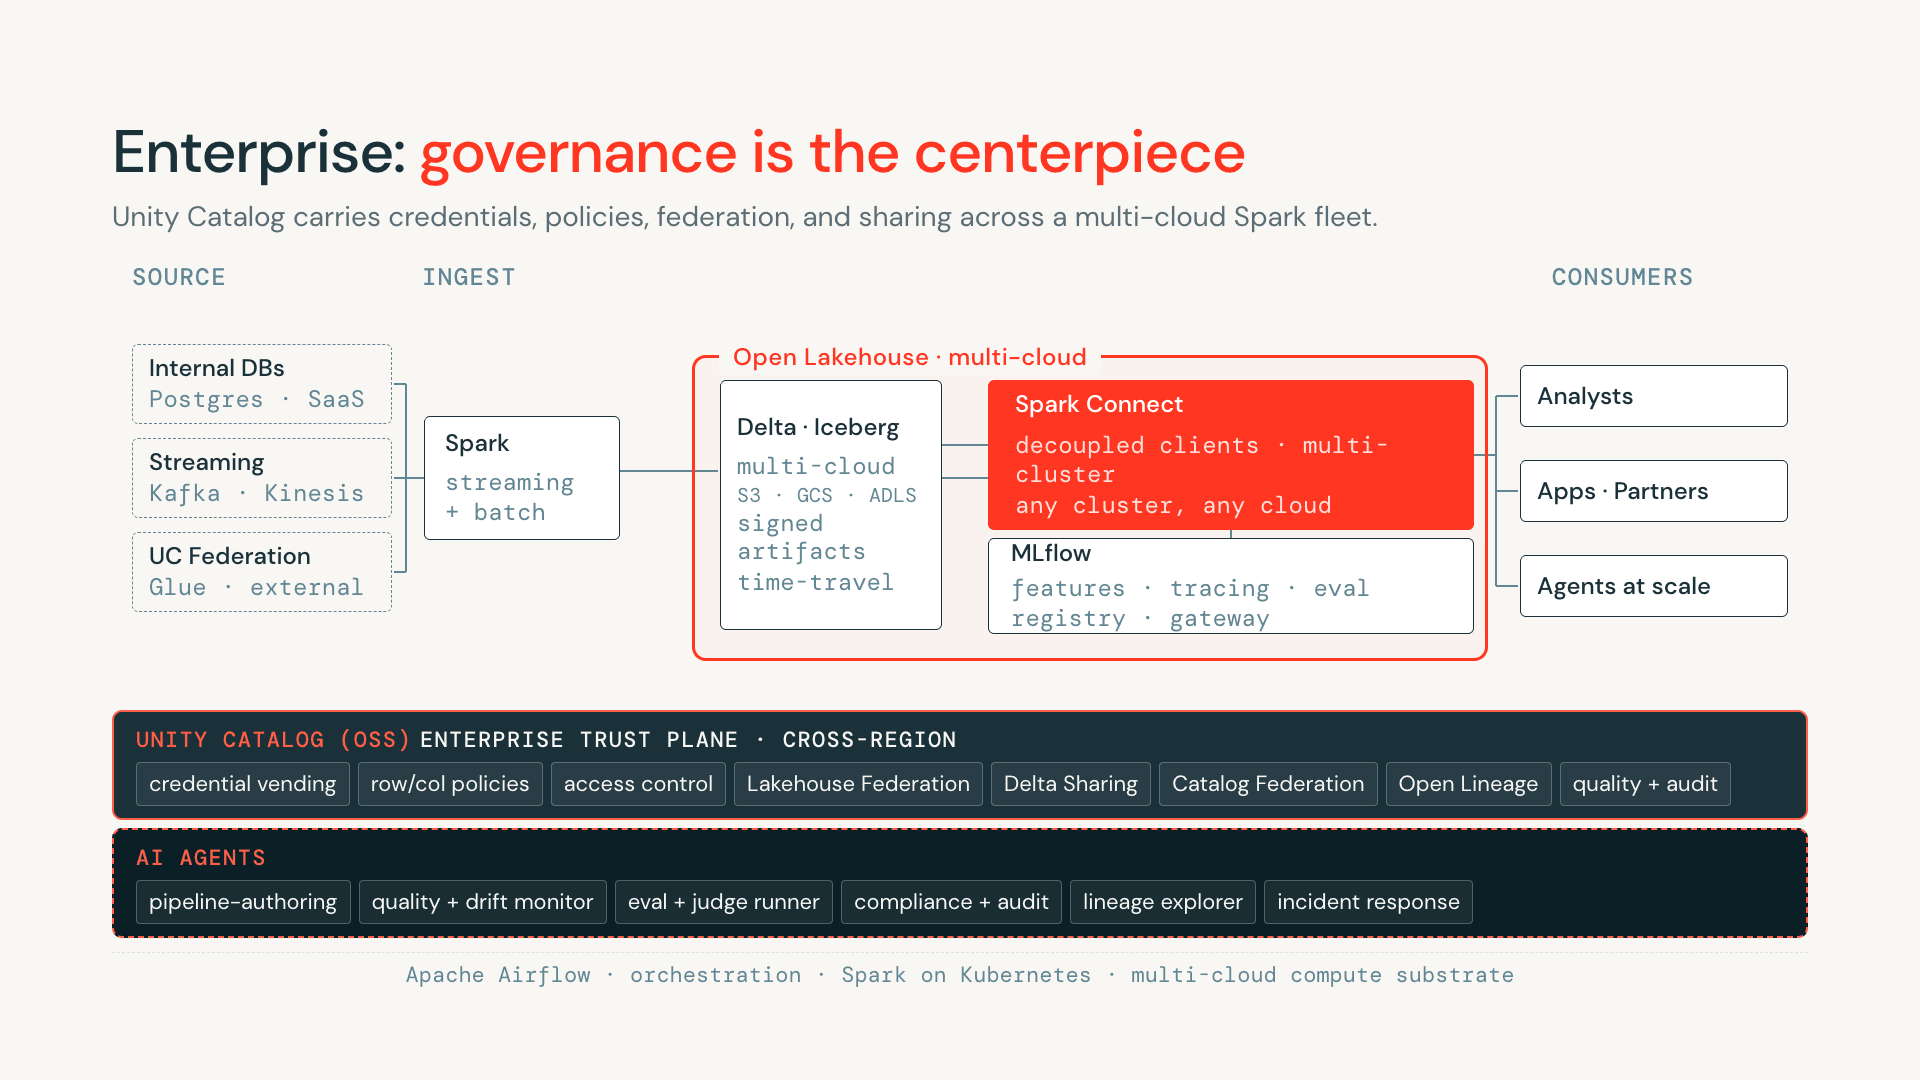
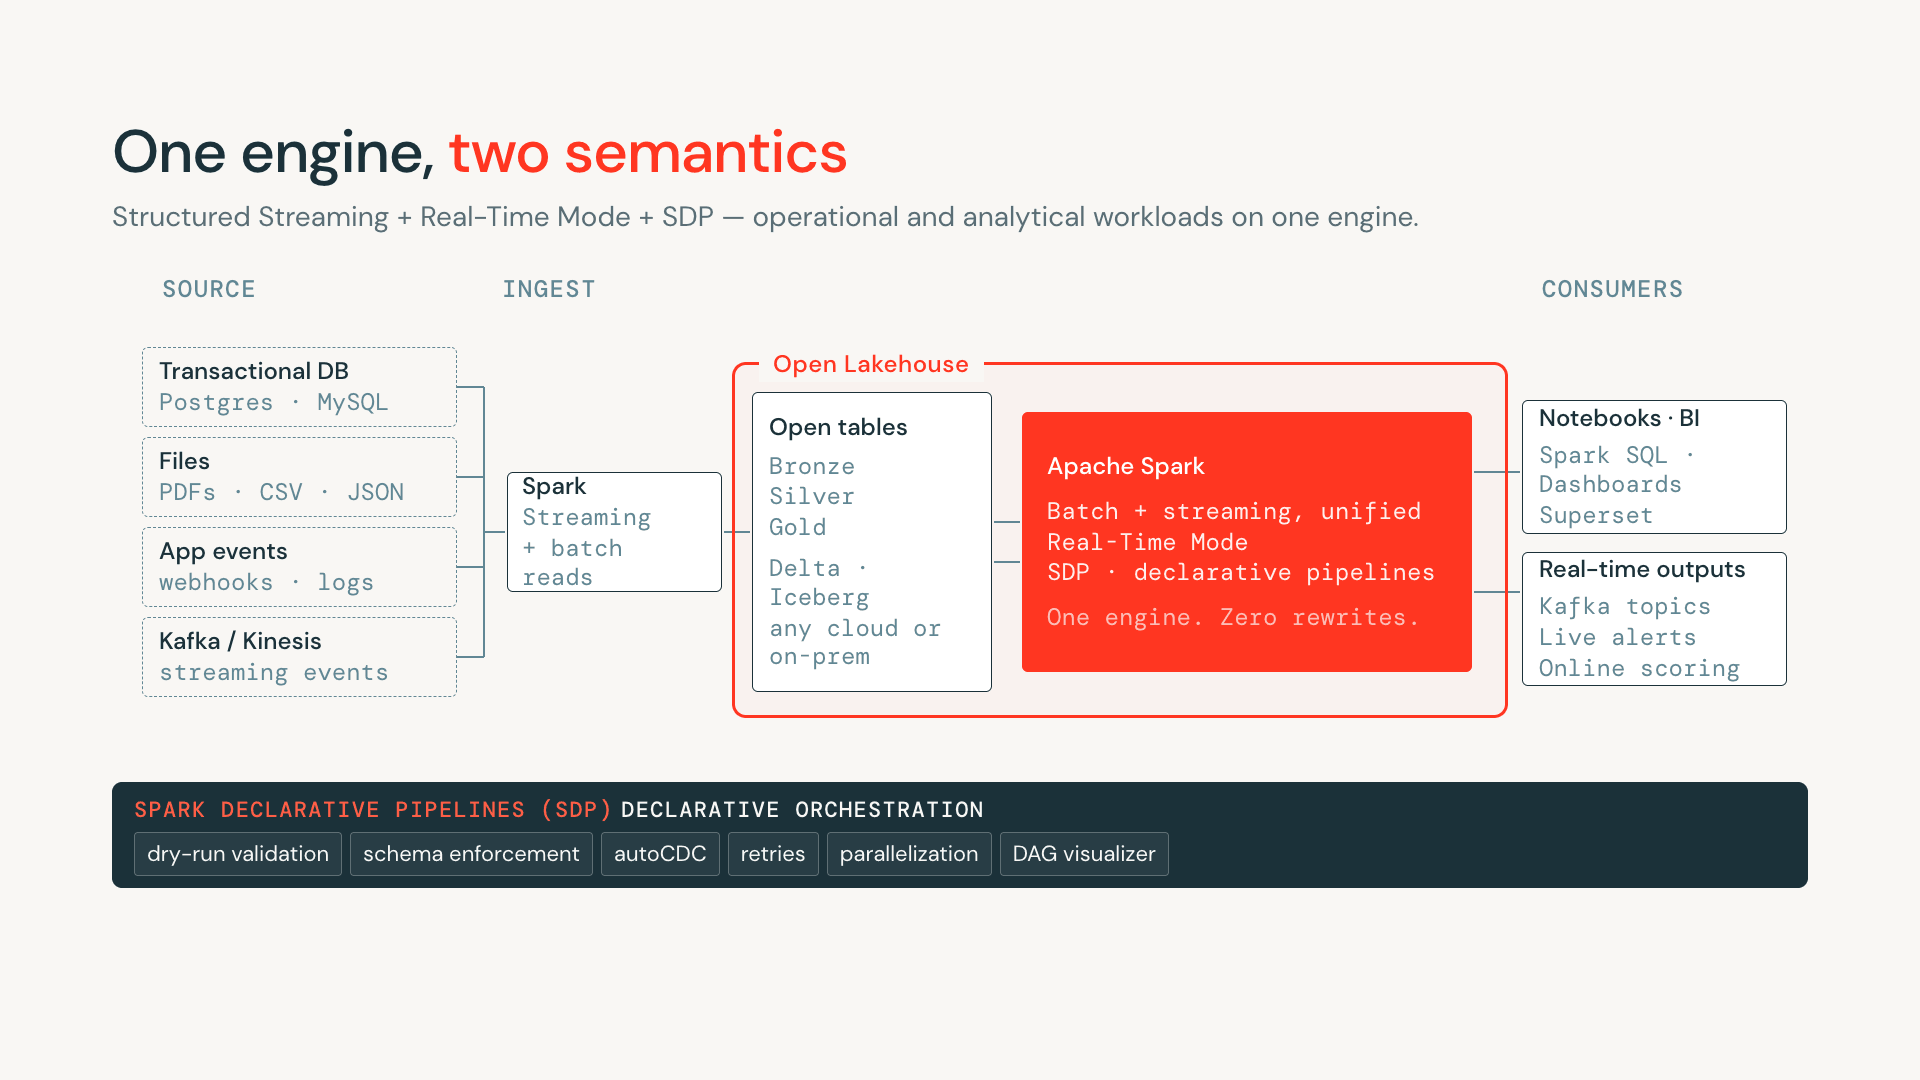
실질적인 이점은 레이어 간의 독립성입니다. 각 레이어는 인접한 레이어의 오픈 인터페이스에만 의존하기 때문에, 팀은 상위 또는 하위 레이어의 플랫폼을 다시 구축할 필요 없이 처리 엔진을 변경하거나, 쿼리 엔진을 추가하거나, 두 번째 테이블 포맷을 도입하거나, 다른 모델 프레임워크로 교체할 수 있습니다.
오픈 레이크하우스의 이점은 무엇인가요?
오픈 레이크하우스의 가장 큰 이점은 선택의 자유입니다. 단일 레이어가 특정 벤더에 종속되지 않으므로, 데이터 및 AI 요구 사항이 증가함에 따라 팀은 선택의 폭을 넓게 유지할 수 있습니다. 구체적인 이점은 다음과 같습니다.
- 종속성(Lock-in) 없음: 오픈 포맷을 사용하면 데이터를 마이그레이션하거나 다시 작성하지 않고도 도구를 변경할 수 있습니다.
- 비용 절감: 저렴한 스토리지에 단 하나의 데이터 복사본만 보관하므로 시스템 간의 데이터 중복을 방지할 수 있습니다.
- 멀티 엔진: BI, SQL, 머신러닝을 위해 동일한 데이터에서 여러 엔진을 실행할 수 있습니다.
- 통합 거버넌스: 단일 카탈로그를 통해 일관된 액세스 제어 및 리니지를 적용합니다.
- AI 준비 완료: 신뢰할 수 있는 통합 데이터를 통해 모델 학습, 피처 스토어, AI 에이전트를 지원합니다.
- 클라우드 자유도: 아키텍처를 재구축할 필요 없이 여러 클라우드에 걸쳐 워크로드를 실행할 수 있습니다.
비즈니스 성장에 따라 오픈 레이크하우스는 어떻게 확장되나요?
오픈 레이크하우스는 플랫폼을 다시 구축하는 대신 레이어를 추가하는 방식으로 확장됩니다. 작업에 필요할 때 더 많은 레이어를 활성화하면 되며, 새로운 레이어가 추가되어도 기존 레이어는 그대로 유지됩니다. 동일한 형태가 2인 규모의 팀부터 여러 지역에 걸쳐 있는 대기업에 이르기까지 모두 적합하며, 차이점은 단지 얼마나 많은 레이어가 활성화되어 있는지뿐입니다.
- 기본 ETL. 오브젝트 스토리지, Delta 테이블 및 Spark. 원시 데이터는 Bronze에 저장되고, Silver에서 정제되며, Gold에서 서비스됩니다. 이 메달리온 구성은 그 자체로 완전한 오픈 스택입니다.
- 스트리밍과 배치의 결합. 데이터가 도착하는 즉시 처리해야 하는 경우, Spark Structured Streaming 및 실시간 모드를 통해 동일한 엔진에서 배치와 함께 스트리밍을 실행하며, Spark 선언적 파이프라인이 변환을 정의합니다. 별도의 두 번째 스트리밍 시스템은 필요하지 않습니다.
- 공유 카탈로그와 최초의 에이전트. 분석가, 애플리케이션, 대시보드, 머신러닝에 모두 동일한 데이터가 필요해지면, Unity Catalog는 이들이 데이터를 읽는 공통 거버넌스 계층이 됩니다. 보통 이 단계에서 첫 번째 에이전트도 등장하여 데이터 품질을 모니터링하고, 파이프라인을 설계하고, 리니지(lineage)를 탐색합니다. 이 모든 작업은 다른 소비자와 마찬가지로 카탈로그를 통해 거버넌스 제어를 받습니다.
- 엔터프라이즈 규모. 리전과 클라우드 전반에 걸쳐 Unity Catalog는 자격 증명 발급(credential vending), 세분화된 정책, Lakehouse Federation 및 Delta Sharing을 추가하며, Spark는 Kubernetes에서 관리형 플릿으로 실행됩니다. 기반은 동일하며, 거버넌스와 컴퓨팅 리소스가 더 늘어날 뿐입니다.
오픈 레이크하우스에 AI는 어떻게 결합되나요?
오픈 레이크하우스에서 AI 애플리케이션과 에이전트는 나중에 임시로 덧붙인 별도의 시스템이 아니라, 다른 데이터 소비자와 완전히 동일하게 거버넌스 제어를 받는 일급(first-class) 워크로드입니다. 대부분의 레이크하우스 설명은 비즈니스 인텔리전스(BI)와 머신러닝 단계에서 멈추는데, 이는 이제 옆에 AI 상자 하나를 대충 붙여 놓은 2021년도 다이어그램처럼 보입니다. 에이전트를 동일한 데이터의 거버넌스 대상 소비자로 취급하는 것이야말로 이 버전을 최신 상태로 만드는 핵심입니다.
MLflow는 데이터를 거버넌스하는 플랫폼 위에서 실행되므로, 에이전트도 다른 모든 사용자와 동일한 규칙을 따릅니다. 에이전트는 Unity Catalog를 통해 데이터를 읽기 때문에 권한이 허용된 데이터만 볼 수 있습니다. 에이전트의 활동은 추적되고 그 답변은 모델 품질을 추적하는 것과 동일한 방식으로 MLflow의 평가기(evaluator)에 의해 점수가 매겨지며, 에이전트 앞단에 있는 게이트웨이는 비용을 제한하고 가드레일을 적용할 수 있습니다. 이 모든 과정에서 자체 데이터 복사본과 더 취약한 거버넌스를 가진 별도의 AI 스택은 전혀 필요하지 않습니다. 보통은 그런 식으로 우회하곤 하지만요.
구체적으로 살펴보면 다음과 같습니다.
- 속성(Attribution): 에이전트는 고유한 ID로 실행되므로, 공유 계정 뒤에 숨겨지지 않고 모든 작업이 주체(principal)로 추적됩니다.
- 범위가 지정된 자격 증명: 카탈로그는 수명이 긴 키 대신 수명이 짧고 범위가 제한된 자격 증명을 발급하므로, 다른 사용자와 마찬가지로 에이전트의 액세스를 제한하고 취소할 수 있습니다.
- 리니지(Lineage): 에이전트의 읽기 및 쓰기 작업이 기록되므로, 감사(audit)를 위해 원본 데이터부터 검색을 거쳐 답변에 이르는 경로를 재구성할 수 있습니다.
- 지출 및 가드레일: 예산 제한 및 콘텐츠 제어는 에이전트 자체 코드 외부의 게이트웨이에서 관리됩니다.
- 장애 모드(Failure mode): 액세스가 카탈로그를 통해 이루어지기 때문에, 카탈로그를 사용할 수 없을 때 거버넌스 제어가 없는 직접 읽기로 대체하는 대신 액세스를 차단하는 등 명시적인 설계 선택이 가능합니다.
에이전트의 ID는 자체 서비스 보안 주체(service principal)이거나 에이전트를 호출한 사용자의 위임 ID(대행 모델)일 수 있으며, 이 선택에 따라 에이전트의 활동이 감사 로그에 표시되는 방식이 결정됩니다. 뒤에서 설명할 독립형 MLflow 경로를 사용하면 레이크하우스 없이도 추적 및 평가 기능을 사용할 수 있지만, 위에서 언급한 카탈로그 강제 액세스 제어는 Unity Catalog가 구축되어 있어야만 적용됩니다.
실제로는 매우 명확하게 작동합니다. 에이전트가 권한이 없는 열을 요청하면 Unity Catalog는 읽기를 거부하고, 감사 로그에는 에이전트의 ID, 요청한 테이블 및 열, 시간, 거부 결정이 기록됩니다. 허용된 쿼리의 경우, 리니지를 통해 답변이 에이전트가 읽은 특정 Gold 테이블로 다시 연결됩니다.
핵심은 에이전트가 기존 아키텍처를 대체한다는 것이 아닙니다. 아키텍처에 자연스럽게 녹아든다는 점입니다. 에이전트는 거버넌스 제어를 받는 데이터를 소비하는 또 하나의 주체일 뿐이며, 주변의 파이프라인 및 모델과 동일한 오픈 도구로 빌드되고 모니터링됩니다.
실제로 오픈 레이크하우스가 필요할까요?
항상 그런 것은 아닙니다. 오픈 레이크하우스는 개방성과 확장성이 제값을 톡톡히 해낼 때 적합한 선택이며, 그렇지 않은 경우에는 과도한 스펙(overkill)이 될 수 있습니다. 다양한 데이터 유형이 있거나, 여러 팀 또는 엔진이 동일한 데이터를 공유하거나, 멀티 클라우드 요구사항이 있거나, 특정 벤더에 종속(lock-in)되지 않겠다는 명확한 목표가 있을 때 매우 적합합니다. 단순한 정형 데이터를 사용하고 도구 간 이동이 필요 없는 소규모 단일 도구 워크로드의 경우에는 과도할 수 있습니다.
실용적인 접근 방식은 전체 마이그레이션을 결정하기 전에 실제 요구사항과 연계된 제한된 범위의 파일럿(예: 기존 소스 하나를 페더레이션하거나 파이프라인 하나를 이전하는 작업)으로 시작하는 것입니다. 이 아키텍처는 한 번에 한 계층씩 도입할 수 있도록 설계되었으므로, 전부가 아니면 전무라는 식의 선택을 할 필요가 없습니다.
오픈 레이크하우스로 점진적으로 마이그레이션할 수 있나요?
네, 가능합니다. 오픈 레이크하우스는 기존 스택을 먼저 완전히 허물어버리라고 요구하는 대신, 기존에 실행 중인 시스템 옆에 한 번에 한 계층씩 유연하게 결합되도록 설계되었습니다. 아무것도 없는 상태에서 시작하는 팀은 거의 없습니다. 대부분은 이미 클라우드 데이터 웨어하우스, EMR, 데이터 카탈로그를 운영 중이거나 Iceberg 마이그레이션을 진행 중일 것입니다.
- 기존 클라우드 데이터 웨어하우스의 경우: Unity Catalog를 통해 페더레이션하여 거버넌스와 리니지가 도달하도록 설정하고, 데이터는 원래 위치에 그대로 둡니다.
- EMR Spark의 경우: 파이프라인 작성 계층만 Spark Declarative Pipelines로 마이그레이션하고, 이미 실행 중인 클러스터는 그대로 유지합니다.
- 별도의 카탈로그의 경우: Unity Catalog가 기존 카탈로그에서 수신할 수 있는 오픈 리니지 이벤트를 내보내도록 하여 두 카탈로그가 함께 작동하도록 합니다.
- Iceberg로 마이그레이션 중인 경우: 이미 설정한 카탈로그 위에 Unity Catalog를 얹고 다른 것은 아무것도 변경하지 않습니다.
이전 방식은 매번 동일합니다. 한 계층을 오픈 버전으로 교체하고, 손댈 이유가 생길 때까지 나머지는 그대로 두는 것입니다.
오픈 레이크하우스에서 정말 까다로운 부분은 무엇인가요?
오픈 레이크하우스에는 실제로 까다로운 부분들이 존재하며, 솔직하게 이를 짚고 넘어가야 합니다. 오픈 테이블 포맷은 작은 파일들이 누적되므로 정기적인 압축(compaction)과 유지 관리가 필요합니다. 여러 엔진에서 동시에 동일한 테이블에 쓰는 작업은 읽기 작업에 비해 아직 성숙도가 낮기 때문에 멀티 엔진 쓰기에는 주의가 필요합니다. 일부 구성 요소의 오픈 소스 릴리스는 몇 가지 기능 면에서 관리형 버전보다 뒤처질 수 있습니다. 그리고 전체 스택을 직접 호스팅하는 것은 상당한 운영 공수가 들어가는 일입니다. 포맷 및 카탈로그 계층에서의 개방성이 모든 형태의 벤더 종속을 없애주는 것도 아닙니다. 관리형 런타임, 독점 쿼리 가속기, 컴퓨팅 요금제 등은 플랫폼이 여전히 사용자를 묶어두는 요소이며, 오픈 계층과는 별개로 평가해 볼 가치가 있습니다. 그렇다고 해서 이 아키텍처를 사용하지 말아야 한다는 뜻은 아닙니다. 모든 계층을 직접 소유하는 데 따르는 정직한 비용일 뿐입니다.
오픈 레이크하우스를 직접 운영하려면 어떻게 해야 하나요?
모든 계층이 오픈 소스이므로 전체를 직접 운영할 수 있습니다. 각 계층을 함께 구축할 수 있는 오픈 참조 구현이 제공됩니다:
이를 통해 Apache Spark, Apache Kafka®, Apache Airflow®, Apache Iceberg, Delta Lake, Unity Catalog 및 MLflow를 Docker 환경에서 로컬로 시작할 수 있으며, 클라우드 배포를 위한 구성도 포함되어 있습니다. 처음에 AI 계층만 필요하다면 MLflow 단독으로 시작할 수 있습니다. pip install 및 기존 애플리케이션의 몇 줄의 코드만으로 충분하며, 나머지는 나중에 추가할 수 있습니다.
예를 들어, 하단에 레이크하우스가 없는 기존 에이전트를 MLflow가 가리키도록 지정할 수 있습니다:
기존 LangGraph 또는 OpenAI 에이전트는 변경 없이 그대로 실행되며, 해당 에이전트의 추적(trace), 프롬프트, 도구 호출이 MLflow에 표시됩니다. Postgres, 벡터 스토어, 모델 제공업체는 그대로 유지됩니다. 에이전트에 거버넌스 제어를 받는 엔터프라이즈 데이터가 필요할 때만 그 하단에 거버넌스가 적용된 레이크하우스를 추가하면 됩니다.
참조 리포지토리는 Apache 2.0 라이선스에 따라 제공되며 Databricks 개발자 관계(developer relations) 팀에서 유지 관리합니다. 새로운 기술은 아닙니다. 전체 스택을 한곳에 모아두고 싶을 때 사용할 수 있도록 위의 5가지 검증된 프로젝트를 Docker로 함께 연결한 것입니다. 각 계층은 독립적으로도 작동하며, 이 번들은 편의를 위한 것일 뿐 종속성을 의미하지는 않습니다. 오픈 레이크하우스를 직접 운영하는 것은 현실적으로 가능하지만 상당한 작업이 필요하며, 리포지토리도 이를 고려하여 구성되어 있습니다. 고가용성 패턴, 배포 구성, 관찰 가능성(observability)을 함께 제공하여 셀프 호스팅이 단순한 주장에 그치지 않고 실제로 지원되는 경로가 되도록 합니다.
오픈 레이크하우스는 여러분의 역할에 어떤 변화를 가져올까요?
- SQL 또는 dbt를 작성하는 경우: Spark Declarative Pipelines는 dbt에서 익숙한 것과 동일한 선언적 SQL 우선 작성 방식을 제공하며, 단일 엔진에서 배치와 함께 스트리밍, 그리고 풀 SQL 및 Python을 추가로 지원합니다. 이 모든 작업은 기존 BI 도구에서 여전히 쿼리할 수 있는 거버넌스 제어 대상 오픈 테이블을 대상으로 수행됩니다.
- 데이터 파이프라인을 구축하는 경우: 예를 들어 Spark Declarative Pipelines를 사용하여 파이프라인을 한 번만 작성하면 단일 엔진에서 배치 및 스트리밍을 모두 실행할 수 있습니다.
- 모델 또는 에이전트를 구축하는 경우: 다른 모든 사용자와 동일한 액세스 규칙에 따라 거버넌스 제어를 받는 동일한 데이터를 대상으로 MLflow에서 모델이나 에이전트를 빌드, 평가 및 서빙합니다.
- 플랫폼을 직접 운영하는 경우: 비즈니스가 성장함에 따라 레이어를 추가하고, 나머지 레이어를 재구축할 필요 없이 그 중 하나를 교체할 수 있습니다.
어떤 플랫폼이 오픈 레이크하우스를 지원하나요?
현재 여러 플랫폼이 오픈 레이크하우스 원칙을 구현하고 있습니다. Databricks, Snowflake, Google Cloud, Microsoft Fabric, Cloudera, Dremio, Starburst, Qlik 모두 이 분야에서 제품을 제공합니다. 이들은 아키텍처 자체가 아니라 오픈 레이크하우스 개념을 기반으로 구축된 제품이며, 각 레이어가 실제로 얼마나 개방되어 있는지에 따라 차이가 있습니다.
Databricks는 레이크하우스 카테고리를 창시했으며, 스토리지를 위한 Delta Lake 및 Apache Iceberg와 거버넌스를 위한 Unity Catalog를 사용하여 오픈 기반에서 데이터 웨어하우스급 성능을 제공합니다. Databricks 플랫폼은 스택을 직접 운영하는 것을 선호하지 않는 팀을 위해 이를 관리형 서비스로 제공합니다.
자주 묻는 질문
오픈 레이크하우스는 데이터 레이크하우스와 같은 것인가요?
데이터 레이크하우스는 레이크 스토리지에서 웨어하우스 스타일로 관리하는 아키텍처입니다. 오픈 레이크하우스는 모든 레이어(스토리지, 테이블 포맷, 엔진, 카탈로그, 그 위의 ML 및 AI 도구)가 오픈 소스이며 상호 호환이 가능하여 특정 벤더에 종속되지 않는 데이터 레이크하우스입니다.
Iceberg와 Delta Lake 중 어떤 것을 사용해야 하나요?
둘 다 ACID 트랜잭션, 스키마 진화(schema evolution), 타임 트래블 기능을 갖춘 오픈 테이블 포맷이며, 오픈 레이크하우스는 둘 중 하나 또는 둘 다 사용할 수 있습니다. Delta Lake는 Spark와 긴밀하게 결합되며 Delta Kernel을 통해 다른 엔진에서도 점점 더 많이 읽을 수 있습니다. Iceberg는 REST 카탈로그를 통해 광범위한 멀티 엔진 액세스가 가능하도록 설계되었습니다. 둘 다 지원하므로 처음부터 하나만 선택할 필요는 없습니다.
오픈 레이크하우스를 구축하려면 5가지 프로젝트가 모두 필요한가요?
아닙니다. 이 아키텍처는 점진적으로 확장하도록 설계되었습니다. 기본적인 오픈 레이크하우스는 오브젝트 스토리지, 테이블 포맷, Spark만으로 구성됩니다. 여러 사용자 간의 거버넌스나 머신러닝 또는 AI 워크로드가 필요해지면 Unity Catalog와 MLflow를 추가합니다.
Databricks 없이도 오픈 레이크하우스를 운영할 수 있나요?
네, 가능합니다. 모든 레이어는 오픈 소스이며 자체 인프라에서 실행됩니다. 레퍼런스 구현은 Docker를 사용하여 로컬에서 전체 스택을 시작하며, 머신러닝 레이어는 단 한 번의 pip install로 단독 사용할 수 있습니다. Databricks는 이러한 오픈 컴포넌트의 관리형 버전을 제공하지만, 셀프 호스팅도 지원되는 방식입니다.
오픈 레이크하우스에서 AI 에이전트는 어디에 위치하나요?
에이전트는 별도의 시스템이 아니라 거버넌스가 적용되는 데이터 소비자로 취급됩니다. 에이전트는 사람이나 다른 엔진과 동일한 정책에 따라 Unity Catalog를 통해 데이터를 읽으며, 모델과 함께 MLflow에서 빌드, 추적 및 평가되므로 AI 레이어가 별도로 추가되는 대신 동일한 오픈 거버넌스 아키텍처 내에 유지됩니다.
오픈 레이크하우스의 비용은 얼마나 드나요?
오픈 소스 컴포넌트는 Apache 2.0 및 Linux Foundation 라이선스에 따라 무료로 사용할 수 있습니다. 발생하는 비용은 오브젝트 스토리지, 실행하는 컴퓨팅 자원, 그리고 스택을 유지 관리하기 위한 운영 노력입니다. 직접 운영하면 라이선스 비용 대신 엔지니어링 시간이 소요되는 반면, Databricks와 같은 관리형 플랫폼을 사용하면 동일한 오픈 기반에서 엔지니어링 시간 대신 구독 비용을 지불하게 됩니다.
오픈 레이크하우스는 프로덕션 환경에서 바로 사용할 수 있나요?
네, 그렇습니다. 5가지 핵심 프로젝트는 이미 대규모 프로덕션 환경에서 실행 중인 성숙한 표준입니다. 예를 들어 Fortune 500대 기업의 약 80%에서 Apache Spark를 사용하고 있으며, MLflow는 월간 다운로드 수가 3,000만 건이 넘습니다. 프로덕션 환경에서 주로 고려해야 할 사항은 운영 측면입니다. 테이블 유지 관리 및 컴팩션(compaction), 멀티 엔진 쓰기 시 주의 사항, 관리형 서비스를 사용하지 않을 경우의 셀프 호스팅 작업 등이 있습니다.
Apache, Apache Spark, Apache Iceberg, Apache Kafka, Apache Airflow, Apache Parquet 및 Apache feather 로고는 미국 및/또는 기타 국가에서 Apache Software Foundation의 등록 상표 또는 상표입니다. Delta Lake, MLflow 및 Unity Catalog는 LF Projects, LLC의 상표입니다. 기타 모든 마크는 해당 소유자의 자산입니다.
전체 작동 과정을 확인하려면 레퍼런스 아키텍처를 클론하고 github.com/open-lakehouse/open-lakehouse에서 엔드투엔드로 실행해 보세요. AI 측면부터 시작하는 경우 MLflow 단독으로도 좋은 시작점이 될 수 있으며, 모델과 에이전트에 거버넌스가 적용된 데이터가 필요할 때 나머지 스택을 활용할 수 있습니다. 완전 관리형 방식을 선호하시나요? 동일한 오픈 기반이 Databricks 레이크하우스 플랫폼을 지원합니다.
(이 글은 AI의 도움을 받아 번역되었습니다. 원문이 궁금하시다면 여기를 클릭해 주세요)
최신 게시물을 이메일로 받아보세요
블로그를 구독하고 최신 게시물을 이메일로 받아보세요.