Bringen Sie Databricks mit der Databricks Power in die Kiro-IDE
Zwei Wege, die Kiro-IDE mit der Databricks Platform zu verbinden: die vier von Databricks verwalteten MCP-Server für einen 10-Minuten-Einstieg oder die Databricks Power mit den offiziellen Agent-Skills für den vollen Funktionsumfang.
- Zwei Wege, die Kiro-IDE mit Databricks zu verbinden: die vier von Databricks verwalteten MCP-Server (Genie, SQL, Unity Catalog Functions, AI Search) für eine PAT-basierte Einrichtung in 10 Minuten oder die Databricks Power, die die offiziellen Databricks-Agent-Skills mit der Databricks CLI installiert.
- KI-gestützte Entwicklung auf Basis echter Workspace-Metadaten: Beide Wege übernehmen Ihre Unity Catalog-Berechtigungen, Zeilenfilter und Spaltenmasken, sodass der Assistent SQL mit Ihren tatsächlichen Spalten schreibt und nur sieht, was Sie sehen dürfen.
- Wählen Sie nach Funktionsumfang: Weg A ist die schlankste Einrichtung für Analysten und SQL-orientierte Entwickler; Weg B bringt die gesamte Databricks-Plattform (Pipelines, Jobs, Agent Bricks, Lakebase, Declarative Automation Bundles) in die IDE.
Warum das wichtig ist
KI-gestützte Entwicklung scheitert in dem Moment, in dem der Assistent Spaltennamen, Tabellenstrukturen oder die für Sie lesbaren Kataloge erraten muss. Die Lösung ist Grounding: Verbinden Sie den Assistenten über das Model Context Protocol (MCP) mit Live-Metadaten aus dem Workspace. Dann verwendet das SQL, das er schreibt, Ihre tatsächlichen Spalten, dbt-Modelle verknüpfen echte Tabellen, und jede Abfrage übernimmt die Unity Catalog-Berechtigungen, die Sie bereits eingerichtet haben. Der Zugriff wird in Databricks durchgesetzt, sodass die KI nur sieht, was Sie sehen dürfen.
Zwei Meilensteine machen das jetzt in der Kiro-IDE von AWS praktikabel:
Erstens ist Kiro jetzt ein unterstützter Agent in der Databricks CLI. Seit CLI v1.20.0 installiert databricks aitools install --agents kiro die offiziellen Databricks-Agent-Skills in ~/.kiro/skills/. Die Skills, die früher im Databricks AI Dev Kit enthalten waren, sind jetzt diese offiziellen Skills, und die CLI installiert sie.
Zweitens installiert die Databricks Power im Kiro Powers-Katalog jetzt genau diese offiziellen Skills: Sie richtet die Skills mit der Databricks CLI ein und liefert keinen MCP-Server mit. Installieren Sie sie über das Powers-Panel; ihr Setup-Skill führt Sie durch die CLI-Prüfung, die Anmeldung und die Installation der Skills.
Zusammen mit den vier von Databricks verwalteten Remote-MCP-Servern, die bereits Teil der Plattform sind, haben Sie zwei Möglichkeiten, Kiro mit Databricks zu verbinden. Beide führen zum selben Ergebnis: Entwickler liefern Analysen, Pipelines und Agent-Workflows schneller, wenn der Assistent echte Workspace-Berechtigungen übernimmt, statt Schemas, Spalten und Berechtigungen zu erraten.
Warum Databricks für KI-gestützte Entwicklung
Die beiden Meilensteine oben machen Kiro × Databricks praktikabel. Entscheidend ist jedoch, was darunter liegt. Vier Dinge machen Databricks zur ersten Wahl als Grundlage für KI-gestützte Entwicklung, unabhängig davon, welchen Weg Sie wählen.
Unity Catalog verankert KI auf Datenebene. Jeder Aufruf läuft mit Ihren eigenen Berechtigungen, egal ob es ein MCP-Tool auf Weg A oder ein Databricks CLI-Befehl ist, den ein Skill auf Weg B ausführt: Tabellenberechtigungen, Zeilenfilter und Spaltenmasken gelten für SQL und Genie-Agents, und AI Search-Indizes werden einzeln freigegeben. Der Assistent hat keine privilegierte Sicht auf Ihre Daten; er sieht, was Sie sehen. Es gibt keine separate Zugriffskontrollebene, die Sie für den Assistenten verwalten müssen.
Eine Kopie der Daten, ein Satz Definitionen. Da Databricks ein Lakehouse ist, ist die Tabelle, die der Assistent über databricks-sql abfragt, dieselbe Tabelle, in die Ihr dbt-Modell schreibt, dieselbe, die Ihr Genie-Agent bereitstellt, und dieselbe, aus der Ihr AI/BI-Dashboard liest. Es gibt keine Synchronisierung zwischen Warehouse und Lake, die ausfallen kann, und keine separate semantische Schicht, die synchron gehalten werden muss. Wenn sich der Assistent an samples.tpch.lineitem orientiert, nutzt er dieselbe Definition wie jedes andere Tool.
Der komplette KI-Stack ist integriert, nicht nachträglich angebaut. Unity Gateway leitet Modellaufrufe weiter. Agent Bricks orchestriert Multi-Agent-Workflows. MLflow verfolgt Experimente und Evaluierungen. AI Search ermöglicht semantisches Retrieval. Lakebase verwaltet den Transaktionsstatus. Die Skills decken all das ab (databricks-unity-gateway, databricks-agent-bricks, databricks-mlflow-evaluation, databricks-vector-search und databricks-lakebase), alles auf demselben Unity Catalog. Sie fügen nicht fünf Produkte zusammen, sondern nutzen eine Plattform.
Die Skills stammen von Databricks. Die Protokolle sind offen, aber die Anleitungen in den Skills hat Databricks speziell für die Arbeitsweise unserer Kunden geschrieben.
Die beiden Wege im Überblick
Dimension | Weg A: Verwaltete MCP-Server | Weg B: Databricks Power |
|---|---|---|
Funktionsumfang | 4 Server: Genie, SQL, Unity Catalog Functions, AI Search | Offizielle Databricks-Agent-Skills plus die MLflow-Skills |
Was Sie erhalten | SQL in natürlicher Sprache, semantische Suche, kontrollierte Ausführung von Funktionen | Umfang von Weg A plus Pipelines, Jobs, Dashboards, Lakebase, Agent Bricks, Declarative Automation Bundles, MLflow, Model Serving, Apps |
Hosting | Von Databricks verwaltet (Remote-HTTPS) | Skills, die die Databricks CLI (databricks aitools) auf Ihrem Rechner installiert; kein MCP-Server |
Authentifizierung | PAT in der Shell-Umgebung | Databricks CLI-Profil, OAuth U2M empfohlen |
Einrichtung | ~/.kiro/settings/mcp.json bearbeiten, Umgebungsvariablen exportieren | Die Power installieren, dann ihre geführte CLI-Einrichtung |
Ideal für | Analysten und SQL-orientierte Entwickler, die in 10 Minuten ihrem Warehouse eine Frage stellen möchten | Data Engineers und Plattformentwickler, die den vollen Databricks-Funktionsumfang in einer IDE benötigen |
Integrationsarchitektur im Überblick
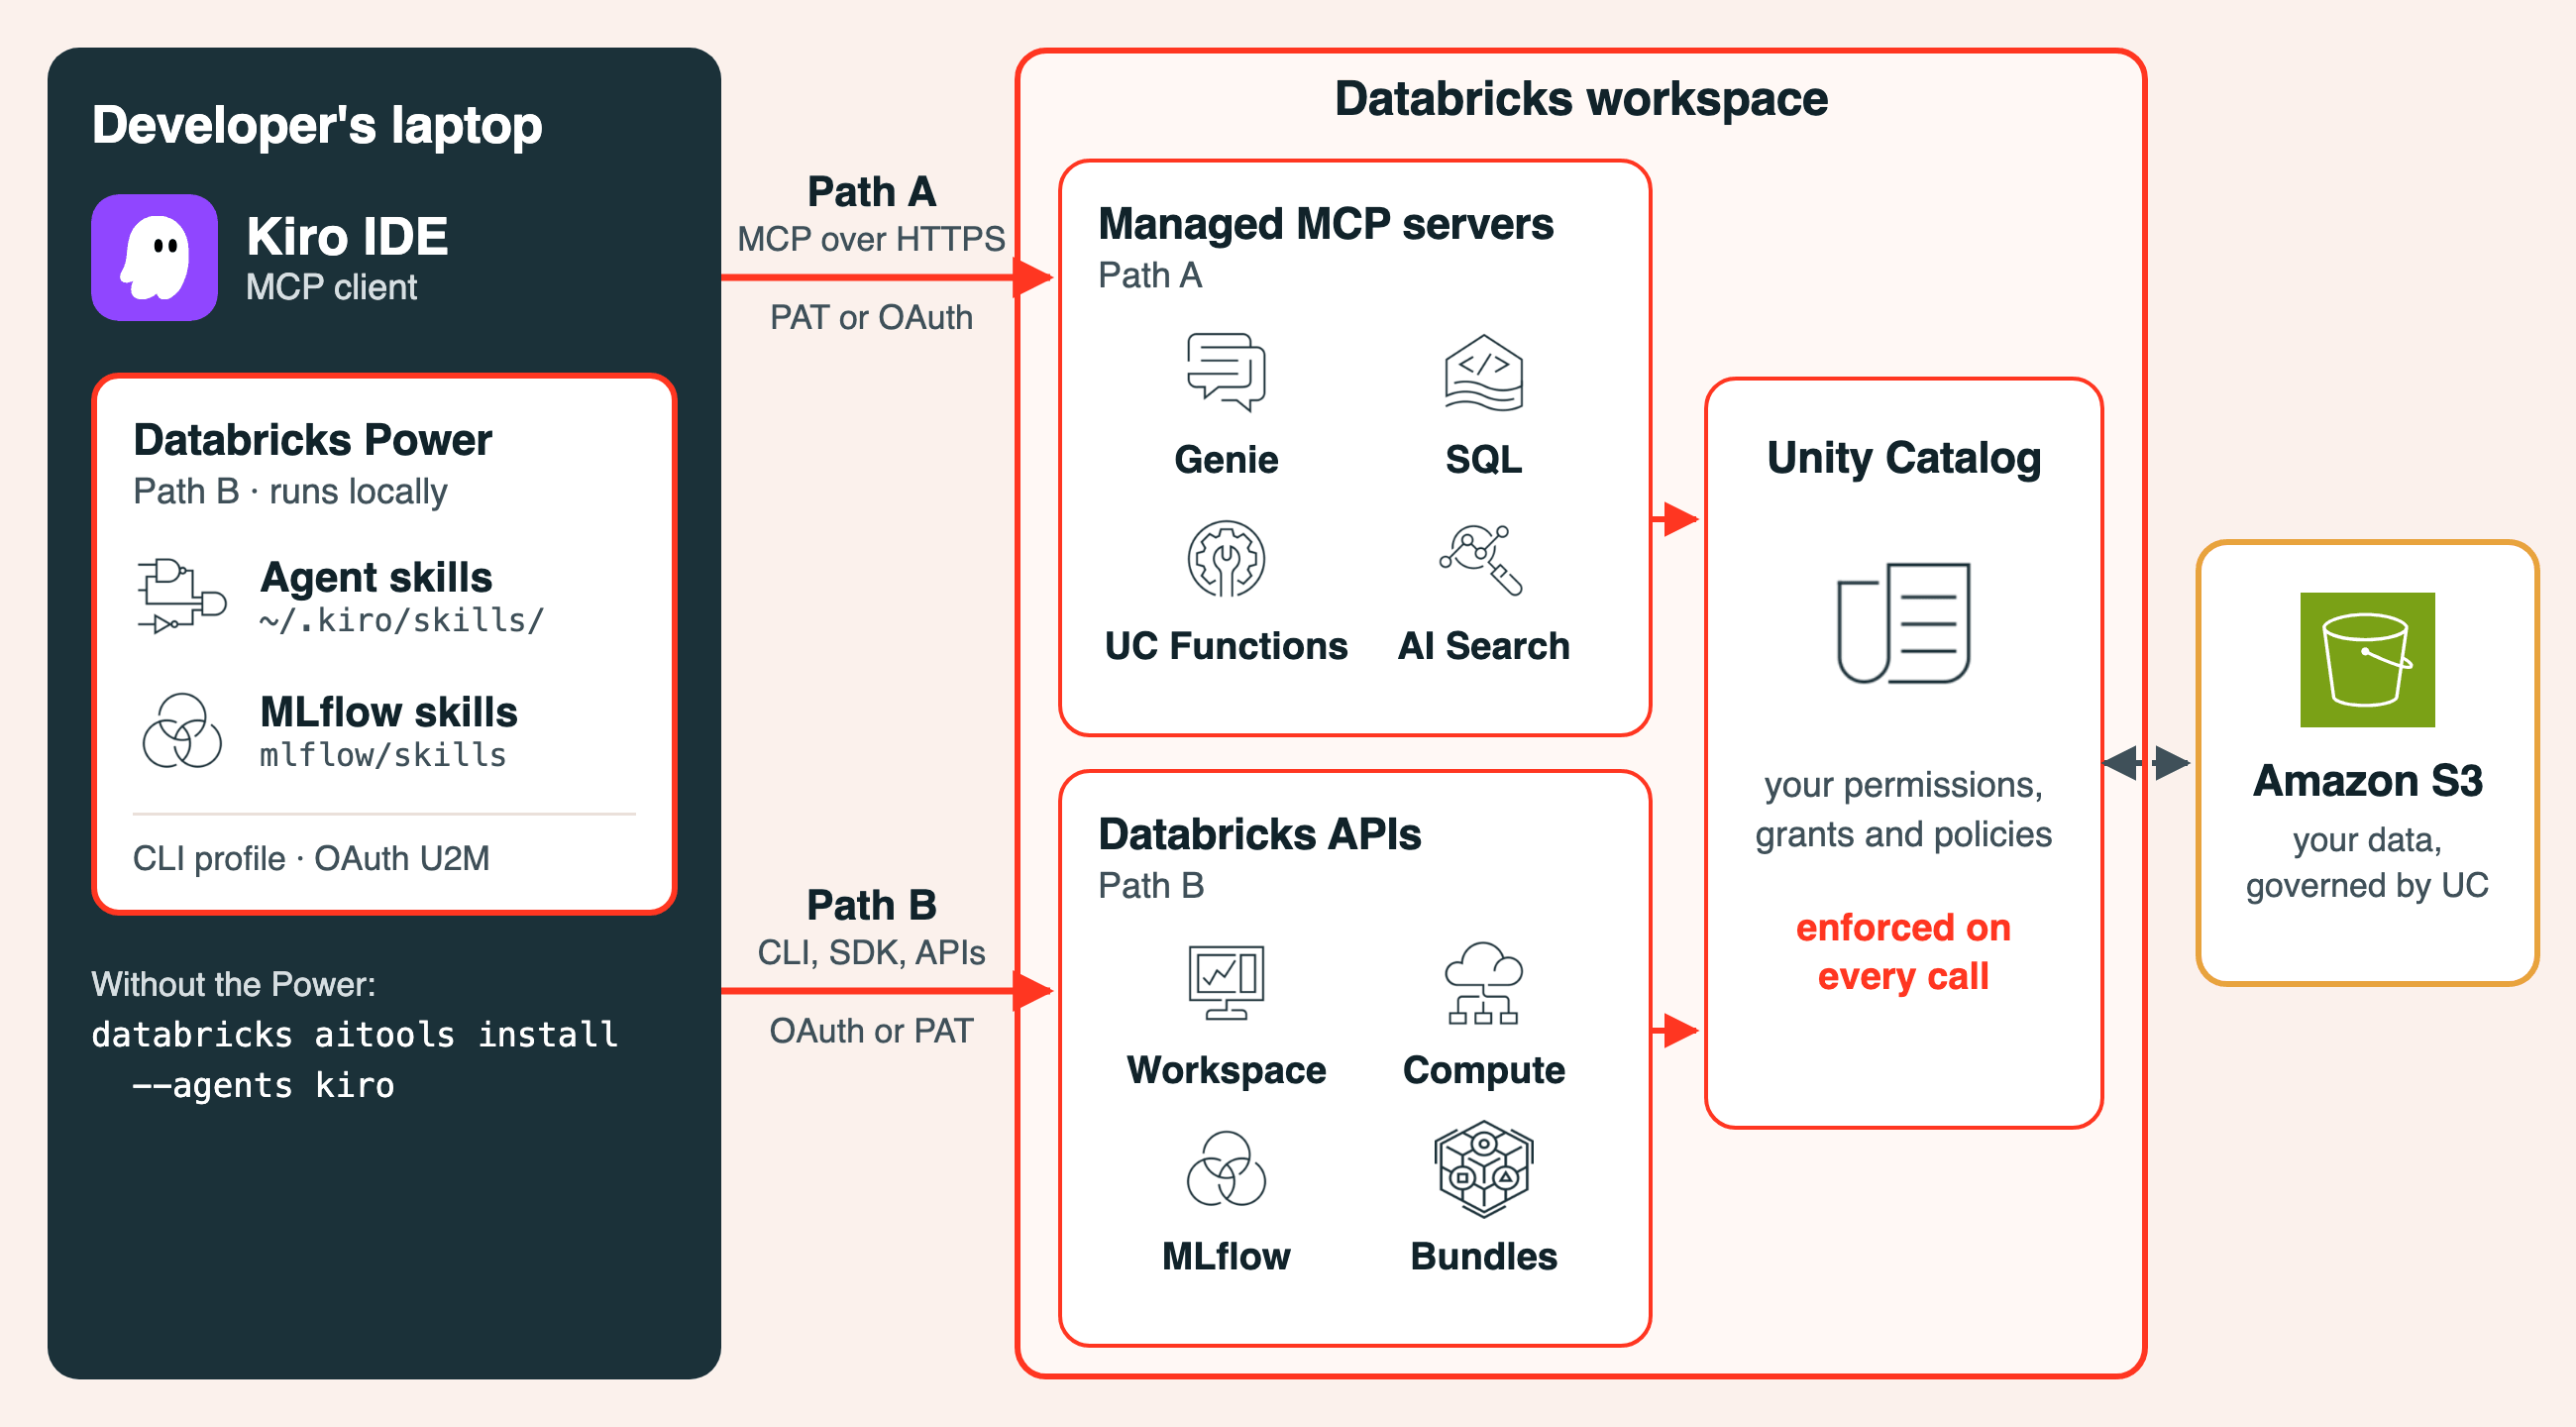
Beide Wege nutzen dasselbe Back-End: die Durchsetzung durch Unity Catalog und die Databricks Workspace-Identität. Sie unterscheiden sich im Funktionsumfang und im Authentifizierungsmodell.
Weg A: Verbindung mit den vier verwalteten MCP-Servern
Das ist die schlankste Einrichtung: eine mcp.json-Datei, ein Databricks Personal Access Token und eine Änderung am Shell-Profil. In weniger als 10 Minuten kommuniziert Kiro mit Genie, SQL, Unity Catalog Functions und AI Search.
Für neue Integrationen empfiehlt Databricks jetzt die system.ai-MCPs über Unity Gateway. Die vier /api/2.0/mcp-Endpunkte auf diesem Weg befinden sich in der Public Preview und werden nicht von Unity Gateway gesteuert. Der Zugriff richtet sich weiterhin nach Ihren Berechtigungen für die zugrunde liegenden Ressourcen (Genie-Agents, Tabellen, Funktionen, Indizes und SQL-Warehouses); Sie verzichten lediglich auf das Tracing von Unity Gateway und dessen Berechtigungen, Richtlinien und Guardrails auf MCP-Ebene. Das Genie One MCP (system.ai.genie_one_mcp) ist allgemein verfügbar, und der Setup-Skill der Databricks Power zeigt, wie Sie es zu mcp.json hinzufügen. Beide Optionen finden Sie unter Databricks-provided MCPs.
Voraussetzungen
- Ein Databricks Workspace auf AWS mit aktiviertem Unity Catalog.
- Ein Workspace-Administrator hat Managed MCP Servers auf der Previews-Seite des Workspace aktiviert. Ohne diese Einstellung funktionieren die unten aufgeführten URLs nicht.
- Ein Databricks Personal Access Token (PAT) oder OAuth-Token mit Scopes für die MCP-Server, die Sie nutzen möchten (
sql,unity-catalog,genie,ai-search). Ungenutzte PATs werden nach 90 Tagen automatisch widerrufen. - Kiro ist installiert und wurde mindestens einmal gestartet, sodass
~/.kiro/existiert. - Der Hostname Ihres Workspace im Format
<workspace>.cloud.databricks.com.
Ein Databricks-PAT erstellen
Gehen Sie im Databricks Workspace zu Settings, Developer, Access tokens, Manage, Generate new token. Legen Sie ein Ablaufdatum fest, das der Rotationsrichtlinie Ihres Teams entspricht. Wählen Sie nur die API-Scopes aus, die Sie benötigen; das Prinzip der minimalen Rechte ist wichtiger als die Bequemlichkeit von „alles“. Kopieren Sie das Token sofort. Databricks zeigt es nicht erneut an.
Wo Kiro die MCP-Konfiguration speichert
Kiro liest die MCP-Konfiguration aus JSON in zwei Geltungsbereichen; der Workspace-Bereich hat Vorrang vor dem Benutzerbereich.
- Benutzerbereich:
~/.kiro/settings/mcp.jsongilt für jeden Workspace. - Workspace-Bereich:
$PWD/.kiro/settings/mcp.jsongilt nur für den aktuellen Workspace und überschreibt den gleichnamigen Eintrag im Benutzerbereich.
Installation mit einem Klick aus dem Kiro-Serververzeichnis
Öffnen Sie kiro.dev/docs/mcp/servers/, suchen Sie die Zeile Databricks und klicken Sie auf Add to Kiro. Der Browser startet Kiro und öffnet einen Bestätigungsdialog mit einer vorausgefüllten Konfiguration. Bestätigen Sie, um den Eintrag databricks-sql in ~/.kiro/settings/mcp.json zu schreiben. Er ist zunächst deaktiviert, mit einer Platzhalter-URL und einem Verweis auf die Variable DATABRICKS_ACCESS_TOKEN. Setzen Sie anschließend die URL auf ${DATABRICKS_SQL_MCP_URL}, setzen Sie "disabled" auf false und legen Sie beide Variablen an.
Den Eintrag databricks-sql prüfen (oder hinzufügen)
Die Umgebungsvariablen setzen
In dem Shell-Profil, aus dem Kiro gestartet wird (unter macOS meist ~/.zshrc):
Laden Sie das Profil neu (source ~/.zshrc), bevor Sie Kiro starten. Beenden Sie Kiro vollständig (Cmd+Q unter macOS) und öffnen Sie es erneut. Reload Window liest Umgebungsvariablen nicht neu ein; das geschieht nur bei einem Neustart des Prozesses.
Kiro löst ${...}-Verweise in mcp.json nur für Umgebungsvariablen auf, die Sie freigegeben haben. Wenn Kiro seine Sicherheitsabfrage mit den DATABRICKS_*-Variablen anzeigt, geben Sie sie frei oder fügen Sie sie selbst unter Settings, Mcp Approved Env Vars hinzu.
Genie, Unity Catalog Functions und AI Search hinzufügen
Alle vier von Databricks verwalteten Server verbinden sich als Remote-HTTP-MCP. Der Initialize-Handshake gelingt sogar mit einer Platzhalter-URL; der Server prüft die Ressource erst, wenn ein Tool aufgerufen wird. Der häufigste Fehlerfall ist ein verbundener, aber fehlerhafter Zustand, in dem tools/call RESOURCE_DOES_NOT_EXIST oder PERMISSION_DENIED zurückgibt. Führen Sie zuerst diese Vorabprüfungen durch:
- Genie: Vergewissern Sie sich, dass ein Genie-Agent existiert und Sie ihn öffnen können. Kopieren Sie seine Space-ID aus dem Tab Settings des Agents (die Oberfläche nennt sie Agent ID); sie ist die
<genie_space_id>in der URL-Tabelle unten. - Unity Catalog Functions: Vergewissern Sie sich, dass die Funktion existiert und Sie
EXECUTEhaben. Funktionen auflisten mitSELECT * FROM system.information_schema.routines WHERE routine_type = 'FUNCTION'. - AI Search: Vergewissern Sie sich, dass ein Endpunkt mit mindestens einem zugänglichen Index existiert.
- PAT-Scope: Ein PAT mit Workspace-Scope kann trotzdem
PERMISSION_DENIEDauslösen, wenn dem Benutzer der Zugriff auf die jeweilige Ressource fehlt: Can View für den Genie-Agent oderSELECTfür den AI Search-Index (plusUSE CATALOGundUSE SCHEMA). Genie-Agents werden einzeln freigegeben.
Fügen Sie die zusätzlichen Umgebungsvariablen hinzu (DATABRICKS_GENIE_MCP_URL, DATABRICKS_UC_FUNCTIONS_MCP_URL, DATABRICKS_AI_SEARCH_MCP_URL) und aktualisieren Sie mcp.json auf die vollständige Konfiguration:
URL-Formate nach Server:
Server | URL-Muster |
|---|---|
databricks-genie | https://<workspace-hostname>/api/2.0/mcp/genie/<genie_space_id> |
databricks-sql | https://<workspace-hostname>/api/2.0/mcp/sql |
databricks-uc-functions | https://<workspace-hostname>/api/2.0/mcp/functions/<catalog>/<schema>/<function_name> |
databricks-ai-search | https://<workspace-hostname>/api/2.0/mcp/ai-search/<catalog>/<schema>/<index_name> |
Beenden Sie Kiro und starten Sie es erneut. Öffnen Sie den Abschnitt MCP SERVERS im Kiro-Panel; die vier databricks-*-Einträge erscheinen mit grünen Statusanzeigen. Klicken Sie bei allem, was rot ist, auf Reconnect und wiederholen Sie die Vorabprüfungen. Probieren Sie im Chat-Panel eine unkritische erste Abfrage: „List the catalogs I have access to.“
Weg B: Die Databricks Power installieren
Die vier verwalteten Server decken SQL, semantische Suche und Analysen in natürlicher Sprache ab, was vielen Entwicklern genügt. Wenn Ihr Workflow Pipelines, Jobs, Model Serving, Lakebase, Declarative Automation Bundles, Agent Bricks, AI/BI-Dashboards, MLflow oder Databricks Apps umfasst, kopieren Sie mit dem Vier-Server-Setup den ganzen Tag Inhalte zurück in die Workspace-Oberfläche.
Die Databricks Power löst das. Eine Installation richtet die offiziellen Databricks-Agent-Skills ein, die je nach Aufgabe bei Bedarf geladen werden.
Was Sie erhalten
Bereich | Abdeckung |
|---|---|
SQL & Compute | SQL auf Warehouses ausführen; Python oder Scala auf Clustern ausführen; den Compute-Lebenszyklus verwalten |
Pipelines & Jobs | Spark Declarative Pipelines (Streaming-Tabellen, CDC, SCD Type 2, Auto Loader); Job-DAGs mit mehreren Tasks |
Unity Catalog | Tabellen, Volumes, Berechtigungen, Tags, Speicher-Anmeldeinformationen, Systemtabellen, Metric Views, External Iceberg Reads |
AI/BI-Dashboards | Visualisierungen, KPIs, Analyse-Dashboards |
Genie-Agents | Datenexploration in natürlicher Sprache über kontrollierte Datensätze |
Agent Bricks | Knowledge Assistants (RAG) und Multi-Agent Supervisors |
AI Search | Semantische Suche und RAG mit verwalteten Indizes |
Model Serving | ML-Modelle, KI-Agents und Foundation Model APIs (FMAPI) mit Pay-per-Token-Abrechnung, über Unity Gateway routbar |
MLflow | Experimente, Evaluierungen, Trace-Instrumentierung, Metrikabfragen |
Lakebase | Bereitgestelltes und automatisch skalierendes verwaltetes PostgreSQL für OLTP-Workloads |
Databricks Apps | Full-Stack-Web-Apps auf dem Lakehouse |
Declarative Automation Bundles (ehemals Databricks Asset Bundles) | Infrastructure-as-Code für Databricks-Ressourcen |
Die Power installieren
Öffnen Sie in Kiro (IDE 1.0.288 oder neuer) das Powers-Panel, suchen Sie nach databricks und installieren Sie die Databricks Power. Ihr Setup-Skill führt Sie dann durch vier Schritte:
- Prüfen, ob die Databricks CLI in v1.20.0 oder neuer vorliegt, der ersten Version mit Kiro-Unterstützung in
databricks aitools, und sie bei Bedarf installieren oder aktualisieren. - Die CLI mit
databricks auth loginanmelden oder ein vorhandenes Profil wiederverwenden. - Die Skills mit
databricks aitools install --agents kiro --scope globalinstallieren, wodurch sie in~/.kiro/skills/landen. Mit--scope projectinstallieren Sie sie nur für einen Workspace. - Acht MLflow-Skills aus mlflow/skills hinzufügen (Tracing, Evaluierung, Trace-Analyse, Metriken), die die CLI nicht mitliefert.
Abgesehen von ihrem Setup-Skill enthält die Power keine Inhalte und liefert keinen MCP-Server mit. Die CLI lädt die Skills aus databricks/databricks-agent-skills, und Sie aktualisieren sie selbst mit databricks aitools update.
Authentifizierung
Die Skills führen Databricks CLI-Befehle aus und verwenden daher ein Databricks CLI-Profil. Melden Sie sich für die interaktive Nutzung mit OAuth User-to-Machine an: databricks auth login --host https://<your-workspace-url> --profile <profile-name> öffnet einen Browser, und das Token wird automatisch erneuert. Service-Principal-OAuth eignet sich für die Automatisierung, und Personal Access Tokens bleiben eine Option; siehe Databricks CLI authentication. Der Setup-Skill listet Ihre vorhandenen Profile auf, ohne Secrets auszugeben, und verwendet nie ein Profil wieder, ohne nachzufragen.
Die Installation prüfen
Kiro lädt Skills zu Beginn einer Chat-Sitzung. Öffnen Sie daher eine neue Sitzung und fragen Sie: „Using the databricks-core skill, which workspace am I connected to?“ Eine korrekte Antwort bestätigt die CLI, Ihr Profil und die Skills. databricks aitools list zeigt die installierte Version jedes Skills.
Upgrade von der AI Dev Kit Power
Wenn Sie die frühere Databricks AI Dev Kit Power installiert haben, aktualisieren Sie die Power in Kiro und führen Sie dann die Skill- und MLflow-Schritte oben aus. Einige Dinge liegen außerhalb der Power und müssen manuell bereinigt werden: ein databricks-Eintrag auf oberster Ebene in mcp.json, der databricks-mcp-server/run_server.py ausführt, sowie alle DATABRICKS_*-Exporte von Anmeldeinformationen, die das alte Setup Ihrem Shell-Profil hinzugefügt hat. Optional können Sie den ai-dev-kit-Klon entfernen (~/.ai-dev-kit oder das Verzeichnis in AIDEVKIT_HOME), aber nur, wenn Sie ai-dev-kit nicht für andere Agents oder Projekte nutzen. Löschen Sie das Verzeichnis, statt install.sh --uninstall von ai-dev-kit auszuführen, denn das entfernt Skill-Ordner nach Namen aus ~/.kiro/skills/, auch die von der Databricks CLI installierten. Der Abschnitt „Migrating from the AI Dev Kit Power“ im Skill databricks-kiro-setup der Power behandelt alle drei Punkte.
So wählen Sie zwischen den beiden Wegen
Ein einfacher Entscheidungsbaum:
- Sie führen nur SQL aus, stellen über Genie Fragen in natürlicher Sprache zu kontrollierten Datensätzen und durchsuchen AI Search-Indizes? Nutzen Sie Weg A. Die vier verwalteten Server erledigen genau das, und die Einrichtung dauert 10 Minuten.
- Sie erstellen Pipelines, verwalten Jobs, stellen Declarative Automation Bundles bereit, arbeiten mit Lakebase, entwickeln Databricks Apps oder rufen Agent Bricks auf? Nutzen Sie Weg B. Das komplette Toolkit ist zu umfangreich, um es als einzelne Remote-MCP-Server anzubinden.
- Beides? Nutzen Sie beide Wege. Weg A und Weg B stehen nicht in Konflikt: Weg B fügt Skills hinzu, keine MCP-Server, sodass die vier Server von Weg A (
databricks-genie,databricks-sql,databricks-uc-functions,databricks-ai-search) daneben im MCP-Panel von Kiro erscheinen. Der Setup-Skill der Power kann Sie auch dabei anleiten, ein von Databricks bereitgestelltes MCP wie Genie One über Unity Gateway zu Ihrermcp.jsonhinzuzufügen.
Für Entwickler, die täglich in Kiro an Databricks-Workloads arbeiten möchten, ist Weg B langfristig die bessere Wahl. Weg A ist die richtige Wahl, wenn Sie 10 Minuten Zeit haben und mit einem SQL-Warehouse chatten möchten.
Aus Sicht der Entwickler
Je nachdem, wer die IDE nutzt, wirken die beiden Wege unterschiedlich. Vier Personas, vier Probleme, vier Antworten.
Der Analytics Engineer. Sie verbringen den halben Tag damit, Tabellen abzufragen, die Sie noch nie gesehen haben, und die andere Hälfte mit Kopieren zwischen Editor und Workspace-Oberfläche. Weg A löst das in 10 Minuten. Die Genie- und SQL-Server verankern jede Abfrage in echten Schema-Metadaten; der Assistent schreibt gegen Ihre tatsächlichen Spalten statt zu raten; und jedes Ergebnis übernimmt Ihre Unity Catalog-Berechtigungen. Sie müssen nicht mehr ständig zwischen Tabs wechseln.
Der Data Engineer. Ihr Alltag besteht aus Pipelines, Jobs, Declarative Automation Bundles und den umgebungsübergreifenden Promotions, die dazugehören. databricks.yml von Hand zu schreiben und databricks bundle deploy in einer Terminal-Seitenleiste auszuführen, ist der langsame Weg. Weg B ist der schnelle. Die Skills der Power für Pipelines, Jobs und Declarative Automation Bundles erstellen, validieren und deployen IaC in einer einzigen Unterhaltung. Spark Declarative Pipelines, CDC, SCD Type 2, Auto Loader: alles gegen Ihre tatsächlichen Unity Catalog-Tabellen generiert und bereit zum Commit.
Der KI- und Agent-Entwickler. Sie verbinden Modellaufrufe, Evaluierung, Governance und Agent-Orchestrierung über drei oder vier Tools, die sich beim Schema nicht ganz einig sind. Weg B deckt den gesamten Databricks-KI-Bereich ab: Unity Gateway für Routing und Fallbacks, Agent Bricks für Multi-Agent Supervisors und Knowledge Assistants, MLflow für die Evaluierung und AI Search für das Retrieval, alles durchgängig von Unity Catalog gesteuert. Ihr Agent übernimmt dieselben Berechtigungen wie sein Aufrufer, und Ihre Evaluierungs-Traces landen im selben Workspace wie Ihre Trainingsläufe.
Der Plattformentwickler. Sie verwalten Databricks-Ressourcen als Code, führen Promotions über dev/stage/prod durch und beantworten wöchentlich die Frage „Gibt es Drift?“. Der Declarative Automation Bundles-Skill von Weg B (databricks-dabs) erzeugt zusammen mit den Skills für die Unity Catalog-Verwaltung das vollständige Bundle, validiert es und zeigt den Deployment-Plan (databricks bundle plan), bevor sich etwas ändert. Sie pflegen nicht mehr einen YAML-Satz von Hand und einen weiteren in einem Dokument.
Ein Workflow, den Sie heute ausführen können
Unabhängig vom gewählten Weg verankert diese Übung den Assistenten in echten Workspace-Metadaten, und zwar mit dem Datensatz samples.tpch aus dem integrierten Katalog samples.
Sie fragen: „What columns and types does samples.tpch.lineitem have, and what is the data distribution by l_shipdate year?“
Kiro liefert das tatsächliche Schema und ein Histogramm aus einer einzigen Abfrage. Echte Spaltennamen und eine echte Verteilung, verankert in Ihrem Workspace.
Sie fragen: „Draft a dbt model that joins lineitem to orders and aggregates revenue by nation per quarter.“
Kiro erzeugt SQL mit den tatsächlichen Spaltennamen (l_extendedprice, l_discount, o_orderdate) statt mit Vermutungen. Da es zuerst das Schema abgefragt hat, kennt es die genauen Typen und die Granularität.
Sie fragen: „Run my new aggregation against samples.tpch and compare the row count to last week's snapshot in poc.gold.revenue_by_nation_qtr.“
Kiro führt beide Abfragen aus und zeigt die Unterschiede. Wenn eine Zahl seltsam aussieht, ruft „Show me the lineage for gold.revenue_by_nation_qtr“ die vorgelagerten Tabellen aus system.access.table_lineage ab. Nach der Prüfung erzeugt Kiro das Databricks-Job-JSON für das Modell und listet auf, welche Kataloge und Schemas es betrifft.
Auf Weg B lässt sich derselbe Workflow erweitern, etwa mit „Generate a Declarative Automation Bundle for this job and deploy it to staging“, „Create an AI/BI dashboard backed by this aggregation“ oder „Wire this into a Unity Gateway endpoint with a fallback model“, alles ohne die IDE zu verlassen.
Best Practices, unabhängig vom Weg
- Authentifizierung mit minimalen Rechten. Erstellen Sie ein separates PAT pro Arbeitsplatz und pro Scope-Satz. Bevorzugen Sie auf Weg B für die interaktive Nutzung OAuth U2M gegenüber PATs.
- Niemals Anmeldeinformationen committen. Speichern Sie
DATABRICKS_ACCESS_TOKENin Ihrem Shell-Profil oder einem Secrets Manager. Legen Sie es niemals in einermcp.jsonab, die in die Versionsverwaltung eingecheckt wird. - Scope pro Projekt. Speichern Sie Genie-Agent-IDs und AI Search-Indexpfade in
$PWD/.kiro/settings/mcp.json, damit jedes Projekt seine eigenen Ressourcenbindungen mitbringt. - Vertrauen Sie den Unity Catalog-Berechtigungen. Auf beiden Wegen arbeitet die KI mit Ihren effektiven Berechtigungen: Tabellenberechtigungen, Zeilenfilter und Spaltenmasken für SQL und Genie-Agents sowie Freigaben pro Ressource für AI Search-Indizes. Es gibt keine separate Zugriffskontrollebene, die verwaltet werden muss.
- Neu starten, nicht neu laden. Kiro liest Umgebungsvariablen einmal beim Prozessstart. Nachdem Sie Ihr Shell-Profil bearbeitet oder die Authentifizierung hinzugefügt haben, beenden Sie Kiro vollständig (Cmd+Q unter macOS) und öffnen Sie es erneut.
Fehlerbehebung
„Server not found“ oder roter Status bei einem MCP-Eintrag.
Weg A: Prüfen Sie echo $DATABRICKS_SQL_MCP_URL in der Shell, aus der Kiro gestartet wurde. Ein leerer Wert bedeutet, dass Kiro die URL nicht auflösen kann. Stellen Sie sicher, dass die mcp.json im Workspace-Bereich Ihre Konfiguration im Benutzerbereich nicht überdeckt. Prüfen Sie unter Settings, Developer, Access tokens, ob das PAT noch gültig ist.
Mit MCP verbunden, aber Tool-Aufrufe geben RESOURCE_DOES_NOT_EXIST oder PERMISSION_DENIED zurück.
Der häufigste Fehler auf Weg A. Der Initialize-Handshake gelingt mit einer Platzhalter-URL, weil der Server die Ressourcenprüfung bis zum Aufruf aufschiebt. Wiederholen Sie die Vorabprüfungen für den jeweiligen Server (der Genie-Agent existiert und ist für Sie freigegeben, die Funktion existiert und Sie haben EXECUTE, der AI Search-Index existiert und Sie haben SELECT darauf).
Kiro verwendet die Databricks-Skills nicht (Weg B).
Öffnen Sie eine neue Chat-Sitzung, da Skills zu Beginn einer Sitzung geladen werden, und prüfen Sie, ob databricks-core/SKILL.md in ~/.kiro/skills/ existiert. Error: unknown agent "kiro" bedeutet, dass die Databricks CLI älter als v1.20.0 ist; aktualisieren Sie sie und führen Sie die Installation erneut aus. Wenn sich der CLI-Befehl eines Skills nicht authentifizieren kann, führen Sie databricks auth profiles aus und melden Sie sich mit databricks auth login erneut an.
Probieren Sie es noch heute aus. Die Databricks Power ist der schnellste Weg, die gesamte Plattform (Pipelines, Jobs, Lakebase, Agent Bricks und alles andere oben Genannte) in Kiro zu nutzen. Installieren Sie sie aus dem Kiro Powers-Katalog unter kirodotdev/powers, oder installieren Sie dieselben Skills ohne die Power, indem Sie databricks aitools install --agents kiro mit Databricks CLI v1.20.0 oder neuer ausführen. Für andere Coding-Agents erkennt databricks aitools install die auf Ihrem Rechner vorhandenen (Claude Code, Cursor, Codex, GitHub Copilot, Gemini CLI und weitere); führen Sie databricks aitools --help aus, um die aktuelle Liste zu sehen, oder besuchen Sie databricks/databricks-agent-skills. Die Installation mit einem Klick für die vier von Databricks verwalteten MCP-Server finden Sie unter kiro.dev/docs/mcp/servers/.
Haben Sie Feedback oder ein Problem? Erstellen Sie ein Issue: für die Einrichtung oder das Packaging der Power unter kirodotdev/powers; für die Agent-Skills unter databricks/databricks-agent-skills; für die Databricks CLI und databricks aitools unter databricks/cli. Wir lesen jedes einzelne.
Partner, Lakebase, Genie, Unity Gateway, Agent Bricks, Unity Catalog, MCP, Developer Tools, AI Search, MLOps & LLMOps und Business Intelligence
Erhalten Sie die neuesten Beiträge in Ihrem Posteingang
Abonnieren Sie unseren Blog und erhalten Sie die neuesten Beiträge direkt in Ihren Posteingang.