Ihre Daten, Ihr Speicher, Ihre Regeln: Ein Leitfaden für 2026 zur Speicherung von durch Unity Catalog verwalteten Tabellen
Die Daten Ihrer verwalteten Tabellen liegen in Ihrem eigenen Cloud-Speicher an einem Ort, den Sie kontrollieren.
von Elizabeth Bowman und Isabel Dong
- Von Unity Catalog verwaltete Tabellen speichern Ihre Daten in einem Cloud-Speicher, der Ihnen gehört, und zwar unter einem Pfad, der durch den verwalteten Speicherort in Ihrem Metastore, Katalog oder Schema festgelegt ist.
- Im Zuge von organisatorischen Veränderungen können Teams auf Daten an einem übernommenen Speicherort sitzen bleiben, den sie nie selbst gewählt haben. SET MANAGED LOCATION ändert, wo neue Tabellen abgelegt werden, und das Konvertieren externer Tabellen verschiebt deren Daten an den von Ihnen festgelegten Speicherort.
- Sie behalten die Kontrolle darüber, wo die Daten Ihrer verwalteten Tabellen gespeichert sind – sei es an einem einzigen Speicherort oder auf separaten Speichern für Compliance und Kostenzuordnung.
Vom Unity Catalog verwaltete Tabellen ermöglichen es Ihnen, die Platzierung Ihrer Daten zu steuern, wenn Ihr Unternehmen separaten Speicher benötigt. Im Gegensatz zu anderen Datenplattformen verbleiben die Tabellendaten von Databricks in einem Cloud-Speicherkonto, das Ihnen gehört, wie z. B. Ihrem S3-Bucket, Ihrem ADLS-Container oder Ihrem GCS-Bucket.
Unity Catalog-verwaltete Tabellen automatisieren die Tabellenverwaltung. Unabhängig davon, ob Sie Ihre vom Unity Catalog verwalteten Tabellen im Iceberg- oder Delta-Format speichern, übernimmt Databricks das Datenlayout, die Optimierung und die Bereinigung für Sie am Ort Ihrer Wahl und wendet Optimierungen automatisch an, wenn sich Ihre Tabellen ändern.
In diesem Blogbeitrag wird erklärt, wie das Speichermodell für verwaltete Tabellen funktioniert und wie Sie einen verwalteten Speicherort in Databricks auswählen oder ändern können.
Ihre Tabellen verbleiben in Ihrem eigenen Speicher
Wenn Sie Ihren eigenen Cloud-Speicher nutzen, landen die Daten der verwalteten Tabellen in einem Cloud-Konto, das Ihnen gehört. Sie behalten das Eigentum an diesem Speicher und die Transparenz darüber, wie Ihre Daten organisiert sind. Sie haben die Möglichkeit, Ihre eigenen Bucket-Richtlinien zu überprüfen, zu auditieren und anzuwenden sowie den Speicherort Ihrer Daten zu steuern.
Im Gegensatz zu anderen Plattformen mit verwalteten oder nativen Tabellenangeboten, die Tabellen in vom Anbieter kontrollierten Speichern oder proprietären Datenformaten ablegen, verbleiben Ihre Daten bei Databricks in Ihrem eigenen Konto.
Offen konzipiert
Die Speicherung von Daten in Ihrem eigenen Cloud-Konto ist nur ein Teil dessen, was verwaltete Tabellen bei Databricks offen macht. Unity Catalog ist der einzige große Katalog in der Branche, bei dem Sie der Eigentümer Ihrer Daten bleiben – mit vollem, kontrolliertem Lese- und Schreibzugriff über Iceberg und Delta hinweg sowie der Möglichkeit, Tabellen im Besitz anderer in offenen Formaten und unter Verwendung offener Standards zu föderieren.
Externe Tools wie Apache Spark™, Flink, Trino, Kafka Connect und Snowflake können über den Iceberg REST Catalog und die offenen APIs von Unity Catalog aus verwaltete Tabellen lesen und in diese schreiben. Ein sicherer Zugriff wird durch offene APIs und Credential Vending ermöglicht, sodass externe Tools mit kontrollierten Daten interagieren können, ohne diese zu duplizieren. Dies vereinfacht die Architektur und ermöglicht eine Single Source of Truth für Analytics- und KI-Workloads.
Wenn Sie Ihren eigenen Speicher nutzen, bleiben die Dateien in Ihrem Cloud-Konto zugänglich, während Unity Catalog den Zugriff darauf steuert.
Sie steuern, wo Ihre Daten liegen
Mit verwalteten Tabellen in Databricks können Sie entscheiden, wo die Daten der verwalteten Tabellen landen. Legen Sie einen verwalteten Speicherort einmal auf Metastore-, Katalog- oder Schema-Ebene fest, und jede darunter liegende Tabelle erbt diesen. Die spezifischste Ebene gewinnt: Der Speicherort eines Schemas hat Vorrang vor dem seines Katalogs und der eines Katalogs vor dem des Metastores. Sie können einen allgemeinen Standardwert festlegen und diesen überall dort überschreiben, wo ein Team oder eine Domäne eigenen Speicher benötigt.
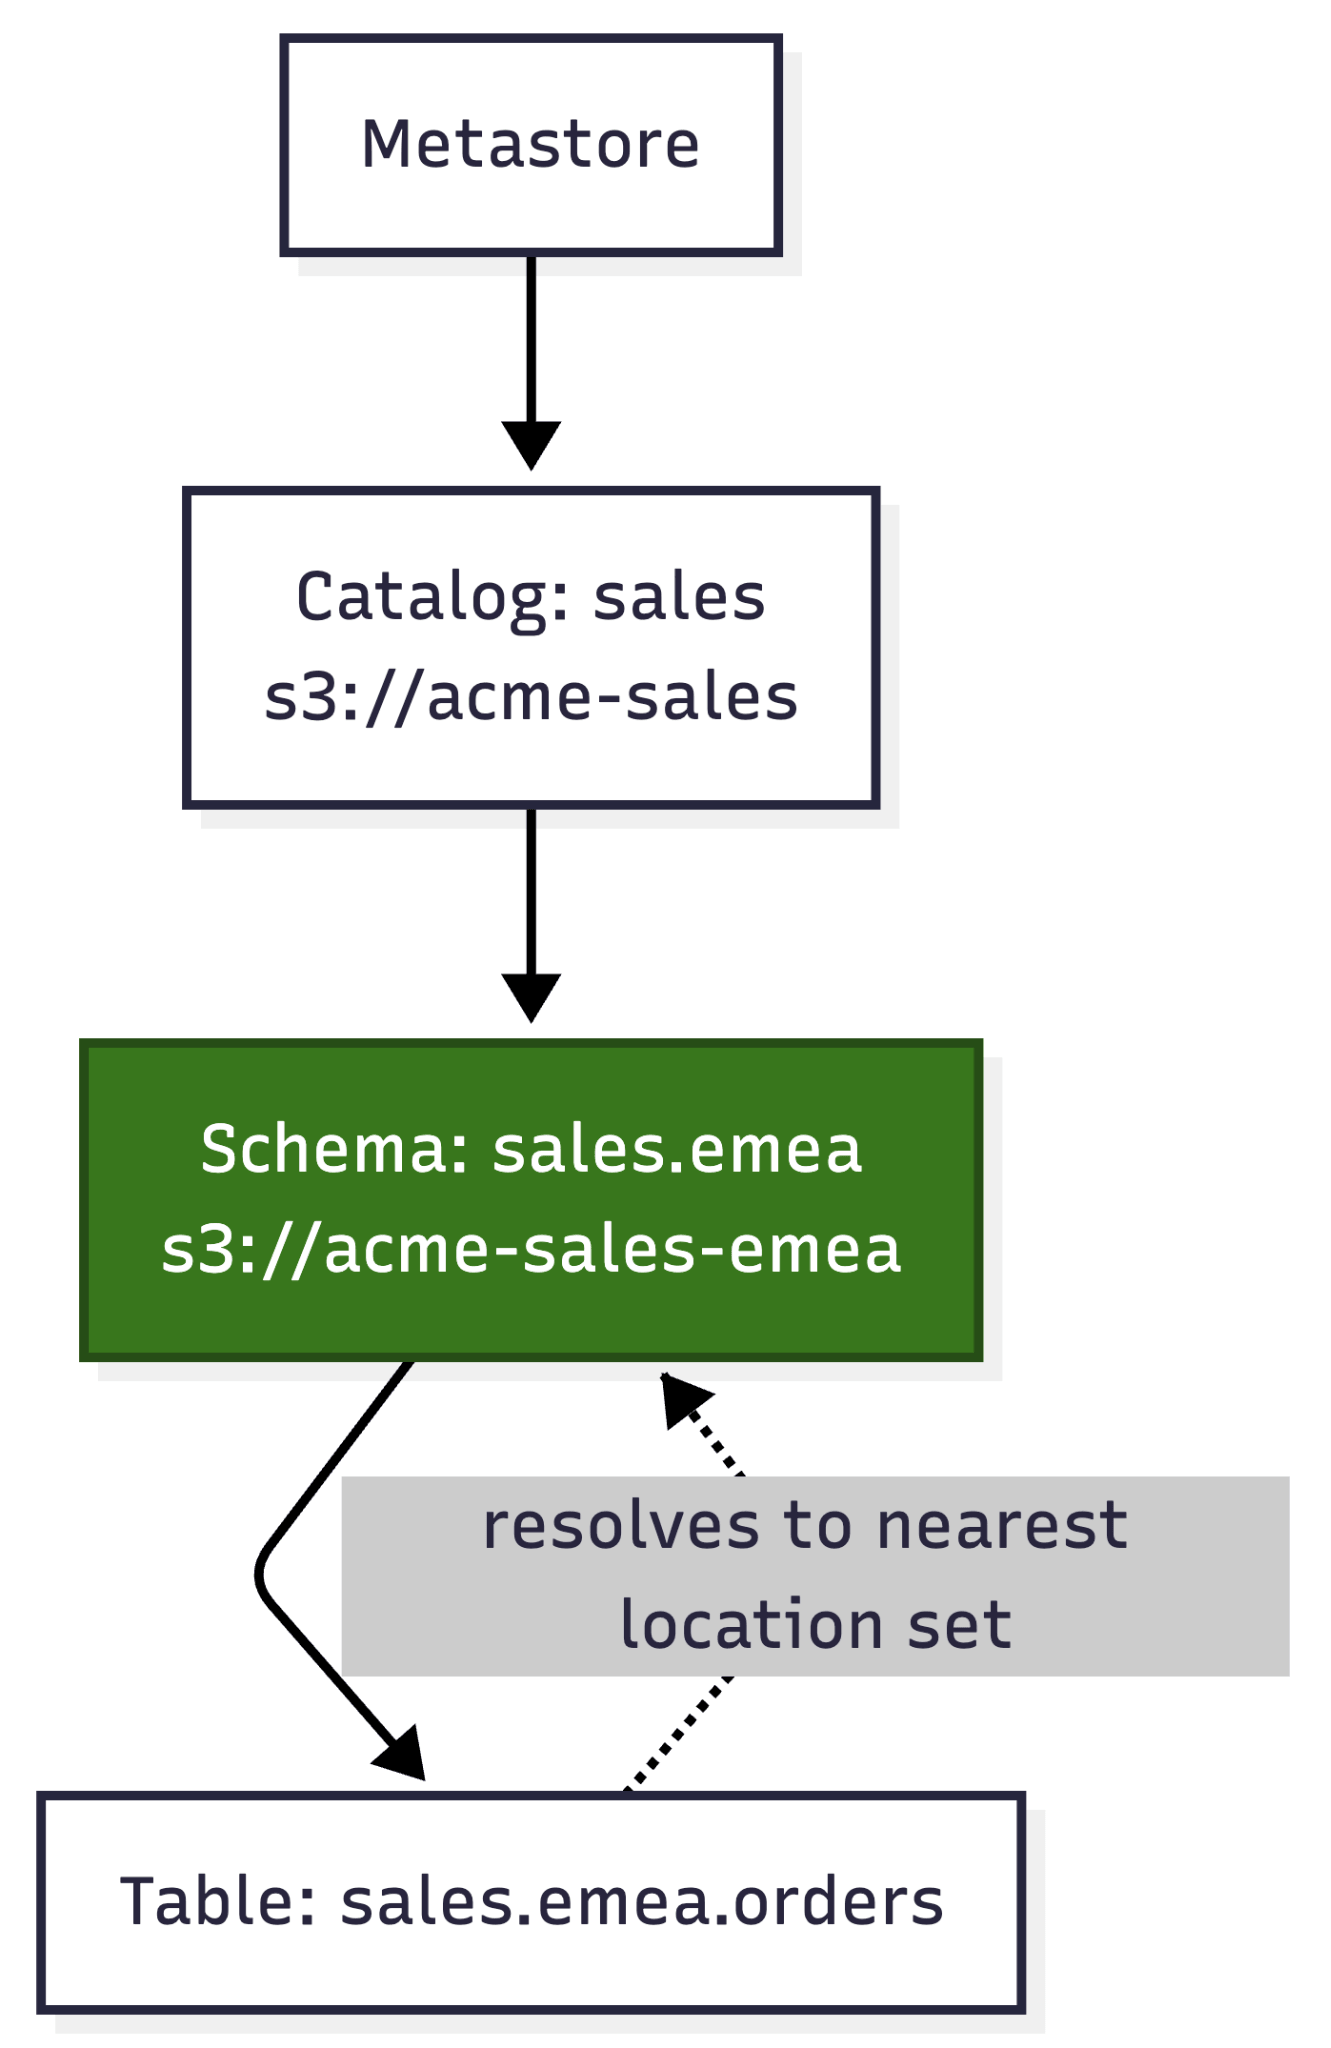
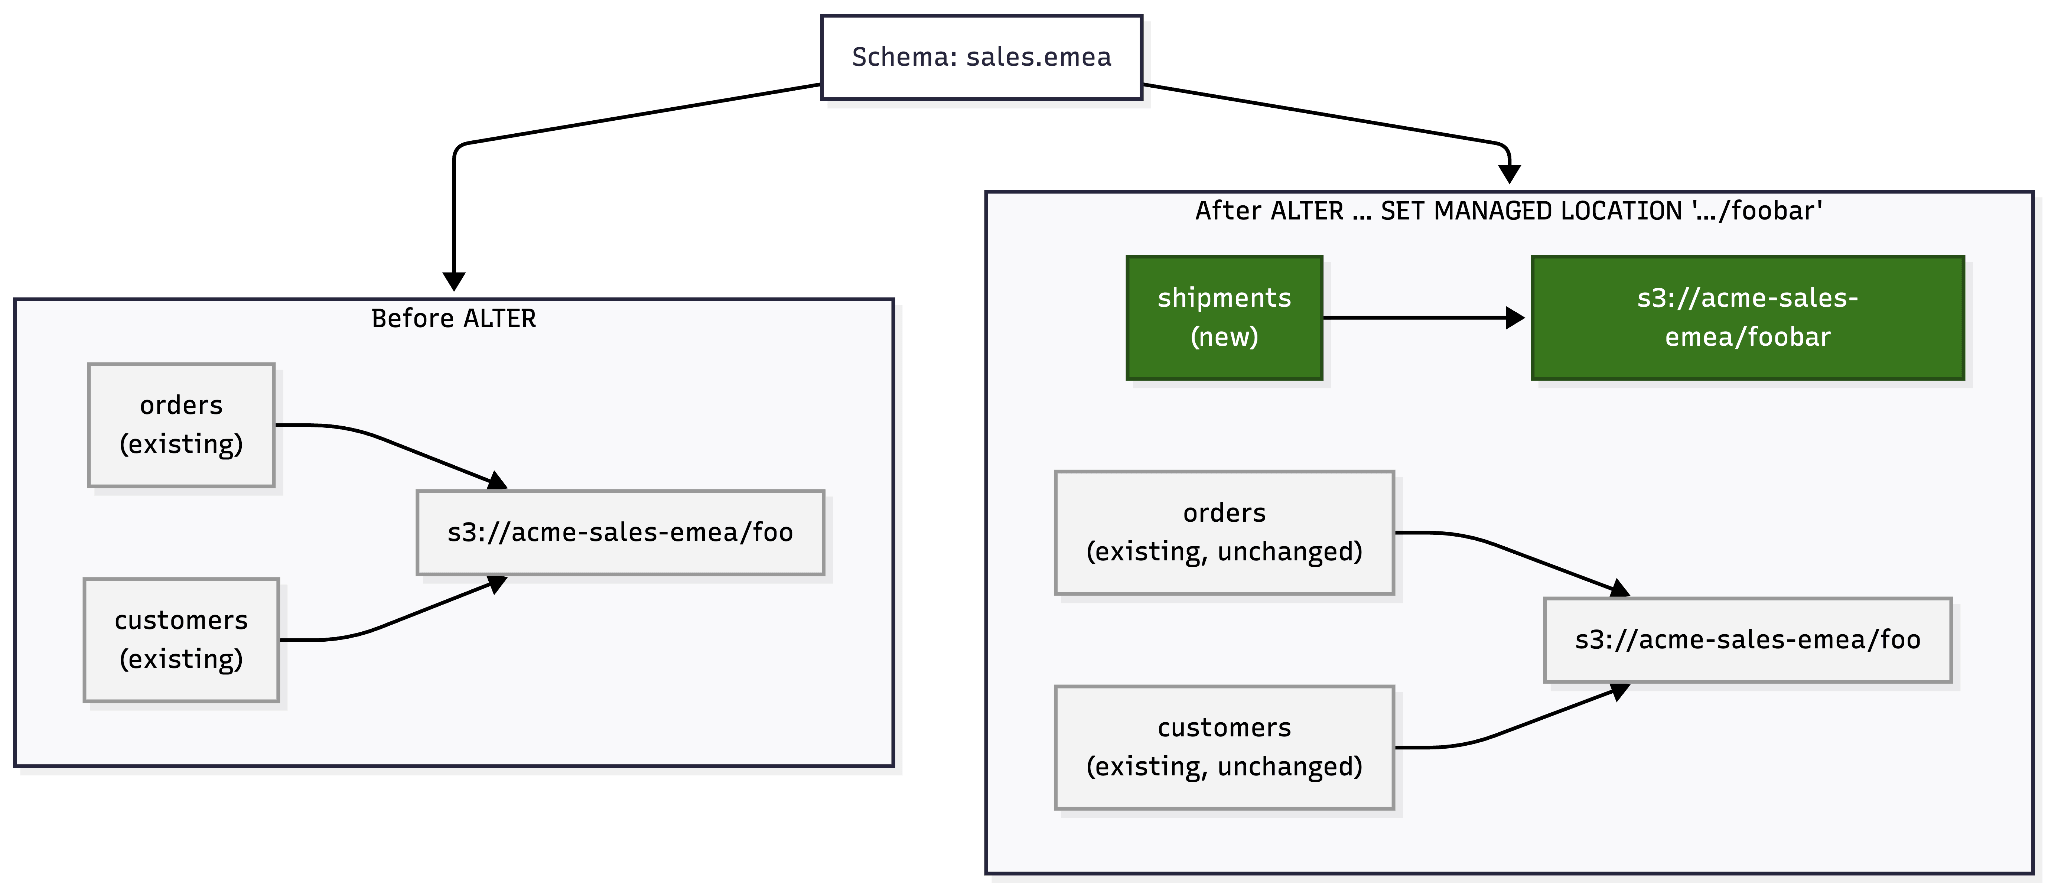
Diese Kontrolle ist nicht auf die Einrichtung beschränkt. Wenn sich Ihr Unternehmen verändert, verweisen ALTER CATALOG oder ALTER SCHEMA ... SET MANAGED LOCATION neue Tabellen und Volumes auf einen neuen Speicherort, während alles bereits Geschriebene dort bleibt, wo es ist.
Mehr Kontrolle, wenn Sie separaten Speicher benötigen
Die meisten Teams organisieren ihre Daten logisch über Kataloge und Schemata und müssen sich nie Gedanken darüber machen, wo sich die zugrunde liegenden Dateien physisch befinden: Der verwaltete Speicherort, den ihre Kataloge und Schemata erben, ist alles, was sie brauchen. In Kombination mit rollen- und attributbasierten Zugriffskontrollen in Unity Catalog erfüllt dieser Ansatz die standardmäßigen GDPR-Anforderungen zur Datentrennung.
Einige Unternehmen benötigen jedoch Grenzen, die bis in den physischen Speicher selbst reichen. Ein Geschäftsbereich benötigt möglicherweise separaten Speicher für die Verwaltung oder die Zuweisung von Cloud-Kosten. Oder regionale und regulatorische Vorschriften schreiben vor, wo bestimmte Daten physisch liegen müssen. In diesen Fällen können Sie einem bestimmten Katalog oder Schema einen eigenen verwalteten Speicherort zuweisen, sodass die physische Platzierung der Daten mit der erforderlichen Abgrenzung übereinstimmt.
Wählen Sie aus, wo Daten landen, wenn Sie diese in verwaltete Tabellen konvertieren
Wenn Sie eine externe Tabelle in eine verwaltete Tabelle konvertieren, landen die Daten an dem verwalteten Speicherort, auf den ihr Katalog oder Schema derzeit verweist. Wenn sich diese externe Tabelle bereits an einem Ad-hoc- oder Nicht-Standard-Ort befindet, möchten Sie die verwaltete Tabelle möglicherweise an einem anderen Ort haben, und zwar in dem Speicher, den Sie heute für diese Domäne verwenden.
Während der Konvertierung kopiert Databricks die Daten und das Transaktionsprotokoll der Tabelle in den von Ihnen festgelegten verwalteten Speicherort, sodass die verwaltete Tabelle dort landet, wo Sie es möchten.
Zusammenfassung
Verwaltete Tabellen automatisieren die Tabellenwartung, während Ihre Daten in Ihrem eigenen Speicher verbleiben können. Dies unterscheidet sich von anderen verwalteten Plattformen, die Tabellendaten in vom Anbieter kontrollierten Speichern ablegen. Sie können die Platzierung auf Metastore-, Katalog- oder Schema-Ebene steuern, ändern, wo neue Tabellen landen, und einen Speicherort auswählen, wenn Sie eine externe Tabelle in eine verwaltete Tabelle konvertieren. Ihre Daten bleiben in offenen Formaten und sind über den Iceberg REST Catalog und die offenen APIs von Unity Catalog erreichbar.
Wenn Sie bereit sind, einen verwalteten Speicherort einzurichten oder zu ändern, finden Sie die Details in der Dokumentation zu verwaltetem Speicher.
Funktion | Databricks Unity Catalog | Andere Plattformen |
Speicherung von Daten im kundeneigenen Speicher | ✅ Ja | Oft proprietär |
Offene Tabellenformate (Iceberg und Delta) | ✅ Ja | Variiert je nach Format |
Lese-/Schreibzugriff für externe Tools mit Governance auf Zeilen- und Spaltenebene | ✅ Über Iceberg REST Catalog oder offene APIs von Unity Catalog | Eingeschränkt |
Kann den Speicherort auf Katalog-/Schema-Ebene steuern | ✅ SET MANAGED LOCATION | Unüblich |
Definitionen
Viele dieser Begriffe verwenden dieselben Wörter, was leicht zu Verwechslungen führen kann. Hier erfahren Sie, was die einzelnen Begriffe in diesem Beitrag bedeuten.
- Verwaltete Tabelle: Eine Tabelle, deren Daten und Lebenszyklus Unity Catalog für Sie verwaltet. Sie erstellen sie ohne eine
LOCATION-Klausel. - Verwalteter Speicherort: Der Cloud-Pfad, in den die verwalteten Tabellen und Volumes eines Metastores, Katalogs oder Schemas geschrieben werden. Sie legen ihn mit der
SET MANAGED LOCATION-Klausel fest. - Externer Speicherort: Ein Unity Catalog-Objekt, das einen Cloud-Pfad mit einer Speicherberechtigung verknüpft, um den Zugriff auf diesen Pfad zu steuern. Externe Speicherorte steuern sowohl externe Tabellen als auch verwalteten Speicher: Ein verwalteter Speicherort auf Katalog- oder Schema-Ebene befindet sich in einem solchen Objekt.
- Kundeneigener Speicher: Eine Speicheroption, bei der sich der zugrunde liegende Cloud-Speicher im eigenen Cloud-Konto des Kunden befindet. Dies macht die überwiegende Mehrheit der Tabellen in Databricks aus.
- Standard-Speicher: Eine alternative Speicheroption, bei der Databricks den zugrunde liegenden Cloud-Speicher für Sie bereitstellt, anstatt dass Sie Ihren eigenen Bucket mitbringen.
- ALTER CATALOG / ALTER SCHEMA … SET MANAGED LOCATION: Der Befehl, der ändert, wohin neue verwaltete Tabellen und Volumes für einen Katalog oder ein Schema geschrieben werden. Bestehende Tabellen sind davon nicht betroffen.
- Konvertierung von extern zu verwaltet (ALTER TABLE … SET MANAGED): Der Befehl, der eine externe Tabelle in eine verwaltete Tabelle konvertiert. Während der Konvertierung werden die Daten und das Transaktionsprotokoll in den aktuellen verwalteten Speicherort kopiert.
FAQs
1. Wo speichert Unity Catalog die Daten verwalteter Tabellen – in von Databricks verwaltetem Speicher oder in meinem eigenen Cloud-Konto?
In Ihrem eigenen Konto. Die Daten verwalteter Tabellen werden in den Cloud-Speicher in Ihrem eigenen Konto geschrieben (sei es S3, ADLS oder GCS), und zwar an einem verwalteten Speicherort, den Sie für Ihr Metastore, Ihren Katalog oder Ihr Schema festlegen. Databricks verwaltet das Layout und den Lebenszyklus der Tabelle, aber die zugrunde liegenden Dateien befinden sich in einem Bucket oder Container, den Sie besitzen und bei Unity Catalog registrieren, nicht in einem von Databricks kontrollierten Konto.
2. Binden mich verwaltete Tabellen in Unity Catalog an Databricks?
Nein. Verwaltete Tabellen verwenden offene Tabellenformate wie Iceberg und Delta, die in dem Cloud-Speicher verbleiben, den Sie besitzen. Externe Engines können über den Iceberg REST Catalog und die offenen APIs von Unity Catalog in diese schreiben und daraus lesen, sodass Ihre Daten nicht hinter einer proprietären Schnittstelle gefangen sind. Sie behalten das Eigentum am Speicher, die Daten bleiben in offenen Formaten und der Zugriff erfolgt über offene Standards. Verwaltete Tabellen bedeuten keinen Lock-in: Der Wechsel zu oder von Databricks ist mit verwalteten Tabellen genauso einfach wie mit externen Tabellen. In beiden Fällen können Sie Ihre Daten physisch am selben Ort belassen.
3. Kann ich bestimmte Daten aus Compliance- oder Datenresidenzgründen in einem separaten Speicher aufbewahren?
Ja. Sie können einem bestimmten Katalog oder Schema einen eigenen verwalteten Speicherort zuweisen – bei Bedarf getrennt von allem anderen –, um Daten für verschiedene Länder oder regulatorische Anforderungen in unterschiedlichen Speichern aufzubewahren oder um Speicherkosten einem bestimmten Team oder Geschäftsbereich zuzuordnen.
4. Können auch andere Engines und Tools als Databricks in meine verwalteten Tabellen schreiben und daraus lesen?
Ja. Verwaltete Tabellen können über den Iceberg REST Catalog und die offenen APIs von Unity Catalog gelesen oder beschrieben werden, sodass externe Engines wie Apache Spark, Trino und Flink darauf zugreifen können. Unity Catalog übernimmt die Governance für den Speicherzugriff und verhindert so Datenbeschädigungen, die durch das Umgehen dieser Mechanismen entstehen können. Ein direkter pfadbasierter Zugriff ist ebenfalls über pfadbasierte Weiterleitung und den Kompatibilitätsmodus verfügbar.
5. Kann ich den Speicherort meiner verwalteten Tabellendaten nachträglich ändern?
Ja. Verwenden Sie ALTER CATALOG … SET MANAGED LOCATION oder ALTER SCHEMA … SET MANAGED LOCATION, um neue Tabellen auf einen anderen Speicherort zu verweisen, wann immer sich die Anforderungen Ihrer Organisation an eine physische Trennung ändern: eine Reorganisation, ein neuer Bucket, eine neue Region. Bestehende Tabellen bleiben genau dort, wo sie sind, und neue Tabellen landen am neuen Speicherort. Wann immer Sie eine externe Tabelle in eine verwaltete Tabelle konvertieren, werden ihre Daten an den von Ihnen festgelegten Speicherort kopiert. So können Sie die Daten im selben Schritt an den richtigen Ort verschieben.
(Dieser Blogbeitrag wurde mit KI-gestützten Tools übersetzt.) Originalbeitrag
Erhalten Sie die neuesten Beiträge in Ihrem Posteingang
Abonnieren Sie unseren Blog und erhalten Sie die neuesten Beiträge direkt in Ihren Posteingang.