Für offene, intelligente Datenspeicherung
Wählen Sie Speicherort und -format selbst bei voller Kontrolle und Portabilität Ihrer Daten.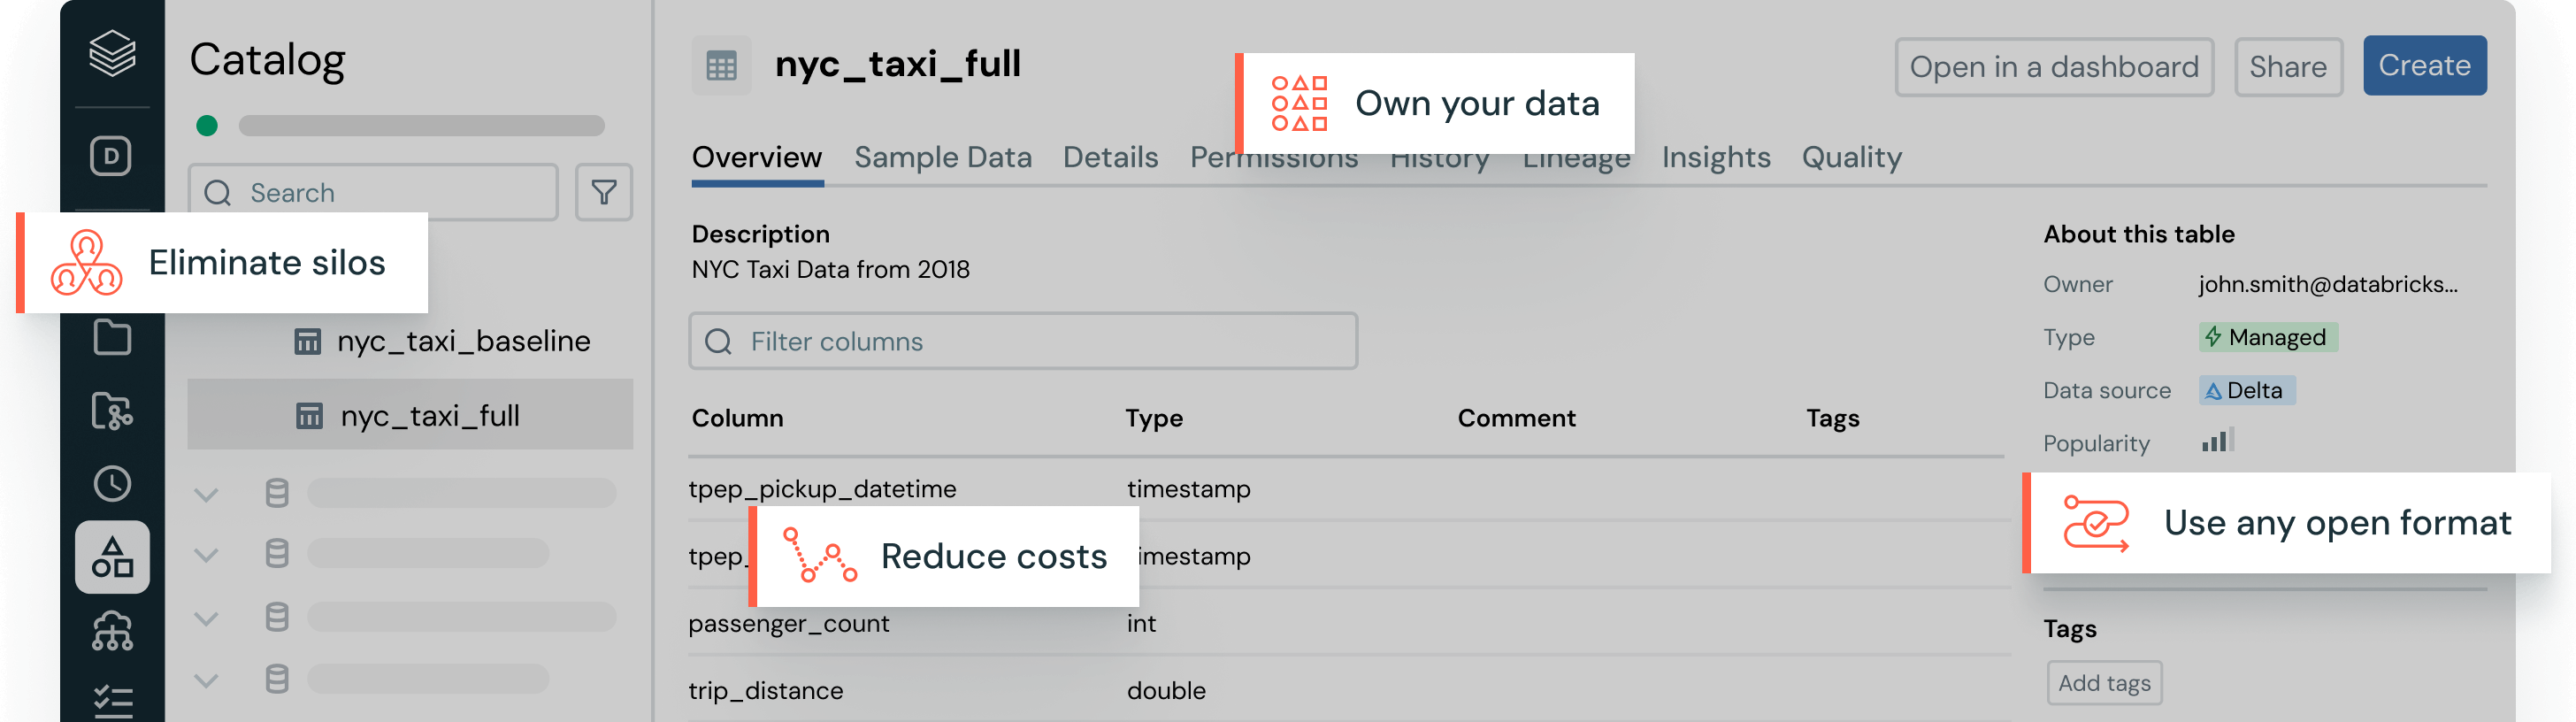
TOP TEAMS SUCCEED WITH DATA INTELLIGENCE
Flexibler, schneller Lakehouse-Speicher mit offenen Formaten
Beseitigen Sie Kopfschmerzen bei der Datenverwaltung mit offenen Tabellenformaten, zentralisierter Governance und automatischen Datenoptimierungen.
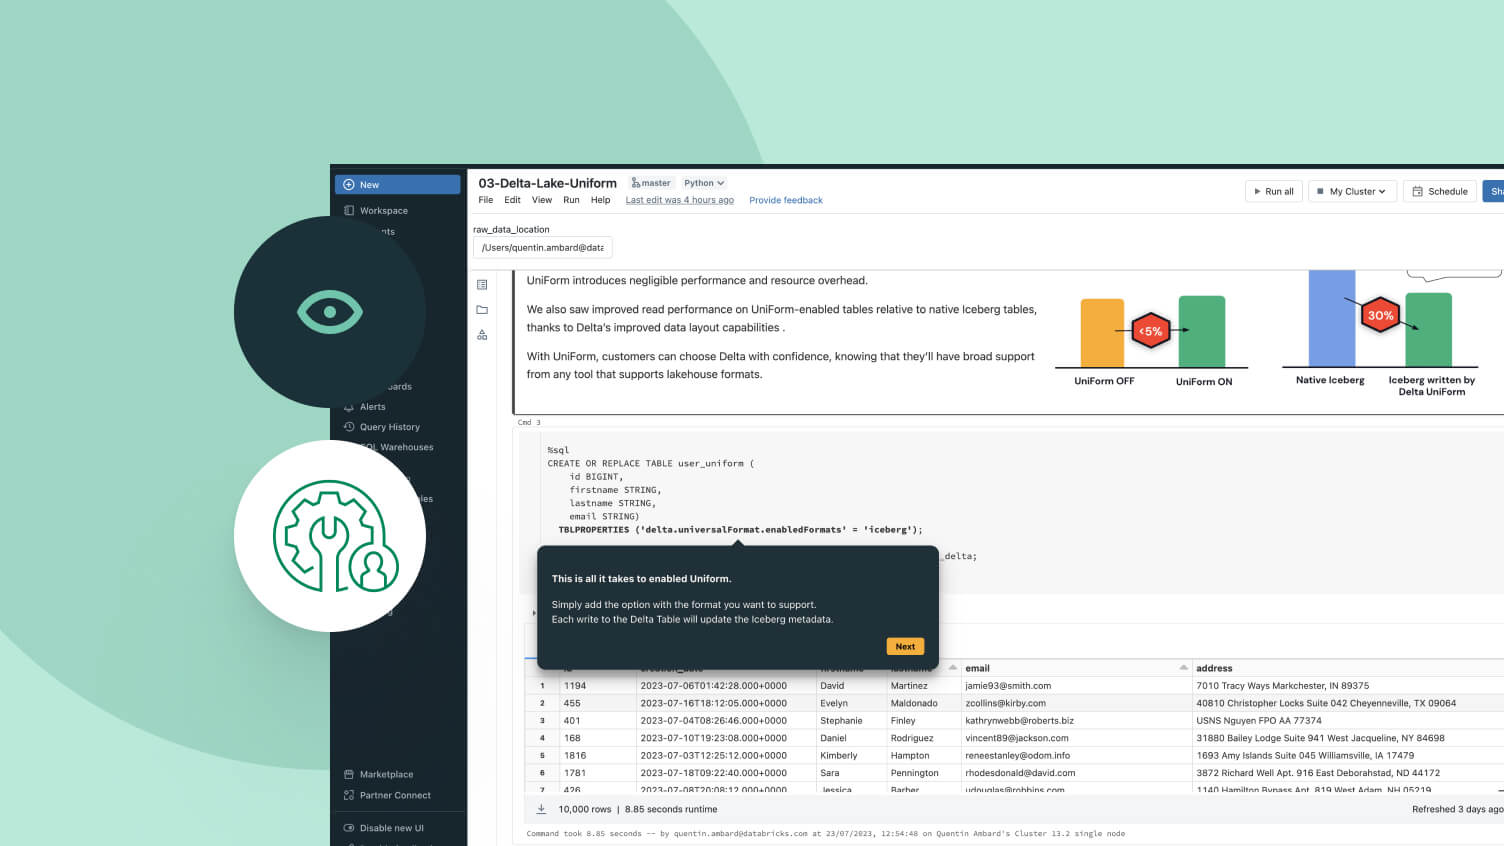
Kompatibilität mit Delta Lake- und Apache Iceberg™-Formaten
Eine einzige Kopie der Quelldaten in Delta Lake oder Apache Iceberg™, auf die von jeder Engine zugegriffen werden kann.

Einheitliche Governance für Daten- und KI-Assets
Ein einziger Katalog für Datenerkennung und Governance für Ihre Daten- und KI-Assets.

KI-gesteuerte Optimierung für Geschwindigkeit und niedrige Kosten
KI-gestützte Modelle optimieren und pflegen Daten autonom für Geschwindigkeit und niedrige Kosten.
Wählen Sie Ihren Speicherort und das Format für die offene Tabelle
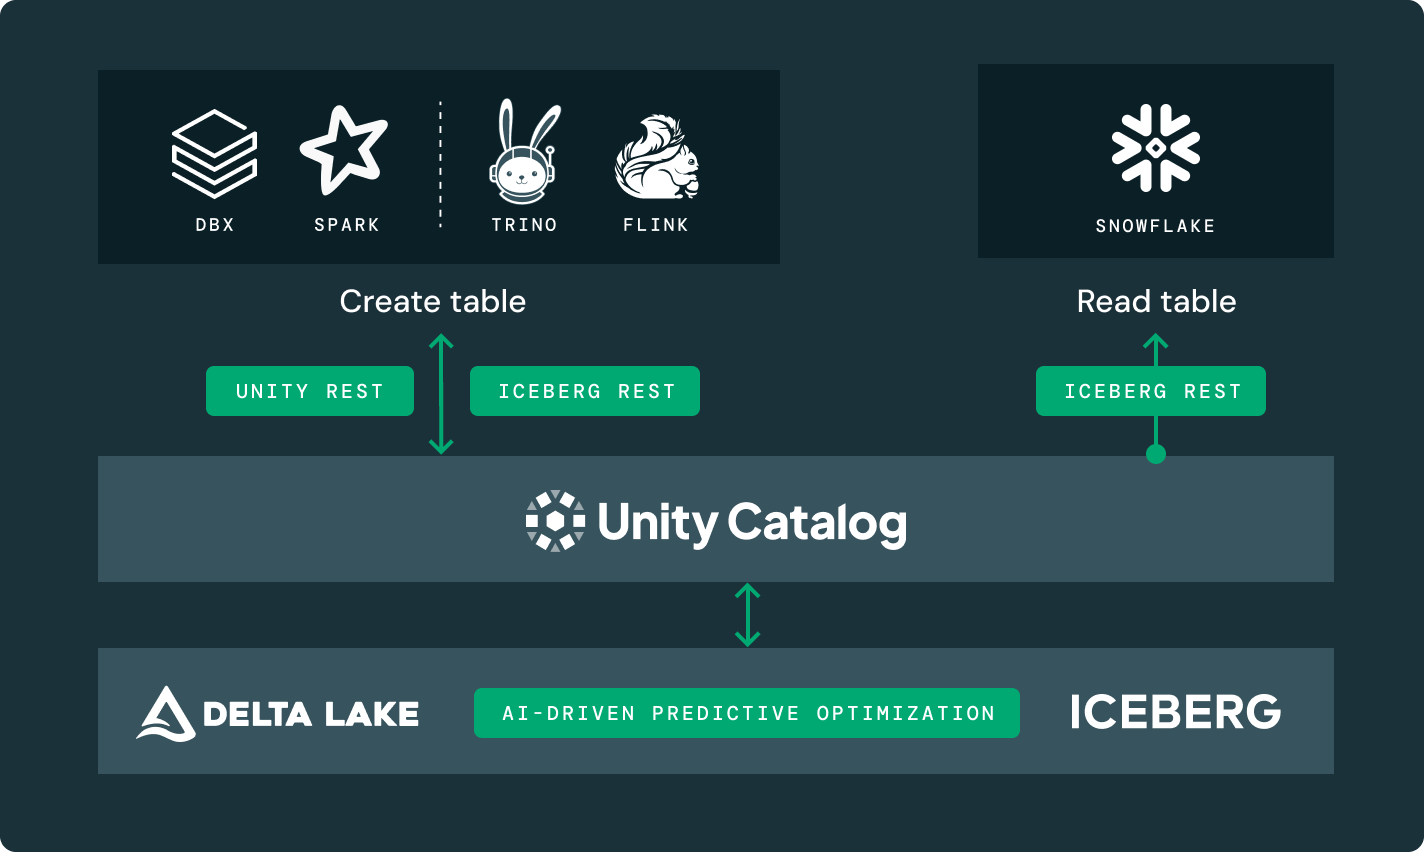
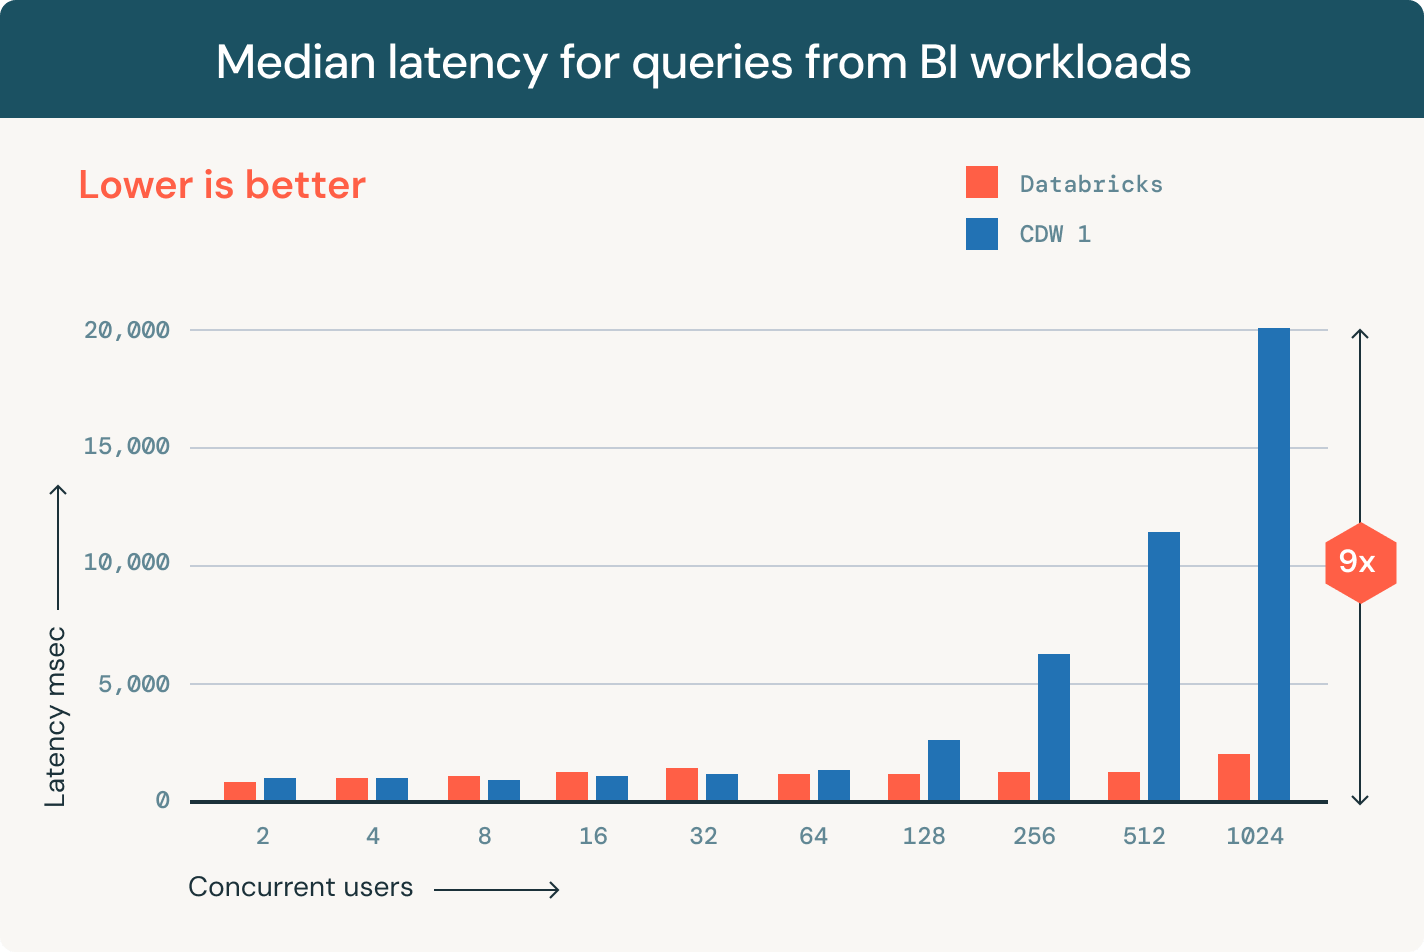
Wählen Sie den Speicherort und das offene Format, das für Sie funktioniert. Halten Sie Ihre Daten portabel, ohne Anbieterbindung.Erstklassige Lese- und Schreibleistung für Delta Lake- und Apache Iceberg™-Tabellen, sofort einsatzbereit, mit Speicheroptimierungen, die in keinem anderen Lakehouse verfügbar sind.
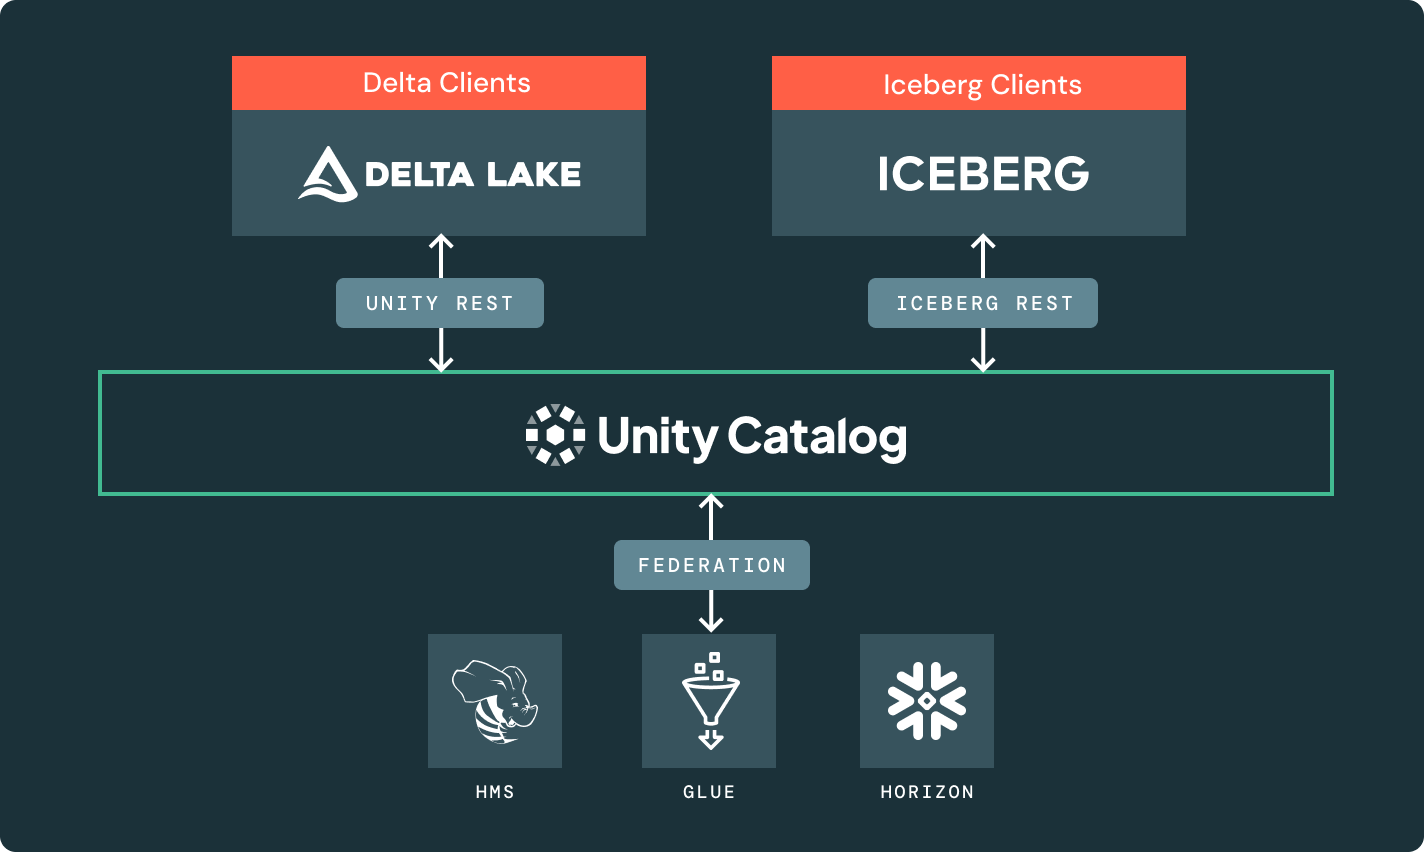
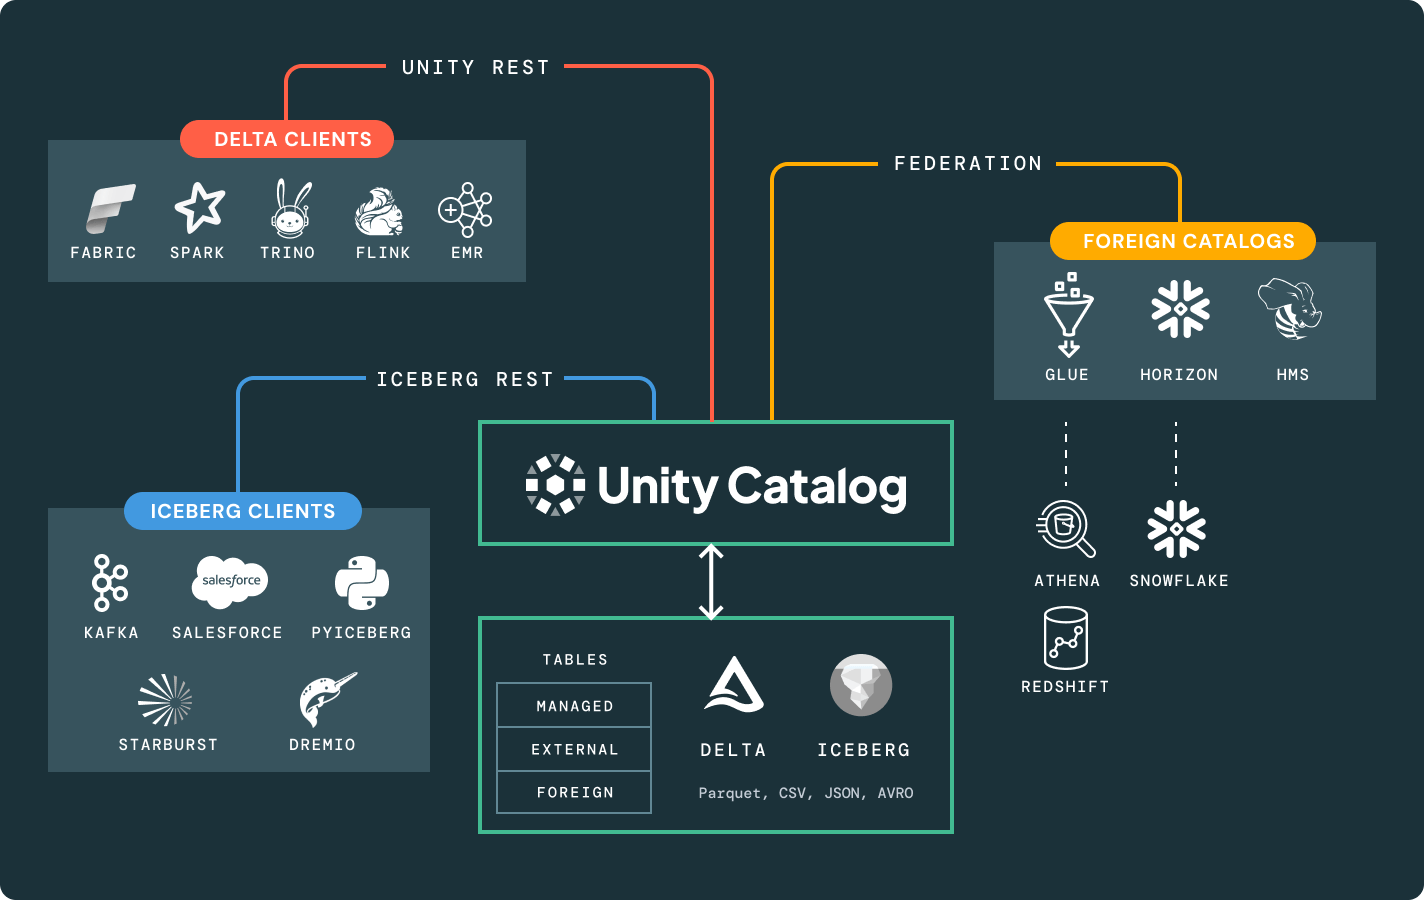
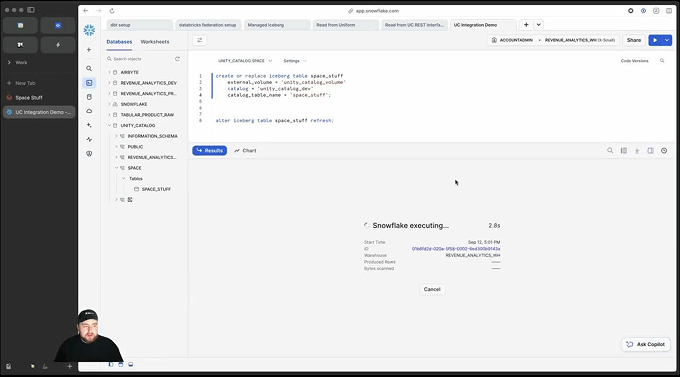
Greifen Sie auf Tabellen zu, die von externen Katalogen wie Glue, HMS und Snowflake Horizon verwaltet werden, und nutzen Sie erweiterte Unity Catalog-Funktionen wie feingranulare Zugriffssteuerungen.
Die REST-APIs für Unity und Iceberg REST Catalog schalten das gesamte Lakehouse-Ökosystem frei – über Formate und Engines hinweg.
Zusätzliche Funktionen für den Lakehouse-Speicher
Lakehouse-Speicher für ETL, Warehousing und Sharing

Erstellen und Verwalten Sie zuverlässige Datenpipelines
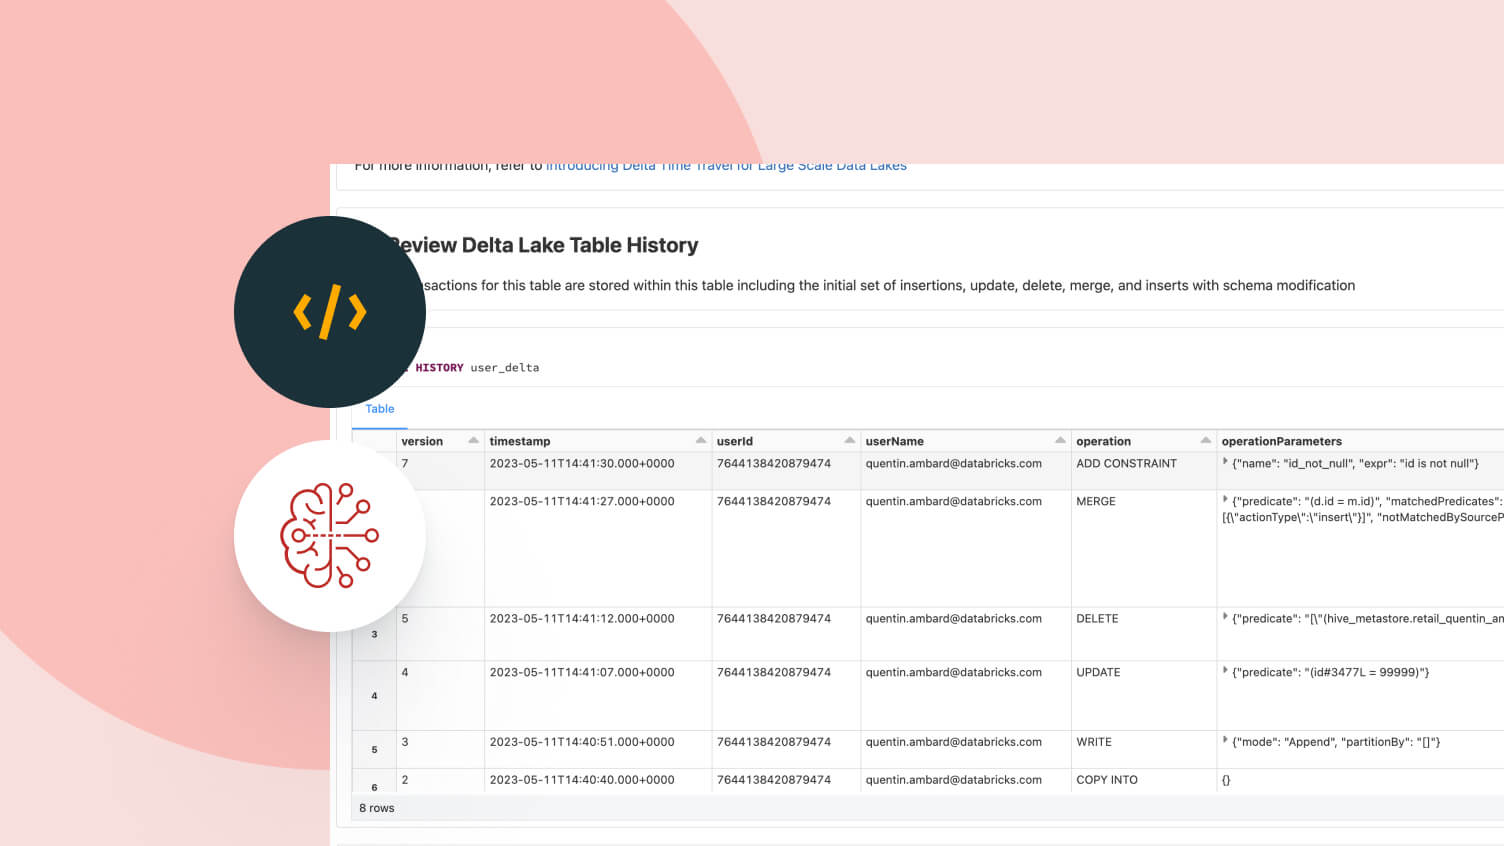
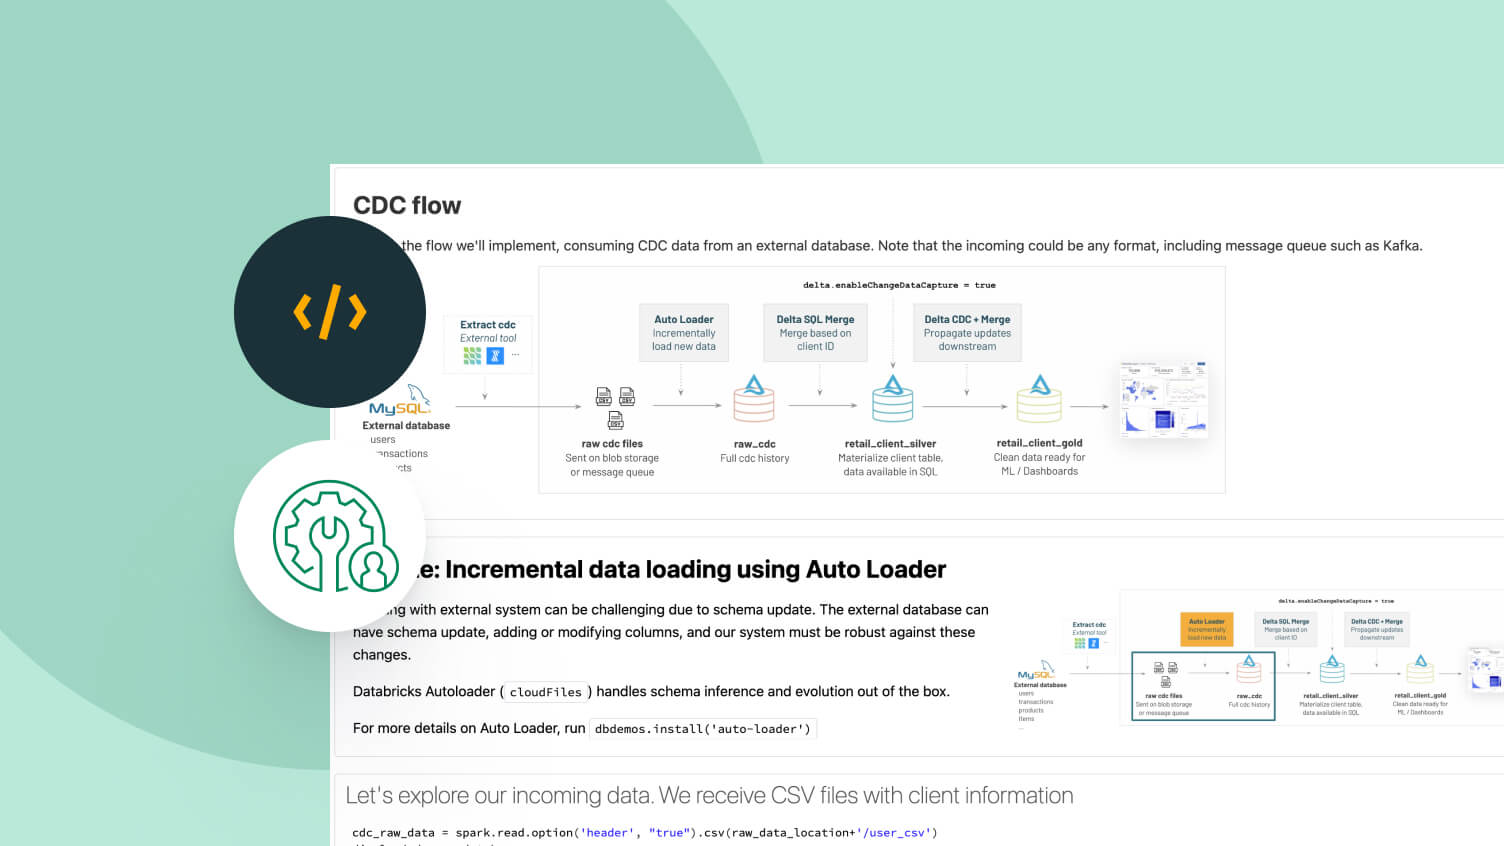
Verwaltete Tabellen fungieren sowohl als Batch-Tabellen als auch als Streaming-Quelle und -Senke. Ob Erfassung von Streaming-Daten, zeitlich versetzter Batch-Abgleich oder interaktive Abfragen: Alles funktioniert von Anfang an erwartungsgemäß und mit direkter Integration in Spark Structured Streaming.
Entdecken, steuern und teilen Sie Ihre Daten- und KI-Assets
Erfahren Sie mehr darüber, wie die Databricks Data + AI Platform Ihre Datenteams bei all Ihren Daten- und KI-Workloads unterstützt.
Unity Catalog
Die einzige einheitliche und offene Governance-Lösung der Branche für Daten und KI, integriert in die Databricks Data + AI Platform.

Delta-Freigabe
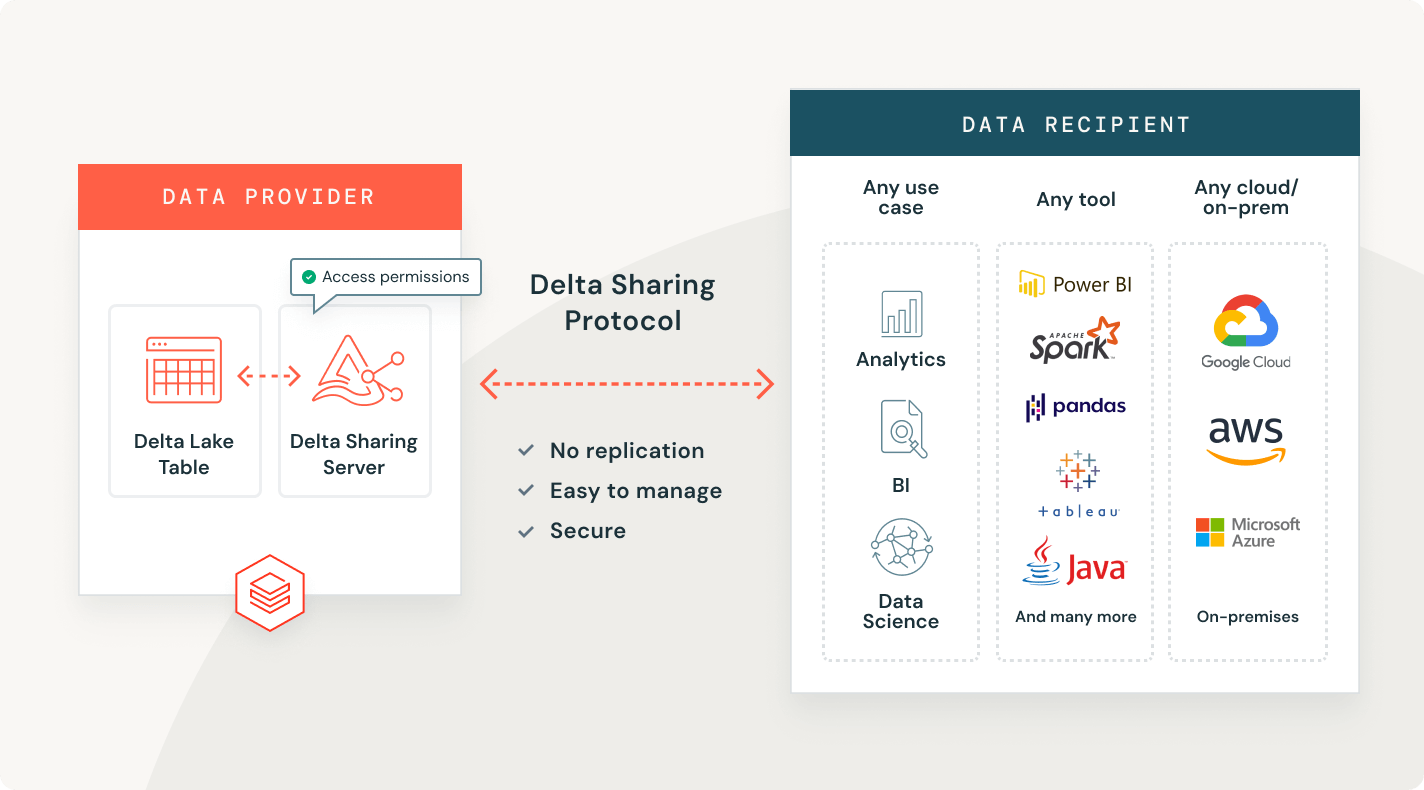
Der erste Open-Source-Ansatz für die gemeinsame Nutzung von Daten, Analytics und KI. Teilen Sie Live-Daten sicher über Plattformen, Clouds und Regionen hinweg.

Data + AI Platform
Entdecken Sie die gesamte Bandbreite der auf der Databricks Data + AI Platform verfügbaren Tools zur nahtlosen Integration von Daten und KI in Ihrem Unternehmen.
Mehr Informationen
FAQ zum Lakehouse-Speicher
Offene Tabellenformate sind Open-Source-Standardtabellenformate, die ACID-Transaktionen in Data Lakes ermöglichen. Databricks unterstützt Delta Lake und Apache Iceberg™. Das bedeutet, dass eine einzige Kopie Ihrer Daten einmal geschrieben und von jeder kompatiblen Engine gelesen werden kann, anstatt in ein proprietäres Format gebunden zu sein.
Möchten Sie ein Daten- und KI-Unternehmen werden?
Machen Sie die ersten Schritte Ihrer Transformation